Che cos’è l’elaborazione delle immagini? Breve introduzione
Scopri che cos’è l’elaborazione delle immagini, come funziona e come viene applicata nella sanità, nella guida autonoma e in altri moderni sistemi intelligenti.
 Abirami Vina8 min di lettura
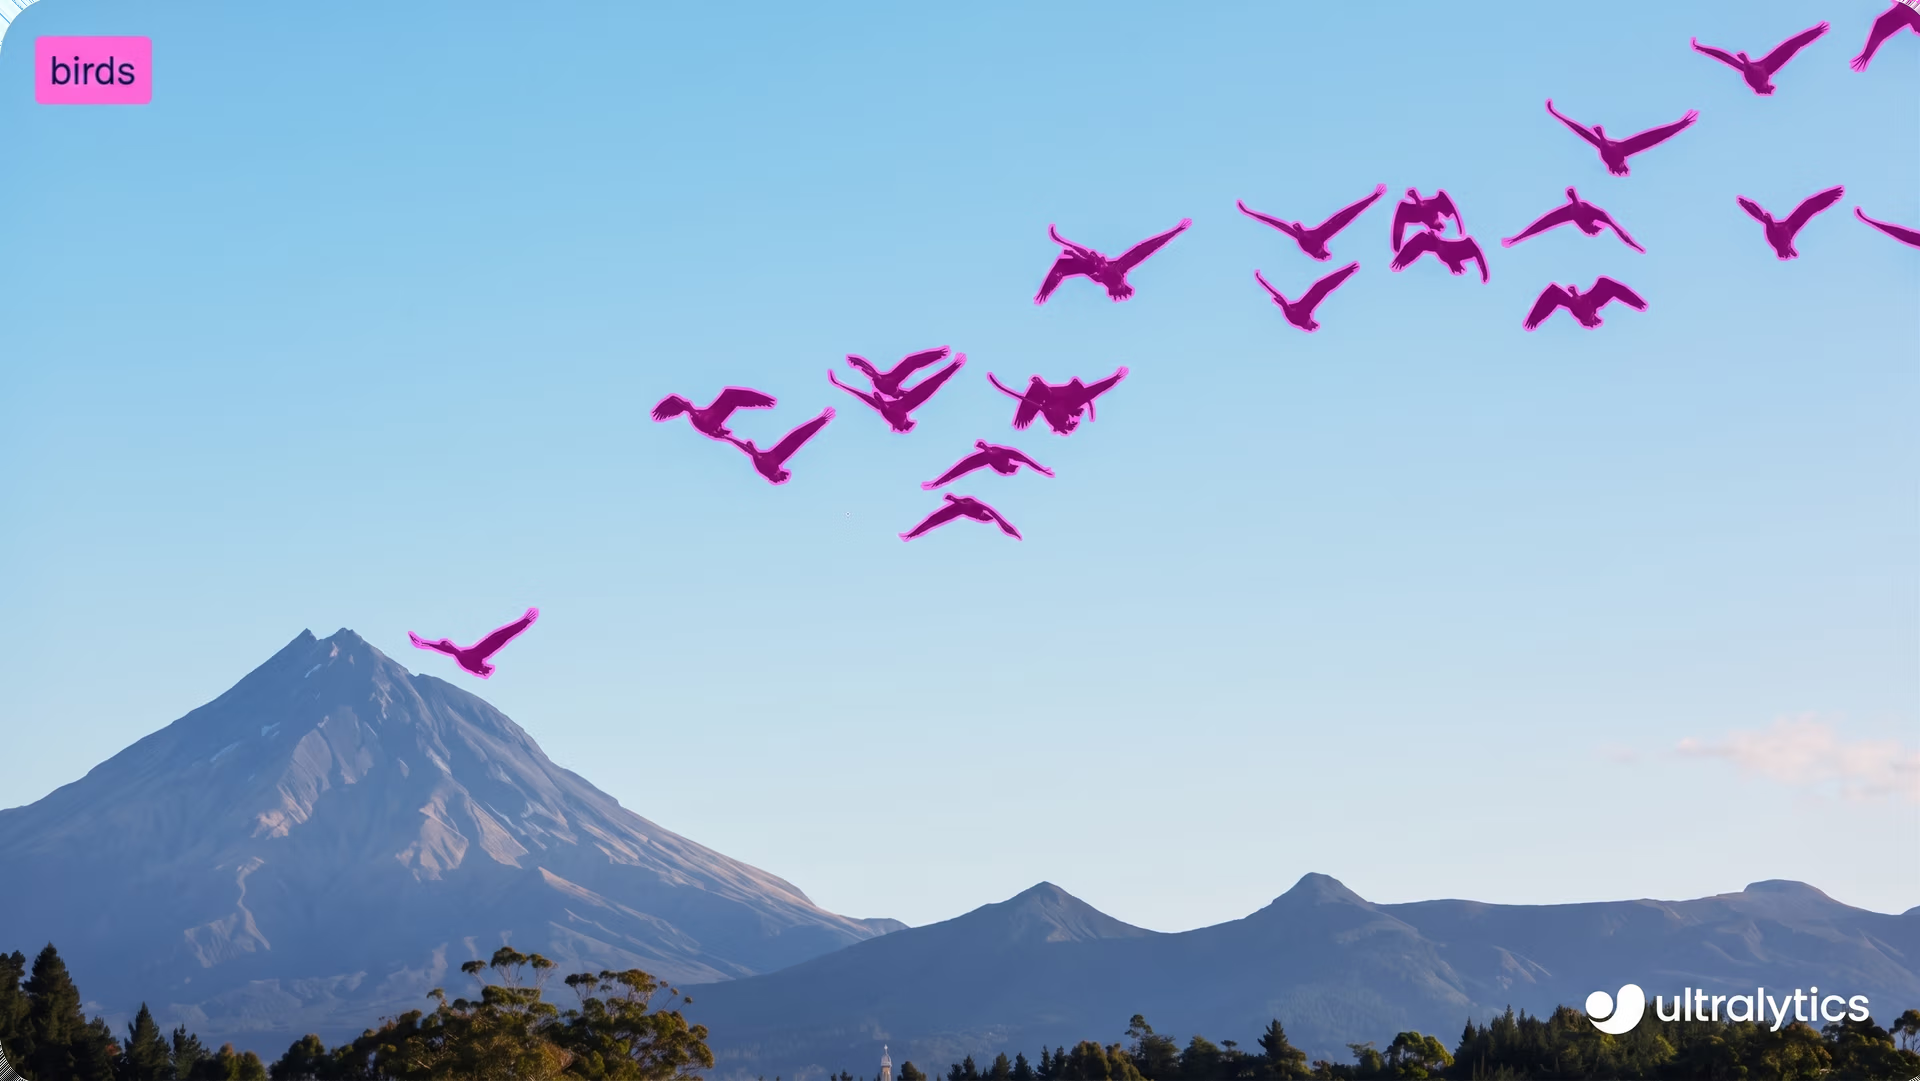
Quando attraversi un centro commerciale o una strada pubblica affollata, le telecamere installate sopra gli ingressi e lungo i passaggi registrano ciò che accade. Generano dati visivi ogni secondo e, il più delle volte, non ce ne accorgiamo nemmeno.
Questo flusso costante di dati alimenta i moderni sistemi basati sull’IA, dai sistemi di sicurezza intelligenti alle auto a guida autonoma. Queste innovazioni sono rese possibili dall’elaborazione computazionale delle immagini, un settore versatile che unisce informatica, matematica e fisica.
L’elaborazione computazionale delle immagini aiuta le macchine a capire ciò che vedono in un’immagine. Consente ai sistemi di riconoscere cosa sta accadendo in una scena e di decidere come funzionare o reagire, per esempio fermando un’auto a guida autonoma quando compare un ostacolo.
In questo articolo esploreremo cos'è l'elaborazione delle immagini e come viene usata nei moderni sistemi di intelligenza artificiale (AI).
Capire l’elaborazione computazionale delle immagini#
L’elaborazione computazionale delle immagini è il processo di acquisizione, elaborazione e analisi delle immagini con algoritmi avanzati. Considera le immagini come dati che le macchine possono comprendere ed elaborare.
In altre parole, ogni immagine viene elaborata come una griglia di numeri. Per farlo, i pixel, le unità più piccole di un’immagine, vengono convertiti in una matrice composta da righe e colonne. Ogni pixel ha un valore numerico che indica alla macchina quanto è chiara o scura una determinata area dell’immagine.
Il modo in cui questi valori sono organizzati dipende dal fatto che l’immagine sia in scala di grigi o a colori. Nelle immagini in scala di grigi, i valori dei pixel vanno in genere da 0 (nero) a 255 (bianco). Nelle immagini a colori si usano più matrici per rappresentare diversi canali cromatici, come rosso, verde e blu (RGB) oppure tonalità, saturazione e valore (HSV).
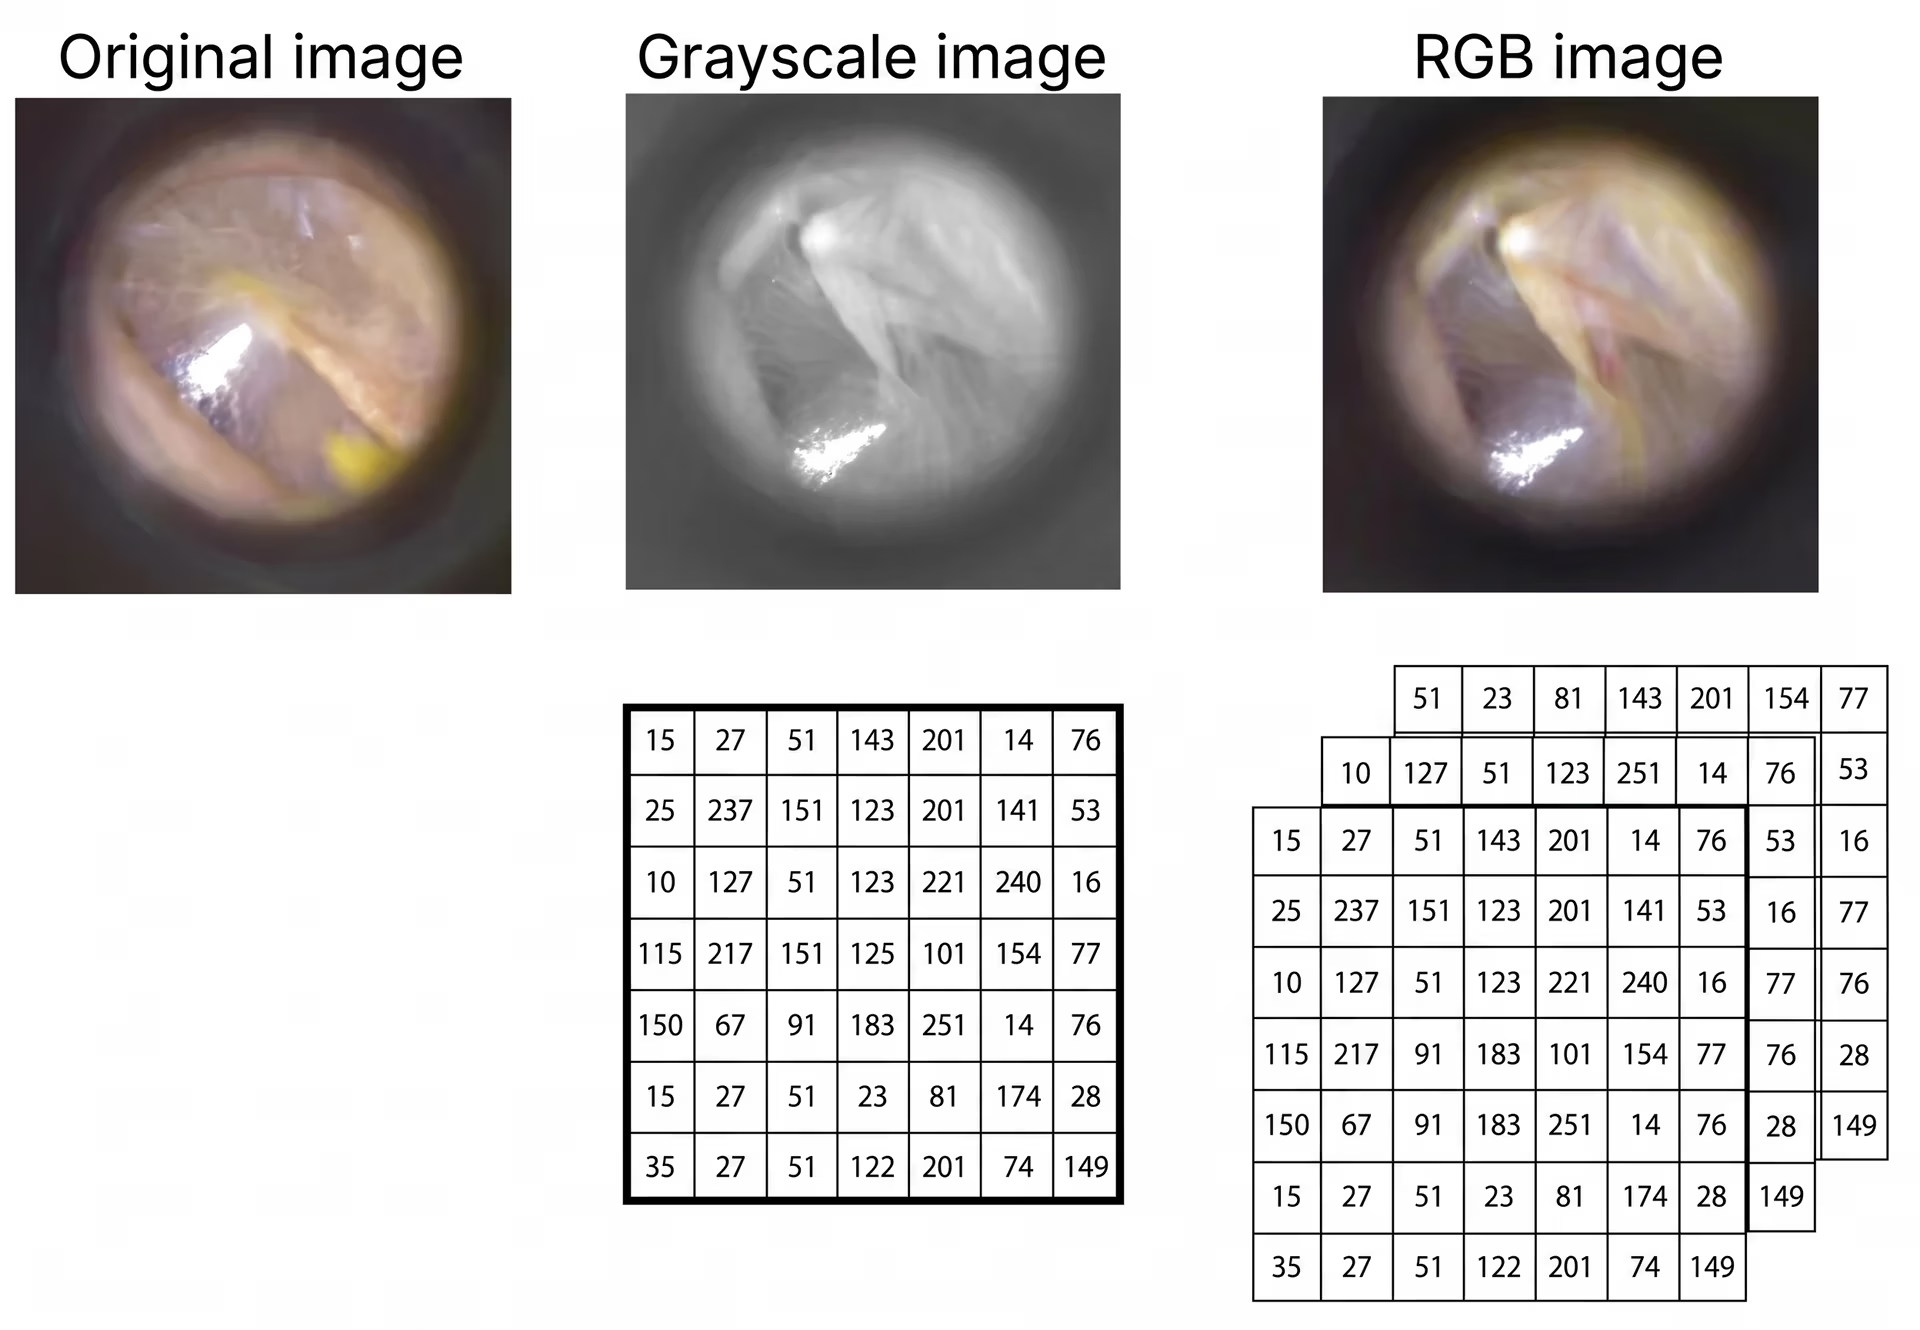
Fig. 1. Rappresentazioni matriciali delle immagini (Fonte)
Oltre alle matrici di pixel, un’immagine contiene spesso informazioni contestuali nascoste, note come metadati. I metadati forniscono dettagli importanti come la risoluzione dell’immagine, la profondità di bit, le impostazioni della fotocamera o del sensore e l’ora esatta in cui l’immagine è stata acquisita. Le immagini vengono archiviate in formati di file specifici per conservare sia i dati visivi sia i metadati.
Per esempio, nell’elaborazione computazionale delle immagini biomediche, le immagini sono comunemente archiviate nel formato Diagnostica per immagini e comunicazioni in medicina (DICOM). DICOM combina i dati visivi dell’immagine con informazioni sul paziente, come i dati identificativi e le impostazioni delle apparecchiature, garantendo che l’analisi delle immagini mediche sia accurata, coerente e sicura.
Come funziona l’elaborazione computazionale delle immagini#
Ora che abbiamo capito meglio cos’è l’elaborazione computazionale delle immagini, vediamo i passaggi necessari per trasformare il flusso video di una telecamera in informazioni utili.
Anche se il flusso di lavoro esatto può variare a seconda dell’applicazione, la maggior parte dei sistemi di elaborazione computazionale delle immagini segue queste fasi principali:
- Acquisizione delle immagini: per prima cosa, i dati visivi vengono acquisiti con fotocamere e sensori oppure raccolti da dataset di immagini open source.
- Preelaborazione delle immagini: successivamente, le immagini acquisite vengono ridimensionate, denoizzate, migliorate e convertite in uno spazio colore specifico per standardizzare gli input.
- Estrazione delle caratteristiche: gli algoritmi di deep learning vengono usati per apprendere schemi importanti nell'immagine, come bordi, forme e trame.
- Interpretazione: le caratteristiche estratte vengono analizzate per svolgere attività come il rilevamento degli oggetti, la segmentazione delle immagini e il tracciamento degli oggetti.
- Output: infine, il sistema genera output strutturati, come etichette di classe o riquadri di delimitazione, e li presenta in modo che siano facili da comprendere e utilizzare per la visualizzazione da parte di persone o altri sistemi.
Elaborazione computazionale delle immagini, visione artificiale ed elaborazione delle immagini a confronto#
Quando si parla di elaborazione computazionale delle immagini, si possono incontrare anche termini come elaborazione delle immagini e visione artificiale. Anche se spesso vengono usati come sinonimi, descrivono modi diversi in cui i sistemi di IA interagiscono con i dati visivi.
Per esempio, l’elaborazione delle immagini si concentra sul miglioramento delle immagini o della qualità delle immagini in ingresso, mediante operazioni di base come la rimozione del rumore, il ridimensionamento e la regolazione del contrasto. La visione artificiale, invece, è un ramo dell’IA che sviluppa l’elaborazione delle immagini, consentendo alle macchine di riconoscere oggetti, interpretare scene e capire cosa accade nelle immagini o nei video.
L’elaborazione computazionale delle immagini combina l’elaborazione delle immagini e la visione artificiale per trasformare i dati visivi in output significativi e utilizzabili dai sistemi intelligenti.
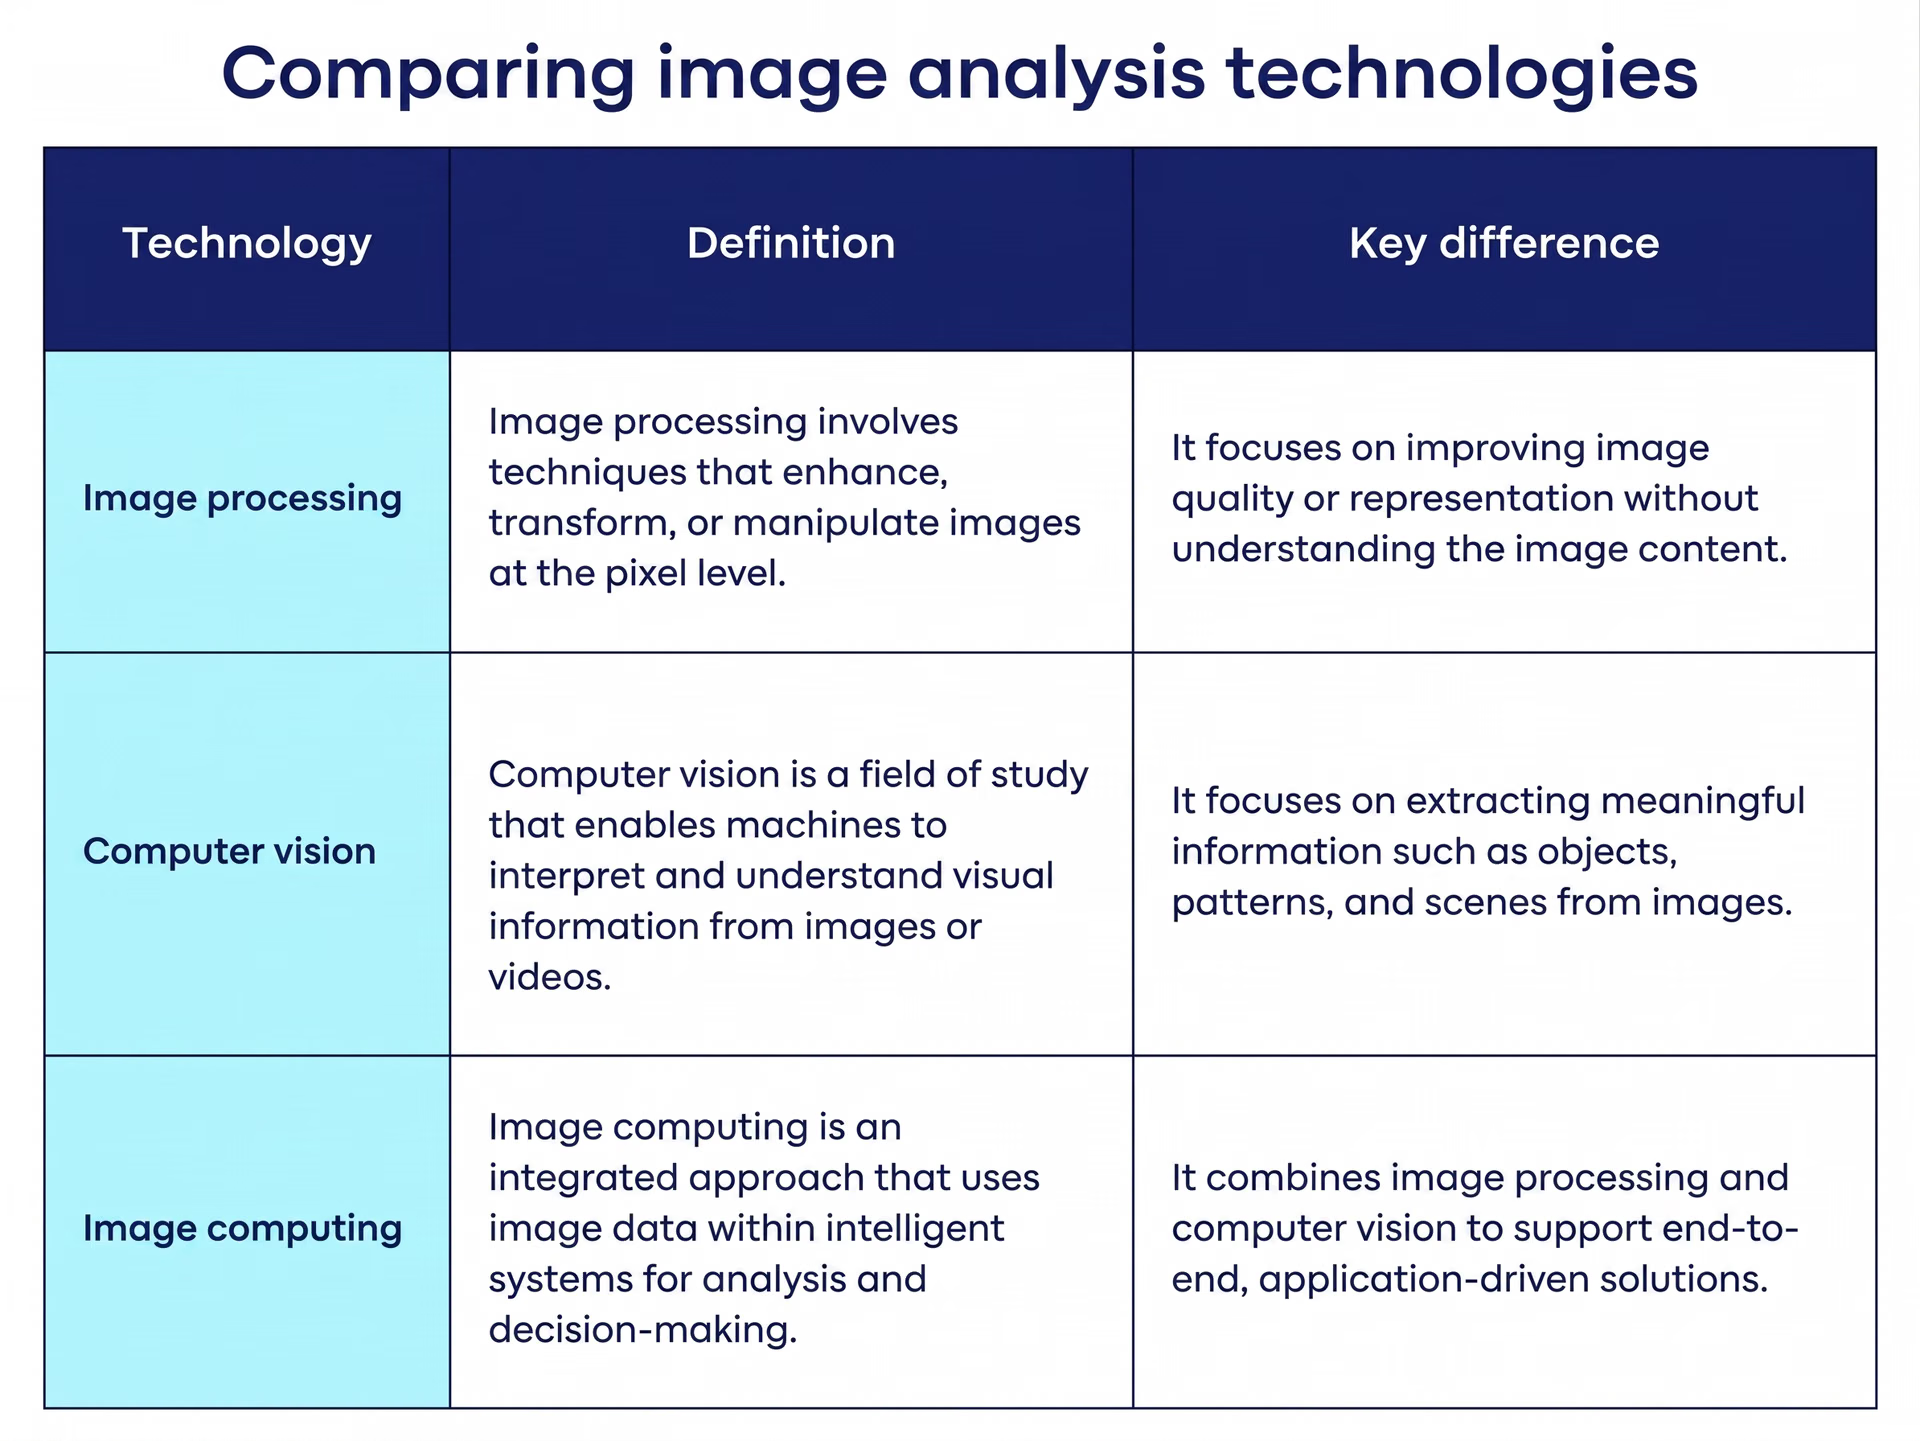
Fig. 2. Elaborazione delle immagini, visione artificiale ed elaborazione computazionale delle immagini a confronto. Immagine dell’autore.
Come viene implementata oggi l’elaborazione computazionale delle immagini#
Vediamo ora come viene implementata oggi l’elaborazione computazionale delle immagini.
Nelle prime fasi dell’elaborazione computazionale delle immagini, caratteristiche come bordi, angoli e texture venivano definite manualmente usando algoritmi basati su regole e progettati a mano. Sebbene questi metodi funzionassero abbastanza bene in ambienti controllati, faticavano a scalare e ad adattarsi alle condizioni complesse del mondo reale.
I moderni sistemi di elaborazione delle immagini superano questi limiti utilizzando approcci basati sul deep learning. Modelli come le reti neurali convoluzionali (CNNs) e i vision transformer apprendono automaticamente le caratteristiche pertinenti da grandi dataset di immagini. Questo consente loro di svolgere attività come il rilevamento degli oggetti, la segmentazione delle istanze e il tracciamento degli oggetti con maggiore precisione e robustezza.
Oggi, i flussi di lavoro di elaborazione delle immagini si basano spesso su modelli di visione in tempo reale progettati per essere distribuiti nei sistemi di AI in produzione. Per esempio, modelli di AI per la visione come Ultralytics YOLO26 consentono capacità di visione artificiale rapide ed efficienti, come il rilevamento degli oggetti e la segmentazione delle istanze, sia sui dispositivi edge sia negli ambienti cloud.
Fig. 3. Esempio di utilizzo di Ultralytics YOLO26 per rilevare e segmentare oggetti in un'immagine.
Applicazioni reali dell’elaborazione computazionale delle immagini#
L’elaborazione computazionale delle immagini è ampiamente usata in applicazioni reali per comprendere i dati visivi e agire di conseguenza. Vediamo come viene applicata in diversi ambiti.
Elaborazione computazionale delle immagini mediche per la diagnosi precoce delle malattie#
L'elaborazione delle immagini può aiutare medici e professionisti sanitari a individuare prima le malattie e ad analizzare le scansioni mediche in modo più efficiente. Questi sistemi possono elaborare rapidamente dati di diagnostica per immagini come radiografie e scansioni di risonanza magnetica (MRI), fornendo spesso risultati più coerenti rispetto alla revisione manuale.
Per esempio, modelli come Ultralytics YOLO26 possono essere addestrati su grandi raccolte di radiografie del torace, come il dataset ZhangLabData Chest X-Ray, per apprendere schemi associati a infezioni e anomalie. Una volta addestrati, questi modelli possono aiutare a stabilire se una scansione appare normale o mostra segni di patologie come polmonite o COVID-19.
Elaborazione computazionale delle immagini per la guida autonoma#
I veicoli autonomi usano l’elaborazione computazionale delle immagini per capire cosa accade intorno a loro e prendere decisioni di guida. Questa tecnologia trasforma i filmati grezzi delle telecamere in informazioni in tempo reale che aiutano il veicolo a muoversi in modo sicuro e fluido.
L'elaborazione delle immagini è comunemente usata nei sistemi avanzati di assistenza alla guida (ADAS). Invece di limitarsi a registrare video, questi moduli analizzano ogni fotogramma per individuare segnaletica orizzontale, altri veicoli, pedoni e ostacoli. In questo modo, l'auto può reagire alle mutevoli condizioni stradali con un intervento umano minimo.
Un altro caso d’uso comune consiste nel combinare le immagini di più telecamere per creare una vista a 360 gradi dell’ambiente circostante il veicolo. L’elaborazione computazionale delle immagini aiuta a correggere la distorsione dell’obiettivo, migliorare la nitidezza delle immagini e bilanciare luminosità e colore in tutti i flussi video delle telecamere. Il risultato è una vista nitida e uniforme che consente al veicolo di muoversi in sicurezza, anche con condizioni meteorologiche avverse o in condizioni di scarsa illuminazione.
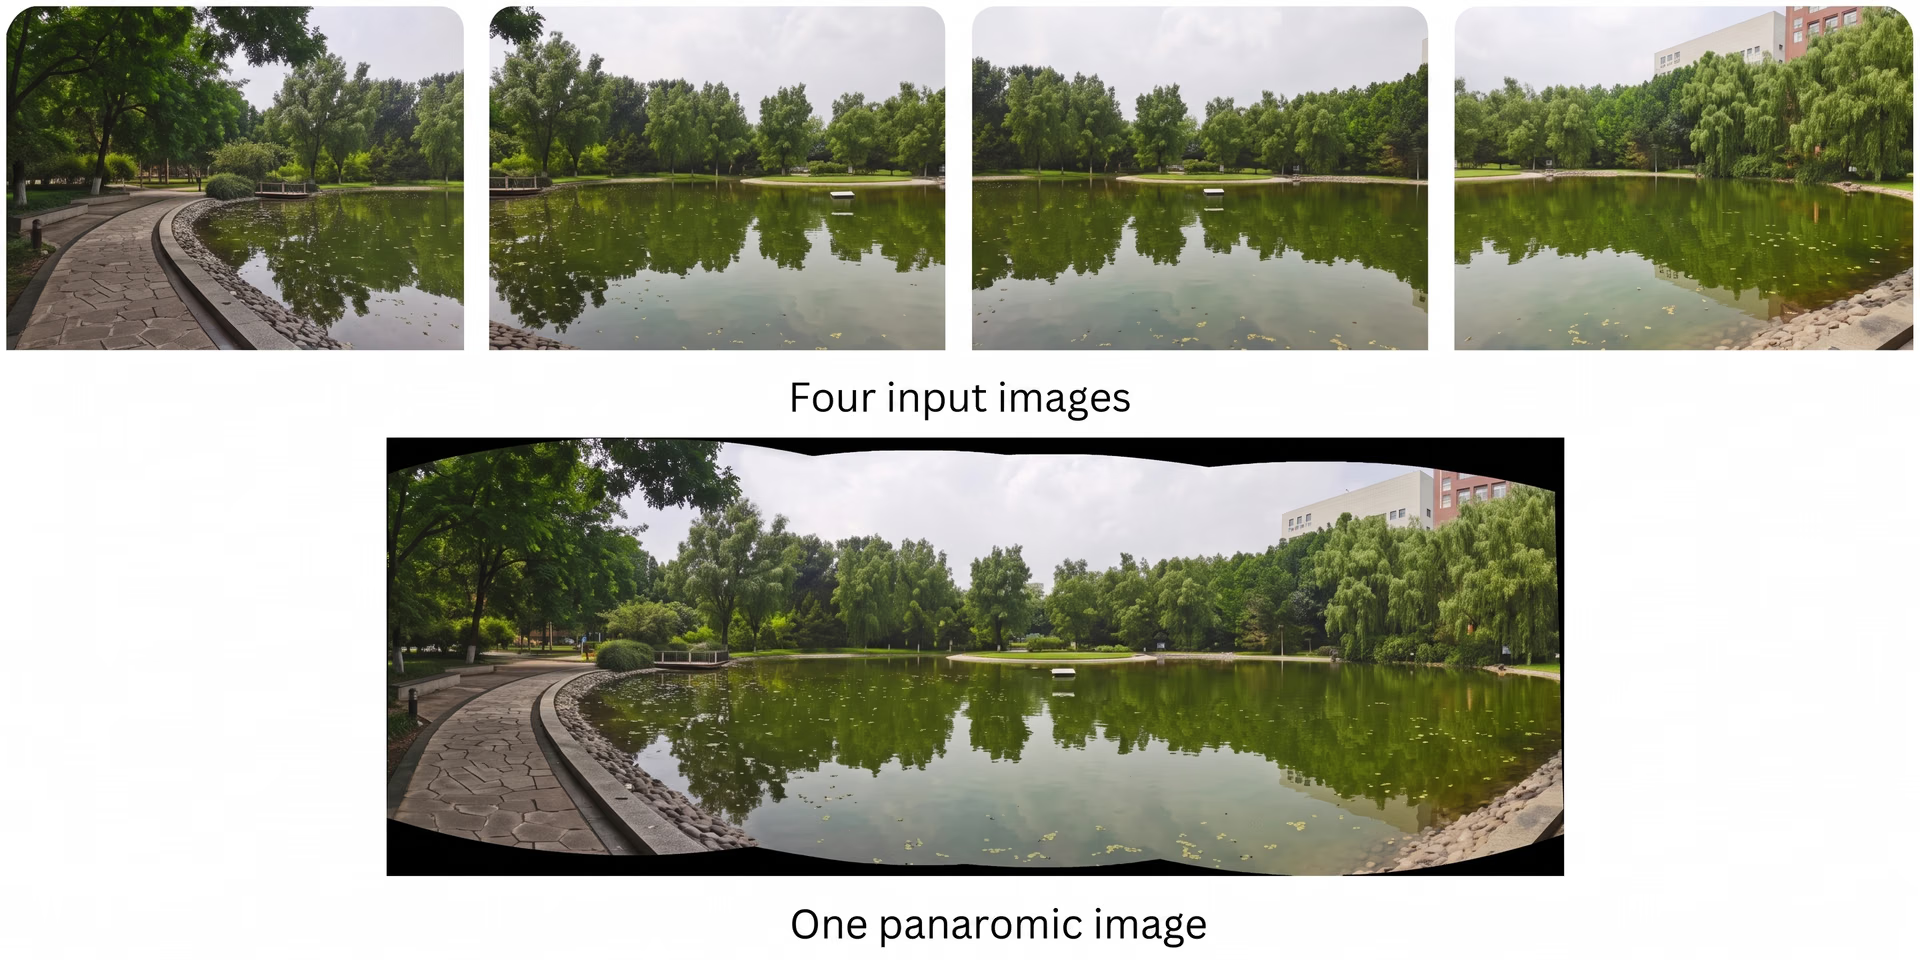
Fig. 4. Composizione di immagini mediante deep learning (Fonte)
Vantaggi e svantaggi dell’elaborazione computazionale delle immagini#
Ecco alcuni vantaggi dell’elaborazione computazionale delle immagini:
- Scalabilità: una volta addestrati, i sistemi di elaborazione computazionale delle immagini possono analizzare grandi volumi di dati visivi in modo continuo e su larga scala.
- Processo decisionale: supporta applicazioni in cui il tempo è un fattore critico, come la guida autonoma, lo screening medico e il monitoraggio industriale.
- Efficienza dei costi nel tempo: anche se la configurazione iniziale può essere costosa, l’analisi visiva automatizzata può ridurre i costi operativi a lungo termine.
Sebbene l’elaborazione computazionale delle immagini offra molti vantaggi, presenta anche alcune limitazioni. Ecco alcuni fattori da considerare:
- Qualità dei dati: i metodi di elaborazione delle immagini dipendono fortemente da etichettature accurate e dataset di alta qualità, che possono essere costosi e richiedere molto tempo per essere creati.
- Sensibilità alle condizioni: i cambiamenti nell’illuminazione, le occlusioni, la sfocatura dovuta al movimento, le condizioni meteorologiche o le angolazioni della telecamera possono influire negativamente sulle prestazioni del modello.
- Spiegabilità limitata: i modelli di immagini basati sul deep learning possono comportarsi come scatole nere, rendendo difficile spiegare come vengono prese le decisioni.
Punti chiave#
L’elaborazione delle immagini si è evoluta, passando dalle tecniche di base a una tecnologia che consente ai sistemi di IA di percepire e comprendere il mondo reale in tempo reale. Con il continuo avanzamento del deep learning, l’elaborazione delle immagini sta diventando una componente essenziale per creare toolkit e applicazioni più intelligenti e pratici.
Unisciti alla nostra community e dai un’occhiata al nostro repository GitHub per saperne di più sull’IA. Esplora le nostre pagine dedicate alle soluzioni per scoprire le applicazioni dell’IA in agricoltura e della visione artificiale nella logistica. Scopri le nostre opzioni di licenza e inizia a creare modelli di IA per la visione.
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









