Apprendimento auto-supervisionato per la riduzione del rumore: guida passo passo
Scopri come funziona l'apprendimento auto-supervisionato per la riduzione del rumore, perché le immagini diventano rumorose e quali sono i principali metodi e passaggi per recuperare dettagli visivi nitidi.
 Abirami Vina15 min di lettura
Le telecamere non sempre catturano il mondo come lo vediamo noi. Un ritratto scattato in condizioni di scarsa illuminazione o la foto di un’auto in rapido movimento possono risultare sgranati, sfocati o distorti.
Sensori lenti, ambienti bui e movimento possono introdurre minuscoli puntini di rumore che ammorbidiscono i contorni e nascondono dettagli importanti. Quando si perde nitidezza, anche i sistemi avanzati di IA e machine learning possono faticare a capire cosa contiene un’immagine, perché molti sistemi intelligenti si affidano a questi dettagli per funzionare bene.
Per esempio, la visione artificiale è un ramo dell’intelligenza artificiale che consente alle macchine di interpretare immagini e video. Per farlo con precisione, però, i modelli di IA per la visione hanno bisogno di dati visivi nitidi e di alta qualità da cui apprendere.
In particolare, modelli come Ultralytics YOLO11 e Ultralytics YOLO26 (rilasciato a gennaio 2026) supportano attività come il rilevamento degli oggetti, la segmentazione delle istanze e la stima della posa, e possono essere addestrati su misura per diversi casi d’uso. Queste attività si basano su indizi visivi chiari, come bordi, texture, colori e dettagli strutturali fini.
Quando il rumore nasconde queste caratteristiche, il modello riceve segnali di addestramento più deboli e imparare schemi accurati diventa più difficile. Di conseguenza, anche piccole quantità di rumore possono ridurre le prestazioni nelle applicazioni reali.
In precedenza abbiamo visto come l’apprendimento auto-supervisionato denoisi le immagini. In questo articolo approfondiremo il funzionamento delle tecniche di denoising auto-supervisionato e il modo in cui aiutano a recuperare informazioni visive significative.
Tipi comuni di rumore nelle immagini reali#
Prima di esaminare come si usa l’apprendimento autosupervisionato per il denoising delle immagini, vediamo perché le immagini diventano rumorose.
Le immagini di oggetti e scene reali sono raramente perfette. La scarsa illuminazione, la qualità limitata dei sensori e i movimenti rapidi possono introdurre disturbi casuali nei singoli pixel dell’immagine. Queste alterazioni a livello dei pixel, note come rumore, riducono la nitidezza complessiva e rendono più difficile distinguere i dettagli importanti.
Quando il rumore nasconde contorni, texture e schemi sottili, i sistemi di visione artificiale faticano a riconoscere gli oggetti o a interpretare le scene con precisione. Condizioni diverse producono tipi diversi di rumore, ognuno dei quali altera l’immagine a modo suo.
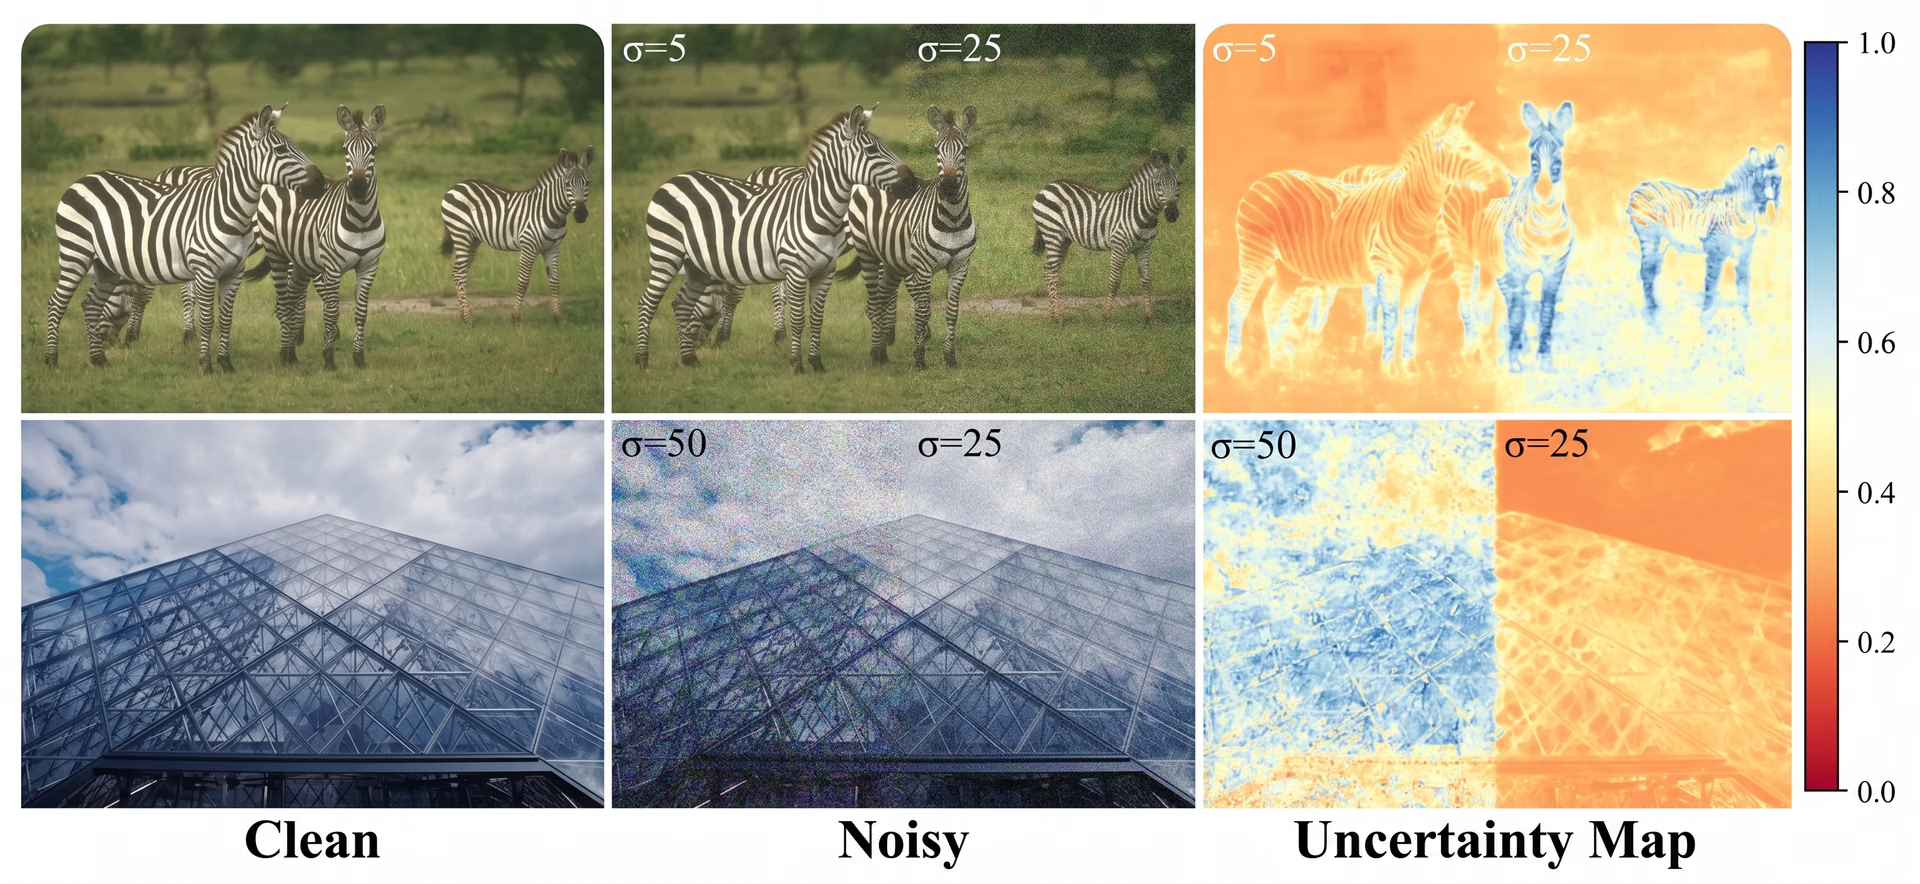
Fig. 1. Esempio di come il rumore possa aumentare l’incertezza in un’immagine. (Fonte)
Ecco alcuni dei tipi di rumore più comuni nelle immagini:
- Rumore gaussiano: questo tipo di rumore si manifesta come una grana tenue e casuale causata da interferenze elettroniche del sensore o da fluttuazioni termiche. Segue una distribuzione gaussiana (normale), in cui piccole variazioni dei pixel sfocano i dettagli fini e riducono la nitidezza complessiva.
- Rumore di Poisson: chiamato anche rumore fotonico, questo tipo di rumore si verifica in condizioni di scarsa illuminazione o con tempi di esposizione brevi. La sua varianza aumenta con la luminosità, ma il rumore è spesso più evidente nelle regioni scure perché vengono catturati meno fotoni, con conseguente riduzione del rapporto segnale-rumore.
- Rumore sale e pepe: questo tipo di rumore si manifesta come picchi netti di pixel neri o bianchi. In genere è causato da errori di trasmissione, corruzione dei bit o sensori della fotocamera difettosi e spesso produce valori dei pixel mancanti o corrotti.
- Rumore speckle: questo tipo di rumore si manifesta con schemi granulari e puntiformi ed è comune nelle immagini mediche, radar ed ecografiche. È causato da interferenze e diffusione del segnale, che riducono il contrasto e rendono più difficile rilevare i contorni.
Quando usare il denoising autosupervisionato?#
Cosa rende speciale il denoising autosupervisionato? È particolarmente efficace quando non esistono immagini pulite di riferimento oppure è troppo difficile acquisirle.
Succede spesso nella fotografia in condizioni di scarsa illuminazione, nell’imaging ad alta sensibilità ISO, nell’imaging medico e scientifico o in qualsiasi ambiente in cui il rumore sia inevitabile e raccogliere dati di riferimento perfetti sia irrealistico. Invece di aver bisogno di esempi puliti, il modello apprende direttamente dalle immagini rumorose che hai già, adattandosi così agli specifici schemi di rumore della tua fotocamera o del tuo sensore.
Il denoising autosupervisionato è anche un’ottima scelta quando vuoi migliorare le prestazioni delle attività di visione artificiale a valle, ma il tuo dataset contiene immagini incoerenti o rumorose. Recuperando contorni, texture e strutture più nitidi, questi metodi aiutano modelli come YOLO a rilevare, segmentare e interpretare le scene in modo più affidabile. In breve, se lavori con dati rumorosi e non hai a disposizione immagini pulite per l’addestramento, il denoising autosupervisionato è spesso la soluzione più pratica ed efficace.
Le tecniche alla base del denoising autosupervisionato#
Come abbiamo visto in precedenza, il denoising auto-supervisionato è un approccio di IA basato sull’apprendimento profondo che consente ai modelli di apprendere direttamente da immagini rumorose senza dipendere da etichette pulite. Si basa sui principi dell’apprendimento auto-supervisionato, in cui i modelli ricavano i propri segnali di addestramento dai dati stessi.
In altre parole, un modello può imparare da solo usando immagini rumorose sia come input sia come fonte del segnale di apprendimento. Confrontando versioni diverse e corrotte della stessa immagine o prevedendo i pixel mascherati, il modello impara quali schemi rappresentano la struttura reale e quali sono solo rumore. Grazie all’ottimizzazione iterativa e al riconoscimento degli schemi, la rete migliora gradualmente la capacità di distinguere i contenuti significativi di un’immagine dalle variazioni casuali.
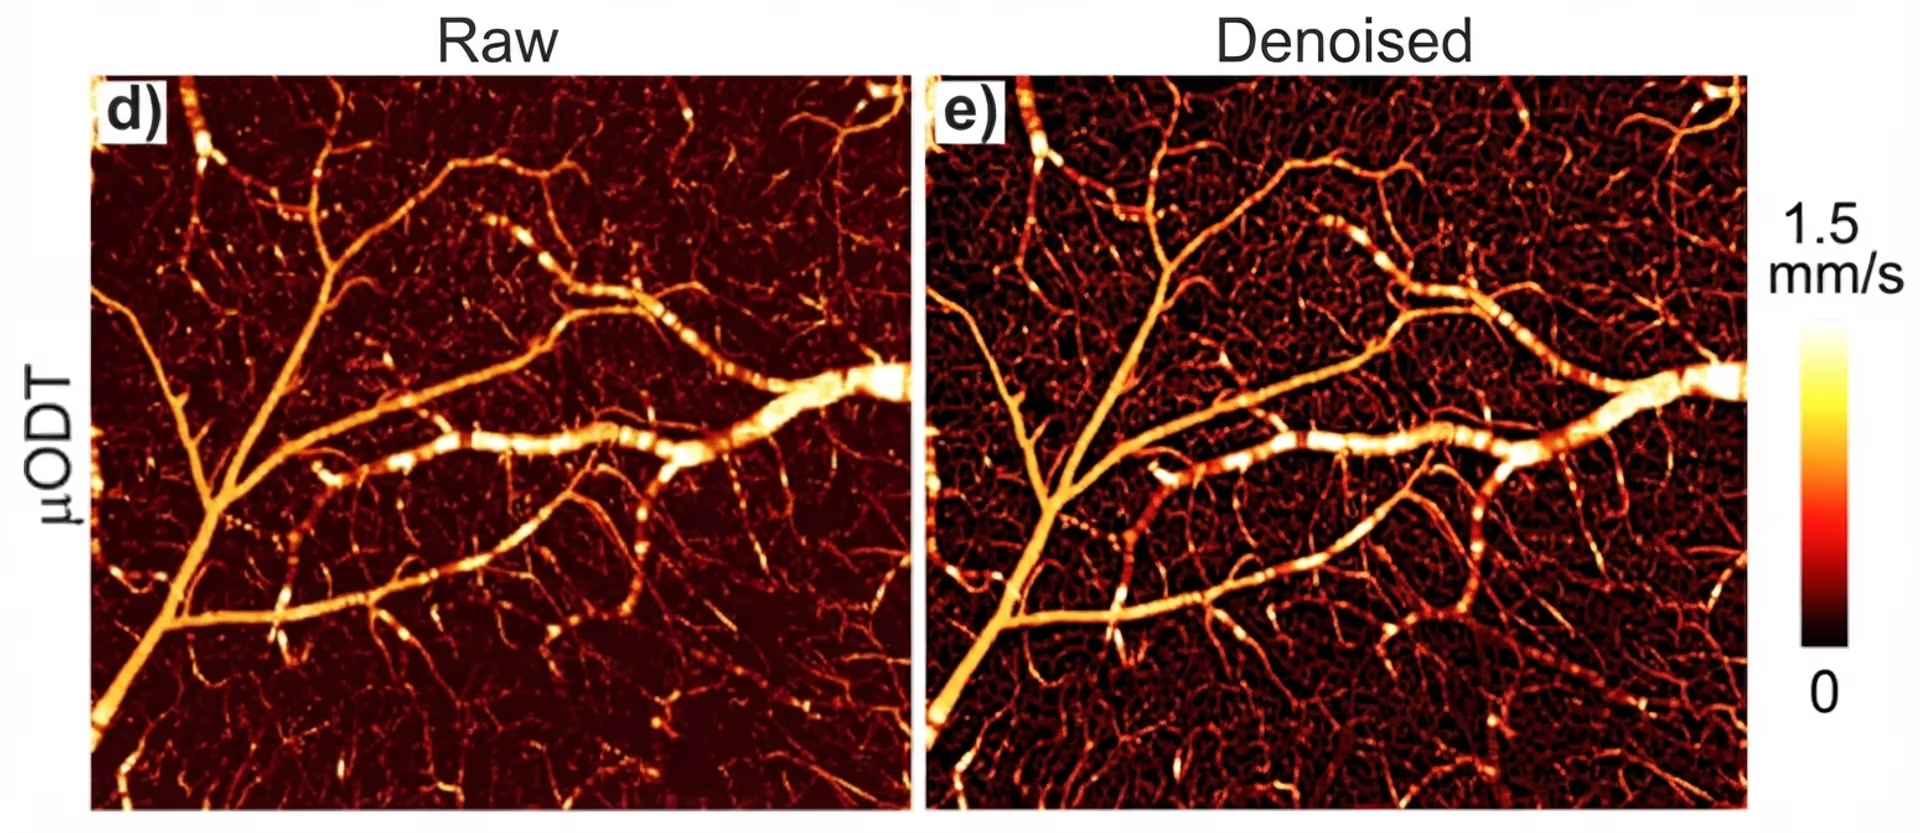
Fig. 2. Un’immagine grezza e un’immagine denoisata. (Fonte)
Questo è possibile grazie a specifiche strategie di apprendimento che guidano il modello nel separare la struttura stabile dell’immagine dal rumore casuale. Vediamo più da vicino le tecniche e gli algoritmi fondamentali che semplificano questo processo e come ciascun approccio aiuta i modelli a ricostruire immagini più nitide e affidabili.
Metodi di denoising delle immagini a coppie#
Molti dei primi metodi di apprendimento autosupervisionato per il denoising funzionavano confrontando due versioni rumorose della stessa immagine. Poiché il rumore cambia casualmente ogni volta che un’immagine viene acquisita o corrotta, mentre la struttura reale rimane invariata, queste differenze possono essere usate come segnale di apprendimento per un modello.
Questi approcci sono comunemente chiamati metodi di denoising delle immagini a coppie perché durante l’addestramento usano o generano coppie di immagini rumorose. Per esempio, l’approccio Noise2Noise, proposto da Jaakko Lehtinen e dal suo team, addestra un modello usando due immagini della stessa scena, corrotte dal rumore in modo indipendente. Poiché gli schemi di rumore differiscono tra le due versioni, il modello impara a individuare i dettagli coerenti che rappresentano l’immagine sottostante reale.
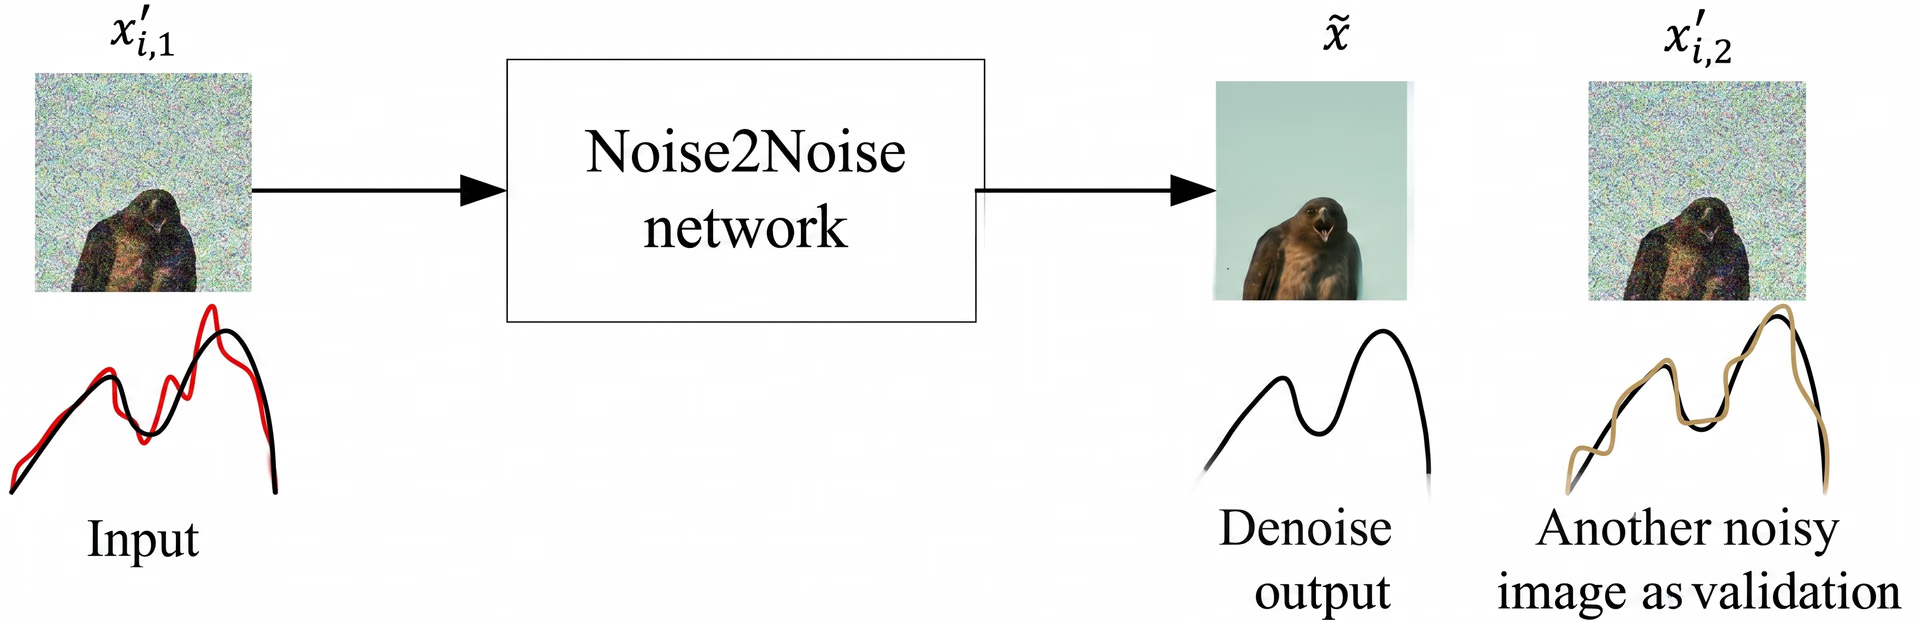
Fig. 3. Come funziona Noise2Noise (Fonte)
Col tempo, questo insegna alla rete a sopprimere il rumore casuale e a preservare la struttura reale, anche se non vede mai un’immagine pulita di riferimento. Considera il semplice caso in cui scatti due foto di una strada poco illuminata di notte.
Ogni immagine contiene gli stessi edifici, luci e ombre, ma la grana del rumore appare in punti diversi. Confrontando queste due foto rumorose durante l’addestramento, un modello autosupervisionato può imparare quali schemi visivi sono stabili e quali sono causati dal rumore, migliorando così la propria capacità di ricostruire immagini più nitide.
Metodi di apprendimento autosupervisionato basati su blind spot per il denoising#
Mentre i metodi a coppie si basano sul confronto tra due versioni della stessa immagine corrotte in modo diverso, i metodi basati su blind spot adottano un approccio diverso. Consentono al modello di apprendere da una singola immagine rumorosa nascondendo alcuni pixel selezionati, in modo che la rete non possa vederne i valori corrotti.
Il modello deve quindi prevedere i pixel nascosti usando solo il contesto circostante. L’idea fondamentale è che il rumore sia casuale, mentre la struttura sottostante di un’immagine non lo è.
Impedendo al modello di copiare il valore rumoroso di un pixel, i metodi basati su blind spot lo incoraggiano a dedurre quale dovrebbe essere quel valore in base a schemi stabili dell’immagine, come contorni, texture o gradienti di colore vicini. Tecniche come Noise2Void, introdotta da Alexander Krull e dal suo team, e Noise2Self, sviluppata da Joshua Batson e Loïc Royer, applicano questo principio mascherando singoli pixel o piccole aree e addestrando il modello a ricostruirli.
Approcci più avanzati, tra cui Noise2Same e PN2V, migliorano la robustezza imponendo previsioni coerenti tra più versioni mascherate oppure modellando esplicitamente la distribuzione del rumore per stimare l’incertezza. Poiché questi metodi richiedono una sola immagine rumorosa, sono particolarmente utili in ambiti in cui acquisire immagini pulite o abbinate è impraticabile o impossibile, come la microscopia, l’astronomia, l’imaging biomedico o la fotografia in condizioni di scarsa illuminazione.
Metodi di denoising basati sui Transformer#
La maggior parte dei metodi di denoising auto-supervisionato pairwise e a punto cieco si basa su reti neurali convoluzionali (CNNs) o reti di denoising. Le CNNs sono un’ottima scelta per questi approcci perché si concentrano sugli schemi locali, come bordi, texture e piccoli dettagli.
Architetture come U-Net sono ampiamente utilizzate perché combinano caratteristiche dettagliate e informazioni a più scale. Tuttavia, le CNN operano principalmente in aree limitate, perciò possono non cogliere relazioni importanti che si estendono su regioni più ampie dell’immagine.
I metodi di denoising all’avanguardia basati su Transformer sono stati introdotti per superare questo limite. Invece di considerare solo i pixel vicini, questi metodi usano meccanismi di attenzione per comprendere le relazioni tra le diverse parti di un’immagine.
Alcuni modelli usano un’attenzione globale completa, mentre altri adottano un’attenzione basata su finestre o gerarchica per ridurre i calcoli; in generale, però, sono progettati per cogliere strutture a lungo raggio che le CNN da sole non riescono a individuare. Questa visione più ampia aiuta il modello a ripristinare texture ripetute, superfici uniformi o oggetti di grandi dimensioni, che richiedono informazioni provenienti da tutta l’immagine.
Altri metodi di denoising delle immagini#
Oltre alle tecniche autosupervisionate, esistono anche diversi altri metodi per ripulire le immagini rumorose. I metodi tradizionali, come il filtro bilaterale, il denoising con wavelet e la media non locale, applicano semplici regole matematiche per attenuare il rumore cercando di preservare i dettagli importanti.
Esistono anche approcci di deep learning, tra cui modelli supervisionati che apprendono da coppie di immagini pulite e rumorose e reti generative avversarie (GAN) che producono risultati più nitidi e realistici. Tuttavia, questi metodi di solito richiedono immagini di qualità superiore per l’addestramento.
Panoramica passo per passo del funzionamento del denoising autosupervisionato delle immagini#
Abbiamo appena esaminato diverse tecniche e potresti chiederti se funzionano tutte in modo completamente diverso, dato che utilizzano architetture proprie. Tuttavia, seguono tutte una pipeline simile, che inizia con la preparazione dei dati e termina con la valutazione del modello.
Vediamo ora più da vicino, passo dopo passo, come funziona il processo complessivo di denoising delle immagini auto-supervisionato.
Passaggio 1: preelaborazione e normalizzazione#
Prima che il modello possa iniziare ad apprendere dalle immagini rumorose, il primo passaggio consiste nell’assicurarsi che tutte le immagini abbiano un aspetto coerente. Le foto reali possono variare molto.
Alcune immagini possono essere troppo luminose, altre troppo scure e altre ancora possono avere colori leggermente alterati. Se forniamo direttamente queste variazioni a un modello, per il modello diventa più difficile concentrarsi sull’apprendimento delle caratteristiche del rumore.
Per gestire questa fase, ogni immagine viene sottoposta a normalizzazione e a un preelaborazione di base. Le operazioni possono includere il ridimensionamento dei valori dei pixel a un intervallo standard, la correzione delle variazioni di intensità o il ritaglio e il ridimensionamento dell’immagine. L’obiettivo è fornire al modello dati coerenti, da usare come input stabili e confrontabili.
Passaggio 2: creazione di un segnale di addestramento autosupervisionato#
Una volta normalizzate le immagini, il passaggio successivo consiste nel creare un segnale di addestramento che consenta al modello di apprendere senza vedere mai un’immagine pulita. I metodi di denoising autosupervisionato lo fanno impedendo al modello di limitarsi a copiare i valori rumorosi dei pixel ricevuti.
Creano invece situazioni in cui il modello deve basarsi sul contesto circostante dell’immagine, che contiene una struttura stabile, anziché sul rumore imprevedibile. I diversi metodi lo ottengono in modi leggermente diversi, ma l’idea fondamentale è la stessa.
Alcuni approcci nascondono o mascherano temporaneamente determinati pixel, costringendo il modello a dedurne il valore da quelli vicini; altri generano una versione della stessa immagine rumorosa, corrotta separatamente, in modo che l’input e il target contengano rumore indipendente. In entrambi i casi, l’immagine target contiene informazioni strutturali significative, ma impedisce alla rete di accedere al valore rumoroso originale del pixel che deve prevedere.
Poiché il rumore cambia casualmente mentre l’immagine sottostante rimane coerente, questa configurazione incoraggia naturalmente il modello ad apprendere l’aspetto della struttura reale e a ignorare il rumore che varia da una versione all’altra.
Passaggio 3: apprendimento del denoising per recuperare la struttura dell’immagine#
Una volta predisposto il segnale di addestramento, il modello può iniziare a imparare a separare la struttura significativa dell’immagine dal rumore durante l’addestramento. Ogni volta che prevede un pixel mascherato o nuovamente corrotto, deve basarsi sul contesto circostante anziché sul valore rumoroso che occupava inizialmente quella posizione.
Dopo molte iterazioni o epoche, la rete impara a riconoscere i tipi di schemi che rimangono stabili nell’immagine, come contorni, texture e superfici uniformi. Impara anche a ignorare le fluttuazioni casuali che caratterizzano il rumore.
Per esempio, considera una foto scattata in condizioni di scarsa illuminazione in cui una superficie appare estremamente granulosa. Sebbene il rumore vari da un pixel all’altro, la superficie sottostante è comunque uniforme. Deducendo ripetutamente i pixel nascosti in queste aree, il modello diventa gradualmente più bravo a individuare lo schema stabile sotto il rumore e a ricostruirlo in modo più nitido.
Durante l’addestramento, la rete apprende una rappresentazione interna della struttura dell’immagine. Questo consente al modello di recuperare dettagli coerenti anche quando l’input è molto corrotto.
Passaggio 4: convalida e risultati della riduzione del rumore#
Dopo aver imparato a prevedere i pixel nascosti o nuovamente corrotti, il passaggio finale consiste nel valutare il rendimento del modello su immagini intere. Durante il test, il modello riceve un’intera immagine rumorosa e produce una versione denoisata completa sulla base di quanto ha appreso sulla struttura delle immagini. Per misurare l’efficacia del processo, l’output viene confrontato con immagini pulite di riferimento o con dataset di benchmark standard.
Due metriche comunemente usate sono PSNR (rapporto segnale-rumore di picco), che misura quanto la ricostruzione sia vicina al riferimento pulito, e SSIM (indice di similarità strutturale), che valuta quanto vengano preservate caratteristiche importanti come contorni e texture. In genere, punteggi più alti indicano un denoising più accurato e visivamente affidabile.
Dataset di immagini usati per l’addestramento e il benchmarking#
Le ricerche sul denoising auto-supervisionato, pubblicate sulle riviste IEEE, presentate alle conferenze CVF come CVPR, ICCV ed ECCV e rese disponibili su arXiv, si basano spesso su una combinazione di dataset sintetici e reali per valutare le prestazioni dei metodi di apprendimento profondo in condizioni sia controllate sia pratiche. Da un lato, i dataset sintetici partono da immagini pulite e aggiungono rumore artificiale, facilitando il confronto tra metodi con metriche come PSNR e SSIM.
Ecco alcuni dataset diffusi, comunemente utilizzati con l’aggiunta di rumore sintetico per il benchmarking:
- Kodak24: Questo dataset offre fotografie di scene naturali di alta qualità, comunemente utilizzate per confrontare visivamente i risultati della rimozione del rumore.
- DIV2K: Questo dataset ad alta risoluzione contiene immagini varie e ricche di dettagli, utilizzate per valutare la fedeltà delle texture e la qualità complessiva del ripristino.
I dataset rumorosi del mondo reale, invece, contengono immagini acquisite direttamente dai sensori delle fotocamere in condizioni di scarsa illuminazione, ISO elevato o altre situazioni difficili. Questi dataset verificano se un modello è in grado di gestire rumore complesso e non gaussiano, difficile da simulare.
Ecco alcuni dataset rumorosi del mondo reale molto diffusi:
- SIDD: Questo dataset fornisce coppie di immagini reali, una rumorosa e una pulita, acquisite con sensori di smartphone in diverse condizioni di illuminazione.
- DND: Include fotografie ad alto ISO che rappresentano schemi realistici di rumore dei sensori presenti nelle fotocamere di uso comune.
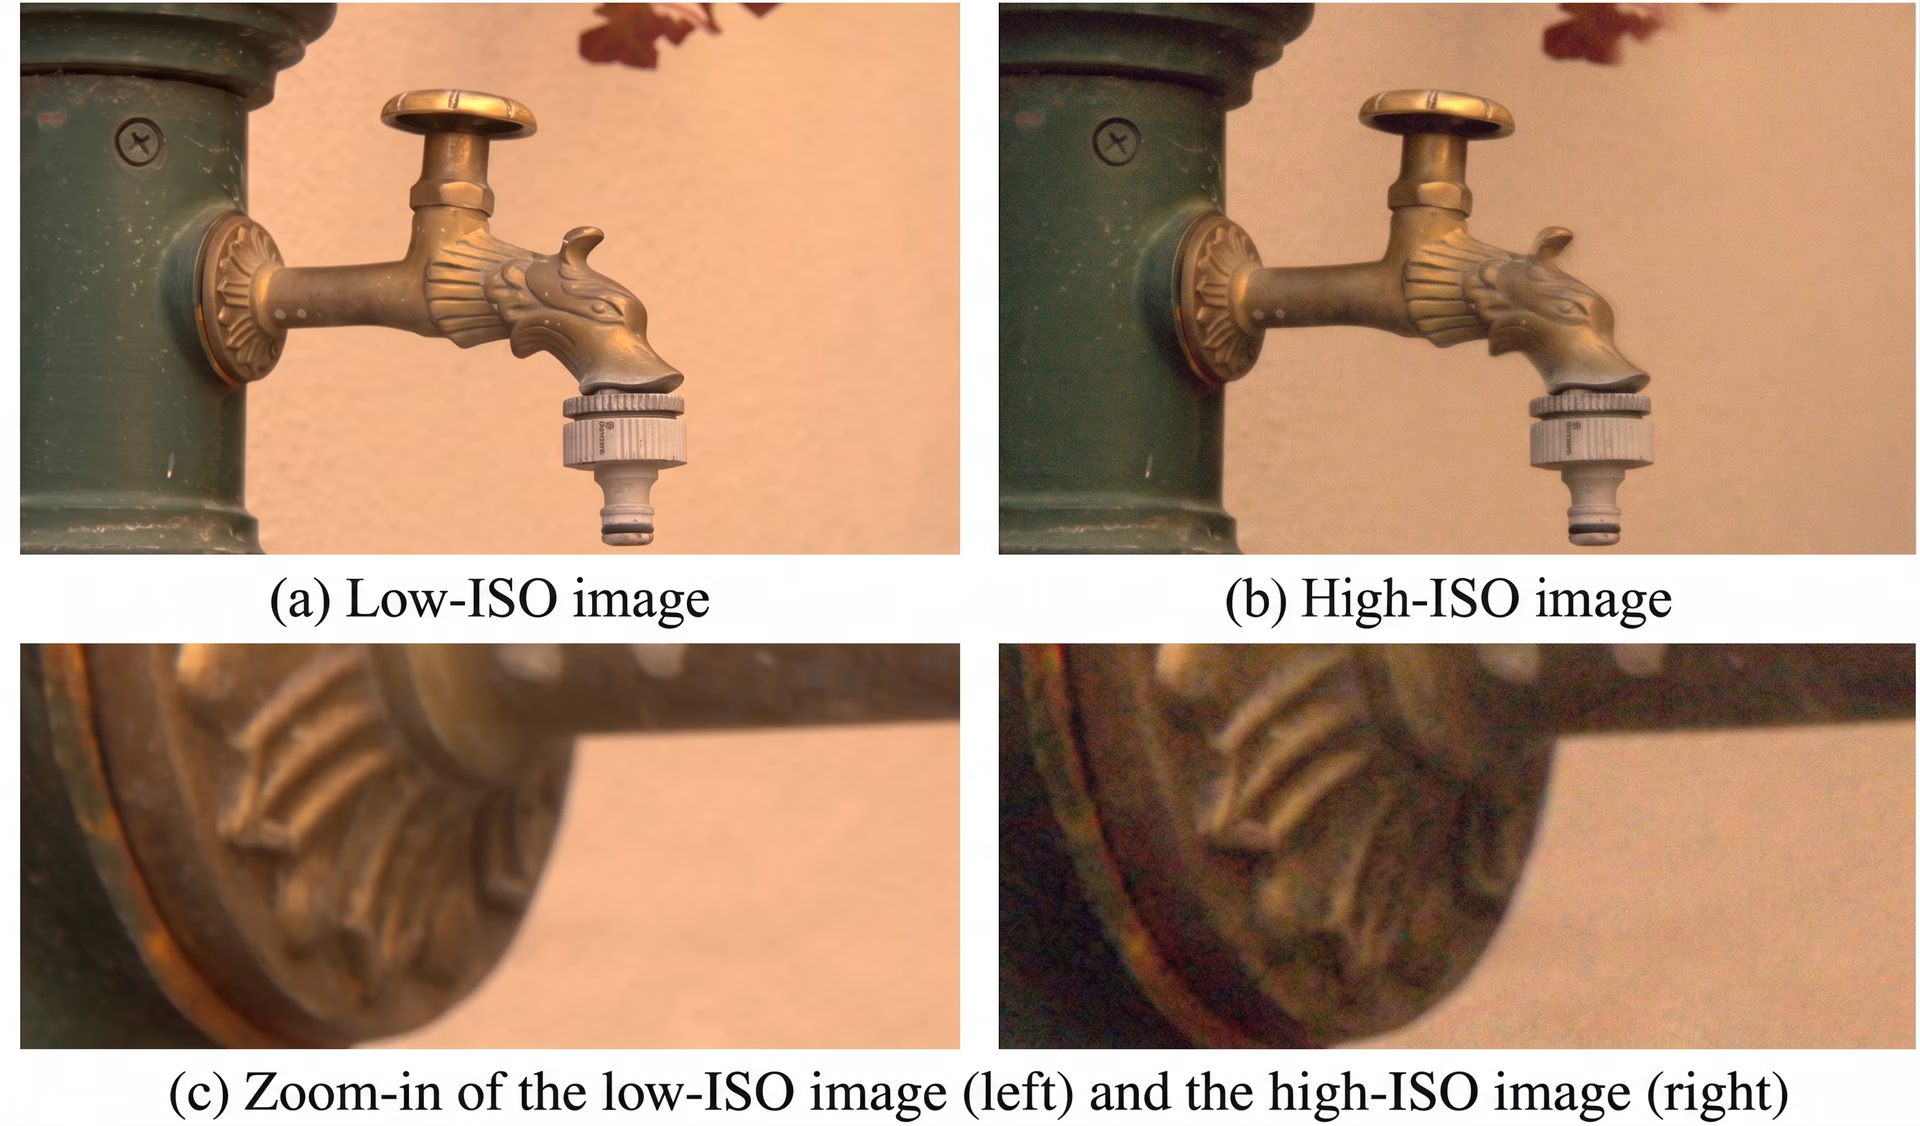
Fig. 4. Un esempio dal dataset DND. (Fonte)
Fattori da considerare quando si addestra un modello di rimozione del rumore autosupervisionato#
Ecco alcuni fattori e limiti da considerare se intendi addestrare un modello di rimozione del rumore autosupervisionato basato sul deep learning:
- Fai corrispondere la distribuzione del rumore: Le immagini rumorose utilizzate per l’addestramento dovrebbero riflettere il rumore che il modello incontrerà nell’uso reale; un rumore non corrispondente porta a una scarsa capacità di generalizzazione.
- Assicurati che i dati di addestramento siano diversificati: Una variazione limitata può causare overfitting o eccessiva levigatura nelle texture complesse.
- Tieni conto dei limiti legati al tipo di rumore: I metodi autosupervisionati faticano maggiormente con rumori strutturati, correlati o non casuali.
- Esegui test su dispositivi o sensori diversi: Le prestazioni di rimozione del rumore possono variare notevolmente tra fotocamere o sistemi di acquisizione delle immagini.
Punti chiave#
La rimozione del rumore autosupervisionata offre agli appassionati di AI un modo pratico per ripulire le immagini utilizzando solo i dati rumorosi già disponibili. Imparando a riconoscere la struttura reale sotto il rumore, questi metodi possono recuperare importanti dettagli visivi. Con il continuo miglioramento delle tecnologie di rimozione del rumore, è probabile che molte attività di computer vision diventino più affidabili nelle situazioni di tutti i giorni.
Entra a far parte della nostra community in crescita! Visita il nostro repository GitHub per saperne di più sull’AI. Se vuoi creare soluzioni di computer vision, dai un’occhiata alle nostre opzioni di licenza. Scopri i vantaggi della computer vision nel settore retail e come l’AI nel settore manifatturiero sta facendo la differenza!
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









