Guida all'architettura U-Net e alle sue applicazioni
Scopri l'architettura U-Net, come supporta la segmentazione delle immagini, quali sono le sue applicazioni e perché è importante nell'evoluzione della visione artificiale.
La computer vision è un ramo dell'intelligenza artificiale (AI) che si concentra sull'analisi dei dati visivi. Ha aperto la strada a molti sistemi all'avanguardia, come l'automazione dell'ispezione dei prodotti in fabbrica e il supporto alla navigazione stradale dei veicoli autonomi.
Uno dei compiti di computer vision più noti è il rilevamento degli oggetti. Questo compito consente ai modelli di localizzare e identificare gli oggetti in un'immagine usando riquadri di delimitazione. Sebbene i riquadri di delimitazione siano utili per varie applicazioni, forniscono solo una stima approssimativa della posizione di un oggetto.
Tuttavia, in ambiti come la sanità, dove la precisione è fondamentale, i casi d'uso dell'AI per la visione richiedono più della semplice identificazione di un oggetto. Spesso servono anche informazioni relative alla forma e alla posizione esatte degli oggetti.
È proprio a questo che serve il compito di computer vision chiamato segmentazione. Invece di usare riquadri di delimitazione, i modelli di segmentazione rilevano gli oggetti a livello di pixel. Nel corso degli anni, i ricercatori hanno sviluppato modelli di computer vision specializzati per la segmentazione.
Uno di questi modelli è U-Net. Sebbene le prestazioni dei modelli più recenti e avanzati abbiano superato le sue, U-Net occupa un posto importante nella storia della computer vision. In questo articolo esamineremo più da vicino l'architettura U-Net, il suo funzionamento, i suoi ambiti di utilizzo e il confronto con i modelli di segmentazione più moderni oggi disponibili.
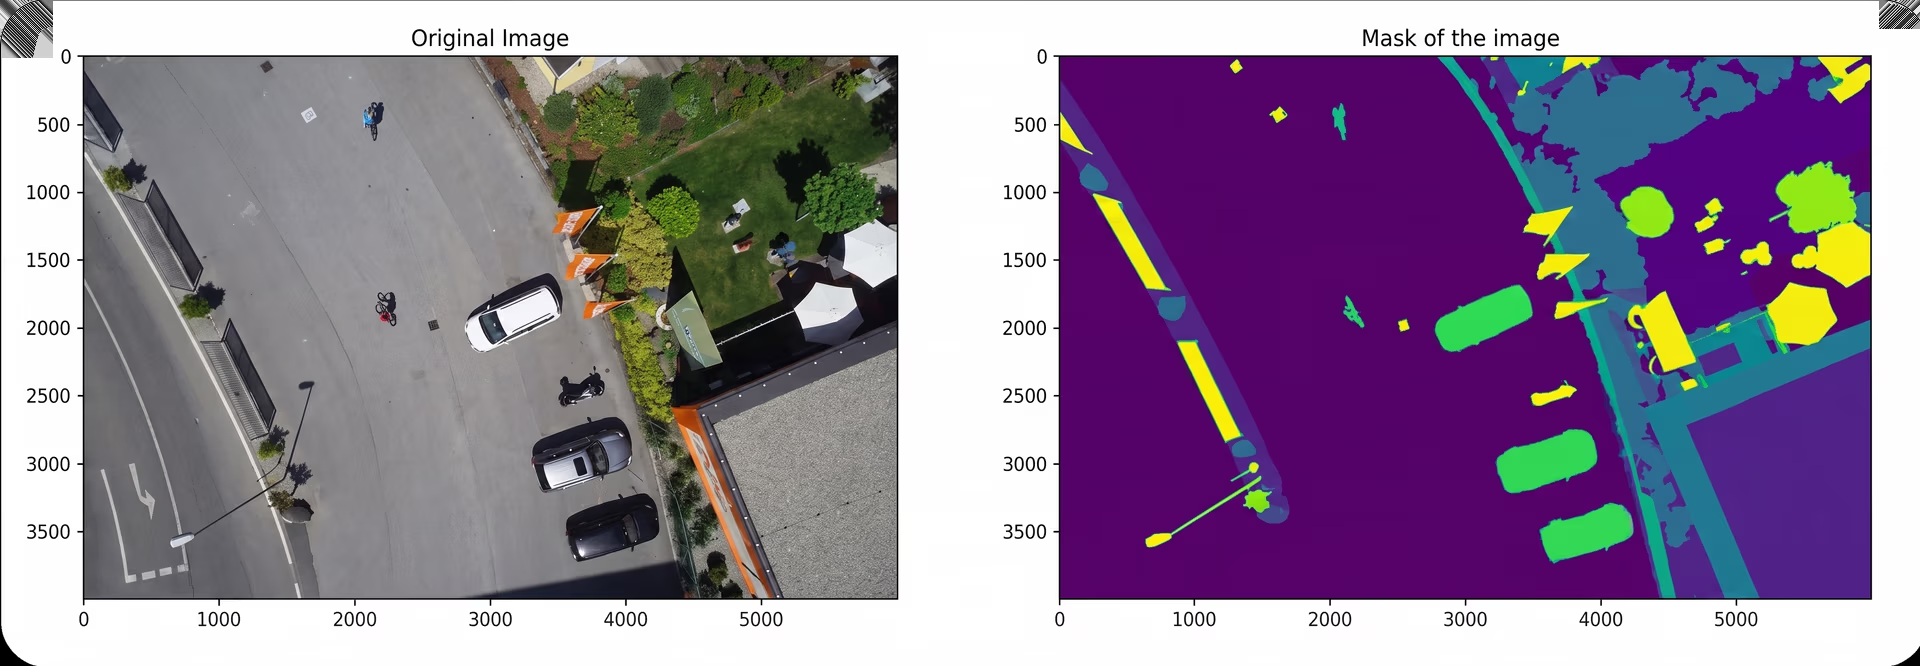
Fig. 1. Un esempio di segmentazione con il modello di deep learning U-Net. (Fonte)
La storia della segmentazione delle immagini#
Prima di approfondire cos'è U-Net, vediamo come si sono evoluti i modelli di segmentazione delle immagini.
Inizialmente, la computer vision si basava su tecniche tradizionali come il rilevamento dei bordi, la sogliatura o la crescita delle regioni per separare gli oggetti in un'immagine. Queste tecniche servivano a rilevare i contorni degli oggetti usando i bordi, separare le regioni in base all'intensità dei pixel e raggruppare i pixel simili. Funzionavano nei casi semplici, ma spesso non erano efficaci con immagini contenenti rumore, forme sovrapposte o contorni poco chiari.
Dopo l'affermazione del deep learning nel 2012, nel 2014 i ricercatori introdussero il concetto di reti completamente convoluzionali (FCNs) per compiti come la segmentazione semantica. Questi modelli sostituivano alcune parti di una rete convoluzionale per consentire al computer di analizzare un'intera immagine in una volta sola, invece di suddividerla in parti più piccole. In questo modo il modello ha potuto creare mappe dettagliate che mostrano con maggiore chiarezza il contenuto di un'immagine.
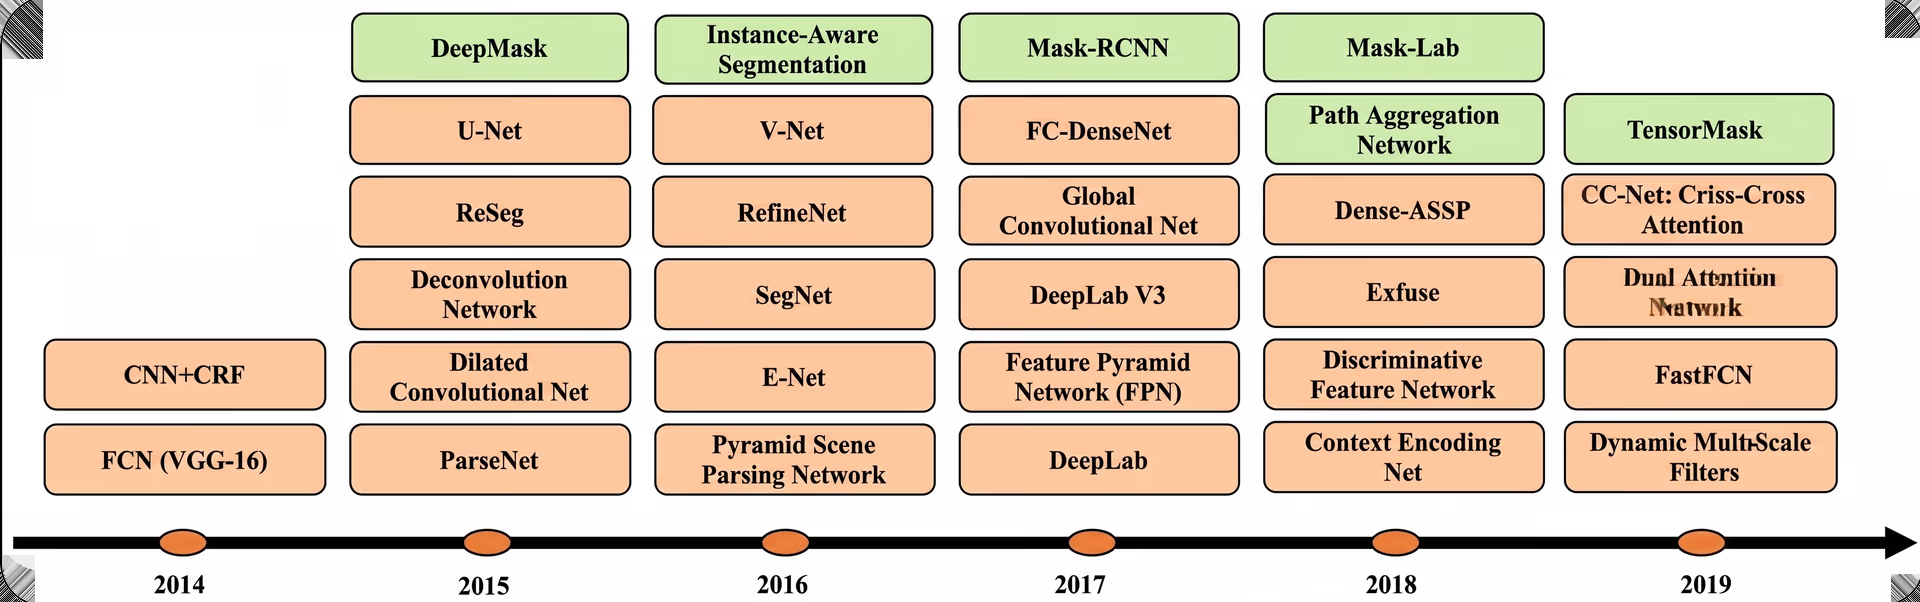
Fig. 2. L'evoluzione degli algoritmi di segmentazione basati sul deep learning. (Fonte)
Sulla base delle FCNs, nel 2015 i ricercatori dell'Università di Friburgo introdussero U-Net. In origine, era progettato per la segmentazione di immagini biomediche. In particolare, U-Net è stato progettato per funzionare bene anche quando i dati annotati sono limitati.
Nel frattempo, versioni successive come UNet++ e TransUNet hanno introdotto miglioramenti come i livelli di attenzione e una migliore estrazione delle caratteristiche. I livelli di attenzione aiutano il modello a concentrarsi sulle regioni chiave, mentre l'estrazione delle caratteristiche potenziata acquisisce informazioni più dettagliate.
Che cos'è U-Net e come fluiscono le caratteristiche nel modello?#
U-Net è un modello di deep learning progettato specificamente per la segmentazione delle immagini. Riceve un'immagine in ingresso e produce una maschera di segmentazione che classifica ogni pixel in base all'oggetto o alla regione a cui appartiene.
Il modello prende il nome dalla sua architettura a forma di U. È composto da due parti principali: un encoder che comprime l'immagine e ne apprende le caratteristiche e un decoder che la riporta alle dimensioni originali. Questa struttura crea una forma a U simmetrica, che aiuta il modello a comprendere sia la struttura complessiva dell'immagine sia i dettagli più fini.
Una caratteristica fondamentale di U-Net è l'uso di connessioni skip, che permettono di trasferire direttamente al decoder le informazioni provenienti dall'encoder. In questo modo il modello può preservare dettagli importanti che potrebbero andare persi durante la compressione dell'immagine.
Panoramica dell'architettura U-Net#
Ecco una panoramica del funzionamento dell'architettura U-Net:
- Immagine in ingresso: U-Net parte da un'immagine 2D, come una scansione medica o una foto satellitare. L'obiettivo è assegnare un'etichetta di classe a ogni pixel dell'immagine.
- Sottocampionamento: l'immagine attraversa livelli convoluzionali che apprendono caratteristiche visive importanti. Man mano che passa attraverso i diversi livelli, la sua risoluzione diminuisce e il modello individua schemi più ampi.
- Livello collo di bottiglia: al centro della rete, le mappe delle caratteristiche raggiungono la risoluzione spaziale minima e acquisiscono caratteristiche semantiche di alto livello. In parole semplici, questa rappresentazione compressa delle mappe delle caratteristiche costituisce il contesto complessivo dell'input.
- Sovracampionamento: la rete ricostruisce quindi l'immagine aumentando gradualmente la risoluzione. Le convoluzioni trasposte aiutano a riportare le mappe delle caratteristiche verso le dimensioni originali.
- Connessioni skip: le mappe delle caratteristiche del percorso di sottocampionamento vengono concatenate con quelle del percorso di sovracampionamento. Questo aiuta a preservare i dettagli spaziali più fini integrando al contempo le informazioni contestuali di alto livello.
- L'output è una mappa di segmentazione: l'output finale è una maschera di segmentazione pixel per pixel delle stesse dimensioni dell'input. Ogni pixel viene classificato in una categoria, come oggetto, sfondo o regione di interesse.
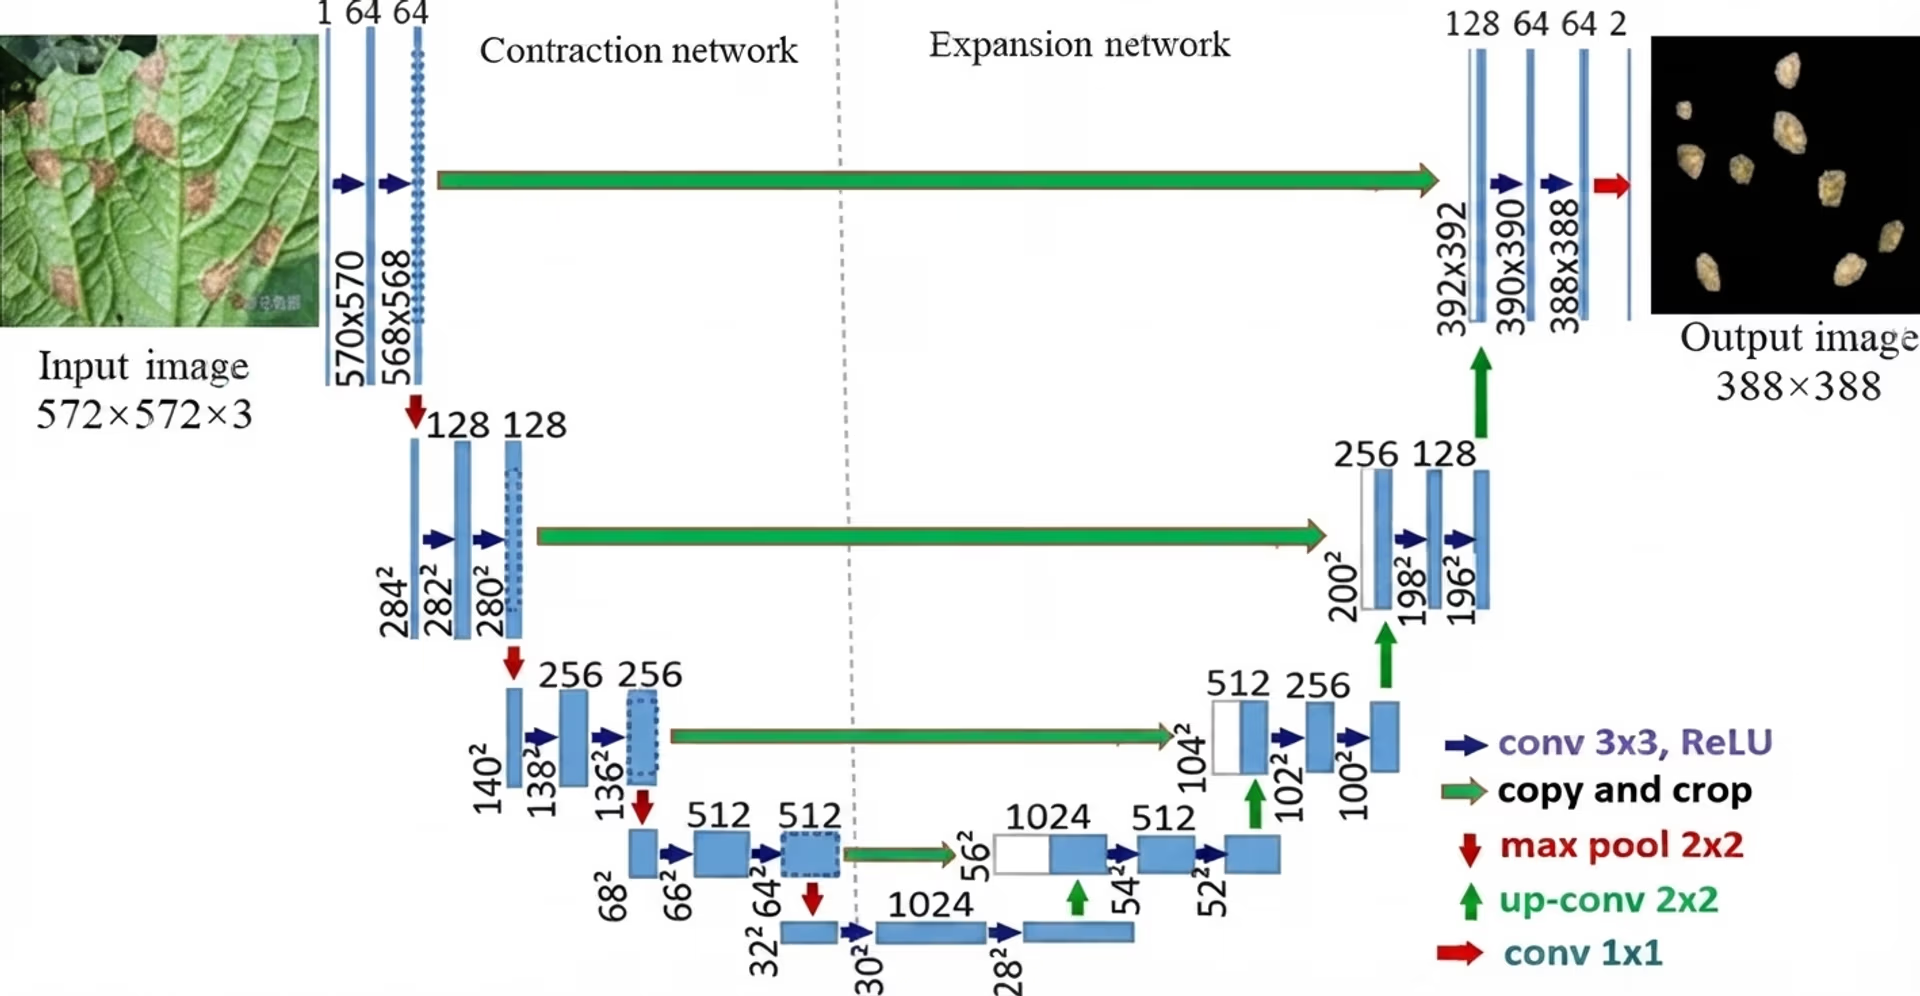
Fig. 3. Diagramma dell'architettura U-Net. (Fonte)
Capire la differenza tra ViT e U-Net#
Approfondendo U-Net, potresti chiederti in che cosa differisce da altri modelli di deep learning, come il Transformer della visione (ViT), che può eseguire anch'esso compiti di segmentazione. Sebbene entrambi i modelli possano svolgere compiti simili, differiscono per struttura e modalità di gestione della segmentazione.
U-Net elabora le immagini a livello di pixel attraverso livelli convoluzionali organizzati in una struttura encoder-decoder. Viene spesso usato per compiti che richiedono una segmentazione precisa, come le scansioni mediche o le scene di guida autonoma.
Il Transformer della visione (ViT), invece, suddivide le immagini in patch e le elabora simultaneamente tramite meccanismi di attenzione. Usa la self-attention (un meccanismo che consente al modello di ponderare l'importanza delle diverse parti dell'immagine rispetto alle altre) per cogliere le relazioni tra le varie parti dell'immagine, a differenza dell'approccio convoluzionale di U-Net.
Un'altra differenza importante è che in genere ViT ha bisogno di più dati per funzionare bene, ma è particolarmente efficace nell'individuare schemi complessi. U-Net, invece, funziona bene con dataset più piccoli, è più rapido da addestrare e spesso richiede meno tempo di addestramento.
Applicazioni del modello U-Net#
Ora che abbiamo capito meglio che cos'è U-Net e come funziona, vediamo come è stato applicato in diversi ambiti.
Segmentazione delle emorragie cerebrali nell'imaging medico#
U-Net è diventato un metodo affidabile per la segmentazione a livello di pixel di immagini mediche complesse, soprattutto nel periodo di massimo interesse nella ricerca. I ricercatori lo hanno usato per evidenziare aree chiave nelle scansioni mediche, come i tumori e i segni di emorragia interna nelle immagini TC e RM. Questo approccio ha migliorato notevolmente la precisione delle diagnosi e semplificato l'analisi di dati medici complessi negli ambienti di ricerca.
Un esempio dell'impatto di U-Net nella ricerca sanitaria è il suo impiego per individuare ictus ed emorragie cerebrali nelle scansioni mediche. I ricercatori potevano usare U-Net per analizzare le scansioni della testa ed evidenziare le aree critiche, consentendo di identificare più rapidamente i casi che richiedevano un intervento immediato.
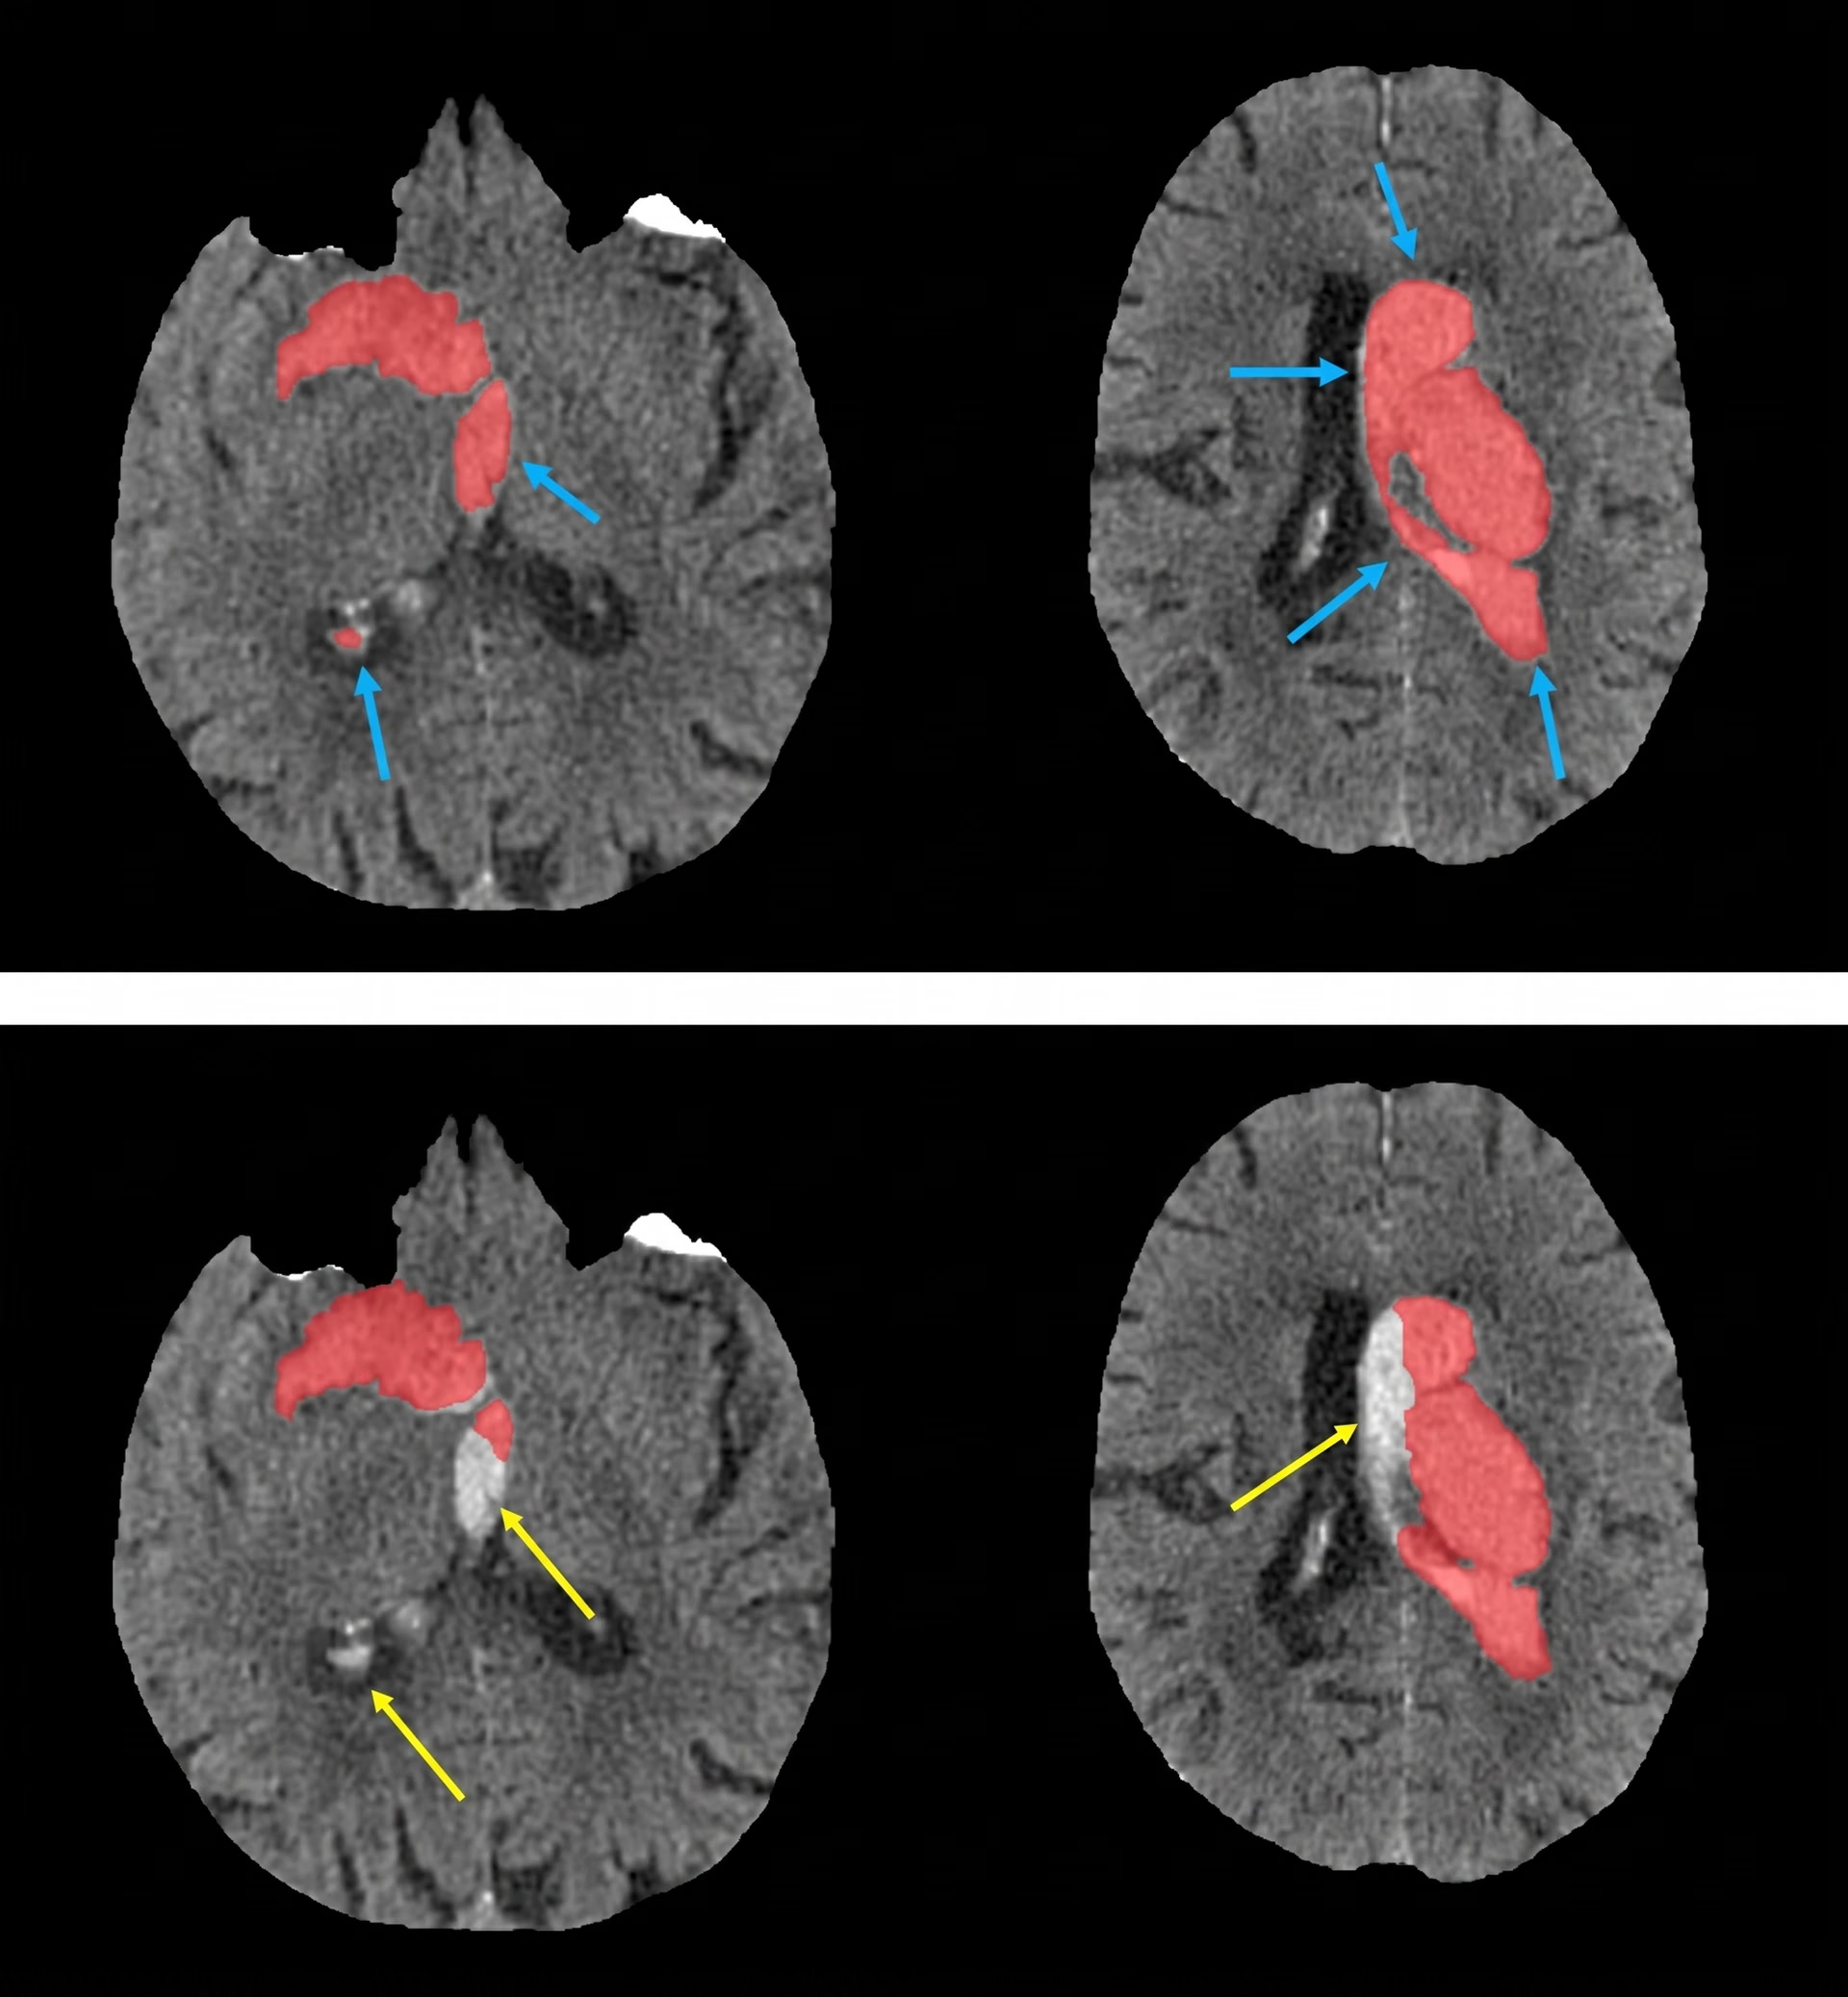
Fig. 4. Segmentazione di lesioni da ictus emorragico con 3D U-Net. (Fonte)
Segmentazione delle colture in agricoltura#
Un altro ambito in cui i ricercatori hanno usato U-Net è l'agricoltura, in particolare per segmentare colture, erbe infestanti e terreno. Aiuta gli agricoltori a monitorare la salute delle piante, stimare i raccolti e prendere decisioni migliori nelle aziende agricole di grandi dimensioni. Per esempio, U-Net può separare le colture dalle erbe infestanti, rendendo più efficiente l'applicazione degli erbicidi e riducendo gli sprechi.
Per affrontare sfide come la sfocatura da movimento nelle immagini riprese con i droni, i ricercatori hanno migliorato U-Net con tecniche di deblur delle immagini. Questo consente di ottenere segmentazioni più nitide anche quando i dati vengono raccolti in movimento, per esempio durante i rilievi aerei.
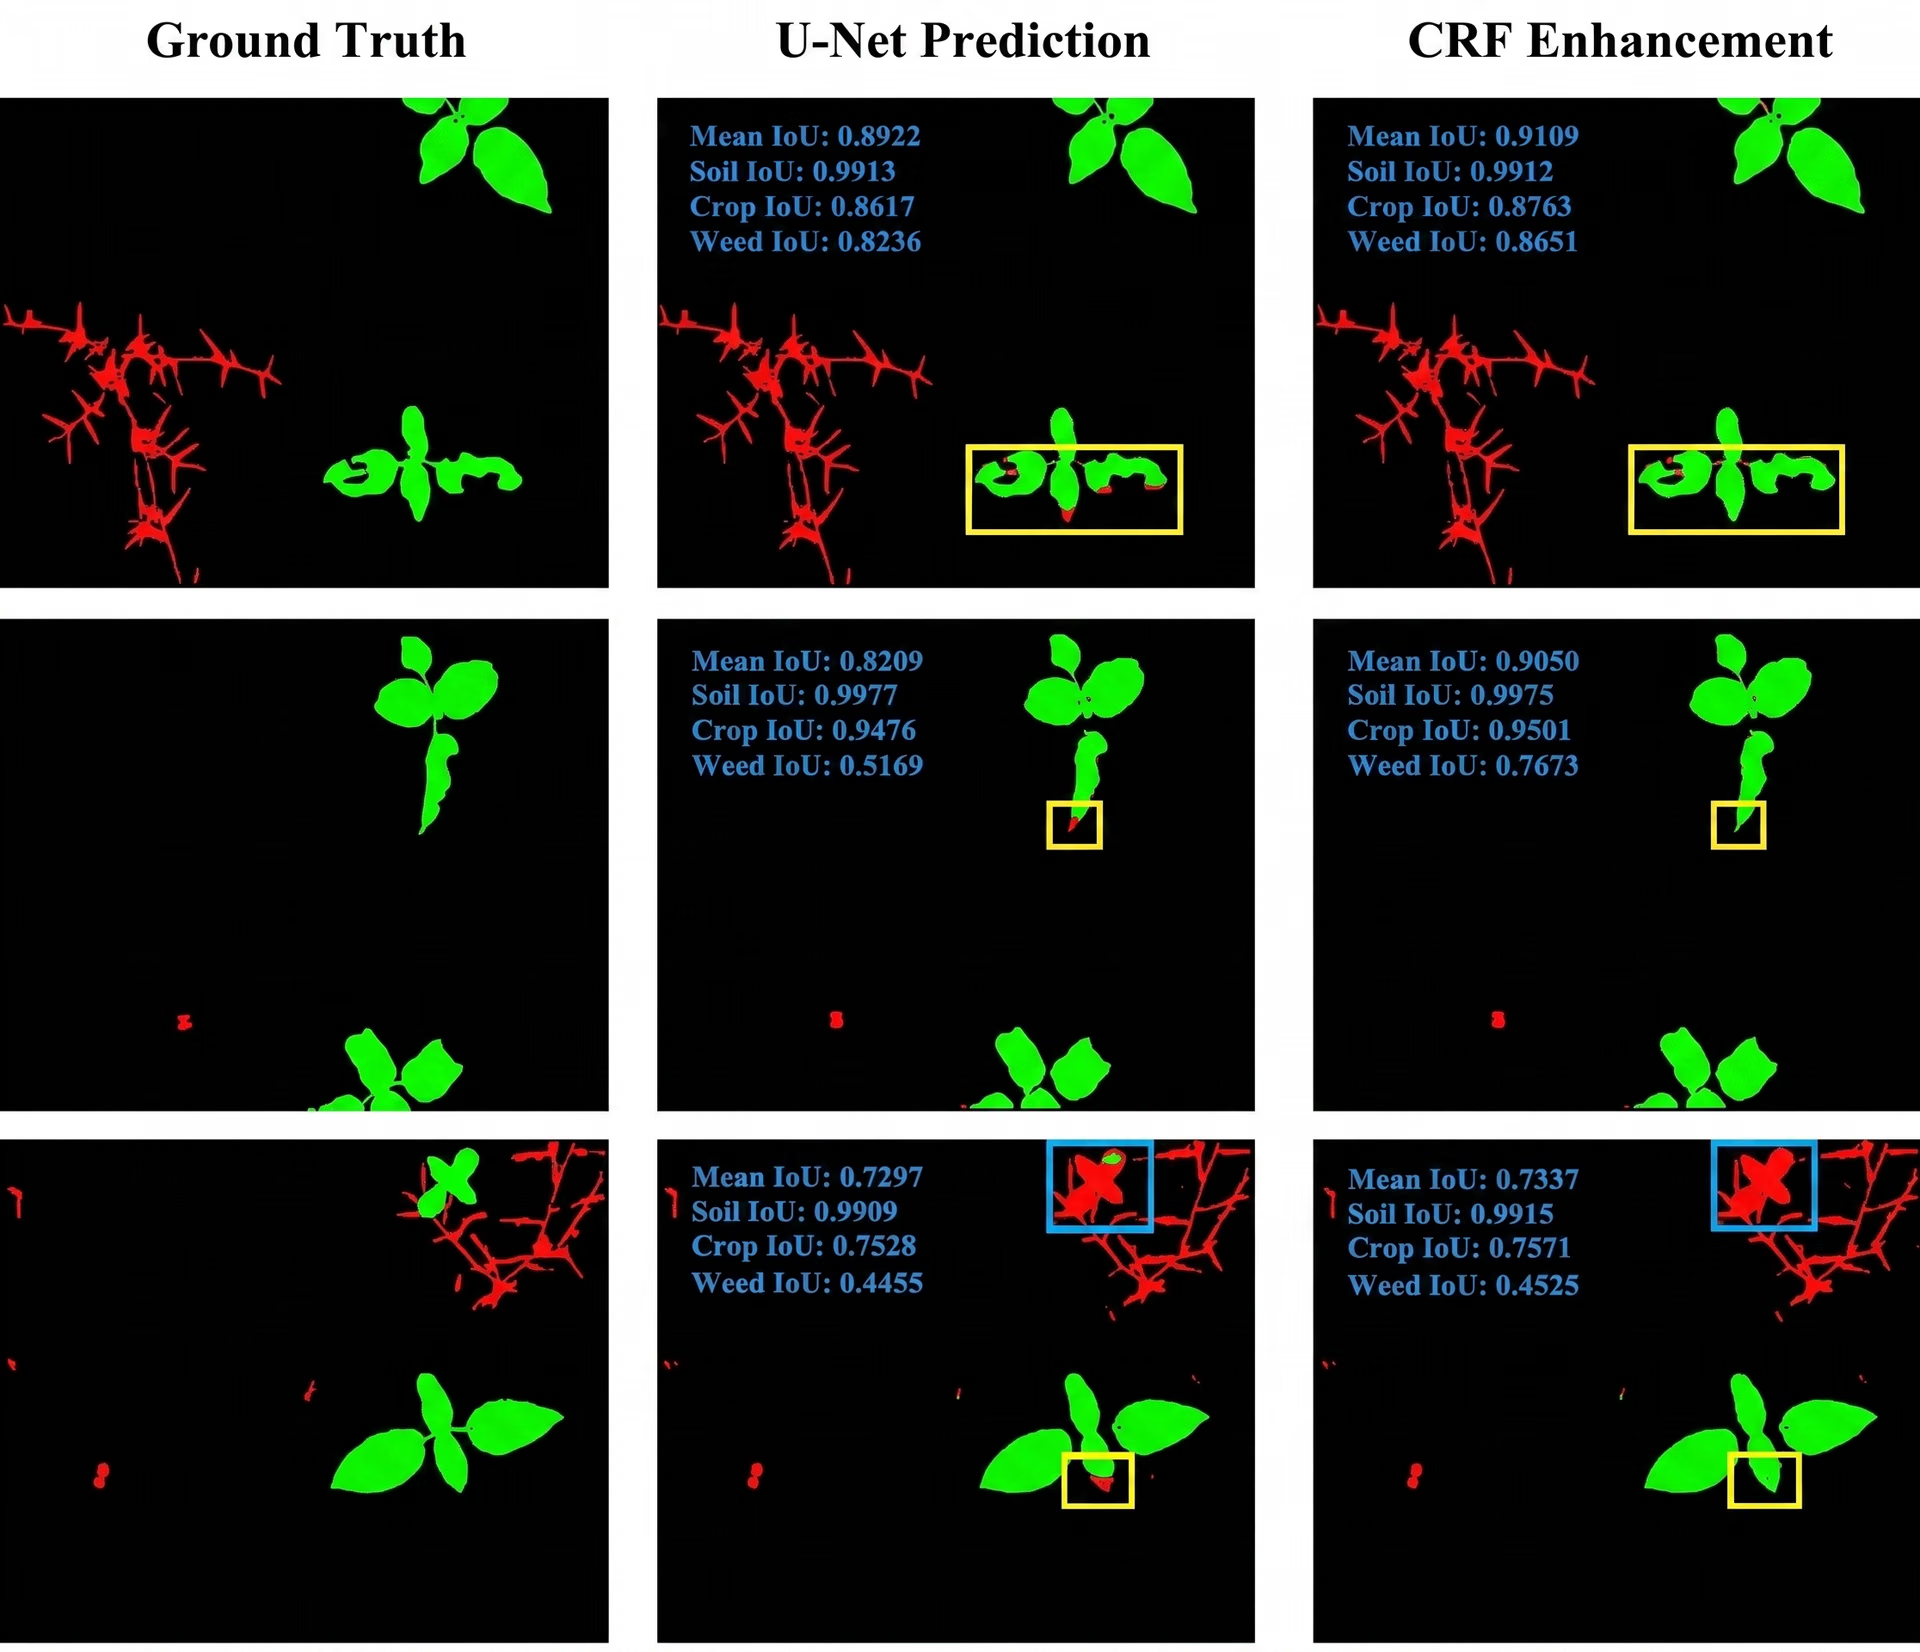
Fig. 5. Separazione delle colture dalle erbe infestanti nei campi agricoli con U-Net. (Fonte)
Guida autonoma#
Prima dell'introduzione di modelli di AI più avanzati, U-Net ha svolto un ruolo fondamentale nell'esplorare come la segmentazione potesse migliorare la guida autonoma. Nei veicoli autonomi, la segmentazione semantica di U-Net può classificare ogni pixel di un'immagine in categorie come strada, veicolo, pedone e segnaletica orizzontale. Questo offre all'auto una visione chiara di ciò che la circonda, favorendo una navigazione sicura e decisioni efficaci.
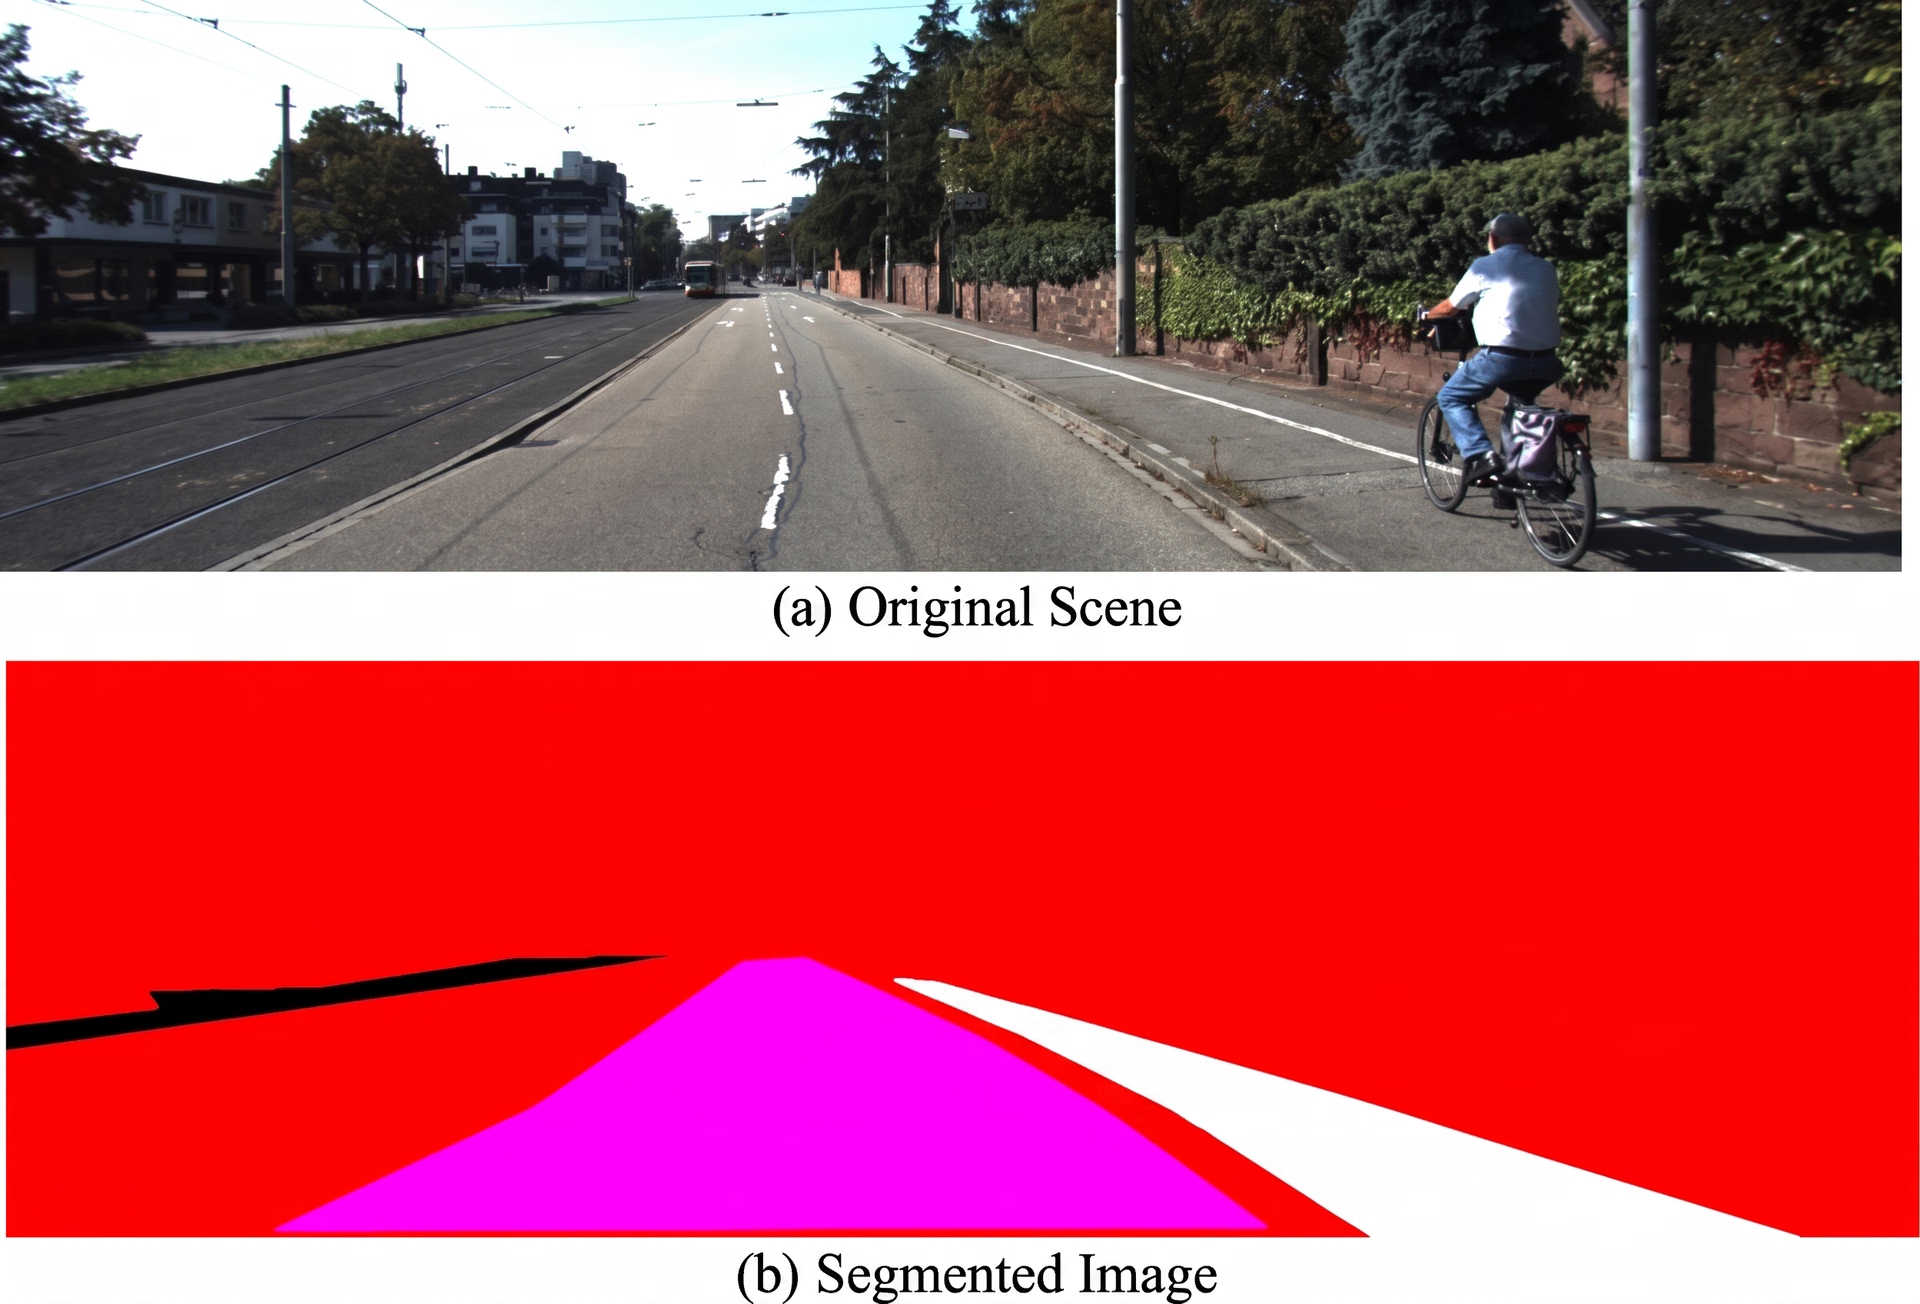
Fig. 6. Scena stradale in cui l'area percorribile è segmentata tramite U-Net. (Fonte)
Pro e contro di U-Net#
Ancora oggi, U-Net resta una valida scelta per la segmentazione delle immagini tra i ricercatori, grazie al suo equilibrio tra semplicità, precisione e adattabilità. Ecco alcuni dei principali vantaggi che lo contraddistinguono:
- Adattabile a diverse modalità: U-Net è stato adattato a diversi tipi di dati, tra cui scansioni mediche 3D, immagini satellitari e persino fotogrammi video.
- Inferenza rapida se ottimizzato: se configurato correttamente, U-Net può funzionare in modo efficiente, risultando adatto ad applicazioni in tempo reale o quasi.
- Open source e community: U-Net è disponibile nelle principali librerie di deep learning ed è supportato da una vasta community di sviluppatori e ricercatori.
U-Net ha molti punti di forza, ma presenta anche alcuni limiti da tenere in considerazione. Ecco alcuni fattori da valutare:
- Sensibile alla qualità dei dati: le prestazioni di U-Net possono risentire negativamente di dati di scarsa qualità, come immagini rumorose o a bassa risoluzione.
- Soggetto all'overfitting con dataset piccoli: sebbene U-Net funzioni bene con dati limitati, rischia comunque di incorrere nell'overfitting se non viene regolarizzato correttamente, soprattutto quando il dataset è troppo piccolo o poco vario.
- Risorse di calcolo: U-Net può richiedere notevoli risorse di calcolo, soprattutto quando si lavora con dataset di grandi dimensioni, e necessita di hardware potente per l'addestramento.
Punti chiave#
U-Net è stata una tappa fondamentale nell'evoluzione della segmentazione delle immagini. Ha dimostrato che i modelli di deep learning possono offrire risultati precisi usando dataset più piccoli, soprattutto in ambiti come l'imaging medico.
Questa svolta ha aperto la strada ad applicazioni più avanzate in diversi campi. Con la continua evoluzione della computer vision, i modelli di segmentazione come U-Net restano fondamentali per consentire alle macchine di comprendere e interpretare i dati visivi con grande precisione.
Vuoi realizzare i tuoi progetti di computer vision? Esplora il nostro repository GitHub per approfondire l'AI e scopri le nostre opzioni di licenza. Scopri come la computer vision in ambito sanitario migliora l'efficienza e approfondisci l'impatto dell'AI nel commercio al dettaglio visitando le nostre pagine dedicate alle soluzioni! Unisciti subito alla nostra community in crescita!









