Modelli OCR open source diffusi e come funzionano
Scopri insieme a noi i modelli OCR più diffusi, come convertono le immagini in testo e quale ruolo svolgono nelle applicazioni di AI e visione artificiale.
Per una panoramica visiva dei concetti trattati in questo articolo, guarda il video qui sotto.
Molte aziende e sistemi digitali si basano sulle informazioni contenute nei documenti, come fatture scansionate, carte d'identità o moduli compilati a mano. Tuttavia, quando queste informazioni sono memorizzate come immagini, per i computer è difficile cercarle, estrarle o utilizzarle per varie attività.
Tuttavia, grazie a strumenti come la visione artificiale, un ambito dell'IA che consente alle macchine di interpretare e comprendere le informazioni visive, trasformare le immagini in testo è diventato molto più semplice. In particolare, il riconoscimento ottico dei caratteri (OCR) è una tecnologia di visione artificiale che può essere usata per rilevare ed estrarre il testo.
I modelli OCR vengono addestrati a riconoscere testi in diversi formati e a convertirli in dati modificabili e consultabili. Sono ampiamente utilizzati nell'automazione dei documenti, nella verifica dell'identità e nei sistemi di scansione in tempo reale.
In questo articolo vedremo come funzionano i modelli OCR, alcuni dei più diffusi modelli open source, i loro ambiti di utilizzo, le applicazioni più comuni e gli aspetti principali da considerare per l'uso nel mondo reale.
Che cos'è l'OCR?#
I modelli OCR sono progettati per aiutare le macchine a leggere il testo da fonti visive, in modo simile a come leggiamo testi stampati o scritti a mano. Questi modelli ricevono input come documenti scansionati, immagini o foto di appunti scritti a mano e li trasformano in testo digitale che può essere cercato, modificato o utilizzato nei sistemi software.
Mentre i primi sistemi OCR seguivano modelli rigidi, i modelli OCR moderni usano il deep learning per riconoscere il testo. Riconoscono facilmente diversi tipi di caratteri, lingue e persino grafie difficili da leggere, gestendo anche immagini di bassa qualità. Questi progressi hanno reso i modelli OCR fondamentali per l'automazione nei settori in cui si elaborano grandi quantità di testo, come finanza, sanità, logistica e servizi governativi.
I modelli OCR funzionano bene con immagini in cui il testo è chiaro e strutturato, ma possono incontrare difficoltà quando il testo è affiancato da elementi visivi complessi o compare all'interno di scene dinamiche. In questi casi, è possibile affiancare ai modelli OCR modelli di visione artificiale come Ultralytics YOLO11.
Ultralytics YOLO11 può rilevare oggetti specifici in un'immagine, come cartelli, documenti o etichette, aiutando a individuare le aree di testo prima di usare l'OCR per estrarre il contenuto.
Ad esempio, nei veicoli autonomi, Ultralytics YOLO11 può rilevare un segnale di stop e l'OCR può poi leggerne il testo, consentendo al sistema di interpretare con precisione sia l'oggetto sia il suo significato.
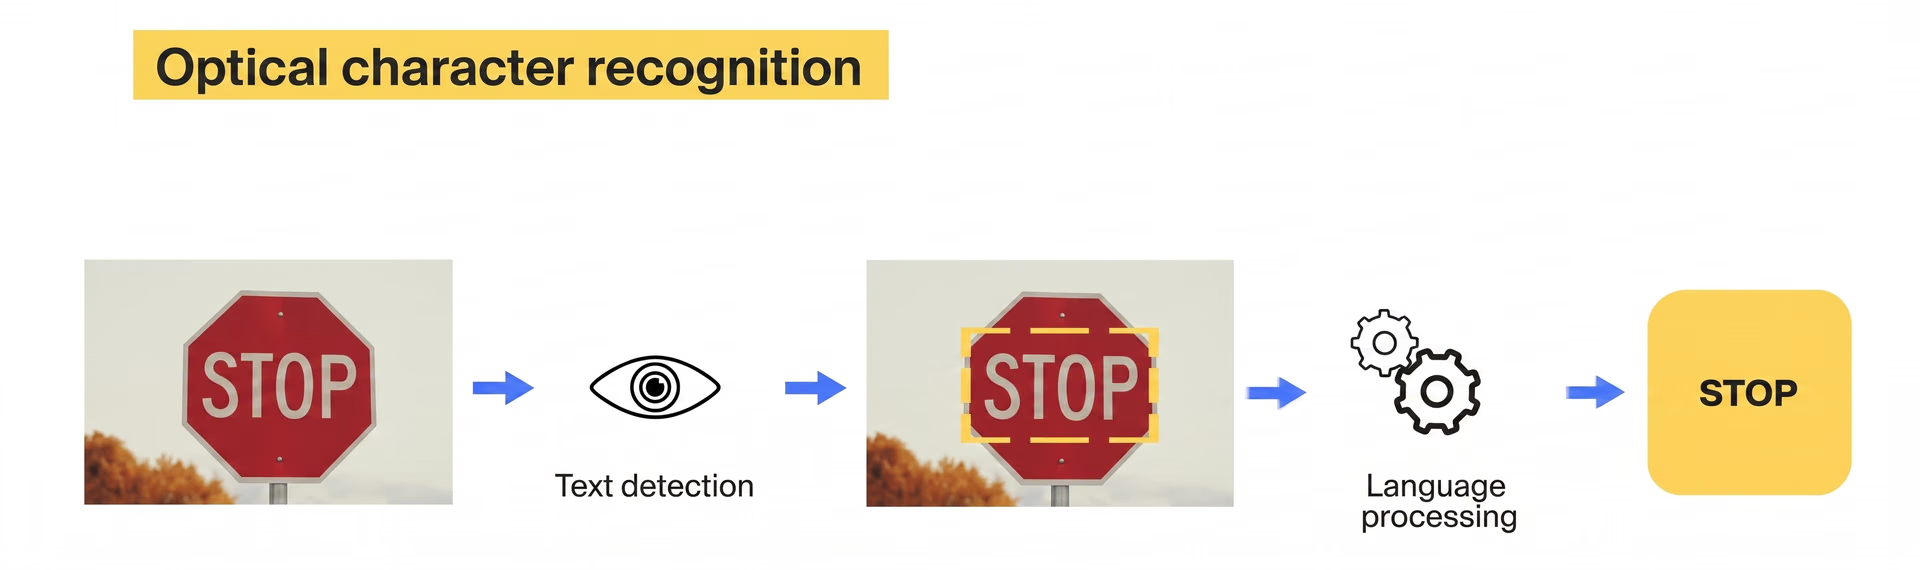
Fig. 1. Esempio di utilizzo dell'OCR (fonte).
Panoramica del funzionamento dei modelli OCR#
Ora che abbiamo visto che cos'è l'OCR, analizziamo più da vicino come funzionano i modelli OCR.
Prima di usare un modello OCR per leggere ed estrarre testo da un'immagine, di solito si eseguono due passaggi importanti: il pre-elaborazione e il rilevamento degli oggetti.
Per prima cosa, l'immagine viene ripulita e migliorata con la pre-elaborazione. Si applicano tecniche di base di elaborazione delle immagini, come la nitidezza, la riduzione del rumore e la regolazione di luminosità o contrasto, per migliorare la qualità complessiva dell'immagine e rendere il testo più facile da rilevare.
Successivamente, si utilizzano task di visione artificiale, come il rilevamento degli oggetti. In questa fase si individuano oggetti d'interesse specifici che contengono testo, ad esempio targhe, cartelli stradali, moduli o carte d'identità. Identificando questi oggetti, il sistema isola le aree che contengono testo significativo e le prepara al riconoscimento.
Solo dopo questi passaggi il modello OCR entra in funzione. Per prima cosa, prende le aree rilevate e le suddivide in parti più piccole, identificando singoli caratteri, parole o righe di testo.
Usando tecniche di deep learning, il modello analizza le forme, i motivi e la spaziatura delle lettere, li confronta con ciò che ha appreso durante l'addestramento e predice i caratteri più probabili. Ricompone quindi i caratteri riconosciuti in un testo coerente, pronto per ulteriori elaborazioni.
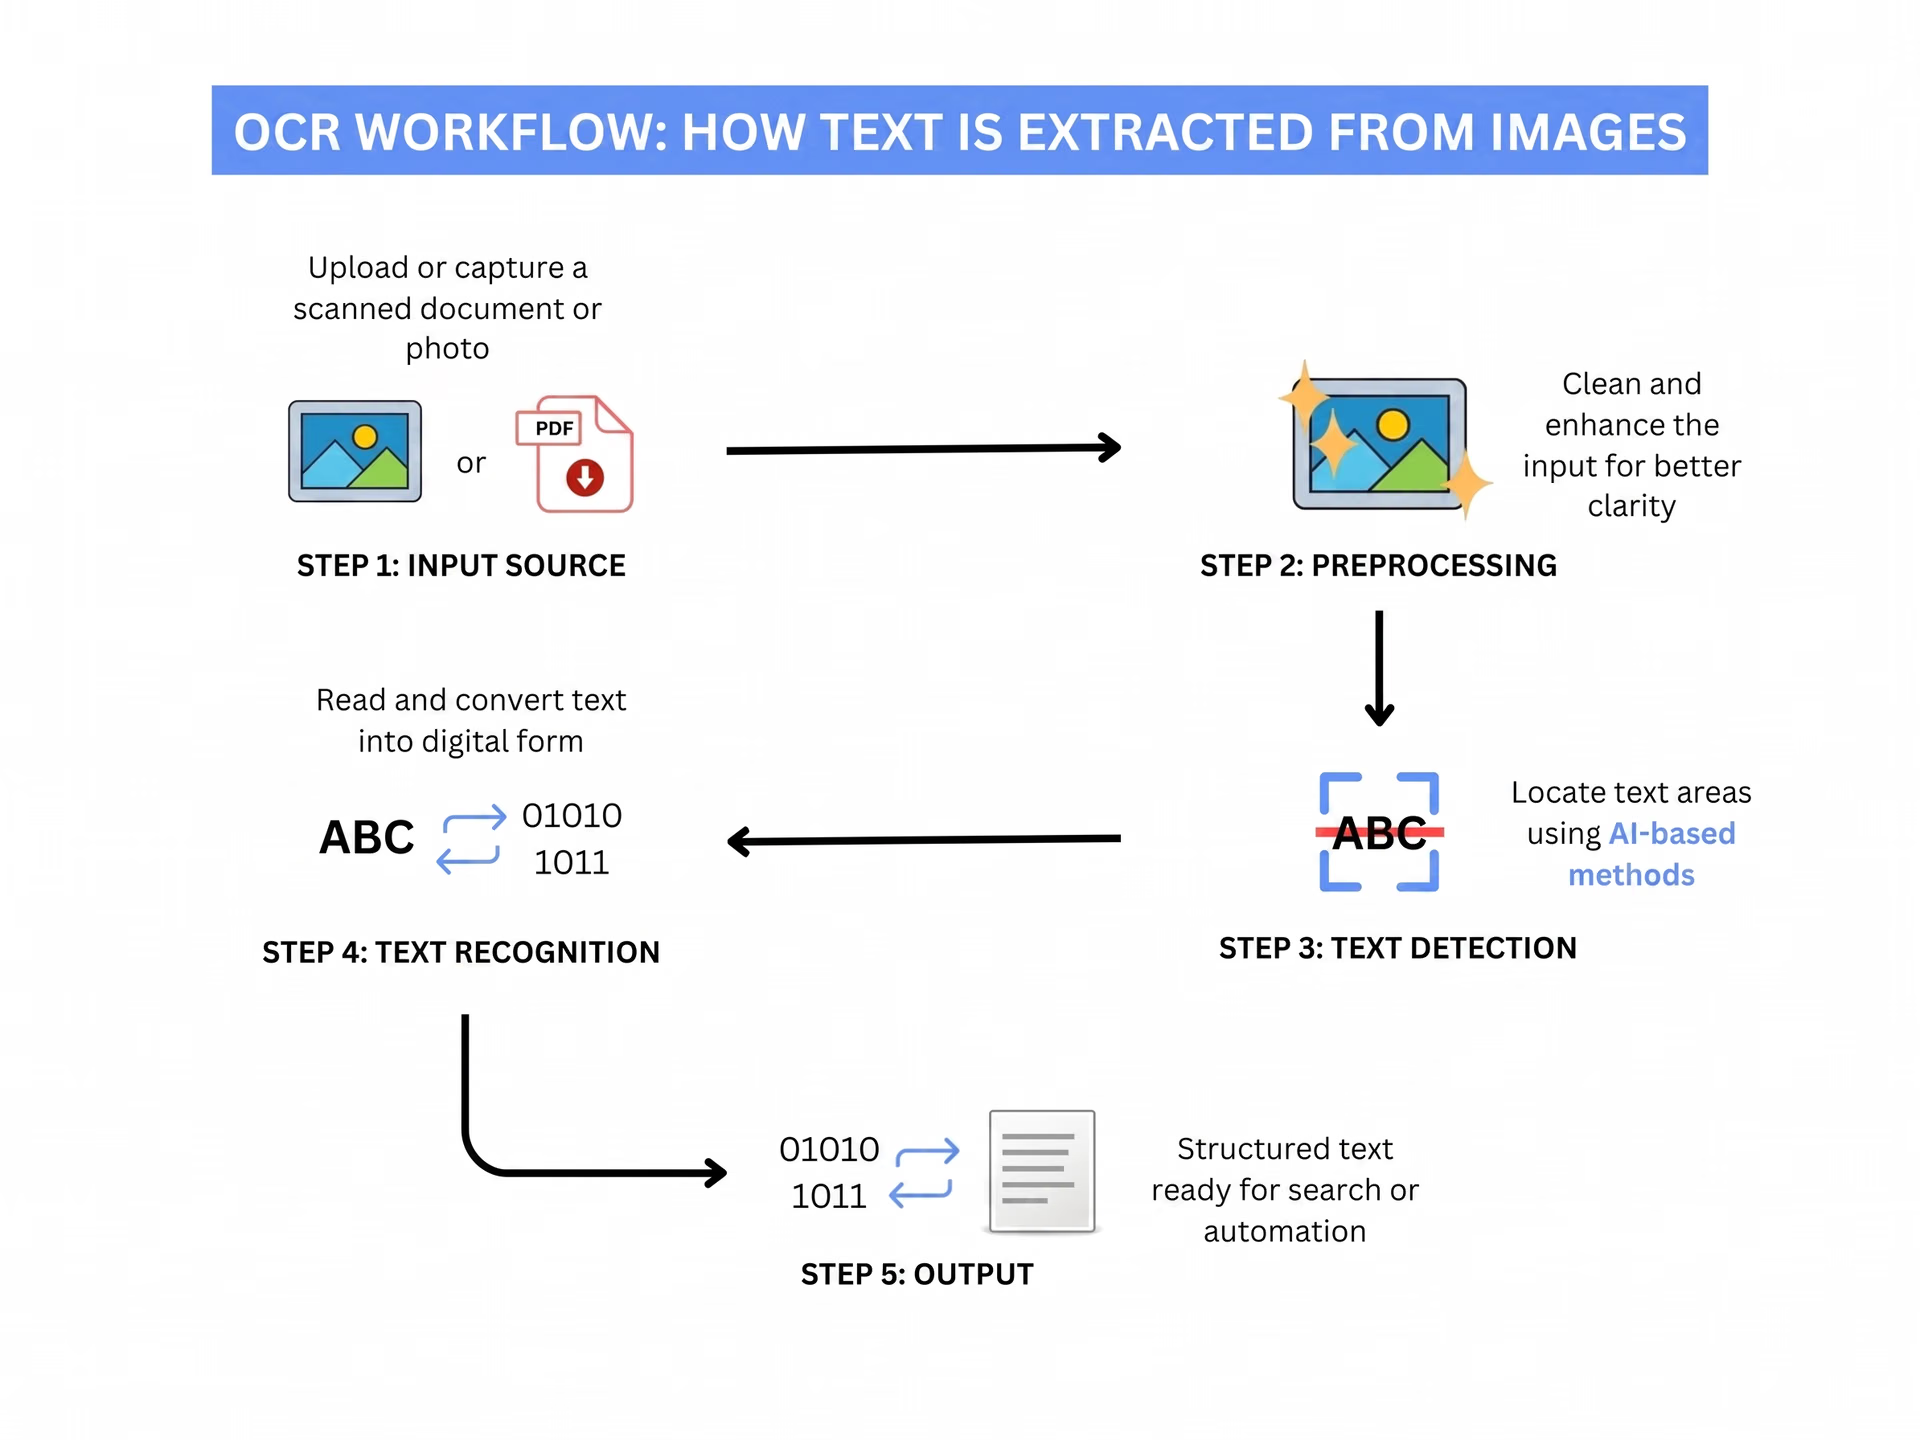
Fig. 2. Come funziona l'OCR. Immagine dell'autore.
Modelli OCR open source più diffusi#
Quando sviluppi un'applicazione di visione artificiale che prevede l'estrazione di testo, la scelta del modello OCR più adatto dipende da fattori come l'accuratezza, il supporto linguistico e la facilità di integrazione nei sistemi reali.
Oggi molti modelli open source offrono la flessibilità, il forte supporto della community e le prestazioni affidabili di cui gli sviluppatori hanno bisogno. Vediamo alcune delle opzioni più diffuse e le loro caratteristiche distintive.
Tesseract OCR#
Tesseract è uno dei modelli OCR open source più utilizzati oggi. È stato inizialmente sviluppato presso gli Hewlett-Packard Laboratories a Bristol, in Inghilterra, e a Greeley, in Colorado, tra il 1985 e il 1994. Nel 2005, HP ha rilasciato Tesseract come software open source e, dal 2006, Google ne cura la manutenzione, con contributi continui della community open source.
Una delle caratteristiche principali di Tesseract è la capacità di gestire oltre 100 lingue, che lo rende una scelta affidabile per i progetti multilingue. I continui miglioramenti ne hanno aumentato l'affidabilità nella lettura di testi stampati, soprattutto nei documenti strutturati come moduli e report.
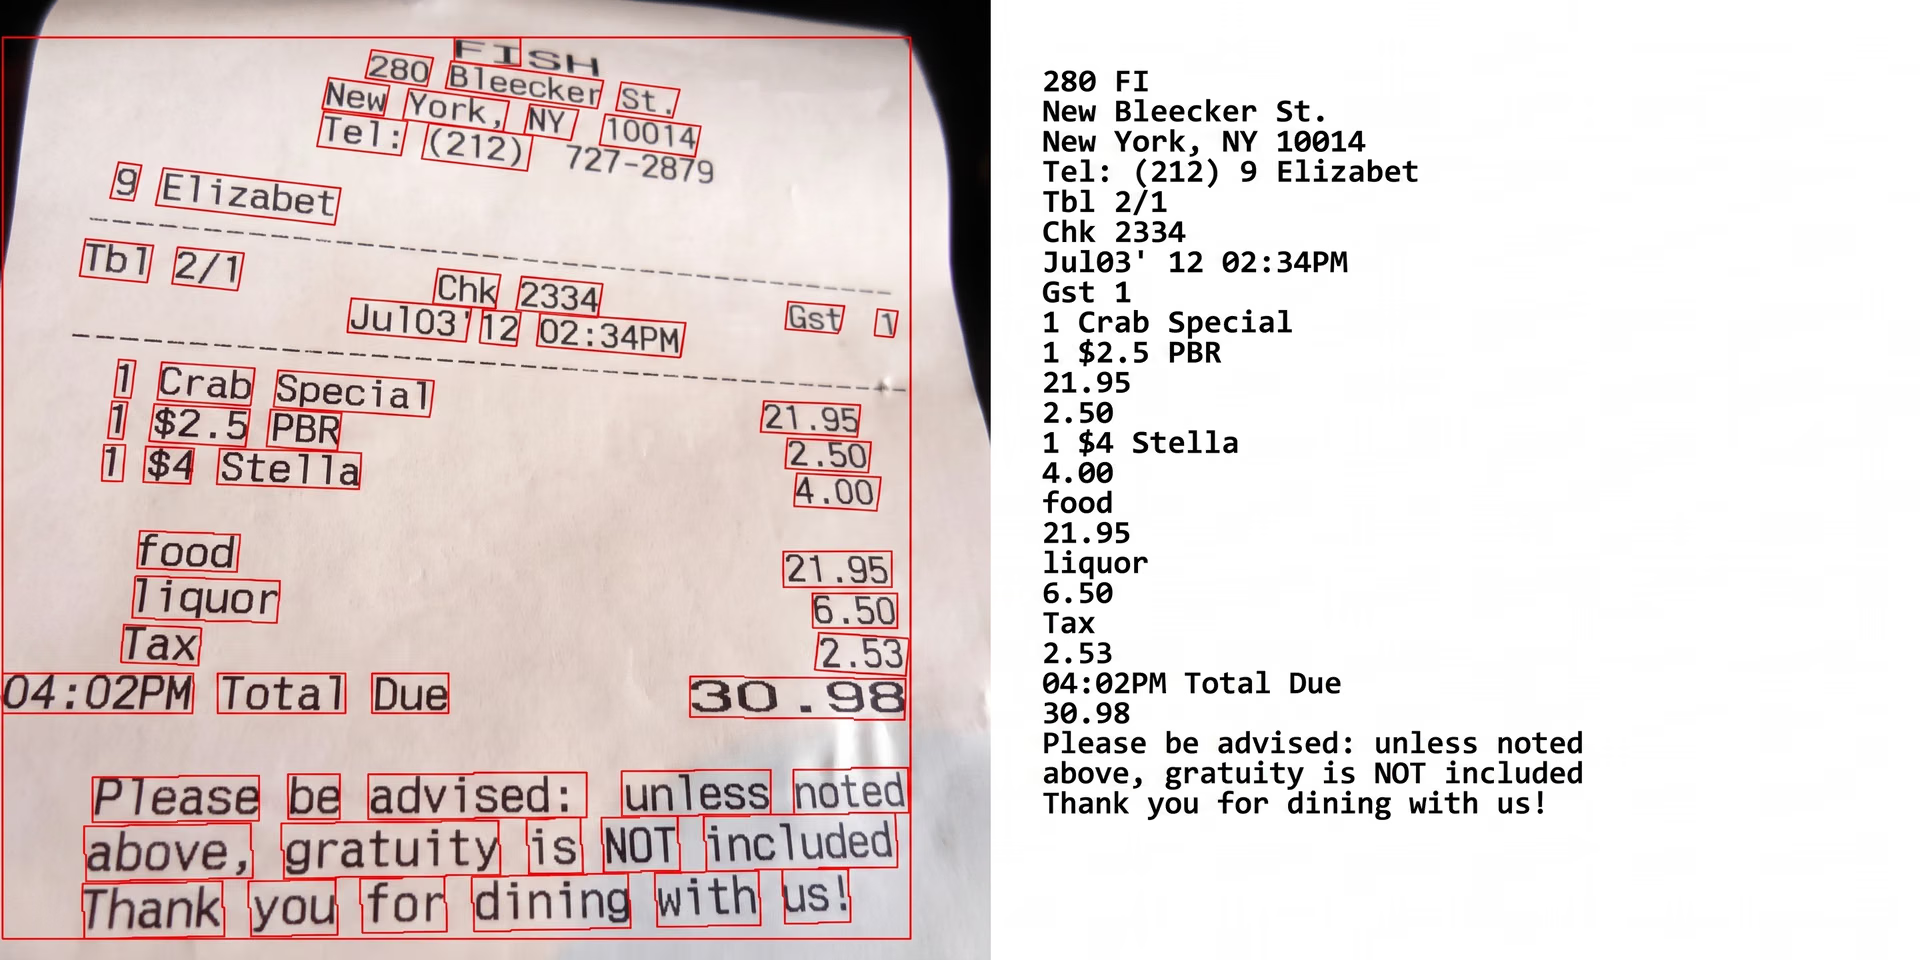
Fig. 3. Riconoscimento del testo con Tesseract OCR (fonte).
Tesseract viene comunemente utilizzato nei progetti che prevedono la scansione di fatture, l'archiviazione di documenti o l'estrazione di testo da documenti con layout standard. Offre i risultati migliori quando la qualità dei documenti è buona e il layout non varia in modo significativo.
EasyOCR#
Analogamente, EasyOCR è una libreria OCR open source basata su Python, sviluppata da Jaided AI. Supporta oltre 80 lingue, compresi gli alfabeti latino, cinese, arabo e cirillico, ed è quindi uno strumento versatile per il riconoscimento di testi multilingue.
Progettato per gestire sia testi stampati sia scritti a mano, EasyOCR funziona bene con documenti dal layout, carattere o struttura variabili. Questa flessibilità lo rende un'ottima scelta per estrarre testo da fonti diverse, come ricevute, cartelli stradali e moduli con contenuti in più lingue.
Basato su PyTorch, EasyOCR sfrutta tecniche di deep learning per rilevare e riconoscere il testo con precisione. Funziona in modo efficiente sia su CPU sia su GPU e può quindi adattarsi alle esigenze del task, che si tratti di elaborare alcune immagini in locale o grandi batch di file su sistemi più potenti.
Essendo uno strumento open source, EasyOCR beneficia di aggiornamenti regolari e miglioramenti guidati dalla community, che lo aiutano a restare aggiornato e ad adattarsi a un'ampia gamma di esigenze OCR del mondo reale.
PaddleOCR#
PaddleOCR è un toolkit OCR ad alte prestazioni sviluppato da Baidu, che combina il rilevamento e il riconoscimento del testo in un'unica pipeline ottimizzata. Supporta 80 lingue e può gestire documenti complessi come ricevute, tabelle e moduli.
PaddleOCR si distingue perché è basato sul framework di deep learning PaddlePaddle. Il framework PaddlePaddle è stato progettato per sviluppare e distribuire modelli di IA in modo semplice, affidabile e scalabile. Inoltre, PaddleOCR offre un'elevata accuratezza anche su immagini di bassa qualità o disordinate, il che lo rende una buona scelta per i task OCR del mondo reale in cui precisione e affidabilità sono fondamentali.
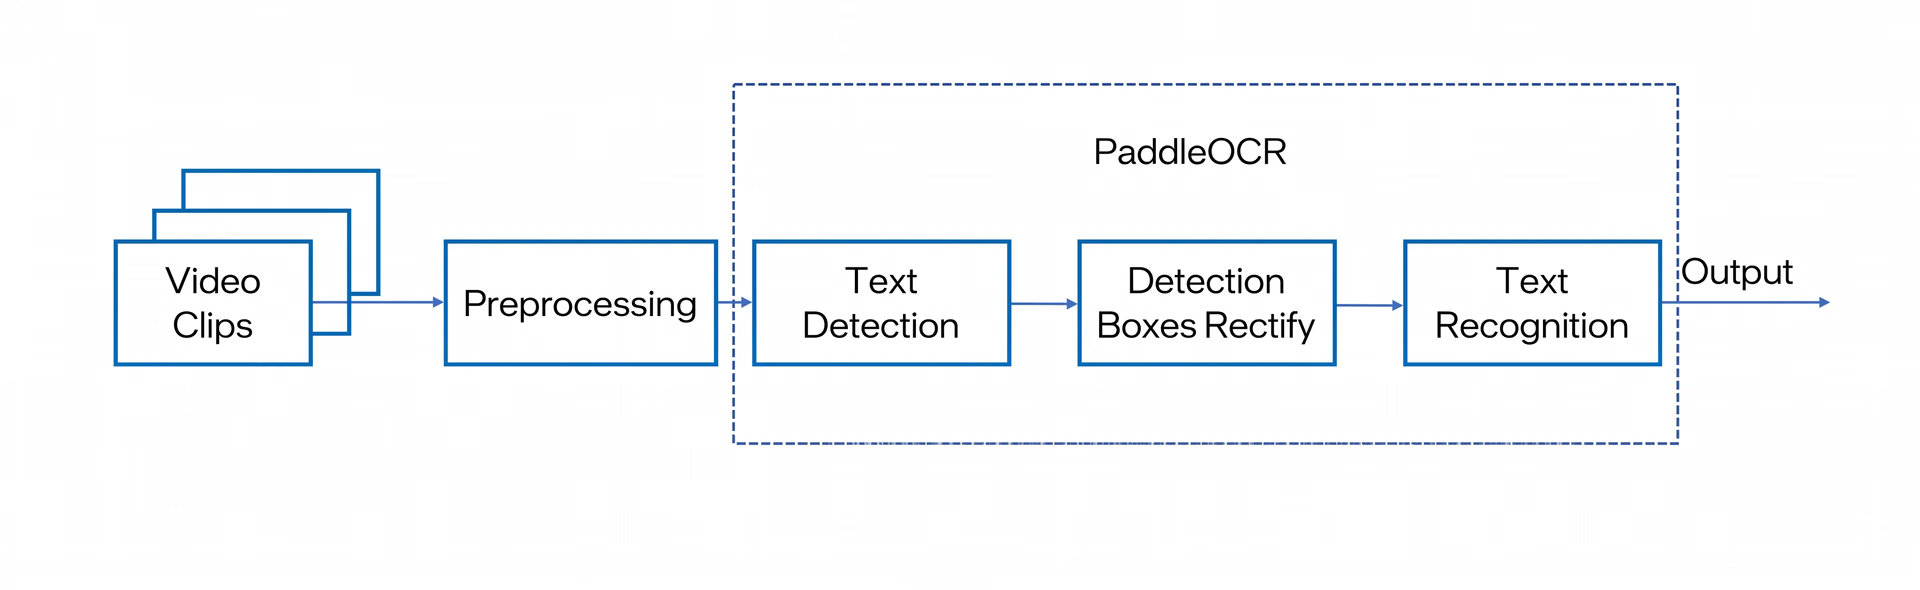
Fig. 4. Flusso di lavoro di PaddleOCR (fonte).
Inoltre, PaddleOCR è altamente modulare e consente agli sviluppatori di personalizzare le pipeline scegliendo componenti specifici per il rilevamento, il riconoscimento e la classificazione. Grazie alle API Python ben documentate e al forte supporto della community, è una soluzione flessibile e pronta per la produzione, adatta a un'ampia gamma di applicazioni OCR.
Altri modelli OCR open source diffusi#
Ecco alcuni altri modelli OCR open source comunemente utilizzati:
- MMOCR: progettato per progetti più complessi, MMOCR è in grado di rilevare il testo e anche di comprenderne la disposizione sulla pagina. È ideale per lavorare con tabelle, layout a più colonne e altri documenti visivamente complessi.
- TrOCR: basato sui Transformer, un tipo di modello di deep learning particolarmente efficace nella comprensione delle sequenze di testo, TrOCR eccelle nella gestione di passaggi più lunghi e layout disordinati e non strutturati. È una scelta affidabile quando il contenuto è composto da frasi continue anziché da etichette isolate.
Applicazioni comuni dei modelli OCR#
Con il progresso della tecnologia OCR, il suo ruolo si è esteso ben oltre la digitalizzazione di base. Oggi, infatti, i modelli OCR vengono adottati in diversi settori che dipendono dalle informazioni testuali. Ecco alcuni esempi di applicazioni dell'OCR nei sistemi del mondo reale:
- Settore legale ed e-discovery: Gli studi legali utilizzano l'OCR per scansionare migliaia di pagine di documenti legali, rendendo consultabili contratti, atti processuali e prove per accelerare la ricerca e l'analisi.
- Sanità: Gli ospedali utilizzano i modelli OCR per digitalizzare le cartelle cliniche, interpretare le prescrizioni scritte a mano e gestire in modo efficiente i referti di laboratorio. Questo semplifica le attività amministrative e migliora la precisione nei flussi di lavoro clinici.
- Tutela del patrimonio storico: Musei, biblioteche e archivi utilizzano l'OCR per digitalizzare libri antichi, manoscritti e giornali, preservando un prezioso patrimonio culturale e rendendolo consultabile dai ricercatori.
- Verifica di documenti d'identità e passaporti: Molti sistemi digitali di registrazione dei clienti e di viaggio si affidano all'OCR per estrarre dati fondamentali dai documenti rilasciati dalle autorità. Verifiche dell'identità più rapide e un minor numero di errori di inserimento manuale migliorano l'esperienza degli utenti e aumentano la sicurezza.
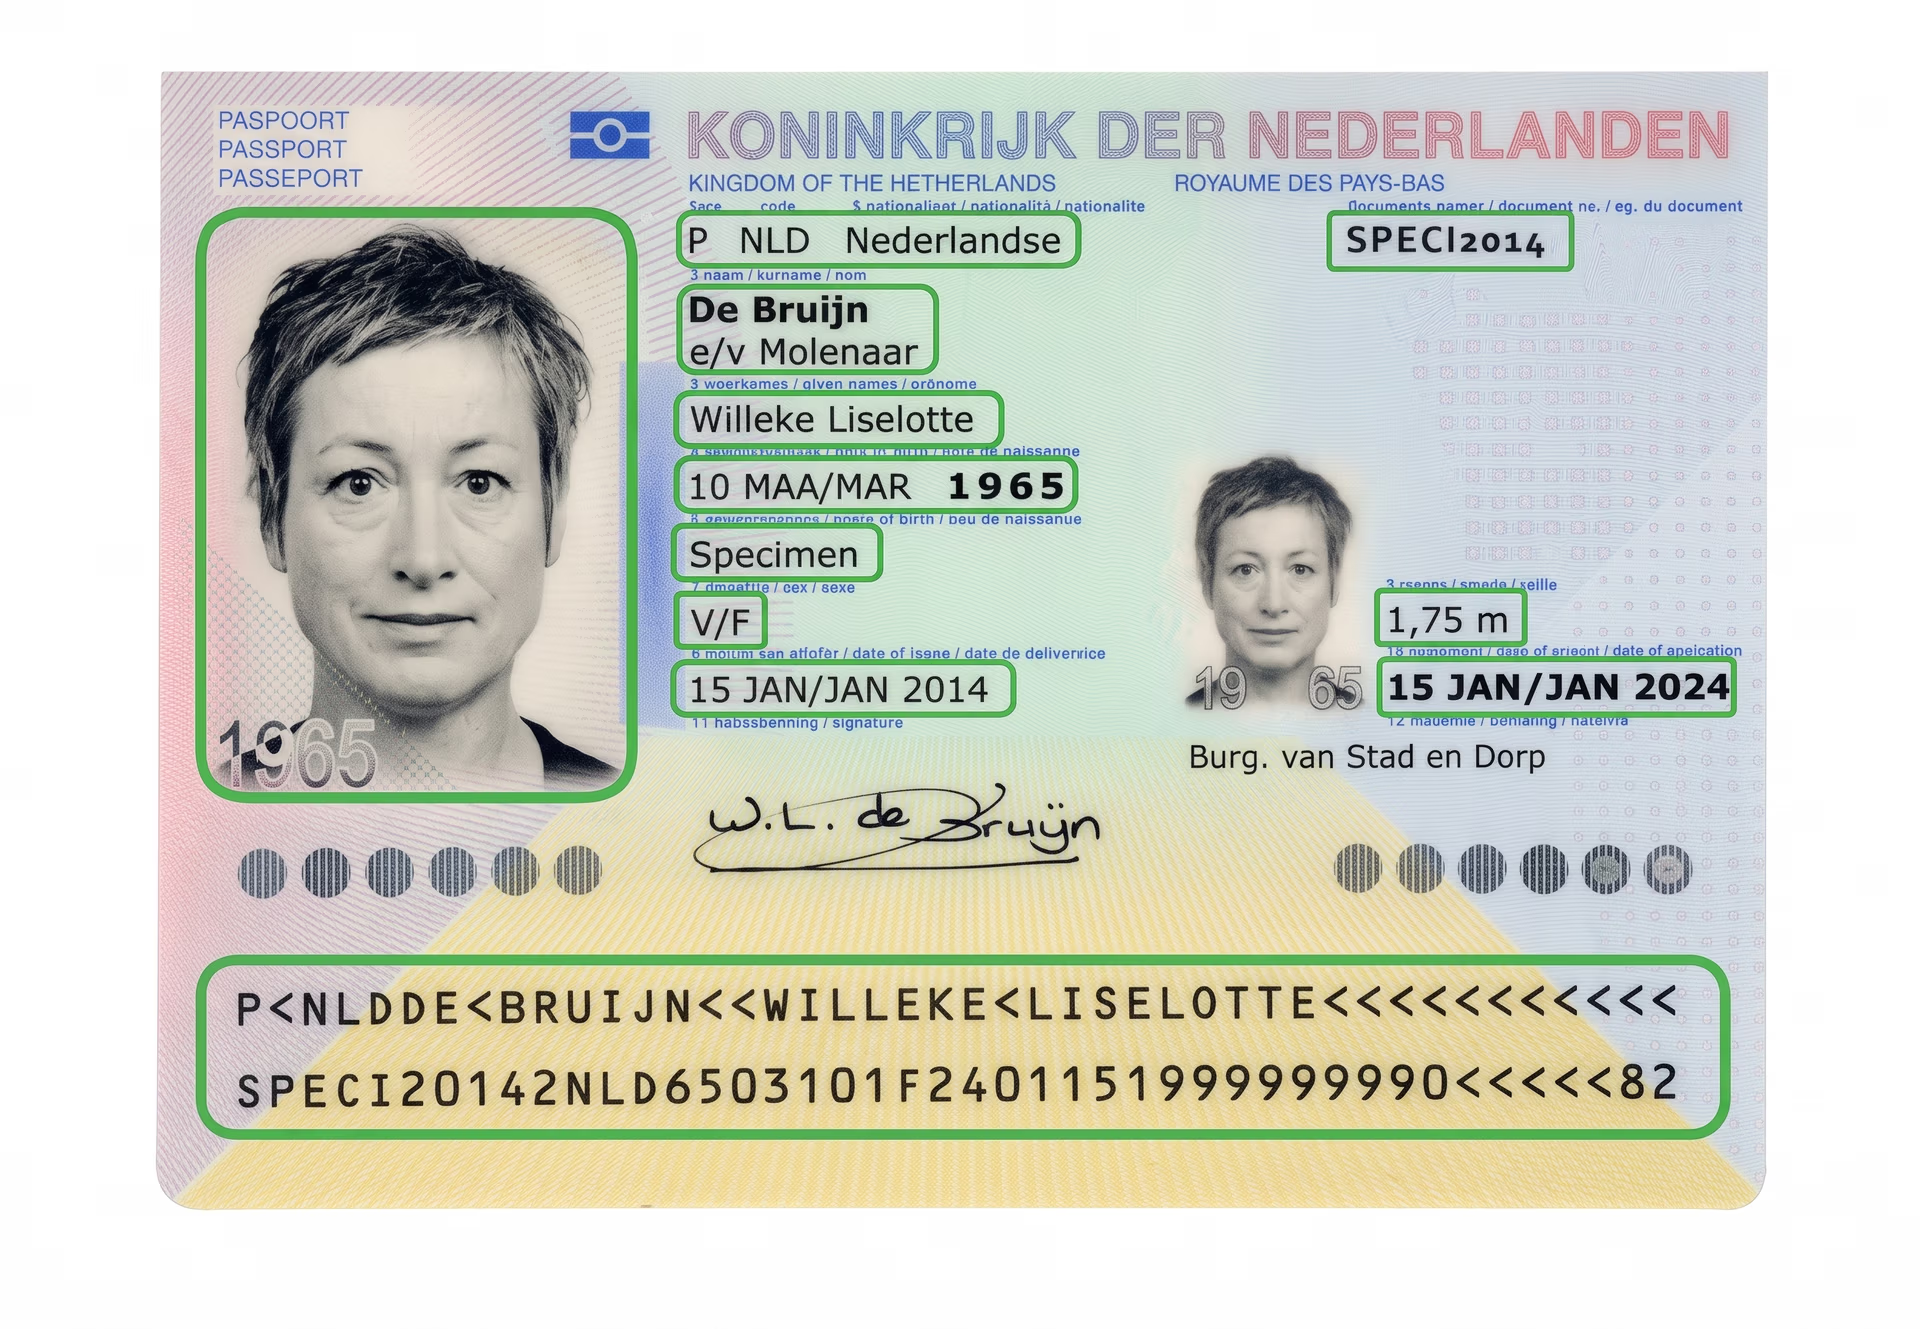
Fig. 5. Scanner basato su OCR per la verifica dell'identità tramite passaporto. (fonte).
Vantaggi e svantaggi dei modelli OCR#
Da quando sono stati ideati negli anni '50, i modelli OCR hanno fatto molta strada. Oggi sono più accessibili, accurati e adattabili a contenuti e piattaforme diversi. Ecco i principali punti di forza dei modelli OCR attuali:
- Miglioramento dell'accessibilità: L'OCR contribuisce a rendere i contenuti più accessibili, convertendo il materiale stampato in formati leggibili dagli screen reader per le persone con disabilità visive.
- Migliora le pipeline di machine learning: Funge da ponte che trasforma dati visivi non strutturati in testo strutturato, rendendolo utilizzabile dai modelli di machine learning nelle fasi successive.
- Estrazione senza modelli predefiniti: L'OCR avanzato non richiede più modelli rigidi: può estrarre le informazioni in modo intelligente anche quando il layout varia da un documento all'altro.
Nonostante i vantaggi, i modelli OCR presentano ancora alcune difficoltà, soprattutto quando l'input non è perfetto. Ecco alcune limitazioni comuni da tenere presenti:
- Sensibilità alla qualità delle immagini: L'OCR funziona al meglio con immagini nitide; le foto sfocate o scure possono influire sui risultati.
- Difficoltà con alcune grafie o caratteri: Anche i modelli migliori possono essere messi in difficoltà da scritture elaborate o disordinate.
- La post-elaborazione è ancora necessaria: Anche con un'elevata accuratezza, i risultati dell'OCR spesso richiedono una revisione o una pulizia manuale, soprattutto per i documenti critici.
Punti chiave#
L'OCR consente ai computer di leggere il testo dalle immagini, rendendo possibile usare queste informazioni nei sistemi digitali. Svolge un ruolo fondamentale nell'elaborazione di documenti, cartelli e appunti scritti a mano ed è particolarmente utile nei contesti in cui velocità e precisione sono cruciali.
I modelli OCR lavorano spesso anche insieme a modelli come Ultralytics YOLO11, in grado di rilevare gli oggetti nelle immagini. Insieme, consentono ai sistemi di capire che cosa è scritto e dove si trova. Man mano che queste tecnologie continuano a migliorare, l'OCR diventa una componente fondamentale del modo in cui le macchine interpretano e interagiscono con il mondo.
Ti interessa l'IA applicata alla visione? Visita il nostro repository GitHub e partecipa alla nostra community per continuare a esplorare. Scopri innovazioni come l'IA nelle auto a guida autonoma e l'IA applicata alla visione in agricoltura nelle pagine dedicate alle nostre soluzioni. Dai un'occhiata alle nostre opzioni di licenza e avvia un progetto di visione artificiale!








