Qu’est-ce que le surapprentissage en vision par ordinateur et comment l’éviter ?
Découvre le surapprentissage en vision par ordinateur, comment le repérer et comment l’éviter grâce à l’augmentation des données, à la régularisation, à l’arrêt anticipé et aux modèles préentraînés.
 Abdelrahman Elgendy10 min de lecture
Les modèles de vision par ordinateur sont conçus pour reconnaître des motifs, détecter des objets et analyser des images. Toutefois, leurs performances dépendent de leur capacité à généraliser à des données inédites. La généralisation est la capacité du modèle à bien fonctionner sur de nouvelles images, et pas seulement sur celles utilisées pour l’entraînement. Un problème courant lors de l’entraînement de ces modèles est le surapprentissage, qui survient lorsqu’un modèle apprend trop de ses données d’entraînement, y compris des détails superflus, au lieu d’identifier des motifs pertinents.
Dans ce cas, le modèle fonctionne bien sur les données d’entraînement, mais a du mal avec de nouvelles images. Par exemple, un modèle de détection d’objets entraîné uniquement sur des images haute résolution bien éclairées peut échouer face à des images floues ou ombragées dans des conditions réelles. Le surapprentissage limite la capacité d’adaptation d’un modèle, réduisant ainsi son utilité dans des applications concrètes comme la conduite autonome, l’imagerie médicale et les systèmes de sécurité.
Dans cet article, nous verrons ce qu’est le surapprentissage, pourquoi il se produit et comment l’éviter. Nous examinerons également comment les modèles de vision par ordinateur comme Ultralytics YOLO11 contribuent à réduire le surapprentissage et à améliorer la généralisation.
Qu’est-ce que le surapprentissage ?#
Le surapprentissage se produit lorsqu’un modèle mémorise les données d’entraînement au lieu d’apprendre des motifs qui s’appliquent largement à de nouvelles entrées. Le modèle se concentre trop sur les données d’entraînement et a donc du mal à traiter des images ou des situations inédites.
En vision par ordinateur, le surapprentissage peut affecter différentes tâches. Un modèle de classification entraîné uniquement sur des images lumineuses et nettes peut avoir du mal dans des conditions de faible luminosité. Un modèle de détection d’objets qui apprend à partir d’images parfaites peut échouer dans des scènes encombrées ou désordonnées. De même, un modèle de segmentation d’instances peut bien fonctionner dans des environnements contrôlés, mais rencontrer des difficultés avec les ombres ou les objets qui se chevauchent.
Cela pose problème dans les applications d’IA concrètes, où les modèles doivent pouvoir généraliser au-delà des conditions d’entraînement contrôlées. Les voitures autonomes, par exemple, doivent pouvoir détecter des piétons dans différentes conditions d’éclairage, météorologiques et environnements. Un modèle qui surapprend son jeu de données d’entraînement ne fonctionnera pas de manière fiable dans des situations aussi imprévisibles.
Quand et pourquoi le surapprentissage se produit-il ?#
Le surapprentissage survient généralement à cause de jeux de données déséquilibrés, d’une complexité excessive du modèle et d’un entraînement trop long. Voici les principales causes :
- Données d’entraînement limitées : les petits jeux de données poussent les modèles à mémoriser des motifs plutôt qu’à les généraliser. Un modèle entraîné sur seulement 50 images d’oiseaux peut avoir du mal à détecter des espèces d’oiseaux absentes de ce jeu de données.
- Modèles complexes avec trop de paramètres : les réseaux profonds comportant un trop grand nombre de couches et de neurones ont tendance à mémoriser des détails fins plutôt qu’à se concentrer sur les caractéristiques essentielles.
- Absence d’augmentation des données : sans transformations comme le recadrage, le retournement ou la rotation, un modèle risque de n’apprendre qu’à partir des images exactes de son jeu d’entraînement.
- Entraînement prolongé : si un modèle parcourt les données d’entraînement trop de fois, autrement dit sur trop d’époques, il mémorise les détails au lieu d’apprendre des motifs généraux, ce qui réduit sa capacité d’adaptation.
- Étiquettes incohérentes ou bruitées : des données mal étiquetées amènent le modèle à apprendre des motifs erronés. Ce problème est fréquent dans les jeux de données annotés manuellement.
Une approche équilibrée de la complexité du modèle, de la qualité du jeu de données et des techniques d’entraînement garantit une meilleure généralisation.
Surapprentissage ou sous-apprentissage#
Le surapprentissage et le sous-apprentissage sont deux problèmes opposés en apprentissage profond.
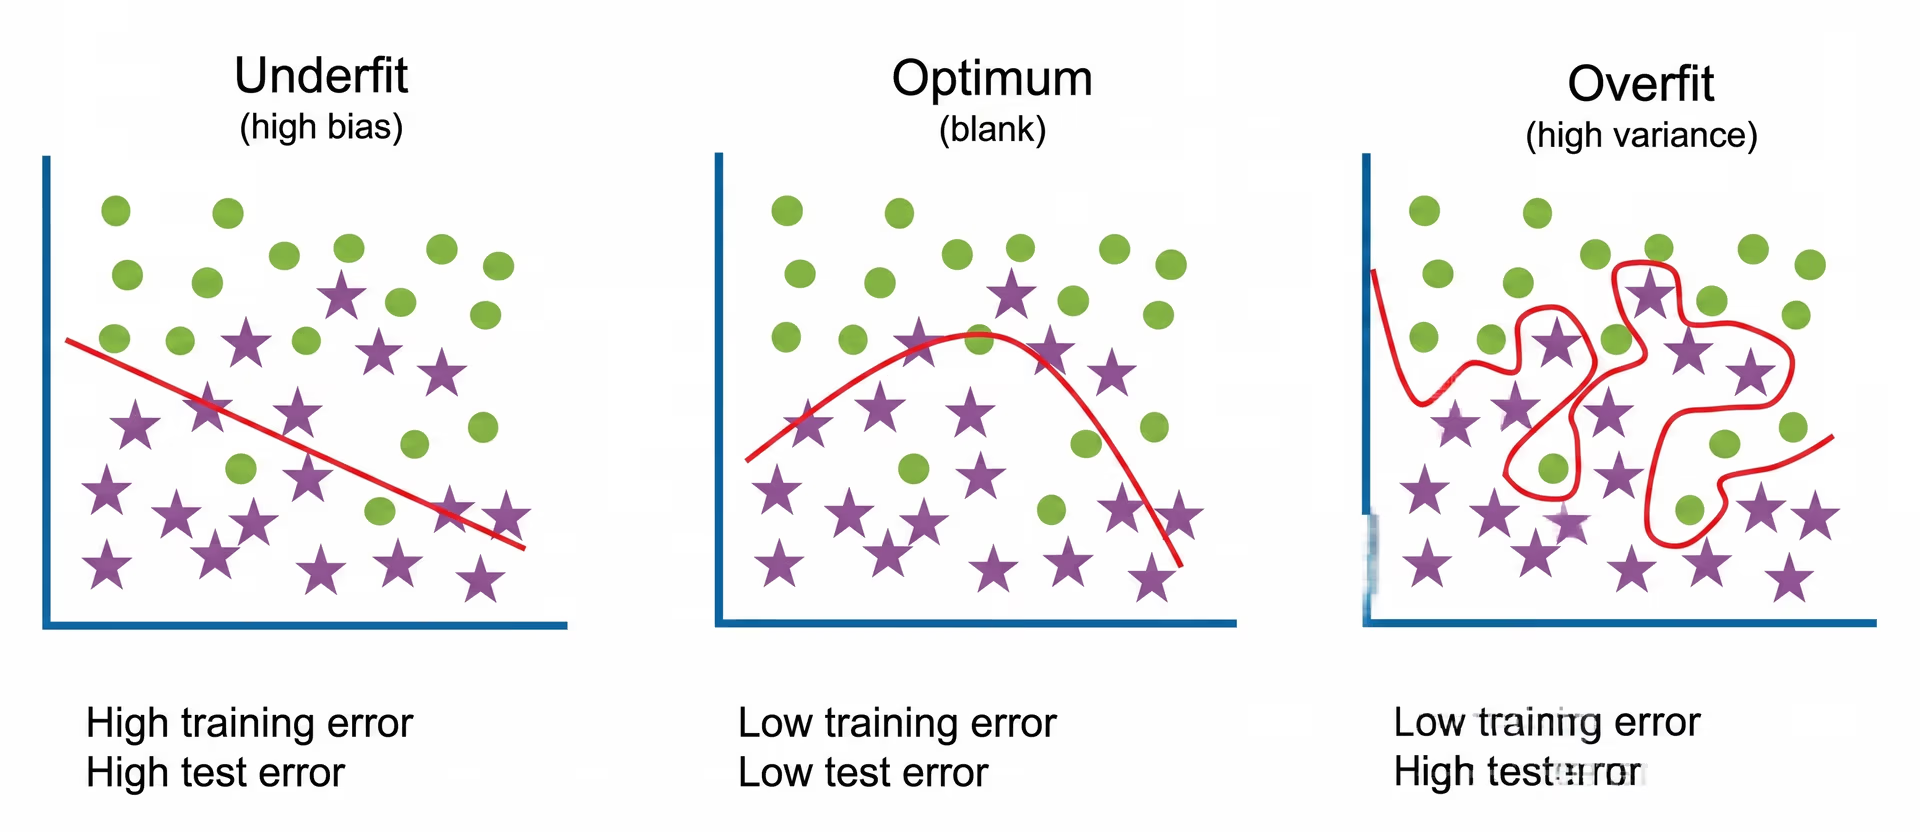
Fig. 1. Comparaison du sous-apprentissage, de l’apprentissage optimal et du surapprentissage dans les modèles de vision par ordinateur.
Le surapprentissage se produit lorsqu’un modèle est trop complexe et se concentre excessivement sur les données d’entraînement. Au lieu d’apprendre des motifs généraux, il mémorise de petits détails, même non pertinents comme le bruit de fond. Le modèle fonctionne alors bien sur les données d’entraînement, mais a du mal avec de nouvelles images : il n’a pas réellement appris à reconnaître des motifs qui s’appliquent à différentes situations.
Le sous-apprentissage se produit lorsqu’un modèle est trop simple et passe à côté de motifs importants dans les données. Cela peut arriver si le modèle comporte trop peu de couches, si le temps d’entraînement est insuffisant ou si les données sont limitées. Il ne parvient alors pas à reconnaître les motifs importants et produit des prédictions inexactes. Ses performances sont médiocres à la fois sur les données d’entraînement et de test, car il n’a pas suffisamment appris pour comprendre correctement la tâche.
Un modèle bien entraîné trouve le bon équilibre entre complexité et généralisation. Il doit être assez complexe pour apprendre les motifs pertinents, sans l’être au point de mémoriser les données au lieu de reconnaître les relations sous-jacentes.
Comment détecter le surapprentissage#
Voici quelques signes indiquant qu’un modèle est en situation de surapprentissage :
- Si la précision sur les données d’entraînement est nettement supérieure à celle obtenue sur les données de validation, le modèle est probablement en situation de surapprentissage.
- Un écart qui se creuse entre la perte sur les données d’entraînement et celle sur les données de validation est un autre signe révélateur.
- Le modèle est trop sûr de ses réponses erronées, ce qui montre qu’il a mémorisé des détails au lieu de comprendre les motifs.
Pour garantir qu’un modèle généralise bien, il faut le tester sur des jeux de données variés qui reflètent les conditions réelles.
Comment éviter le surapprentissage en vision par ordinateur#
Le surapprentissage n’est pas inévitable et peut être évité. Grâce aux bonnes techniques, les modèles de vision par ordinateur peuvent apprendre des motifs généraux au lieu de mémoriser les données d’entraînement, ce qui les rend plus fiables dans les applications concrètes.
Voici cinq stratégies clés pour éviter le surapprentissage en vision par ordinateur.
Accroître la diversité des données grâce à l’augmentation et aux données synthétiques#
La meilleure façon d’aider un modèle à bien fonctionner sur de nouvelles données consiste à enrichir le jeu de données grâce à l’augmentation des données et aux données synthétiques. Les données synthétiques sont générées par ordinateur plutôt que collectées à partir d’images du monde réel. Elles aident à combler les lacunes lorsqu’on ne dispose pas de suffisamment de données réelles.
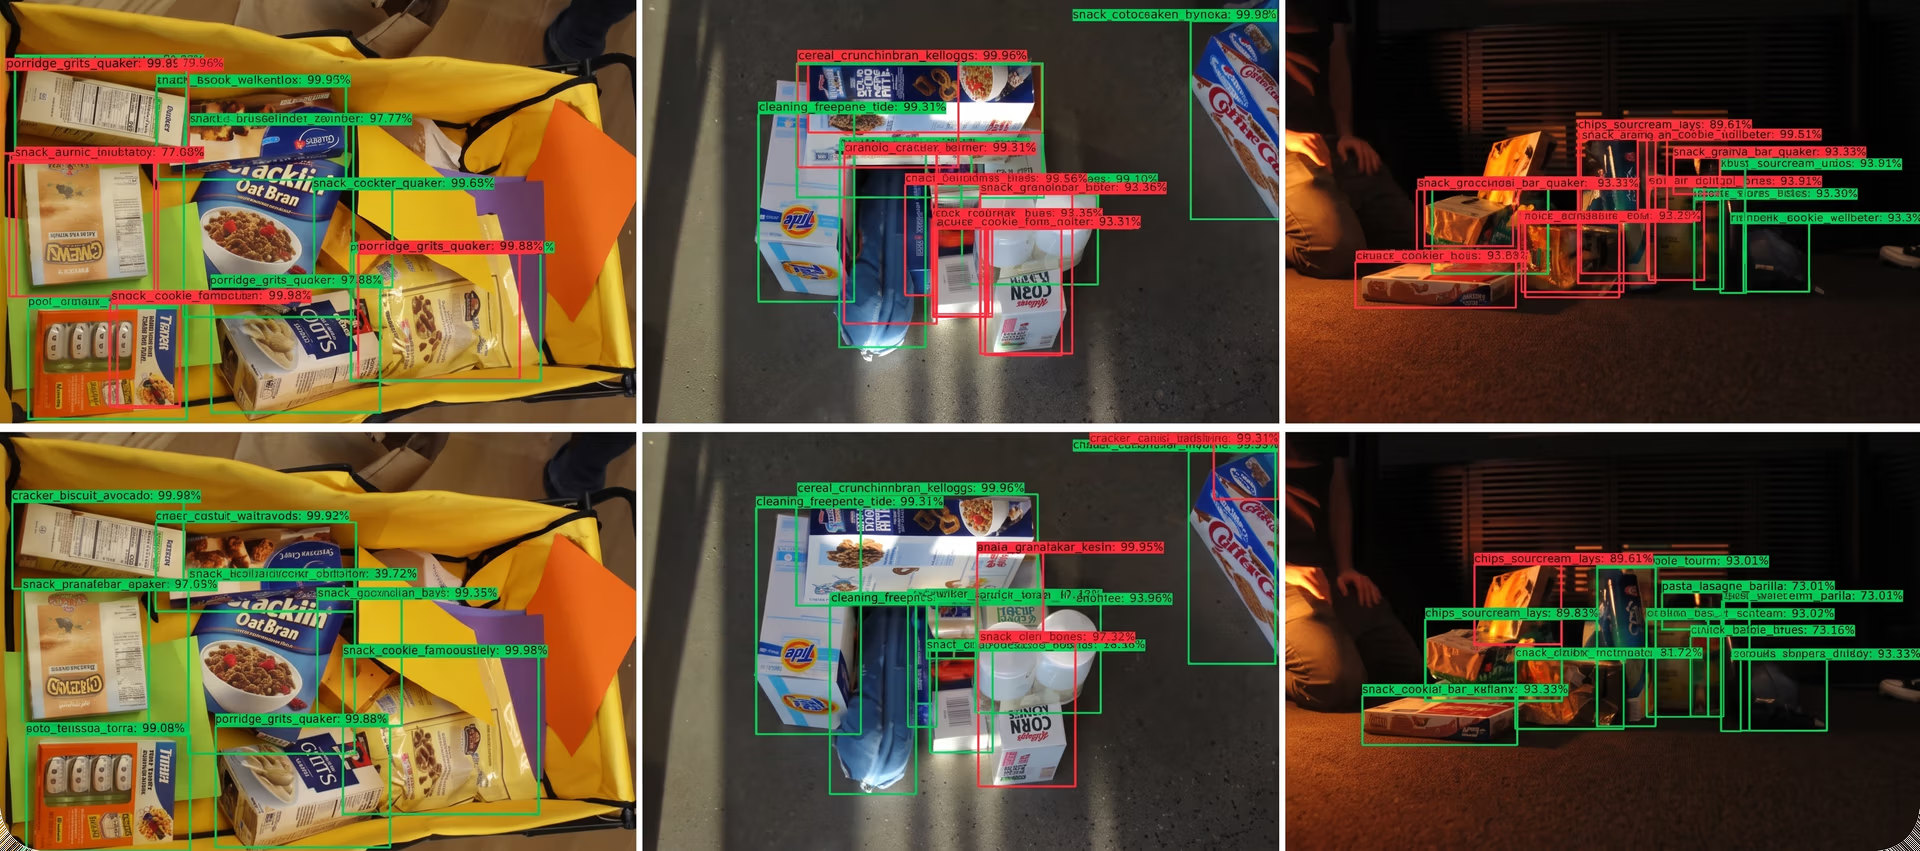
Fig. 2. La combinaison de données du monde réel et de données synthétiques réduit le surapprentissage et améliore la précision de la détection d’objets.
L’augmentation des données modifie légèrement les images existantes en les retournant, en les faisant pivoter ou en les recadrant, ou en ajustant leur luminosité. Le modèle ne se contente ainsi pas de mémoriser les détails, mais apprend à reconnaître les objets dans différentes situations.
Les données synthétiques sont utiles lorsque les images réelles sont difficiles à obtenir. Par exemple, les modèles de voitures autonomes peuvent être entraînés sur des scènes routières générées par ordinateur afin d’apprendre à détecter des objets dans différentes conditions météorologiques et d’éclairage. Le modèle gagne ainsi en flexibilité et en fiabilité sans nécessiter des milliers d’images du monde réel.
Optimiser la complexité et l’architecture du modèle#
Un réseau neuronal profond, un type de modèle d’apprentissage automatique comportant de nombreuses couches qui traitent les données plutôt qu’une seule couche, n’est pas toujours préférable. Lorsqu’un modèle comporte trop de couches ou de paramètres, il mémorise les données d’entraînement au lieu de reconnaître des schémas plus généraux. Réduire la complexité inutile peut aider à prévenir le surapprentissage.
Pour y parvenir, une approche consiste à effectuer un élagage, qui supprime les neurones et les connexions redondants afin de rendre le modèle plus léger et plus efficace.
Une autre approche consiste à simplifier l’architecture en réduisant le nombre de couches ou de neurones. Les modèles préentraînés comme Ultralytics YOLO11 sont conçus pour bien généraliser à différentes tâches avec moins de paramètres, ce qui les rend plus résistants au surapprentissage que l’entraînement d’un modèle profond à partir de zéro.
Trouver le juste équilibre entre la profondeur et l’efficacité du modèle l’aide à apprendre des schémas utiles sans se contenter de mémoriser les données d’entraînement.
Appliquer des techniques de régularisation#
Les techniques de régularisation empêchent les modèles de devenir trop dépendants de caractéristiques spécifiques des données d’entraînement. Voici quelques techniques couramment utilisées :
- Dropout désactive aléatoirement certaines parties du modèle pendant l’entraînement afin qu’il apprenne à reconnaître différents schémas au lieu de trop dépendre de quelques caractéristiques.
- La décroissance des poids (régularisation L2) décourage les valeurs extrêmes des poids et aide à maîtriser la complexité du modèle.
- La normalisation par lots contribue à stabiliser l’entraînement en rendant le modèle moins sensible aux variations du jeu de données.
Ces techniques aident à préserver la flexibilité et l’adaptabilité du modèle, en réduisant le risque de surapprentissage tout en maintenant sa précision.
Suivre l’entraînement à l’aide de la validation et de l’arrêt anticipé#
Pour prévenir le surapprentissage, il est important de suivre l’apprentissage du modèle et de vérifier qu’il généralise bien à de nouvelles données. Voici quelques techniques qui peuvent t’y aider :
- Arrêt anticipé : interrompt automatiquement l’entraînement lorsque les performances de validation cessent de s’améliorer, afin que le modèle n’apprenne pas continuellement des détails inutiles.
- Validation croisée : répartit les données en plusieurs sous-ensembles, puis entraîne le modèle à plusieurs reprises sur tous les sous-ensembles sauf un et le valide sur celui qui a été mis de côté. Cette méthode donne une idée plus fiable de la capacité du modèle à généraliser au-delà d’images précises.
Ces techniques aident le modèle à garder un bon équilibre : il apprend suffisamment pour être précis sans se focaliser excessivement sur les seules données d’entraînement.
Utiliser des modèles préentraînés et améliorer l’annotation du jeu de données#
Au lieu d’entraîner un modèle à partir de zéro, utiliser des modèles préentraînés comme Ultralytics YOLO11 peut réduire le surapprentissage. YOLO11 est entraîné sur des jeux de données à grande échelle, ce qui lui permet de bien généraliser dans différentes conditions.
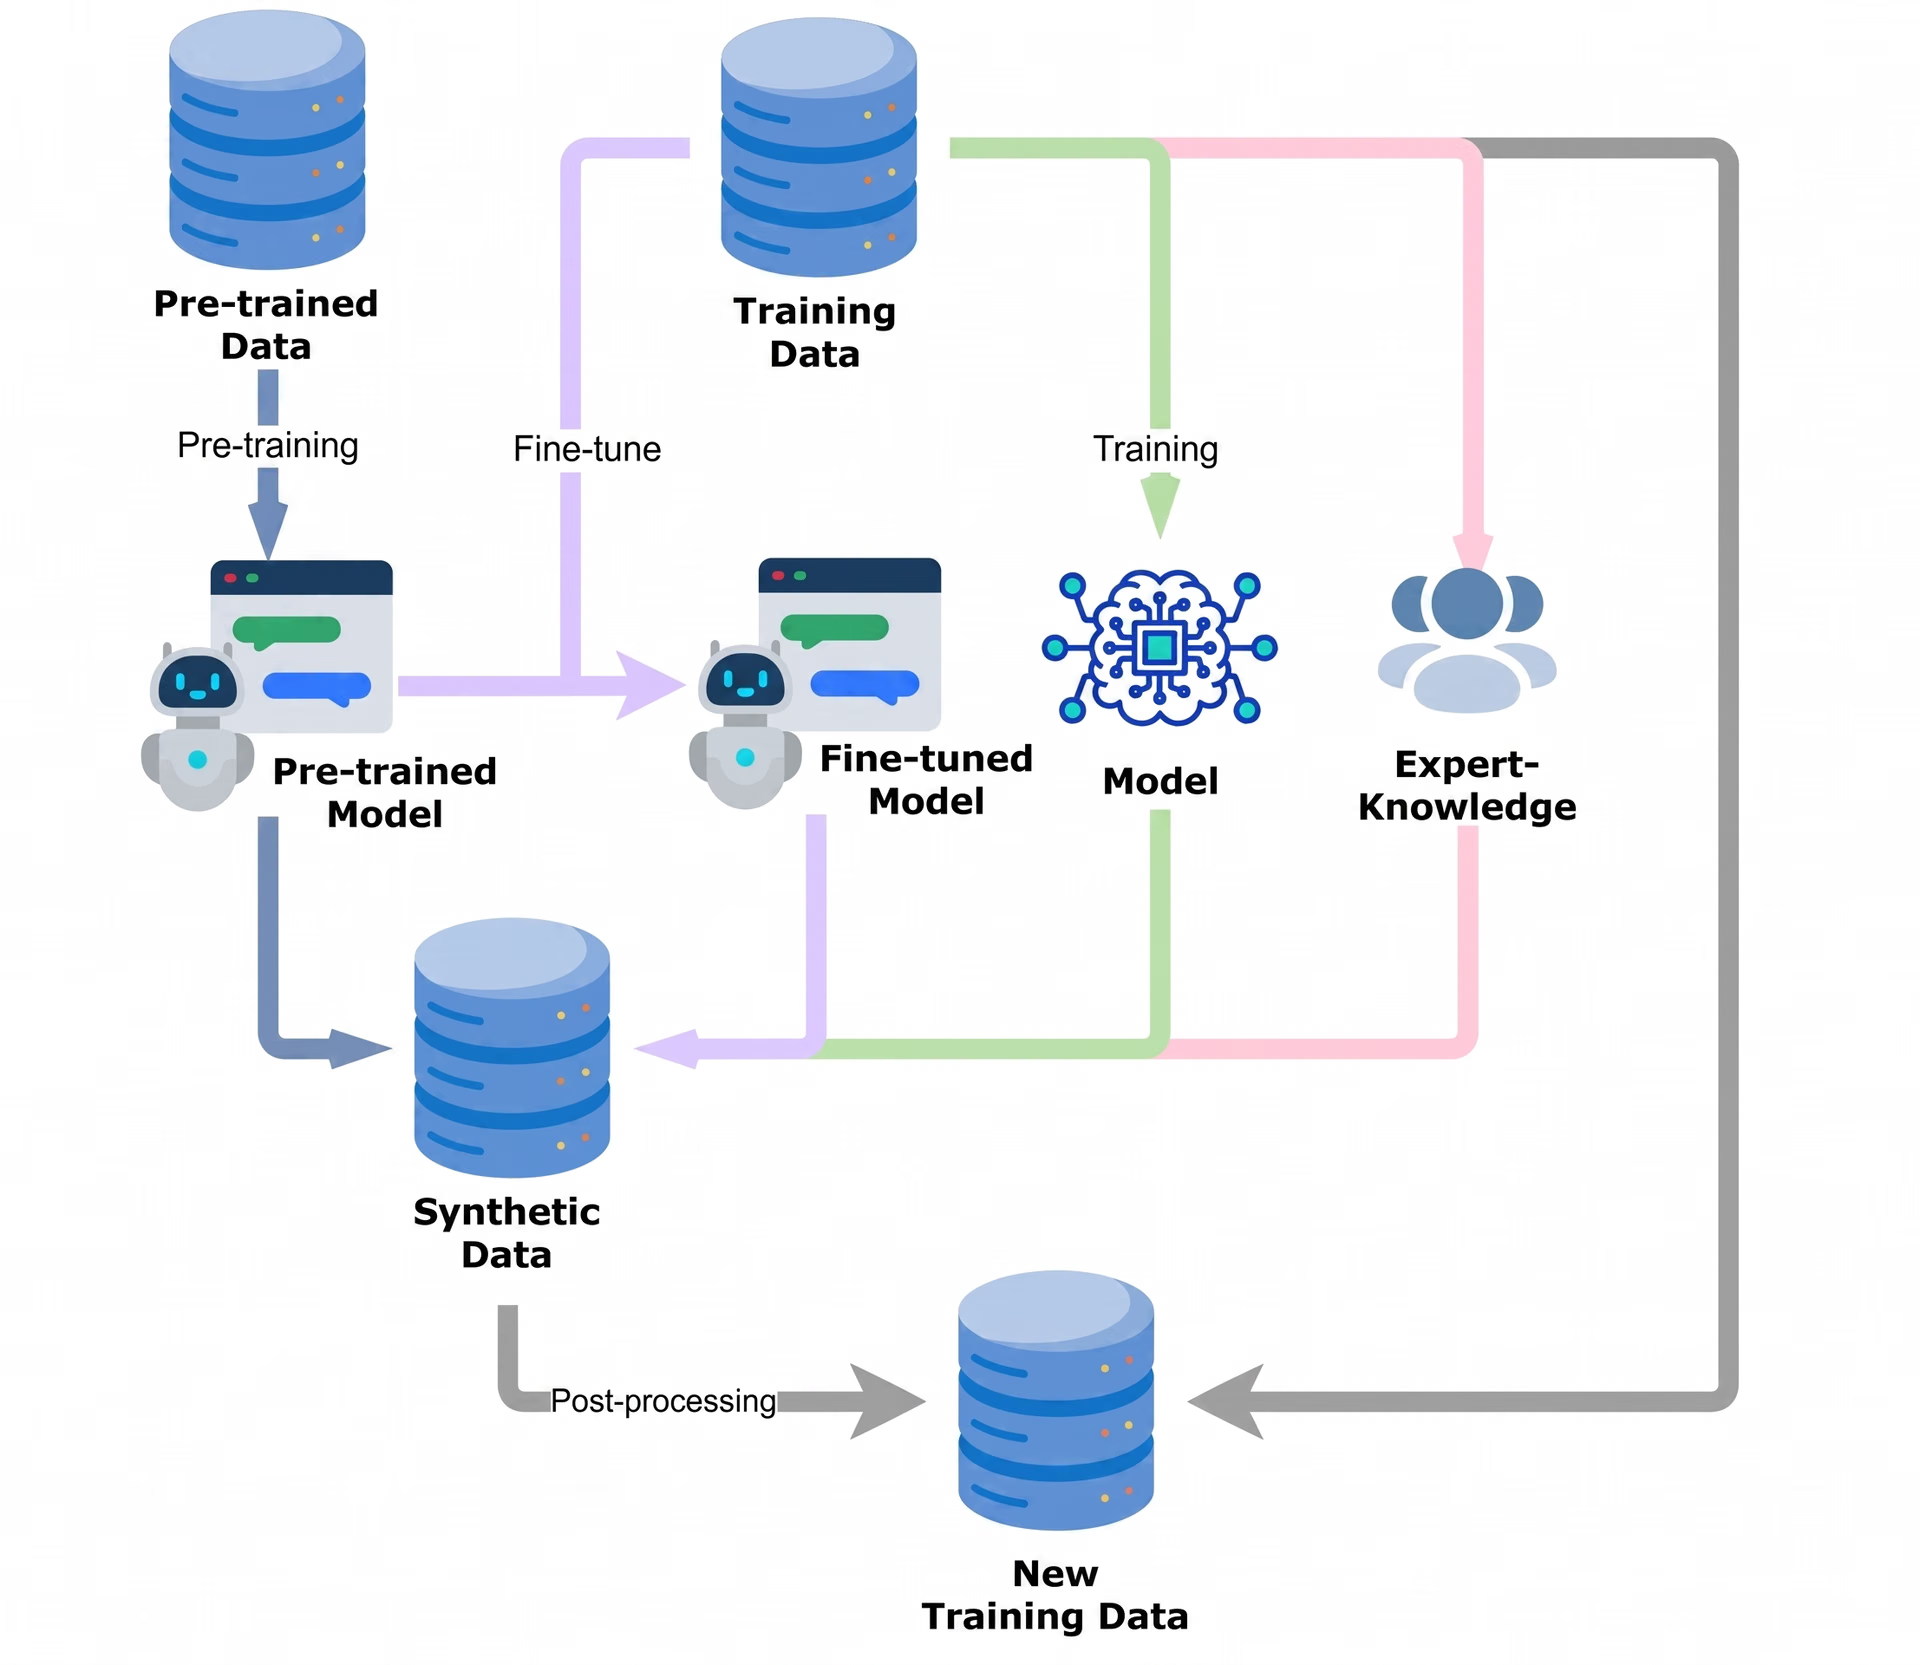
Fig. 3. Les modèles de vision par ordinateur préentraînés améliorent la précision et préviennent le surapprentissage.
Le réglage fin d’un modèle préentraîné l’aide à conserver ses acquis tout en apprenant de nouvelles tâches, afin qu’il ne se contente pas de mémoriser les données d’entraînement.
Il est également essentiel de veiller à la qualité de l’annotation du jeu de données. Des données mal étiquetées ou déséquilibrées peuvent induire les modèles en erreur et leur faire apprendre des schémas incorrects. Nettoyer les jeux de données, corriger les images mal étiquetées et équilibrer les classes améliore la précision et réduit le risque de surapprentissage. Une autre approche efficace consiste à utiliser l’entraînement adversarial, qui expose le modèle à des exemples légèrement modifiés ou plus difficiles, conçus pour tester ses limites.
Points clés à retenir#
Le surapprentissage est un problème courant en vision par ordinateur. Un modèle peut bien fonctionner sur les données d’entraînement, mais avoir du mal avec les images du monde réel. Pour l’éviter, des techniques comme l’augmentation des données, la régularisation et l’utilisation de modèles préentraînés comme Ultralytics YOLO11 contribuent à améliorer la précision et l’adaptabilité.
En appliquant ces méthodes, les modèles d’IA peuvent rester fiables et bien fonctionner dans différents environnements. À mesure que l’apprentissage profond progresse, veiller à ce que les modèles généralisent correctement sera essentiel à la réussite de l’IA dans le monde réel.
Rejoins notre communauté en pleine croissance ! Explore notre dépôt GitHub pour en savoir plus sur l’IA. Prêt à te lancer dans tes propres projets de vision par ordinateur ? Découvre nos options de licence. Découvre l’IA visuelle appliquée aux voitures autonomes et l’IA dans le secteur de la santé sur nos pages consacrées aux solutions !
Écrit par
Auteur · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









