コンピュータービジョンにおける過学習とは何ですか?また、どうすれば防げますか?
コンピュータービジョンにおける過学習とは何か、また、データ拡張、正則化、事前学習済みモデルを使って防ぐ方法をご紹介します。
コンピュータービジョンモデルは、パターンの認識、物体の検出、画像の解析を目的として設計されています。しかし、その性能は未知のデータにどれだけ汎化できるかに左右されます。汎化とは、モデルがトレーニングに使った画像だけでなく、新しい画像にも適切に対応する能力です。こうしたモデルのトレーニングでよく起きる問題の一つが過学習です。過学習では、意味のあるパターンを見つけるのではなく、不要なノイズも含めてトレーニングデータを過剰に学習します。
この状態になると、モデルはトレーニングデータでは高い性能を発揮する一方、新しい画像への対応に苦労します。たとえば、高解像度で明るく撮影された画像だけでトレーニングした物体検出モデルは、実環境のぼやけた画像や影のある画像では失敗する可能性があります。過学習はモデルの適応性を損ない、自動運転、医療画像、セキュリティシステムなど、実環境での用途を制限します。
この記事では、過学習とは何か、なぜ起きるのか、どうすれば防げるのかを解説します。また、Ultralytics YOLO11のようなコンピュータービジョンモデルが、過学習の抑制と汎化性能の向上にどのように役立つかも見ていきます。
過学習とは何ですか?#
過学習は、新しい入力にも広く当てはまるパターンを学ぶのではなく、モデルがトレーニングデータを記憶してしまうと発生します。モデルがトレーニングデータに過度に偏るため、これまでに見たことのない新しい画像や状況への対応に苦労します。
コンピュータービジョンでは、過学習はさまざまなタスクに影響します。明るく鮮明な画像だけでトレーニングした分類モデルは、暗い環境で苦戦する可能性があります。鮮明な画像から学習した物体検出モデルは、混雑した場面や雑然とした場面で失敗することがあります。同様に、インスタンスセグメンテーションモデルは、管理された環境ではうまく動作しても、影や重なり合う物体への対応に苦労する可能性があります。
モデルが管理されたトレーニング条件を超えて汎化する必要がある実環境のAIアプリケーションでは、これが問題になります。たとえば自動運転車は、さまざまな照明条件、天候、環境で歩行者を検出できなければなりません。トレーニングセットに過学習したモデルは、このような予測困難な状況で安定した性能を発揮できません。
過学習はいつ、なぜ発生しますか?#
過学習は通常、データセットの偏り、モデルの過度な複雑さ、過剰なトレーニングが原因で発生します。主な原因は次のとおりです。
- トレーニングデータの不足: データセットが小さいと、モデルはパターンを汎化するのではなく記憶します。鳥の画像50枚だけでトレーニングしたモデルは、そのデータセットに含まれない鳥の種の検出に苦労する可能性があります。
- パラメーターが多すぎる複雑なモデル: 層やニューロンが過剰なディープネットワークは、重要な特徴に注目するよりも、細部を記憶する傾向があります。
- データ拡張の不足: クロッピング、反転、回転などの変換を行わないと、モデルはトレーニング画像そのものからしか学習できない可能性があります。
- トレーニングの長期化: モデルがトレーニングデータを過剰に繰り返し学習すると、その反復回数であるエポックが多くなり、一般的なパターンではなく細部を記憶するため、適応性が低下します。
- 一貫性のないラベルやノイズの多いラベル: 誤ったラベルが付いたデータは、モデルに誤ったパターンを学習させます。これは手作業でラベリングしたデータセットでよく起きます。
モデルの複雑さ、データセットの品質、トレーニング手法のバランスを適切に取ることで、汎化性能を高められます。
過学習と未学習#
過学習と未学習は、ディープラーニングにおける正反対の問題です。
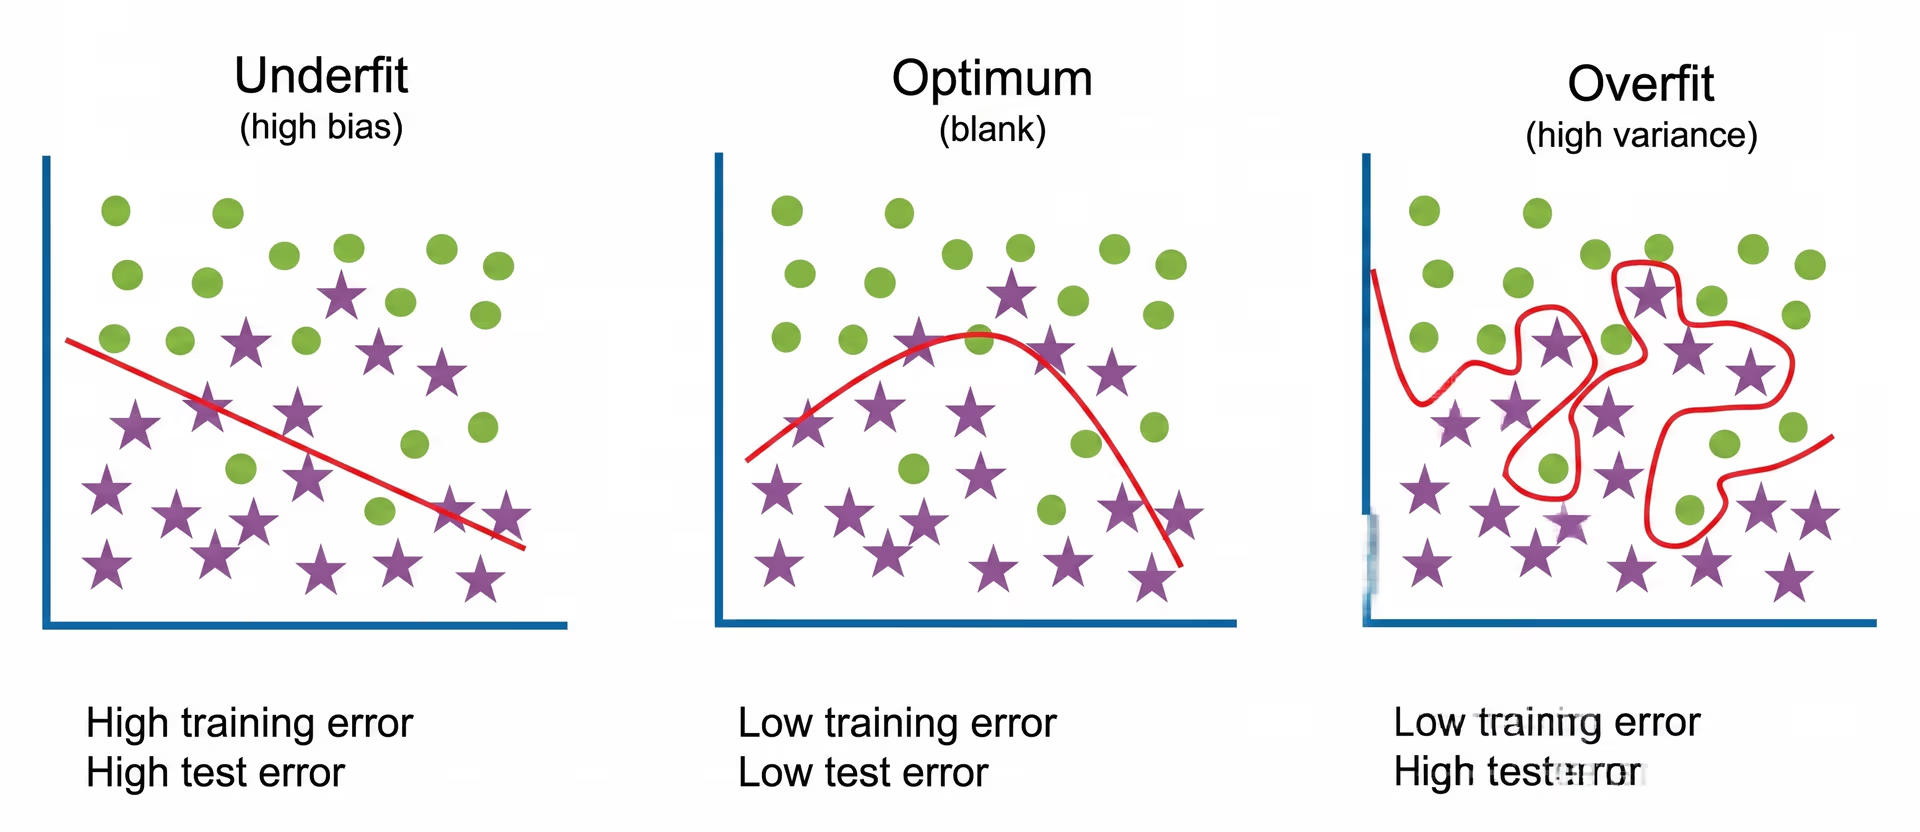
図1. コンピュータービジョンモデルにおける未学習、最適な学習、過学習の比較です。
過学習は、モデルが複雑すぎてトレーニングデータに過度に集中すると発生します。一般的なパターンを学習する代わりに、背景ノイズのような無関係なものも含め、細部を記憶します。その結果、モデルはトレーニングデータでは高い性能を示しますが、新しい画像への対応に苦労します。つまり、異なる状況にも当てはまるパターンの認識方法を本当の意味で学習できていません。
未学習は、モデルが単純すぎてデータ内の重要なパターンを捉えられない場合に発生します。モデルの層が少なすぎる、トレーニング時間が不十分である、またはデータが限られている場合に起きることがあります。その結果、重要なパターンを認識できず、不正確な予測を行います。タスクを適切に理解するだけの学習ができていないため、トレーニングデータとテストデータの両方で性能が低くなります。
適切にトレーニングされたモデルは、複雑さと汎化性能のバランスを取ります。関連するパターンを学ぶには十分に複雑でありながら、データを記憶して根本的な関係性の認識を妨げるほど複雑であってはなりません。
過学習を特定する方法#
次の兆候が見られる場合、モデルが過学習している可能性があります。
- トレーニング精度が検証精度を大幅に上回っている場合、モデルは過学習している可能性があります。
- トレーニング損失と検証損失の差が広がることも、過学習を示す強い兆候です。
- モデルが誤った回答に過度な確信を示す場合、パターンを理解せずに細部を記憶していることが分かります。
モデルが適切に汎化することを確認するには、実環境の状況を反映した多様なデータセットでテストする必要があります。
コンピュータービジョンにおける過学習を防ぐ方法#
過学習は避けられないものではなく、防止できます。適切な手法を使えば、コンピュータービジョンモデルはトレーニングデータを記憶するのではなく一般的なパターンを学習し、実環境のアプリケーションでより信頼性の高い性能を発揮できます。
ここでは、コンピュータービジョンにおける過学習を防ぐための5つの主要な手法を紹介します。
データ拡張と合成データでデータの多様性を高める#
新しいデータでもモデルが適切に動作するようにするには、データ拡張と合成データを活用してデータセットを拡充するのが最適です。合成データは、実世界の画像を収集するのではなく、コンピューターで生成されます。実データが不足している場合に、その不足を補うのに役立ちます。
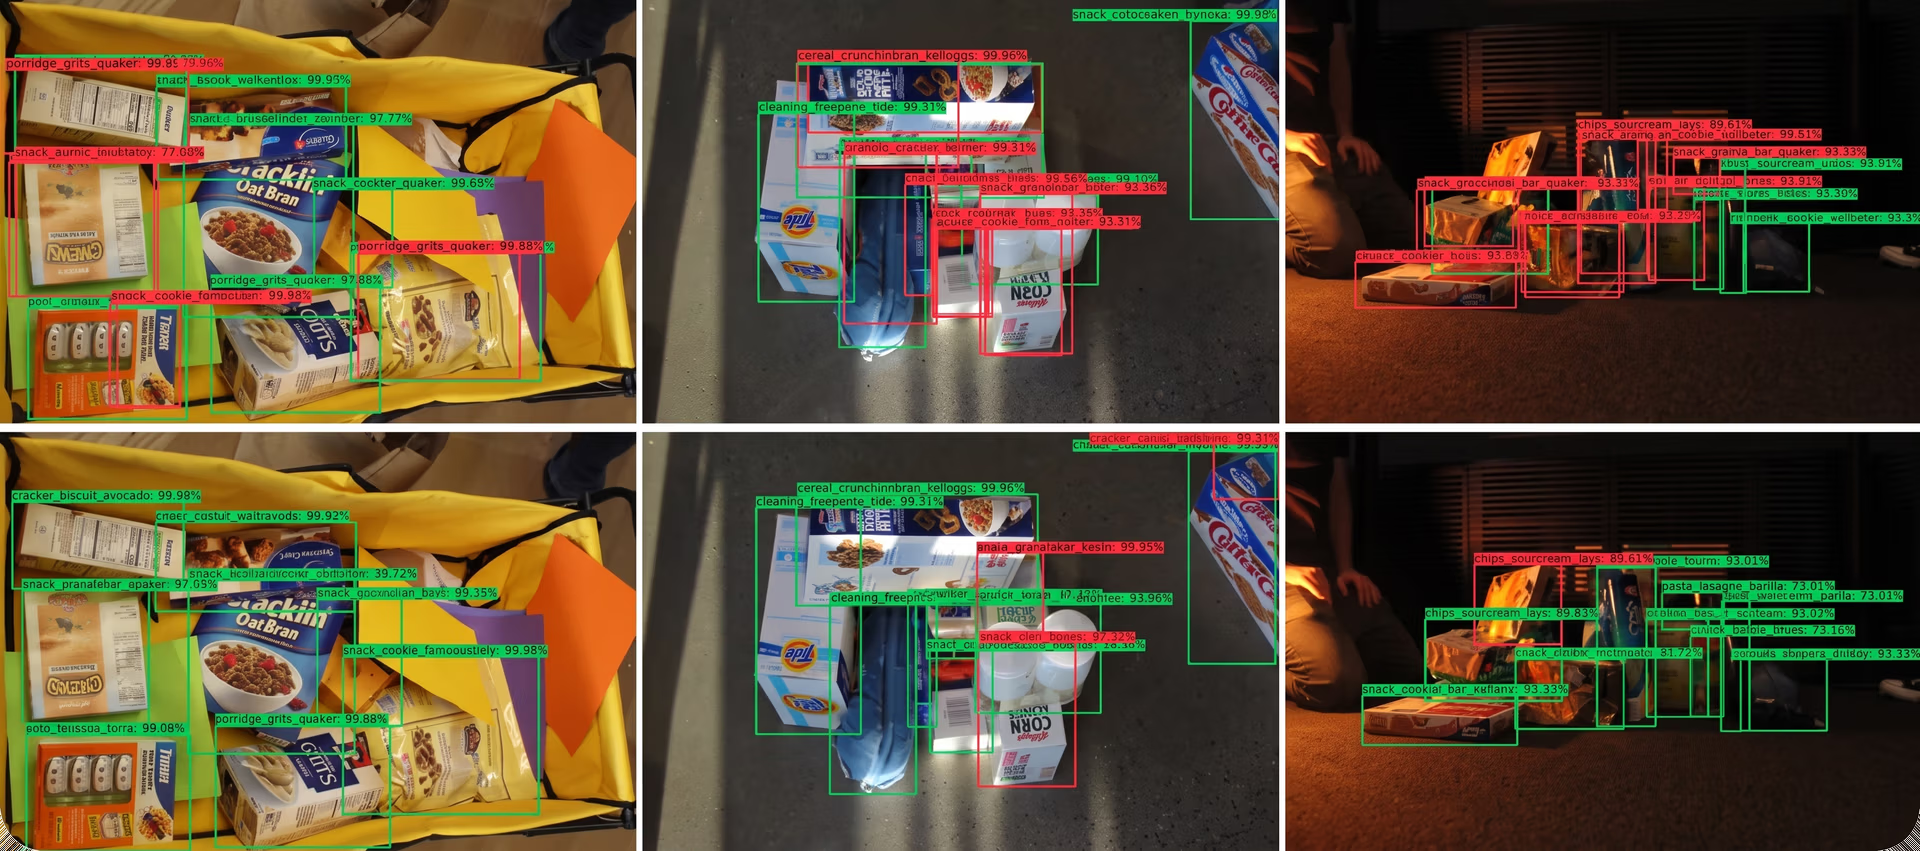
図2 実世界のデータと合成データを組み合わせることで、過学習を抑え、物体検出の精度を高められます。
データ拡張では、既存の画像を反転、回転、クロップしたり、明るさを調整したりして少し変化させます。これにより、モデルが細部を単に記憶するのではなく、さまざまな状況で物体を認識できるようになります。
実画像を入手しにくい場合は、合成データが役立ちます。たとえば、自動運転車のモデルは、コンピューターで生成した道路のシーンを使って学習し、さまざまな天候や照明条件で物体を検出する方法を習得できます。これにより、実世界の画像を何千枚も用意しなくても、モデルの柔軟性と信頼性を高められます。
モデルの複雑さとアーキテクチャを最適化する#
データを単一の層ではなく複数の層で処理する機械学習モデルの一種である、深層ニューラルネットワークが常に優れているとは限りません。モデルの層やパラメーターが多すぎると、より広範なパターンを認識するのではなく、学習データを記憶してしまいます。不要な複雑さを減らすことで、過学習を防ぎやすくなります。
その方法の一つがプルーニングです。冗長なニューロンや接続を取り除き、モデルをより軽量で効率的にします。
もう一つの方法は、層やニューロンの数を減らしてアーキテクチャを簡素化することです。Ultralytics YOLO11のような事前学習済みモデルは、少ないパラメーターでさまざまなタスクに適切に汎化するよう設計されているため、深層モデルをゼロから学習させる場合よりも過学習しにくくなっています。
モデルの深さと効率の適切なバランスを見つけることで、学習データを単に記憶するのではなく、有用なパターンを学習できるようになります。
正則化手法を適用する#
正則化手法は、モデルが学習データ内の特定の特徴に過度に依存するのを防ぎます。よく使われる手法をいくつか紹介します。
- ドロップアウトは、学習中にモデルの一部をランダムに無効化します。これにより、少数の特徴に過度に依存するのではなく、さまざまなパターンを認識できるようになります。
- 重み減衰(L2正則化)は、極端な重みの値を抑制し、モデルの複雑さを適切に保ちます。
- バッチ正規化は、データセットのばらつきに対するモデルの感度を下げ、学習の安定化に役立ちます。
これらの手法は、モデルの柔軟性と適応性を維持し、精度を保ちながら過学習のリスクを抑えるのに役立ちます。
検証と早期終了で学習を監視する#
過学習を防ぐには、モデルの学習状況を追跡し、新しいデータにも適切に汎化することを確認することが重要です。これに役立つ手法をいくつか紹介します。
- 早期終了:モデルの性能が向上しなくなった時点で学習を自動的に終了し、不要な詳細まで学習し続けるのを防ぎます。
- 交差検証:データを複数の部分に分け、それぞれを使ってモデルを学習させます。特定の画像を記憶するのではなく、パターンを学習するのに役立ちます。
これらの手法は、学習データだけに過度に焦点を当てず、十分な学習によって精度を確保できるよう、モデルのバランスを保つのに役立ちます。
事前学習済みモデルを使用し、データセットのラベリングを改善する#
ゼロから学習させる代わりに、Ultralytics YOLO11のような事前学習済みモデルを使うことで、過学習を抑えられます。YOLO11は大規模なデータセットで学習されているため、さまざまな条件に適切に汎化できます。
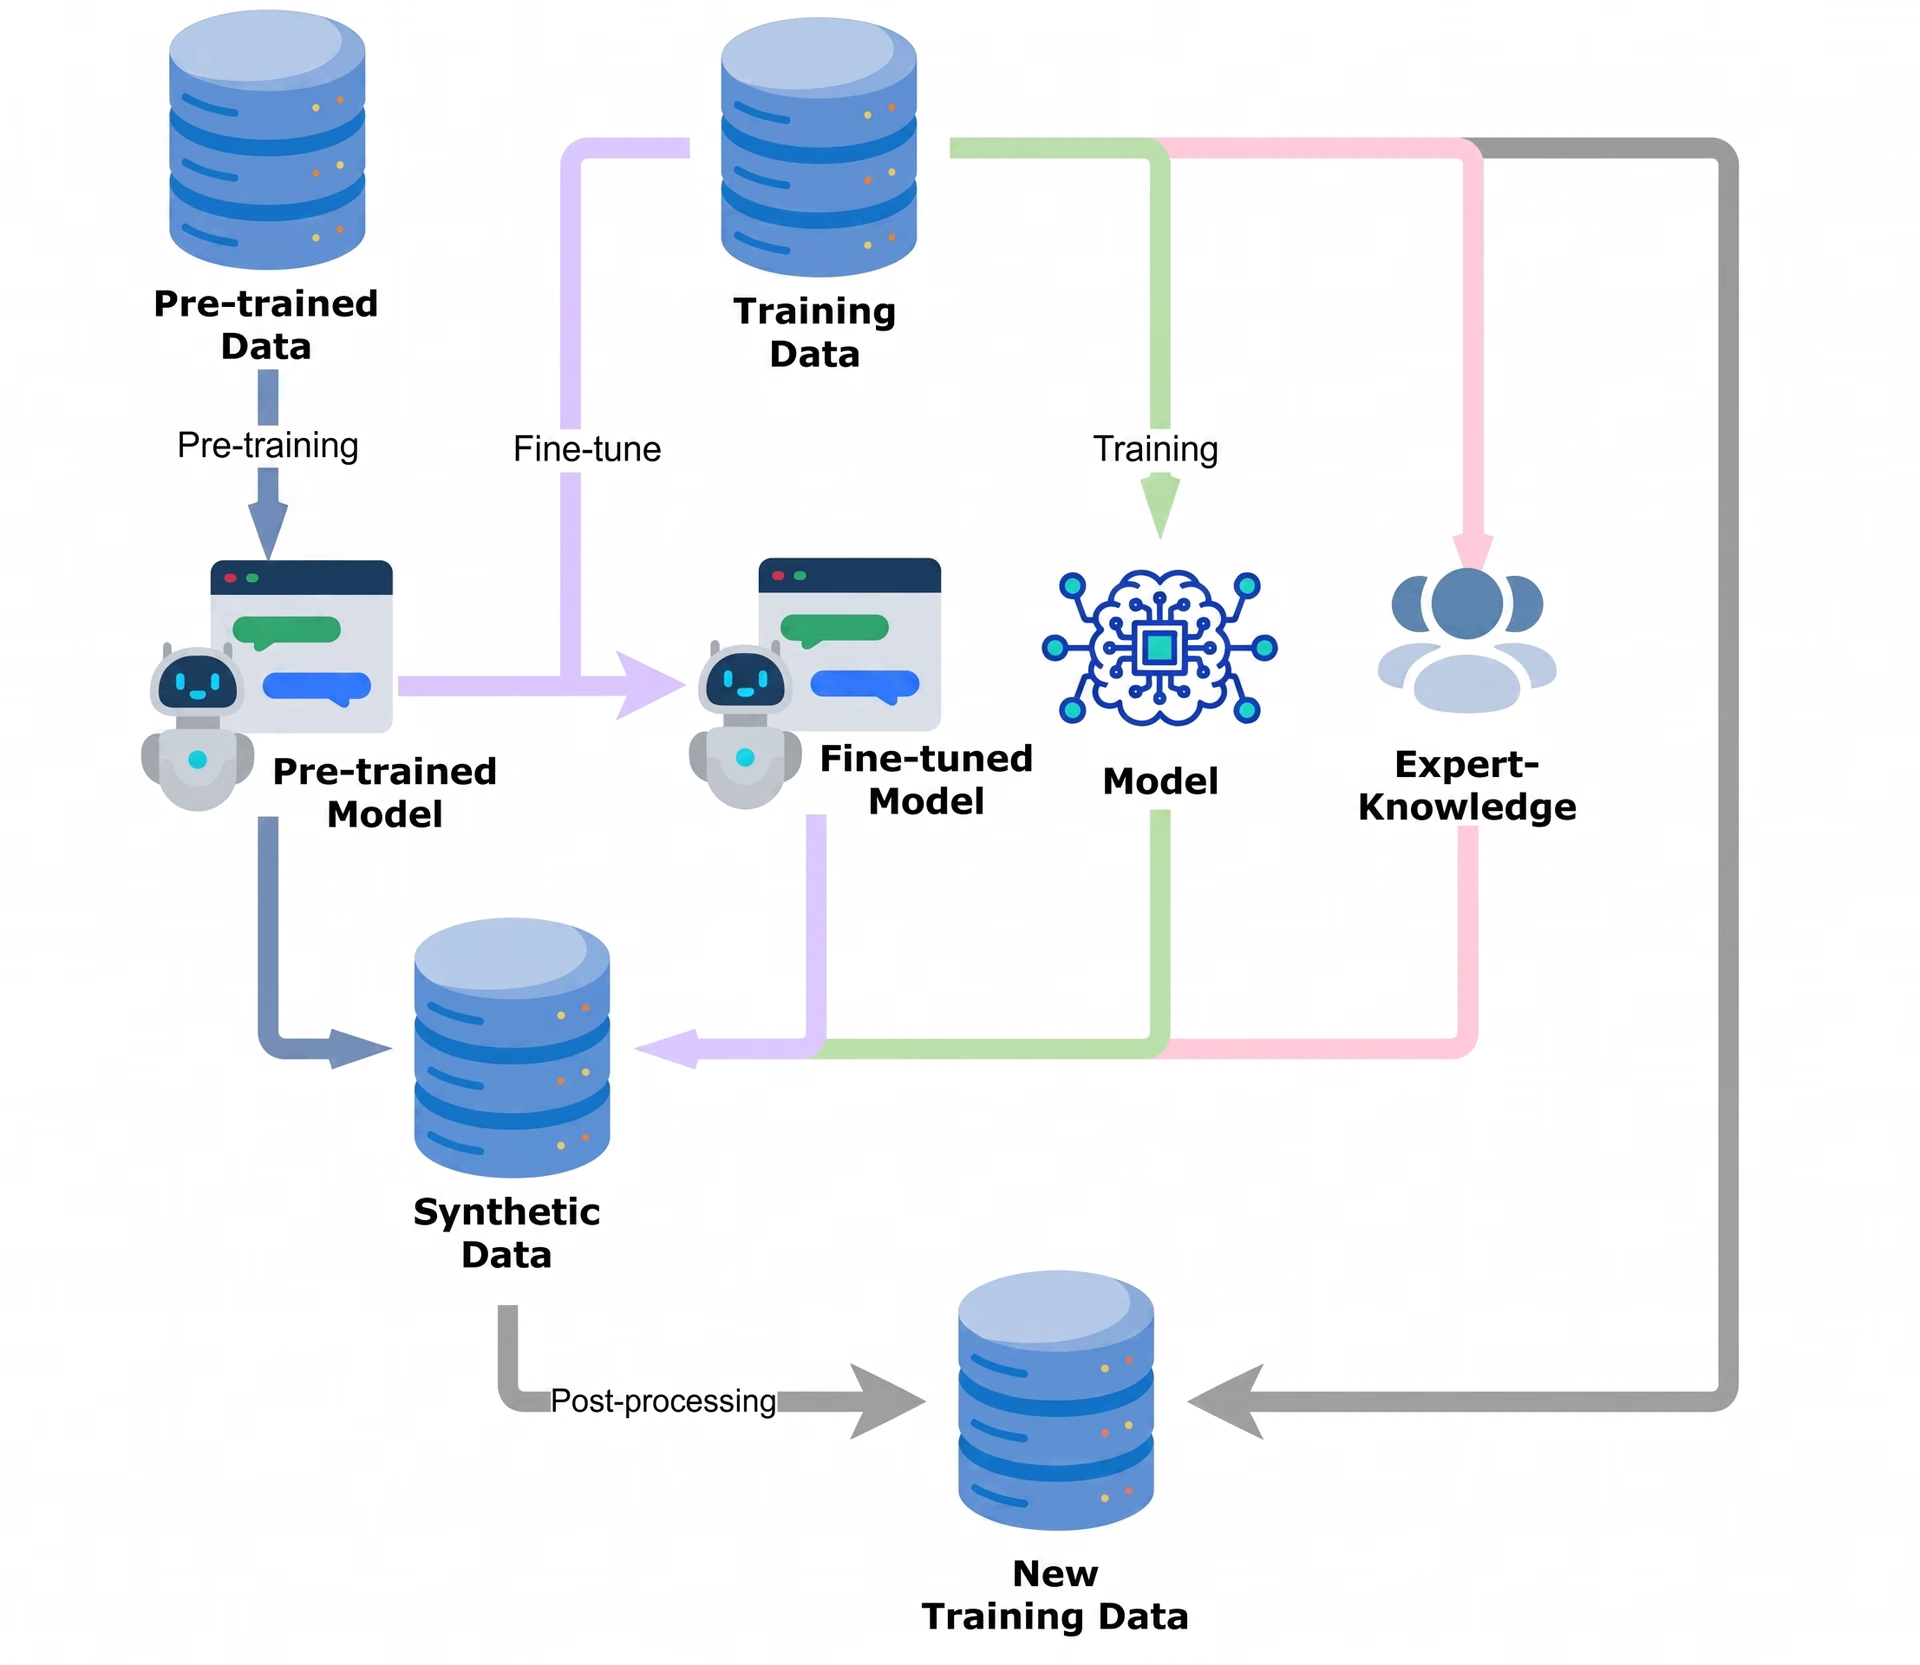
図3 事前学習済みコンピュータービジョンモデルは、精度を高め、過学習を防ぎます。
事前学習済みモデルをファインチューニングすると、既に習得した知識を維持しながら新しいタスクを学習できるため、学習データを単に記憶することを防げます。
さらに、高品質なデータセットのラベリングを確保することも不可欠です。誤ったラベルや不均衡なデータは、モデルに誤ったパターンを学習させるおそれがあります。データセットをクリーニングし、誤ラベルの画像を修正して、クラスのバランスを整えることで、精度が向上し、過学習のリスクが低減します。もう一つの効果的な方法は敵対的学習です。モデルの限界を試すために、わずかに変更したサンプルや、より難易度の高いサンプルをモデルに与えます。
重要なポイント#
過学習は、コンピュータービジョンでよく見られる問題です。モデルが学習データでは良好に動作しても、実世界の画像ではうまくいかないことがあります。これを防ぐには、データ拡張や正則化、Ultralytics YOLO11のような事前学習済みモデルの使用といった手法が、精度と適応性の向上に役立ちます。
これらの手法を適用することで、AIモデルの信頼性を保ち、さまざまな環境で良好な性能を発揮できます。ディープラーニングが進歩するなか、モデルを適切に汎化させることが、実世界でAIを成功させる鍵となります。
成長を続けるコミュニティにぜひご参加ください。AIについて詳しくは、GitHubリポジトリをご覧ください。コンピュータービジョンのプロジェクトを始めませんか?ライセンスの選択肢をご確認ください。自動運転におけるビジョンAIや医療におけるAIについて、ソリューションページでご覧いただけます。









