L'impatto del design più veloce e pensato per l'edge di Ultralytics YOLO26
Scopri come Ultralytics YOLO26 è più veloce sui dispositivi edge e perché è importante per le applicazioni di computer vision di nuova generazione che richiedono bassa latenza ed efficienza.
All'inizio di questa settimana, Ultralytics ha lanciato ufficialmente Ultralytics YOLO26, un modello YOLO più veloce, leggero e compatto, pensato per ridefinire le prestazioni dei sistemi di visione artificiale all'edge. YOLO26 supporta le stesse attività di visione fondamentali dei precedenti modelli YOLO, tra cui il rilevamento degli oggetti e la segmentazione delle istanze.
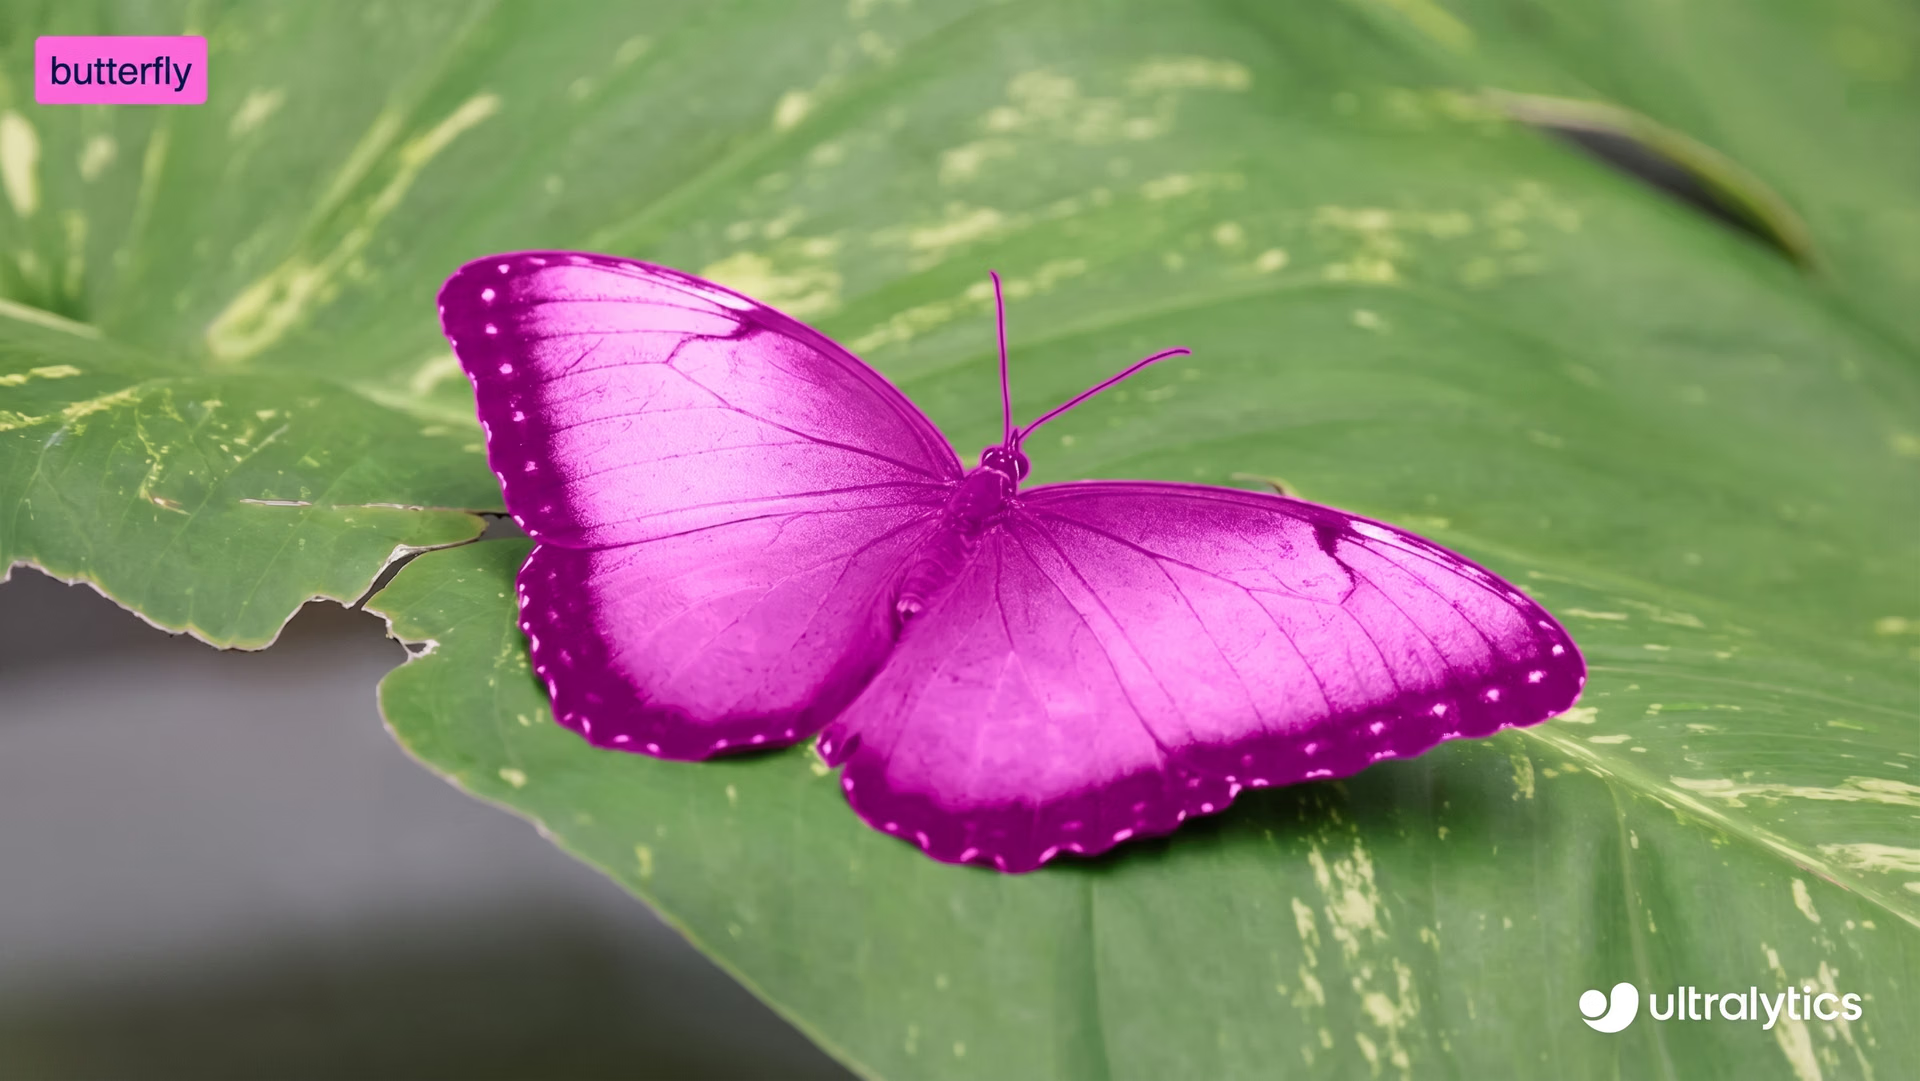
Fig. 1. Esempio di utilizzo di Ultralytics YOLO26 per segmentare un oggetto.
La differenza fondamentale tra Ultralytics YOLO26 e i modelli precedenti riguarda l'ambiente per cui è stato progettato. Invece di ottimizzare soprattutto per le unità di elaborazione grafica (GPU) cloud o per prestazioni misurate sui benchmark, YOLO26 è stato progettato da zero per la distribuzione nel mondo reale su dispositivi edge e hardware embedded.
Man mano che la visione artificiale passa dalla ricerca alla produzione, i limiti prestazionali diventano sempre più evidenti. Gli ambienti edge sono caratterizzati da budget di latenza ridotti, vincoli di memoria, alimentazione e temperatura e dalla necessità di un comportamento prevedibile su piattaforme diverse.
In questi contesti, le prestazioni complessive del sistema dipendono non solo dalla velocità pura di inferenza, ma anche dall'efficienza dell'intera pipeline. L'overhead della post-elaborazione, la pressione sulla memoria e i percorsi di esecuzione specifici della piattaforma sono spesso colli di bottiglia.
Ultralytics YOLO26 affronta queste sfide adottando un approccio più veloce e progettato prima di tutto per l'edge, che considera l'intera pipeline di inferenza anziché le metriche dei singoli modelli. Concentrandosi sull'ottimizzazione per l'edge, semplificando la pipeline di inferenza ed eliminando le fasi di post-elaborazione non necessarie, YOLO26 migliora la velocità, riducendo la latenza e rendendo il comportamento in produzione più affidabile.
In questo articolo vedremo come le scelte architetturali di Ultralytics YOLO26 si traducono in miglioramenti prestazionali nel mondo reale e perché essere più veloci all'edge cambia radicalmente ciò che è possibile fare con le applicazioni di visione artificiale di nuova generazione.
La realtà della distribuzione all'edge#
Eseguire modelli di visione artificiale all'edge è molto diverso dall'eseguirli nel cloud. Negli ambienti cloud, i sistemi hanno in genere accesso a GPU potenti, molta memoria e hardware stabile. All'edge, invece, queste stesse condizioni non sono garantite.
La maggior parte delle distribuzioni edge si basa su architetture hardware diverse, non su GPU. I dispositivi utilizzano in genere più processori specializzati per attività diverse, ottimizzati per l'efficienza e i bassi consumi anziché per la pura capacità di calcolo delle GPU cloud.
La latenza è un altro vincolo importante. Spesso i sistemi edge devono rispettare limiti rigorosi di tempo reale, in cui anche piccoli ritardi possono influire sulla reattività o sulla sicurezza. In questi casi, la latenza end-to-end è più importante della velocità pura di inferenza. Un modello può sembrare veloce sulla carta, ma non essere all'altezza quando si aggiungono la post-elaborazione e lo spostamento dei dati.
Anche la memoria ha un ruolo importante. Molti dispositivi edge hanno memoria limitata e cache condivise. Tensori intermedi di grandi dimensioni e un utilizzo inefficiente della memoria possono rallentare i sistemi, anche quando il modello è efficiente.
I limiti di alimentazione e temperatura impongono ulteriori vincoli. Spesso i dispositivi edge funzionano senza raffreddamento attivo e con budget di potenza fissi. Le prestazioni devono essere efficienti e sostenibili, non solo veloci per brevi periodi.
Inoltre, le distribuzioni edge richiedono coerenza. I modelli devono comportarsi allo stesso modo su dispositivi e ambienti di esecuzione diversi. Il codice specifico per piattaforma o le complesse fasi di post-elaborazione possono introdurre sottili differenze che rendono i sistemi più difficili da distribuire e mantenere.
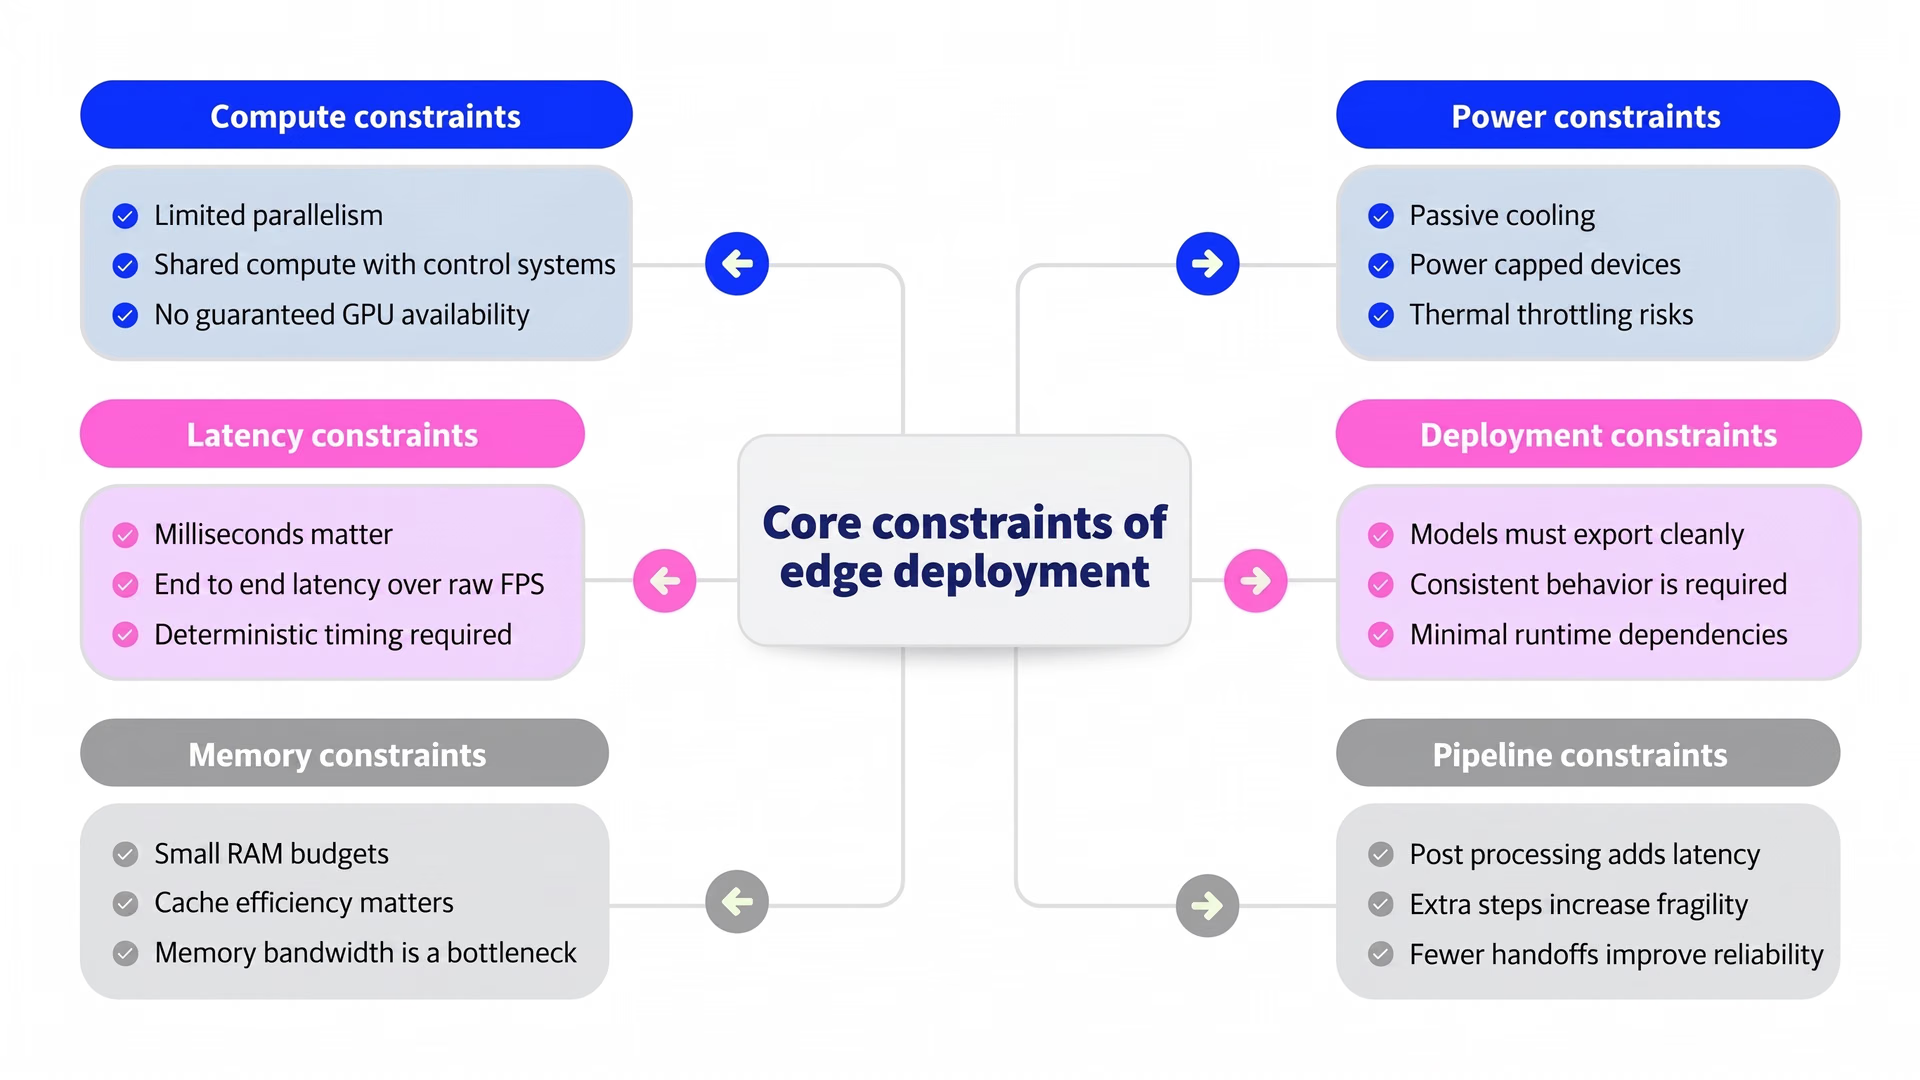
Fig. 2. Uno sguardo ai vincoli della distribuzione all'edge. Immagine dell'autore.
Questi vincoli definiscono il vero significato delle prestazioni all'edge. In altre parole, le prestazioni dipendono dall'intera pipeline, non da una singola metrica.
Perché la visione all'edge richiede un modello prestazionale diverso#
In che modo i vincoli della distribuzione all'edge sono collegati ai requisiti di un modello di visione artificiale progettato per l'edge? Il nesso diventa chiaro quando i modelli passano dalla ricerca ai sistemi reali.
Negli ambienti cloud, le prestazioni si misurano spesso con benchmark che valutano la velocità di inferenza e la precisione. All'edge, queste metriche raccontano solo una parte della storia. In genere, i sistemi di visione funzionano su hardware eterogeneo, dove l'inferenza della rete neurale è affidata ad acceleratori specializzati, mentre altre parti della pipeline vengono eseguite su processori generici.
In questo contesto, la velocità del modello non basta. È fondamentale il comportamento dell'intero sistema dopo la distribuzione del modello. Un modello può sembrare veloce da solo, ma non essere all'altezza se la post-elaborazione, lo spostamento dei dati o le fasi specifiche della piattaforma introducono overhead.
Per questo la visione all'edge richiede un modello prestazionale incentrato sull'efficienza a livello di sistema, anziché su benchmark isolati. Ultralytics YOLO26 riflette questo cambiamento concentrandosi sull'ottimizzazione pensata prima di tutto per l'edge, sull'inferenza semplificata e sull'esecuzione end-to-end progettata per la distribuzione nel mondo reale.
Le basi della velocità: un design pensato prima di tutto per l'edge#
All'edge, le prestazioni dipendono da quanto bene un modello si adatta all'effettiva architettura hardware del dispositivo. Progettare prima di tutto per l'edge garantisce che i sistemi di visione funzionino in modo affidabile sulle piattaforme del mondo reale, indipendentemente dalla combinazione specifica di unità di elaborazione disponibili.
Un approccio pensato prima di tutto per l'edge dà priorità a un'esecuzione prevedibile ed efficiente su hardware eterogeneo, invece di adattare a posteriori modelli ottimizzati per GPU cloud. In poche parole, significa preferire operazioni che si adattano bene agli acceleratori per reti neurali, ridurre al minimo le attività non neurali esterne al modello e limitare la complessità superflua che può rallentare l'esecuzione end-to-end.
Ultralytics YOLO26 è stato progettato tenendo conto di questi vincoli. La sua architettura punta a prestazioni coerenti, anziché a una produttività massima in condizioni ideali. Semplificando i percorsi di esecuzione ed eliminando i calcoli non necessari, YOLO26 riduce l'overhead dell'intera pipeline di inferenza e sfrutta meglio l'accelerazione disponibile e la gerarchia di memoria del dispositivo.
Questo approccio migliora anche l'affidabilità. L'ottimizzazione pensata prima di tutto per l'edge offre tempi più prevedibili e meno picchi prestazionali, caratteristiche fondamentali per i sistemi in tempo reale. Invece di affidarsi a hardware specializzato o a una post-elaborazione pesante per raggiungere la velocità, Ultralytics YOLO26 punta sull'efficienza in tutta la pipeline di inferenza.
L'inferenza end-to-end e il costo della post-elaborazione#
Ti starai chiedendo cosa significhi eliminare le fasi di post-elaborazione non necessarie. Per capirlo, facciamo un passo indietro e vediamo come funzionano i sistemi tradizionali di rilevamento degli oggetti.
In molte pipeline di rilevamento degli oggetti, l'inferenza non termina quando il modello produce le sue previsioni. Il modello genera invece un gran numero di riquadri di delimitazione sovrapposti, che devono essere filtrati e perfezionati prima di poter essere utilizzati. Questa fase di pulizia avviene tramite passaggi di post-elaborazione eseguiti al di fuori del modello stesso.
Una delle fasi di post-elaborazione più comuni è la soppressione non massima, o NMS. NMS confronta i riquadri di delimitazione sovrapposti e mantiene solo i rilevamenti con il maggiore livello di confidenza, rimuovendo i duplicati che si riferiscono allo stesso oggetto. Sebbene questo approccio sia efficace, introduce calcoli aggiuntivi al termine dell'inferenza.
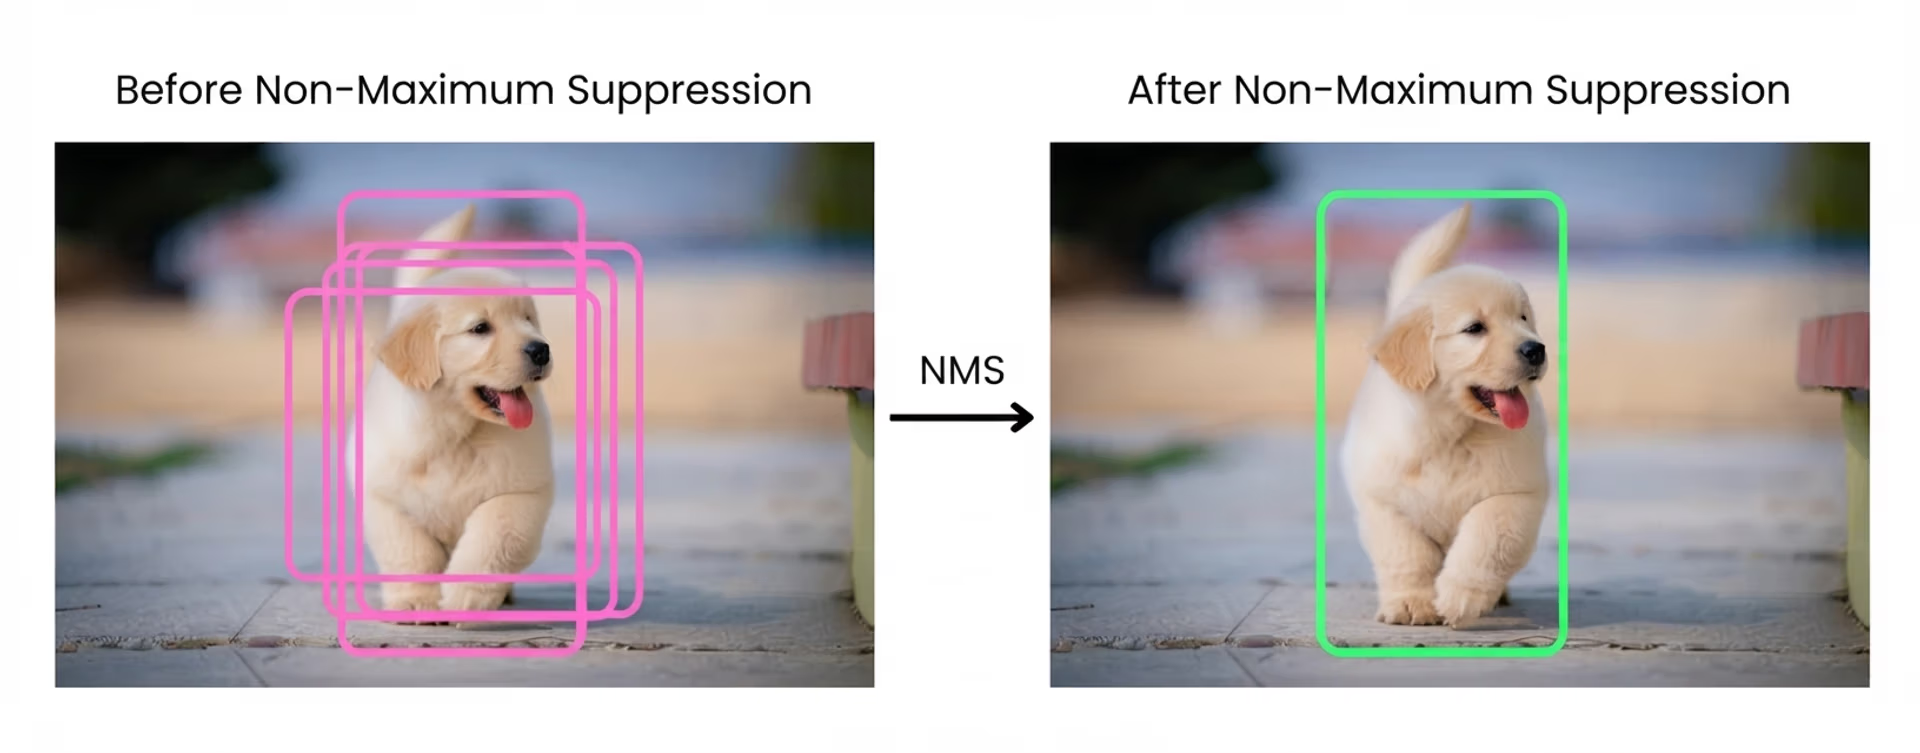
Fig. 3. Come funziona NMS. Immagine dell'autore.
All'edge, questo lavoro aggiuntivo ha un costo. Le fasi di post-elaborazione come NMS non sono adatte agli acceleratori specializzati utilizzati per l'inferenza delle reti neurali, ottimizzati per calcoli neurali densi anziché per operazioni con molto controllo o un uso intensivo della memoria.
Di conseguenza, NMS aggiunge latenza e overhead di memoria, e il suo costo aumenta con il numero di rilevamenti. Anche quando il modello è veloce, NMS può comunque occupare una parte significativa del tempo di esecuzione totale.
La post-elaborazione aumenta anche la complessità del sistema. Poiché viene eseguita al di fuori del modello, deve essere implementata separatamente per ambienti di esecuzione e piattaforme hardware diversi. Questo spesso comporta percorsi di codice specifici per piattaforma, comportamenti incoerenti tra dispositivi e pipeline di distribuzione più fragili.
Soprattutto, la post-elaborazione vanifica il concetto di vere prestazioni end-to-end. Misurare la velocità di inferenza del modello non rispecchia il comportamento del sistema in produzione. Ciò che conta davvero è il tempo totale dall'input all'output finale, inclusi tutti i passaggi della pipeline.
In queste situazioni, la post-elaborazione diventa un collo di bottiglia nascosto all'edge. Aggiunge latenza, consuma risorse della CPU e complica la distribuzione, pur rimanendo al di fuori del modello stesso.
Come Ultralytics YOLO26 rimuove NMS e perché questo lo rende più veloce#
YOLO26 rimuove NMS affrontando la causa principale dei rilevamenti duplicati, anziché eliminarli dopo l'inferenza. Invece di produrre molte previsioni sovrapposte da filtrare, il modello viene addestrato per generare direttamente un insieme più piccolo di rilevamenti finali con un elevato livello di confidenza.
Questo è possibile modificando il modo in cui i rilevamenti vengono appresi durante l'addestramento. Ultralytics YOLO26 favorisce una corrispondenza one-to-one più chiara tra oggetti e previsioni, riducendo la ridondanza alla fonte. Di conseguenza, i rilevamenti duplicati vengono risolti direttamente all'interno della rete, anziché tramite post-elaborazione esterna.
La rimozione di NMS ha un impatto immediato sulle prestazioni all'edge. Poiché NMS non si adatta bene agli acceleratori per reti neurali, eliminarlo riduce lo spostamento dei dati in memoria ed evita costose fasi di elaborazione non neurale. Questo riduce la latenza end-to-end e rende le prestazioni più prevedibili, soprattutto sui dispositivi edge, dove la post-elaborazione può altrimenti occupare una parte significativa del tempo di esecuzione totale.
Semplifica anche la pipeline di inferenza. Riducendo i passaggi esterni al modello, diminuiscono lo spostamento dei dati e i passaggi di consegne tra componenti. L'output del modello è già il risultato finale, rendendo l'esecuzione più prevedibile.
La rimozione di DFL per ottenere vere prestazioni end-to-end#
Un'altra innovazione di Ultralytics YOLO26 è la rimozione della Distribution Focal Loss, o DFL, utilizzata nei precedenti modelli YOLO per la regressione dei riquadri di delimitazione. Invece di prevedere direttamente una singola coordinata, i modelli che utilizzavano DFL apprendevano una distribuzione di valori possibili, da cui ricavavano poi un riquadro di delimitazione finale. Questo approccio contribuiva a migliorare la precisione della localizzazione ed è stato un importante passo avanti nelle generazioni precedenti.
Nel tempo, però, DFL ha comportato anche alcuni compromessi. Predire distribuzioni aumenta i calcoli e aggiunge complessità all'architettura del modello, rallentando l'inferenza sulle CPU e rendendo più difficile esportare i modelli nei diversi formati di distribuzione. DFL imponeva inoltre intervalli di regressione fissi, che potevano limitare la flessibilità nel rilevamento di oggetti molto grandi.
Ultralytics YOLO26 rimuove DFL per passare a un design più semplice ed end-to-end. La regressione dei riquadri di delimitazione è stata riprogettata per essere più diretta, riducendo i calcoli non necessari e mantenendo la precisione. Questa modifica è in linea con l'approccio di YOLO26 senza NMS.
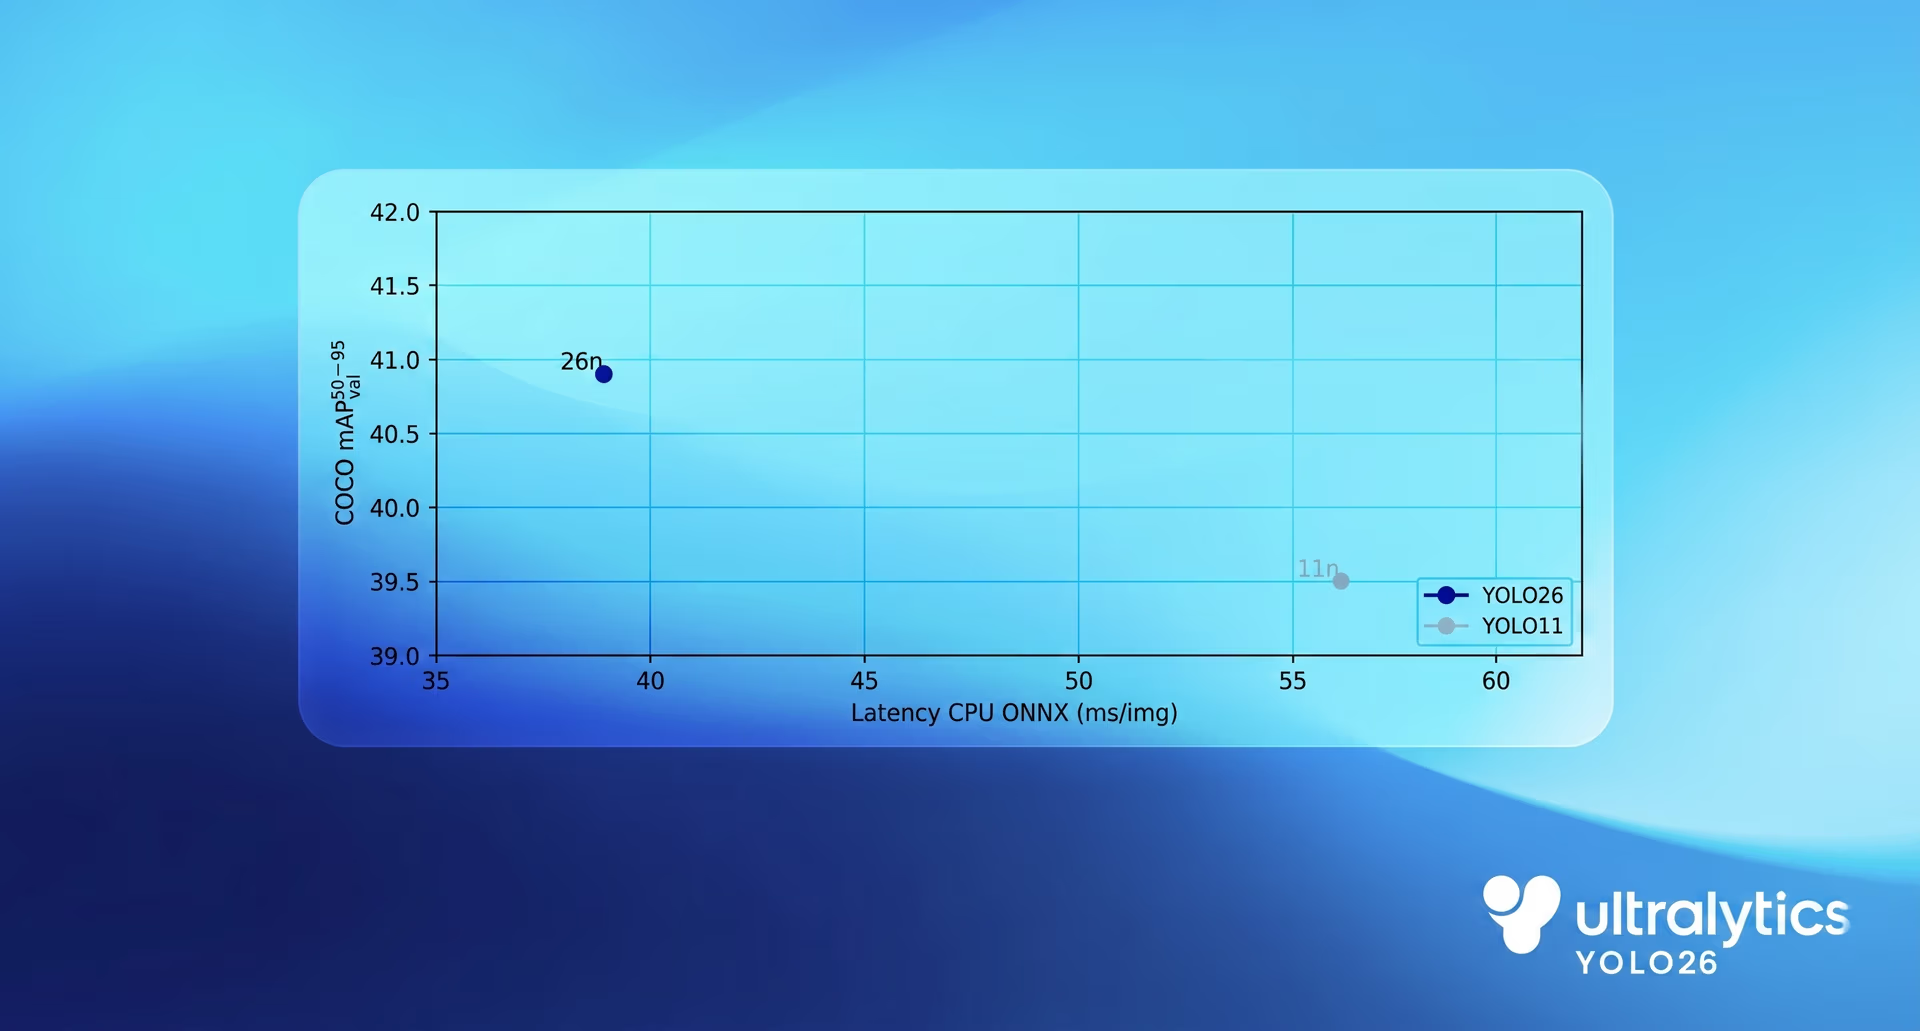
Da dove deriva il 43% di velocità in più nell'inferenza su CPU#
Nei benchmark basati su CPU, YOLO26 mostra un chiaro miglioramento prestazionale rispetto ai modelli YOLO precedenti. Rispetto a Ultralytics YOLO11, il modello nano di YOLO26 offre un'inferenza su CPU fino al 43% più veloce, una differenza significativa nelle distribuzioni edge del mondo reale.
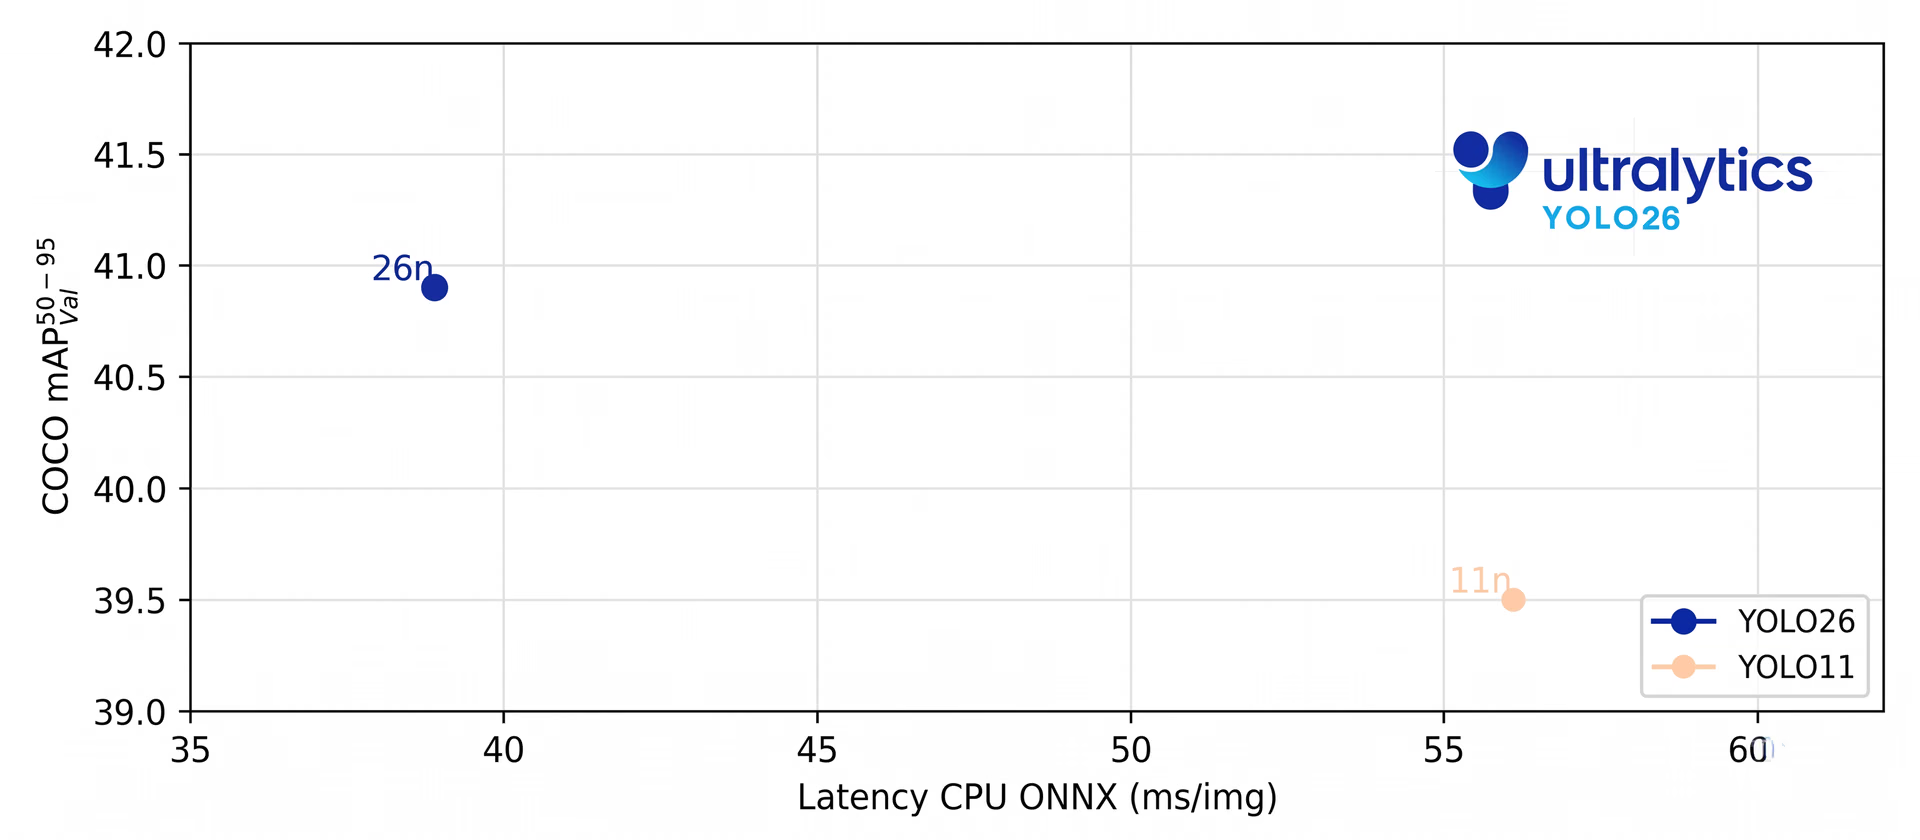
Fig. 4. Benchmark della velocità di Ultralytics YOLO26 su CPU.
Questo miglioramento deriva dalla semplificazione dell'intera pipeline di inferenza, anziché dall'ottimizzazione di un singolo componente. L'esecuzione end-to-end elimina l'overhead della post-elaborazione, un metodo più diretto di regressione dei riquadri di delimitazione riduce i calcoli e le scelte progettuali orientate prima di tutto alla CPU migliorano l'efficienza di esecuzione sui processori generici.
Nel complesso, queste modifiche riducono la latenza e il carico sulla CPU, offrendo prestazioni più rapide e coerenti sull'hardware edge del mondo reale.
L'impatto di Ultralytics YOLO26 sulla distribuzione all'edge e sulle esportazioni#
I miglioramenti prestazionali di Ultralytics YOLO26 vanno oltre la maggiore velocità di inferenza. Semplificando il modello e riducendo l'overhead di memoria, la distribuzione diventa più facile e l'esecuzione più affidabile negli ambienti edge.
Il design end-to-end di Ultralytics YOLO26 semplifica anche l'esportazione. Con meno componenti ausiliari e senza fasi di post-elaborazione esterne, i modelli esportati sono completamente autonomi. Questo riduce le dipendenze specifiche della piattaforma e contribuisce a garantire un comportamento coerente tra ambienti di esecuzione e piattaforme hardware diversi.
In pratica, questo significa che Ultralytics YOLO26 può essere distribuito più facilmente su dispositivi edge come telecamere, robot e sistemi embedded, utilizzando vari formati di esportazione. Ciò che esporti è ciò che esegui, con meno passaggi di integrazione e meno rischi di divergenze dopo la distribuzione.
L'inferenza edge più veloce abilita la robotica e l'IA per la visione industriale#
Finora abbiamo visto come il design di Ultralytics YOLO26 pensato prima di tutto per l'edge migliori le prestazioni a livello di sistema. Il vero impatto, tuttavia, consiste nel rendere più semplice integrare l'IA per la visione nelle applicazioni del mondo reale.
Per esempio, negli ambienti di robotica e industriali, spesso i sistemi di visione operano con rigorosi vincoli di tempo reale. Le decisioni devono essere prese rapidamente e con coerenza, usando risorse di calcolo limitate e senza dipendere dalla connettività cloud. Con Ultralytics YOLO26, soddisfare questi requisiti diventa concretamente possibile.
Applicazioni come la navigazione robotica e la manipolazione di oggetti traggono vantaggio da una latenza inferiore e da inferenze più prevedibili, consentendo ai robot di reagire senza intoppi ai cambiamenti dell’ambiente circostante. Allo stesso modo, negli ambienti industriali, i modelli di visione possono essere eseguiti direttamente sulle linee di produzione per rilevare difetti, tracciare componenti e monitorare i processi senza introdurre ritardi o maggiore complessità.
Consentendo inferenze rapide e affidabili sull’hardware edge, Ultralytics YOLO26 contribuisce a rendere la visione artificiale una componente naturale dei sistemi robotici e industriali, anziché una sfida da affrontare in fase di implementazione e manutenzione.
Punti chiave#
Ultralytics YOLO26 è stato progettato per l’edge, dove vincoli reali come latenza, memoria e affidabilità determinano ciò che è possibile fare. Progettando il modello per un’esecuzione incentrata sulla CPU, inferenze end-to-end e un’implementazione più semplice, YOLO26 rende pratica l’integrazione della visione artificiale nei sistemi reali. Questo approccio edge-first consente un’ampia gamma di applicazioni, dalla robotica e dalla visione industriale all’IA embedded e on-device, dove prestazioni e prevedibilità sono fondamentali.
Unisciti alla nostra community in crescita ed esplora il nostro repository GitHub per trovare risorse pratiche sull’IA. Per iniziare a sviluppare con la visione artificiale oggi stesso, esplora le nostre opzioni di licenza. Scopri come l’IA in agricoltura sta trasformando il settore agricolo e come la visione artificiale in ambito sanitario sta plasmando il futuro visitando le nostre pagine dedicate alle soluzioni.









