Perché Ultralytics YOLO26 rimuove NMS e come cambia il deployment
Scopri come Ultralytics YOLO26 abilita un’inferenza realmente end-to-end e senza NMS e perché la rimozione del post-processing semplifica l’esportazione e il deployment sui dispositivi edge.
Il 14 gennaio abbiamo lanciato Ultralytics YOLO26, la generazione più recente dei nostri modelli di computer vision. Con YOLO26, il nostro obiettivo non era soltanto migliorare la precisione o la velocità, ma ripensare il modo in cui i modelli di rilevamento degli oggetti vengono sviluppati e implementati nei sistemi reali.
Man mano che la computer vision passa dalla ricerca alla produzione, ci si aspetta sempre più che i modelli funzionino su CPU, dispositivi edge, fotocamere, robot e hardware embedded. In questi ambienti, affidabilità, bassa latenza e facilità di implementazione sono importanti tanto quanto le prestazioni.
Ultralytics YOLO26 è stato progettato tenendo conto di questa realtà, utilizzando un'architettura end-to-end semplificata che elimina la complessità non necessaria dalla pipeline di inferenza. Una delle innovazioni più importanti introdotte in YOLO26 è la rimozione della soppressione non massima, comunemente nota come NMS.
Per anni, NMS è stata una componente standard dei sistemi di rilevamento degli oggetti, utilizzata come fase di post-processing per eliminare i rilevamenti duplicati. Sebbene efficace, introduceva anche calcoli aggiuntivi e difficoltà di implementazione, soprattutto sull'hardware edge.
Con YOLO26 abbiamo adottato un approccio diverso. Ripensando il modo in cui le predizioni vengono generate e apprese, abilitiamo un'inferenza realmente end-to-end e senza NMS. Il modello produce direttamente i rilevamenti finali, senza dipendere da fasi esterne di pulizia o da regole definite manualmente. Questo rende YOLO26 più veloce, più facile da esportare e più affidabile da implementare su un'ampia gamma di piattaforme hardware.
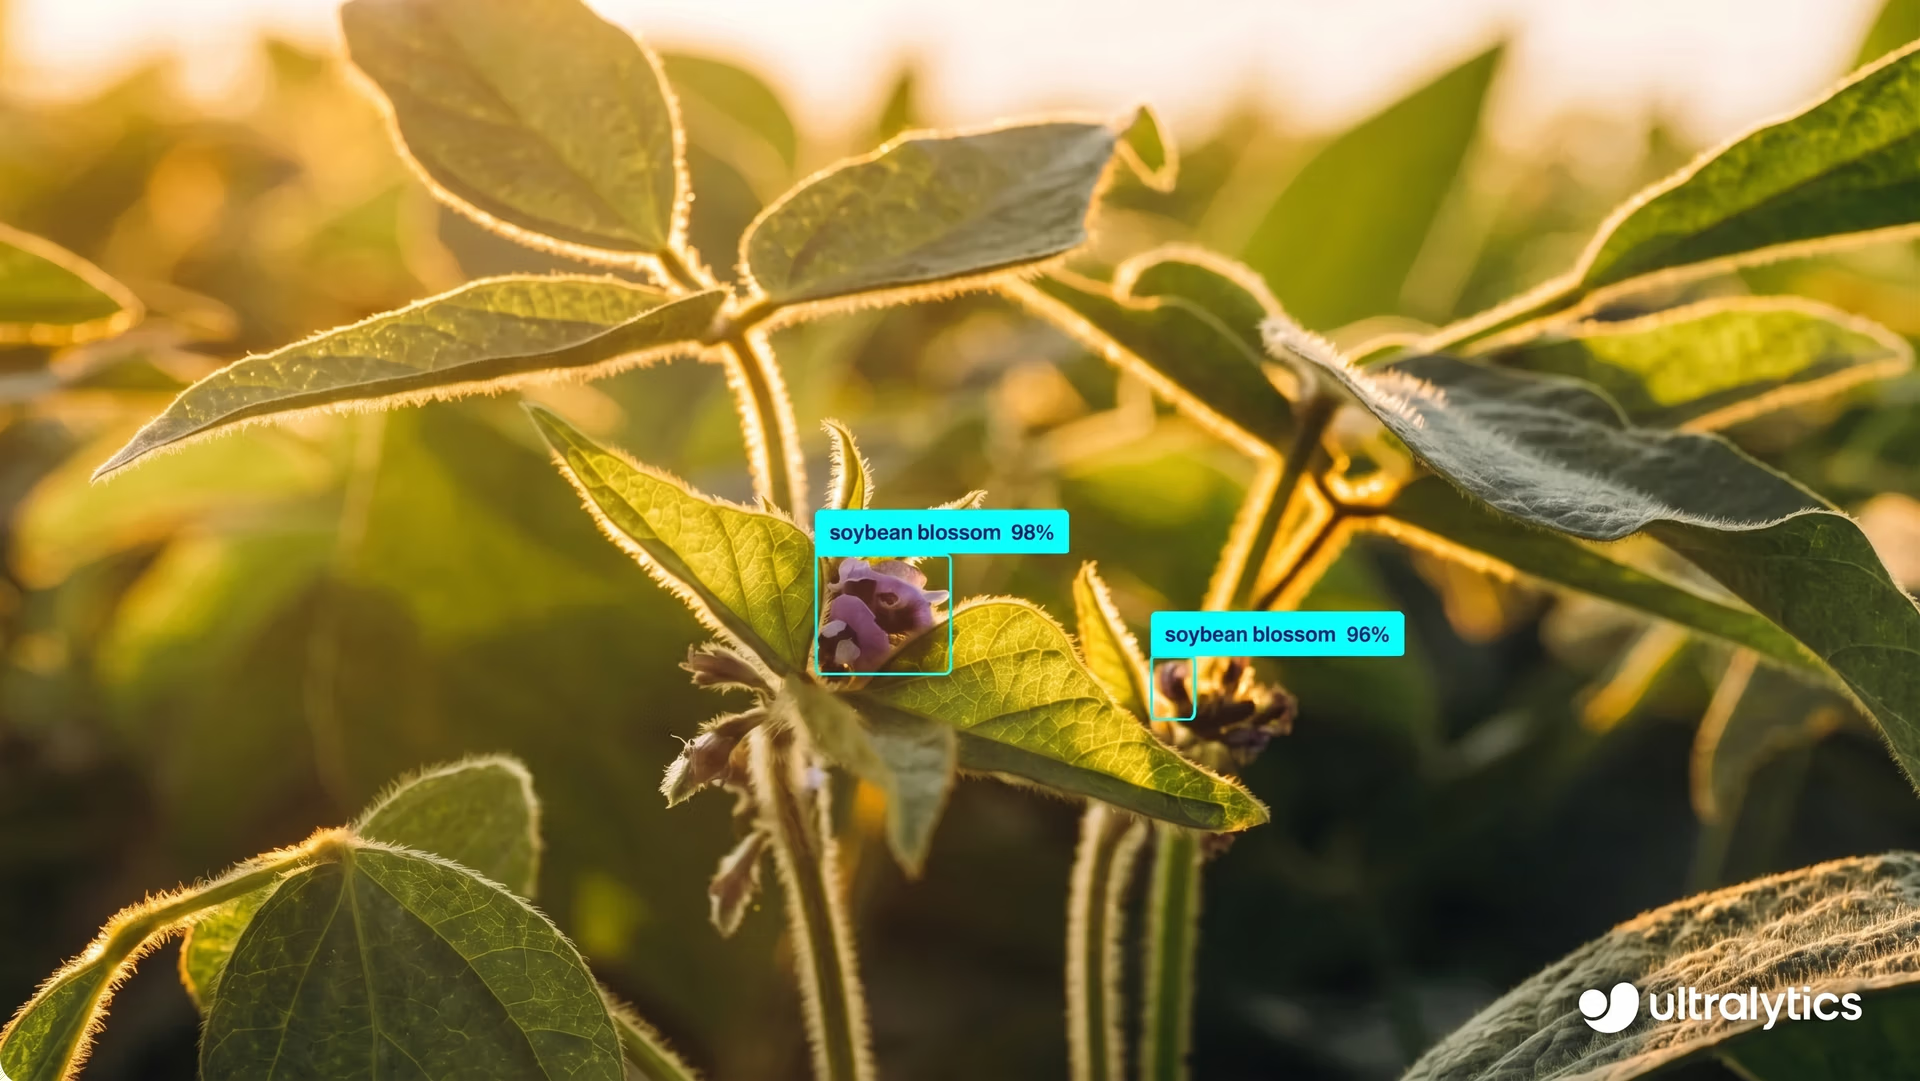
Fig. 1. Rilevamento degli oggetti in un'immagine utilizzando Ultralytics YOLO26.
In questo articolo analizzeremo più da vicino perché il rilevamento tradizionale degli oggetti si basava su NMS, come NMS sia diventata un collo di bottiglia per l'implementazione e come Ultralytics YOLO26 elimini la necessità di soluzioni alternative. Iniziamo!
Il rilevamento tradizionale degli oggetti produce rilevamenti duplicati#
Prima di approfondire cos'è NMS e perché l'abbiamo rimossa in Ultralytics YOLO26, facciamo un passo indietro e osserviamo come i modelli tradizionali di rilevamento degli oggetti generano le loro predizioni.
I modelli tradizionali di rilevamento degli oggetti producono spesso più bounding box sovrapposti per lo stesso oggetto. Ognuno di questi box ha il proprio punteggio di confidenza, anche se si riferiscono tutti allo stesso oggetto nell'immagine.
Questo accade per alcuni motivi. Innanzitutto, il modello effettua predizioni contemporaneamente in molte posizioni spaziali e a scale diverse. Questo aiuta il modello a rilevare oggetti di dimensioni diverse, ma significa anche che più posizioni vicine possono identificare indipendentemente lo stesso oggetto.
In secondo luogo, molti sistemi di rilevamento degli oggetti utilizzano approcci basati su anchor, che generano un gran numero di box candidati attorno a ogni posizione. Sebbene ciò aumenti la probabilità di individuare accuratamente gli oggetti, aumenta anche il numero di predizioni sovrapposte.
Infine, il rilevamento basato su griglia porta naturalmente a una certa ridondanza. Quando un oggetto si trova vicino al confine di più celle della griglia, diverse celle possono predire un box per quell'oggetto, generando più rilevamenti sovrapposti.
Per questo motivo, l'output grezzo del modello contiene spesso diversi box per un singolo oggetto. Per rendere utilizzabili i risultati, queste predizioni ridondanti devono essere filtrate in modo che rimanga un solo rilevamento finale.
Comprendere la soppressione non massima#
Quando un modello di rilevamento degli oggetti produce più bounding box sovrapposti per lo stesso oggetto, i risultati devono essere ripuliti prima di poter essere utilizzati. È qui che viene applicata la soppressione non massima.
La soppressione non massima è una fase di post-processing che viene eseguita dopo che il modello ha terminato di elaborare le predizioni. Il suo scopo è ridurre i rilevamenti duplicati, così che ogni oggetto sia rappresentato da un singolo bounding box finale.
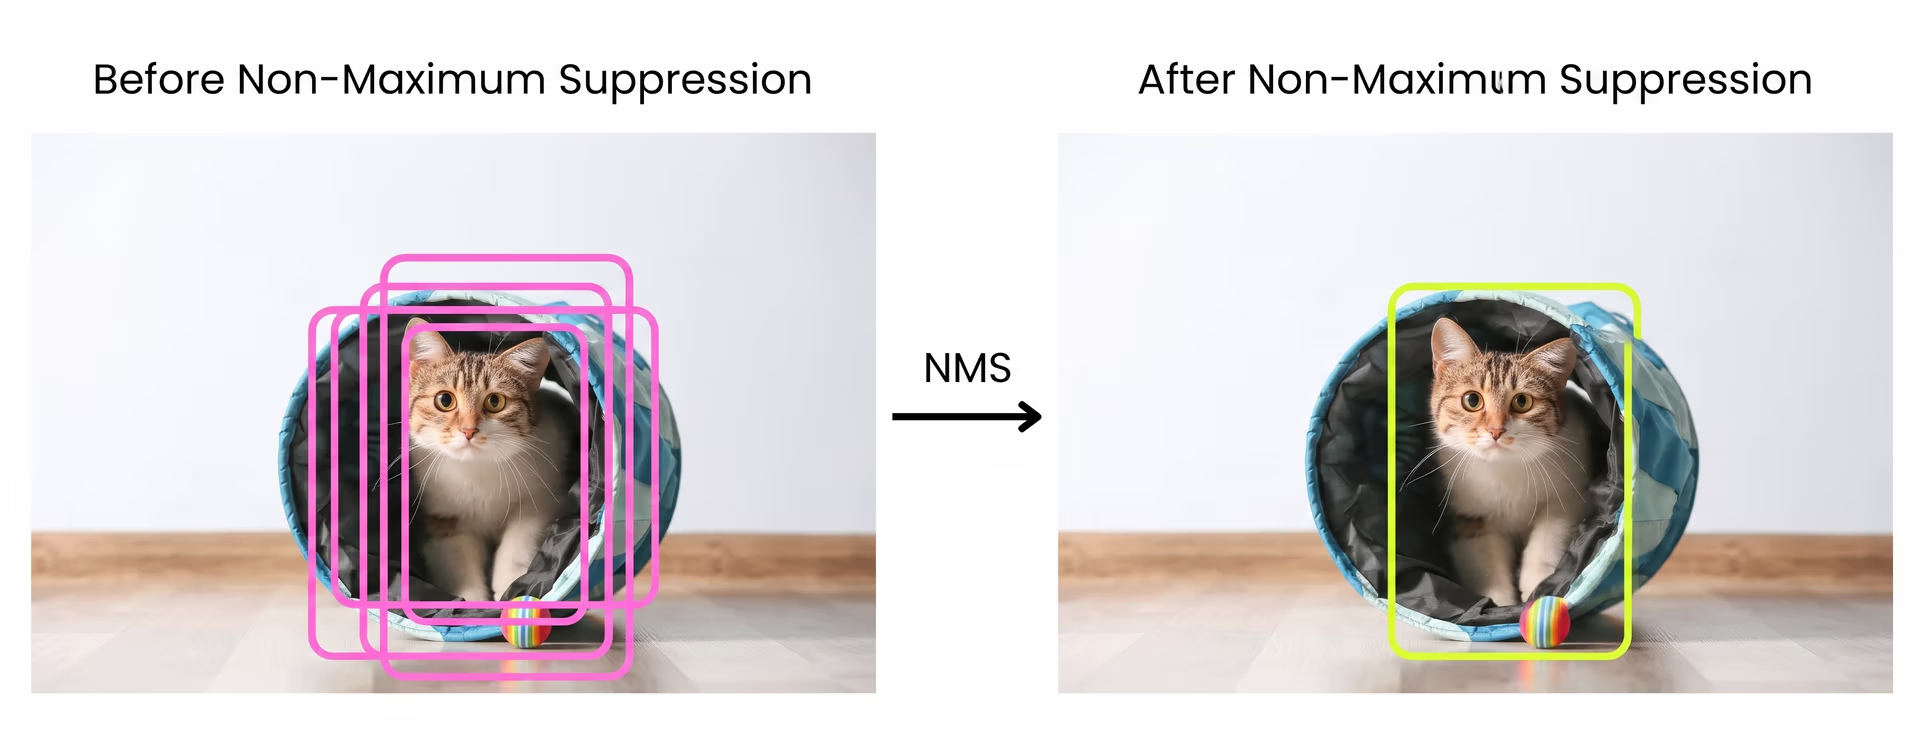
Fig. 2. Panoramica di NMS. Immagine dell'autore.
Il processo funziona confrontando i bounding box in base ai relativi punteggi di confidenza e al grado di sovrapposizione. Le predizioni con confidenza molto bassa vengono rimosse per prime.
I box rimanenti vengono quindi ordinati in base alla confidenza e il box con il punteggio più alto viene selezionato come rilevamento migliore. Il box selezionato viene confrontato con gli altri box.
Se un altro box si sovrappone eccessivamente a quello selezionato, viene soppresso e rimosso. La sovrapposizione viene generalmente misurata tramite Intersezione sull'unione, una metrica che calcola il rapporto tra l'area condivisa da due box e l'area totale coperta da entrambi. Il processo si ripete finché rimangono soltanto i rilevamenti più affidabili e non sovrapposti.
Perché NMS complica l'implementazione#
Sebbene la soppressione non massima aiuti a filtrare i rilevamenti duplicati, introduce anche difficoltà che diventano più evidenti quando i modelli passano dalla ricerca all'implementazione nel mondo reale.
Uno dei problemi principali riguarda le prestazioni. NMS viene eseguita dopo l'inferenza e richiede il confronto dei bounding box tra loro per decidere quali mantenere.
Questo processo è oneroso dal punto di vista computazionale e difficile da parallelizzare in modo efficiente. Sui dispositivi edge e sui sistemi basati su CPU, questo lavoro aggiuntivo può introdurre una latenza significativa, rendendo più difficile soddisfare i requisiti in tempo reale.
NMS aumenta anche la complessità dell'implementazione. Poiché non fa parte del modello stesso, deve essere implementata separatamente come codice di post-processing.
Runtime e piattaforme diversi gestiscono NMS in modi differenti, il che spesso significa dover mantenere implementazioni personalizzate per ogni ambiente di destinazione. Ciò che funziona in una configurazione può comportarsi in modo leggermente diverso in un'altra, rendendo l'implementazione più fragile e difficile da scalare.
L'ottimizzazione hardware rappresenta un'altra difficoltà. NMS non si adatta bene agli acceleratori AI specializzati, progettati per eseguire in modo efficiente le operazioni delle reti neurali. Di conseguenza, anche quando il modello funziona rapidamente su hardware ottimizzato, NMS può diventare un collo di bottiglia che limita le prestazioni complessive.
Oltre a questi fattori, NMS si basa su parametri scelti manualmente, come le soglie di confidenza e di sovrapposizione. Queste impostazioni possono influire significativamente sui risultati e spesso devono essere ottimizzate per dataset, applicazioni o hardware diversi. Questo rende il comportamento meno prevedibile nei sistemi di produzione e aggiunge ulteriore complessità di configurazione.
Spiegazione dell'inferenza end-to-end per il rilevamento degli oggetti#
I limiti della soppressione non massima ci hanno portato a ripensare il comportamento che i modelli di rilevamento degli oggetti dovrebbero avere al momento dell'inferenza. Invece di generare molte predizioni sovrapposte e ripulirle in seguito, ci siamo posti una domanda più fondamentale.
E se il modello potesse produrre direttamente i rilevamenti finali? Questa domanda è al centro dell'inferenza end-to-end per il rilevamento degli oggetti. In un sistema end-to-end, il modello viene addestrato per gestire l'intero processo di rilevamento dall'inizio alla fine, senza dipendere da fasi esterne di pulizia.
Invece di produrre molti box candidati e filtrarli dopo l'inferenza, il modello impara a generare autonomamente un insieme ridotto di predizioni affidabili e non sovrapposte. I rilevamenti duplicati vengono risolti all'interno della rete invece di essere rimossi dal post-processing.
Le architetture di modelli più recenti hanno dimostrato che questo approccio è possibile e pratico. Con la giusta strategia di addestramento, i modelli possono imparare ad associare ogni oggetto a una singola predizione anziché a molte predizioni concorrenti, riducendo la ridondanza alla sua origine.
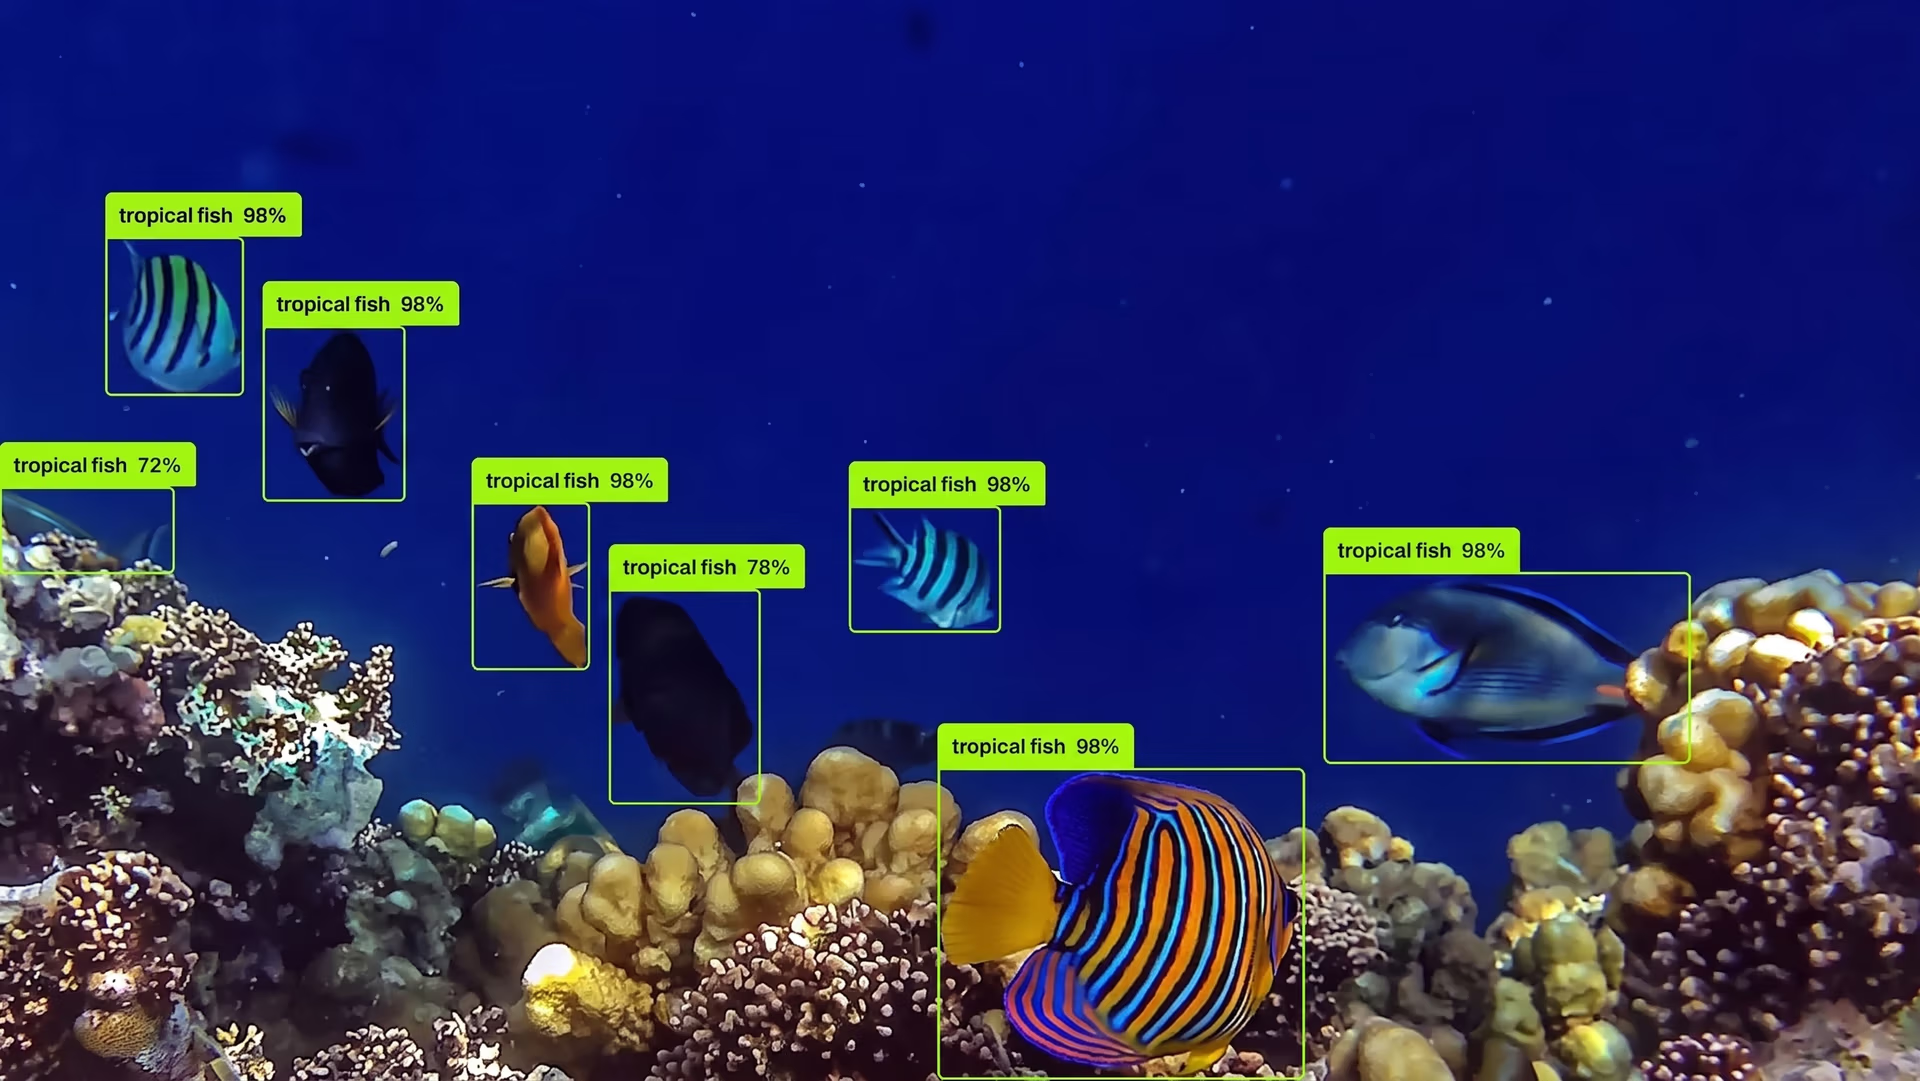
Fig. 3. Un esempio di rilevamento degli oggetti utilizzando Ultralytics YOLO26.
Affinché questo funzioni, anche l'addestramento deve cambiare. Invece di lasciare che molte predizioni competano per lo stesso oggetto, il modello impara a prendere una decisione chiara, producendo un numero inferiore di rilevamenti e con maggiore confidenza.
Il risultato complessivo è una pipeline di inferenza più semplice. Poiché i duplicati vengono già risolti internamente, non è necessaria la soppressione non massima al momento dell'inferenza. L'output del modello è già l'insieme finale dei rilevamenti.
Questo design end-to-end semplifica anche l'implementazione. Senza fasi di post-processing o implementazioni di NMS specifiche per piattaforma, il modello esportato è completamente autonomo e si comporta in modo coerente su diversi framework di inferenza e target hardware.
Come spiega il nostro Lead Partnership Engineer, Francesco Mattioli, «L'apprendimento realmente end-to-end significa che il modello dovrebbe gestire tutto, dai pixel alle predizioni, senza fasi di post-processing definite manualmente che interrompono la differenziabilità e complicano l'implementazione».
Come Ultralytics YOLO26 rimuove NMS#
Ultralytics YOLO26 rimuove la soppressione non massima modificando il modo in cui i rilevamenti vengono appresi e prodotti, invece di affidarsi al post-processing per ripulirli. Anziché consentire a molte predizioni di competere per lo stesso oggetto, YOLO26 viene addestrato per apprendere una relazione chiara uno-a-uno tra oggetti e output.
Questo è reso possibile in parte dal rilevamento basato su query apprendibili, che aiuta il modello a concentrarsi sulla produzione di una singola predizione affidabile per ogni oggetto anziché su molti candidati sovrapposti. Ogni oggetto viene associato a una predizione, riducendo naturalmente i rilevamenti duplicati.
Questo comportamento viene rafforzato da strategie di matching coerenti durante l'addestramento, che incoraggiano il modello a prendere una decisione affidabile per ogni oggetto anziché generare predizioni sovrapposte. In definitiva, il modello produce meno predizioni, ma ognuna rappresenta un rilevamento finale.
Perché la rimozione di DFL ha reso possibile il rilevamento senza NMS#
Un'altra innovazione importante che abilita l'inferenza senza NMS in Ultralytics YOLO26 è la rimozione della Distribution Focal Loss (DFL). Nei precedenti modelli YOLO, DFL veniva utilizzata per migliorare la regressione dei bounding box predicendo una distribuzione di possibili posizioni del box anziché un singolo valore.
Sebbene questo approccio migliorasse la precisione della localizzazione, aggiungeva anche complessità alla pipeline di rilevamento. Questa complessità è diventata un limite nel passaggio verso una vera inferenza end-to-end.
DFL introduceva calcoli aggiuntivi e intervalli di regressione fissi, rendendo più difficile per il modello apprendere assegnazioni degli oggetti chiare e uno-a-uno e aumentando la dipendenza da fasi di post-processing come la soppressione non massima. Con Ultralytics YOLO26 abbiamo rimosso DFL e riprogettato la regressione dei bounding box in modo più semplice e diretto.
Invece di affidarsi a output basati su distribuzioni, il modello impara a predire coordinate accurate dei box in modo da supportare un numero inferiore di rilevamenti più affidabili. Questa modifica contribuisce a ridurre le predizioni sovrapposte alla loro origine e allinea la regressione dei bounding box al design end-to-end e senza NMS di Ultralytics YOLO26.
Ultralytics YOLO26 è senza NMS e facile da implementare#
Un design senza NMS rende Ultralytics YOLO26 un modello realmente end-to-end. Questo ha un impatto importante sull'esportazione dei modelli.
L'esportazione consiste nella conversione di un modello addestrato in un formato che possa funzionare al di fuori dell'ambiente di addestramento, come ONNX, TensorRT, CoreML o OpenVINO. Nelle pipeline tradizionali, questo processo spesso si interrompe perché la soppressione non massima non fa parte del modello stesso.
Rimuovendo NMS, Ultralytics YOLO26 evita completamente questo problema. Il modello esportato include già tutto ciò che serve per produrre i rilevamenti finali.
Questo rende il modello esportato completamente autonomo e più portabile tra framework di inferenza e target hardware. Lo stesso modello si comporta in modo coerente sia che venga implementato su server, sistemi dotati esclusivamente di CPU, dispositivi embedded o acceleratori edge. L'implementazione diventa più semplice perché ciò che esporti è esattamente ciò che esegui.
Questa semplicità è particolarmente importante per le applicazioni edge. Ad esempio, YOLO26 può essere facilmente implementato su dispositivi come i droni per casi d'uso quali il monitoraggio delle colture, l'ispezione dei campi e l'analisi dello stato di salute delle piante, dove budget limitati di calcolo ed energia rendono impraticabili pipeline di post-processing complesse. Poiché il modello produce direttamente i rilevamenti finali, funziona in modo affidabile su hardware leggero senza fasi di elaborazione aggiuntive.
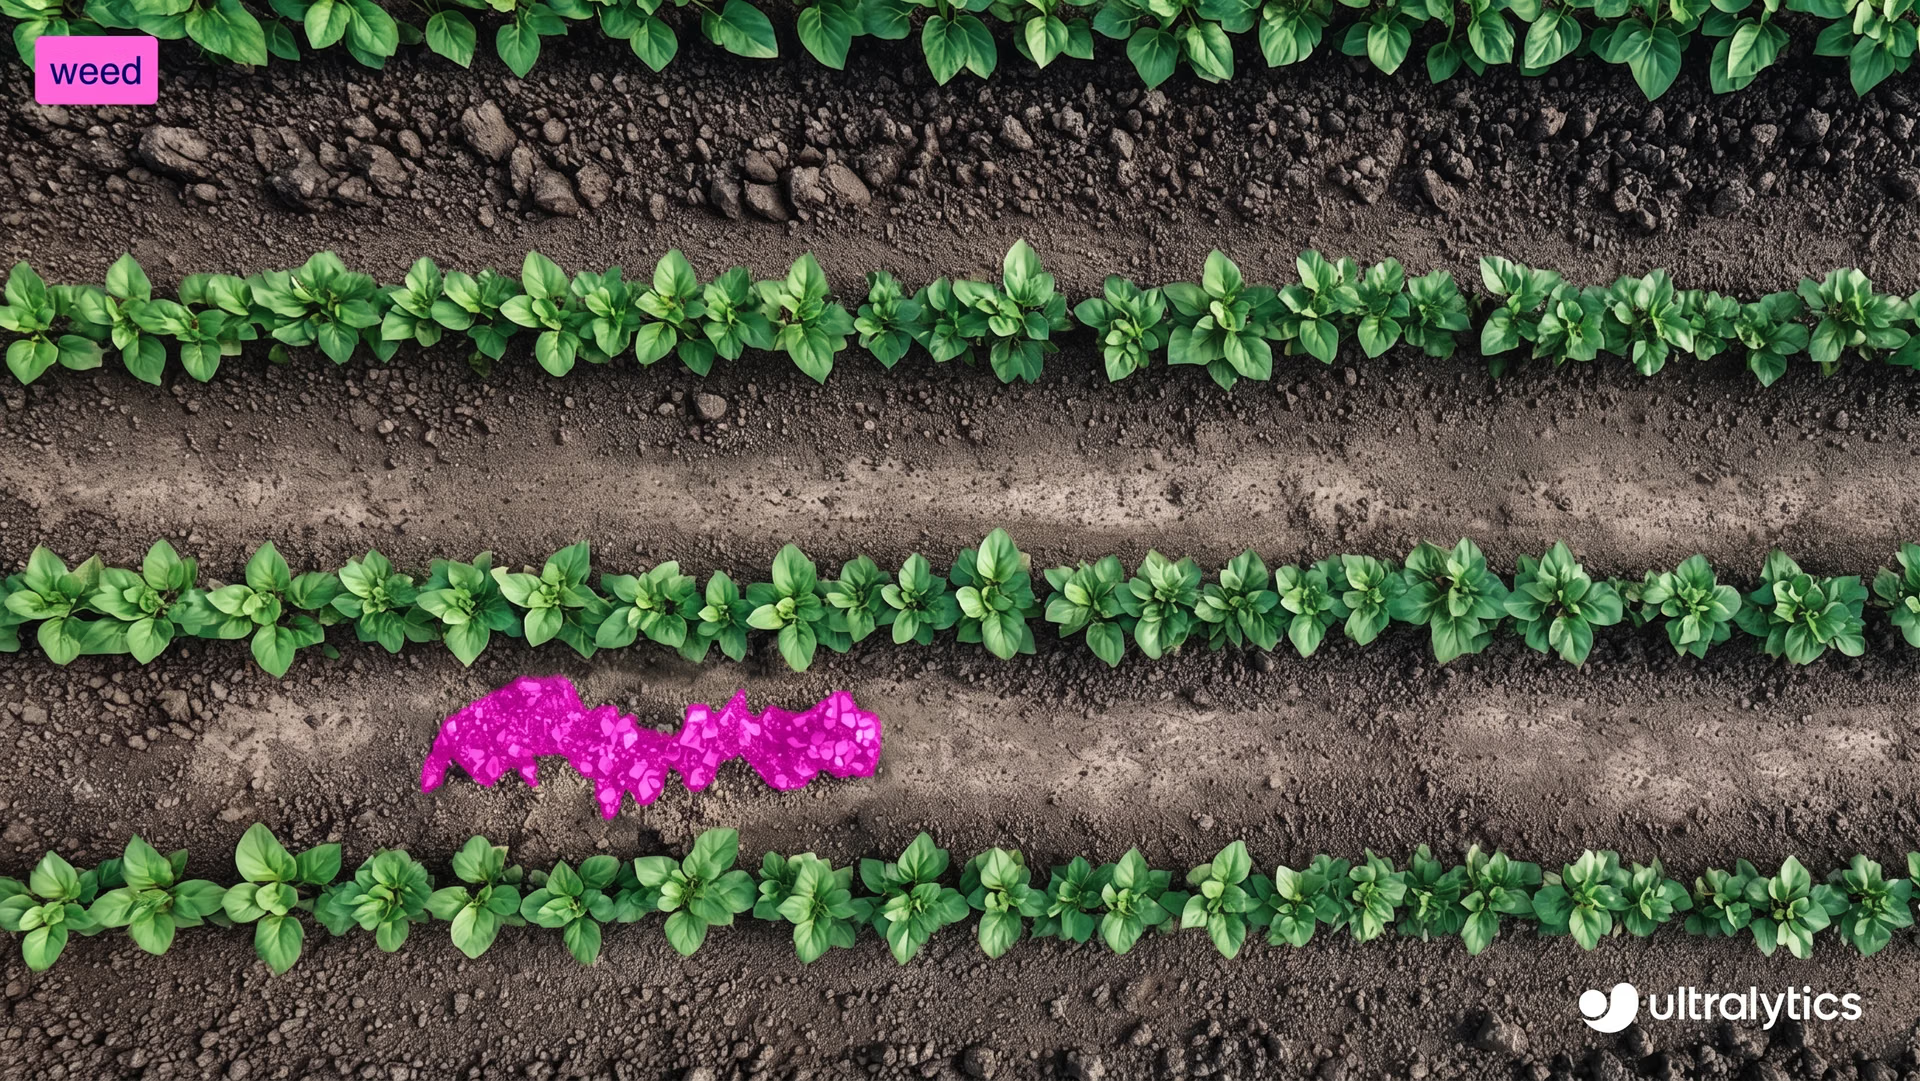
Fig. 4. Ultralytics YOLO26 è facile da implementare su dispositivi edge come i droni.
In breve, l'inferenza senza NMS elimina gli ostacoli dall'esportazione e dall'implementazione e consente di creare sistemi di visione più puliti e affidabili. NMS era una soluzione alternativa. Ultralytics YOLO26 non ha più bisogno di soluzioni alternative.
Punti chiave#
Ultralytics YOLO26 rimuove la soppressione non massima risolvendo il problema alla base dei rilevamenti duplicati, invece di ripulirli a posteriori. Il suo design end-to-end consente al modello di produrre direttamente i rilevamenti finali, rendendo l'esportazione e l'implementazione più semplici e coerenti su hardware diversi. NMS era una soluzione alternativa utile per i sistemi precedenti, ma YOLO26 non ne ha più bisogno.
Unisciti alla nostra community e dai un'occhiata al nostro repository GitHub per saperne di più sull'AI. Esplora le nostre pagine dedicate alle soluzioni per l'AI nell'agricoltura e la computer vision nel retail. Scopri le nostre opzioni di licenza e inizia oggi stesso a utilizzare l'AI per la visione!






