Capire la segmentazione di concetti basata su prompt
Scopri la segmentazione di concetti basata su prompt, le differenze rispetto ai metodi tradizionali e come modelli correlati, come YOLOE-26, consentono capacità a vocabolario aperto.
 Abirami Vina14 min di lettura
L’IA per la visione sta avanzando rapidamente ed è ampiamente usata per analizzare immagini e video in contesti reali. Per esempio, applicazioni che spaziano dai sistemi di gestione del traffico all’analisi del commercio al dettaglio vengono integrate con i modelli di visione artificiale.
In molte di queste applicazioni, i modelli di visione, come quelli per il rilevamento degli oggetti, vengono addestrati a riconoscere un insieme predefinito di oggetti, tra cui veicoli, persone e attrezzature. Durante l’addestramento, ai modelli vengono mostrati numerosi esempi etichettati, così che possano imparare l’aspetto di ciascun oggetto e distinguerlo dagli altri presenti in una scena.
Per le attività di segmentazione, i modelli fanno un passo in più producendo contorni precisi, a livello di pixel, attorno a questi oggetti. Questo permette ai sistemi di capire con esattezza dove si trova ogni oggetto in un'immagine.
Questo approccio funziona bene finché il sistema deve riconoscere solo ciò su cui è stato addestrato. Tuttavia, negli ambienti reali raramente è così.
Le scene visive sono in genere dinamiche. Compaiono nuovi oggetti e concetti visivi, le condizioni cambiano e spesso gli utenti vogliono segmentare oggetti che non facevano parte della configurazione di addestramento originale.
Queste limitazioni sono particolarmente evidenti nella segmentazione. Con la continua evoluzione dell’IA per la visione, cresce la necessità di modelli di segmentazione più flessibili, in grado di adattarsi a nuovi concetti senza richiedere ripetuti riaddestramenti. Per questo la segmentazione di concetti guidata da prompt (PCS) sta suscitando interesse.
Anziché basarsi su un elenco fisso di categorie di oggetti, gli utenti possono descrivere ciò che vogliono segmentare usando testo, prompt visivi o immagini di esempio. I modelli possono quindi individuare e segmentare tutte le aree corrispondenti al concetto descritto, anche se quel concetto non era stato incluso esplicitamente durante l’addestramento.
In questo articolo vedremo come funziona la segmentazione di concetti guidata da prompt, in cosa si differenzia dagli approcci tradizionali e dove viene usata oggi.
Che cos’è la segmentazione di concetti guidata da prompt?#
Nella maggior parte dei casi, i modelli di segmentazione vengono addestrati a riconoscere un breve elenco di tipi di oggetti. Questo funziona bene quando un sistema di IA per la visione deve solo rilevare e segmentare un insieme specifico di oggetti.
Nelle applicazioni del mondo reale, però, le scene visive sono dinamiche. Compaiono nuovi oggetti, i requisiti delle attività cambiano e spesso gli utenti devono segmentare concetti che non erano inclusi nell’insieme originale di etichette. Per gestire queste situazioni è in genere necessario raccogliere nuovi dati e annotazioni di alta qualità e riaddestrare il modello, aumentando i costi e rallentando la distribuzione.
La segmentazione di concetti guidata da prompt risolve questo problema consentendo agli utenti di indicare al modello cosa cercare, anziché scegliere da un elenco fisso di etichette. Gli utenti descrivono l’oggetto o il concetto che cercano e il modello evidenzia tutte le aree corrispondenti nell’immagine. In questo modo è molto più facile collegare l’intento dell’utente ai pixel effettivi dell’immagine.
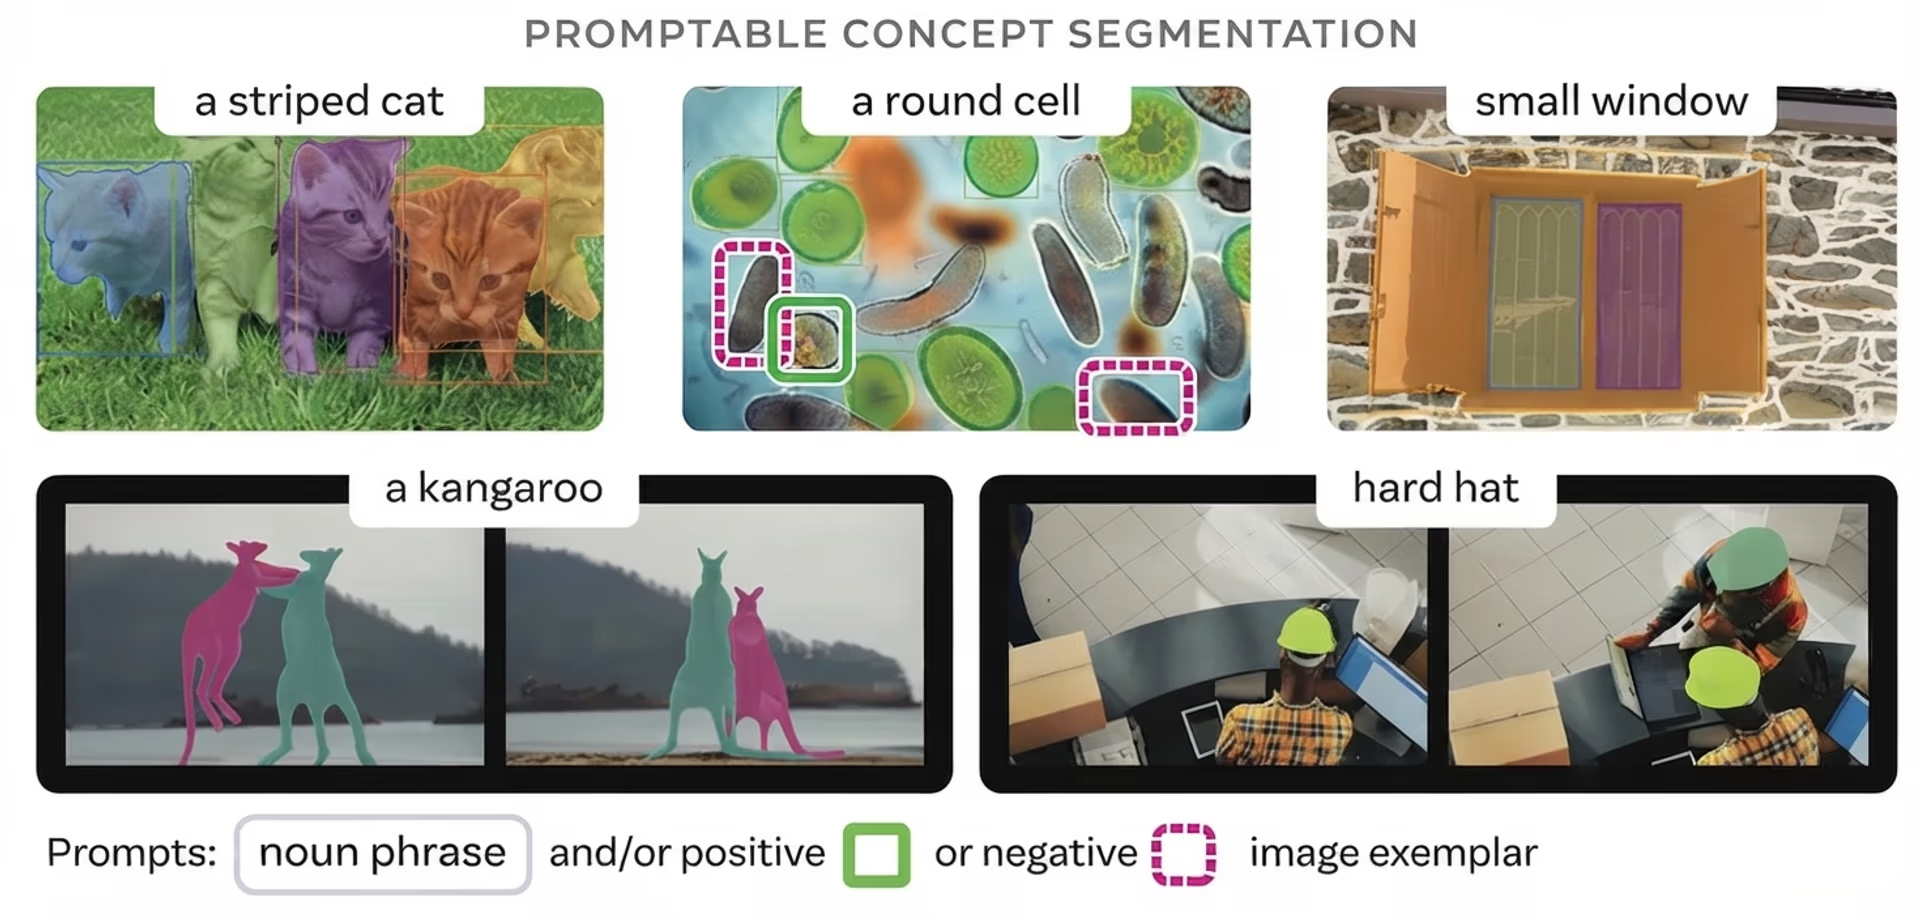
Fig. 1. Esempio di utilizzo di prompt concettuali per la segmentazione (Fonte)
Guidare la segmentazione con diversi tipi di prompt#
I modelli che supportano la segmentazione di concetti guidata da prompt sono flessibili perché possono ricevere diversi tipi di input. In altre parole, esistono vari modi per indicare al modello cosa cercare, per esempio usando descrizioni testuali, indicazioni visive o immagini di esempio.
Ecco un’analisi più approfondita di ciascun approccio:
- Prompt testuali: Frasi brevi come “scuolabus” o “area tumorale” possono essere usate per descrivere il concetto da segmentare. Il modello interpreta il significato delle parole e individua le aree corrispondenti.
- Prompt visivi: Questi prompt usano punti, riquadri o schizzi approssimativi all’interno dell’immagine come indicazioni. Questi indizi guidano la ricerca e contribuiscono a definire il contorno finale.
- Immagini di riferimento: Immagini di riferimento o piccoli ritagli rappresentano il concetto di interesse. Il modello cerca aree visivamente simili e le segmenta in base al loro aspetto.
Differenze tra PCS e segmentazione tradizionale#
Prima di approfondire il funzionamento della segmentazione di concetti guidata da prompt, confrontiamola con i diversi metodi tradizionali di segmentazione degli oggetti.
PCS consente di creare modelli con vocabolario aperto e guidati da prompt. Può gestire nuovi concetti descritti tramite prompt, mentre la segmentazione tradizionale non può farlo. Esistono diversi tipi di approcci tradizionali alla segmentazione, ciascuno con presupposti e limitazioni specifici.
Ecco alcuni dei principali tipi di segmentazione tradizionale:
- Segmentazione semantica: Ogni pixel dell’immagine viene etichettato come parte di una categoria, come strada, edificio o persona. Tutti i pixel con la stessa etichetta vengono raggruppati, quindi il modello non distingue le singole istanze degli oggetti.
- Segmentazione delle istanze: Il modello identifica e segmenta i singoli oggetti, trattando quindi due persone o due automobili come elementi distinti.
- Segmentazione panottica: Questa tecnica combina la segmentazione semantica e quella delle istanze per offrire una visione completa della scena, includendo sia le aree di sfondo sia i singoli oggetti.
Tutti questi approcci si basano su un elenco predefinito di categorie di oggetti. Funzionano bene entro questi limiti, ma gestiscono con difficoltà i concetti che ne restano fuori. Quando è necessario segmentare un nuovo oggetto specifico, di solito servono ulteriori dati di addestramento e una messa a punto del modello.
PCS mira a cambiare questa situazione. Invece di essere vincolata a categorie predefinite, consente di descrivere ciò che si vuole segmentare in un’immagine al momento dell’inferenza.
L’evoluzione dei modelli PCS#
Vediamo ora come i modelli di segmentazione si sono evoluti fino ad arrivare alla segmentazione di concetti guidata da prompt.
Un popolare modello fondazionale che ha segnato una svolta nella segmentazione è SAM, ovvero il Modello Segment Anything. È stato introdotto nel 2023. Anziché basarsi su categorie di oggetti predefinite, SAM consentiva agli utenti di guidare la segmentazione usando semplici prompt visivi, come punti o riquadri di delimitazione.
Con SAM, gli utenti non dovevano più selezionare un’etichetta. Bastava indicare la posizione di un oggetto e il modello ne generava una maschera. Questo rendeva la segmentazione più flessibile, ma gli utenti dovevano comunque indicare al modello dove guardare.
SAM 2, rilasciato nel 2024, ha sviluppato ulteriormente questa idea, gestendo scene più complesse ed estendendo la segmentazione guidata da prompt ai video. Ha migliorato la robustezza in diverse condizioni di illuminazione, con forme e movimenti degli oggetti differenti, pur continuando a basarsi soprattutto su prompt visivi per guidare la segmentazione.
Il modello SAM 3 rappresenta la fase più recente di questa evoluzione. È stato rilasciato l’anno scorso ed è un modello unificato che combina la comprensione visiva con la guida linguistica, garantendo un comportamento coerente nelle attività di segmentazione di immagini e video.
Con SAM 3, gli utenti non sono limitati a indicare punti o disegnare prompt. Possono invece descrivere con il testo ciò che vogliono segmentare e il modello cerca nelle immagini o nei fotogrammi video le aree che corrispondono alla descrizione.
La segmentazione è guidata da concetti anziché da categorie di oggetti predefinite, consentendo l’uso di un vocabolario aperto in scene diverse e nel tempo. SAM 3, infatti, opera in un ampio spazio di concetti appresi, fondato su un’ontologia derivata da fonti come Wikidata e ampliato con dati di addestramento su larga scala.
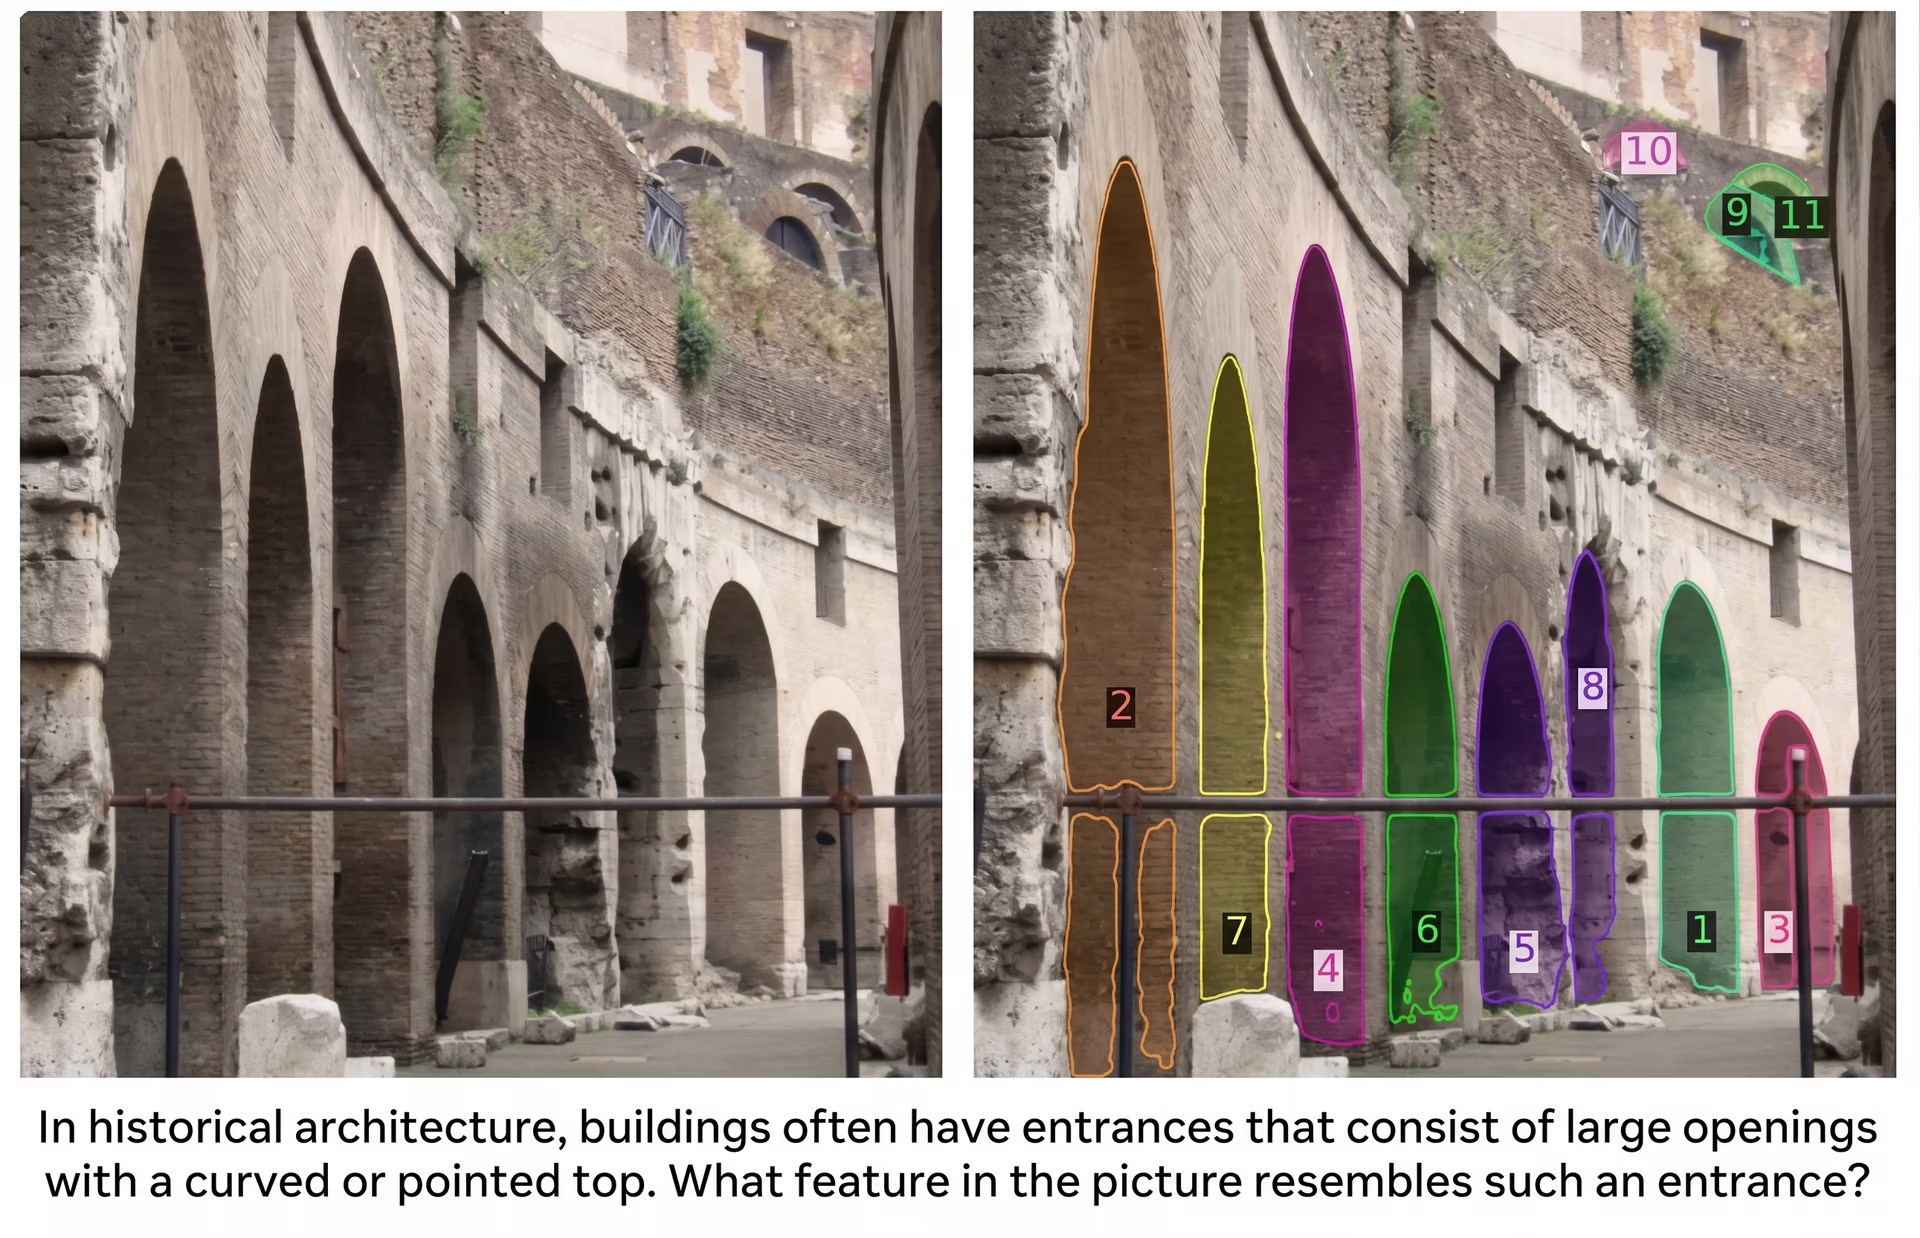
Fig. 2. Un esempio di richiesta a SAM 3 e segmentazione di una singola immagine (Fonte)
Rispetto alle versioni precedenti, basate soprattutto su prompt geometrici, SAM 3 rappresenta un passo avanti verso una segmentazione più flessibile e guidata dai concetti. Questo lo rende più adatto alle applicazioni del mondo reale, in cui gli oggetti o i concetti di interesse possono cambiare e non sempre si possono definire in anticipo.
Esplorare il funzionamento della segmentazione di concetti guidata da prompt#
Come funziona, quindi, la segmentazione di concetti guidata da prompt? Si basa su modelli visivo-linguistici di grandi dimensioni preaddestrati, addestrati su enormi raccolte di immagini e, in molti casi, di testi associati. Questo addestramento consente loro di apprendere schemi visivi generali e significati semantici.
La maggior parte dei modelli PCS usa architetture basate su Transformer, che elaborano un’intera immagine alla volta per capire in che modo le diverse regioni sono correlate. Un vision Transformer estrae le caratteristiche visive dall’immagine, mentre un encoder testuale converte le parole in rappresentazioni numeriche utilizzabili dal modello.
Durante l’addestramento, questi modelli possono apprendere da diversi tipi di supervisione, tra cui maschere a livello di pixel che definiscono i contorni esatti degli oggetti, riquadri di delimitazione che ne indicano approssimativamente la posizione ed etichette a livello di immagine che descrivono ciò che vi appare. L’addestramento con diversi tipi di dati etichettati aiuta il modello a cogliere sia i dettagli più fini sia i concetti visivi più ampi.
Al momento dell'inferenza, cioè quando il modello viene effettivamente usato per fare previsioni, PCS segue un processo guidato da prompt. L'utente fornisce indicazioni tramite descrizioni testuali, suggerimenti visivi come punti o riquadri oppure immagini di esempio. Il modello codifica sia il prompt sia l'immagine in una rappresentazione interna condivisa, detta embedding, e individua le regioni che corrispondono al concetto descritto.
Un decoder delle maschere converte quindi questa rappresentazione condivisa in maschere di segmentazione precise a livello di pixel. Poiché il modello associa le caratteristiche visive al significato semantico, può segmentare nuovi concetti anche se non sono stati inclusi esplicitamente durante l’addestramento.
Inoltre, spesso è possibile perfezionare i risultati modificando il prompt o aggiungendo ulteriori indicazioni, aiutando il modello a gestire scene complesse o ambigue. Questo processo iterativo consente di ottimizzare concretamente il modello durante la distribuzione.
I modelli di segmentazione di concetti guidata da prompt vengono in genere valutati in base alla capacità di segmentare concetti mai visti prima e alla robustezza con cui operano in scene diverse. I benchmark si concentrano spesso sulla qualità delle maschere, sulla generalizzazione e sull’efficienza computazionale, in linea con i requisiti della distribuzione nel mondo reale.
Casi d’uso reali di PCS#
Vediamo ora in quali ambiti viene già usata la segmentazione di concetti guidata da prompt e dove sta iniziando ad avere un impatto concreto.
Segmentazione flessibile per l’imaging medico#
L’imaging medico comprende numerose strutture biologiche, patologie e tipologie di scansione, e ogni giorno emergono nuovi casi. I modelli di segmentazione tradizionali faticano a stare al passo con questa varietà.
PCS si adatta bene a questo ambito perché consente ai medici di descrivere ciò che vogliono individuare, anziché scegliere da un elenco breve e rigido. Con frasi testuali o prompt visivi, PCS può segmentare direttamente organi o aree di interesse senza riaddestrare il modello per ogni nuovo compito. Questo facilita la gestione di esigenze cliniche diverse, riduce la necessità di disegnare manualmente le maschere e funziona con numerose tipologie di imaging.
Un ottimo esempio è MedSAM-3, che adatta l’architettura SAM 3 per usare PCS nell’imaging medico con prompt testuali. È possibile fornire a questo modello prompt con termini anatomici e patologici espliciti, come i nomi di organi quali fegato o rene e concetti legati alle lesioni, come tumore o lesione. Dato un prompt, il modello segmenta direttamente la regione corrispondente nell’immagine medica.
MedSAM-3 integra anche modelli multimodali di grandi dimensioni (MLLM o LLM multimodali), in grado di ragionare sia su testi sia su immagini. Questi modelli operano in un sistema con intervento dell’agente, in cui i risultati vengono perfezionati iterativamente per migliorare la precisione nei casi più complessi.
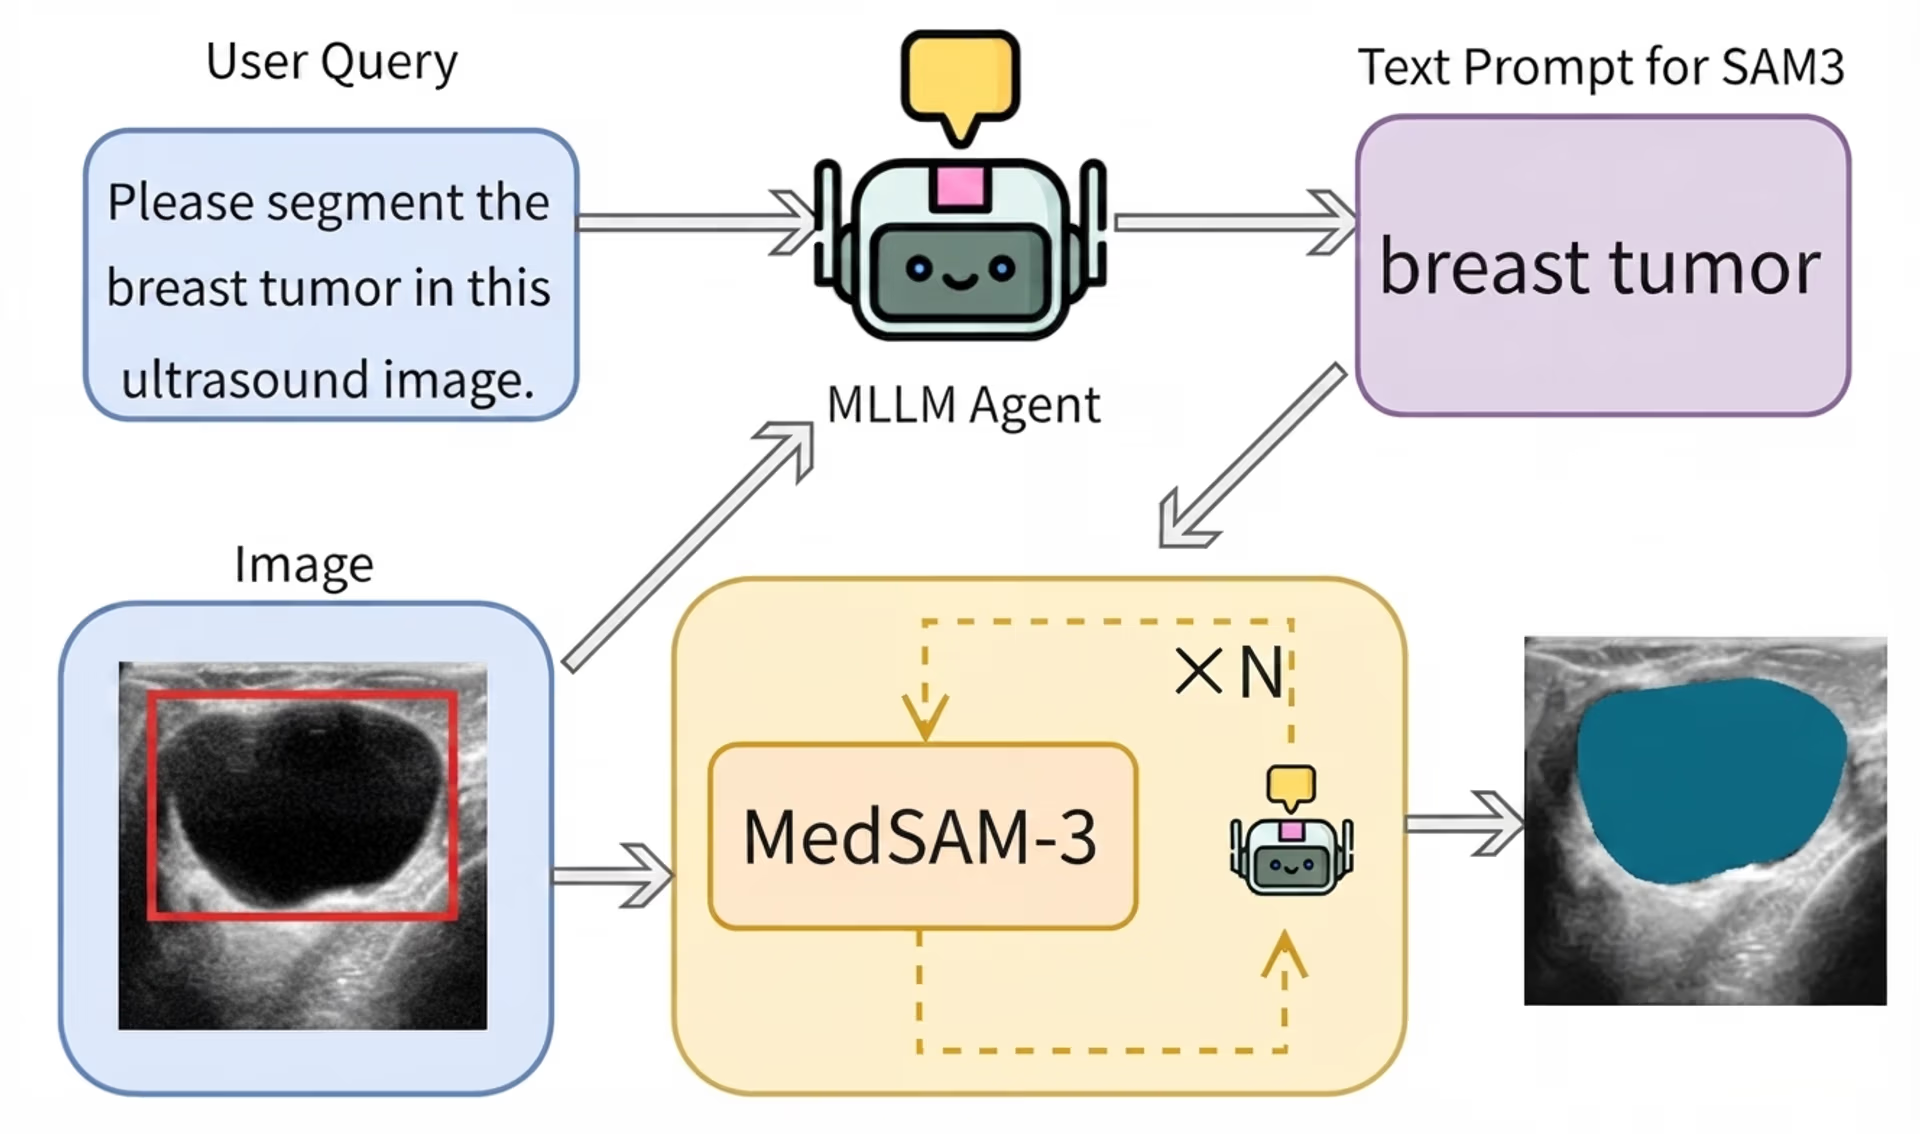
Fig. 3. Una pipeline MedSAM-3 per la segmentazione di tumori nelle immagini mediche tramite prompt testuali (Fonte)
MedSAM-3 offre buone prestazioni con radiografie, MRI, CT, ecografie e dati video, dimostrando come PCS possa rendere i flussi di lavoro di imaging medico più flessibili ed efficienti nei contesti clinici reali.
Segmentazione adattiva per la chirurgia robotica e l’automazione#
La chirurgia robotica si affida a sistemi di visione per tracciare gli strumenti e comprendere scene chirurgiche in rapido cambiamento. Gli strumenti si muovono velocemente, l’illuminazione varia e possono comparire nuovi strumenti in qualsiasi momento, rendendo difficile mantenere sistemi di etichette predefinite.
Con PCS, i robot possono tracciare gli strumenti, guidare le telecamere e seguire le fasi chirurgiche in tempo reale. Questo riduce il lavoro di etichettatura manuale e facilita l’adattamento dei sistemi a procedure diverse. I chirurghi o i sistemi automatizzati possono usare prompt testuali come «pinza», «bisturi» o «strumento con telecamera» per indicare cosa segmentare in un’immagine.
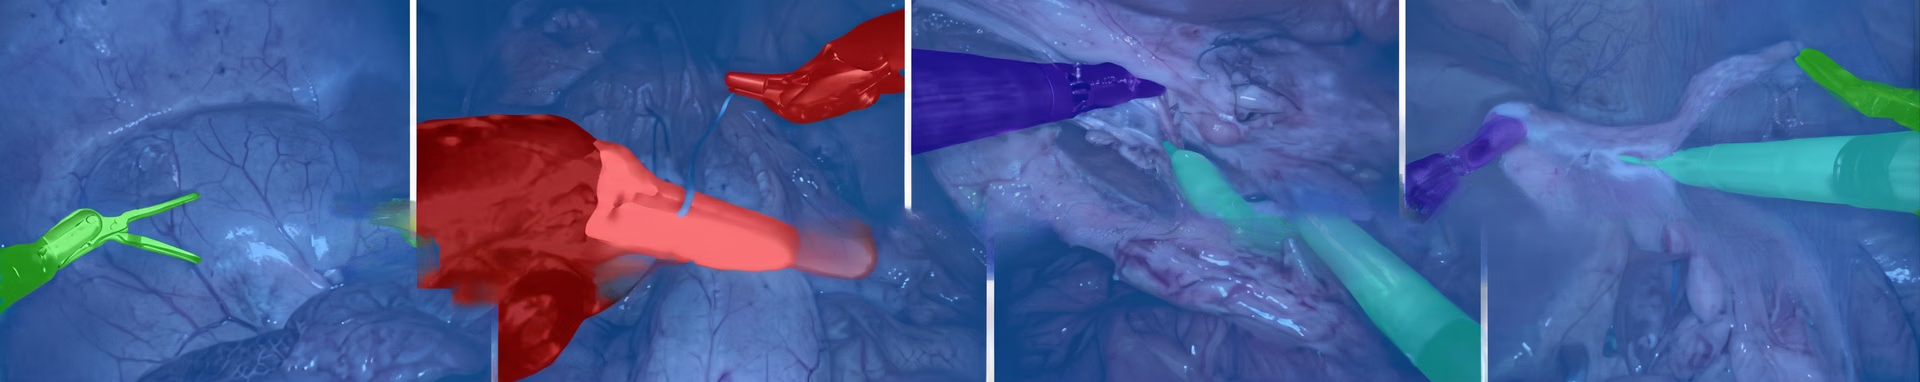
Fig. 4. Segmentazione degli strumenti chirurgici usati durante un intervento di chirurgia robotica (Fonte)
Segmentazione a vocabolario aperto con Ultralytics YOLOE-26#
Un altro interessante modello all'avanguardia correlato alla segmentazione di concetti guidata da prompt è Ultralytics YOLOE-26. Introduce la segmentazione guidata da prompt con vocabolario aperto nella famiglia di modelli Ultralytics YOLO.
YOLOE-26 si basa sull’architettura Ultralytics YOLO26 e supporta la segmentazione di istanze a vocabolario aperto. YOLOE-26 consente agli utenti di guidare la segmentazione in diversi modi.
Supporta prompt testuali, in cui brevi frasi legate a elementi visivi possono specificare l’oggetto target, e prompt visivi, che forniscono ulteriori indicazioni basate sugli indizi presenti nell’immagine. Inoltre, YOLOE-26 include una modalità senza prompt per l’inferenza zero-shot, in cui il modello rileva e segmenta gli oggetti usando un vocabolario integrato, senza richiedere prompt all’utente.
YOLOE-26 è ideale per applicazioni come analisi video, percezione robotica e sistemi edge, in cui le categorie degli oggetti possono cambiare, ma la bassa latenza e una produttività affidabile restano essenziali. È particolarmente utile anche per l'etichettatura dei dati e la cura dei dataset, perché semplifica i flussi di lavoro automatizzando parte del processo di annotazione.
Vantaggi e svantaggi della segmentazione di concetti guidata da prompt#
Ecco alcuni dei principali vantaggi dell’uso della segmentazione di concetti guidata da prompt:
- Iterazione e prototipazione più rapide: puoi testare rapidamente nuovi compiti di segmentazione modificando i prompt, anziché ricostruire i dataset o riaddestrare i modelli, accelerando così la sperimentazione e lo sviluppo.
- Adattabilità a diversi ambiti: spesso puoi applicare lo stesso modello PCS a settori diversi, come l’imaging medico, la robotica o l’analisi video, con modifiche minime al flusso di lavoro.
- Perfezionamento interattivo: gli utenti possono modificare iterativamente i prompt o aggiungere indicazioni per migliorare i risultati, facilitando la gestione di scene ambigue o casi limite senza riaddestrare il modello.
PCS offre vantaggi evidenti, ma ecco alcune limitazioni da considerare:
- Sensibilità ai prompt: piccole variazioni nella formulazione o nel modo in cui viene fornito un prompt possono influire sul risultato. I prompt troppo vaghi o troppo specifici possono portare a una segmentazione incompleta o errata.
- Comportamento meno prevedibile: poiché il modello interpreta i prompt anziché scegliere tra etichette fisse, i risultati possono variare maggiormente tra scene e input, un aspetto che può creare problemi nelle pipeline sottoposte a controlli rigorosi.
- Interpretazione ambigua dei concetti: alcuni concetti sono soggettivi o definiti in modo approssimativo, e possono quindi produrre risultati di segmentazione incoerenti tra utenti o immagini.
- Affidabilità limitata per target molto specifici: in genere, i modelli basati su prompt sono meno affidabili per compiti circoscritti e specifici delle singole istanze, come il rilevamento dei difetti, che richiedono l’identificazione precisa e coerente di caratteristiche poco evidenti.
Scegliere tra segmentazione guidata da prompt e segmentazione tradizionale#
Esplorando la segmentazione guidata da prompt, potresti chiederti per quali applicazioni sia più adatta e quando un modello di visione artificiale tradizionale come Ultralytics YOLO26 sia più indicato per il problema che vuoi risolvere. La segmentazione guidata da prompt funziona bene con gli oggetti generici, ma non è adatta ai casi d’uso che richiedono risultati molto precisi e coerenti.
Il rilevamento dei difetti è un buon esempio. Nel settore manifatturiero, i difetti sono spesso minuscoli e poco evidenti, come piccoli graffi, ammaccature, disallineamenti o irregolarità superficiali. Possono inoltre variare molto a seconda dei materiali, dell’illuminazione e delle condizioni di produzione.
È difficile descrivere questi problemi con un prompt semplice, e ancora più difficile per un modello generico rilevarli in modo affidabile. In generale, i modelli basati su prompt tendono a non rilevare i difetti o a produrre risultati instabili, mentre i modelli addestrati specificamente su dati relativi ai difetti sono molto più affidabili nei sistemi di ispezione reali.
Punti chiave#
La segmentazione di concetti guidata da prompt semplifica l’adattamento dei sistemi di visione al mondo reale, in cui compaiono continuamente nuovi oggetti e concetti. Invece di essere vincolati a etichette fisse, gli utenti possono semplicemente descrivere ciò che vogliono segmentare e lasciare che il modello faccia il resto, risparmiando tempo e riducendo il lavoro manuale. Pur avendo ancora dei limiti, PCS sta già cambiando il modo in cui si usa la segmentazione nella pratica e probabilmente diventerà una componente fondamentale dei sistemi di visione del futuro.
Scopri di più sull’IA visitando il nostro repository GitHub e unendoti alla nostra community. Visita le pagine delle nostre soluzioni per saperne di più sull’IA nella robotica e sulla visione artificiale nel settore manifatturiero. Scopri le nostre opzioni di licenza e inizia oggi stesso a usare l’IA per la visione!
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









