Ultralytics YOLO26이 NMS를 제거하는 이유와 이에 따른 배포 방식의 변화
Ultralytics YOLO26이 진정한 엔드투엔드 NMS 없는 추론을 구현하는 방식과 후처리 제거가 export 및 엣지 배포를 간소화하는 이유를 알아보세요.
1월 14일, 최신 세대 컴퓨터 비전 모델인 Ultralytics YOLO26을 출시했습니다. YOLO26의 목표는 정확도나 속도만 개선하는 것이 아니라, 실제 시스템에서 객체 탐지 모델을 구축하고 배포하는 방식을 재고하는 것이었습니다.
컴퓨터 비전이 연구에서 프로덕션으로 확장되면서, 모델은 CPU, 엣지 디바이스, 카메라, 로봇, 임베디드 하드웨어에서 실행될 것이 점점 더 많이 요구되고 있습니다. 이러한 환경에서는 성능만큼 안정성, 낮은 latency, 간편한 배포가 중요합니다.
Ultralytics YOLO26은 이러한 현실을 고려하여 설계되었으며, 추론 파이프라인에서 불필요한 복잡성을 제거한 간소화된 end-to-end 아키텍처를 사용합니다. YOLO26의 가장 중요한 혁신 중 하나는 일반적으로 NMS라고 하는 비최대 억제를 제거한 것입니다.
수년 동안 NMS는 중복 탐지 결과를 정리하는 후처리 단계로 사용되며 객체 탐지 시스템의 표준 구성 요소로 자리 잡았습니다. 효과적이지만, 특히 엣지 하드웨어에서 추가 연산과 배포상의 문제도 발생시켰습니다.
YOLO26에서는 다른 접근 방식을 취했습니다. 예측을 생성하고 학습하는 방식을 재고함으로써 진정한 end-to-end, NMS-free 추론을 구현했습니다. 모델은 외부 정리 단계나 수작업으로 만든 규칙에 의존하지 않고 최종 탐지 결과를 직접 생성합니다. 이를 통해 YOLO26이 더 빨라지고, 내보내기가 쉬워지며 다양한 하드웨어 플랫폼에 더욱 안정적으로 배포할 수 있습니다.
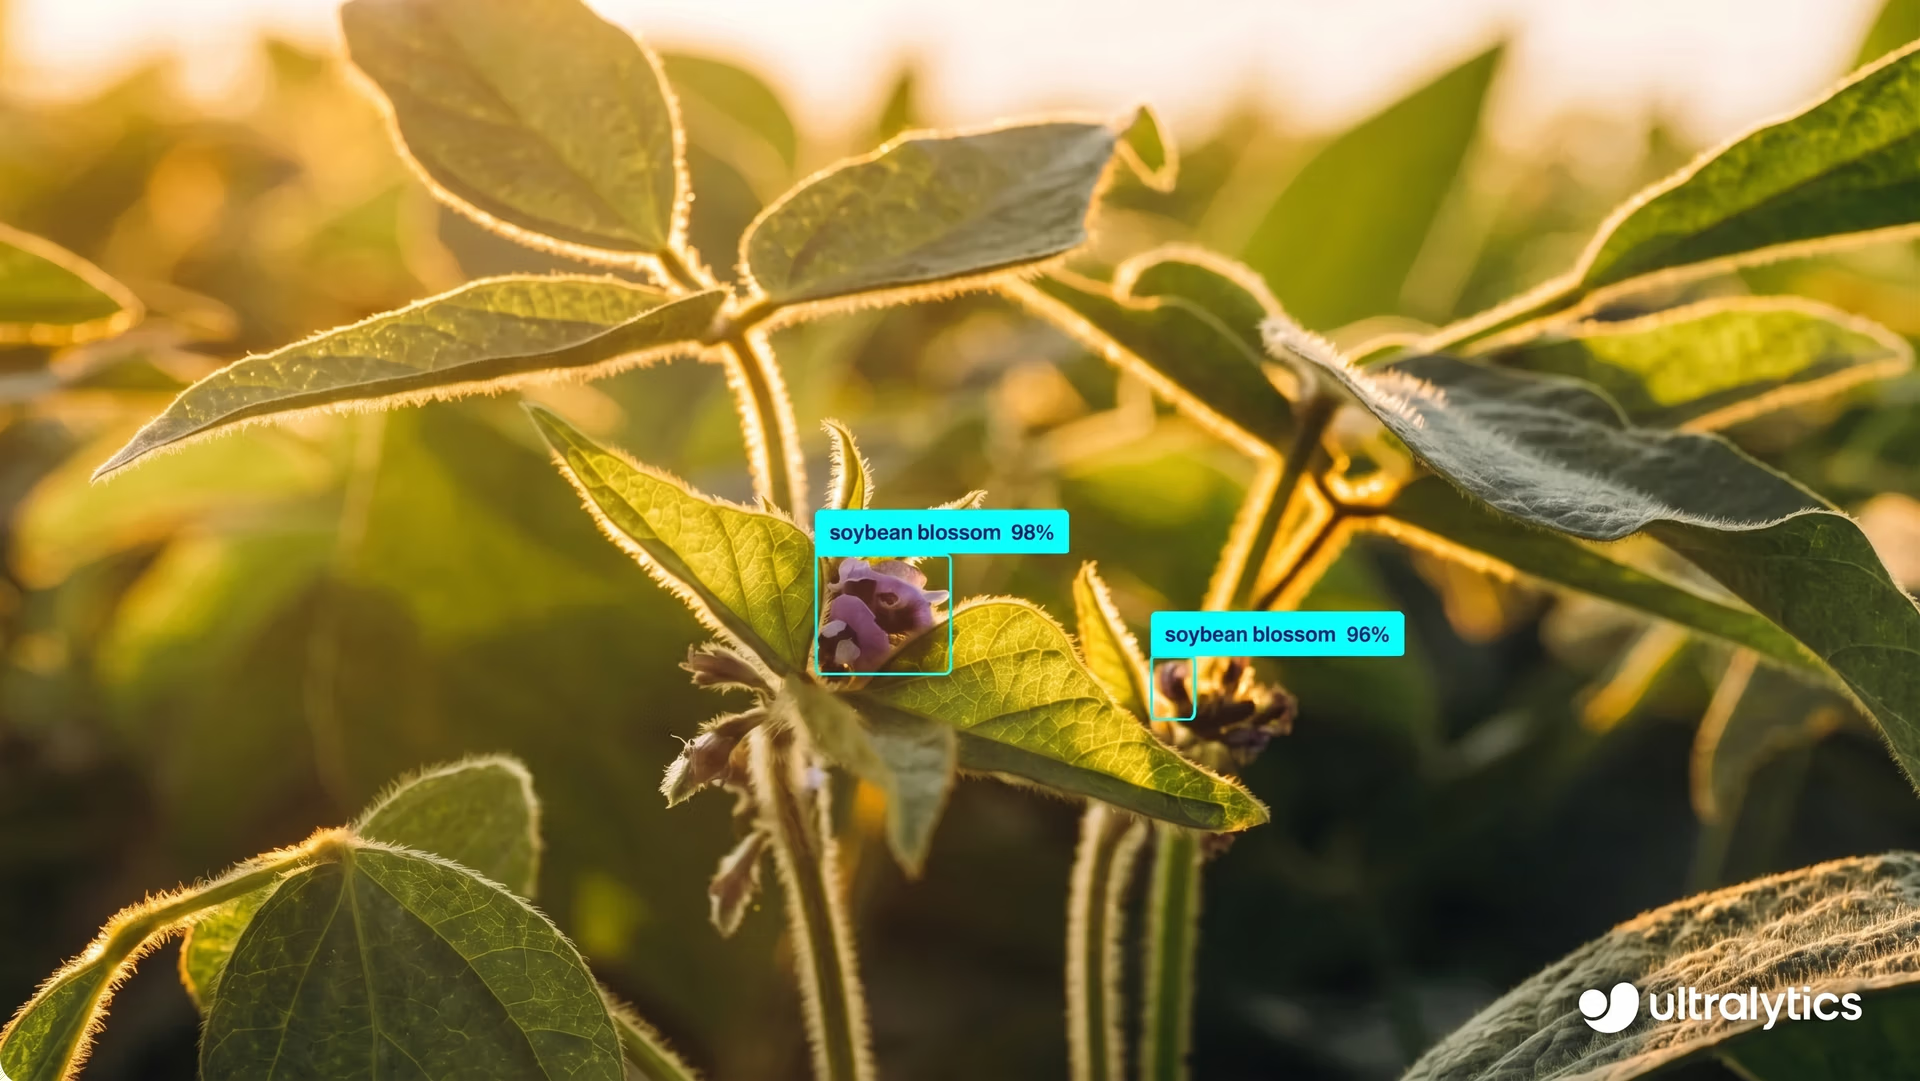
그림 1. Ultralytics YOLO26을 사용한 이미지 내 객체 탐지
이 글에서는 기존 객체 탐지가 NMS에 의존했던 이유, NMS가 배포 병목으로 작용하게 된 과정, 그리고 Ultralytics YOLO26이 우회 방법의 필요성을 없애는 방식을 자세히 살펴보겠습니다. 시작하겠습니다!
기존 객체 탐지는 중복 탐지 결과를 생성합니다#
NMS가 무엇이며 Ultralytics YOLO26에서 이를 제거한 이유를 살펴보기에 앞서, 잠시 한 걸음 물러나 기존 객체 탐지 모델이 예측을 생성하는 방식을 살펴보겠습니다.
기존 객체 탐지 모델은 동일한 객체에 대해 서로 겹치는 여러 개의 bounding box를 생성하는 경우가 많습니다. 이러한 box는 모두 이미지 속 동일한 객체를 가리키지만, 각각 고유한 confidence score를 갖습니다.
여기에는 몇 가지 이유가 있습니다. 첫째, 모델은 여러 spatial location과 서로 다른 scale에서 동시에 예측을 수행합니다. 이를 통해 다양한 크기의 객체를 탐지할 수 있지만, 인접한 location들이 동일한 객체를 각각 독립적으로 식별할 수 있다는 의미이기도 합니다.
둘째, 많은 객체 탐지 시스템은 anchor 기반 접근 방식을 사용하며, 각 location 주변에 많은 candidate box를 생성합니다. 이는 객체를 정확하게 찾을 가능성을 높이지만, 겹치는 예측의 수도 증가시킵니다.
마지막으로 grid 기반 탐지 자체가 자연스럽게 중복을 유발합니다. 객체가 여러 grid cell의 경계 근처에 있으면 여러 cell이 해당 객체에 대한 box를 예측할 수 있어, 서로 겹치는 여러 탐지 결과가 생성됩니다.
이 때문에 모델의 raw output에는 단일 객체에 대한 여러 box가 포함되는 경우가 많습니다. 결과를 사용할 수 있도록 하려면 이러한 중복 예측을 필터링하여 최종 탐지 결과 하나만 남겨야 합니다.
비최대 억제 이해하기#
객체 탐지 모델이 동일한 객체에 대해 서로 겹치는 여러 bounding box를 생성하면, 해당 결과를 사용하기 전에 정리해야 합니다. 이때 비최대 억제가 적용됩니다.
비최대 억제는 모델이 예측을 완료한 후 실행되는 후처리 단계입니다. 목적은 중복 탐지 결과를 줄여 각 객체를 하나의 최종 bounding box로 표현하는 것입니다.
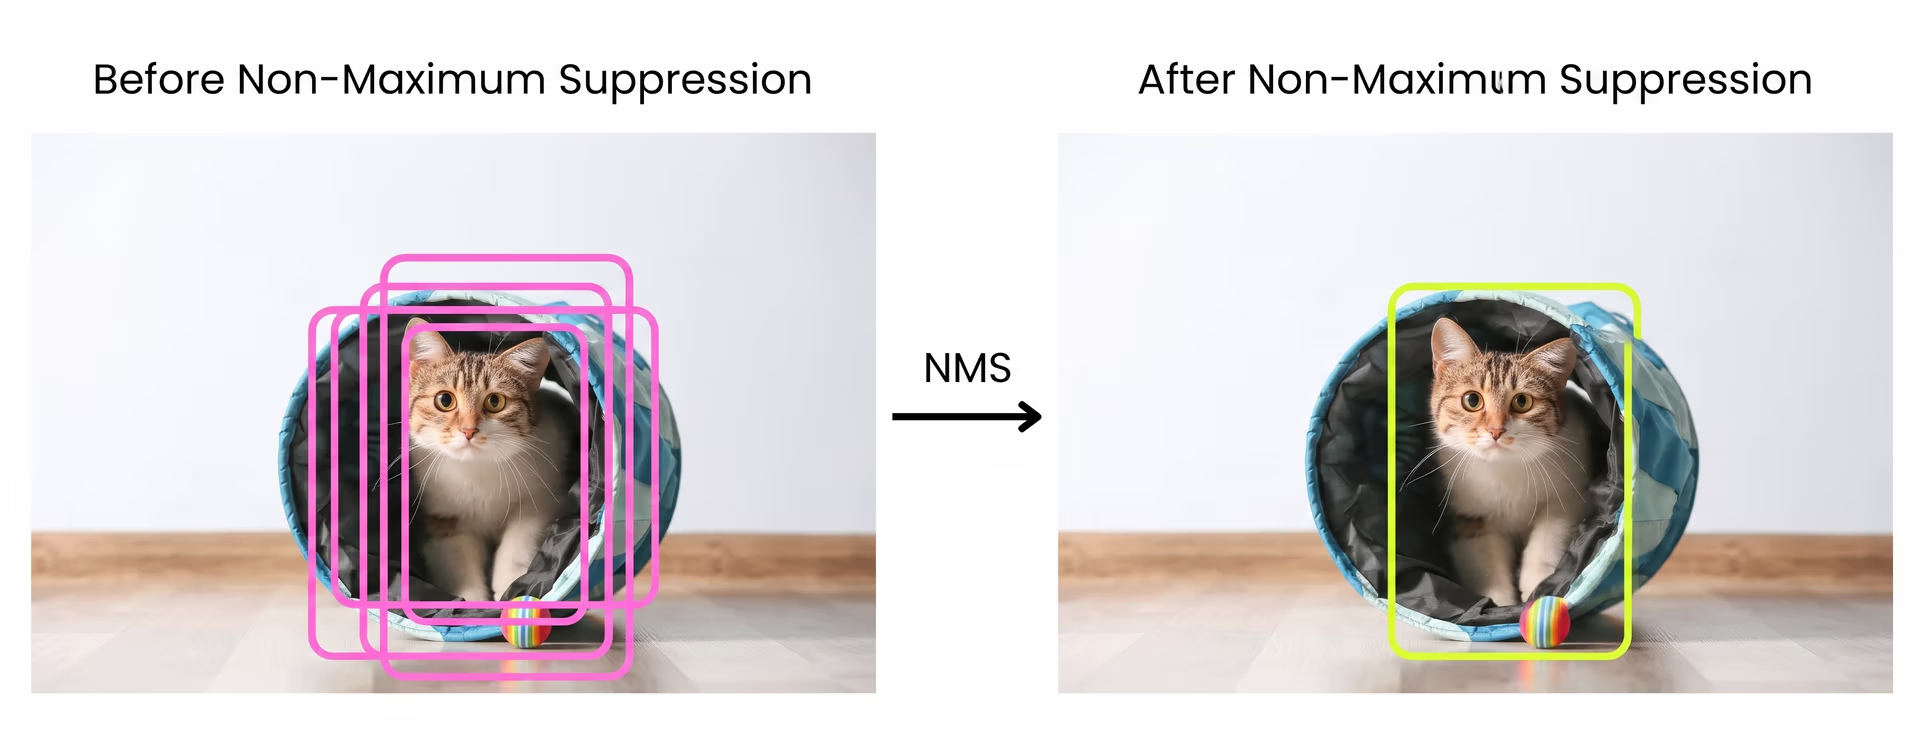
그림 2. NMS 개요. 이미지 작성자 제공
이 프로세스는 confidence score와 겹치는 정도를 기준으로 bounding box를 비교하는 방식으로 작동합니다. confidence가 매우 낮은 예측이 먼저 제거됩니다.
그런 다음 남은 box를 confidence 순으로 정렬하고, 가장 높은 score를 가진 box를 최적의 탐지 결과로 선택합니다. 선택된 box는 다른 box와 비교됩니다.
다른 box가 선택된 box와 지나치게 겹치면 해당 box를 억제하고 제거합니다. 겹침 정도는 일반적으로 Intersection over Union을 사용해 측정합니다. 이는 두 box가 공유하는 영역과 두 box가 포함하는 전체 영역 사이의 비율을 계산하는 metric입니다. 이 프로세스는 confidence가 가장 높고 서로 겹치지 않는 탐지 결과만 남을 때까지 반복됩니다.
NMS가 배포를 복잡하게 만드는 이유#
비최대 억제는 중복 탐지 결과를 필터링하는 데 도움이 되지만, 모델이 연구 환경을 벗어나 실제 환경에 배포되면 더욱 뚜렷해지는 문제도 발생시킵니다.
가장 큰 문제 중 하나는 성능입니다. NMS는 추론 후 실행되며, 어떤 bounding box를 유지할지 결정하기 위해 box끼리 비교해야 합니다.
이 프로세스는 연산 비용이 높고 효율적으로 병렬화하기도 어렵습니다. 엣지 디바이스와 CPU 기반 시스템에서는 이러한 추가 작업으로 인해 latency가 눈에 띄게 증가하여 실시간 요구 사항을 충족하기 어려워질 수 있습니다.
NMS는 배포 복잡성도 높입니다. NMS는 모델 자체에 포함되어 있지 않으므로 별도의 후처리 코드로 구현해야 합니다.
runtime과 플랫폼마다 NMS를 처리하는 방식이 다르기 때문에, 대상 환경별로 custom 구현을 유지해야 하는 경우가 많습니다. 한 환경에서 작동하는 방식이 다른 환경에서는 약간 다르게 동작할 수 있어 배포의 안정성이 떨어지고 확장하기도 어려워집니다.
하드웨어 최적화도 또 다른 과제입니다. NMS는 neural network 연산을 효율적으로 실행하도록 설계된 특수 AI accelerator에 쉽게 매핑되지 않습니다. 그 결과 최적화된 하드웨어에서 모델이 빠르게 실행되더라도 NMS가 병목이 되어 전체 성능을 제한할 수 있습니다.
이러한 요인 외에도 NMS는 confidence threshold와 overlap threshold처럼 수동으로 선택한 parameter에 의존합니다. 이러한 설정은 결과에 상당한 영향을 줄 수 있으며, 다양한 dataset, 애플리케이션 또는 하드웨어에 맞게 조정해야 하는 경우가 많습니다. 이로 인해 프로덕션 시스템에서 동작을 예측하기 어려워지고 추가적인 configuration overhead가 발생합니다.
End-to-end 객체 탐지 추론 설명#
비최대 억제의 한계로 인해 객체 탐지 모델이 추론 시 어떻게 동작해야 하는지 재고하게 되었습니다. 많은 겹치는 예측을 생성한 뒤 나중에 정리하는 대신, 더욱 근본적인 질문을 던졌습니다.
모델이 최종 탐지 결과를 직접 생성할 수 있다면 어떨까요? 이 질문은 end-to-end 객체 탐지 추론의 핵심입니다. end-to-end 시스템에서 모델은 외부 정리 단계에 의존하지 않고 처음부터 끝까지 전체 탐지 프로세스를 처리하도록 학습됩니다.
많은 candidate box를 생성한 후 추론이 끝나면 필터링하는 대신, 모델이 스스로 적은 수의 confidence가 높고 서로 겹치지 않는 예측을 생성하도록 학습합니다. 중복 탐지 결과는 후처리로 제거하는 것이 아니라 network 내부에서 해결됩니다.
최신 모델 아키텍처는 이러한 접근 방식이 가능하면서도 실용적임을 보여주었습니다. 적절한 학습 전략을 사용하면 모델은 여러 예측이 서로 경쟁하도록 하는 대신 각 객체를 하나의 예측과 연결하는 방법을 학습하여, 중복을 근본 원인부터 줄일 수 있습니다.
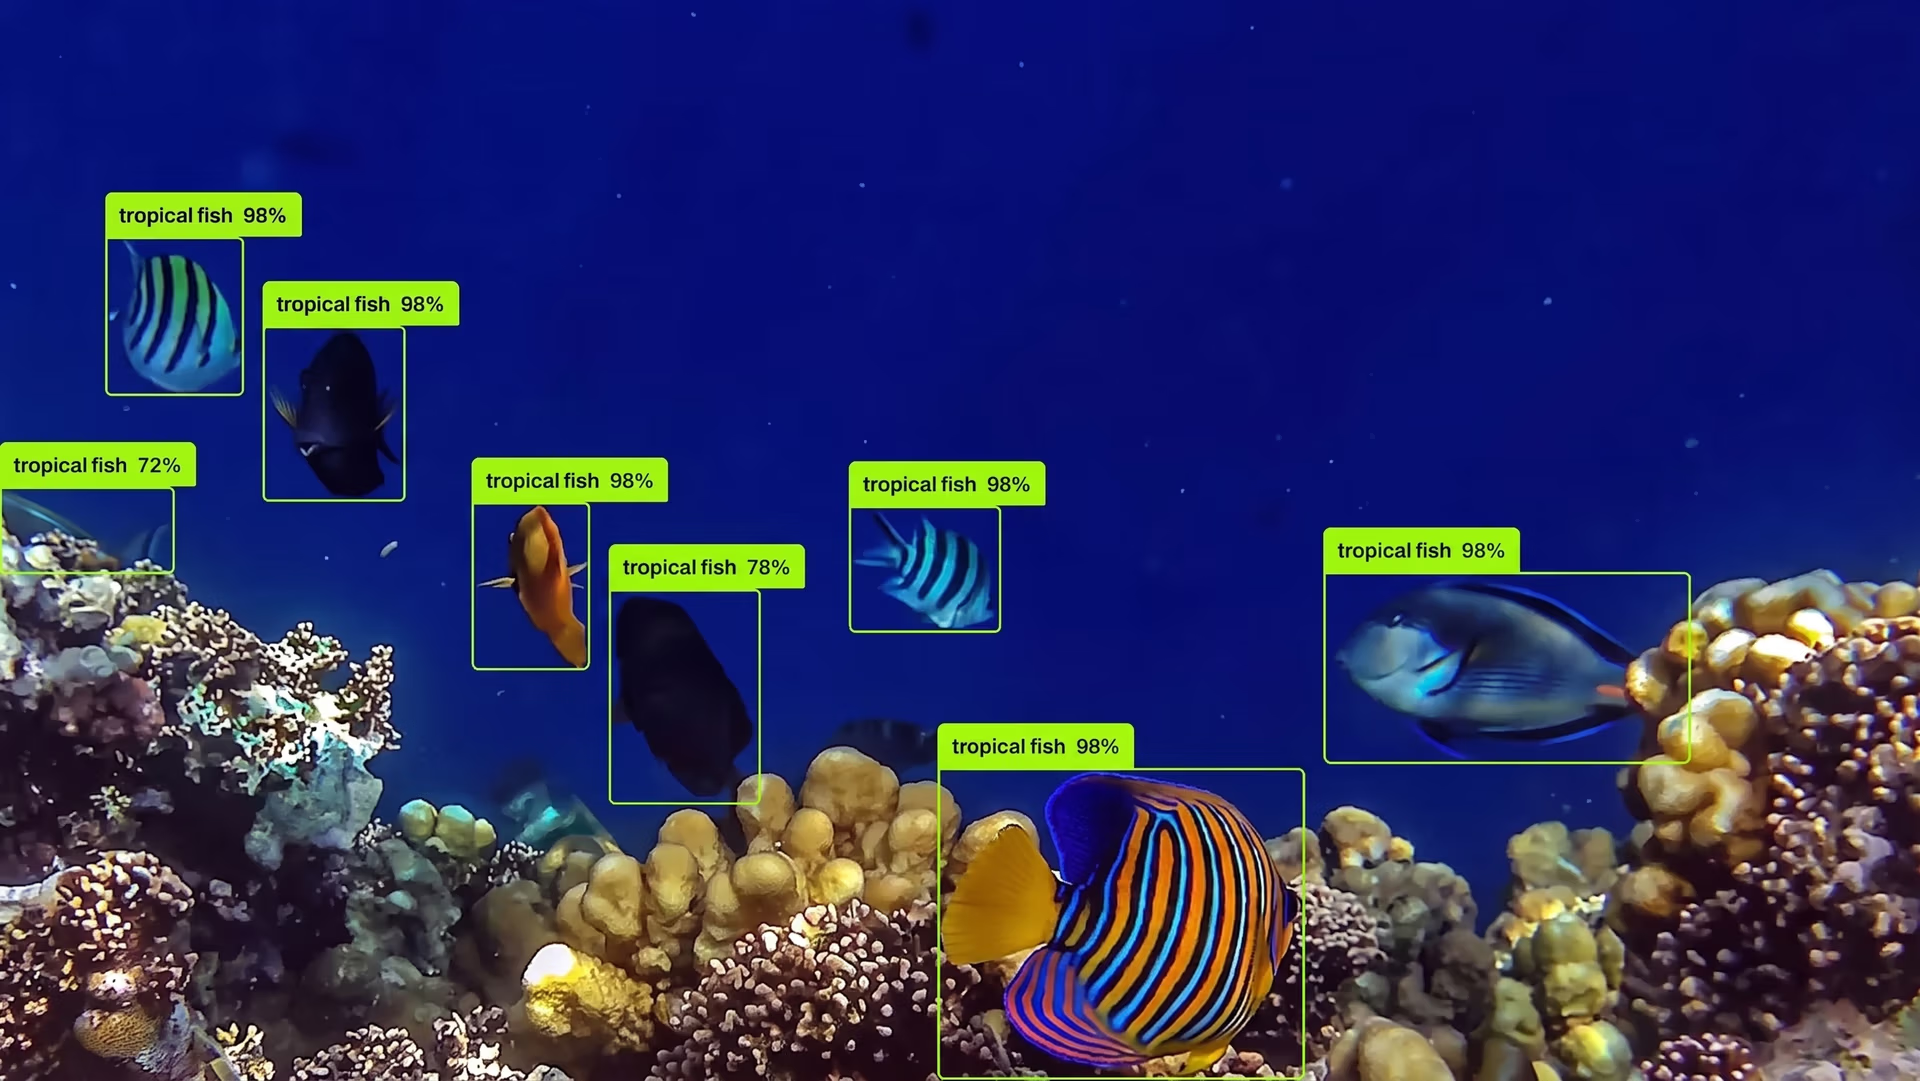
그림 3. Ultralytics YOLO26을 사용한 객체 탐지 예시
이 방식이 작동하려면 학습 방식도 바뀌어야 합니다. 여러 예측이 동일한 객체를 두고 경쟁하도록 하는 대신, 모델은 하나의 명확한 결정을 내리도록 학습하여 더 적고 confidence가 높은 탐지 결과를 생성합니다.
전체적인 결과는 더욱 단순한 추론 파이프라인입니다. 중복이 이미 내부에서 해결되므로 추론 시 비최대 억제가 필요하지 않습니다. 모델 output은 이미 최종 탐지 결과 집합입니다.
이 end-to-end 설계는 배포도 더욱 쉽게 만듭니다. 후처리 단계나 플랫폼별 NMS 구현이 없으므로 내보낸 모델은 완전히 self-contained하며 다양한 추론 framework와 하드웨어 target에서 일관되게 동작합니다.
Lead Partnership Engineer인 Francesco Mattioli는 다음과 같이 설명합니다. “진정한 end-to-end learning이란 모델이 미분 가능성을 저해하고 배포를 복잡하게 만드는 수작업 후처리 단계 없이 pixel부터 prediction까지 모든 작업을 처리해야 한다는 의미입니다.”
Ultralytics YOLO26이 NMS를 제거하는 방식#
Ultralytics YOLO26은 후처리를 통해 탐지 결과를 정리하는 대신 탐지 결과를 학습하고 생성하는 방식을 변경하여 비최대 억제를 제거합니다. 여러 예측이 동일한 객체를 두고 경쟁하도록 하는 대신, YOLO26은 객체와 output 간의 명확한 one-to-one 관계를 학습하도록 훈련됩니다.
이는 learnable query 기반 탐지를 통해 부분적으로 가능해집니다. 이 방식은 모델이 서로 겹치는 여러 candidate가 아니라 각 객체에 대해 하나의 confidence 높은 예측을 생성하는 데 집중하도록 돕습니다. 각 객체가 하나의 예측과 연결되므로 중복 탐지 결과가 자연스럽게 줄어듭니다.
이러한 동작은 학습 중 일관된 matching strategy를 통해 강화되며, 모델이 서로 겹치는 예측을 생성하는 대신 객체마다 하나의 confidence 높은 결정을 내리도록 유도합니다. 결과적으로 모델은 더 적은 수의 예측을 생성하지만, 각각이 최종 탐지 결과를 나타냅니다.
DFL을 제거하여 NMS-free 탐지가 가능해진 이유#
Ultralytics YOLO26에서 NMS-free 추론을 가능하게 한 또 다른 중요한 혁신은 Distribution Focal Loss, 즉 DFL을 제거한 것입니다. 이전 YOLO 모델에서 DFL은 하나의 값을 예측하는 대신 가능한 box location의 distribution을 예측하여 bounding box regression을 개선하는 데 사용되었습니다.
이 접근 방식은 localization 정확도를 향상시켰지만 탐지 파이프라인에 복잡성도 추가했습니다. 이러한 복잡성은 진정한 end-to-end 추론으로 전환할 때 한계로 작용했습니다.
DFL은 추가 연산과 고정된 regression range를 도입하여 모델이 명확한 one-to-one 객체 할당을 학습하기 어렵게 만들고 비최대 억제와 같은 후처리 단계에 대한 의존도를 높였습니다. Ultralytics YOLO26에서는 DFL을 제거하고 bounding box regression을 더욱 단순하고 직접적인 방식으로 재설계했습니다.
distribution 기반 output에 의존하는 대신, 모델은 더 적고 confidence가 높은 탐지 결과를 지원하는 방식으로 정확한 box coordinate를 예측하도록 학습합니다. 이러한 변경은 겹치는 예측을 근본 원인부터 줄이고 bounding box regression을 Ultralytics YOLO26의 end-to-end, NMS-free 설계에 맞추는 데 도움이 됩니다.
Ultralytics YOLO26은 NMS-free이며 배포가 쉽습니다#
NMS-free 설계를 적용한 Ultralytics YOLO26은 진정한 end-to-end 모델이 됩니다. 이는 모델 내보내기에 중요한 영향을 줍니다.
내보내기란 학습 환경 외부에서 실행할 수 있는 형식(예: ONNX, TensorRT, CoreML 또는 OpenVINO)으로 학습된 모델을 변환하는 것을 의미합니다. 기존 파이프라인에서는 비최대 억제가 모델 자체에 포함되지 않기 때문에 이 프로세스가 중단되는 경우가 많습니다.
NMS를 제거함으로써 Ultralytics YOLO26은 이 문제를 완전히 해결합니다. 내보낸 모델에는 최종 탐지 결과를 생성하는 데 필요한 모든 요소가 이미 포함되어 있습니다.
따라서 내보낸 모델은 완전히 self-contained하며 다양한 추론 framework와 하드웨어 target에서 더욱 portable하게 사용할 수 있습니다. 동일한 모델이 server, CPU-only 시스템, 임베디드 디바이스 또는 엣지 accelerator에 배포되더라도 일관되게 동작합니다. 내보낸 것이 곧 실행하는 것이므로 배포가 더욱 간단해집니다.
이러한 단순성은 엣지 애플리케이션에서 특히 중요합니다. 예를 들어 YOLO26은 드론과 같은 디바이스에 쉽게 배포하여 작물 모니터링, 현장 검사, 식물 건강 분석 등에 사용할 수 있습니다. 이러한 use case에서는 제한된 연산 및 전력 budget으로 인해 복잡한 후처리 파이프라인을 적용하기 어렵습니다. 모델이 최종 탐지 결과를 직접 output하므로 추가 처리 단계 없이 경량 하드웨어에서 안정적으로 실행됩니다.
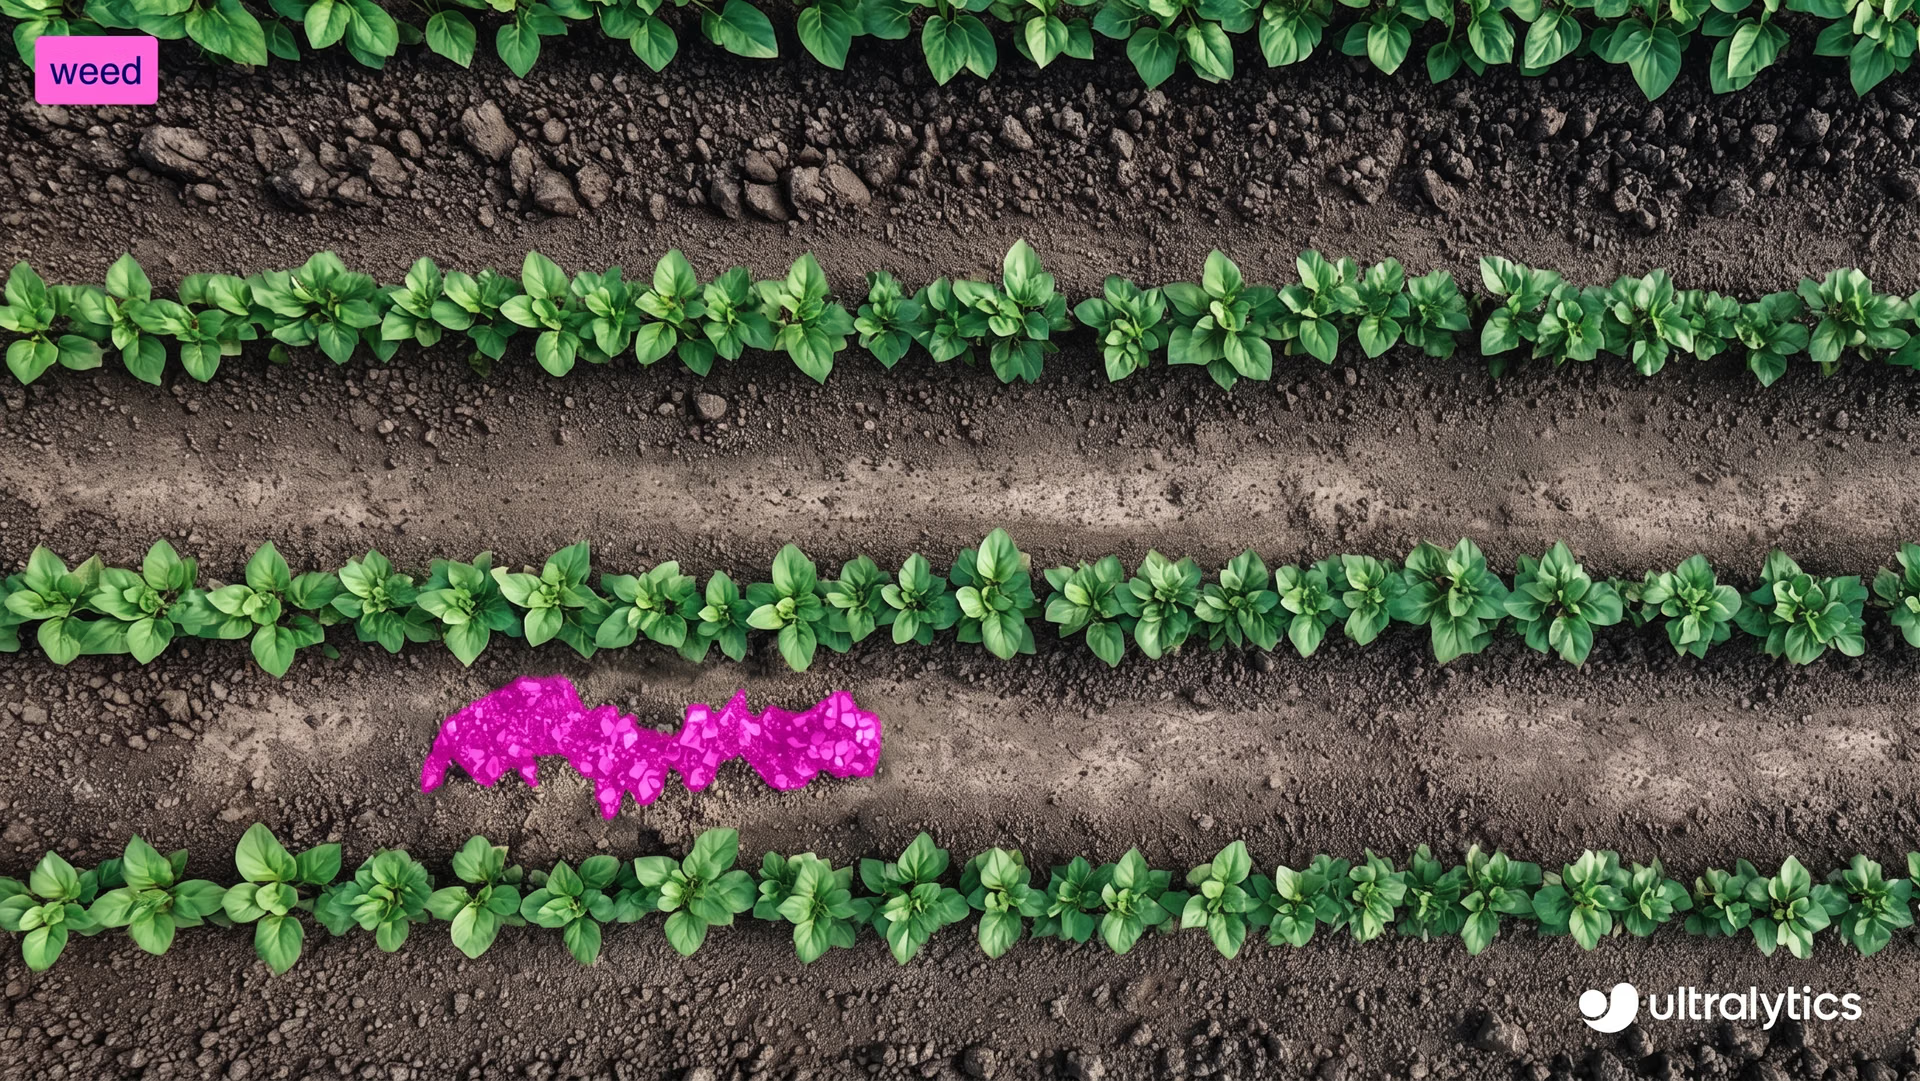
그림 4. Ultralytics YOLO26은 드론과 같은 엣지 디바이스에 쉽게 배포할 수 있습니다.
간단히 말해 NMS-free 추론은 내보내기와 배포 과정의 마찰을 줄이고 더욱 깔끔하고 안정적인 vision 시스템을 구현합니다. NMS는 workaround였습니다. 이제 Ultralytics YOLO26에는 workaround가 더 이상 필요하지 않습니다.
핵심 요점#
Ultralytics YOLO26은 사후에 중복 탐지 결과를 정리하는 대신 중복 탐지라는 근본적인 문제를 해결하여 비최대 억제를 제거합니다. end-to-end 설계를 통해 모델이 최종 탐지 결과를 직접 생성할 수 있으므로 다양한 하드웨어에서 내보내기와 배포가 더욱 간단하고 일관되게 이루어집니다. NMS는 기존 시스템에 유용한 workaround였지만 YOLO26에는 더 이상 필요하지 않습니다.
커뮤니티에 참여하고 GitHub repository를 확인하여 AI에 대해 자세히 알아보세요. 농업 분야의 AI 및 소매업의 컴퓨터 비전 솔루션 페이지를 살펴보세요. 라이선싱 옵션을 확인하고 지금 바로 vision AI를 시작해 보세요!








