Exporte e otimize o Ultralytics YOLOv8 para inferência com Intel OpenVINO
Exporte e otimize um modelo Ultralytics YOLOv8 com OpenVINO para obter uma inferência até 3 vezes mais rápida em CPUs e GPUs Intel e, em seguida, compare o desempenho com PyTorch.
 Nuvola Ladi4 min de leitura
Nesta publicação, vamos ver como podes exportar e otimizar o teu modelo Ultralytics YOLOv8, pré-treinado ou treinado à medida, para realizar inferência com o OpenVINO. Se utilizas um sistema baseado em Intel, seja com CPU ou GPU, este guia mostra-te como acelerar significativamente o teu modelo com o mínimo de esforço.
Por que otimizar o Ultralytics YOLOv8 com OpenVINO?#
Otimizar o teu modelo Ultralytics YOLOv8 com o OpenVINO pode proporcionar um aumento de velocidade até 3 vezes nas tarefas de inferência, sobretudo se estiveres a utilizar uma CPU Intel. Este aumento de desempenho pode fazer uma enorme diferença em aplicações em tempo real, desde a deteção de objetos à segmentação e aos sistemas de segurança.
Etapas para exportar e otimizar seu modelo Ultralytics YOLOv8#
Entendendo o processo#
Antes de mais nada, vamos detalhar o processo. Vamos converter um modelo PyTorch para o formato OpenVINO e otimizá-lo. Na época do vídeo, essa conversão passava pelo ONNX como etapa intermediária; as versões atuais da Ultralytics fazem a conversão diretamente do PyTorch. O processo envolve algumas etapas simples e pode ser aplicado a vários modelos e formatos, incluindo TensorFlow, PyTorch e ONNX.
Exportando o modelo#
Ao explorar a documentação da Ultralytics, vemos que exportar um modelo YOLOv8 envolve usar o método export do framework Ultralytics. Esse método converte nosso modelo de PyTorch e o otimiza para OpenVINO. O resultado é um modelo que roda significativamente mais rápido em hardware Intel.
Instalando as dependências#
Antes de executar o script de exportação, você precisa garantir que todas as dependências necessárias estejam instaladas. Elas incluem a biblioteca Ultralytics e o OpenVINO. A instalação desses pacotes é simples e pode ser feita por meio do pip, o instalador de pacotes do Python.
Executando o script de exportação#
Depois de configurar seu ambiente, você pode executar o script de exportação. Esse script converterá seu modelo PyTorch para OpenVINO. O processo é simples e envolve chamar uma única função para realizar a exportação. O framework Ultralytics facilita a conversão e a otimização dos seus modelos, garantindo o melhor desempenho com o mínimo de complicações.
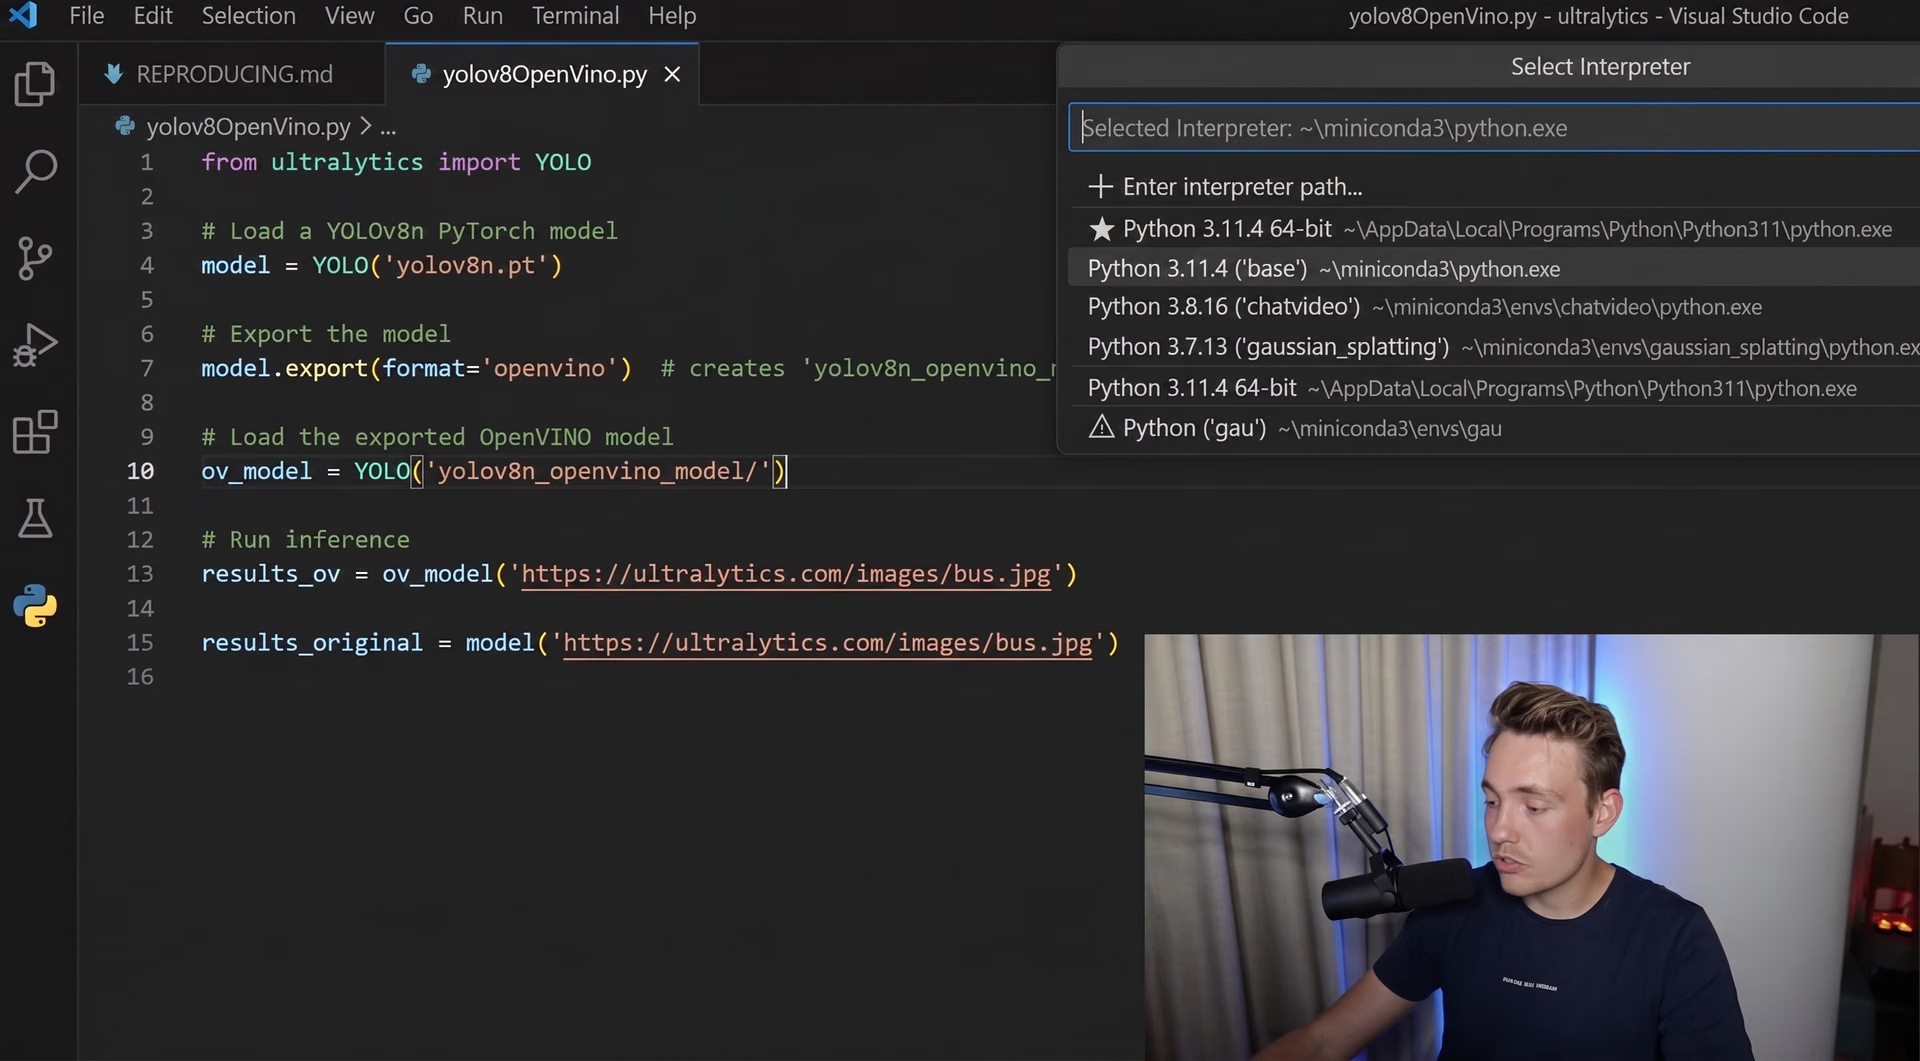
Fig. 1. Nicolai Nielsen explicando como executar o script de exportação.
Comparando o desempenho#
Após a exportação, é essencial comparar o desempenho dos modelos original e otimizado. Ao comparar o tempo de inferência de ambos os modelos, você consegue ver claramente os ganhos de desempenho. Em geral, o modelo OpenVINO apresenta uma redução significativa no tempo de inferência em comparação com o modelo PyTorch original. Isso é especialmente válido para modelos maiores, nos quais o ganho de desempenho é mais perceptível.
Aplicações e benefícios no mundo real#
Otimizar modelos Ultralytics YOLOv8 com OpenVINO é especialmente vantajoso para aplicações que exigem processamento em tempo real. Veja alguns exemplos:
- Sistemas de segurança: a detecção de objetos em tempo real pode alertar imediatamente as equipes de segurança, aumentando a proteção e a capacidade de resposta.
- Veículos automatizados: velocidades de inferência mais altas melhoram a capacidade de resposta dos sistemas de direção autônoma, tornando-os mais seguros e confiáveis.
- Saúde: o processamento rápido de imagens para ferramentas de diagnóstico pode salvar vidas ao fornecer resultados mais rapidamente e permitir intervenções oportunas.
Ao implementar essas otimizações, você não apenas melhora o desempenho, mas também aumenta a confiabilidade e a eficiência das suas aplicações. Isso pode resultar em melhores experiências para os usuários, maior produtividade e soluções mais inovadoras.
Encerramento#
Exportar e otimizar um modelo Ultralytics YOLOv8 para OpenVINO é uma maneira eficaz de aproveitar o hardware Intel para executar aplicações de IA com mais rapidez e eficiência. Com apenas algumas etapas simples, você pode melhorar significativamente o desempenho do seu modelo e aplicá-lo com eficácia a situações do mundo real.
Confira mais tutoriais e guias da Ultralytics, como a lição OpenVINO na CPU da Ultralytics Academy, para continuar aprimorando seus projetos de IA. Visite nosso repositório do GitHub e participe da comunidade Ultralytics para conferir mais informações e novidades.
Lembre-se: otimizar seus modelos não é apenas uma questão de velocidade — é uma forma de desbloquear novas possibilidades e garantir que suas soluções de IA sejam robustas, eficientes e estejam prontas para o futuro.
Escrito por
Gerente de conteúdo digital · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









