Computer Vision (CV)
Explora como a visão computacional permite às máquinas interpretar imagens e vídeo. Aprende as principais tarefas, aplicações industriais e como começar com o Ultralytics YOLO.
A visão computacional (CV) é a área da inteligência artificial (AI) que permite aos computadores e sistemas obter informações relevantes a partir de imagens digitais, vídeos e outros dados visuais. Se a AI permite que as máquinas pensem, a visão computacional permite que vejam, observem e compreendam. Ao contrário das ferramentas de processamento de imagem baseadas em regras, os sistemas modernos aprendem diretamente com os dados: não lhes é dito explicitamente como é um carro ou um tumor; em vez disso, identificam os padrões subjacentes em milhares de exemplos anotados e generalizam esse conhecimento para imagens que nunca encontraram. Ao aplicar aprendizagem automática (ML) e aprendizagem profunda (DL), a visão computacional transforma dados visuais não estruturados em decisões sobre as quais o software pode agir.
Como funciona a visão computacional#
Um computador vê uma imagem como uma matriz de valores numéricos que representam píxeis. Transformar essa matriz numa ação segue um pipeline de cinco etapas.
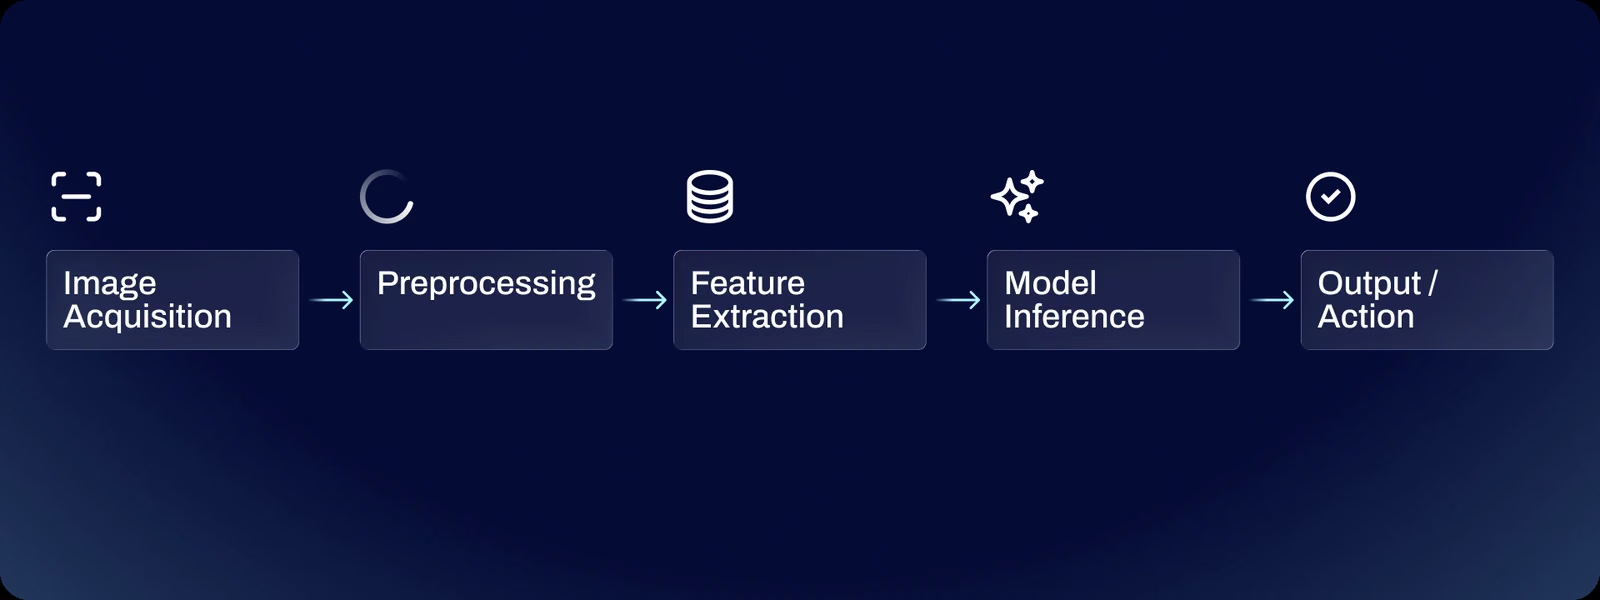
Aquisição de imagem. O fluxo de trabalho começa com hardware — sensores CMOS, câmaras de infravermelhos ou scanners LiDAR — que captam luz e a convertem numa grelha digital de píxeis. A calibração da câmara tem em conta a geometria da lente antes do início da análise.
Pré-processamento. Os dados capturados são normalizados para que o modelo receba uma entrada consistente: redimensionamento, redução de ruído e ajuste do contraste.
Extração de características. O sistema identifica características de baixo nível, como contornos, gradientes e cantos. À medida que os dados avançam pela rede, esses elementos básicos combinam-se em características de alto nível — texturas, padrões e geometrias complexas. Um sistema pode detetar linhas verticais, reconhecê-las como postes de uma vedação e depois compreender a cena como um limite de perímetro. Este processo é conhecido como extração de características.
Inferência do modelo. O motor da visão computacional moderna é a rede neuronal convolucional (CNN). Ao contrário de uma rede neuronal padrão, que trata uma imagem como uma lista plana de números, as CNN preservam a relação espacial entre os píxeis, utilizando filtros que deslizam pela imagem para detetar padrões independentemente do local onde aparecem no enquadramento. Mais recentemente, os Transformers de visão (ViTs) surgiram como uma alternativa poderosa, aplicando o mecanismo de atenção do processamento de linguagem natural a dados de imagem.
Saída e ação. O modelo devolve um resultado estruturado — uma etiqueta, um conjunto de caixas delimitadoras ou uma máscara de píxeis — sobre o qual o sistema envolvente atua: rejeitar uma peça defeituosa, travar um veículo ou emitir um alerta.
Como um modelo aprende#
Um modelo é tão bom quanto os dados que consome. A aprendizagem supervisionada requer grandes volumes de dados de treino, e referências de avaliação como ImageNet e COCO fornecem milhões de exemplos anotados. Durante o treino, o modelo faz uma previsão, compara-a com a etiqueta de referência e ajusta os seus pesos internos para reduzir o erro. Depois de treinado, esse mesmo modelo executa a etapa de inferência acima.
A transição dos sistemas baseados em regras para a aprendizagem profunda#
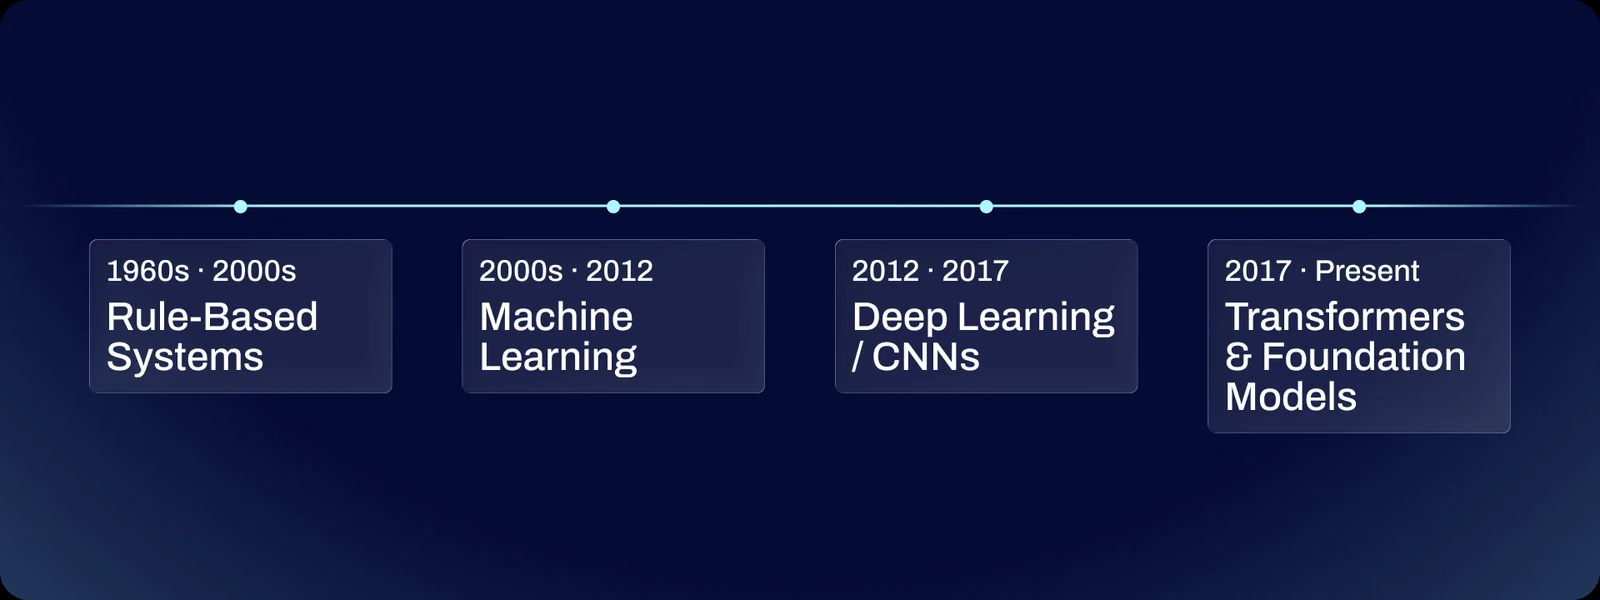
A visão computacional inicial dependia da engenharia manual de características: os engenheiros definiam parâmetros geométricos rígidos para ajudar as máquinas a reconhecer objetos. Esses sistemas eram frágeis e falhavam sempre que a iluminação mudava ou um objeto aparecia num ângulo desconhecido. A publicação de AlexNet em 2012, treinada com mais de um milhão de imagens anotadas do ImageNet, marcou o ponto de viragem ao demonstrar que as redes convolucionais podiam superar abordagens concebidas manualmente em grande escala. A aprendizagem profunda substituiu regras ajustadas manualmente por arquiteturas que aprendem as suas próprias características — suficientemente flexíveis para funcionar em condições reais que nunca são perfeitamente controladas.
Visão computacional vs. processamento de imagem vs. visão industrial#
É importante distinguir a visão computacional das áreas adjacentes com as quais é frequentemente confundida.
- Processamento de imagem manipula uma imagem para a melhorar ou extrair informação — ajustando o brilho e o contraste ou aplicando filtros. A sua saída é geralmente outra imagem. A visão computacional recebe uma imagem como entrada e produz uma interpretação ("há três pessoas nesta sala"). A visão computacional utiliza regularmente o processamento de imagem como etapa de preparação.
- Visão industrial refere-se a sistemas de inspeção industrial que funcionam em ambientes rigorosamente controlados, com iluminação fixa e posições conhecidas das peças. A visão computacional é a disciplina mais abrangente, concebida para lidar com condições imprevisíveis e não controladas.
- O processamento de linguagem natural lida com texto e voz. A visão computacional centra-se inteiramente nos dados visuais, embora os modelos de linguagem e visão estejam cada vez mais a estabelecer uma ponte entre as duas áreas.
Principais tarefas de visão computacional#
A visão computacional não é uma única função, mas um conjunto de tarefas distintas, cada uma resolvendo um problema diferente. Para uma explicação mais aprofundada de cada uma, consulta o guia completo sobre tarefas de visão computacional.
- Classificação de imagens: atribui uma única etiqueta a uma imagem inteira, respondendo à pergunta "o que está nesta imagem?" — por exemplo, classificando produtos como defeituosos ou não defeituosos. Estreitamente relacionada está a reconhecimento de imagens, que identifica o que está presente.
- Deteção de objetos: identifica objetos distintos e desenha uma caixa delimitadora à volta de cada um, permitindo aos sistemas contar e localizar vários objetos num único enquadramento.
- Segmentação de instâncias: produz uma máscara ao nível dos píxeis para cada objeto detetado, separando instâncias individuais da mesma classe. A segmentação semântica, por sua vez, atribui uma classe a cada píxel sem distinguir instâncias.
- Estimativa de pose: deteta pontos-chave num objeto, como as articulações do corpo humano, para acompanhar o movimento e a postura.
- Caixas delimitadoras orientadas: ajustam caixas rodadas a objetos que não estão alinhados com os eixos — algo essencial em imagens aéreas e de satélite.
- Rastreamento de objetos: acompanha um objeto ao longo de um fluxo de vídeo, mantendo um ID consistente entre enquadramentos. O fluxo ótico amplia esta capacidade ao analisar o movimento aparente entre enquadramentos consecutivos.
- Reconhecimento ótico de caracteres (OCR): converte imagens de texto impresso ou manuscrito em dados legíveis por máquina, automatizando o processamento de documentos em grande escala.
Escolher a tarefa certa#
Alinhar a tarefa técnica com o objetivo empresarial desde o início evita retrabalho dispendioso.
| Objetivo empresarial | Tarefa a utilizar |
|---|---|
| Classificar produtos por categorias | Classificação de imagens |
| Contar itens ou localizar a sua posição | Deteção de objetos |
| Analisar a forma exata ou o limite de um objeto | Segmentação de instâncias |
| Acompanhar o movimento ao longo dos enquadramentos de vídeo | Acompanhamento de objetos |
| Medir a posição do corpo ou os ângulos das articulações | Estimativa de pose |
| Detetar objetos rodados em imagens aéreas | Caixas delimitadoras orientadas |
| Ler texto de documentos ou etiquetas | Reconhecimento ótico de caracteres |
Aplicações no mundo real#
Atualmente, a visão computacional sustenta sistemas de produção na maioria dos principais setores.
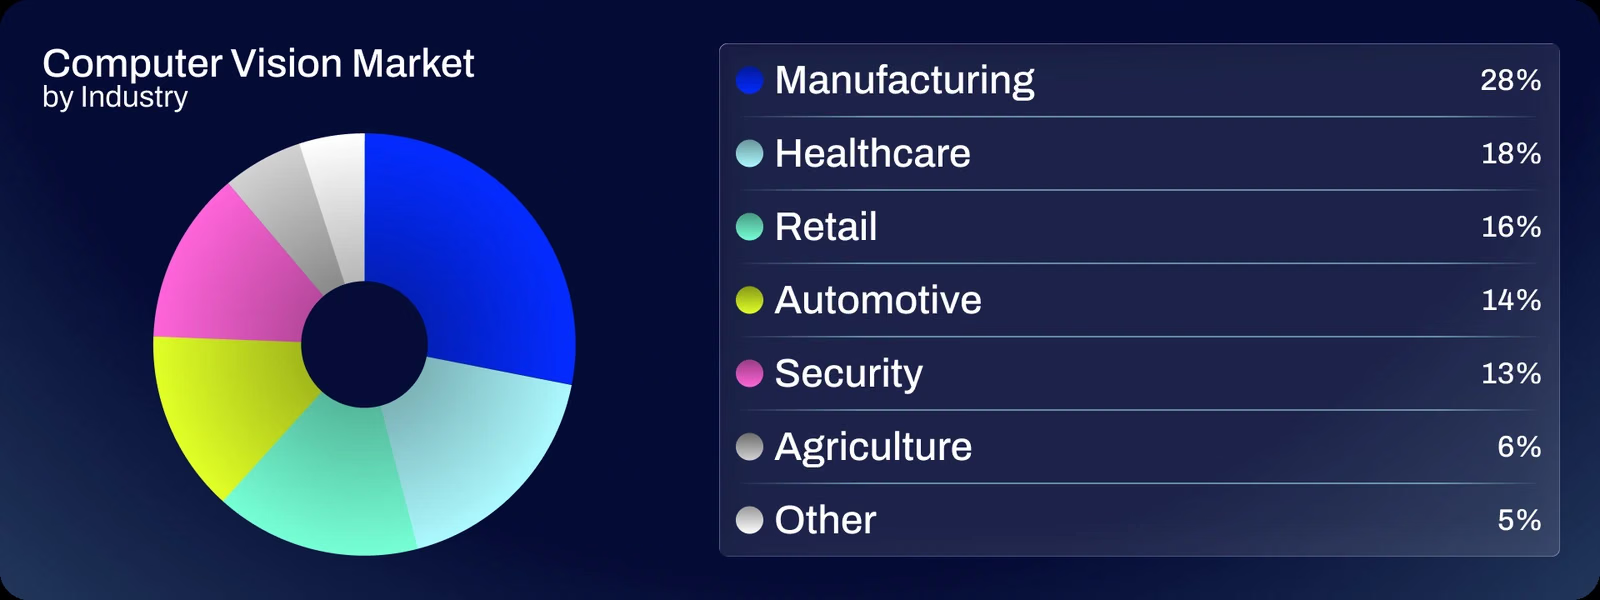
- Indústria transformadora e controlo de qualidade. As linhas de produção modernas funcionam mais depressa do que a capacidade visual humana. Os sistemas de visão realizam inspeção de qualidade instantânea, identificando fissuras microscópicas ou componentes desalinhados à velocidade da linha, sem a fadiga que se acumula num inspetor humano. A monitorização dos padrões de desgaste das máquinas também permite a manutenção preditiva — identificando sinais de falha antes que uma avaria provoque paragens não planeadas. Consulta visão computacional na indústria transformadora e deteção de defeitos.
- Saúde e diagnóstico. Os algoritmos de análise de imagens médicas processam radiografias, RM e TC para detetar tumores em fase inicial, microfraturas e anomalias da retina que são fáceis de não detetar sob pressão de tempo. Na sala de operações, os sistemas de visão fornecem mapeamento espacial em tempo real durante procedimentos minimamente invasivos. Consulta visão computacional na saúde.
- Retalho. As lojas sem caixas utilizam fusão de sensores e algoritmos de visão para acompanhar os artigos retirados das prateleiras e cobrar automaticamente aos clientes. Os mesmos sistemas monitorizam os níveis das prateleiras em tempo real para acionar alertas de reposição, apoiando a gestão de inventário e a prevenção de perdas no retalho. Consulta visão computacional no retalho.
- Transportes autónomos. A camada de perceção é o componente mais crítico para a segurança de um carro autónomo. Os sistemas de visão identificam marcações de faixa, sinais de trânsito, peões e outros veículos em tempo real, combinando a entrada da câmara com radar e LiDAR para criar um modelo de 360 graus do ambiente do veículo através da deteção de objetos 3D. Consulta veículos autónomos.
- Segurança e monitorização. A infraestrutura de segurança passou da gravação passiva para a intervenção proativa — detetando permanências prolongadas em zonas restritas, assinalando padrões comportamentais invulgares à medida que ocorrem e apoiando a gestão de filas em espaços públicos. A deteção de anomalias é a capacidade subjacente.
- Agricultura. Drones e tratores avaliam a saúde das culturas ao nível de cada planta, analisando imagens multiespectrais para detetar desidratação, infestação de pragas ou deficiência de nutrientes. A água, os pesticidas e os fertilizantes são depois aplicados apenas onde são necessários, em vez de serem distribuídos por campos inteiros. Consulta visão computacional na agricultura.
Visão computacional na periferia#
A análise visual em tempo real é cada vez mais executada na periferia — diretamente na câmara ou num gateway local — em vez de encaminhar o vídeo para um servidor cloud centralizado. Isto é importante por dois motivos.
A latência aproxima-se de zero, algo indispensável na robótica autónoma ou na inspeção de linhas industriais, onde um atraso de milissegundos provoca erros. E, como apenas os metadados atravessam a rede, em vez do vídeo bruto, os requisitos de largura de banda diminuem significativamente e a privacidade melhora, uma vez que as imagens sensíveis nunca saem do dispositivo local. A AI na periferia e a inferência em tempo real tornam isto prático, e opções de implementação de modelos como ONNX e TensorRT permitem que um único modelo treinado funcione em hardware diversificado.
Desafios e limitações#
Qualidade dos dados. Um modelo reflete a qualidade dos seus dados de treino. Conjuntos de dados de baixa resolução, mal anotados ou não representativos produzem modelos pouco fiáveis, e criar um conjunto de dados anotado e diversificado é frequentemente mais trabalhoso do que conceber o algoritmo. Consulta rotulagem de dados.
Variáveis ambientais. Chuva intensa, reflexos na lente, oclusão parcial e escala variável dos objetos degradam o desempenho. Os sistemas robustos dependem do aumento de dados durante o treino para simular estas condições e criar resiliência antes da implementação, bem como de uma validação cuidadosa para evitar o sobreajuste.
Considerações éticas e enviesamento. Um modelo treinado com um conjunto de dados sem diversidade demográfica terá um desempenho desigual entre grupos populacionais. As organizações que implementam sistemas que analisam pessoas — em imagiologia médica, segurança no trabalho ou espaços públicos — devem auditar os seus conjuntos de dados quanto à equidade e cumprir a regulamentação emergente relativa à tomada de decisões automatizada.
O futuro da visão computacional#
Os Transformers de visão estão a transformar o que é possível alcançar em tarefas que exigem compreender as relações entre partes distantes de uma imagem. Além disso, a aprendizagem multimodal combina dados visuais com texto, áudio e profundidade para criar sistemas com uma compreensão contextual mais rica — os modelos de linguagem e visão que respondem a perguntas sobre imagens são um exemplo inicial.
A AI generativa está a responder diretamente à escassez de dados. Os dados sintéticos tornam possível criar imagens hiper-realistas de cenários raros — modos de falha específicos ou manifestações incomuns de doenças — que não podem ser recolhidos em volume suficiente no mundo real. Entretanto, as câmaras de deteção de profundidade e o LiDAR estão a levar os sistemas para além da análise de imagens planas, rumo à computação espacial, na qual a informação digital é sobreposta ao mundo físico para aplicações como manutenção orientada por RA e mapeamento estrutural.
Implementar visão computacional com a Ultralytics#
Para equipas que estão a testar um projeto de visão computacional, a Ultralytics YOLO26 é um ponto de partida prático para deteção de objetos em tempo real — de código aberto, amplamente documentada e suficientemente rápida para funcionar na periferia. Os valores de precisão e latência em diferentes hardwares são publicados na página de benchmarks, com comparações de modelos lado a lado na documentação. O ecossistema mais abrangente inclui OpenCV para processamento clássico de imagem e PyTorch como principal framework de treino.
from ultralytics import YOLO

# Load the YOLO26n model (nano version for speed)
model = YOLO("yolo26n.pt")

# Run inference on a standard example image
# The model identifies objects and their locations
results = model("https://ultralytics.com/images/bus.jpg")

# Display the resulting image with bounding boxes
results[0].show()
Este script utiliza um modelo pré-treinado para realizar inferência em poucas linhas. As equipas que passam de um projeto-piloto para produção podem utilizar a Ultralytics Platform para anotar conjuntos de dados, treinar modelos na cloud e gerir a implementação, ou aplicar aprendizagem por transferência para adaptar um modelo pré-treinado a um conjunto de dados personalizado com muito menos dados anotados do que seriam necessários para treinar do zero.
Perguntas frequentes
A aprendizagem automática é a disciplina mais abrangente de criação de sistemas que aprendem com dados. A visão computacional é a aplicação dessa disciplina — geralmente através de aprendizagem profunda — a entradas visuais, como imagens e vídeo. Quase toda a visão computacional moderna se baseia em aprendizagem automática, mas a aprendizagem automática também abrange texto, áudio e dados tabulares.
Não. O reconhecimento de imagens é uma tarefa da visão computacional — identificar o que aparece numa imagem. A visão computacional também abrange deteção de objetos, segmentação, estimativa de pose, rastreamento e compreensão de cenas.
Depende da complexidade da tarefa e do grau de variação que o modelo tem de suportar. A aprendizagem por transferência a partir de um modelo pré-treinado, como a Ultralytics YOLO26, reduz substancialmente esse requisito, e frequentemente é possível treinar detetores personalizados úteis com algumas centenas a alguns milhares de imagens anotadas por classe, em vez dos milhões utilizados para treinar modelos fundacionais.
Sim. Os modelos podem ser implementados diretamente em dispositivos de periferia e funcionar totalmente offline, uma prática comum quando a latência, a largura de banda ou as regras de privacidade dos dados impedem o envio de vídeo para a cloud.
Python predomina, graças à maturidade do seu ecossistema — o pacote
ultralytics, PyTorch e OpenCV. C++ é utilizado quando é necessário obter o máximo desempenho de inferência, normalmente em sistemas incorporados e automóveis.








