在 LiteRT 上导出 Ultralytics YOLO
了解全新的 LiteRT 导出集成如何通过统一格式,将 Ultralytics YOLO 推理带到移动设备、嵌入式设备、边缘设备和浏览器环境。
在 Ultralytics,我们发现越来越多的人开始直接在需要运行的设备上运行计算机视觉模型,而不是依赖云连接。移动应用、嵌入式系统、IoT 传感器和基于浏览器的工具越来越需要在本地运行推理,而且通常要在电量和算力预算有限的硬件上运行。因此,我们很高兴宣布,Ultralytics YOLO 模型现在可以直接导出为 LiteRT 格式。
要满足这一需求,就需要一种能适用于所有这些环境的模型格式,同时不必强迫开发者为每种环境分别维护导出流程。
此前,第三方非官方软件包已提供这项功能,但这次的新集成源于我们与 Google 的官方合作。我们与 LiteRT 团队紧密合作,构建了一个端到端流程,可通过 LiteRT 将 Ultralytics YOLO 模型导出为 TFLite。借助这项集成,只需导出一个 Ultralytics YOLO 模型,就能部署到移动设备、嵌入式设备、边缘设备和浏览器环境;它将旧版 TFLite 和 TF.js 导出格式分别处理的场景整合为一种简洁统一的格式。
什么是 LiteRT?#
LiteRT 是 Lite Runtime 的简称,是 Google 为设备端 AI 打造的高性能运行时。它是 TensorFlow Lite (TFLite) 的新一代版本和新名称,并使用开发者熟悉的相同 .tflite 模型格式运行。
LiteRT 是一个专为设备端推理设计的开源框架,这种推理也称为边缘计算。它为开发者提供了工具,可在移动设备、嵌入式设备和 IoT 设备、传统计算机上运行训练好的模型,也可通过 LiteRT.js 直接在 Web 浏览器和 Node.js 中运行。LiteRT 导出格式会针对目标检测、分割、姿态估计和分类等任务优化模型,使其能在各种设备上快速离线运行。
为什么要将 Ultralytics YOLO 模型导出为 LiteRT?#
现在,一种模型格式即可覆盖所有部署目标:
• 移动设备和嵌入式设备。 Android、iOS、桌面设备、嵌入式 Linux 和微控制器 (MCU)。
• 边缘加速器。 兼容 Coral Edge TPU,可进一步加速。
• 浏览器和 Node.js。 LiteRT.js 可在 Web 上运行相同的 .tflite 模型,并通过 WebGPU/WASM 加速,无需再单独导出 TensorFlow.js 格式。
• 桌面设备
这种整合很重要,因为它消除了生产部署中的一个实际障碍。团队无需再分别维护移动设备、浏览器和边缘加速器的导出流程,现在只需导出一次,就能部署到所有支持 LiteRT 的环境中。
LiteRT 模型的主要特性#
• 设备端优化。 在本地处理数据以降低延迟;不传输个人数据以增强隐私保护;并缩小模型尺寸以节省空间。
• 支持多种平台。 可在 Android、iOS、嵌入式 Linux、微控制器和现代 Web 浏览器上运行。
• 硬件加速。 在 CPU 上使用 XNNPACK,并通过 OpenCL、Metal 和 WebGPU 提供 GPU 加速。GPU 加速默认以 FP16 运行,以进一步提升速度。
• 量化。 支持 FP32、静态 INT8、静态 INT16 激活和动态 INT8,可在精度损失极小的情况下压缩模型并加快推理速度。
• 支持多种语言。 兼容 Java/Kotlin、Swift、Objective-C、C++、Python 和 JavaScript。
开始使用 LiteRT 导出#
Ultralytics Python 软件包和 Ultralytics Platform提供了完整统一的环境,可用于训练、评估和部署 YOLO 模型,覆盖全部五种计算机视觉任务。LiteRT 导出格式支持导出、预测和验证模式,因此模型导出后即可立即在本地用于推理或精度验证。
只需一条命令即可导出模型:
from ultralytics import YOLO

# 加载 YOLO26 模型
model = YOLO("yolo26n.pt")

# 将模型导出为 LiteRT 格式
model.export(format="litert") # 创建 'yolo26n.tflite'
对于要部署到资源受限硬件的团队,LiteRT 还支持量化导出,可在精度损失极小的情况下压缩模型,以加快推理速度:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# 动态 INT8:int8 权重、FP32 激活——无需校准数据
model.export(format="litert", quantize="w8a32")

# 静态 INT8:int8 权重 + int8 激活——需要校准数据
model.export(format="litert", quantize=8, data="coco8.yaml")
导出后,可以直接加载模型并运行推理:
from ultralytics import YOLO

# 加载导出的 LiteRT 模型
model = YOLO("yolo26n.tflite")

# 运行推理
results = model("https://ultralytics.com/images/bus.jpg")
目前,LiteRT 导出支持 Linux x86_64 和 macOS。导出的 .tflite 模型本身可在所有 LiteRT 支持的平台上运行,包括移动设备、嵌入式设备、边缘设备和浏览器。
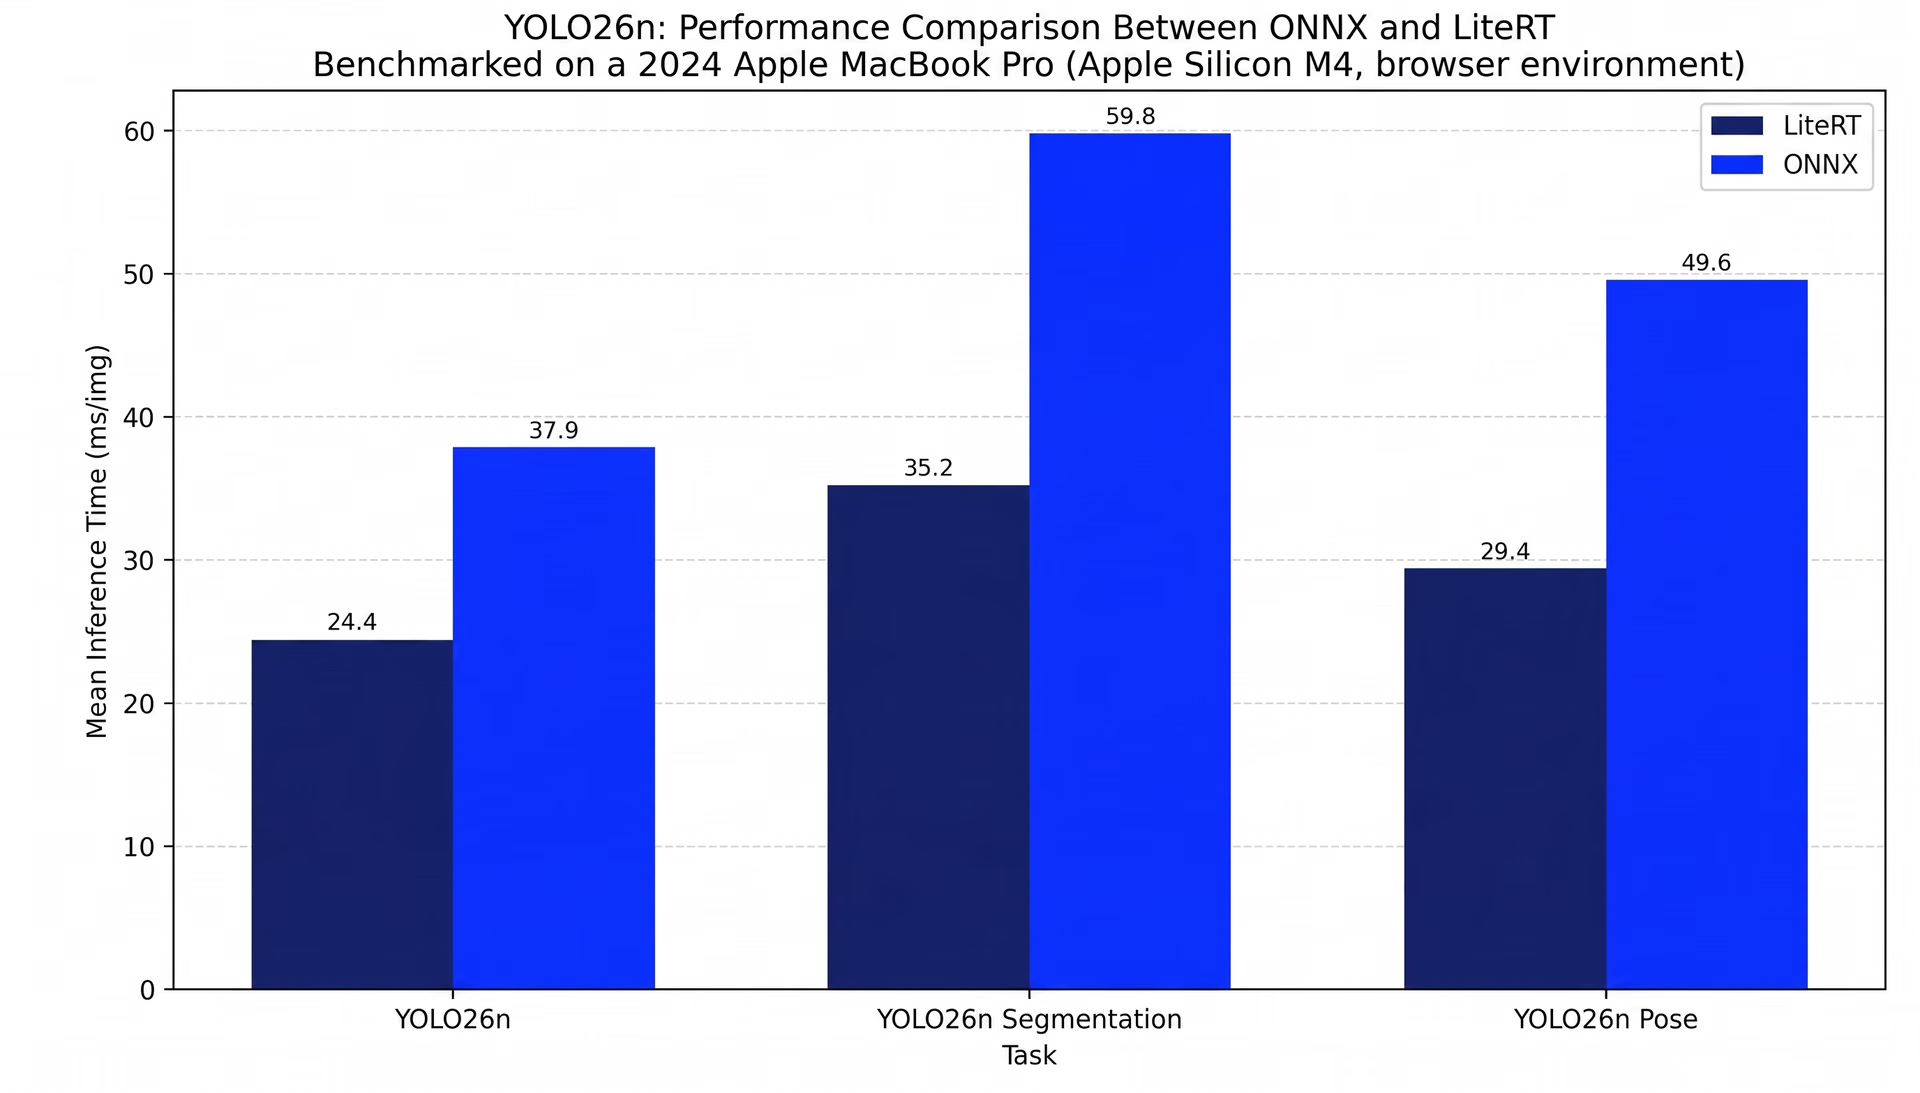 图 1. ONNX 与 LiteRT 的性能对比。
上图对比了检测、分割和姿态估计的平均推理时间。测试对象为 YOLO26n,通过 @ultralytics/yolo 在浏览器中运行;这是 Ultralytics 的 npm 软件包,可通过 ONNX Runtime Web 在客户端使用 WebGPU/WASM 进行推理。测试在 2024 款 Apple MacBook Pro(Apple Silicon M4)上,在受控的浏览器环境中进行。
将 Ultralytics YOLO 带到边缘端#
借助 LiteRT,将 Ultralytics YOLO 模型部署到移动设备、嵌入式设备、边缘设备和浏览器环境,不再需要为每个目标分别维护导出流程。只需导出一次,使用一种模型格式,即可从训练到生产部署保持一致,无论推理需要在哪里运行。
想了解视觉 AI?查看我们的许可选项,将计算机视觉应用到你的项目中。访问我们的 GitHub 代码库,了解完整的 Ultralytics 导出集成;还可以看看 Ultralytics Platform,开始构建自己的端到端视觉 AI 工作流。









