Florence-2: أحدث نموذج للرؤية واللغة من Microsoft
تعرّف على Florence-2، نموذج Microsoft للرؤية واللغة، والمخصص لاكتشاف الأجسام وتقسيمها وكتابة أوصافها وتحديد مواضعها، مع أداء قوي دون تدريب مسبق.
 Abirami Vina7 دقيقة قراءة
في يونيو 2024، قدمت Microsoft Florence-2، وهو نموذج متعدد الوسائط للرؤية واللغة (VLM) مصمم للتعامل مع مجموعة واسعة من المهام، بما فيها اكتشاف الأجسام والتجزئة وكتابة أوصاف الصور والتأريض. ويضع Florence-2 معيارًا جديدًا لأداء التعلم الصفري، أي إنه يستطيع تنفيذ المهام من دون تدريب مسبق مخصص، كما أن حجمه أصغر من أحجام نماذج الرؤية واللغة الأخرى المتطورة.
Florence-2 أكثر من مجرد نموذج آخر. إذ تتمتع مرونته وأداؤه المحسّن بإمكانات تؤهله لإحداث تأثير كبير في قطاعات مختلفة، عبر تحسين الدقة وتقليل الحاجة إلى التدريب المكثف. في هذه المقالة، سنستكشف الميزات الأساسية لـ Florence-2، ونقارن أداءه بأداء نماذج VLM الأخرى، ونناقش تطبيقاته المحتملة.
ما هو Florence-2؟#
يستطيع Florence-2 التعامل مع مجموعة متنوعة من المهام ضمن إطار عمل موحّد واحد. وتُعزى بعض إمكانات النموذج إلى مجموعة بيانات التدريب الكبيرة المسماة FLD-5B، التي تضم 5.4 مليارات تعليق توضيحي عبر 126 مليون صورة. أُنشئت هذه المجموعة الشاملة خصيصًا لتزويد Florence-2 بالإمكانات اللازمة للتعامل مع نطاق واسع من مهام الرؤية بدقة وكفاءة عاليتين.
فيما يلي نظرة أقرب على المهام التي يدعمها Florence-2:
- اكتشاف الأجسام: يستطيع تحديد الأجسام في الصور وتعيين مواقعها بدقة عالية.
- التجزئة: تتضمن هذه المهمة تقسيم الصورة إلى أجزاء ذات دلالة لتسهيل تحليلها وتفسيرها.
- وصف الصور: يستطيع Florence-2 إنشاء أوصاف تفصيلية للصور توفر سياقاً وتفاصيل عنها.
- الإرساء البصري: يستطيع النموذج ربط عبارات أو كلمات محددة في الوصف بالمناطق المقابلة لها في الصورة.
- أداء التعلّم الصفري: يستطيع تنفيذ المهام دون تدريب محدد.
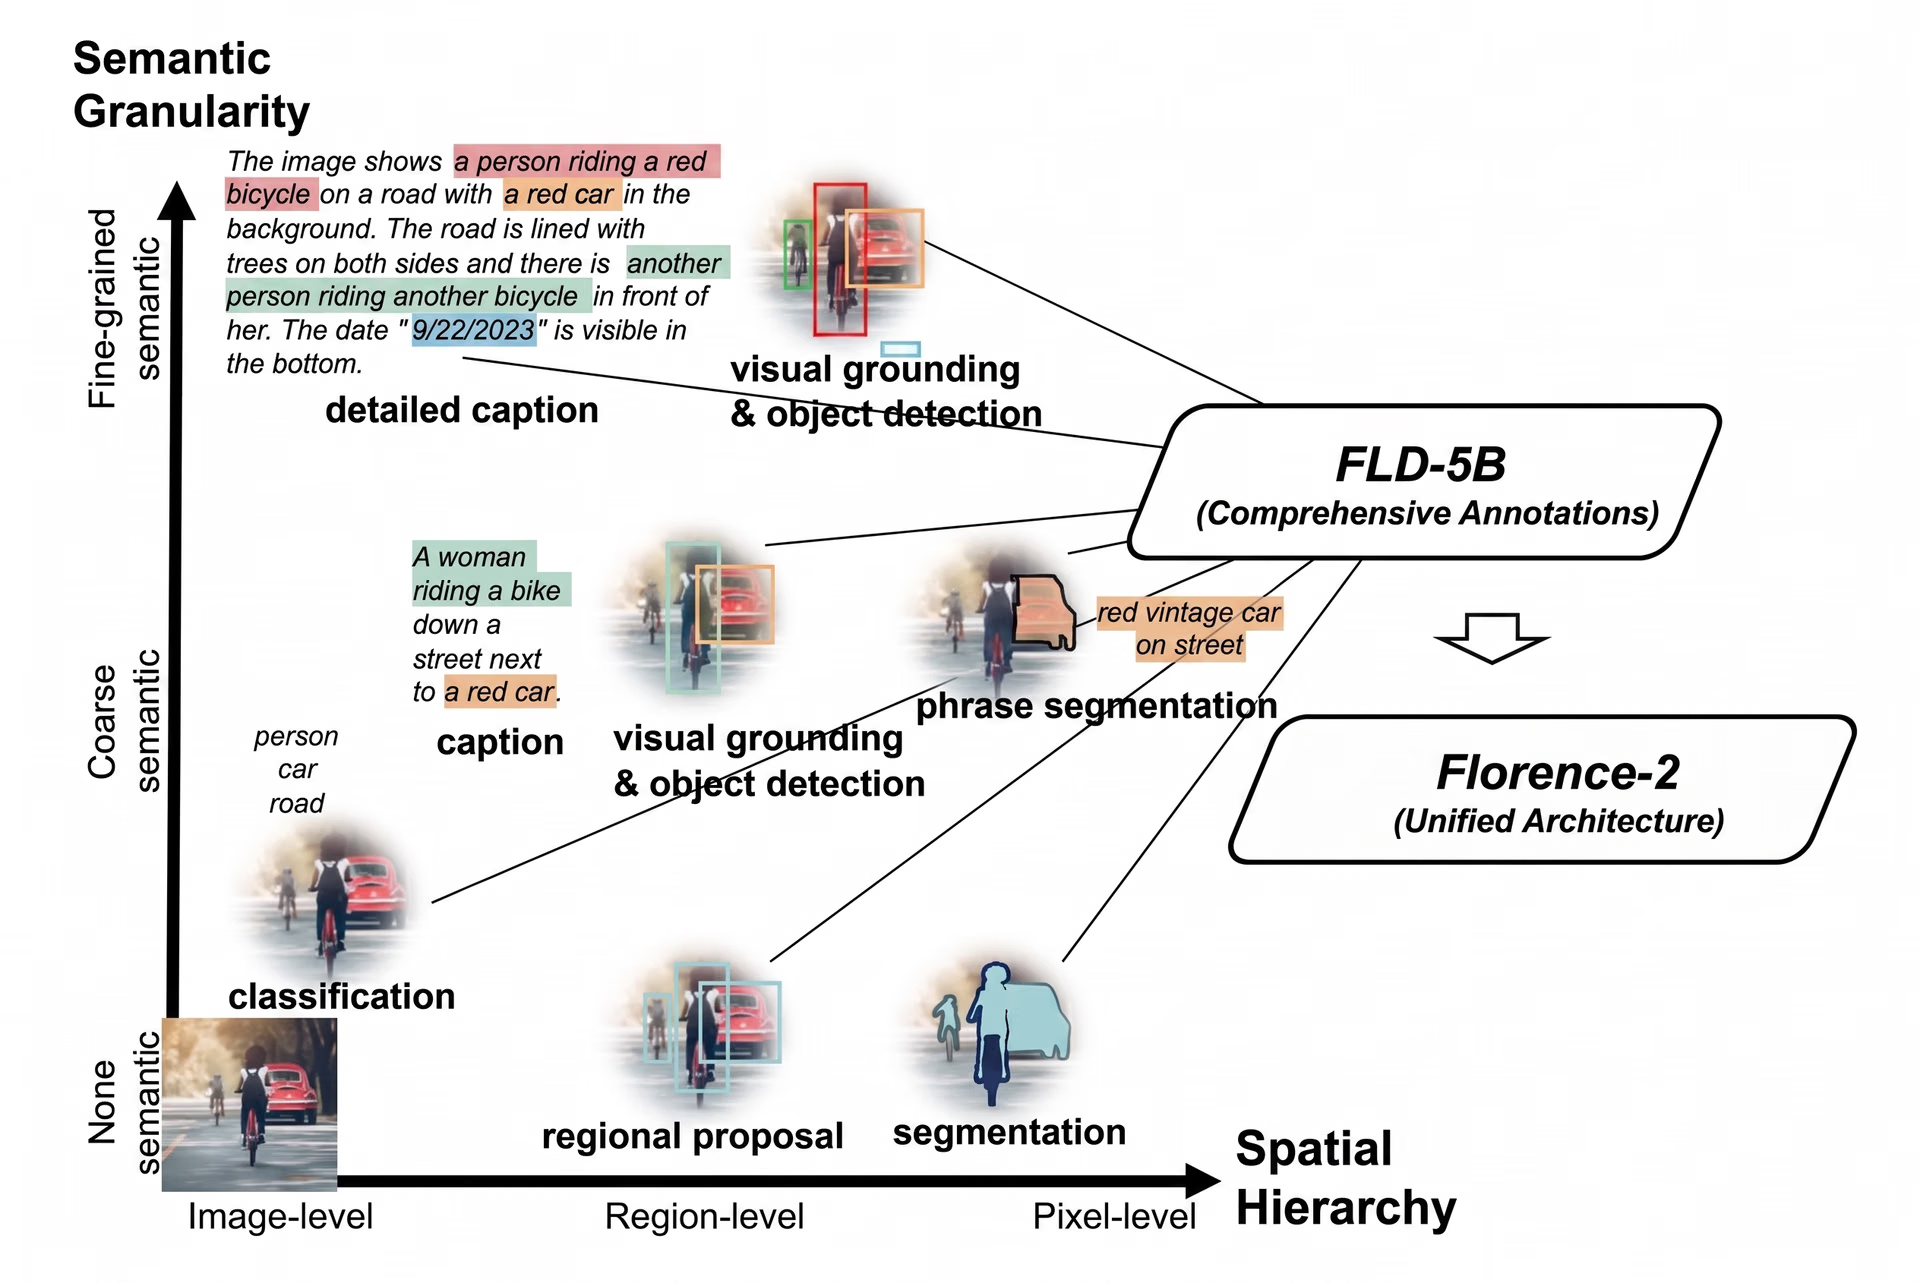
الشكل 1. فهم كيفية تدريب Florence-2.
يدعم النموذج المهام القائمة على النصوص والمهام القائمة على المناطق. وتُضاف رموز مواقع خاصة إلى مفردات النموذج للمهام التي تتضمن مناطق محددة من الصورة. وتساعد هذه الرموز النموذج على فهم أشكال مختلفة، مثل المستطيلات حول الأجسام (تمثيل الصندوق)، والأشكال رباعية الأضلاع (تمثيل الصندوق الرباعي)، والأشكال متعددة الأضلاع (تمثيل المضلع). ويُدرّب النموذج باستخدام دالة خسارة الانتروبيا المتقاطعة القياسية، التي تساعده على التعلم عبر مقارنة تنبؤاته بالإجابات الصحيحة وضبط معلماته الداخلية وفقًا لذلك.
إنشاء مجموعة بيانات FLD-5B#
تتضمن مجموعة بيانات FLD-5B أنواعًا مختلفة من التعليقات التوضيحية: أوصافًا نصية، وأزواجًا من المناطق والنصوص، ومزيجًا من النصوص والعبارات والمناطق. وأُنشئت عبر عملية من خطوتين تشمل جمع البيانات والتعليق عليها. واستُمدت الصور من مجموعات بيانات شائعة مثل ImageNet-22k وObjects365 وOpen Images وConceptual Captions وLAION. ومعظم التعليقات التوضيحية في مجموعة بيانات FLD-5B اصطناعي، أي إنها أُنشئت آليًا بدلًا من وسمها يدويًا.
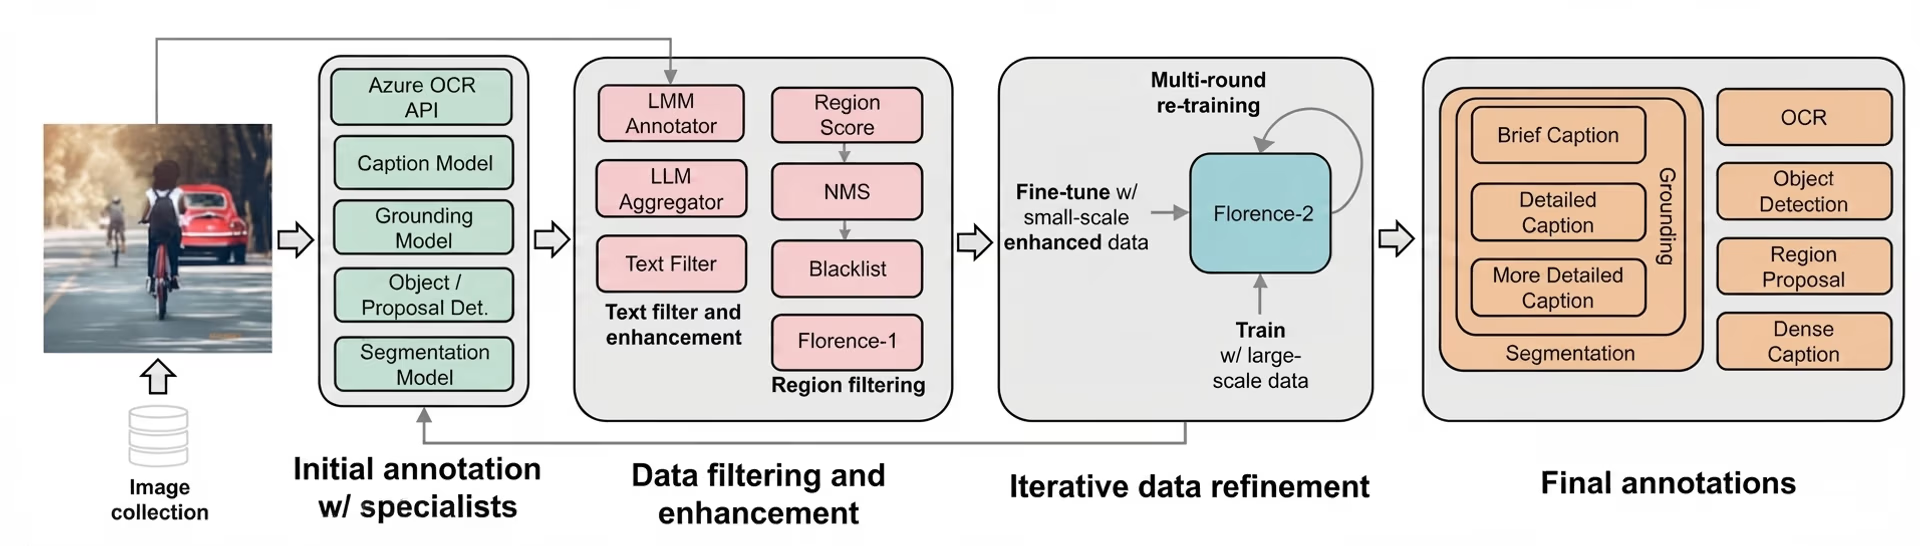
الشكل 2. إنشاء مجموعة بيانات FLD-5B.
في البداية، أنشأت نماذج متخصصة متمكنة في مهام محددة، مثل اكتشاف الأجسام أو التجزئة، هذه التعليقات التوضيحية. ثم استُخدمت عملية ترشيح وتحسين لضمان دقة التعليقات التوضيحية وتفصيلها. وبعد إزالة أي تشويش، خضعت مجموعة البيانات لتنقيح تكراري، استُخدمت فيه مخرجات Florence-2 لتحديث التعليقات التوضيحية وتحسينها باستمرار.
فهم بنية نموذج Florence-2#
تعتمد بنية نموذج Florence-2 على نهج التعلم من تسلسل إلى تسلسل. وهذا يعني أن النموذج يعالج تسلسلاً مُدخلاً (مثل صورة مع مطالبة نصية) وينشئ تسلسلاً مُخرجاً (مثل وصف أو تسمية) خطوةً بخطوة. في إطار العمل القائم على التسلسل إلى التسلسل، تُعامل كل مهمة بوصفها مسألة ترجمة: إذ يتلقى النموذج صورة مُدخلة ومطالبة خاصة بالمهمة، ثم ينشئ المخرج المقابل.
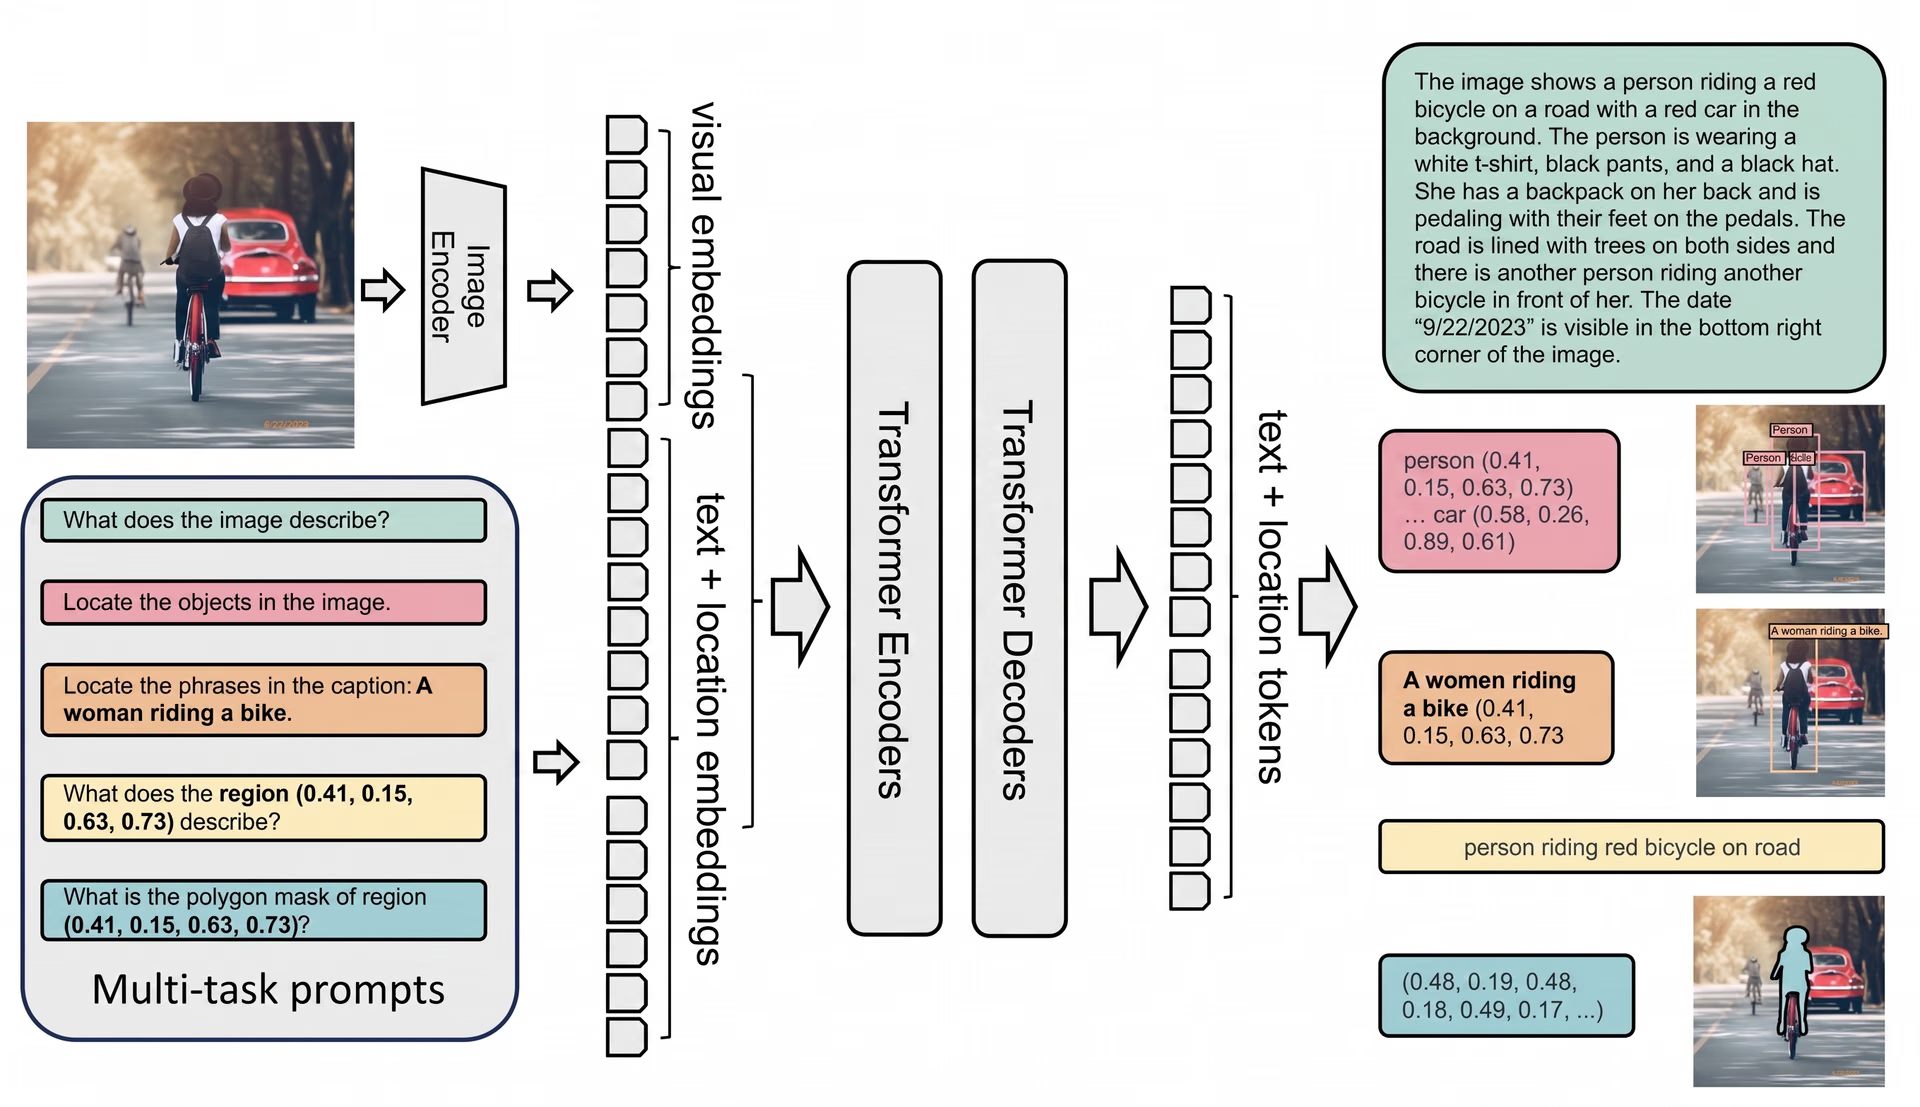
الشكل 3. بنية نموذج Florence-2 للرؤية واللغة.
في صميم بنية النموذج يوجد محوّل متعدد الوسائط من نوع المُرمِّز-مُفكِّك الترميز، يجمع بين مُرمِّز للصور ومُرمِّز-مُفكِّك ترميز متعدد الوسائط. ويعالج مُرمِّز الصور، المسمى DaViT (محوّل الرؤية بالانتباه المزدوج)، الصور المدخلة بتحويلها إلى تضمينات رموز مرئية؛ وهي تمثيلات موجزة للصورة تلتقط المعلومات المكانية (مواضع الأشياء) والدلالية (ماهية الأشياء). ثم تُدمج هذه الرموز المرئية مع تضمينات النص (تمثيلات النص)، ما يسمح للنموذج بدمج البيانات النصية والمرئية.
مقارنة Florence-2 بنماذج VLMs الأخرى#
يتميز Florence-2 عن نماذج الرؤية واللغة الأخرى بقدراته القوية في التعلم الصفري. وعلى خلاف نماذج مثل PaliGemma، التي تعتمد على الضبط الدقيق المكثف للتكيف مع مهام مختلفة، يعمل Florence-2 بكفاءة فور استخدامه. كما يستطيع Florence-2 منافسة نماذج أكبر مثل GPT-4V وFlamingo، التي غالبًا ما تضم عددًا أكبر بكثير من المعلمات، لكنها لا تضاهي أداء Florence-2 دائمًا. فعلى سبيل المثال، يحقق Florence-2 نتائج أفضل في التعلم الصفري من Kosmos-2، رغم أن عدد معلمات Kosmos-2 يزيد على ضعف عدد معلمات Florence-2.
أظهر Florence-2 أداءً قويًا في اختبارات المعايير لمهام مثل كتابة أوصاف COCO وفهم التعبيرات الإحالية. وتفوق على نماذج مثل PolyFormer وUNINEXT في مهام اكتشاف الأجسام وتجزئتها على مجموعة بيانات COCO. وهو خيار تنافسي للغاية للتطبيقات الواقعية التي تتطلب أداءً وكفاءة في استهلاك الموارد معًا. ويمكنك إجراء التعليق التوضيحي التلقائي لمجموعات بيانات الاكتشاف باستخدام Florence-2 على Ultralytics Platform، ومقارنة أدائه بأداء نماذج الرؤية واللغة الأخرى في لوحة ترتيب نماذج VLM.
تطبيقات Florence-2#
يمكن استخدام Florence-2 في قطاعات متنوعة، مثل الترفيه وإمكانية الوصول والتعليم وغيرها. لنستعرض بعض الأمثلة لفهم ذلك على نحو أفضل.
تطبيقات وصف الصور#
عندما تستخدم منصة بث وتحاول اختيار ما تشاهده، قد تقرأ ملخصاً لفيلم لمساعدتك على الاختيار. ماذا لو أمكن للمنصة أيضاً تقديم وصف تفصيلي لملصق الفيلم؟ يستطيع Florence-2 تحقيق ذلك من خلال وصف الصور، الذي ينشئ نصوصاً وصفية للصور. ويمكن لـ Florence-2 إنشاء أوصاف مفصلة لملصقات الأفلام، ما يجعل منصات البث أكثر شمولاً للمستخدمين ذوي الإعاقة البصرية. ومن خلال تحليل العناصر المرئية في الملصق، مثل الشخصيات والمناظر الطبيعية والنصوص، يستطيع Florence-2 إنشاء أوصاف مفصلة تنقل محتوى الملصق وأجواءه. توضح الصورة أدناه مستوى التفاصيل الذي يستطيع Florence-2 تقديمه في وصفه.
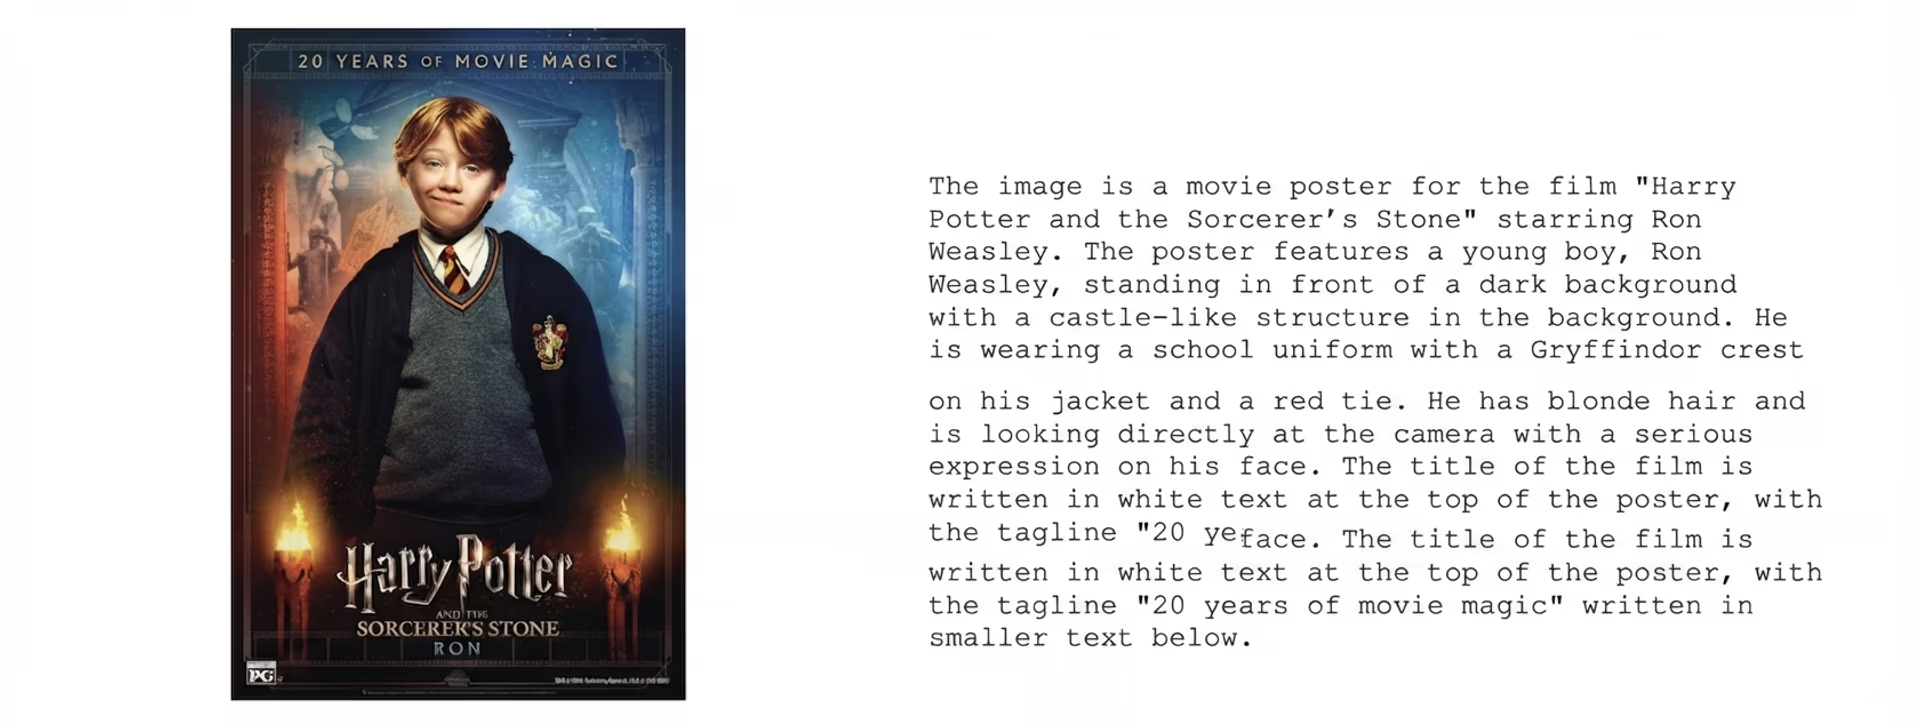
الشكل 4. مثال على وصف صورة أنشأه Florence-2.
فيما يلي أمثلة أخرى على الحالات التي يكون فيها وصف الصور مفيداً:
- التجارة الإلكترونية: يمكن أن توفر كتابة أوصاف الصور أوصافًا مفصلة لصور المنتجات، ما يساعد العملاء على فهم خصائص المنتجات وتفاصيلها بوضوح أكبر.
- السفر والسياحة: يمكنه تقديم أوصاف تفصيلية للمعالم ومناطق الجذب السياحي في أدلة السفر والتطبيقات.
- التعليم: يمكن لوصف الصور تسمية الصور والرسوم التوضيحية التعليمية ووصفها، بما يدعم التعليم والتعلم.
- العقارات: يمكنه تقديم أوصاف تفصيلية لصور العقارات، تسلط الضوء على ميزاتها ومرافقها للمشترين المحتملين.
استخدام الإرساء البصري أثناء الطهي#
يمكن استخدام Florence-2 أيضاً لإثراء تجارب الطهي. فعلى سبيل المثال، يمكن لكتاب طبخ عبر الإنترنت استخدام Florence-2 لإرساء أجزاء من صورة وصفة معقدة بصرياً وتسميتها. ويساعد الإرساء البصري هنا على ربط أجزاء محددة من الصورة بالنصوص الوصفية المقابلة لها. ويمكن تسمية كل مكوّن وخطوة بدقة وشرحها، ما يسهل على الطهاة المنزليين اتباع الوصفة وفهم دور كل عنصر في الطبق.
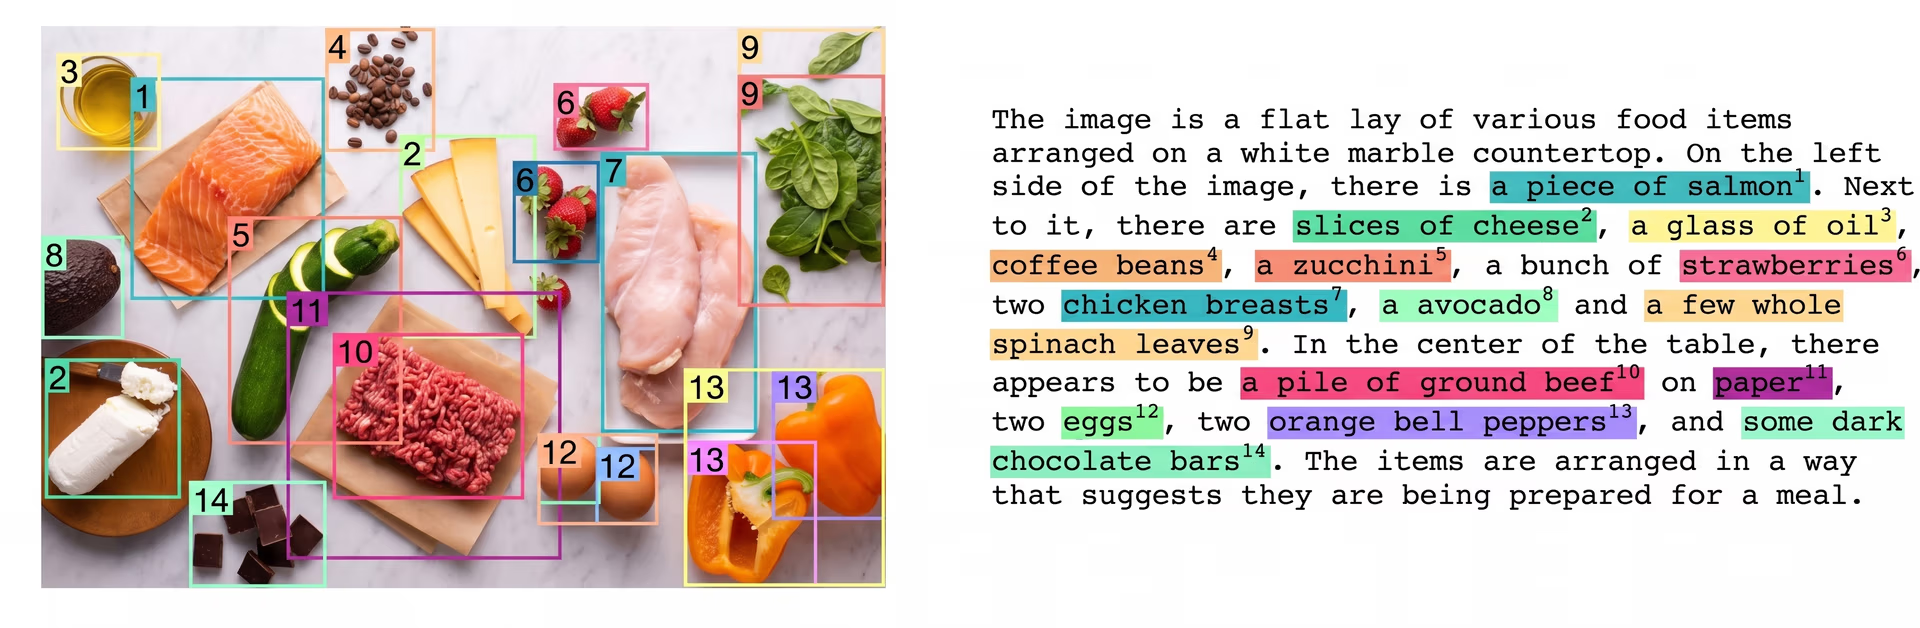
الشكل 5. مثال على الإرساء البصري باستخدام Florence-2.
التعرّف الضوئي على الحروف القائم على المناطق للمستندات المالية#
قد يكون التعرّف الضوئي على الحروف (OCR) باستخدام المعالجة القائمة على المناطق، التي تركز على استخراج النص من مواضع محددة داخل المستند، مفيداً في مجالات مثل المحاسبة. إذ يمكن تحليل مناطق محددة من المستندات المالية لاستخراج معلومات مهمة تلقائياً، مثل تفاصيل المعاملات وأرقام الحسابات وتواريخ الاستحقاق. ومن خلال تقليل الحاجة إلى إدخال البيانات يدوياً، يقلل ذلك الأخطاء ويسرّع أوقات المعالجة. ويمكن للمؤسسات المالية استخدامه لتبسيط مهام مثل معالجة الفواتير ومطابقة الإيصالات وتسوية الشيكات، ما يؤدي إلى معاملات أسرع وخدمة عملاء أفضل.
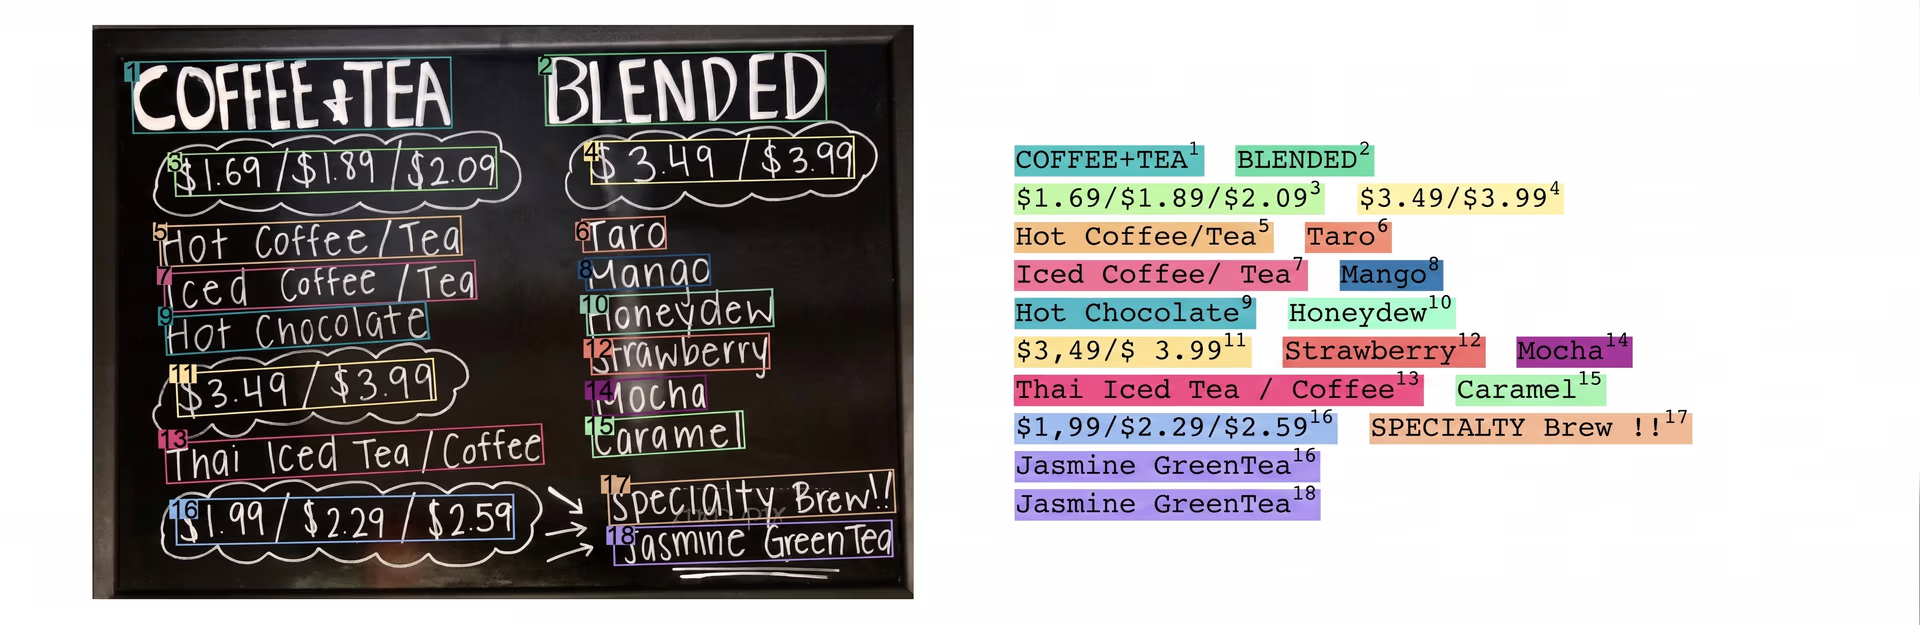
الشكل 6. مثال على استخراج النص بالتعرّف الضوئي على الحروف في منطقة باستخدام Florence-2.
التجزئة القائمة على المناطق في التطبيقات الصناعية#
يمكن للتجزئة القائمة على المناطق، التي تتضمن تقسيم الصورة إلى أجزاء ذات دلالة لإجراء تحليل مركّز وفحص تفصيلي، أن تدعم التطبيقات الصناعية التي تحسن الدقة والكفاءة في عمليات مختلفة. ومن خلال التركيز على مناطق محددة داخل الصورة، تتيح هذه التقنية فحص المكونات والمنتجات وتحليلها بالتفصيل. وفي مراقبة الجودة، يمكنها اكتشاف العيوب أو أوجه عدم الاتساق في المواد، مثل الشقوق أو حالات عدم المحاذاة، ما يضمن وصول المنتجات الأعلى جودةً فقط إلى السوق.
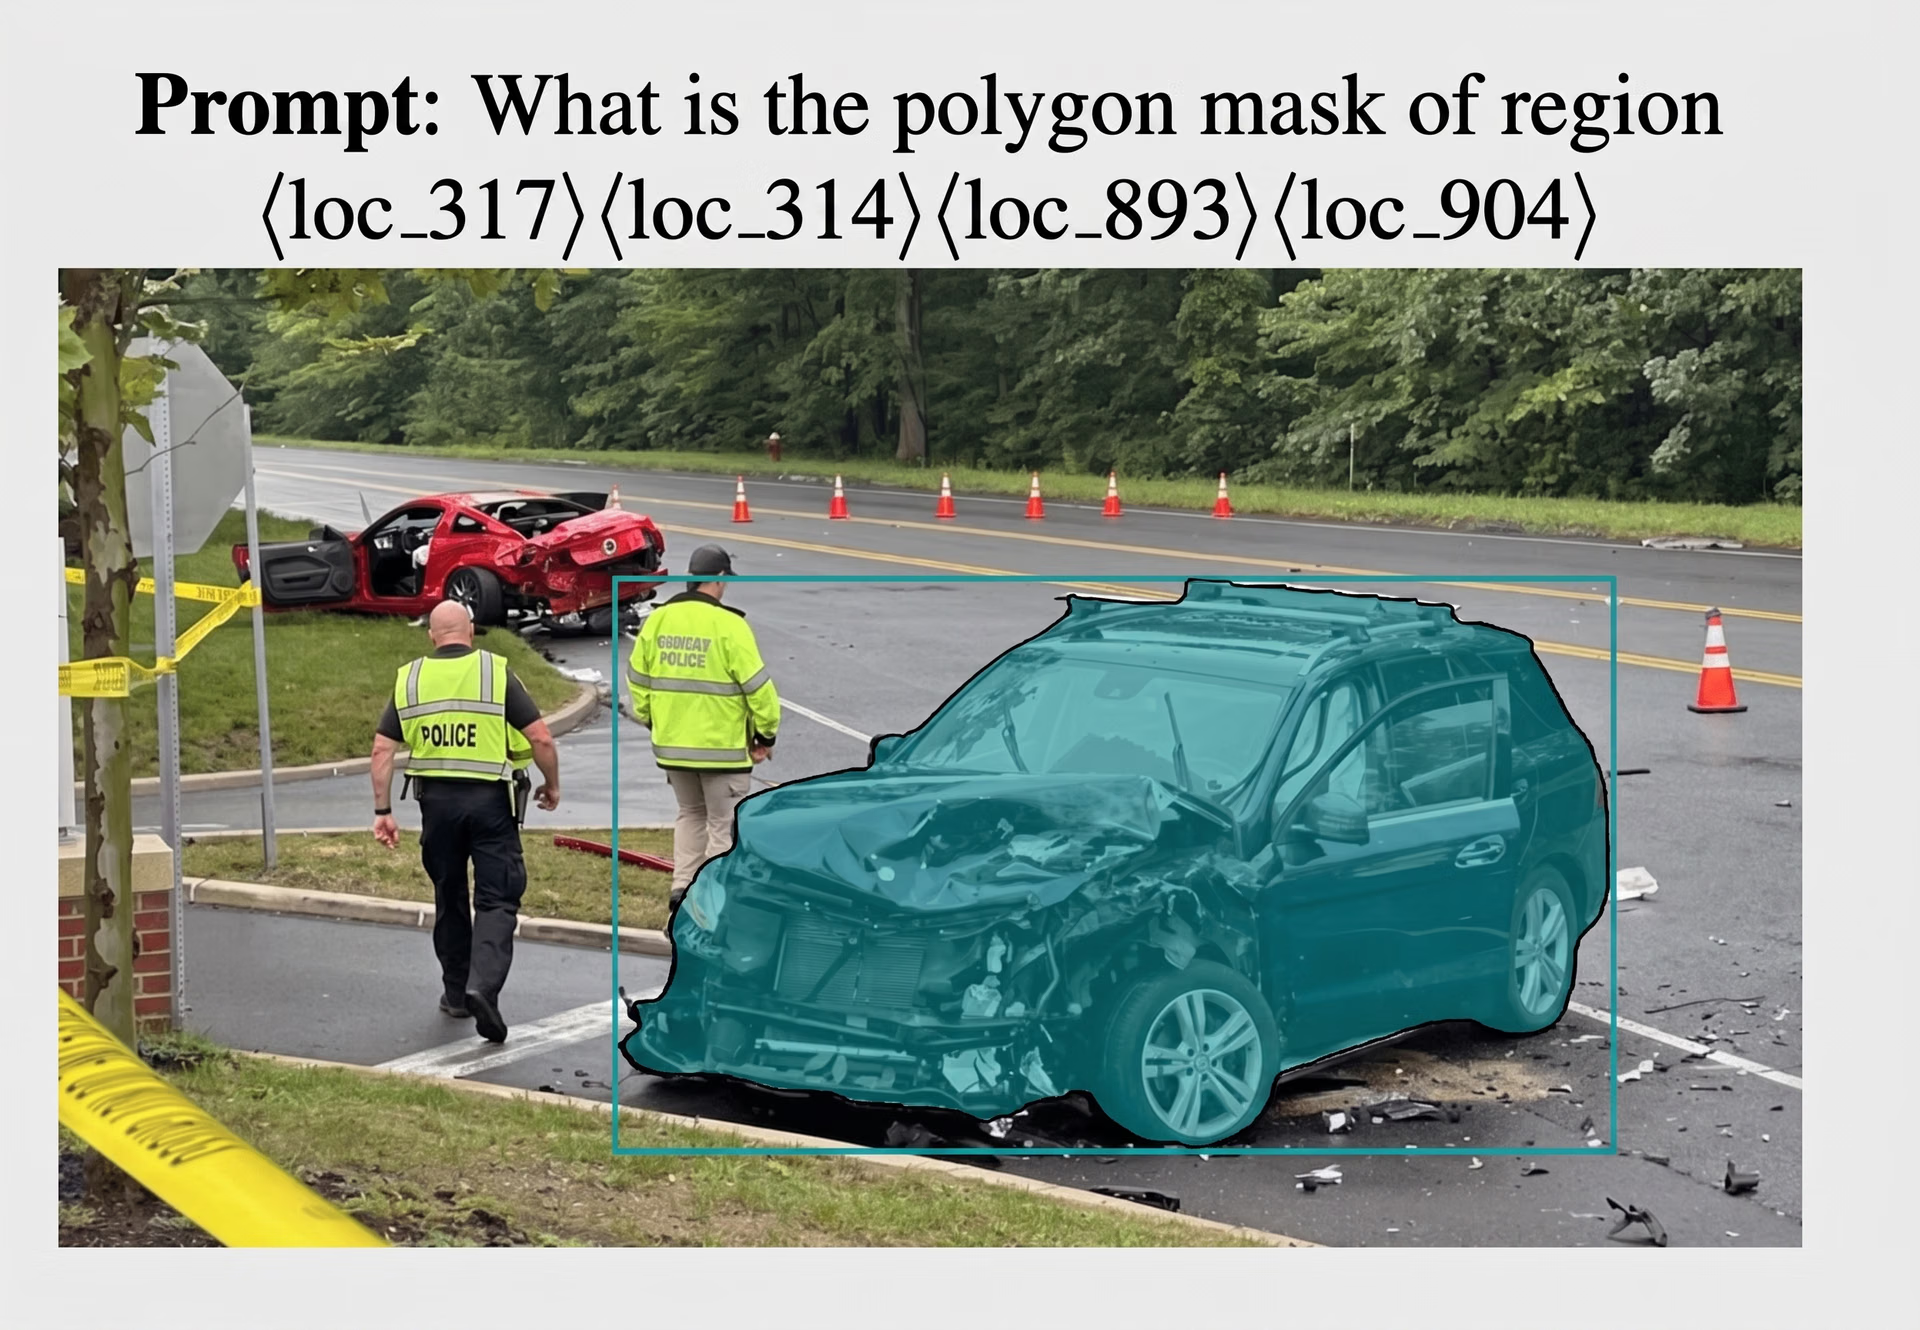
الشكل 7. مثال على التجزئة القائمة على المناطق باستخدام Florence-2.
كما تحسن هذه التقنية خطوط التجميع المؤتمتة من خلال توجيه الأذرع الروبوتية إلى أجزاء محددة وتحسين مواضع المكونات وتجميعها. وبالمثل، تساعد في إدارة المخزون على تتبّع حالة البضائع ومواقعها ومراقبتها، ما يؤدي إلى كفاءة أكبر في الخدمات اللوجستية وتقليل فترات التوقف. وبوجه عام، تعزز التجزئة القائمة على المناطق الدقة والإنتاجية، ما يؤدي إلى خفض التكاليف وتحسين جودة المنتجات في البيئات الصناعية.
أبرز النقاط#
بدأنا نرى توجهًا نحو جعل نماذج الذكاء الاصطناعي أخف وزنًا مع الحفاظ على أدائها العالي. ويمثل Florence-2 خطوة كبيرة إلى الأمام لنماذج الرؤية واللغة. إذ يستطيع التعامل مع مهام متنوعة، مثل اكتشاف الأجسام والتجزئة وكتابة أوصاف الصور والتأريض، مع أداء مذهل في التعلم الصفري. وعلى الرغم من حجمه الأصغر، يتسم Florence-2 بالكفاءة وتعدد الوظائف، ما يجعله مفيدًا لتطبيقات في قطاعات مختلفة. وتتيح نماذج مثل Florence-2 مزيدًا من الإمكانات، وتوسع آفاق ابتكارات الذكاء الاصطناعي.
تعرّف على المزيد عن الذكاء الاصطناعي بزيارة مستودع GitHub والانضمام إلى مجتمعنا. تفقّد صفحات حلولنا لقراءة المزيد عن تطبيقات الذكاء الاصطناعي في التصنيع والزراعة.
بقلم
منشئ محتوى · Ultralytics
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









