فهم نماذج الرؤية واللغة وتطبيقاتها
تعرّف على نماذج الرؤية واللغة، وكيفية عملها، وتطبيقاتها المتنوعة في الذكاء الاصطناعي. واكتشف كيف تجمع هذه النماذج بين قدرات الرؤية واللغة.
في مقال سابق، استكشفنا كيف يمكن لـGPT-4o فهم الصور ووصفها بالكلمات. ونرى هذه القدرة أيضًا في نماذج جديدة أخرى مثل Google Gemini وClaude 3. واليوم، نتعمق أكثر في هذا المفهوم لشرح آلية عمل نماذج الرؤية واللغة وكيفية جمعها بين البيانات المرئية والنصية.
يمكن استخدام هذه النماذج لتنفيذ مجموعة من المهام المذهلة، مثل إنشاء تعليقات توضيحية مفصلة للصور، والإجابة عن الأسئلة المتعلقة بها، بل وحتى إنشاء محتوى مرئي جديد استنادًا إلى أوصاف نصية. ومن خلال الدمج السلس للمعلومات المرئية واللغوية، تُغيّر نماذج الرؤية واللغة طريقة تفاعلنا مع التقنية وفهمنا للعالم من حولنا.
آلية عمل نماذج الرؤية واللغة#
قبل أن نستعرض مجالات استخدام نماذج الرؤية واللغة (VLMs)، لنتعرف إلى ماهيتها وآلية عملها. نماذج الرؤية واللغة هي نماذج متقدمة للذكاء الاصطناعي تجمع قدرات نماذج الرؤية واللغة لمعالجة الصور والنصوص معًا. وتستقبل هذه النماذج الصور إلى جانب أوصافها النصية، ثم تتعلم الربط بينهما. يلتقط مكوّن الرؤية تفاصيل الصور، بينما يفهم مكوّن اللغة النص. ويتيح هذا التكامل لنماذج الرؤية واللغة فهم الصور والنصوص وتحليلها معًا.
فيما يلي القدرات الأساسية لنماذج الرؤية واللغة:
- التعليق التوضيحي على الصور: إنشاء نص وصفي استنادًا إلى محتوى الصور.
- الإجابة عن الأسئلة المرئية (VQA): الإجابة عن الأسئلة المتعلقة بمحتوى صورة.
- تحويل النص إلى إنشاء الصور: إنشاء الصور استنادًا إلى أوصاف نصية.
- استرجاع الصور والنصوص: العثور على الصور ذات الصلة باستعلام نصي معين، والعكس صحيح.
- إنشاء محتوى متعدد الوسائط: دمج الصور والنصوص لإنشاء محتوى جديد.
- فهم المشاهد واكتشاف الكائنات: تحديد الكائنات والتفاصيل داخل الصورة وتصنيفها.
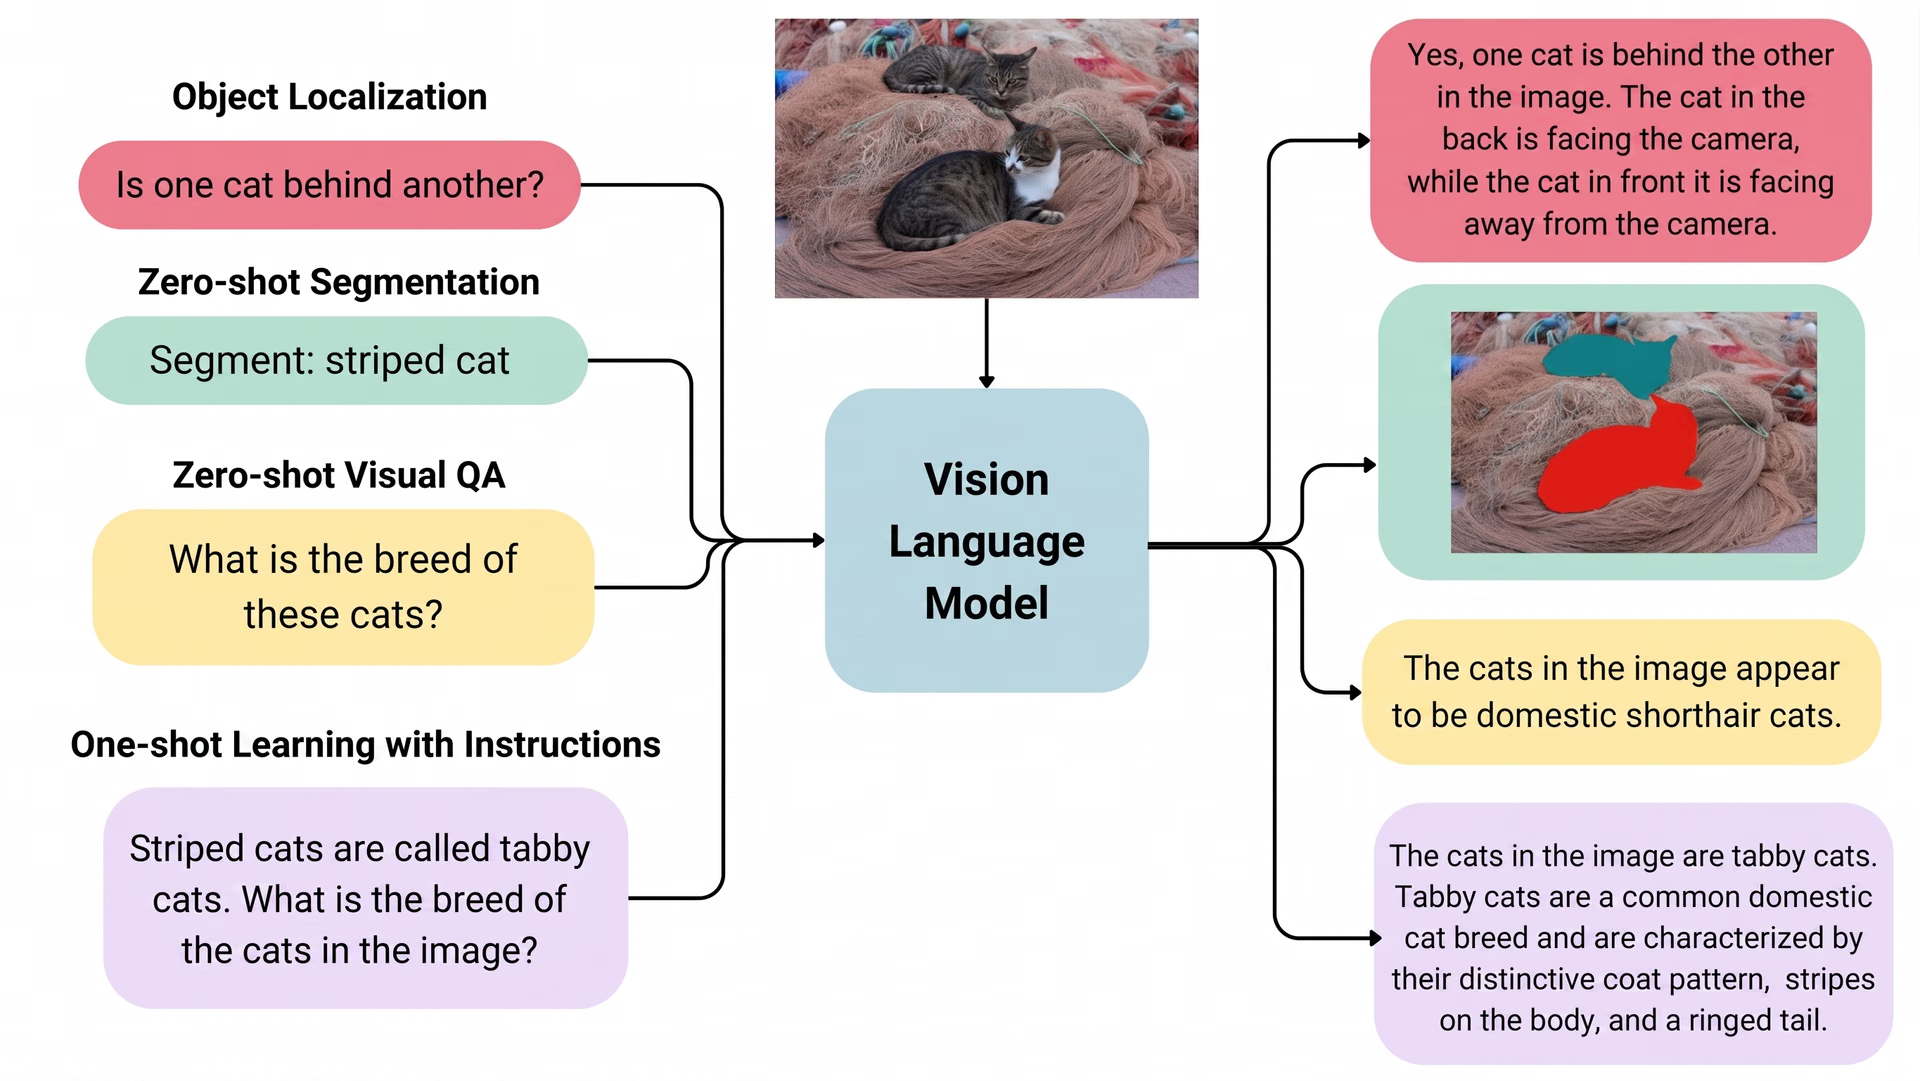
الشكل 1. مثال على قدرات نموذج للرؤية واللغة.
بعد ذلك، لنستكشف البنى الشائعة لنماذج الرؤية واللغة وتقنيات التعلّم المستخدمة في نماذج معروفة مثل CLIP وSimVLM وVisualGPT.
التعلّم التقابلي#
التعلّم التقابلي تقنية تساعد النماذج على التعلّم من خلال مقارنة الاختلافات بين نقاط البيانات. وتحسب مدى التشابه أو الاختلاف بين الحالات، وتسعى إلى تقليل الخسارة التقابلية التي تقيس هذه الاختلافات. وتفيد هذه التقنية بوجه خاص في التعلّم شبه الخاضع للإشراف، حيث ترشد مجموعة صغيرة من الأمثلة المصنفة النموذج إلى تصنيف بيانات جديدة لم يسبق له رؤيتها. فعلى سبيل المثال، لفهم شكل القطة، يقارنها النموذج بصور قطط مشابهة وصور كلاب. ومن خلال تحديد سمات مثل بنية الوجه وحجم الجسم والفراء، تستطيع تقنيات التعلّم التقابلي التمييز بين القطة والكلب.
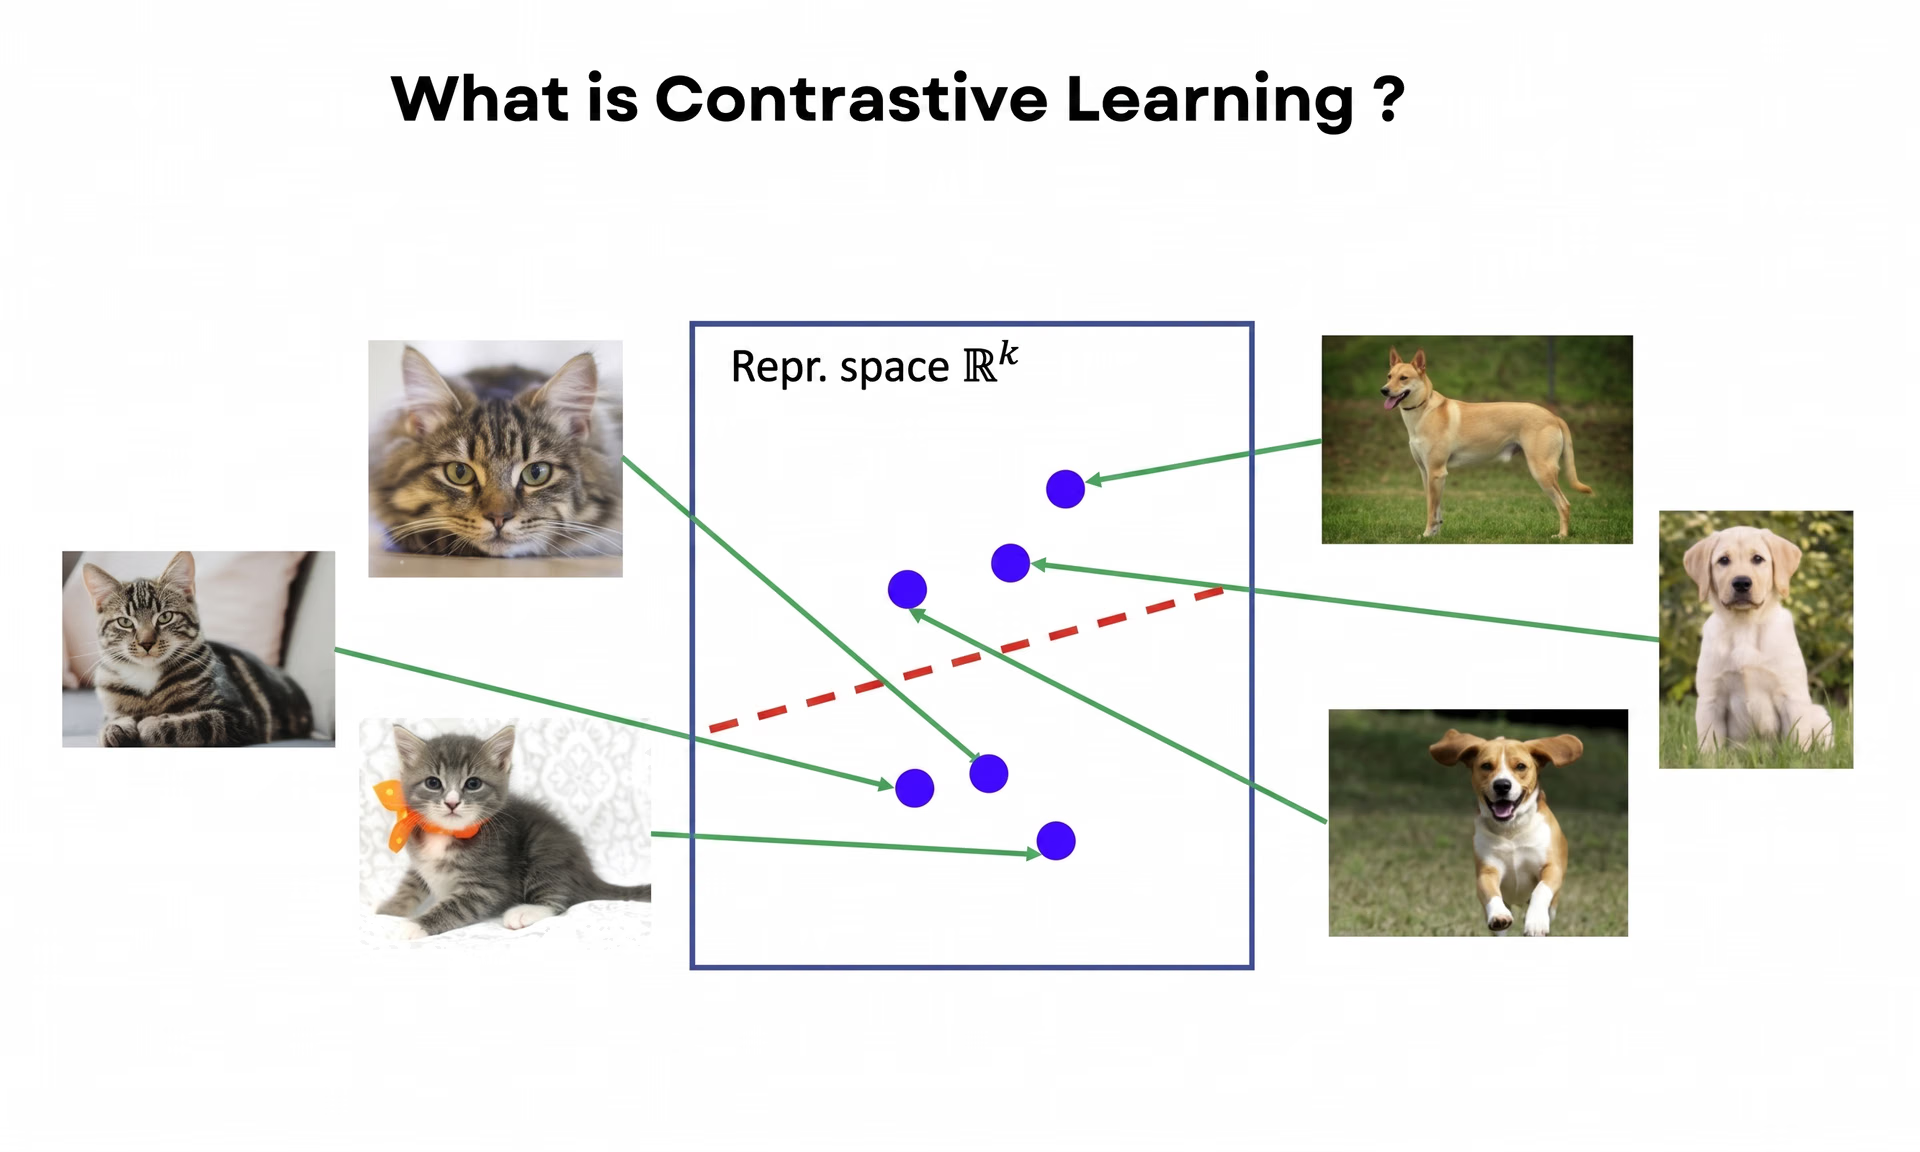
الشكل 2. آلية عمل التعلّم التقابلي.
CLIP نموذج للرؤية واللغة يستخدم التعلّم التقابلي لمطابقة الأوصاف النصية بالصور. ويعمل عبر ثلاث خطوات بسيطة. أولًا، يدرّب أجزاء النموذج التي تفهم النصوص والصور معًا. ثانيًا، يحوّل الفئات الموجودة في مجموعة البيانات إلى أوصاف نصية. ثالثًا، يحدد الوصف الأكثر تطابقًا مع صورة معينة. وبفضل هذه الطريقة، يستطيع نموذج CLIP تقديم تنبؤات دقيقة حتى في المهام التي لم يُدرّب عليها تحديدًا.
PrefixLM#
تقنية PrefixLM هي تقنية في معالجة اللغة الطبيعية (NLP) تُستخدم لتدريب النماذج. تبدأ بجزء من جملة (بادئة)، ثم تتعلم التنبؤ بالكلمة التالية. وفي نماذج الرؤية واللغة، تساعد PrefixLM النموذج على التنبؤ بالكلمات التالية استنادًا إلى صورة وجزء نصي معطى. وتستخدم التقنية محوّل الرؤية (ViT)، الذي يقسّم الصورة إلى رقع صغيرة تمثل كل منها جزءًا منها، ثم يعالج هذه الرقع بالتتابع.
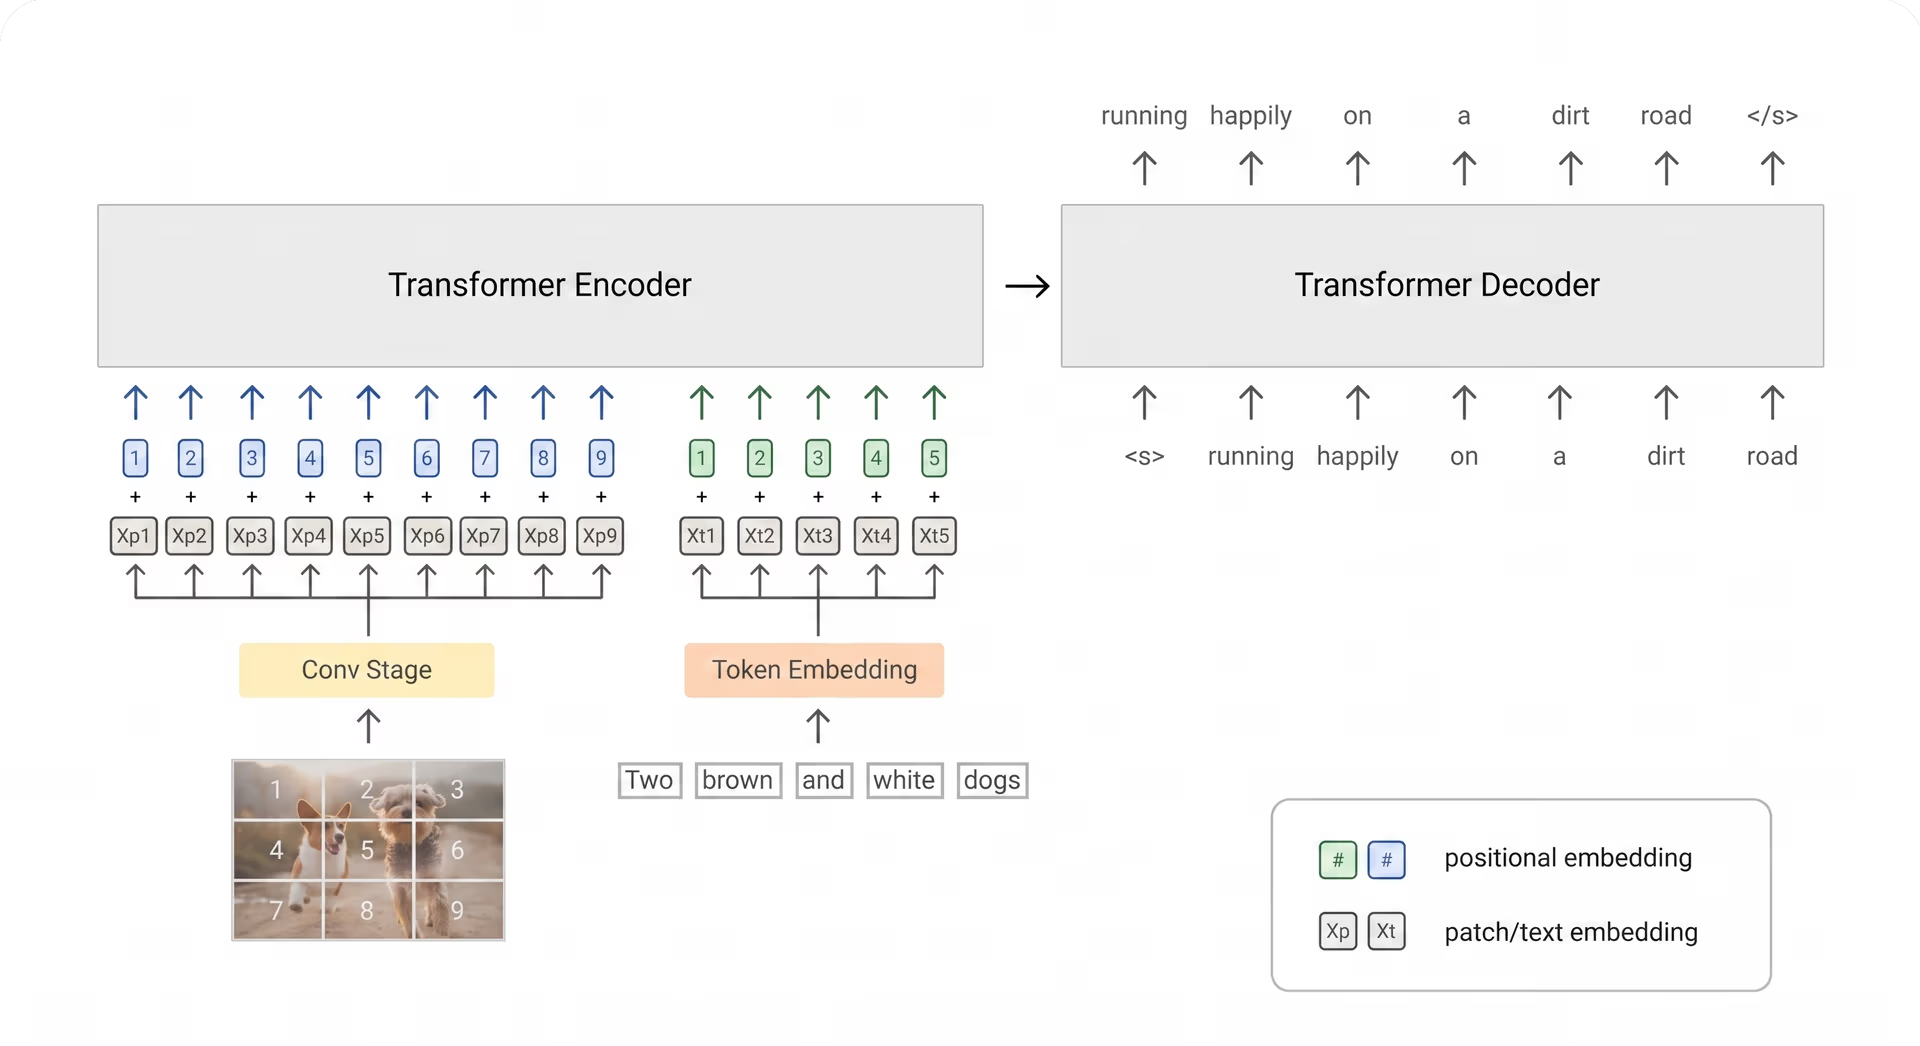
الشكل 3. مثال على تدريب نموذج للرؤية واللغة يستخدم تقنية PrefixLM.
SimVLM نموذج للرؤية واللغة يستخدم تقنية التعلّم PrefixLM. ويعتمد على بنية محوّل أبسط مقارنةً بالنماذج السابقة، لكنه يحقق نتائج أفضل في اختبارات متنوعة. وتتضمن بنية النموذج تعلّم ربط الصور بالبادئات النصية باستخدام مُرمّز محوّل، ثم إنشاء النص باستخدام مفكّك ترميز محوّل.
دمج متعدد الوسائط باستخدام الانتباه المتقاطع#
دمج الوسائط المتعددة باستخدام الانتباه المتقاطع تقنية تحسّن قدرة نموذج الرؤية واللغة المدرّب مسبقًا على فهم البيانات المرئية ومعالجتها. وتعمل بإضافة طبقات انتباه متقاطع إلى النموذج، ما يتيح له الانتباه إلى المعلومات المرئية والنصية في الوقت نفسه.
إليك آلية عملها:
- تُحدَّد الكائنات الأساسية في الصورة وتُبرَز.
- يعالج مُرمّز مرئي الكائنات المبرزة، ويحوّل المعلومات المرئية إلى صيغة يستطيع النموذج فهمها.
- تُنقل المعلومات المرئية إلى مفكّك ترميز يفسّر الصورة مستعينًا بمعرفة نموذج اللغة المدرّب مسبقًا.
يُعد VisualGPT مثالًا جيدًا على نموذج يستخدم هذه التقنية. ويتضمن ميزة خاصة تُسمى وحدة التنشيط ذاتية الإحياء (SRAU)، تساعد النموذج على تجنب مشكلة شائعة تُعرف بتلاشي التدرجات. فقد يؤدي تلاشي التدرجات إلى فقدان النماذج معلومات مهمة أثناء التدريب، لكن وحدة SRAU تحافظ على قوة أداء النموذج.
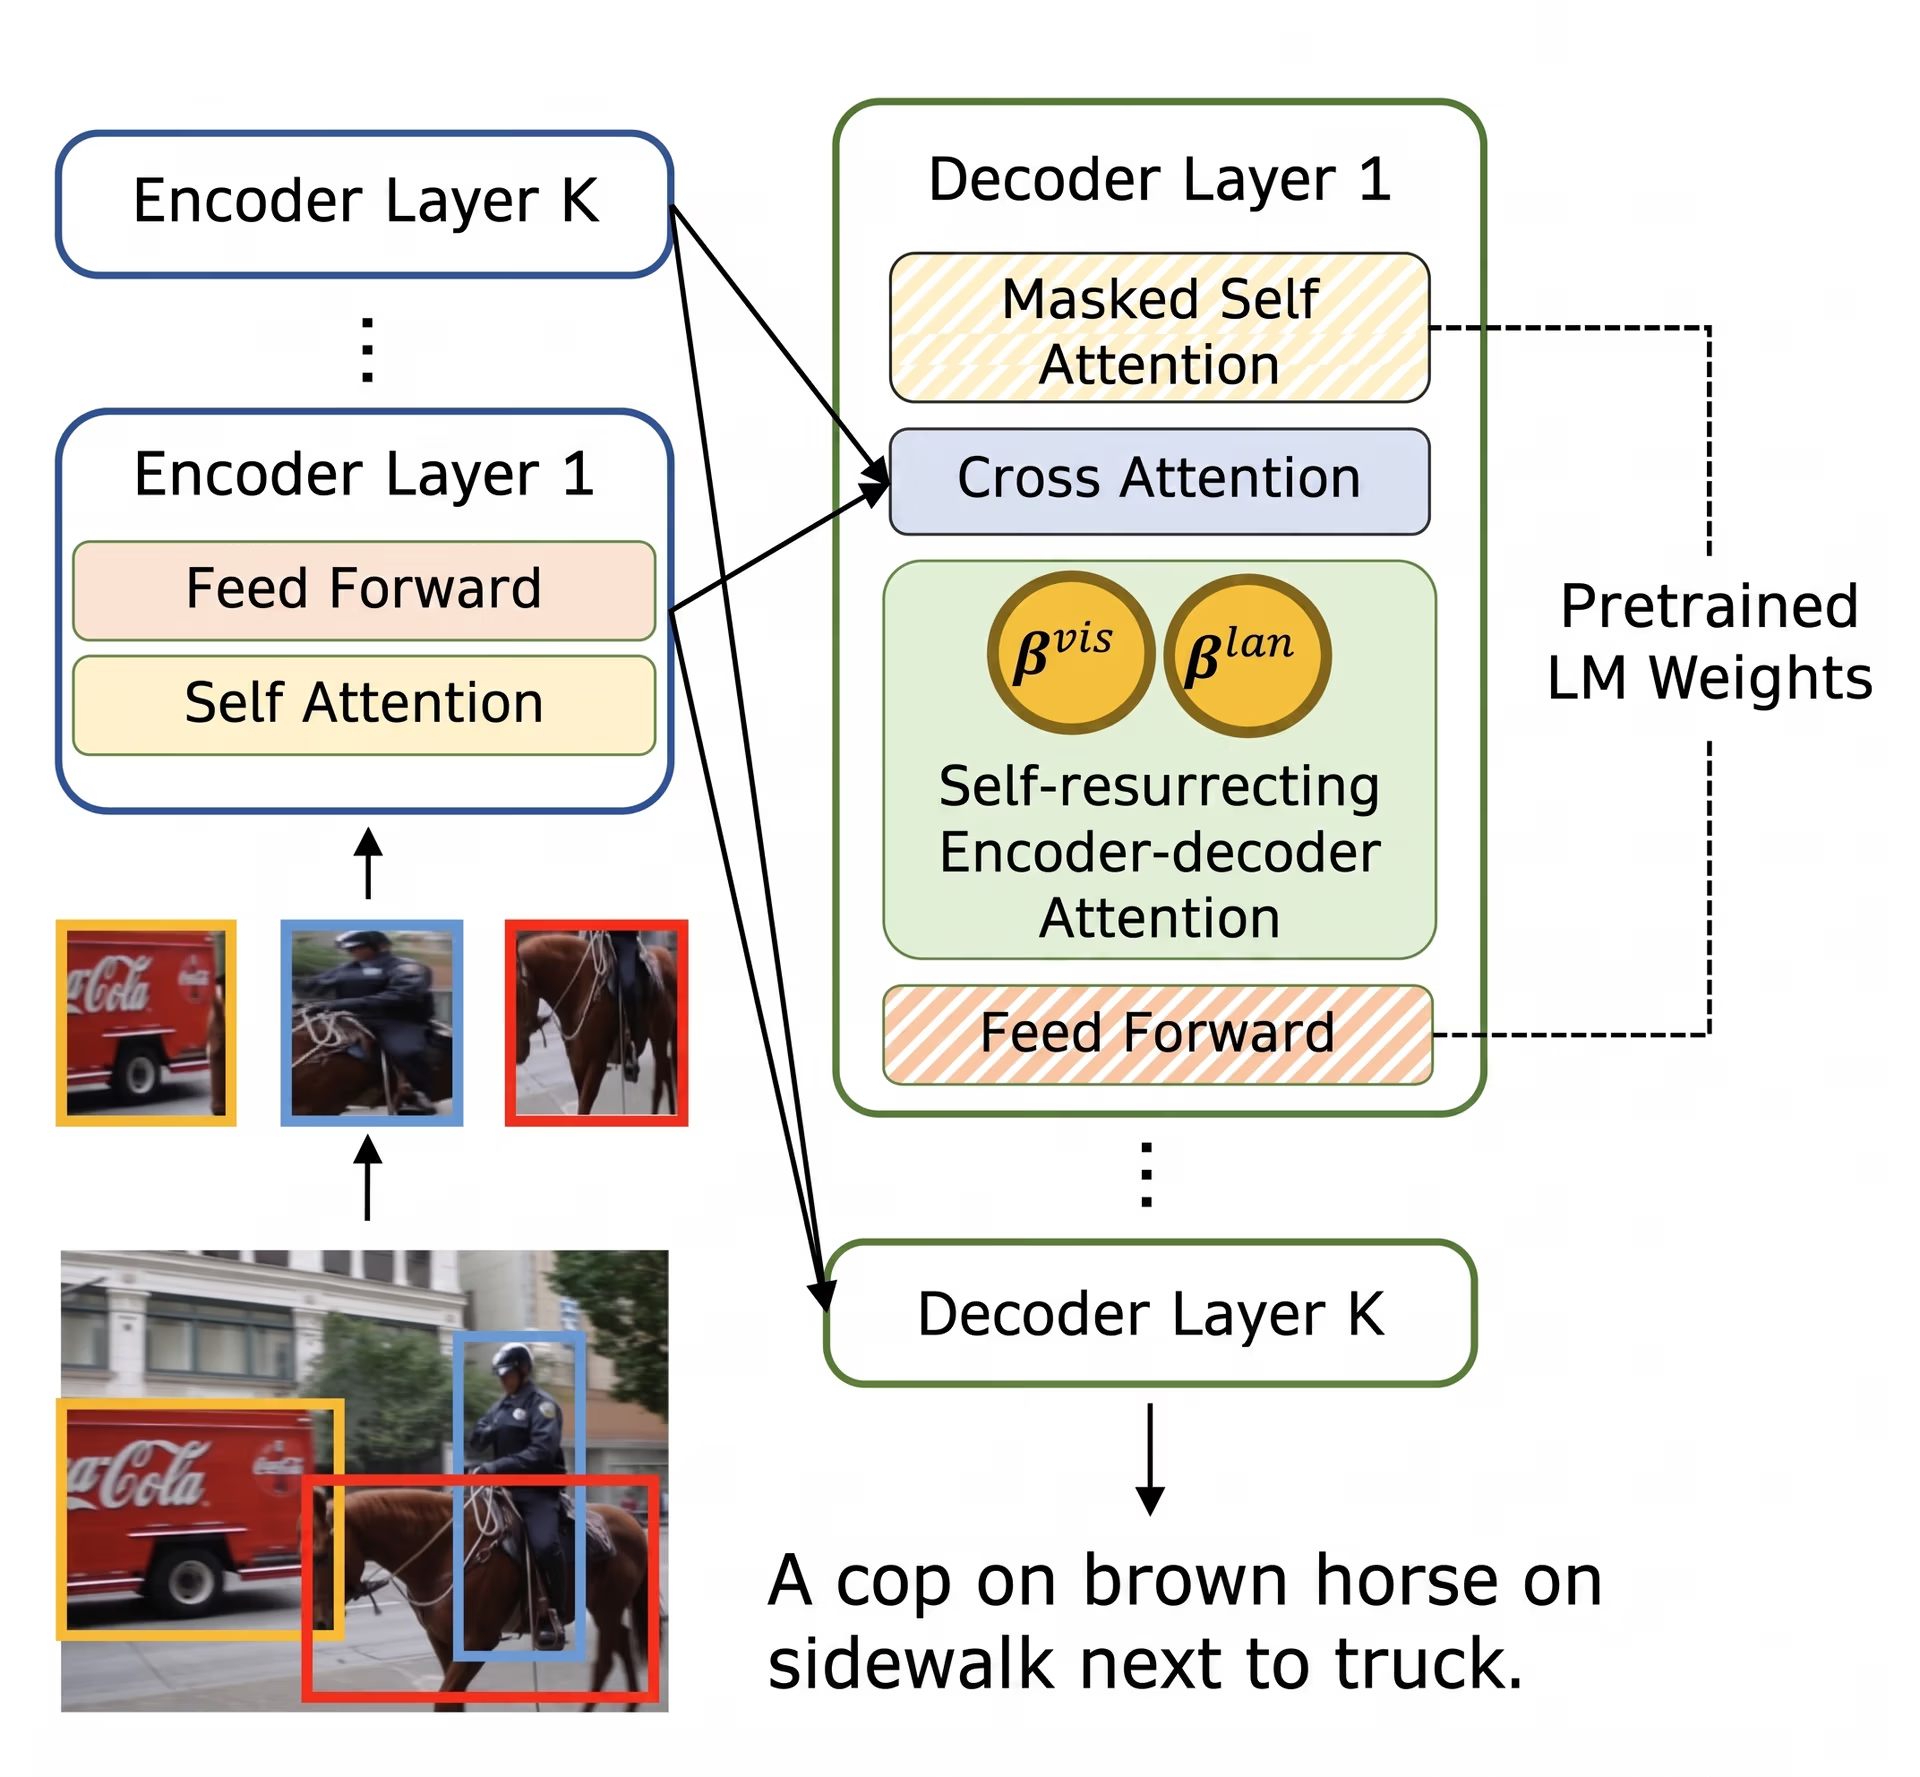
الشكل 4. بنية نموذج VisualGPT.
تطبيقات نماذج الرؤية واللغة#
تُحدث نماذج الرؤية واللغة أثرًا في مجموعة متنوعة من القطاعات. ومن تعزيز منصات التجارة الإلكترونية إلى جعل الإنترنت أكثر سهولة في الوصول، تثير استخدامات هذه النماذج المحتملة الحماسة. لنستكشف بعض هذه التطبيقات.
إنشاء أوصاف المنتجات#
عند التسوق عبر الإنترنت، ترى أوصافًا مفصلة لكل منتج، لكن إعداد هذه الأوصاف قد يستغرق وقتًا طويلًا. وتبسّط نماذج الرؤية واللغة هذه العملية بأتمتة إنشاء الأوصاف. ويمكن لـتجار التجزئة عبر الإنترنت إنشاء أوصاف مفصلة ودقيقة مباشرةً من صور المنتجات باستخدام نماذج الرؤية واللغة.
تساعد أوصاف المنتجات عالية الجودة محركات البحث على تحديد المنتجات استنادًا إلى سمات محددة مذكورة في الوصف. فعلى سبيل المثال، يساعد وصف يتضمن عبارتي «أكمام طويلة» و«ياقة قطنية» العملاء على العثور بسهولة أكبر على «قميص قطني بأكمام طويلة». كما يساعد العملاء على العثور سريعًا على ما يريدون، مما يزيد المبيعات ورضا العملاء بدوره.
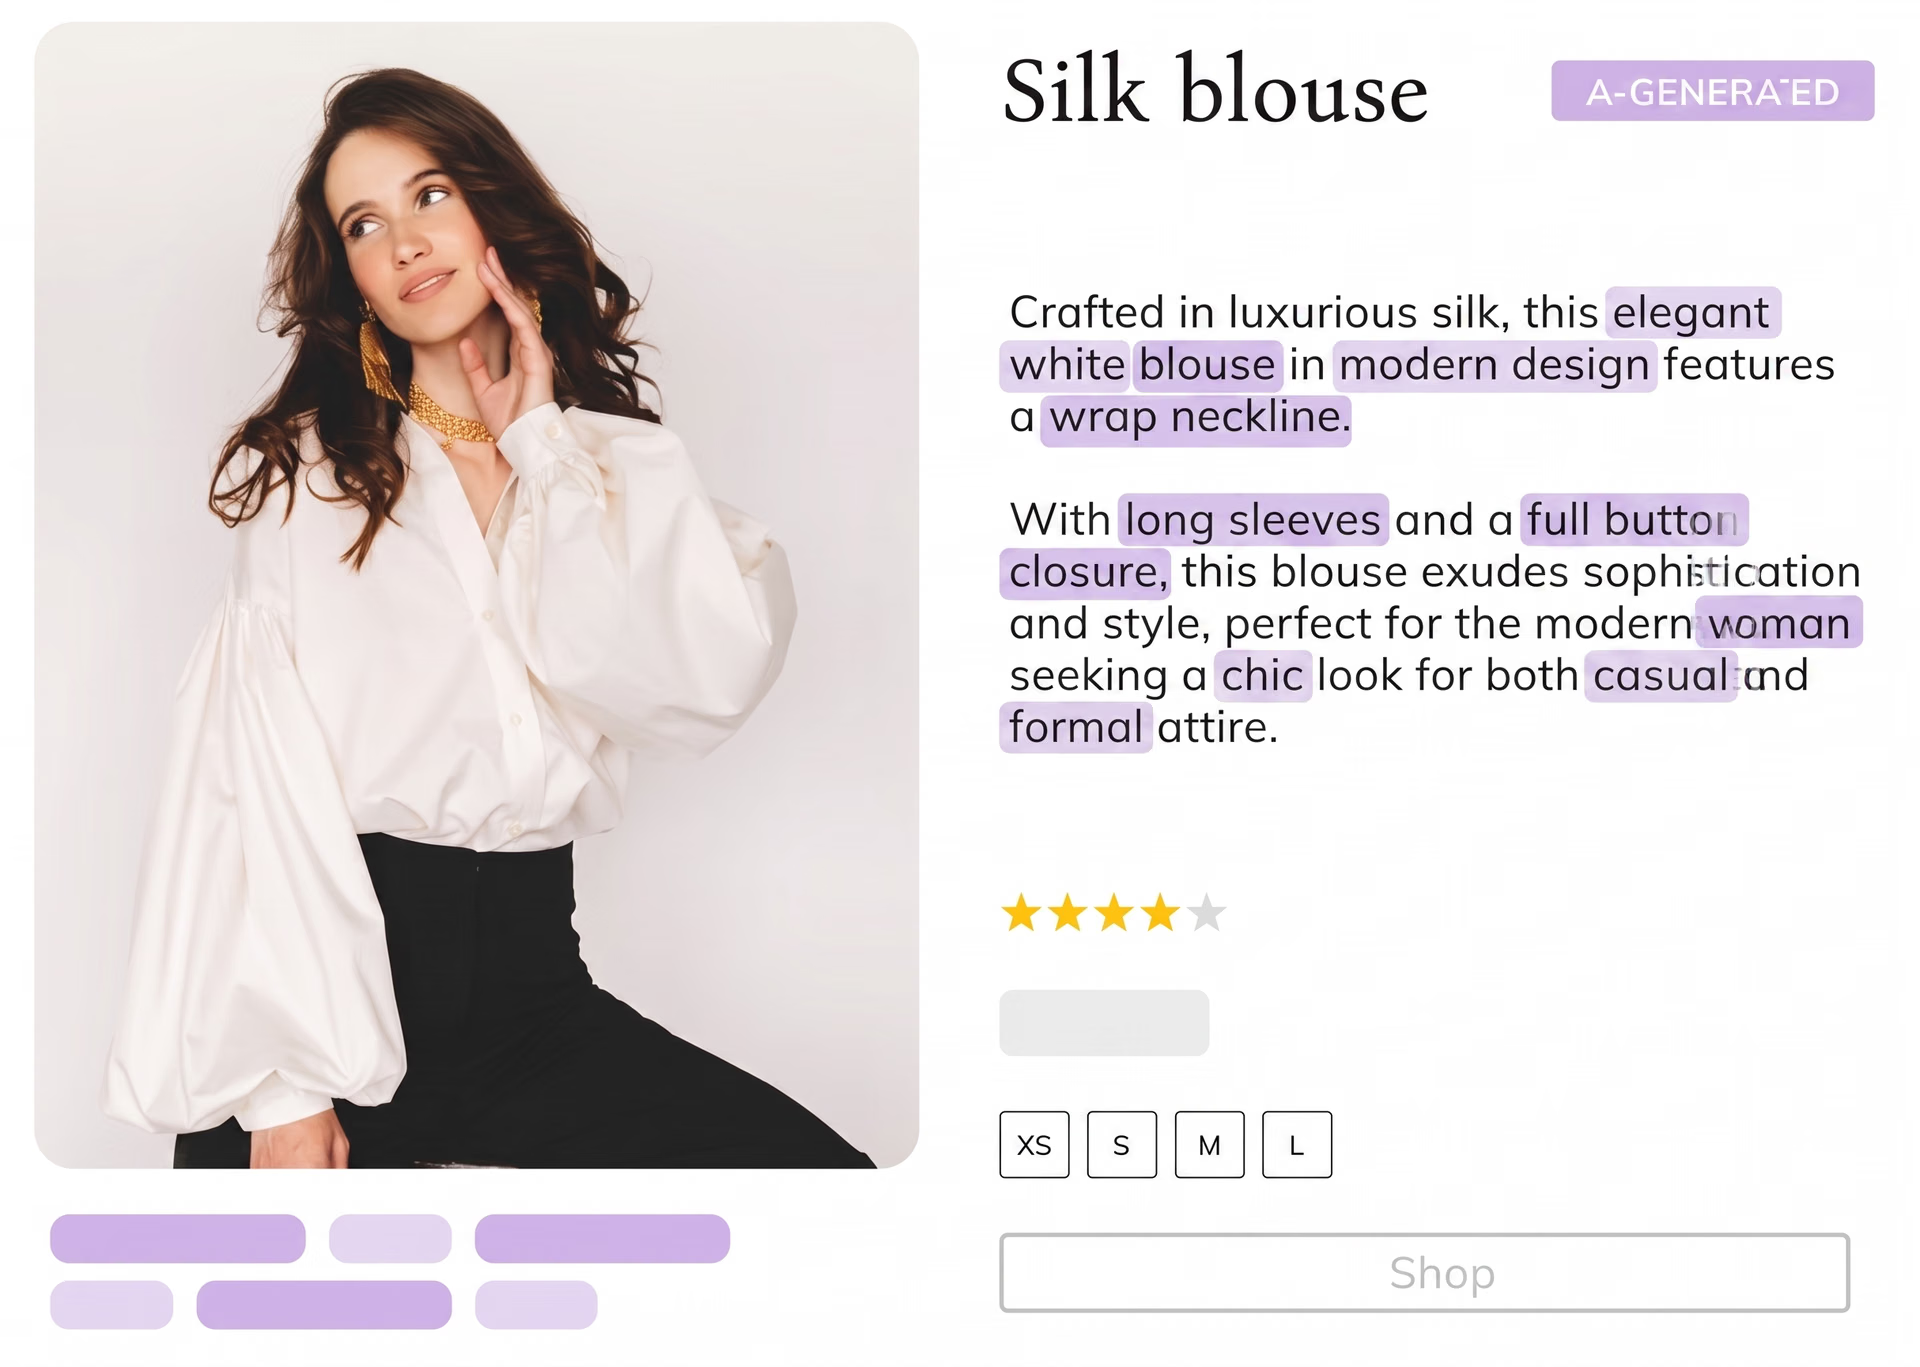
الشكل 5. مثال على وصف منتج أنشأه الذكاء الاصطناعي.
تُعد نماذج الذكاء الاصطناعي التوليدي، مثل BLIP-2، أمثلة على نماذج متطورة للرؤية واللغة تستطيع التنبؤ بسمات المنتجات مباشرةً من الصور. يستخدم BLIP-2 عدة مكونات لفهم منتجات التجارة الإلكترونية ووصفها بدقة. يبدأ بمعالجة الجوانب المرئية للمنتج وفهمها باستخدام مُرمّز للصور. ثم يفسّر محوّل الاستعلام هذه المعلومات المرئية في سياق أسئلة أو مهام محددة. وأخيرًا، ينشئ نموذج لغوي كبير أوصافًا مفصلة ودقيقة للمنتجات.
جعل الإنترنت أكثر سهولة في الوصول#
يمكن لنماذج الرؤية واللغة جعل الإنترنت أكثر سهولة في الوصول من خلال التعليق التوضيحي على الصور، ولا سيما للأشخاص ذوي الإعاقة البصرية. تقليديًا، يحتاج المستخدمون إلى إدخال أوصاف للمحتوى المرئي على المواقع ومنصات التواصل الاجتماعي. فعلى سبيل المثال، عند نشر صورة على Instagram، يمكنك إضافة نص بديل لقارئات الشاشة. لكن نماذج الرؤية واللغة تستطيع أتمتة هذه العملية.
عندما ترى نماذج الرؤية واللغة صورة قطة جالسة على أريكة، يمكنها إنشاء التعليق التوضيحي «قطة تجلس على أريكة»، ما يوضح المشهد للمستخدمين ذوي الإعاقة البصرية. وتستخدم هذه النماذج تقنيات مثل التلقين بأمثلة قليلة، حيث تتعلم من عدد قليل من أزواج الصور والتعليقات التوضيحية، والتلقين بسلسلة الأفكار، الذي يساعدها على تفكيك المشاهد المعقدة منطقيًا. وتجعل هذه التقنيات التعليقات التوضيحية الناتجة أكثر ترابطًا وتفصيلًا.
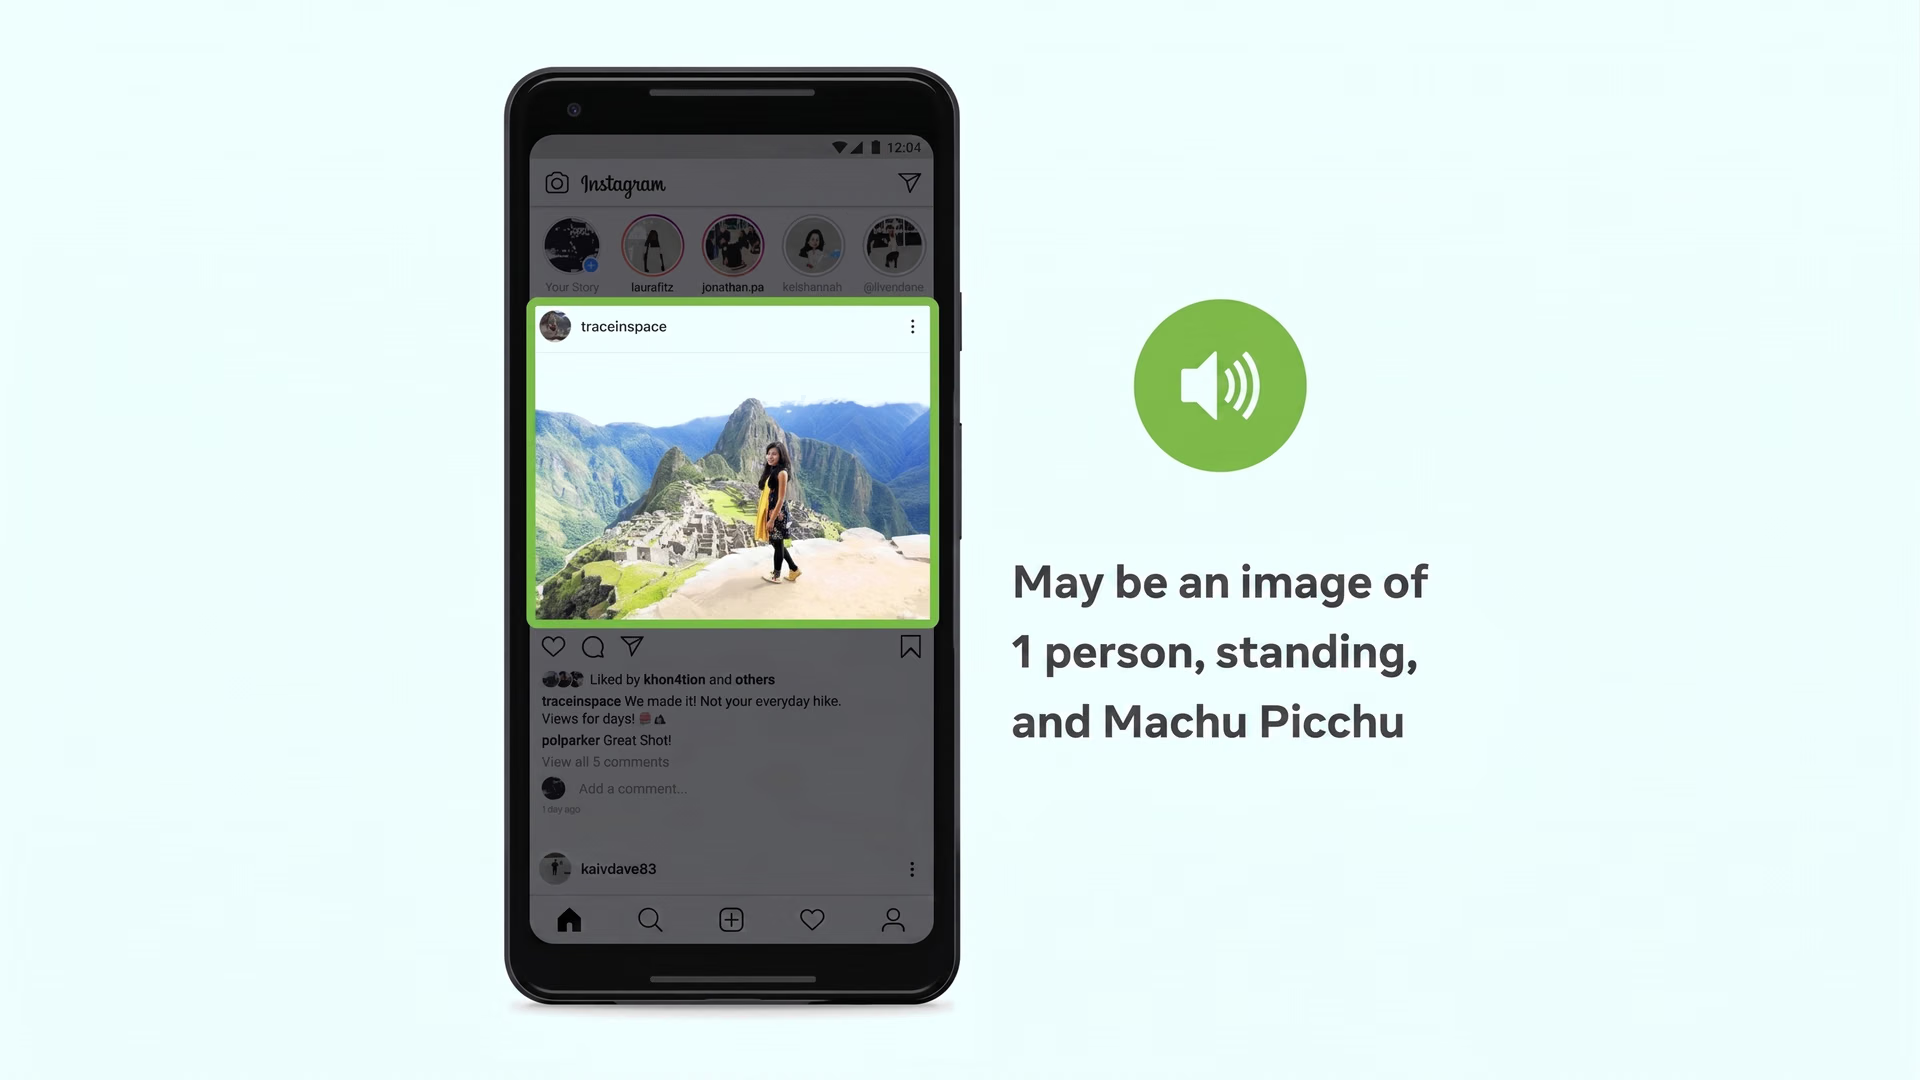
الشكل 6. استخدام الذكاء الاصطناعي لإنشاء تعليقات توضيحية للصور.
ولتحقيق هذا الغرض، تنشئ ميزة Google المسماة «الحصول على أوصاف الصور من Google» في Chrome أوصافًا تلقائيًا للصور التي لا تتضمن نصًا بديلًا. ورغم أن هذه الأوصاف التي ينشئها الذكاء الاصطناعي قد لا تكون مفصلة بقدر الأوصاف التي يكتبها البشر، فإنها تظل توفر معلومات قيّمة.
مزايا نماذج الرؤية واللغة وقيودها#
توفر نماذج الرؤية واللغة (VLMs) مزايا عديدة من خلال الجمع بين البيانات المرئية والنصية. ومن أبرز فوائدها:
- تحسين التفاعل بين الإنسان والآلة: تمكّن الأنظمة من فهم المدخلات المرئية والنصية معًا والاستجابة لها، ما يحسّن المساعدات الافتراضية وروبوتات المحادثة والروبوتات.
- التشخيص والتحليل المتقدمان: تساعد في المجال الطبي من خلال تحليل الصور وإنشاء الأوصاف، وتزويد المتخصصين الصحيين بآراء ثانية، واكتشاف الحالات الشاذة.
- السرد القصصي التفاعلي والترفيه: إنشاء قصص جذابة من خلال الجمع بين المدخلات المرئية والنصية لتحسين تجربة المستخدم في الألعاب والواقع الافتراضي.
على الرغم من القدرات المذهلة لنماذج الرؤية واللغة، فإن لها بعض القيود أيضًا. إليك أمورًا ينبغي مراعاتها عند التعامل مع هذه النماذج:
- متطلبات حوسبة عالية: يتطلب تدريب نماذج الرؤية واللغة ونشرها موارد حوسبة كبيرة، ما يجعلها مكلفة وأقل سهولة في الاستخدام.
- الاعتماد على البيانات والتحيّز: قد تنتج نماذج الرؤية واللغة نتائج متحيزة إذا دُرّبت على مجموعات بيانات غير متنوعة أو متحيزة، ما قد يؤدي إلى ترسيخ الصور النمطية والمعلومات المضللة.
- فهم محدود للسياق: قد تواجه نماذج الرؤية واللغة صعوبة في فهم الصورة الأكبر أو السياق، وقد تنتج مخرجات مفرطة في التبسيط أو غير صحيحة.
أبرز النقاط#
تتمتع نماذج الرؤية واللغة بإمكانات هائلة في مجالات كثيرة، مثل التجارة الإلكترونية والرعاية الصحية. ويمكنها دفع الابتكار وتحويل القطاعات من خلال الجمع بين البيانات المرئية والنصية. ومع ذلك، من الضروري تطوير هذه التقنيات بمسؤولية وأخلاقية لضمان استخدامها بإنصاف. ومع استمرار تطور نماذج الرؤية واللغة، ستتحسن مهام مثل البحث المستند إلى الصور والتقنيات المساعدة.
لمواصلة التعلّم عن الذكاء الاصطناعي، تواصل مع مجتمعنا! واستكشف مستودع GitHub لمعرفة كيف نستخدم الذكاء الاصطناعي لإنشاء حلول مبتكرة في قطاعات مثل التصنيع والرعاية الصحية. 🚀









