Computer Vision (CV)
الرؤية الحاسوبية (CV) هي مجال الذكاء الاصطناعي الذي يمكّن الآلات من تفسير الصور والفيديو. يتناول هذا الموضوع آلية عملها ومهامها الأساسية وتطبيقاتها وتحدياتها.
الرؤية الحاسوبية (CV) هي مجال من الذكاء الاصطناعي (AI) يمكّن الحواسيب من استخلاص المعنى من الصور والفيديو والبيانات المرئية الأخرى: ما الكائنات الموجودة، وأين تقع، وكيف تتحرك، وما الذي يحدث في المشهد. تتعلم الأنظمة الحديثة هذه المهارات من الأمثلة. فالنموذج المدرّب على آلاف الصور المعلّمة يتعلم الأنماط المرئية التي تحدد سيارة أو شقًا أو ورمًا، ثم يطبقها على صور لم يرها من قبل؛ ولهذا يستند المجال اليوم إلى التعلّم الآلي (ML)، وقبل كل شيء إلى التعلّم العميق (DL).
آلية عمل الرؤية الحاسوبية#
بالنسبة إلى الحاسوب، الصورة الملونة شبكة من الأرقام. تحتوي صورة بأبعاد 640×480 على 921,600 قيمة، قيمة واحدة لكل بكسل في كل قناة من قنوات الألوان الثلاث، وتتراوح شدة كل قيمة بين 0 و255. يحوّل مسار معالجة الرؤية الحاسوبية هذه الشبكة إلى قرار عبر خمس مراحل.
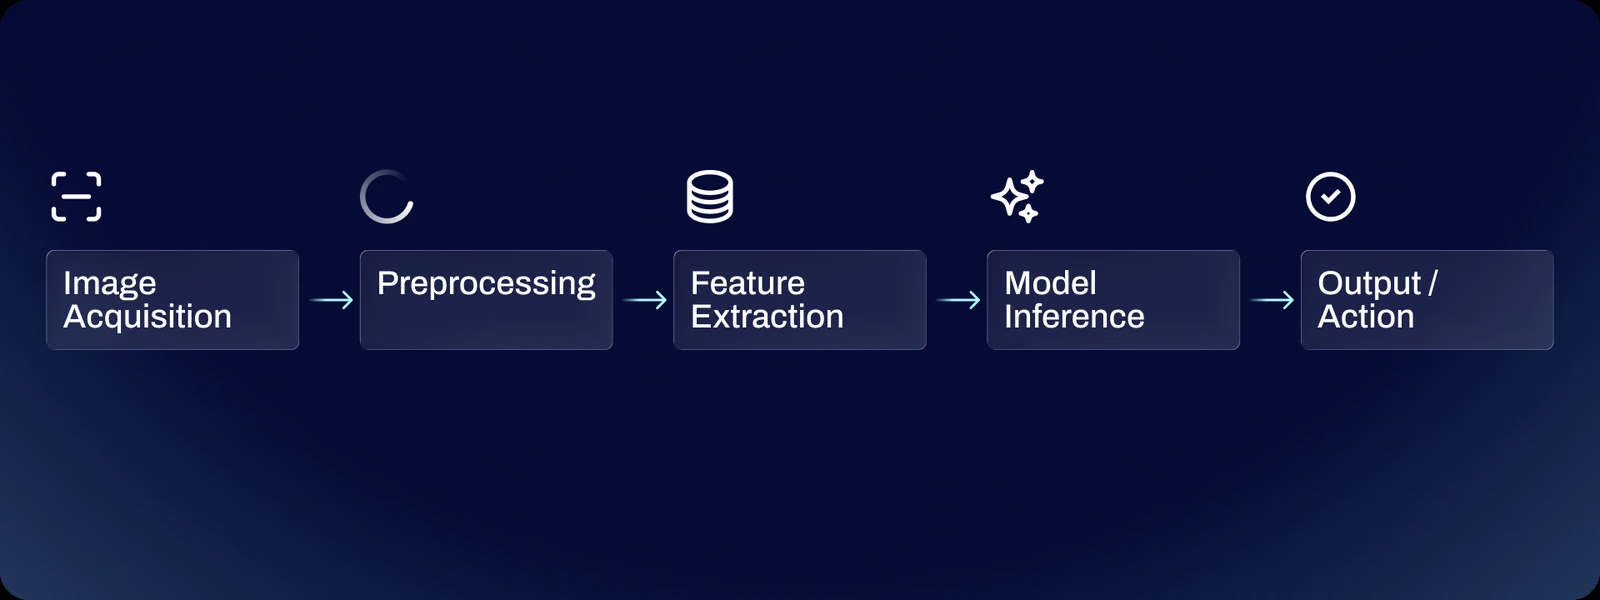
تلتقط كاميرا أو مستشعر الصورة، ثم تعمل المعالجة المسبقة، غالبًا باستخدام OpenCV، على تغيير حجمها وتوحيد قيمها المعيارية كي يتلقى النموذج المدخلات دائمًا بالتنسيق نفسه. بعد ذلك ينفذ النموذج استخراج السمات: تستجيب الطبقات الأولى في الشبكة العصبية الالتفافية (CNN) للحواف وتدرجات الألوان، وتجمع الطبقات الوسطى هذه العناصر في أنسجة وأجزاء، بينما تستجيب الطبقات العميقة للكائنات الكاملة. وتصل المحوّلات البصرية (ViTs) إلى تمثيلات مشابهة عبر تقسيم الصورة إلى رقع وربط كل رقعة بجميع الرقع الأخرى باستخدام الانتباه الذاتي. ويحوّل رأس مخصص للمهمة السمات إلى المخرجات، مثل تسمية فئة أو مجموعة من الصناديق المحيطة أو قناع بكسلات، ثم يتخذ النظام المحيط إجراءً بناءً عليها، مثل رفض قطعة معيبة أو كبح مركبة أو إطلاق تنبيه.
تتعلّم النماذج هذه السمات من خلال التعلّم الخاضع للإشراف. أثناء التدريب، يجري النموذج تنبؤات على صور موسومة، وتقيس دالة الخسارة مدى ابتعاد كل تنبؤ عن القيم المرجعية، ويعدّل الانتشار العكسي الأوزان لتقليل ذلك الخطأ. وتوفّر مجموعات البيانات العامة الكبيرة، مثل ImageNet التي تضم أكثر من 14 مليون صورة موسومة، وCOCO التي تضم 80 فئة من الكائنات اليومية، التدريب المسبق الذي تنطلق منه معظم النماذج المخصصة باستخدام التعلّم بالنقل.
من السمات المصممة يدويًا إلى التعلّم العميق#
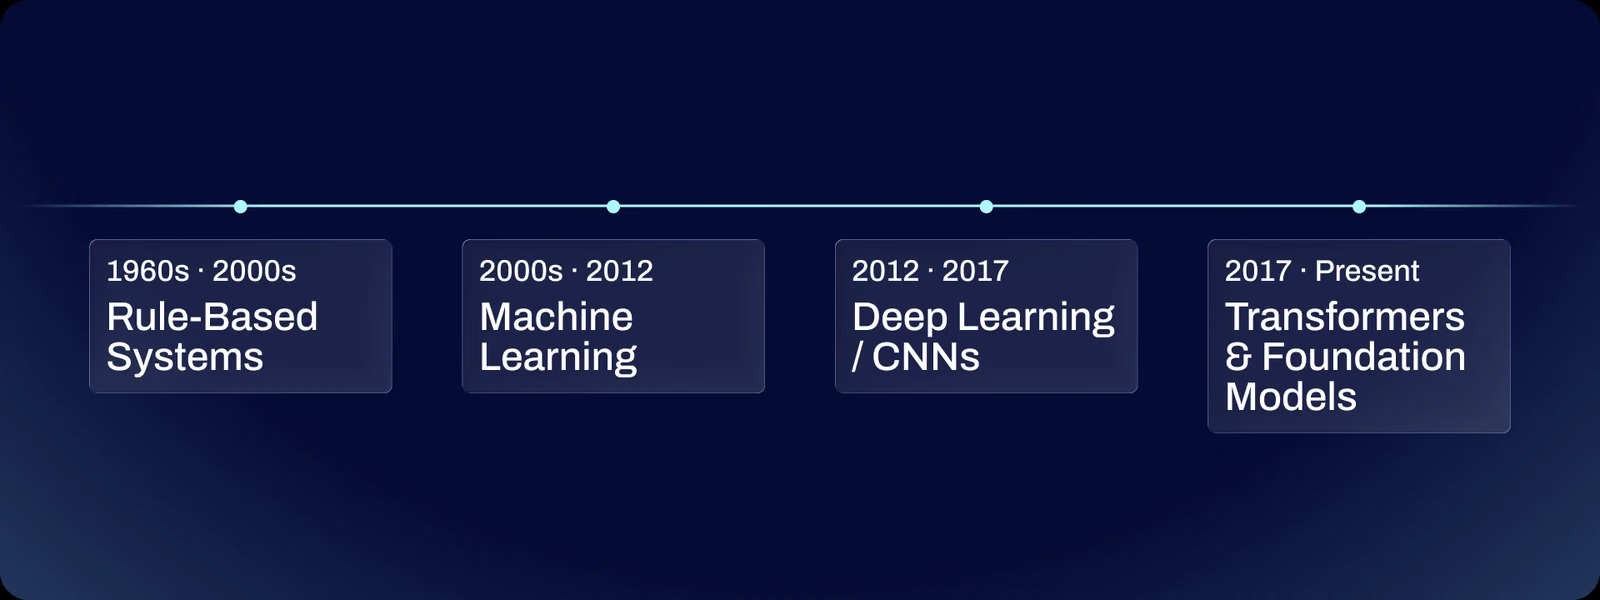
اعتمدت الرؤية الحاسوبية المبكرة على سمات صُممت يدويًا. فكتب المهندسون كواشف للحواف والزوايا وأنماط التدرج مثل SIFT وHOG، ثم مرّروا هذه السمات إلى مصنّف؛ وكانت الأنظمة الناتجة تتعطل كلما تغيرت الإضاءة أو زاوية الرؤية أو الخلفية. وجاء التحول الحاسم في عام 2012، حين فاز AlexNet بتحدي ImageNet بمعدل خطأ ضمن أفضل 5 بلغ 15.3%، مقابل 26.2% لأقرب منافس. ومنذ ذلك الحين، تعلمت CNNs، ثم محولات الرؤية ابتداءً من عام 2020، سماتها مباشرةً من البيانات. وتقرن نماذج الرؤية واللغة (VLMs) الصور بالنصوص الآن، ما يتيح لنموذج واحد الإجابة عن أسئلة مفتوحة حول صورة أو العثور على أجسام موصوفة بلغة بسيطة. وتقيس لوحة صدارة VLM دقة هذه النماذج في كشف الأجسام ضمن مجموعات بيانات واقعية.
المهام الأساسية للرؤية الحاسوبية#
تجيب كل مهمة عن سؤال مختلف حول الصورة:
- اكتشاف الكائنات: يعثر على كل كائن ويرسم صندوقًا حوله، مع فئة ودرجة ثقة، ما يتيح العد وتحديد المواقع.
- تقسيم الكائنات: يمنح كل كائن قناع بكسلات خاصًا به، بحيث يظل شخصان متجاوران منفصلين.
- التقسيم الدلالي: يضع تسمية فئة لكل بكسل، مثل الطريق أو الرصيف أو السماء.
- تقدير العمق: يتنبأ ببعد كل بكسل عن الكاميرا انطلاقًا من صورة واحدة.
- تصنيف الصور: يسند تسمية واحدة إلى الصورة كاملة، مثل «معيب» أو «سليم».
- تقدير الوضعية: يحدد النقاط المفتاحية، مثل مفاصل الجسم، لقياس الوضعية والحركة.
- الصناديق المحيطة الموجّهة (OBB): تلائم صناديق مدوّرة الكائنات ذات الزوايا المختلفة، مثل السفن والطائرات في صور الأقمار الصناعية.
- تتبّع الكائنات: يربط الاكتشافات عبر إطارات الفيديو كي يحتفظ كل كائن بمعرّف ثابت.
يبدأ اختيار المهمة من المخرجات التي يحتاجها التطبيق:
يغطي Ultralytics YOLO26 سبعًا من هذه المهام عبر واجهة Python واحدة: يستدعي YOLO() نفسه لتحميل نموذج للكشف أو تقسيم المثيلات أو التقسيم الدلالي أو العمق أو التصنيف أو الوضعيات أو OBB، وتضيف model.track() التتبع في الفيديو. يشغّل هذا المثال كشف الأجسام على صورة عينة:
from ultralytics import YOLO
# تحميل نموذج YOLO26 nano للكشف مدرّب مسبقًا
model = YOLO("yolo26n.pt")
# تشغيل الاستدلال على صورة شارع نموذجية
results = model("https://ultralytics.com/images/bus.jpg")
result = results[0]
# طباعة عدد الكائنات المكتشفة لكل فئة وحفظ الصورة المشروحة
print(result.verbose())
result.save(filename="bus_detections.jpg")يحصي السطر المطبوع الاكتشافات لكل فئة، وترسم الصورة المحفوظة كل اكتشاف مع صندوقه وتسميته ودرجة ثقته.
الرؤية الحاسوبية مقارنةً بالمجالات ذات الصلة#
- معالجة الصور: تحوّل صورة إلى صورة أخرى عبر زيادة الحدة أو إزالة الضوضاء أو تغيير الحجم أو تعديل التباين. وتستخدم مسارات الرؤية الحاسوبية هذه العمليات للمعالجة المسبقة قبل تفسير المشهد.
- الرؤية الآلية: تطبيق صناعي للرؤية الحاسوبية على الفحص وتوجيه الروبوتات، عادةً باستخدام كاميرات ثابتة وإضاءة مضبوطة وأجهزة مخصصة على خط الإنتاج.
- التعرّف على الصور: مرادف شائع لتصنيف الصور، ويُستخدم أحيانًا على نحو غير دقيق لوصف أي مهمة تحدد محتوى الصورة.
تطبيقات عملية#
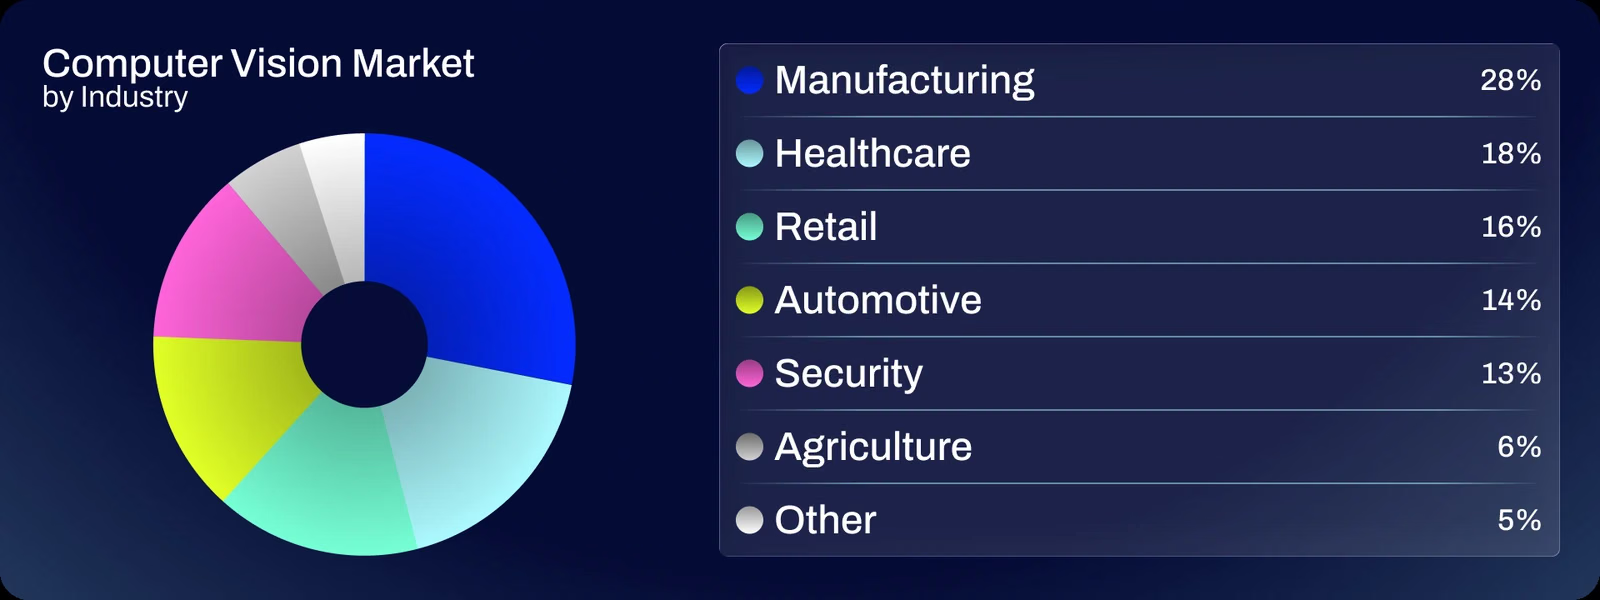
- التصنيع: تفحص الكاميرات كل قطعة بسرعة خط الإنتاج بحثًا عن الشقوق والخدوش والمكونات غير المحاذية، وتتتبع تآكل الآلات قبل تعطلها.
- التصوير الطبي: تحدد النماذج الأورام والكسور وأمراض الشبكية في الأشعة السينية والتصوير المقطعي وصور الشبكية، ليطلع عليها اختصاصيو الأشعة.
- المركبات ذاتية القيادة: تكتشف السيارات المسارات والإشارات والمشاة والمركبات الأخرى آنيًا، وتدمج مخرجات الكاميرا مع الرادار وLiDAR في نموذج ثلاثي الأبعاد لمحيطها.
- البيع بالتجزئة: تكتشف كاميرات الرفوف الواجهات الفارغة والمنتجات الموضوعة في غير مكانها، وتتتبع متاجر التسوق دون محاسبة العناصر التي يأخذها كل متسوق.
- الزراعة: تميّز الطائرات المسيّرة والمرشّات المحاصيل من الأعشاب الضارة لكل نبتة، بحيث لا يُستخدم مبيد الأعشاب والأسمدة إلا حيث يلزم.
- الأمن والمدن الذكية: تحصي الأنظمة الأشخاص والمركبات، وتراقب حركة المرور، وتستخدم كشف الحالات الشاذة للإبلاغ عن الأحداث غير المعتادة في المناطق المحظورة.
التحديات والقيود#
لا تتجاوز جودة النموذج جودة مجموعة التدريب، وغالبًا ما يتطلب وضع تسميات للبيانات، أي رسم الصناديق أو الأقنعة على آلاف الصور، جهدًا أكبر من تدريب النموذج نفسه. وتتغير الظروف أيضًا بعد النشر: فالمطر والوهج والإضاءة الليلية والحجب أو تحريك الكاميرا تغيّر المدخلات عما رآه النموذج أثناء التدريب. وتحاكي زيادة البيانات هذه الظروف أثناء التدريب، فيما يكشف التحقق باستخدام صور مستبعدة من التدريب عن فرط التكيّف قبل الإصدار.
تمثل القدرة الحاسوبية القيد التالي. إذ تشغّل الكاميرات والطائرات المسيّرة والهواتف النماذج ضمن ميزانيات محدودة للطاقة والذاكرة، لذا تفضل عمليات نشر الذكاء الاصطناعي الطرفي النماذج الصغيرة وتكميم النماذج لتحقيق سرعة آنية من دون إرسال الفيديو إلى السحابة.
تثير الأنظمة التي تحلل الأشخاص مخاوف بشأن التحيز والخصوصية. وتنتج مجموعة البيانات التي لا تمثل بعض الفئات تمثيلًا كافيًا نموذجًا يختلف أداؤه بينها، كما تُعد بيانات الوجه والجسم بيانات شخصية حساسة بموجب معظم قوانين الخصوصية. ومنذ فبراير 2025، يحظر قانون الذكاء الاصطناعي الأوروبي على أجهزة إنفاذ القانون إجراء التعرف البيومتري عن بُعد آنيًا في الأماكن المتاحة للجمهور، باستثناءات ضيقة، مثل البحث عن ضحايا الاختطاف أو منع تهديد إرهابي وشيك.









