Ultralytics Platform: Computer-Vision-Modelle in jeder Region bereitstellen
Erfahre, wie du Computer-Vision-Modelle mit der Ultralytics Platform auf dedizierten Endpunkten in 42 Regionen weltweit bereitstellst – inklusive integrierter Überwachung.
Anfang dieser Woche hat Ultralytics die Ultralytics Platform vorgestellt, eine neue durchgängige Umgebung, die die Bereitstellung von Computer-Vision-Systemen (CV) beschleunigen soll, indem sie alle Phasen des KI-Arbeitsablaufs für Bildverarbeitung optimiert – von der Datenvorbereitung und Modellentwicklung bis zur Bereitstellung.
Einer der wichtigsten Beweggründe für die Entwicklung der Ultralytics Platform ist die Erkenntnis, dass es mehr braucht als ein leistungsstarkes Modell, um eine Computer-Vision-Lösung von der Idee bis zur praktischen Wirkung zu bringen. Sobald ein Modell trainiert und validiert wurde, muss es bereitgestellt werden, damit Anwendungen Bilder senden, Vorhersagen empfangen und in realen Umgebungen zuverlässig Inferenzen ausführen können.
In dieser Phase des Lebenszyklus maschinellen Lernens gehen Computer-Vision-Modelle über das Experimentieren hinaus und beginnen, praktische Systeme anzutreiben. Selbst wenn frühere Schritte wie Datensatzvorbereitung, Annotation, Modelltraining und Tests reibungslos verlaufen, können diese Ergebnisse ohne eine zuverlässige Möglichkeit zur Modellbereitstellung nichts bewirken.
Bei vielen Computer-Vision-Projekten ist die Bereitstellung eine der komplexesten Phasen des Arbeitsablaufs.
Teams müssen häufig Inferenz-APIs konfigurieren, Rechenressourcen verwalten, Modelle zur Verringerung der Latenz in der Nähe der Nutzer bereitstellen und die Leistung überwachen, sobald die Systeme in der Produktion laufen.
Die Ultralytics Platform vereinfacht und automatisiert diesen Prozess mit mehreren Bereitstellungsoptionen, darunter Modell-Exportformate, gemeinsam genutzte Inferenzdienste und dedizierte Endpunkte in Regionen auf der ganzen Welt. Dank verwalteter Infrastruktur und integrierter Überwachung können Teams trainierte Modelle problemlos in produktionsreife Computer-Vision-Systeme überführen.
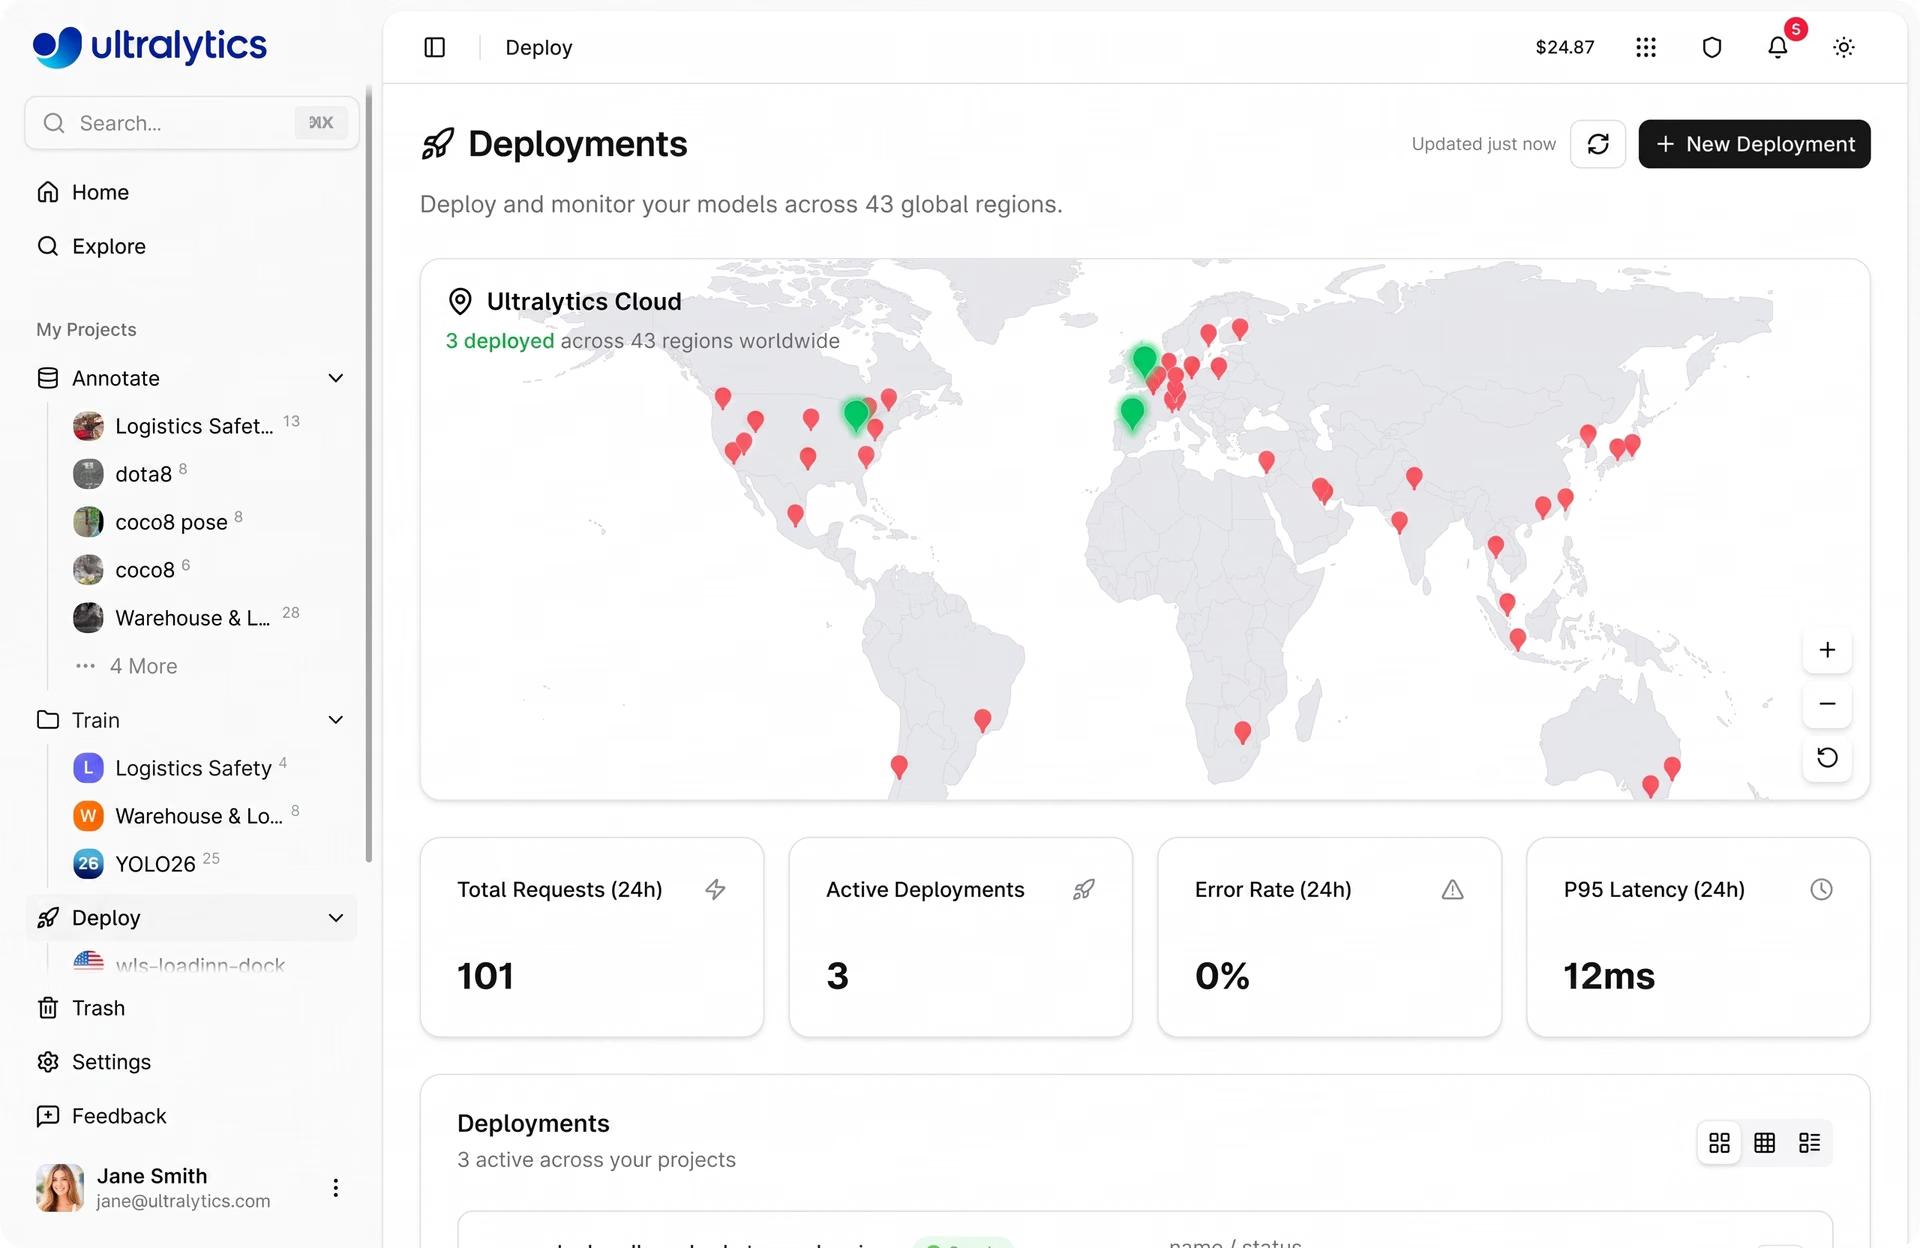
Abb. 1. Einblick in die Modellbereitstellung mit der Ultralytics Platform (Quelle)
In diesem Artikel sehen wir uns an, wie du Computer-Vision-Modelle mithilfe dedizierter Endpunkte auf der Ultralytics Platform in beliebigen Regionen bereitstellen kannst.
Was bedeutet die Bereitstellung von CV-Modellen?#
Bevor wir uns ansehen, wie du Deep-Learning-Modelle mit der Ultralytics Platform bereitstellst, wollen wir genauer klären, was die Bereitstellung von Computer-Vision-Modellen eigentlich bedeutet.
Die Modellbereitstellung für Computer Vision bezeichnet den Prozess, ein trainiertes Modell für den Einsatz in der Praxis verfügbar zu machen. Statt ausschließlich in einer Trainingsumgebung zu laufen, wird das Modell so eingerichtet, dass Anwendungen Bilder oder Videos senden und im Gegenzug Vorhersagen erhalten können.
Ein Modell kann beispielsweise Objekte in einem Bild erkennen, Bilder segmentieren, Artikel in einem Lager identifizieren oder Muster in Videoaufnahmen erkennen. In den meisten realen Systemen geschieht dies über eine API oder einen Inferenzendpunkt.
Eine Anwendung sendet ein Bild an das Modell, das Modell verarbeitet es und gibt innerhalb von Millisekunden eine Vorhersage zurück. So können Computer-Vision-Modelle wie Ultralytics YOLO Echtzeitanwendungen ermöglichen.
Je nach Anwendungsfall lassen sich Modelle in unterschiedlichen Umgebungen bereitstellen. Einige laufen in der Cloud (über Cloud-Plattformen) und sind für zahlreiche Anwendungen zugänglich, während andere auf Edge-Geräten ausgeführt werden, etwa auf lokalen Kameras, Robotern oder eingebetteten Systemen, die schnelle Vorhersagen vor Ort benötigen.
Optionen zur Bereitstellung von KI-Modellen auf der Ultralytics Platform#
Die Ultralytics Platform begegnet vielen Herausforderungen, mit denen die Computer-Vision-Community bei der Bereitstellung von Modellen konfrontiert ist, und bietet flexible Möglichkeiten zur Inferenz, die sich nach den Anforderungen deiner Anwendung richten.
Hier ist ein kurzer Überblick über die auf der Plattform verfügbaren Optionen zur Modellbereitstellung:
- Modell-Export: Du kannst Modelle in 22 verschiedene Formate exportieren, darunter ONNX, TensorRT, CoreML und TFLite. So lassen sich Modelle in vielen Umgebungen ausführen, etwa auf Edge-Geräten wie Raspberry Pi und NVIDIA Jetson, in mobilen Apps, Docker-Containern und auf individueller Infrastruktur.
- Gemeinsam genutzte Inferenz: Auf der Plattform kannst du Vorhersagen über einen verwalteten, gemeinsam genutzten Inferenzdienst ausführen, der sich ideal für das schnelle Testen von Modellen eignet.
- Dedizierte Endpunkte: Stelle Modelle einfach als eigenständige Dienste mit eindeutigen API-URLs bereit, die in 42 Regionen weltweit laufen können. Für den Produktionseinsatz bieten sie Skalierung auf null, Überwachung und Zustandsprüfungen.
Bereitstellung über dedizierte Endpunkte#
Eine der am besten skalierbaren Möglichkeiten, vortrainierte oder individuell trainierte Computer-Vision-Modelle in der Produktion auf der Ultralytics Platform auszuführen, sind dedizierte Endpunkte. Über einen dedizierten Endpunkt kannst du ein trainiertes Modell als eigenen Dienst bereitstellen, sodass Anwendungen Bilder senden und über eine API Vorhersagen empfangen können.
Wird ein Modell nicht nur in einer Trainingsumgebung oder einem lokalen Notebook ausgeführt, sondern als Endpunkt bereitgestellt, können echte Anwendungen darauf zugreifen. So könnte ein Lagerverwaltungssystem Bilder von Paketen zur Objekterkennung senden, eine intelligente Kamera Videobilder analysieren oder ein Robotersystem Vorhersagen zur Steuerung von Aktionen verwenden.
Jeder dedizierte Endpunkt wird als Dienst mit nur einem Mandanten ausgeführt. Das bedeutet, dass die Infrastruktur für dein Modell nicht mit anderen Nutzern geteilt wird. Dadurch ist die Leistung besser vorhersehbar und das Verhalten des Modells in der Produktion lässt sich leichter überwachen.
So funktionieren dedizierte Inferenzendpunkte#
Du kannst dir einen dedizierten Endpunkt als gehosteten Dienst für dein Modell vorstellen. Die Ultralytics Platform stellt eine eindeutige Endpunkt-URL bereit, über die Anwendungen auf den Dienst zugreifen.
Sendet eine Anwendung eine Anfrage an diese URL, enthält sie ein Bild und optionale Parameter wie Konfidenzschwellen oder die Bildgröße sowie einen API-Schlüssel zur Authentifizierung.
Der Dienst führt mithilfe deines Modells eine Inferenz auf dem Bild aus und gibt die Vorhersagen in einer strukturierten Antwort zurück. So können Entwickler Computer-Vision-Modelle mithilfe gängiger Webwerkzeuge in reale Systeme integrieren.
Anwendungen können Anfragen mit Python, JavaScript, cURL oder anderen HTTP-Clients senden. So lassen sich Modelle einfach mit Dashboards, Robotersystemen oder Cloud-Anwendungen verbinden. Da der Endpunkt unabhängig läuft, unterstützt er außerdem Skalierung, Überwachung und die weltweite Bereitstellung und hilft Teams dabei, zuverlässige Computer-Vision-Systeme für den Produktiveinsatz zu entwickeln.
Bereitstellungen in mehreren Regionen verbessern die Echtzeit-Inferenz#
Ein entscheidender Vorteil dedizierter Endpunkte auf der Ultralytics Platform ist, dass du Modelle in 42 Regionen weltweit bereitstellen kannst. Diese Regionen umfassen mehrere Teile der Welt, darunter Nordamerika, Südamerika, Europa, den asiatisch-pazifischen Raum sowie den Nahen Osten und Afrika.
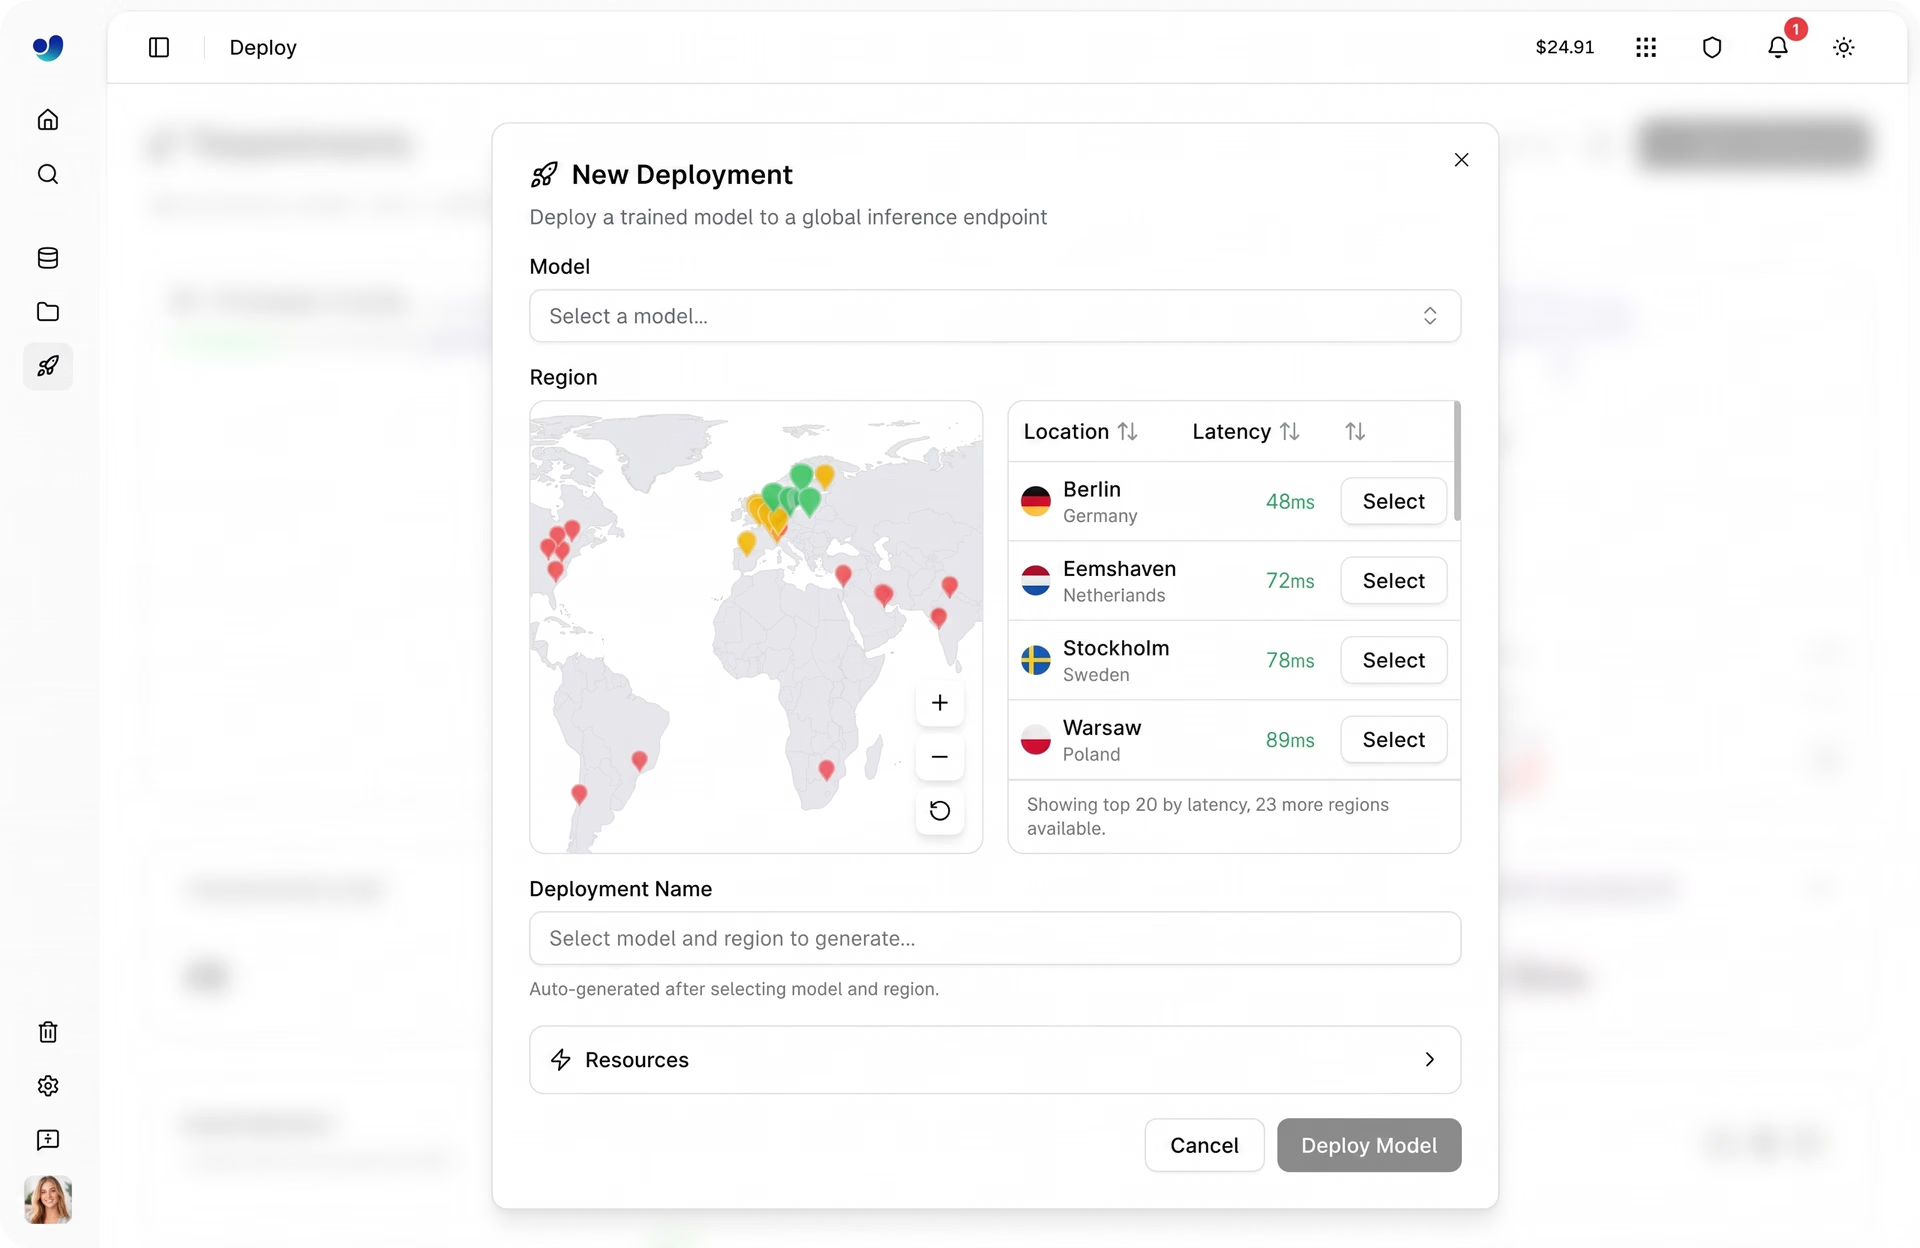
Abb. 2. Die Ultralytics Platform unterstützt 42 Regionen weltweit (Quelle)
Wenn du Modelle in Regionen bereitstellst, die näher an den Einsatzorten der Anwendungen liegen, verringert sich die Latenz, also die Zeit, die eine Anwendung benötigt, um ein Bild zu senden und eine Vorhersage zu erhalten. Außerdem können Unternehmen Datenschutz- und Anforderungen an den Datenstandort erfüllen, indem sie die Daten näher an ihrem Ursprung verarbeiten.
Eine geringe Latenz ist für viele Computer-Vision-Anwendungen wichtig, die auf Echtzeit-Inferenz angewiesen sind, etwa Robotersysteme, Geräte des Internets der Dinge (IoT), industrielle Prüfabläufe und Smart-City-Infrastruktur.
Wird eine Anwendung beispielsweise hauptsächlich in Europa genutzt, kann die Bereitstellung des Modells in einer europäischen Region die Reaktionszeiten im Vergleich zum Betrieb in einer weit entfernten Region erheblich verbessern.
So stellst du Modelle mit der Ultralytics Platform in jeder Region bereit#
Die Bereitstellung eines Modells in einer bestimmten Region ist einfach und dauert in der Regel nur ein paar Minuten. Die Plattform richtet die Infrastruktur ein, sodass sich Entwickler auf die Integration des Modells in ihre Anwendungen konzentrieren können. Sehen wir uns die einzelnen Schritte an.
Schritt 1: Ein Modell trainieren oder hochladen#
Vor der Bereitstellung brauchst du ein trainiertes Modell in deinem Projekt. Das kann ein direkt auf der Ultralytics Platform trainiertes Modell sein, ein nach dem Training an einem anderen Ort hochgeladenes Modell oder ein aus einem Community-Projekt geklontes Modell, das du im Tab „Entdecken“ findest. Dort kannst du öffentliche Projekte anderer Nutzer mit einem Klick in dein eigenes Konto kopieren.
Sobald das Modell bereit ist, öffne die Modellseite in deinem Projekt, um fortzufahren.
Schritt 2: Den Tab „Deploy“ öffnen#
Rufe beim Modell den Tab „Deploy“ auf. In diesem Bereich der Plattform kannst du Bereitstellungen konfigurieren und starten.
Auf dieser Seite siehst du eine Regionentabelle und eine interaktive Karte mit den weltweit verfügbaren Bereitstellungsstandorten. Die Plattform misst die Latenz von deinem Standort aus und sortiert die Regionen entsprechend, damit du die am besten geeignete Region auswählen kannst.
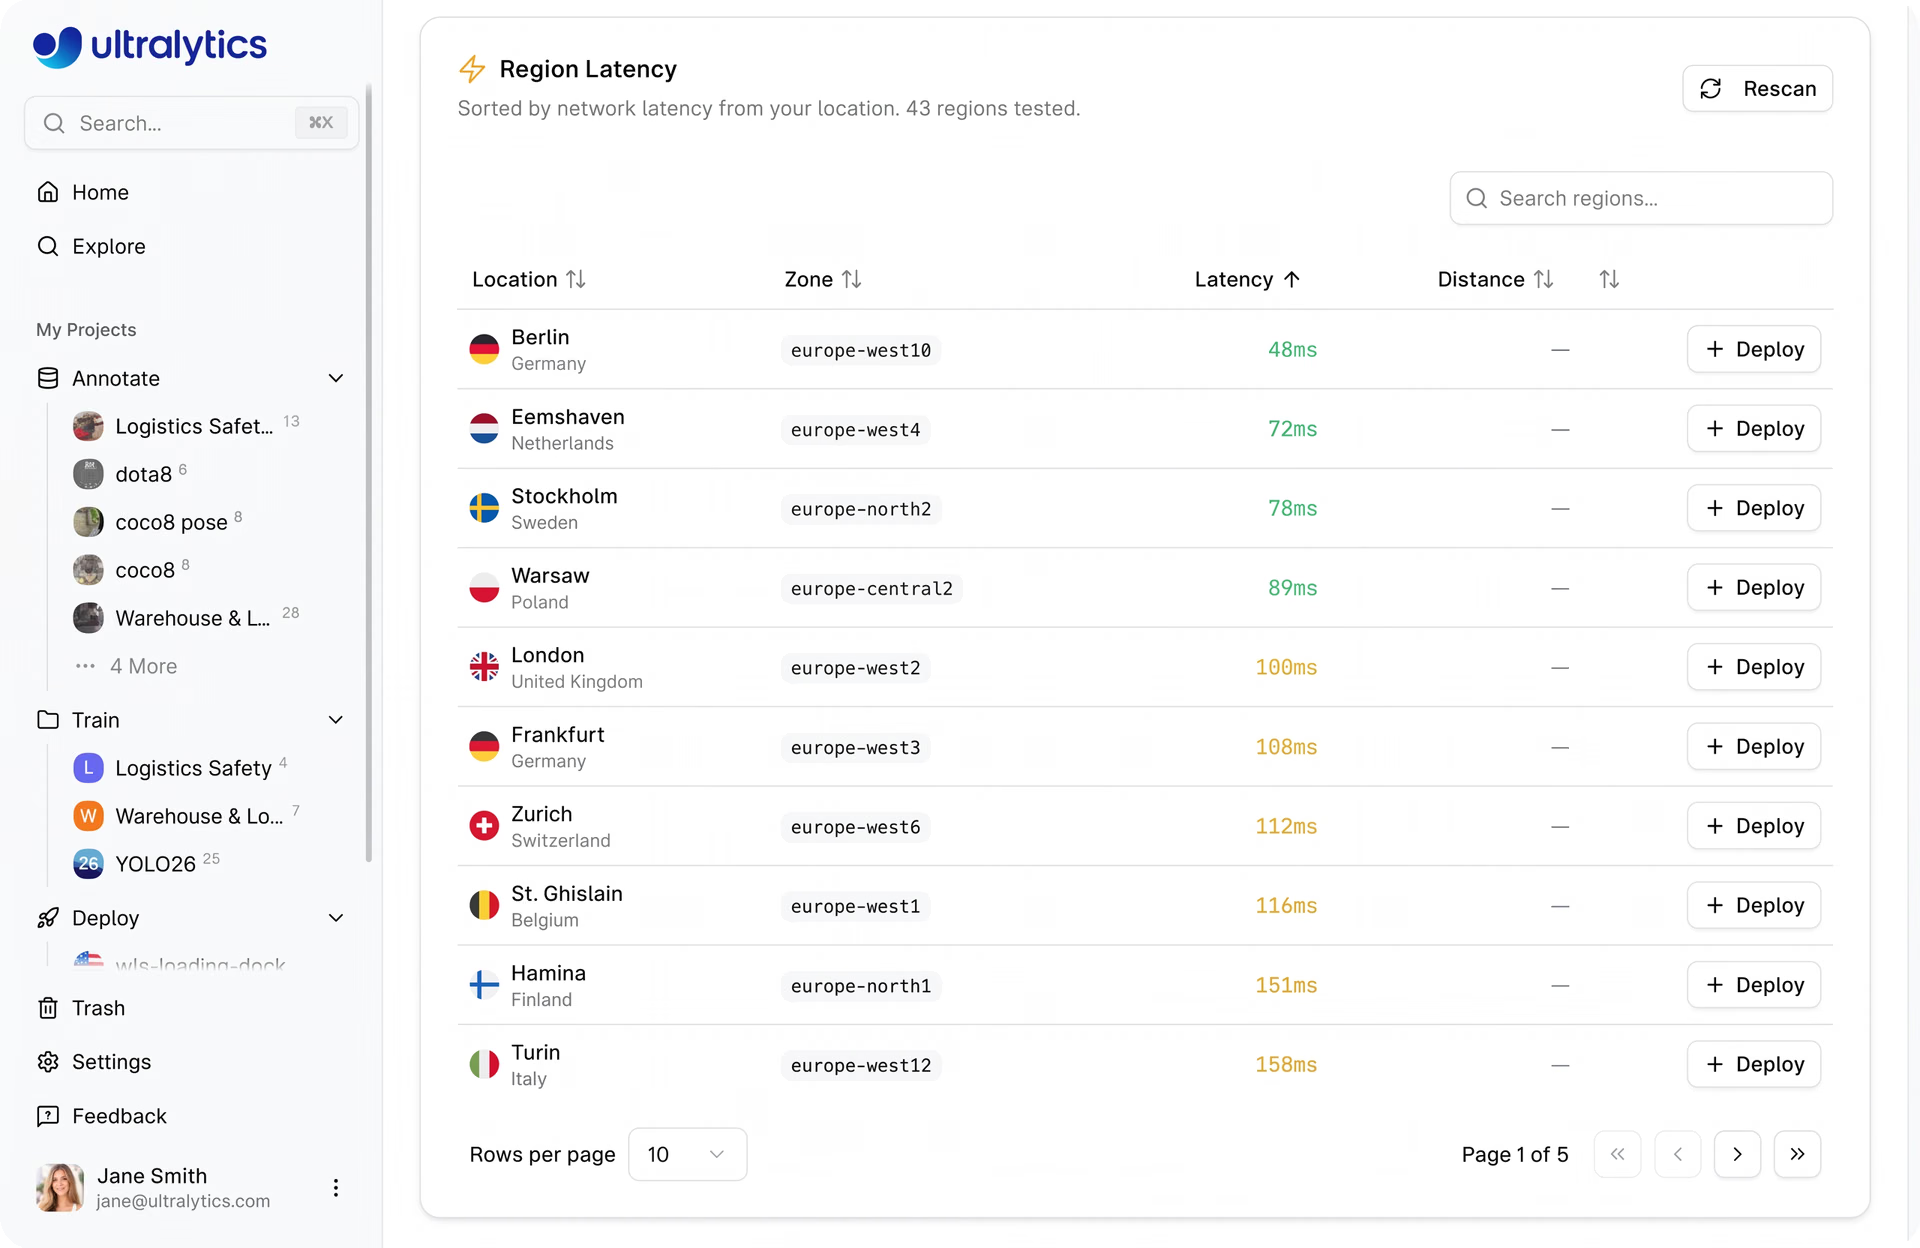
Abb. 3. Regionen auf der Ultralytics Platform nach Latenz sortiert (Quelle)
Schritt 3: Eine Bereitstellungsregion auswählen#
Wähle eine Region entsprechend dem Standort deiner Nutzer oder Anwendungen aus. Wenn du das Modell näher an der Quelle der Anfragen bereitstellst, lassen sich die Reaktionszeiten erheblich verkürzen.
Schritt 4: Den Endpunkt bereitstellen#
Nachdem du die Region ausgewählt und die Konfiguration bestätigt hast, kannst du auf „Deploy“ klicken.
Die Plattform richtet dann die Bereitstellungsumgebung ein, lädt das Modell-Image herunter, startet den Dienst und führt eine Zustandsprüfung durch, um sicherzustellen, dass der Endpunkt bereit ist. Dieser Vorgang dauert in der Regel etwa ein bis zwei Minuten.
Nach Abschluss der Bereitstellung erstellt die Plattform eine eindeutige Endpunkt-URL, über die Anwendungen Inferenzanfragen senden können.
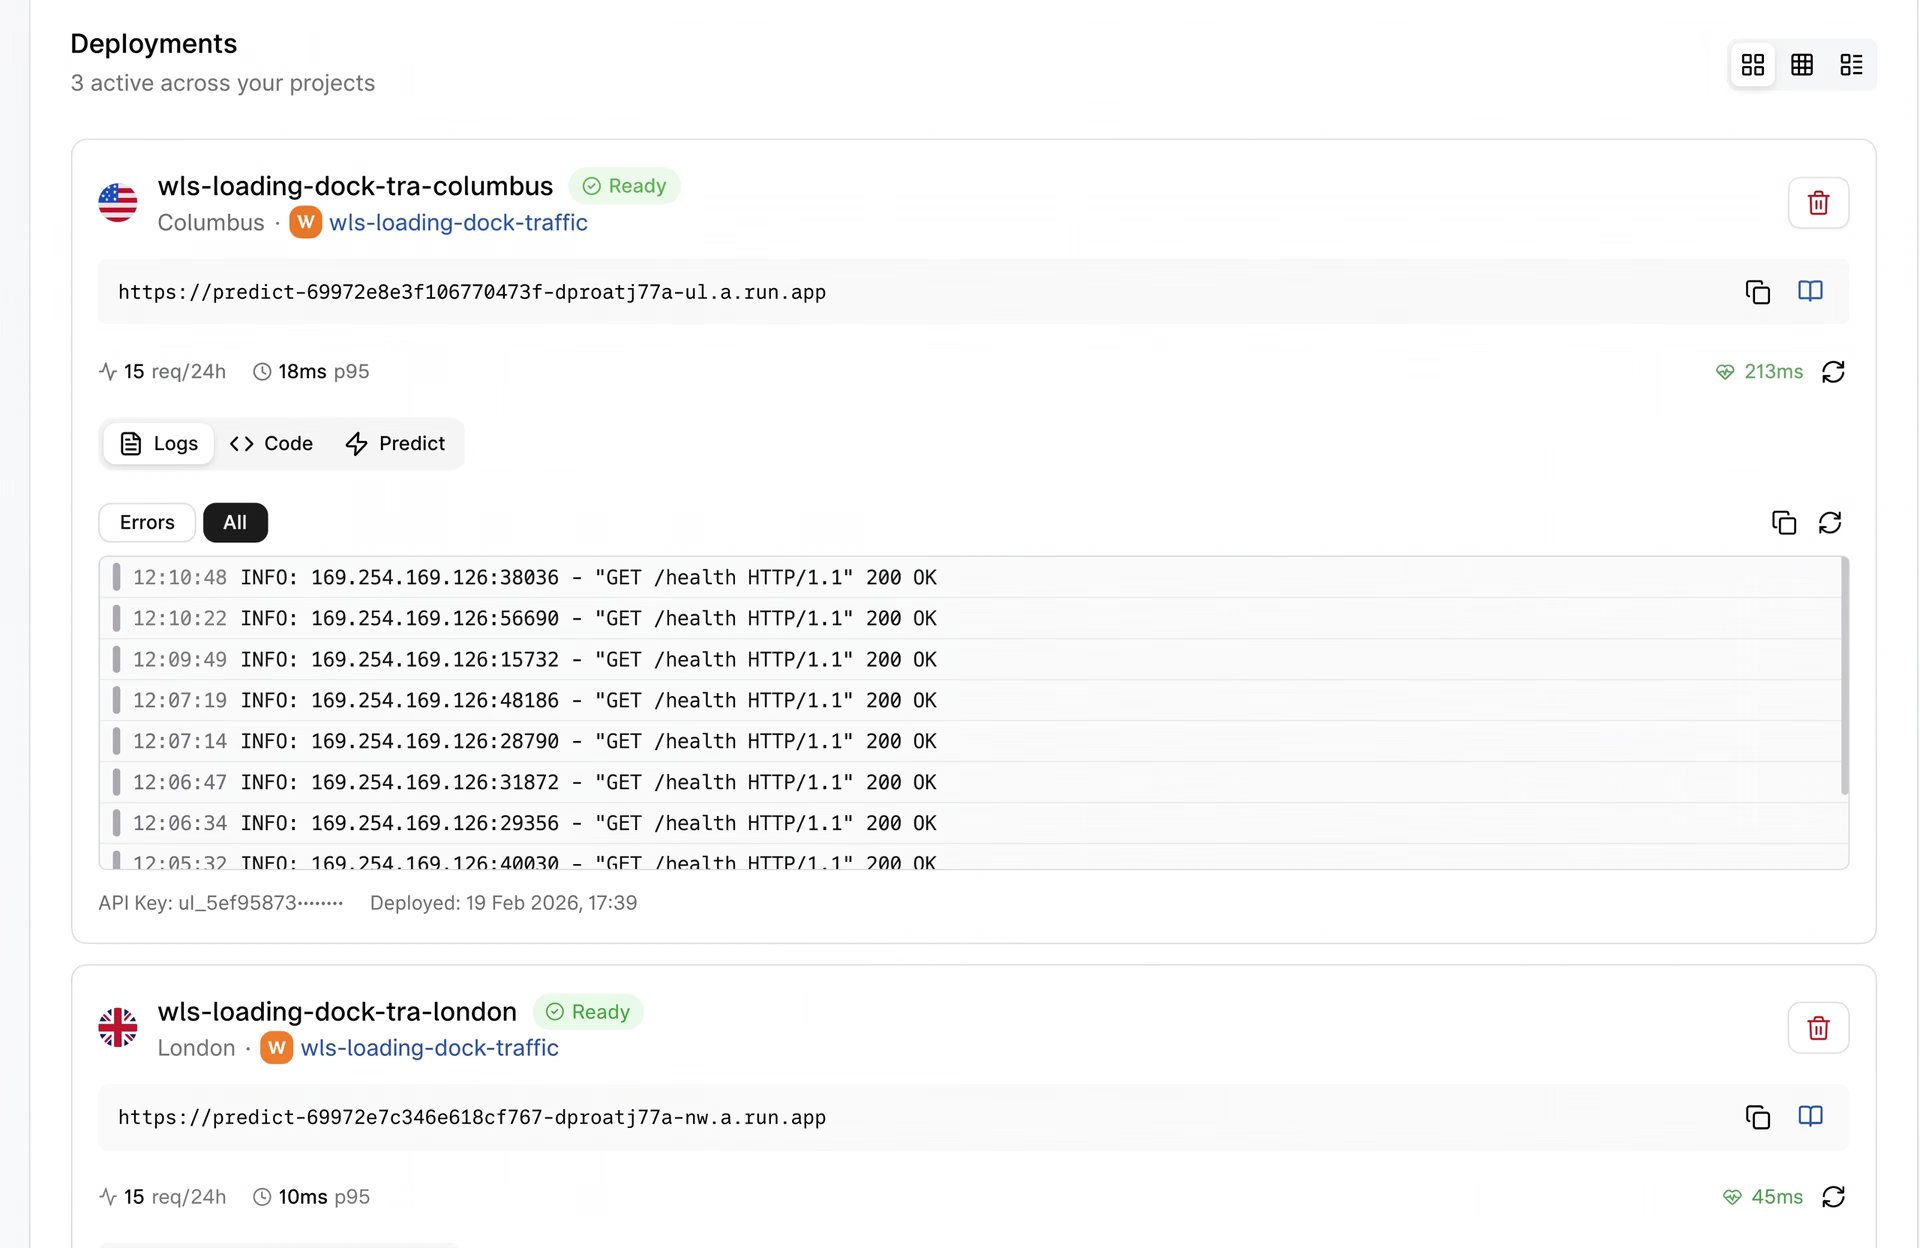
Abb. 4. Beispiel für einen bereitgestellten Endpunkt (Quelle)
Schritt 5: Inferenzanfragen senden#
Sobald der Endpunkt läuft, können Anwendungen mithilfe des bereitgestellten REST API-Endpunkts Bilder an das Modell senden. Dazu muss ein API-Schlüssel im Authorization-Header übergeben werden. Der Endpunkt verarbeitet jede Anfrage und gibt Vorhersagen zurück, etwa erkannte Objekte, Begrenzungsrahmen oder andere aufgabenspezifische Ausgaben.
Weitere Informationen zur Modellbereitstellung findest du in der offiziellen Dokumentation zur Ultralytics Platform.
Modellleistung und Kennzahlen bereitgestellter Endpunkte überwachen#
Sobald ein Computer-Vision-Modell bereitgestellt ist, wird die Überwachung seiner Leistung zu einem wichtigen Bestandteil der Systemzuverlässigkeit und Robustheit. Auch ein gut trainiertes Modell muss im Produktivbetrieb beobachtet werden, damit sichergestellt ist, dass es weiterhin schnell reagiert, eingehende Anfragen korrekt verarbeitet und präzise Vorhersagen liefert.
Die Ultralytics Platform bietet integrierte Überwachungswerkzeuge, mit denen Teams die Leistung bereitgestellter Endpunkte im Blick behalten können. Die Deploy-Seite der Plattform dient als Überwachungsdashboard und bietet eine zentrale Übersicht über alle laufenden Endpunkte sowie wichtige Kennzahlen zur Überwachung des Systemzustands und der Nutzung.
Hier sind einige Kennzahlen, die du mit der Platform überwachen kannst:
- P95-Latenz: Diese Kennzahl misst die serverseitige Antwortzeit am 95. Perzentil für Inferenzanfragen. Sie gibt Aufschluss darüber, wie lange die meisten Inferenzanfragen dauern, und hilft, Leistungseinbußen zu erkennen.
- Fehlerrate: Sie gibt den Prozentsatz der Anfragen an, die im ausgewählten Überwachungszeitraum fehlgeschlagen sind oder Fehler zurückgegeben haben. Durch die Überwachung der Fehlerrate können Teams Probleme mit Bereitstellungen oder eingehenden Anfragen schnell erkennen.
- Gesamtzahl der Anfragen: Diese Kennzahl zeigt die Gesamtzahl der Inferenzanfragen, die während des ausgewählten Zeitraums (beispielsweise der letzten 24 Stunden) über alle bereitgestellten Endpunkte verarbeitet wurden. Sie hilft Teams dabei, das Anfrageaufkommen und die Nutzungshäufigkeit ihrer Modelle zu verstehen.
Zusätzlich zu diesen Kennzahlen bietet die Plattform Zustandsprüfungen der Endpunkte und Bereitstellungsprotokolle. Zustandsprüfungen zeigen an, ob ein Endpunkt korrekt reagiert, während die Protokolle detaillierte Informationen zu kürzlich eingegangenen Anfragen und Systemaktivitäten enthalten.
Die wichtigsten Erkenntnisse#
Die Bereitstellung von Computer-Vision-Modellen ist ein entscheidender Schritt, um trainierte Modelle in Systeme zu verwandeln, die Anwendungen in der realen Welt antreiben. Mit der Ultralytics Platform können Teams Modelle ganz einfach über dedizierte Endpunkte in 42 Regionen weltweit bereitstellen, Echtzeit-Inferenz über APIs ausführen und die Leistung zentral überwachen. Durch flexible Bereitstellungsoptionen, integrierte Überwachung und skalierbare Infrastruktur hilft die Plattform Entwicklerinnen und Entwicklern, schneller von trainierten Machine-Learning-Modellen zu zuverlässigen Computer-Vision-Anwendungen zu gelangen.
Werde Teil unserer wachsenden Community! In unserem GitHub-Repository erfährst du mehr über KI. Wenn du Lösungen für Computer Vision entwickeln möchtest, sieh dir unsere Lizenzoptionen an. Entdecke die Vorteile von Computer Vision im Gesundheitswesen und erfahre, wie KI in der Logistik etwas bewirkt!
Comments
Ask a question, share your results, or help someone else.









