Computer-Vision-Modelle in 42 Regionen weltweit bereitstellen
Überführe trainierte Modelle mit wenigen Klicks von Tests im Browser zu produktiven Endpunkten – mit dedizierten Endpunkten, Überwachung der Bereitstellung und 22 Exportformaten.
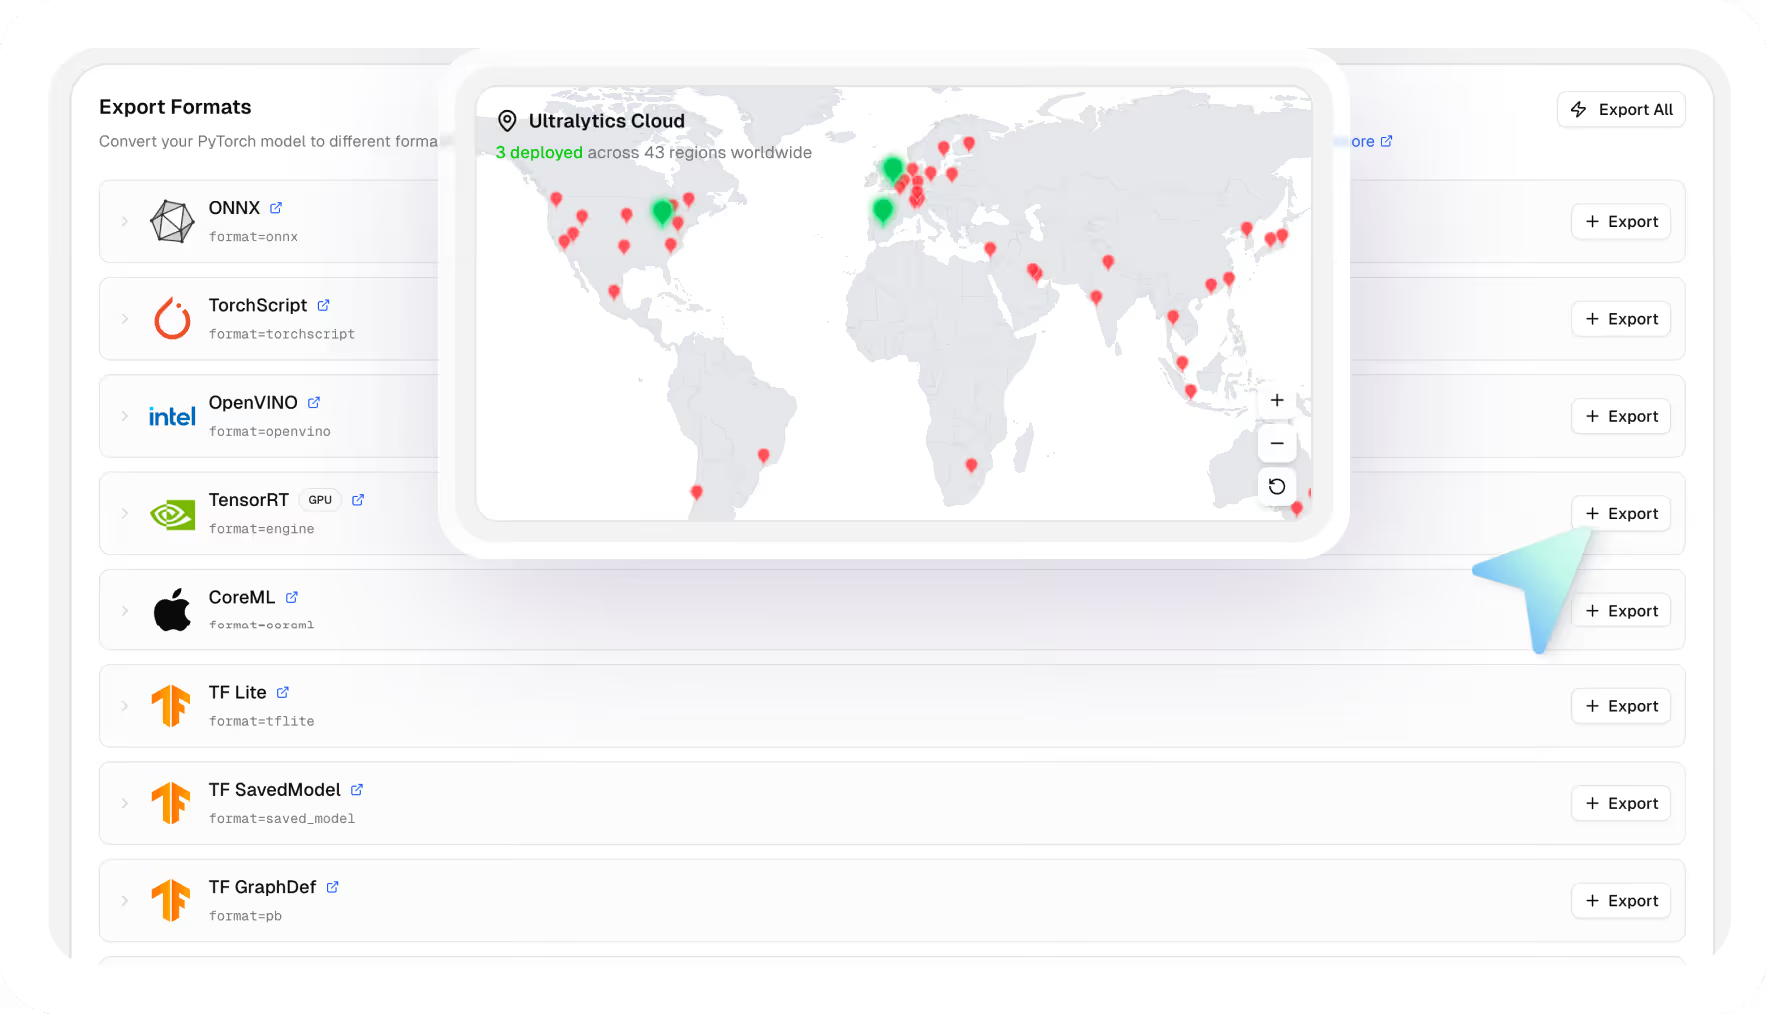
Weltweit im Produktionsmaßstab bereitstellen
Überführe trainierte Modelle in die Produktion – mit weltweiter Verfügbarkeit, umfassender Unterstützung für Exportformate und der durch das Ultralytics-Ökosystem bewährten Nutzungsmenge.
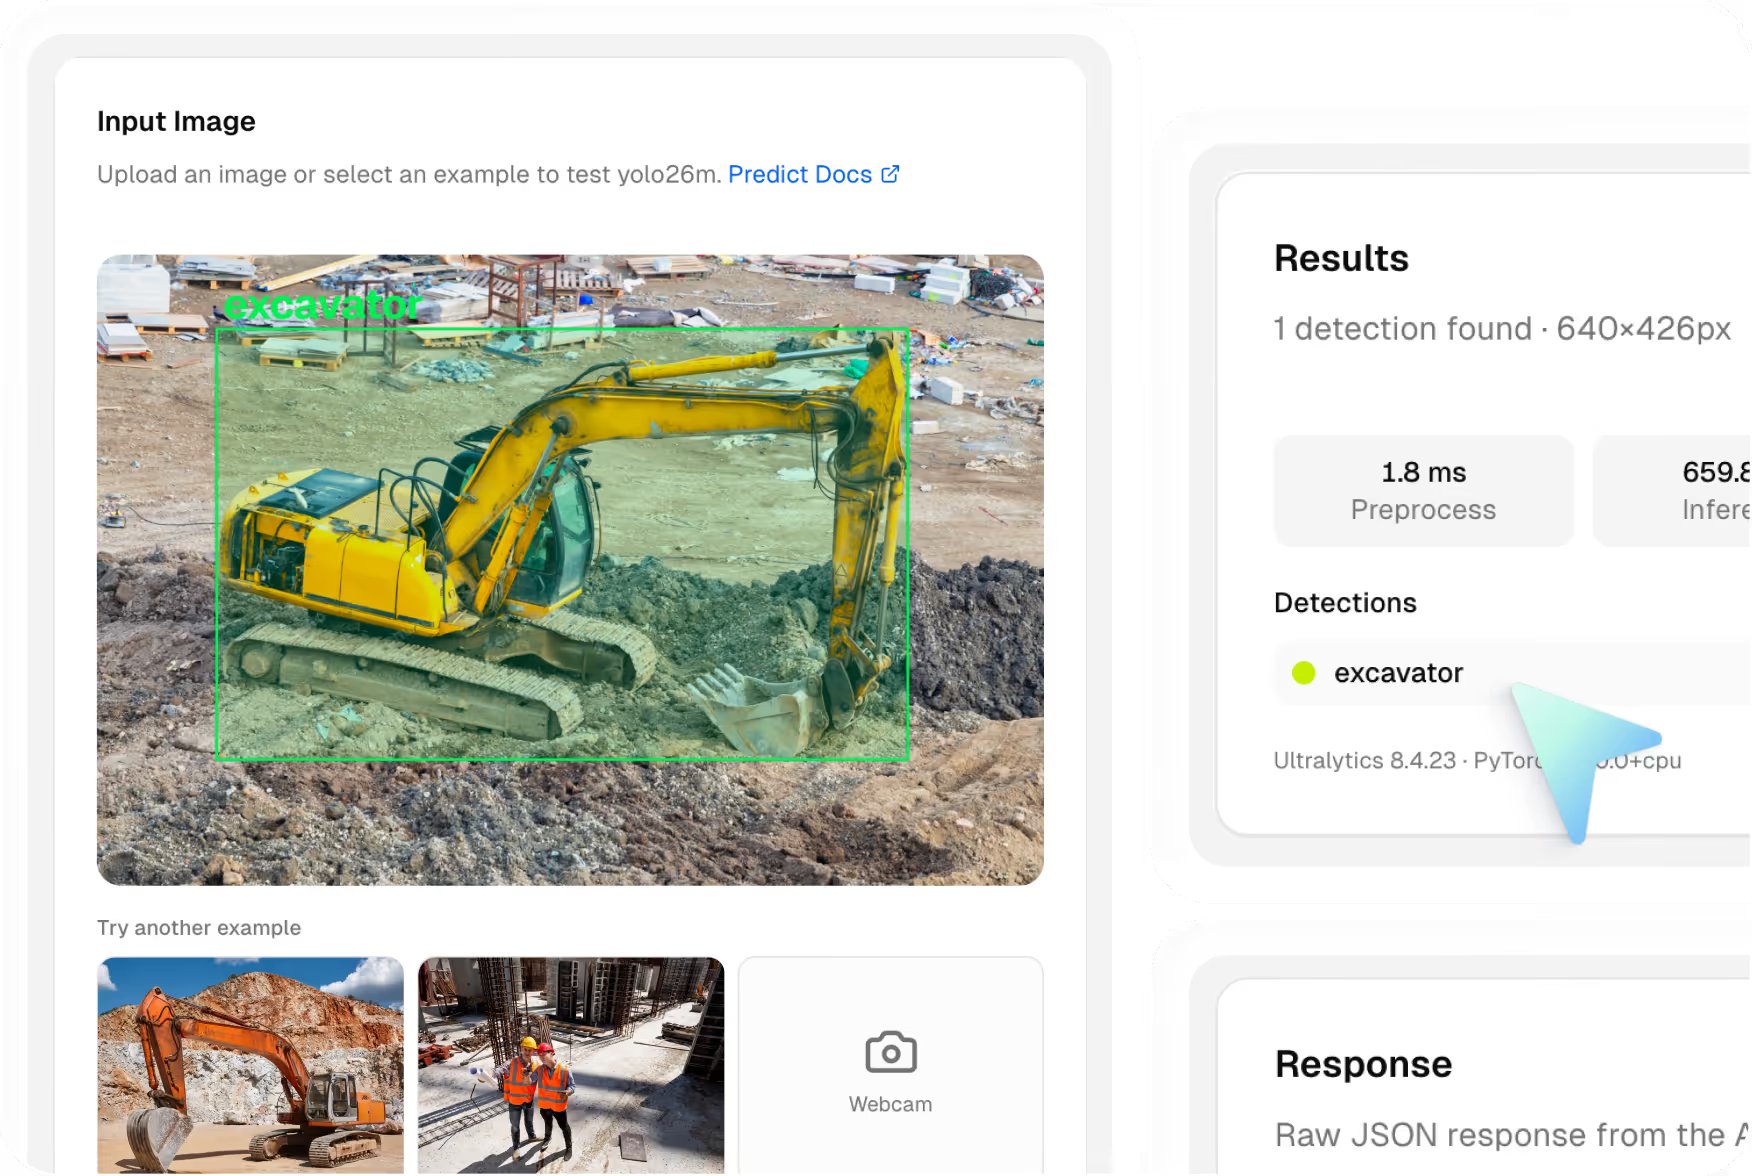
Teste dein Modell im Browser
Jedes trainierte Modell verfügt über eine integrierte Funktion auf der Registerkarte Predict. Lade ein Bild hoch oder öffne deine Kamera – die Begrenzungsrahmen erscheinen sofort.
In 42 Regionen weltweit bereitstellen
Stelle deine Modelle an dedizierten Endpunkten in Amerika, Europa, Asien-Pazifik und dem Nahen Osten bereit. Jeder Endpunkt hat eine eigene URL, konfigurierbare CPU- und Speicherressourcen sowie eine Überwachung von Anfragen, Latenz, Fehlern und Protokollen.
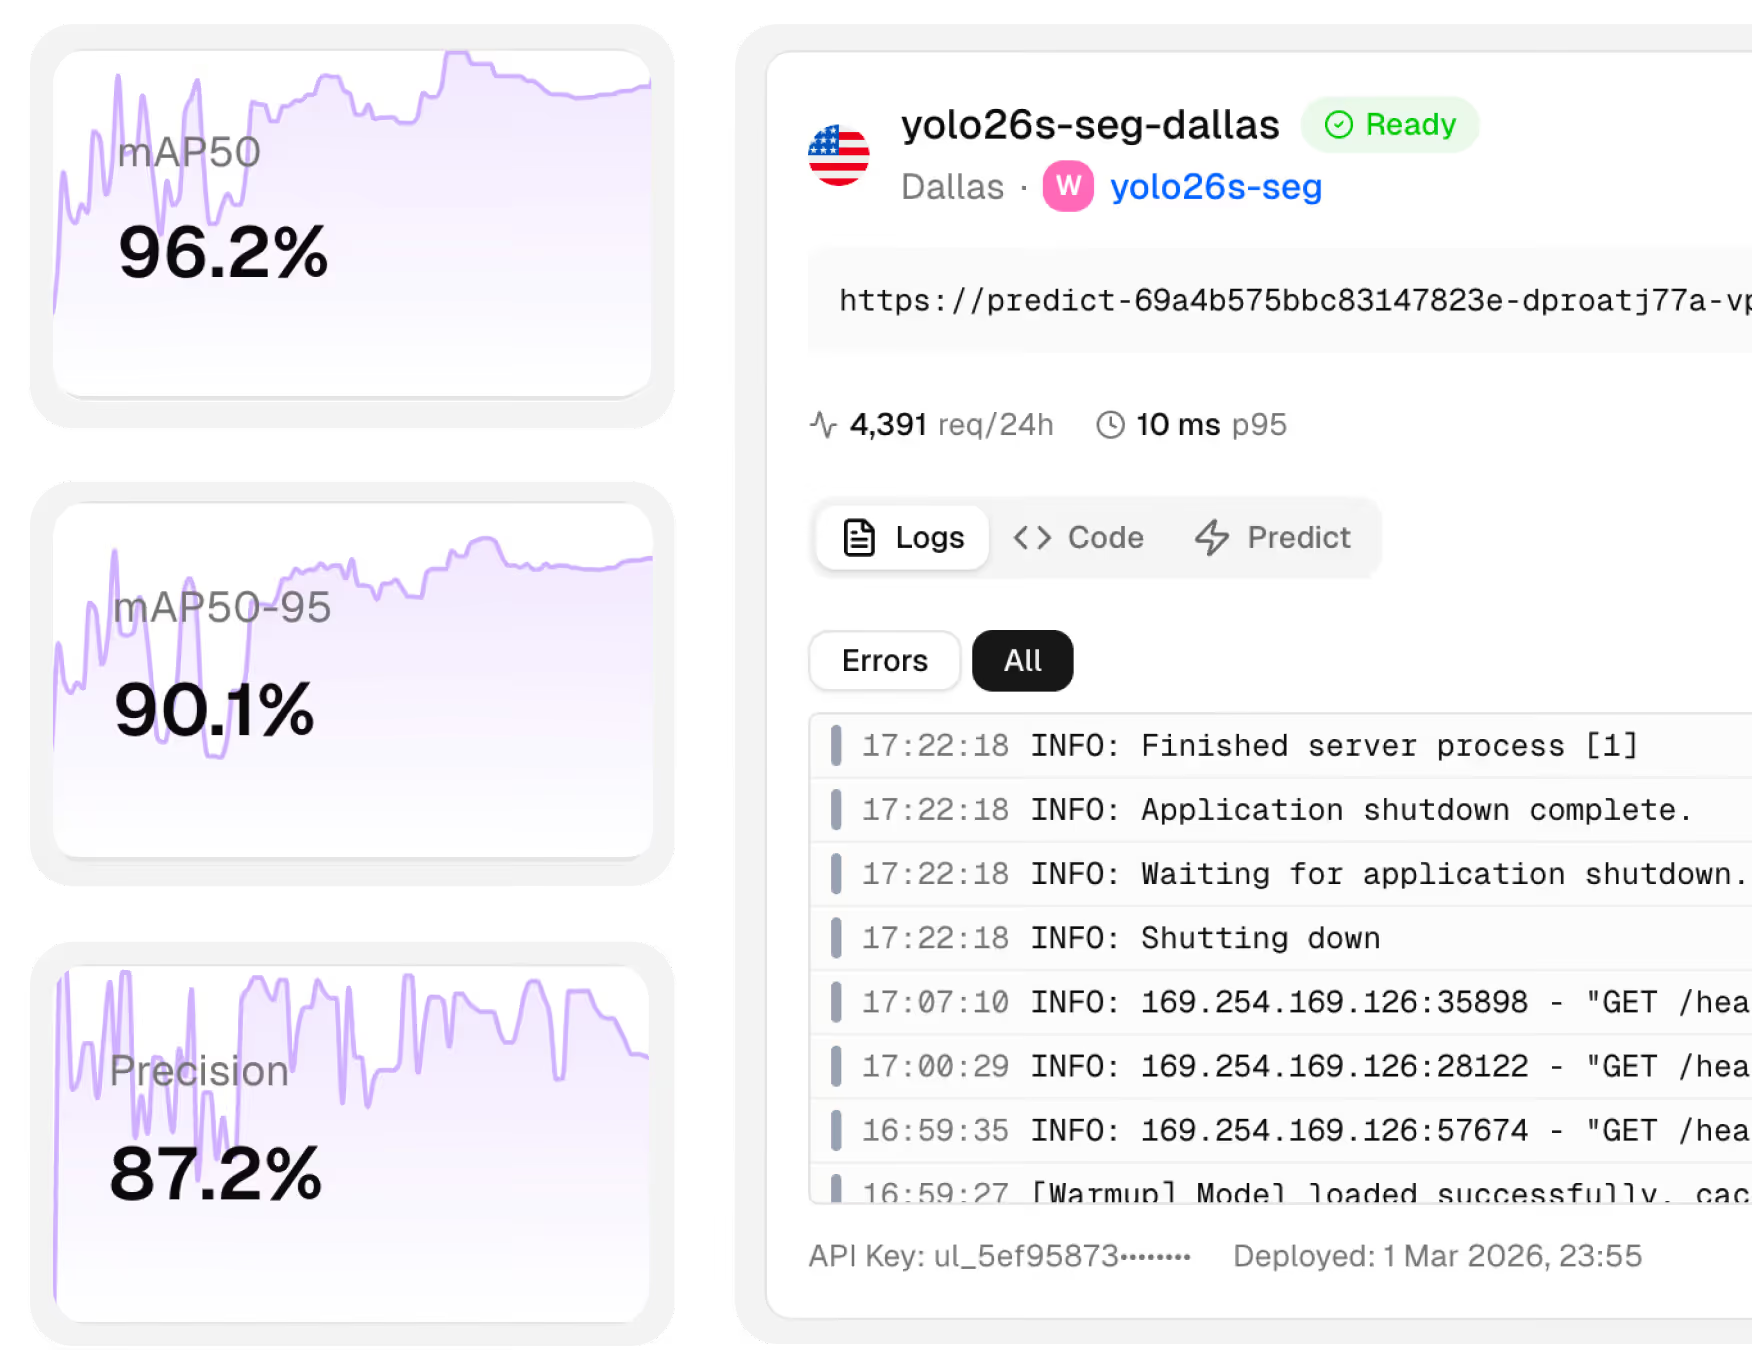
Endpunkte passend zu deiner Arbeitslast
Starte mit der enthaltenen Größe oder wähle die benötigte CPU- und Speicherkapazität für jeden Endpunkt.
- Standardmäßig auf null skalieren:Die enthaltene Größe skaliert im Leerlauf auf null und verursacht keine Kosten für die Betriebszeit.
- Kein Ratenlimit für die Platform API:Anfragen gehen direkt an deinen Endpunkt und nicht durch die Ratenbegrenzung der Platform API.
- Konfigurierbare Ressourcen:Wähle CPU (1–8 Kerne) und Arbeitsspeicher (2–32 GB) passend zu deiner Arbeitslast. Bei benutzerdefinierten Größen bleibt eine Instanz aktiv; die Betriebszeit wird berechnet.
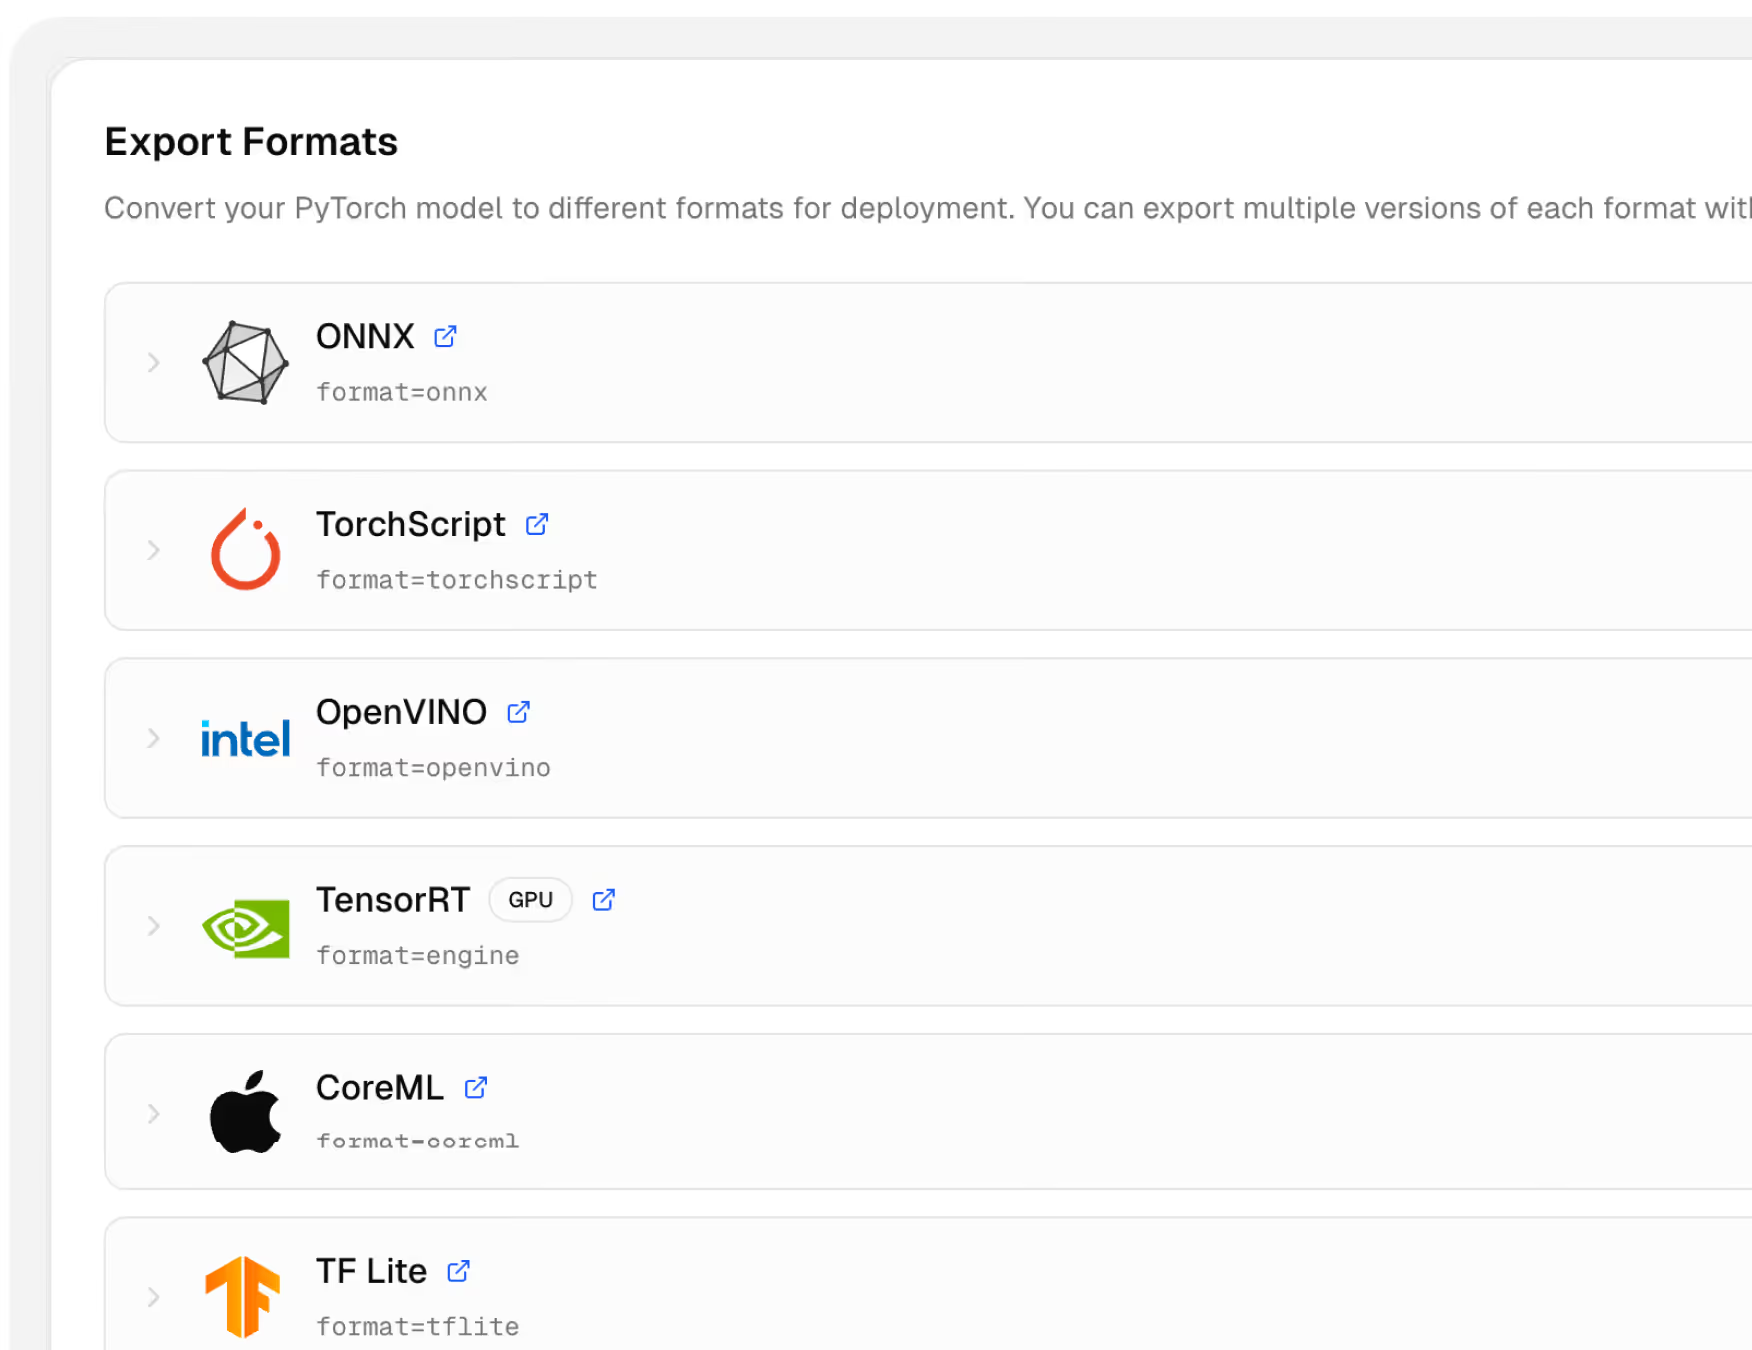
22 Exportformate. Dein Modell. Jede Umgebung.
Ultralytics Platform unterstützt die Bereitstellung in der Cloud und auf Edge-Geräten mit hoher Leistung. Alle Ultralytics-YOLO-Modelle sind nativ für den effizienten Einsatz in verschiedenen Umgebungen optimiert. Sie bieten hohe Genauigkeit, zuverlässige Leistung und Kompatibilität – auch auf Edge-Geräten mit begrenzten Rechenressourcen.
Alles in der Produktion überwachen
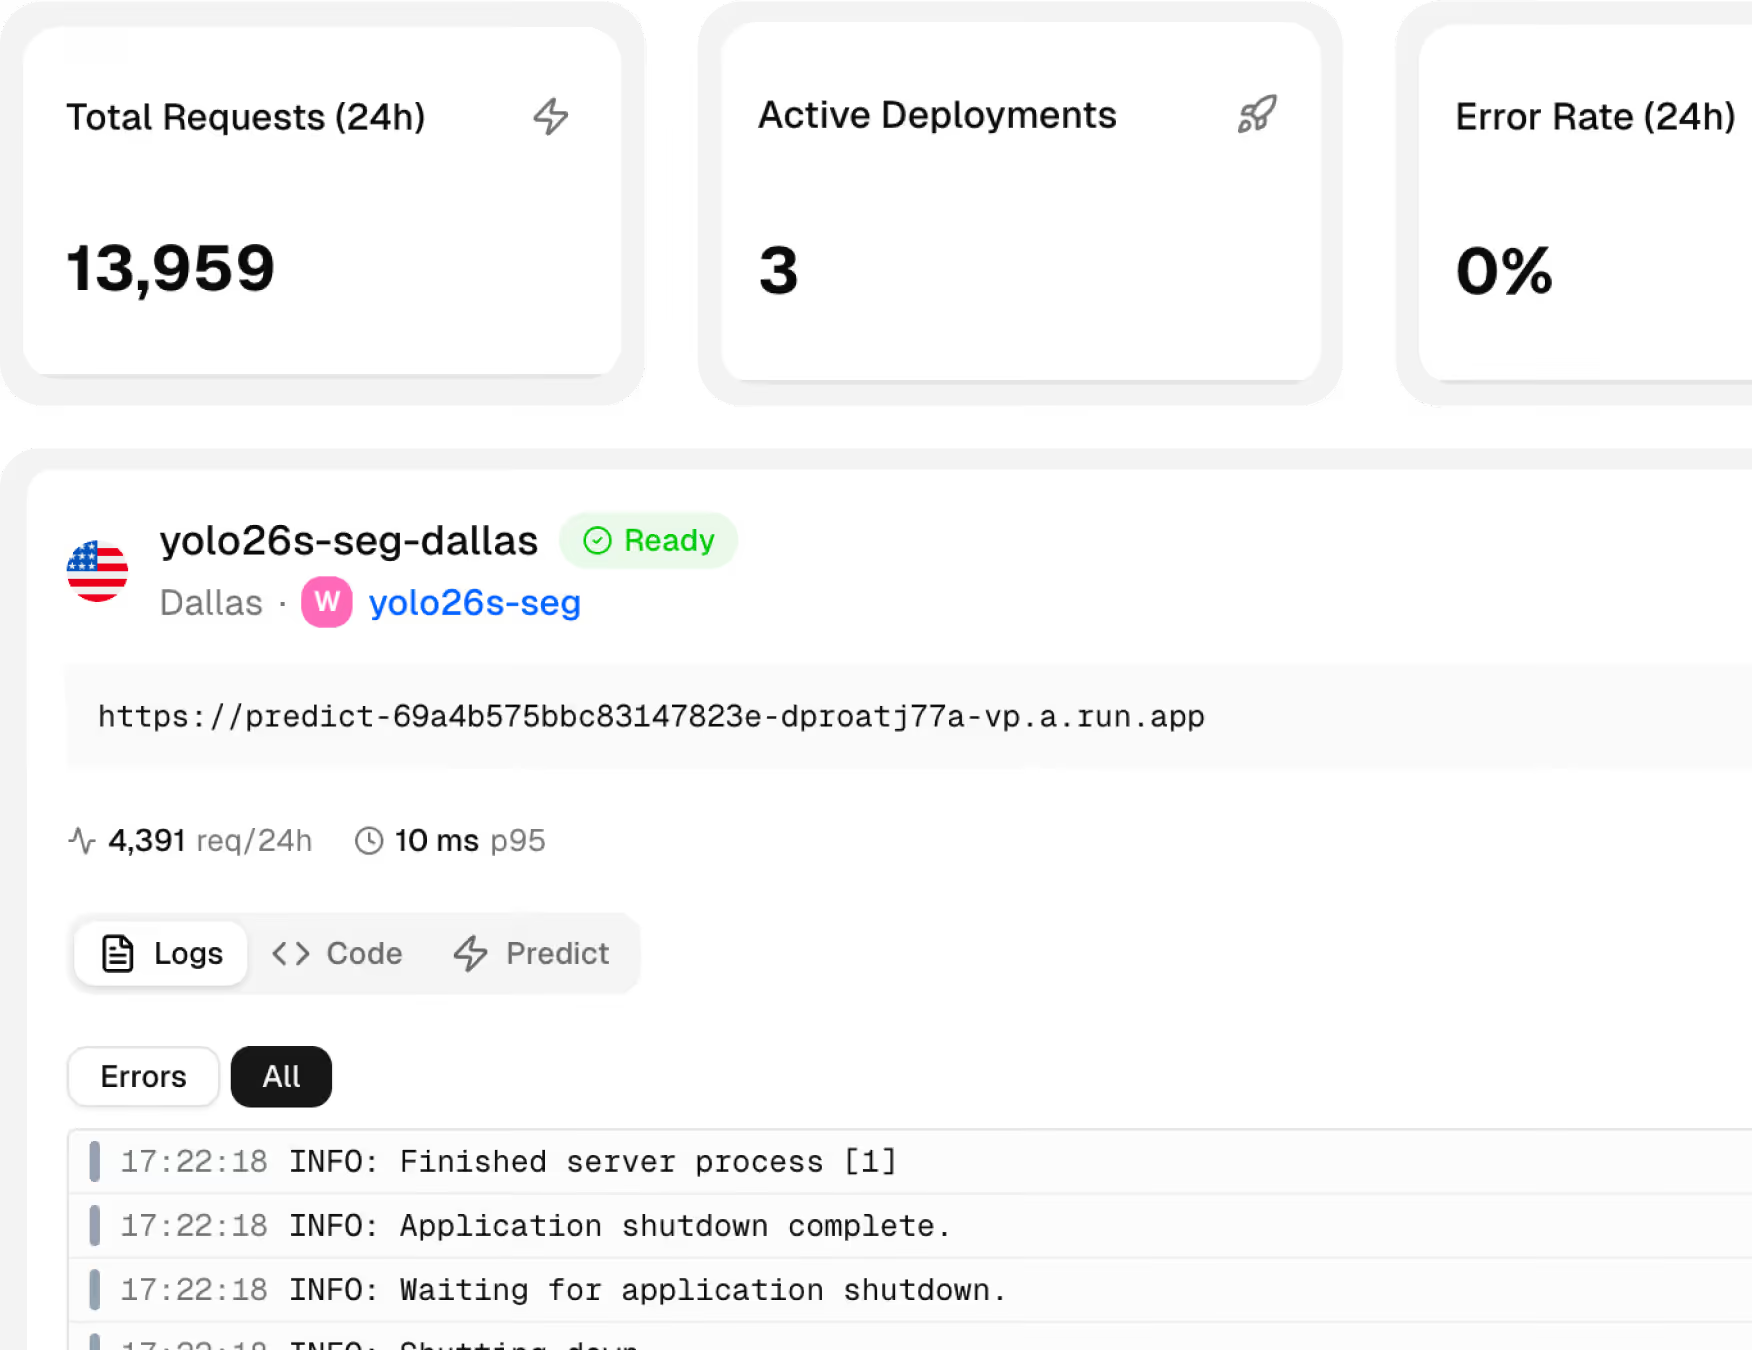
Verfolge Anfragen, Latenz, Fehler und Protokolle von Endpunkten im Dashboard für Bereitstellungen. Dedizierte Endpunkte bieten außerdem Live-Statistiken zu Vorhersagen und temporäre Beispiele, die du prüfen und in einem Datensatz speichern kannst.
- Anfragen, Latenz und Fehler:HTTP-Anfragevolumen der letzten 24 Stunden, volumen-gewichtete P95-Latenz und Warnmeldungen bei einer Fehlerquote über 5 %.
- Integritätsprüfungen und Protokolle:Live-Status des Endpunkts mit automatischen Wiederholungsversuchen sowie nach Schweregrad gefilterte Protokolle zur schnellen Fehlerdiagnose.
- Temporäre Beispiele:Prüfe Stichproben von Vorhersagen auf dedizierten Endpunkten. Die Beispiele werden im Arbeitsspeicher des Endpunkts gehalten. Speichere nützliche Bilder in einem Datensatz, damit sie erhalten bleiben.
- Vorhersagestatistiken:Klassenanzahlen, Konfidenz, Inferenzzeit und räumliche Heatmaps, sofern von der Modellaufgabe unterstützt. Die Statistiken werden zurückgesetzt, wenn die Serving-Instanz ersetzt wird.
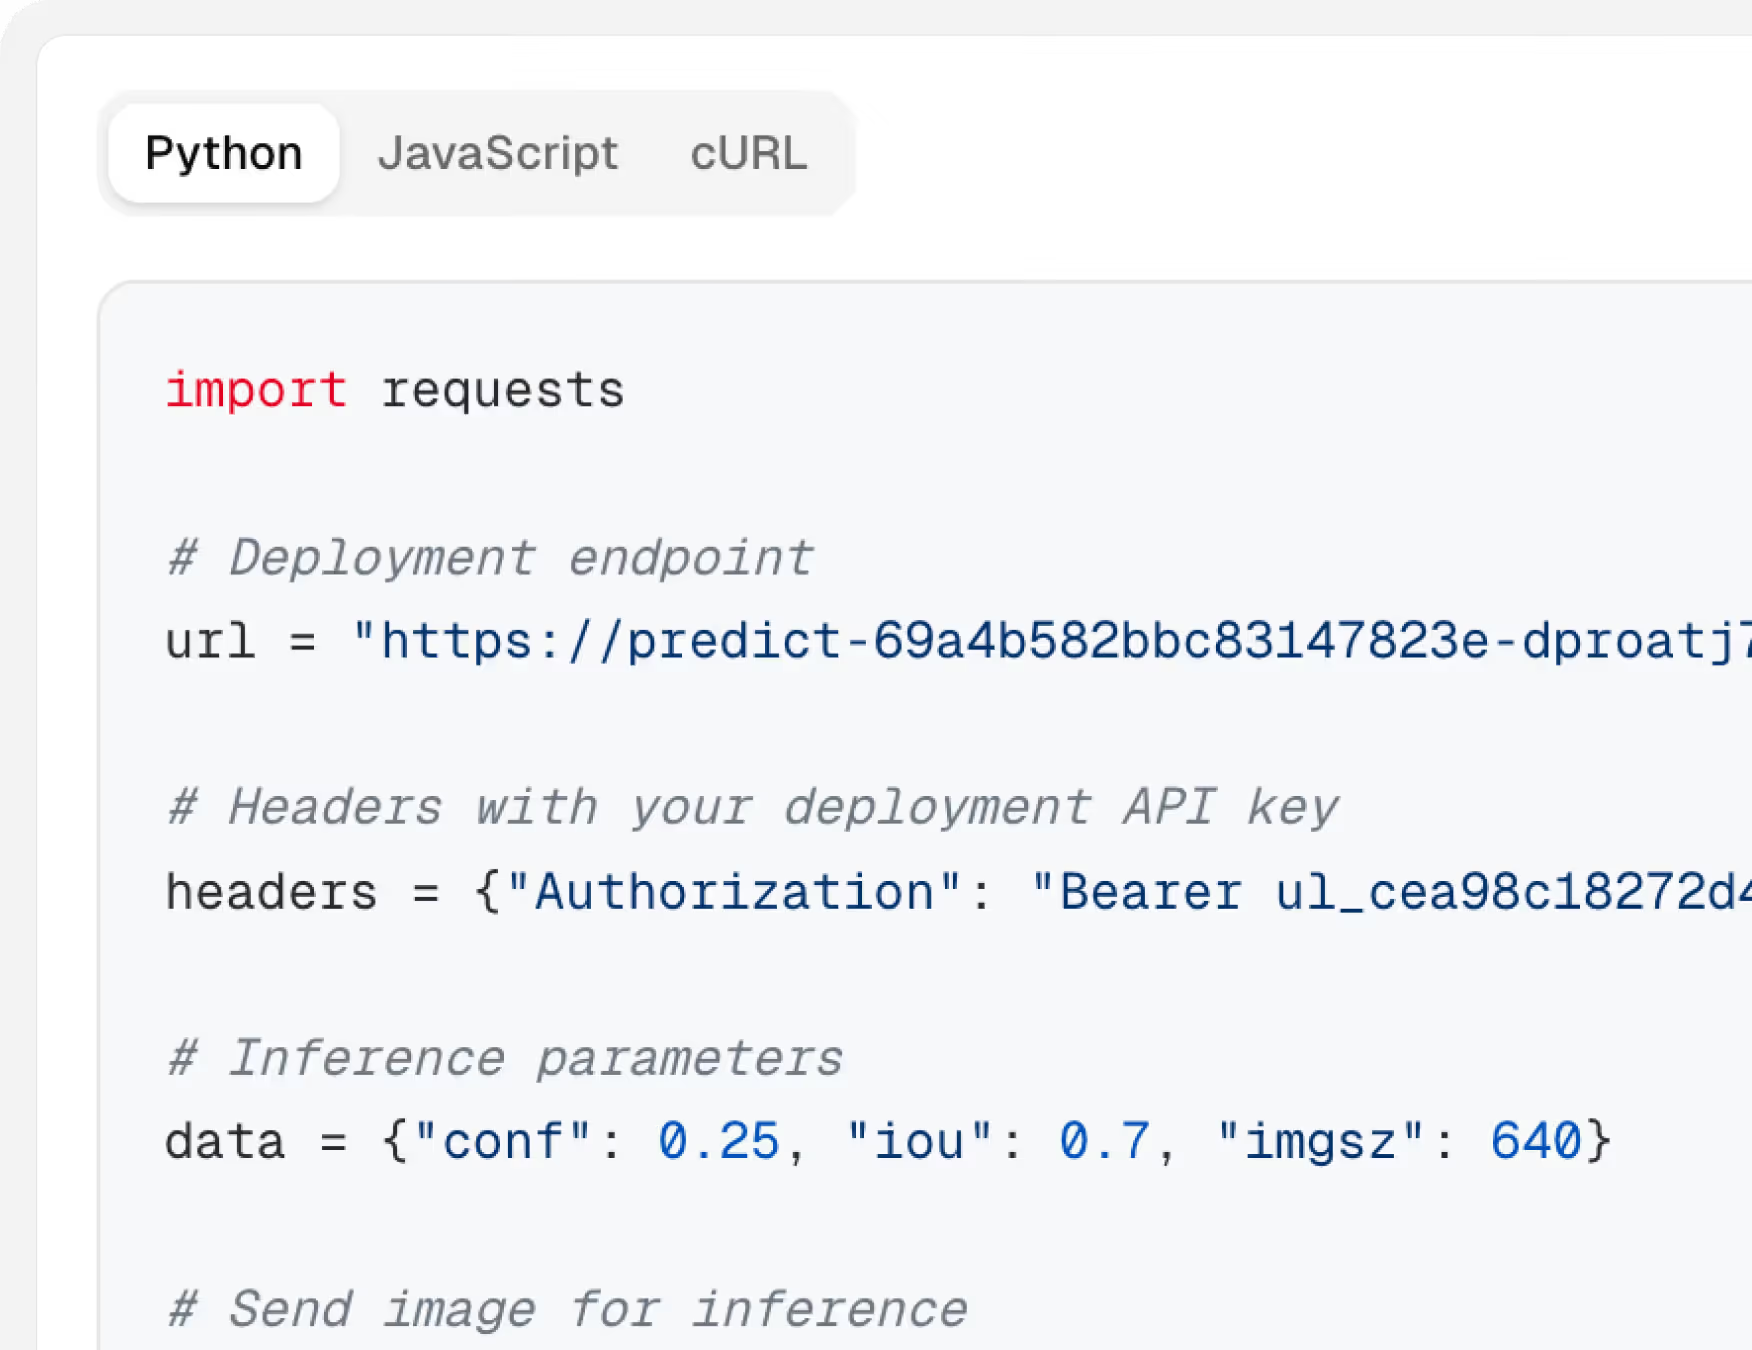
In wenigen Minuten integrieren
Jeder bereitgestellte Endpunkt enthält automatisch generierte Codebeispiele in Python, JavaScript und cURL, ausgefüllt mit deiner tatsächlichen Endpunkt-URL und deinem API-Schlüssel. Kopiere den Code, füge ihn ein und sende Inferenzanfragen aus jeder Anwendung.
Probiere die Inferenz mit YOLO26 aus
Ziehe ein Bild hierher, um die Objekterkennung in Echtzeit zu sehen
Erfahre, wie du Modelle bereitstellst!
Sieh dir an, wie du ein trainiertes Modell testest, es an einem globalen Endpunkt bereitstellst und Anfragen, Latenz und Live-Vorhersagen überwachst.
Das sagen unsere Kunden
Die Ultralytics Platform hat für uns alles verändert. Unsere Data Scientists können damit ganz einfach Datensätze erstellen, mithilfe von Cloud-Rechenleistung schnell neue Modelle trainieren, Experimente mit verschiedenen Modelleinstellungen vergleichen und schließlich das beste Modell für jedes Problem ermitteln. Für Experimente mit Objekterkennung, Instanzsegmentierung und semantischer Segmentierung ist sie inzwischen unsere erste Anlaufstelle.
Tyler Biesel, Manager für Softwareentwicklung
Mit den Ultralytics YOLO-Modellen konnten wir die Implementierungsgeschwindigkeit unseres KI-Dienstes um 25,2 % steigern. Sie lassen sich einfach bereitstellen und bieten in der Praxis eine hervorragende Leistung. So ermöglichen sie mehr Geschwindigkeit, Genauigkeit und Skalierbarkeit, ohne die betriebliche Leistung zu beeinträchtigen.
Ultralytics YOLO26 läuft nahtlos auf der Plattform von Axelera und ermöglicht eine schnellere Bereitstellung von Edge-KI bei minimalem Integrationsaufwand. Genau diese Zusammenarbeit zwischen Hardware und Software hilft Kunden, schneller von der Entwicklung zur Produktion überzugehen.
Alexis Crowell, Globaler CMO & Geschäftsführer für Nord- und Südamerika
Mit Ultralytics YOLOv8 nano können wir direkt am Edge-Modell nachtrainieren und innerhalb von Stunden statt Wochen ein neues Modell bereitstellen, wobei nur ein Bruchteil der Daten übertragen wird. Diese Kombination aus Genauigkeit und geringem Ressourcenbedarf ist genau das, was unsere Umgebungen brauchen.
Mit Ultralytics konnten wir im Vergleich zu anderen Modellen die Geschwindigkeit steigern und zugleich eine höhere Genauigkeit erzielen. Die Kompatibilität mit verschiedenen Frameworks – CUDA, TensorRT, ONNX und OpenVINO – war äußerst hilfreich, um die Gewichte in Forschung und Entwicklung abzustimmen und anschließend für die jeweils verfügbare Hardware zu optimieren.
Die Leistung der Ultralytics YOLO-Modelle auf unseren STM32-Mikrocontrollern eröffnet neue Möglichkeiten für Computer Vision am Edge. Dank der schlanken Integration und der Unterstützung mehrerer Modellvarianten haben Entwickler alles, was sie zum Aufbau skalierbarer und reaktionsschneller eingebetteter Bildverarbeitungslösungen benötigen.

Sie verwandeln visuelle Daten mit außergewöhnlicher Genauigkeit und Effizienz in umsetzbare Erkenntnisse. Durch die Kombination von Ultralytics YOLOv8 mit dem IMX500-Sensor von SSS (Sony Semiconductor Solutions Corporation) ermöglicht diese Partnerschaft leistungsstarke KI direkt auf dem Gerät. Dadurch können Unternehmen, die auf die Verarbeitung leistungsstarker visueller Daten angewiesen sind, fundiertere Entscheidungen in Echtzeit treffen.
Wei Tang, Manager für Geschäftsentwicklung
Die YOLO-Modelle von Ultralytics sind wegweisend für die KI-Branche. Entwickler bevorzugen YOLOv5 und YOLOv8, weil sie einfach zu verwenden sind und eine Leistung auf dem neuesten Stand der Technik sowie hohe Genauigkeit bieten. In Kombination mit OpenVINO können diese Modelle auf modernen CPUs direkt nach der Installation eine hervorragende Leistung erzielen.
Musst du zuerst ein Modell trainieren?
Ultralytics Platform vereint Annotation, Training und Bereitstellung auf einer Plattform.
Branchenlösungen entdecken
Erfahre, wie Teams Computer Vision von Ultralytics in Produktionsumgebungen einsetzen.

Computer Vision im Sport

Computer Vision für Luftbilder

Computer Vision in der Luft- und Raumfahrt

Computer Vision im Sicherheitsbereich

Computer Vision in der Robotik

Bildverarbeitung in der Logistik

Bildverarbeitung im Einzelhandel

Bildverarbeitung im Gesundheitswesen

Computer Vision in der Fertigung

Computer Vision in der Automobilbranche

Computer Vision in der Landwirtschaft
Sicherheit und Compliance für Unternehmen
Entwickle und stelle mit Zuversicht bereit. Nach ISO 27001 zertifiziert, nach SOC 2 testiert und mit Unterstützung bei der HIPAA-Konformität.
SOC 2 Type I
ISO 27001:2022
HIPAA
DSGVO und CCPA
Häufig gestellte Fragen
Ja. Du kannst ein Modell in so vielen der 42 Regionen bereitstellen, wie dein Tarif zulässt: 3 Endpunkte im Free-Tarif, 10 im Pro-Tarif und unbegrenzt viele im Enterprise-Tarif, jeweils über deinen Workspace hinweg gezählt. Eine Bereitstellung näher bei deinen Nutzern kann die Latenz verringern.
Die Standardgröße eines Endpunkts (1 vCPU, 2 GiB) ist auch beim Verarbeiten von Anfragen kostenlos und wird bei Inaktivität auf null skaliert. Benutzerdefinierte Größen bis zu 8 vCPU und 32 GiB halten eine Instanz dauerhaft bereit. Die Kosten werden den Credits für die Betriebszeit einschließlich Leerlaufzeit belastet und richten sich nach Größe und Region. Gemeinsame Inferenz ist in jedem Tarif enthalten.
Gemeinsame Inferenz läuft auf einem mandantenfähigen Dienst in 3 Regionen und ist auf 20 Anfragen pro Minute und API-Schlüssel oder Aufrufer begrenzt. Das eignet sich für Tests. Ein dedizierter Endpunkt ist ein Dienst für einen einzelnen Mandanten in einer der 42 Regionen mit eigener URL und eigenem API-Schlüssel. Direkt dorthin gesendete Anfragen unterliegen dieser Begrenzung nicht. Jeder Endpunkt führt jedoch nur eine Instanz aus und kann Anfragen ablehnen, wenn sie zu stark ausgelastet ist. Führe daher vor dem Produktionseinsatz einen Lasttest durch.
Ein neuer Endpunkt ist in der Regel innerhalb weniger Minuten bereit; die Dauer hängt vom Modell und der Region ab. Endpunkte in Standardgröße werden bei Inaktivität auf null skaliert. Daher kann die erste Anfrage nach einer längeren Ruhephase bis zu etwa eine Minute dauern, während der Endpunkt startet.
Durch die Modellbereitstellung kann ein trainiertes Modell Vorhersagen zu neuen Daten treffen, zum Beispiel zu Bildern oder Videobildern, die eine Anwendung sendet. Auf der Ultralytics Platform kannst du ein Modell im Browser testen, es in einer der 42 Regionen auf einem dedizierten Endpunkt bereitstellen, es aus deiner Anwendung aufrufen und überwachen – alles im selben Workspace.
Sende Bilder oder unterstützte Videodateien an die REST API deines Endpoints; Tiefenmodelle akzeptieren nur Bilder. Auf jeder Bereitstellungsseite findest du Beispiele für Python, JavaScript und cURL. Workspace-Besitzer können einen Endpoint auch über den Tab „Vorhersage“ mit einer Webcam oder einer über das Internet erreichbaren RTSP-Kamera ausführen (Adressen im lokalen Netzwerk werden nicht unterstützt). Endpoints mit benutzerdefinierter Größe können außerdem im Hintergrund eine IP-Kamera dauerhaft überwachen.
Ja. Exportiere dein Modell für deine Zielhardware und führe es auf deinen eigenen Servern oder Edge-Geräten aus, auch offline. Zu den Formaten gehören TensorRT für NVIDIA Jetson, OpenVINO, CoreML, LiteRT, NCNN, RKNN, Hailo und Qualcomm. Welche Formate verfügbar sind, hängt vom Modell und der Aufgabe ab. Für die Nutzung in proprietären Produkten ohne Verpflichtungen aus der AGPL-3.0 benötigst du eine Ultralytics Enterprise-Lizenz.
Beginne noch heute mit der Bereitstellung!
Bringe deine trainierten Modelle in 42 Regionen weltweit in den Produktiveinsatz – mit dedizierten Endpoints und Deployment-Überwachung.