Promptgesteuerte Konzeptsegmentierung verstehen
Entdecke die promptgesteuerte Konzeptsegmentierung, ihre Unterschiede zu herkömmlichen Methoden und wie verwandte Modelle wie YOLOE-26 Funktionen mit offenem Vokabular ermöglichen.
 Abirami Vina13 Min. Lesezeit
Computer-Vision-KI entwickelt sich rasant weiter und wird häufig eingesetzt, um Bilder und Videos in realen Umgebungen zu analysieren. So werden beispielsweise Anwendungen von Verkehrsmanagementsystemen bis hin zu Analysen im Einzelhandel mit Computer-Vision-Modellen integriert.
In vielen dieser Anwendungen werden Bildverarbeitungsmodelle, etwa Objekterkennungsmodelle, darauf trainiert, eine festgelegte Auswahl von Objekten zu erkennen, darunter Fahrzeuge, Menschen und Ausrüstung. Während des Trainings erhalten die Modelle viele beschriftete Beispiele. So lernen sie, wie die einzelnen Objekte aussehen und wie sie sich von anderen Objekten in einer Szene unterscheiden.
Bei Segmentierungsaufgaben gehen Modelle noch einen Schritt weiter und erzeugen präzise Umrisse dieser Objekte auf Pixelebene. So können Systeme genau erkennen, wo sich jedes Objekt in einem Bild befindet.
Das funktioniert gut, solange das System nur erkennen muss, worauf es trainiert wurde. In realen Umgebungen ist das jedoch selten der Fall.
Visuelle Szenen verändern sich typischerweise ständig. Neue Objekte und visuelle Konzepte tauchen auf, die Bedingungen ändern sich, und Nutzende möchten oft Objekte segmentieren, die nicht Teil der ursprünglichen Trainingskonfiguration waren.
Diese Einschränkungen zeigen sich besonders deutlich bei der Segmentierung. Mit der Weiterentwicklung von Computer-Vision-KI wächst der Bedarf an flexibleren Segmentierungsmodellen, die sich ohne wiederholtes Training an neue Konzepte anpassen können. Deshalb gewinnt die promptgesteuerte Konzeptsegmentierung (PCS) zunehmend an Bedeutung.
Statt sich auf eine feste Liste von Objektkategorien zu stützen, können Nutzende mithilfe von Text, visuellen Prompts oder Beispielbildern beschreiben, was segmentiert werden soll. Anschließend können diese Modelle alle Bereiche erkennen und segmentieren, die dem beschriebenen Konzept entsprechen – auch wenn das Konzept beim Training nicht ausdrücklich enthalten war.
In diesem Artikel sehen wir uns an, wie promptgesteuerte Konzeptsegmentierung funktioniert, worin sie sich von herkömmlichen Ansätzen unterscheidet und wo sie heute eingesetzt wird.
Was ist promptgesteuerte Konzeptsegmentierung?#
In den meisten Fällen werden Segmentierungsmodelle darauf trainiert, eine kleine Auswahl von Objekttypen zu erkennen. Das funktioniert gut, wenn ein Computer-Vision-KI-System nur eine bestimmte Auswahl von Objekten erkennen und segmentieren muss.
In realen Anwendungen sind visuelle Szenen jedoch dynamisch. Neue Objekte tauchen auf, Anforderungen ändern sich und Nutzende müssen oft Konzepte segmentieren, die nicht in der ursprünglichen Liste beschrifteter Klassen enthalten waren. Um solche Fälle zu unterstützen, müssen in der Regel neue hochwertige Daten und Annotationen gesammelt und das Modell erneut trainiert werden. Das erhöht die Kosten und verzögert die Bereitstellung.
Die promptgesteuerte Konzeptsegmentierung löst dieses Problem, indem Nutzende dem Modell mitteilen können, wonach es suchen soll, statt aus einer festen Liste von Beschriftungen auszuwählen. Nutzende beschreiben das gesuchte Objekt oder Konzept, und das Modell hebt alle passenden Bereiche im Bild hervor. Dadurch lässt sich die Absicht der Nutzenden viel einfacher den tatsächlichen Bildpunkten zuordnen.
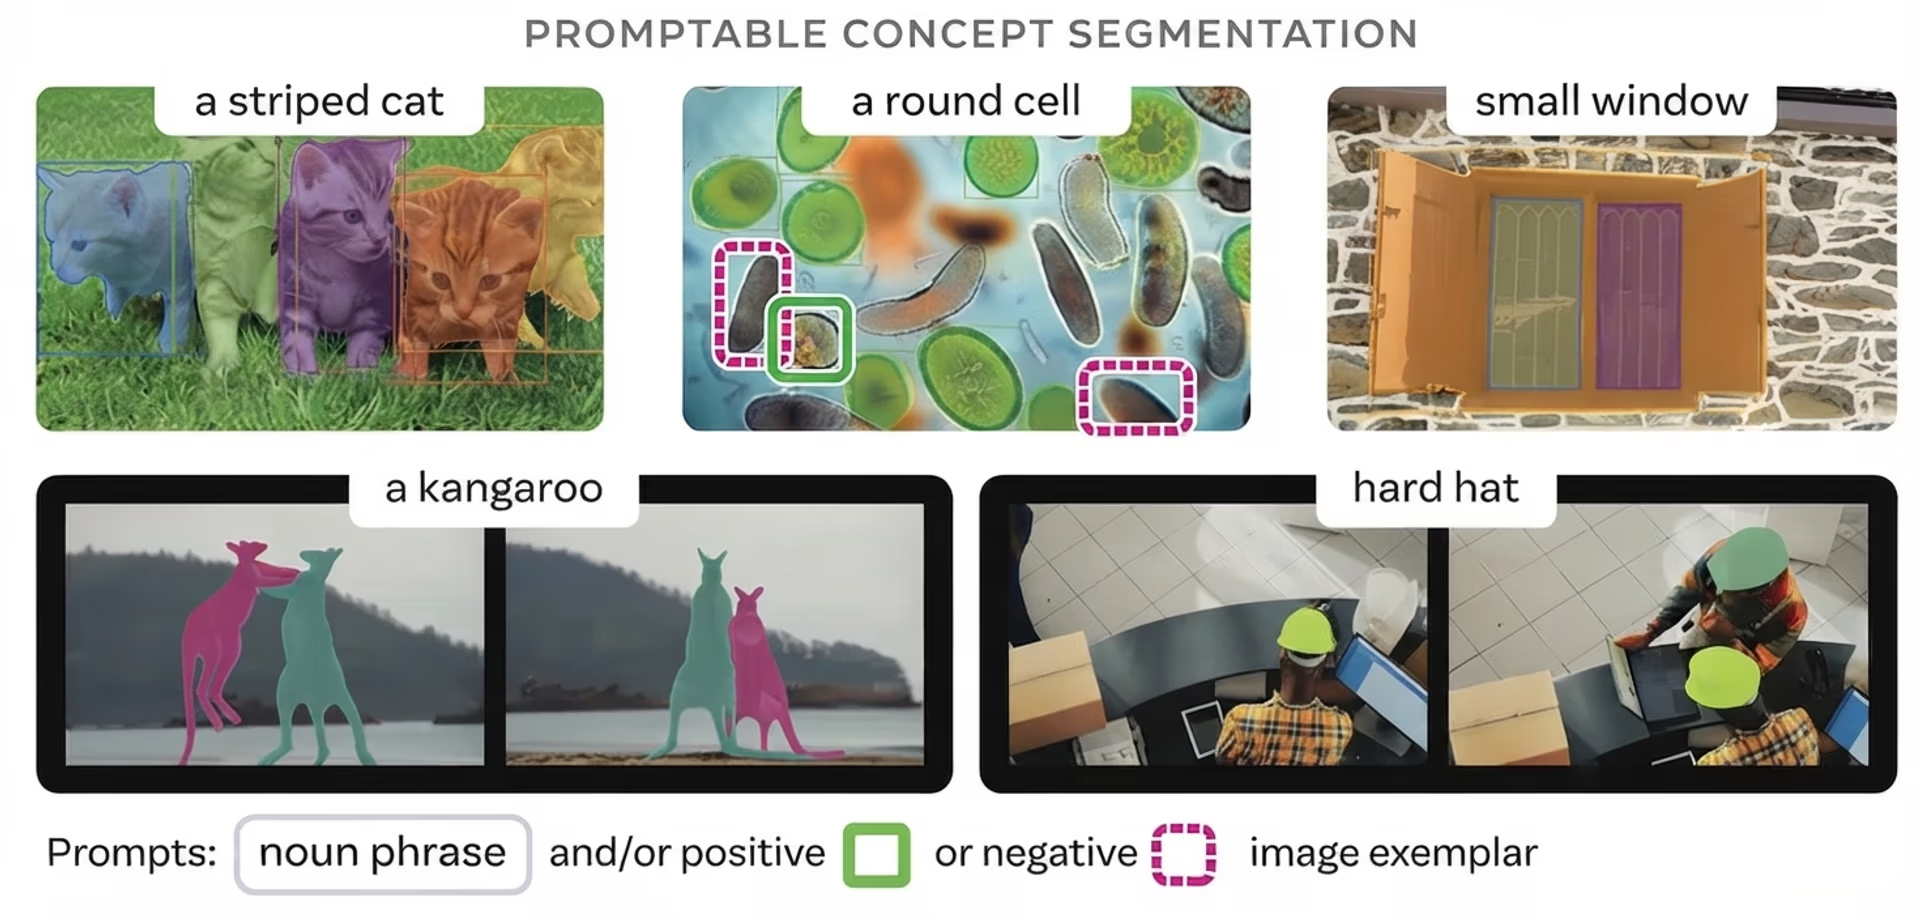
Abb. 1: Segmentierung mithilfe von Konzept-Prompts (Quelle)
Segmentierung mit verschiedenen Arten von Prompts steuern#
Modelle, die promptgesteuerte Konzeptsegmentierung unterstützen, sind flexibel, weil sie verschiedene Arten von Eingaben verarbeiten können. Es gibt also mehrere Möglichkeiten, dem Modell mitzuteilen, wonach es suchen soll, etwa durch Textbeschreibungen, visuelle Hinweise oder Beispielbilder.
Hier siehst du die einzelnen Ansätze genauer:
- Text-Prompts: Kurze Ausdrücke wie „Schulbus“ oder „Tumorbereich“ können das zu segmentierende Konzept beschreiben. Das Modell interpretiert die Bedeutung der Wörter und erkennt passende Bereiche.
- Visuelle Prompts: Diese Prompts verwenden Punkte, Boxen oder grobe Skizzen im Bild als Hinweise. Sie zeigen, wo das Modell suchen soll, und helfen dabei, die endgültige Begrenzung festzulegen.
- Referenzbilder: Referenzbilder oder kleine Bildausschnitte stellen das gewünschte Konzept dar. Das Modell sucht nach visuell ähnlichen Bereichen und segmentiert sie anhand ihres Aussehens.
Der Unterschied zwischen PCS und herkömmlicher Segmentierung#
Bevor wir uns genauer mit der promptgesteuerten Konzeptsegmentierung befassen, vergleichen wir sie zunächst mit verschiedenen herkömmlichen Methoden der Objektsegmentierung.
PCS ermöglicht Modelle mit offenem Vokabular, die sich durch Prompts steuern lassen. Sie können mit neuen Konzepten arbeiten, die durch Prompts beschrieben werden – herkömmliche Segmentierung dagegen nicht. Es gibt mehrere Arten herkömmlicher Segmentierungsansätze, die jeweils auf eigenen Annahmen beruhen und eigene Einschränkungen haben.
Hier ist ein kurzer Überblick über einige wichtige Arten der herkömmlichen Segmentierung:
- Semantische Segmentierung: Jeder Bildpunkt wird als Teil einer Kategorie wie Straße, Gebäude oder Person gekennzeichnet. Alle Bildpunkte mit derselben Kennzeichnung werden zusammengefasst, sodass das Modell einzelne Objektinstanzen nicht voneinander trennt.
- Instanzsegmentierung: Das Modell erkennt und segmentiert einzelne Objekte. Zwei Personen oder zwei Autos werden daher als separate Objekte behandelt.
- Panoptische Segmentierung: Diese Technik kombiniert semantische Segmentierung und Instanzsegmentierung, um ein vollständiges Bild der Szene zu liefern, das sowohl Hintergrundbereiche als auch einzelne Objekte umfasst.
Alle diese Ansätze stützen sich auf eine vordefinierte Liste von Objektkategorien. Innerhalb dieses Rahmens funktionieren sie gut, aber mit Konzepten außerhalb davon kommen sie nicht gut zurecht. Wenn ein bestimmtes neues Objekt segmentiert werden soll, sind in der Regel zusätzliche Trainingsdaten und eine Feinabstimmung des Modells erforderlich.
PCS soll das ändern. Statt auf vordefinierte Kategorien beschränkt zu sein, kannst du zur Inferenzzeit beschreiben, was in einem Bild segmentiert werden soll.
Die Entwicklung von PCS-Modellen#
Sehen wir uns nun an, wie sich Segmentierungsmodelle hin zur promptgesteuerten Konzeptsegmentierung entwickelt haben.
Ein beliebtes Basismodell, das einen Wandel in der Segmentierung einleitete, war SAM, das Segment Anything Model. Es wurde 2023 vorgestellt. Statt sich auf vordefinierte Objektkategorien zu stützen, konnten Nutzende mit SAM die Segmentierung durch einfache visuelle Prompts wie Punkte oder Begrenzungsrahmen steuern.
Mit SAM mussten Nutzende keine Beschriftung mehr auswählen. Sie konnten einfach angeben, wo sich ein Objekt befand, und das Modell erzeugte dafür eine Maske. Dadurch wurde die Segmentierung flexibler, doch Nutzende mussten dem Modell weiterhin zeigen, wo es suchen sollte.
SAM 2, das 2024 veröffentlicht wurde, baute auf dieser Idee auf: Es konnte komplexere Szenen verarbeiten und erweiterte die promptgesteuerte Segmentierung auf Videos. Die Robustheit bei unterschiedlichen Lichtverhältnissen, Objektformen und Bewegungen wurde verbessert. Die Segmentierung wurde jedoch weiterhin hauptsächlich durch visuelle Prompts gesteuert.
Das Modell SAM 3 ist der jüngste Schritt in dieser Entwicklung. Es wurde im vergangenen Jahr veröffentlicht und vereint als einheitliches Modell visuelles Verständnis mit sprachlicher Steuerung. So ermöglicht es ein konsistentes Verhalten bei Segmentierungsaufgaben mit Bildern und Videos.
Mit SAM 3 sind Nutzer nicht auf Punkt- oder Zeichenwerkzeuge als Vorgabe beschränkt. Stattdessen können sie mit Text beschreiben, was sie segmentieren möchten. Das Modell durchsucht dann das Bild oder die Videobilder nach Bereichen, die dieser Beschreibung entsprechen.
Die Segmentierung orientiert sich an Konzepten statt an festen Objektkategorien und ermöglicht so den Einsatz eines offenen Vokabulars in unterschiedlichen Szenen und im Zeitverlauf. SAM 3 arbeitet mit einem großen, erlernten Konzeptbereich, der in einer Ontologie verankert ist, die aus Quellen wie Wikidata abgeleitet und mithilfe umfangreicher Trainingsdaten erweitert wurde.
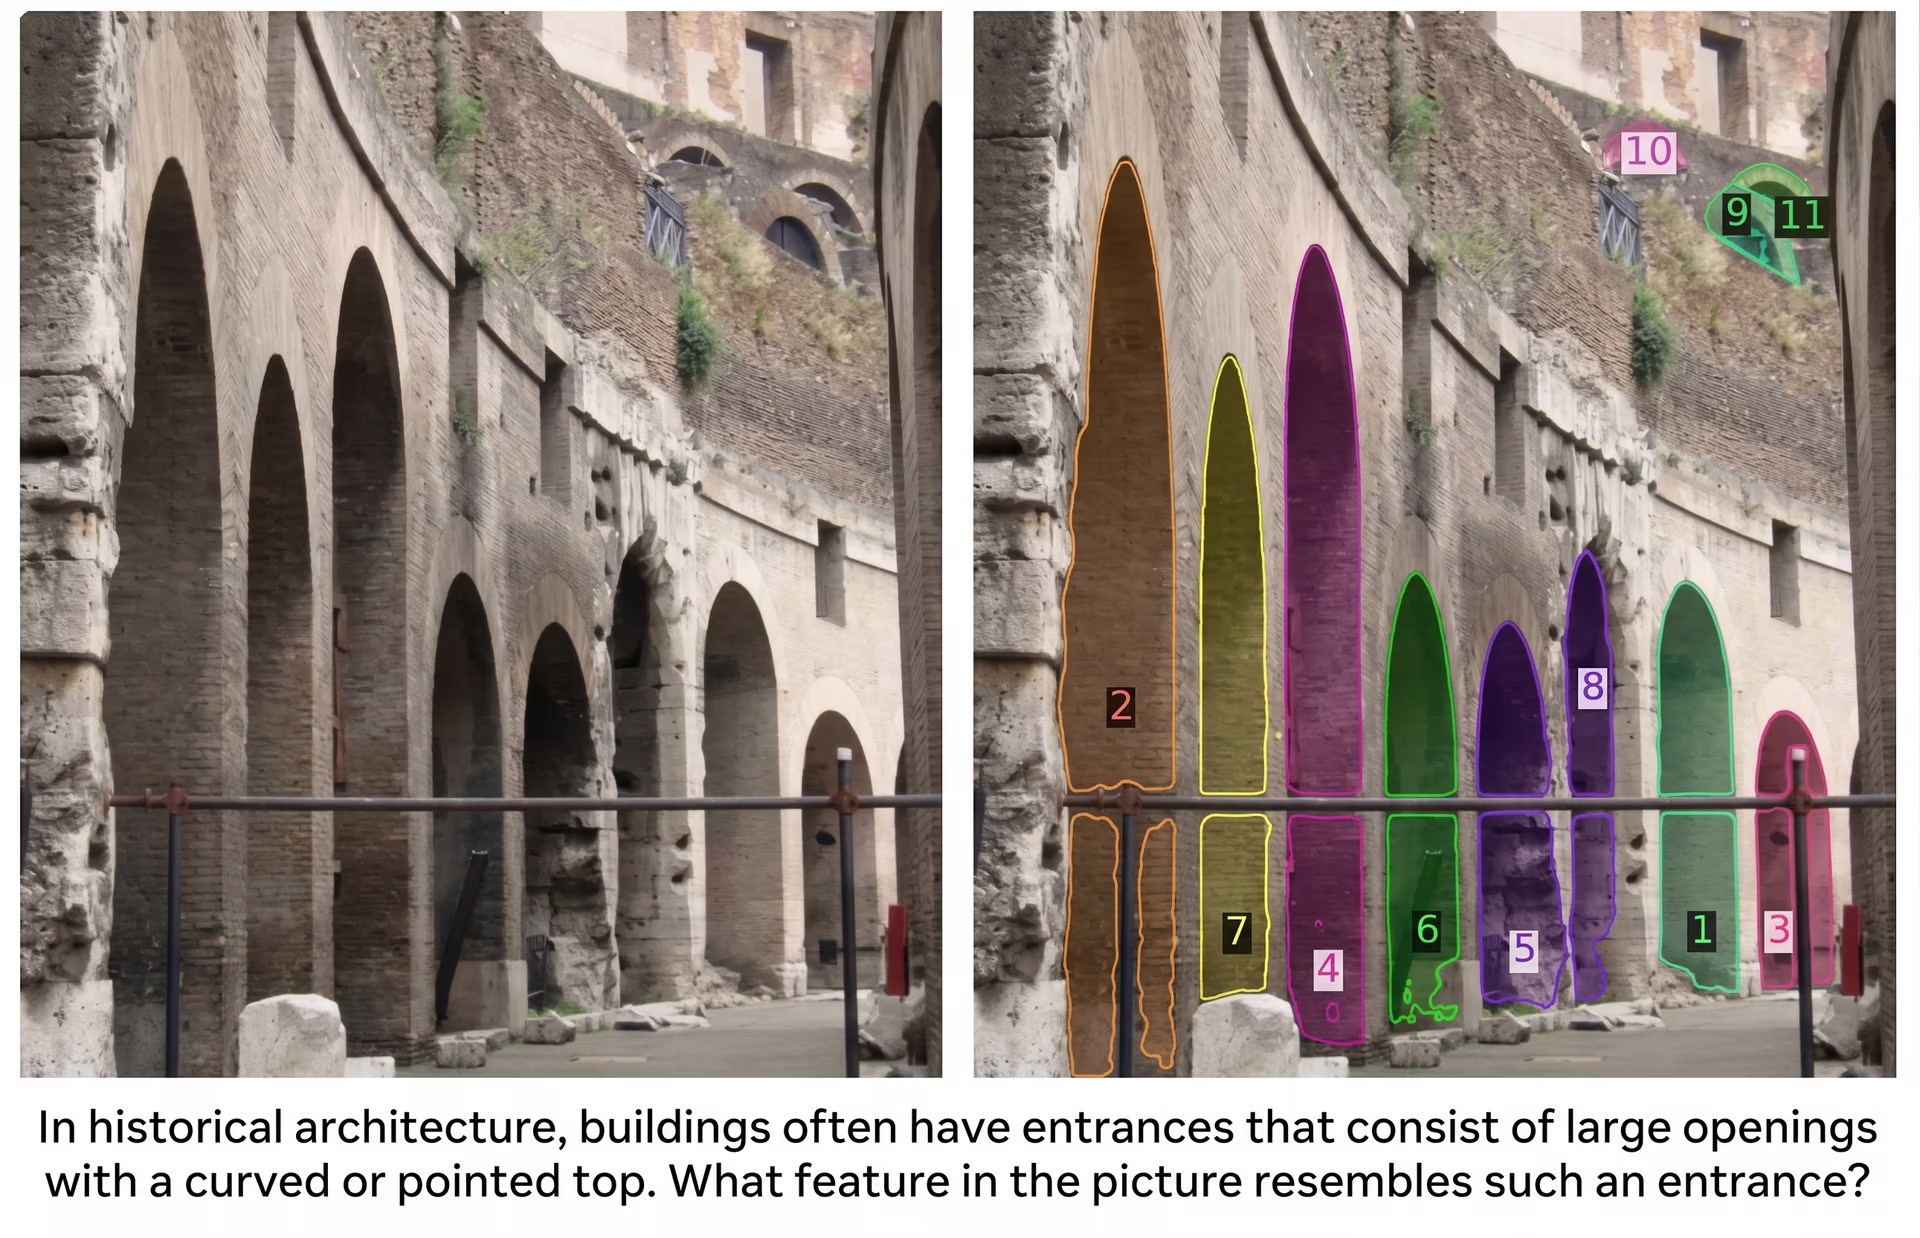
Abb. 2: Ein Beispiel dafür, wie SAM 3 per Prompt angeleitet und ein einzelnes Bild segmentiert wird (Quelle)
Im Vergleich zu früheren Versionen, die sich vor allem auf geometrische Prompts stützten, ist SAM 3 ein Schritt hin zu einer flexibleren, konzeptgesteuerten Segmentierung. Dadurch eignet sich SAM 3 besser für reale Anwendungen, in denen sich die relevanten Objekte oder Ideen ändern können und nicht immer im Voraus definiert werden können.
Wie die promptgesteuerte Konzeptsegmentierung funktioniert#
Wie funktioniert also die promptgesteuerte Konzeptsegmentierung? Sie baut auf großen, vortrainierten Bildverarbeitungs- und Bild-Sprach-Modellen auf. Diese Modelle wurden mit riesigen Bildsammlungen und oft auch mit zugehörigen Texten trainiert. Durch dieses Training können sie allgemeine visuelle Muster und semantische Bedeutungen erlernen.
Die meisten PCS-Modelle verwenden Transformer-basierte Architekturen, die ein ganzes Bild auf einmal verarbeiten, um zu verstehen, wie verschiedene Bereiche zusammenhängen. Ein Vision Transformer extrahiert visuelle Merkmale aus dem Bild, während ein Textencoder Wörter in numerische Repräsentationen umwandelt, mit denen das Modell arbeiten kann.
Während des Trainings können diese Modelle aus verschiedenen Arten von Supervision lernen, darunter pixelgenaue Masken, die exakte Objektgrenzen festlegen, Begrenzungsrahmen, die Objekte ungefähr lokalisieren, und Bildbeschriftungen, die beschreiben, was auf einem Bild zu sehen ist. Das Training mit verschiedenen Arten annotierter Daten hilft dem Modell, sowohl feine Details als auch übergeordnete visuelle Konzepte zu erfassen.
Bei der Inferenz, also wenn das Modell tatsächlich für Vorhersagen eingesetzt wird, folgt PCS einem promptgesteuerten Prozess. Nutzer geben Anweisungen in Form von Textbeschreibungen, visuellen Hinweisen wie Punkten oder Rechtecken oder Beispielbildern. Das Modell kodiert sowohl den Prompt als auch das Bild in einer gemeinsamen internen Repräsentation, den sogenannten Embeddings, und identifiziert Bereiche, die mit dem beschriebenen Konzept übereinstimmen.
Ein Maskendecoder wandelt diese gemeinsame Repräsentation anschließend in präzise, pixelgenaue Segmentierungsmasken um. Da das Modell visuelle Merkmale mit semantischer Bedeutung verknüpft, kann es auch neue Konzepte segmentieren, selbst wenn diese im Training nicht ausdrücklich enthalten waren.
Oft lässt sich die Ausgabe außerdem durch Anpassung des Prompts oder zusätzliche Hinweise verfeinern, sodass das Modell komplexe oder mehrdeutige Szenen besser bewältigt. Dieser iterative Prozess ermöglicht eine praktische Optimierung während des Einsatzes.
Promptgesteuerte Konzeptsegmentierungsmodelle werden in der Regel danach bewertet, wie gut sie zuvor ungesehene Konzepte segmentieren und wie zuverlässig sie in unterschiedlichen Szenen funktionieren. Benchmarks konzentrieren sich oft auf die Maskenqualität, die Generalisierungsfähigkeit und die Recheneffizienz und spiegeln damit die Anforderungen des praktischen Einsatzes wider.
Anwendungsfälle von PCS in der Praxis#
Sehen wir uns als Nächstes an, wo die promptgesteuerte Konzeptsegmentierung bereits eingesetzt wird und erste spürbare Auswirkungen zeigt.
Flexible Bildsegmentierung in der medizinischen Bildgebung#
In der medizinischen Bildgebung gibt es zahlreiche biologische Strukturen, Krankheiten und Scanarten, und täglich kommen neue Fälle hinzu. Herkömmliche Segmentierungsmodelle haben Schwierigkeiten, mit dieser Vielfalt Schritt zu halten.
PCS eignet sich besonders gut für diesen Bereich, weil Ärzte und Ärztinnen beschreiben können, wonach sie suchen, statt aus einer kurzen, starren Liste auszuwählen. Mit Textbeschreibungen oder visuellen Prompts kann PCS Organe oder auffällige Bereiche direkt segmentieren, ohne das Modell für jede neue Aufgabe erneut zu trainieren. So lassen sich vielfältige klinische Anforderungen leichter bewältigen, manuelle Maskenerstellung wird reduziert und verschiedene Bildgebungsverfahren werden unterstützt.
Ein gutes Beispiel ist MedSAM-3, das die SAM 3-Architektur für textgesteuerte PCS in der medizinischen Bildgebung anpasst. Dieses Modell lässt sich mit konkreten anatomischen und pathologischen Begriffen anleiten, etwa mit Organbezeichnungen wie Leber oder Niere sowie mit Begriffen für Läsionen wie Tumor oder Läsion. Mit einem Prompt segmentiert das Modell den entsprechenden Bereich direkt im medizinischen Bild.
MedSAM-3 integriert außerdem multimodale große Sprachmodelle (MLLMs oder multimodale LLMs), die sowohl Texte als auch Bilder analysieren können. Diese Modelle arbeiten in einem Ablauf mit menschlicher oder agentischer Beteiligung, bei dem die Ergebnisse iterativ verfeinert werden, um die Genauigkeit bei schwierigeren Fällen zu verbessern.
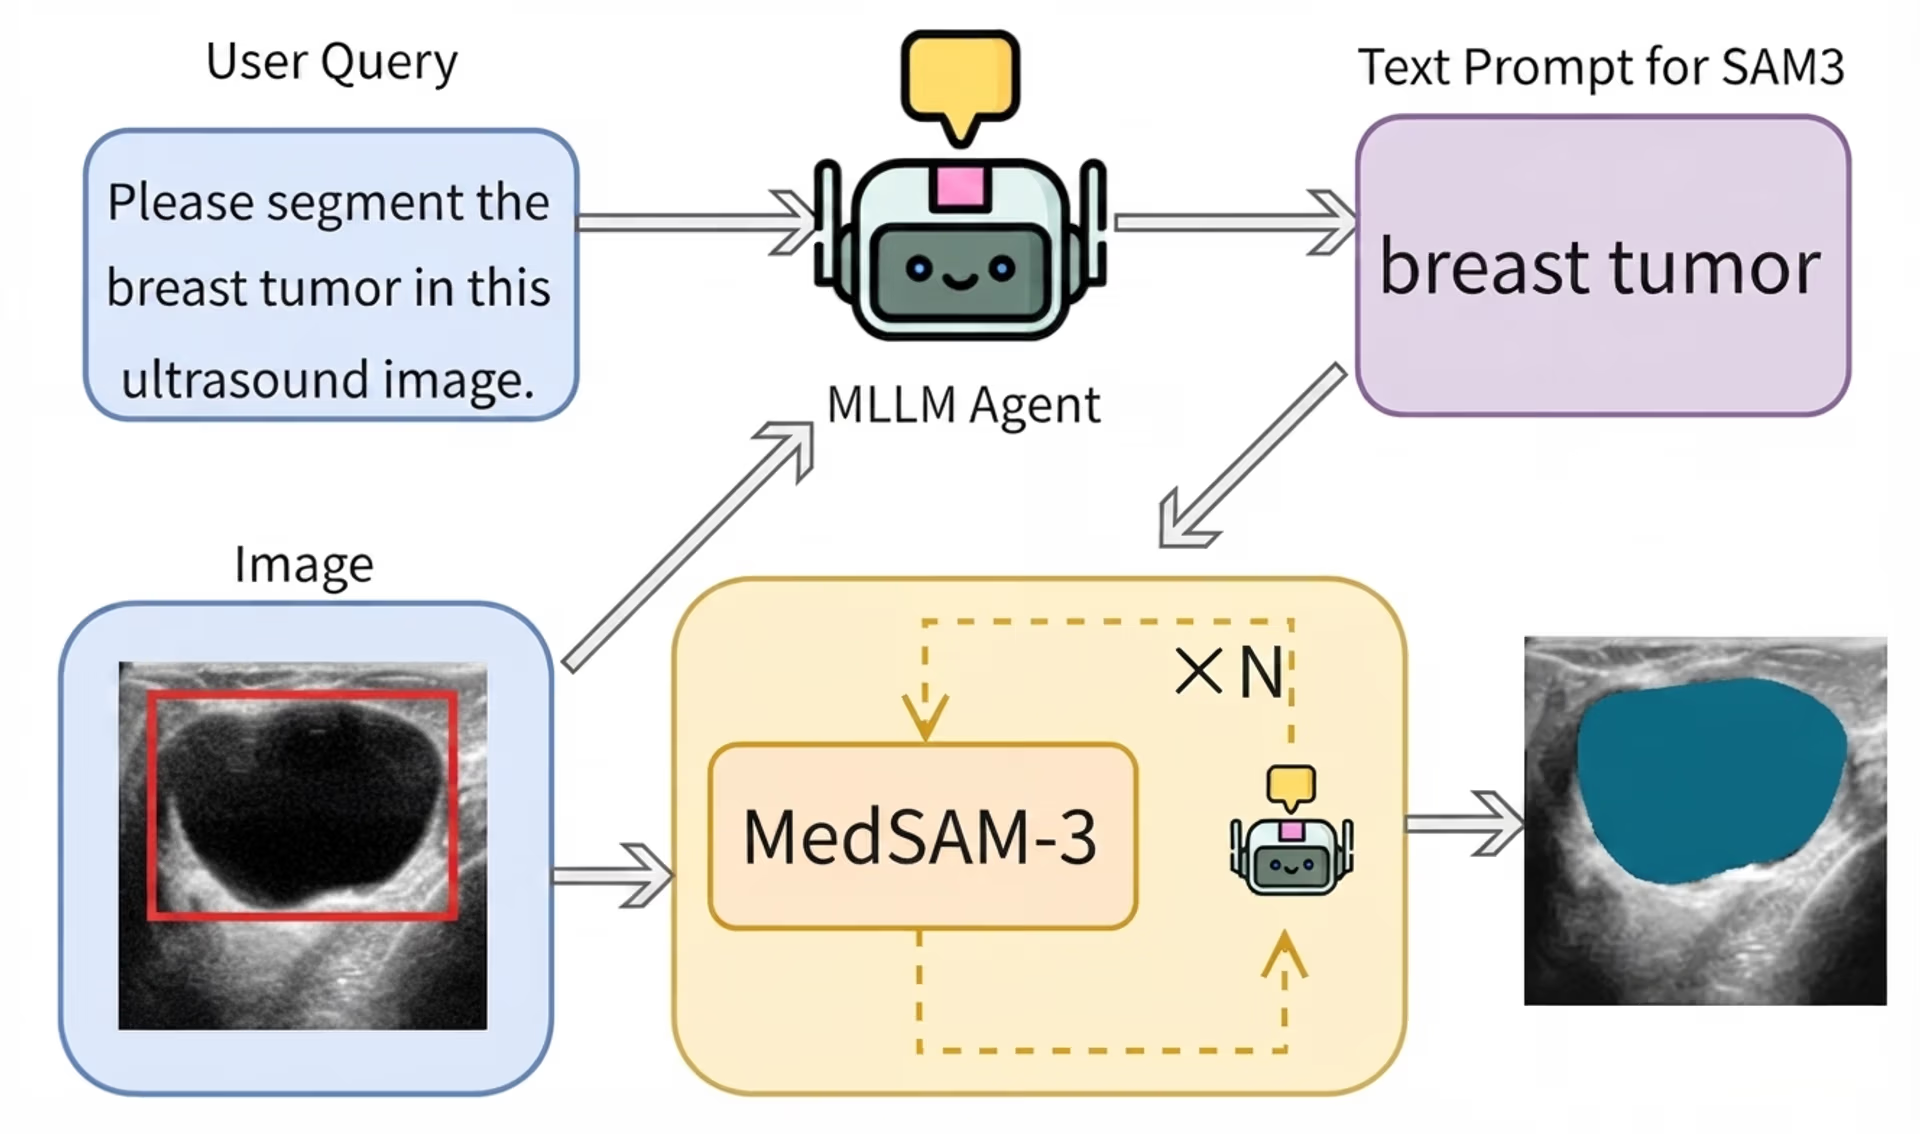
Abb. 3: Eine MedSAM-3-Pipeline zur textgesteuerten Tumorsegmentierung in medizinischen Bildern (Quelle)
MedSAM-3 erzielt gute Ergebnisse mit Röntgen-, MRT-, CT-, Ultraschall- und Videodaten und zeigt, wie PCS flexiblere und effizientere Abläufe in der medizinischen Bildgebung im klinischen Alltag ermöglichen kann.
Adaptive Segmentierung für die Roboterchirurgie und Automatisierung#
Die Roboterchirurgie ist auf Bildverarbeitungssysteme angewiesen, um Instrumente zu verfolgen und sich schnell verändernde Operationsszenen zu erfassen. Instrumente bewegen sich schnell, die Beleuchtung variiert und jederzeit können neue Werkzeuge zum Einsatz kommen. Dadurch lassen sich vordefinierte Beschriftungssysteme nur schwer aufrechterhalten.
Mit PCS können Roboter Werkzeuge verfolgen, Kameras steuern und Operationsschritte in Echtzeit begleiten. Das reduziert den manuellen Beschriftungsaufwand und erleichtert die Anpassung der Systeme an verschiedene Eingriffe. Chirurgen und Chirurginnen oder automatisierte Systeme können Text-Prompts wie „Greifer“, „Skalpell“ oder „Kamerawerkzeug“ verwenden, um anzugeben, was in einem Bild segmentiert werden soll.
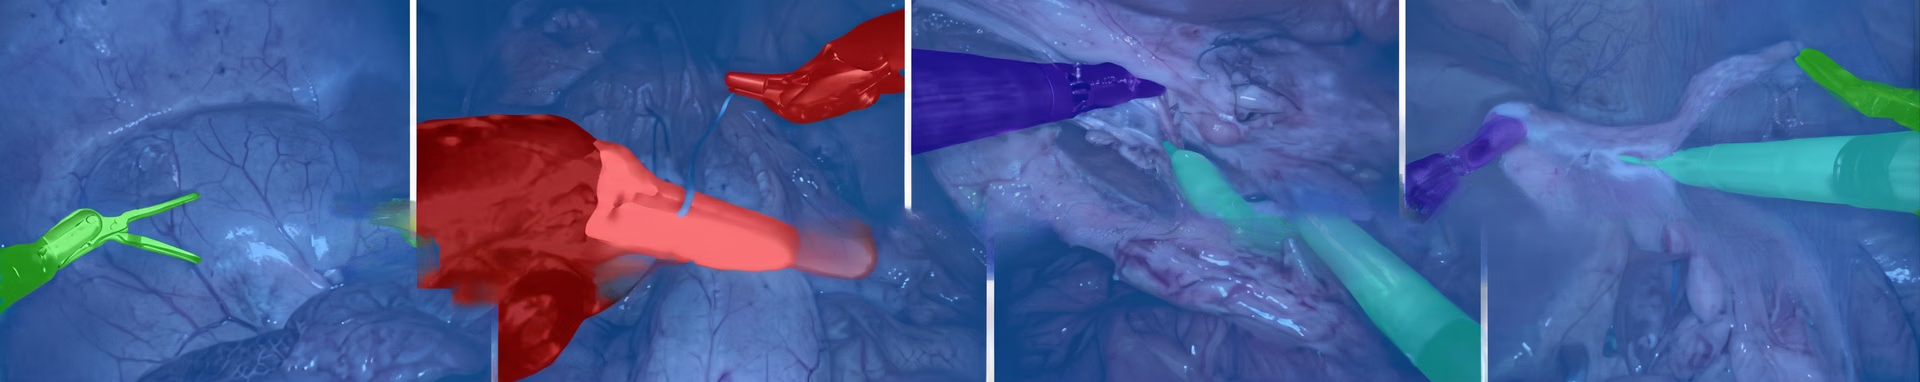
Abb. 4: Segmentierung chirurgischer Instrumente bei einer Roboteroperation (Quelle)
Segmentierung mit offenem Vokabular mit Ultralytics YOLOE-26#
Ein weiteres interessantes hochmodernes Modell im Bereich der promptgesteuerten Konzeptsegmentierung ist Ultralytics YOLOE-26. Es bringt Segmentierung mit offenem Vokabular und promptgesteuerter Bedienung in die Ultralytics-YOLO-Modellfamilie.
YOLOE-26 basiert auf der Ultralytics YOLO26-Architektur und unterstützt die Instanzsegmentierung mit offenem Vokabular. YOLOE-26 bietet verschiedene Möglichkeiten, die Segmentierung anzuleiten.
Das Modell unterstützt Text-Prompts, bei denen kurze, visuell verankerte Formulierungen das Zielobjekt festlegen, sowie visuelle Prompts, die zusätzliche Hinweise aus dem Bild liefern. Außerdem bietet YOLOE-26 einen Prompt-freien Modus für die Zero-Shot-Inferenz: Dabei erkennt und segmentiert das Modell Objekte aus einem integrierten Vokabular, ohne dass Nutzer-Prompts erforderlich sind.
YOLOE-26 eignet sich hervorragend für Anwendungen wie Videoanalyse, Robotik-Wahrnehmung und Edge-Systeme, bei denen sich Objektkategorien ändern können, geringe Latenz und zuverlässiger Durchsatz jedoch entscheidend bleiben. Das Modell ist auch besonders nützlich für die Datenkennzeichnung und Datensatzaufbereitung, da es Arbeitsabläufe durch die Automatisierung von Teilen des Annotationsprozesses vereinfacht.
Vor- und Nachteile der promptgesteuerten Konzeptsegmentierung#
Hier sind einige der wichtigsten Vorteile der promptgesteuerten Konzeptsegmentierung:
- Schnellere Iteration und Prototypenerstellung: Neue Segmentierungsaufgaben lassen sich schnell testen, indem Prompts geändert werden, statt Datensätze neu aufzubauen oder Modelle erneut zu trainieren. Das beschleunigt Experimente und Entwicklung.
- Anpassungsfähigkeit an verschiedene Bereiche: Dasselbe PCS-Modell lässt sich oft mit nur geringfügigen Änderungen am Arbeitsablauf in unterschiedlichen Bereichen einsetzen, etwa in der medizinischen Bildgebung, der Robotik oder der Videoanalyse.
- Interaktive Verfeinerung: Nutzer können Prompts schrittweise anpassen oder zusätzliche Hinweise geben, um die Ergebnisse zu verbessern. So lassen sich mehrdeutige Szenen oder Sonderfälle leichter bewältigen, ohne das Modell erneut zu trainieren.
PCS hat zwar klare Vorteile, doch solltest du auch die folgenden Einschränkungen berücksichtigen:
- Empfindlichkeit gegenüber Prompts: Schon kleine Änderungen an der Formulierung oder Eingabe eines Prompts können sich auf die Ausgabe auswirken. Zu vage oder zu spezifische Prompts können zu unvollständigen oder falschen Segmentierungen führen.
- Weniger vorhersehbares Verhalten: Da das Modell Prompts interpretiert, statt feste Beschriftungen auszuwählen, können die Ergebnisse je nach Szene und Eingabe stärker variieren. Das kann bei streng kontrollierten Verarbeitungsketten problematisch sein.
- Mehrdeutige Interpretation von Konzepten: Manche Konzepte sind subjektiv oder nur ungenau definiert. Dadurch können die Segmentierungsergebnisse zwischen Nutzern oder Bildern uneinheitlich ausfallen.
- Eingeschränkte Zuverlässigkeit bei sehr spezifischen Zielen: Promptbasierte Modelle sind bei eng definierten, instanzspezifischen Aufgaben wie der Fehlererkennung im Allgemeinen weniger zuverlässig, wenn subtile Merkmale präzise und konsistent erkannt werden müssen.
Die Wahl zwischen promptgesteuerter und herkömmlicher Segmentierung#
Wenn du dich mit promptgesteuerter Segmentierung beschäftigst, fragst du dich vielleicht, für welche Anwendungen sie am besten geeignet ist und wann ein herkömmliches Computer-Vision-Modell wie Ultralytics YOLO26 besser zu deinem Problem passt. Promptgesteuerte Segmentierung funktioniert gut bei allgemeinen Objekten, eignet sich aber nicht für Anwendungsfälle, die sehr präzise und konsistente Ergebnisse erfordern.
Die Fehlererkennung ist ein gutes Beispiel. In der Fertigung sind Fehler oft klein und unauffällig, etwa feine Kratzer, Dellen, Fehlstellungen oder Oberflächenunregelmäßigkeiten. Je nach Material, Beleuchtung und Produktionsbedingungen können sie außerdem sehr unterschiedlich ausfallen.
Solche Fehler lassen sich nur schwer mit einem einfachen Prompt beschreiben und sind für ein universell einsetzbares Modell noch schwieriger zuverlässig zu erkennen. Promptbasierte Modelle übersehen Fehler daher häufig oder liefern instabile Ergebnisse, während Modelle, die speziell mit Fehlerdaten trainiert wurden, für Prüfsysteme in der Praxis deutlich zuverlässiger sind.
Die wichtigsten Erkenntnisse#
Die promptgesteuerte Konzeptsegmentierung erleichtert die Anpassung von Bildverarbeitungssystemen an die reale Welt, in der ständig neue Objekte und Ideen auftauchen. Statt an feste Beschriftungen gebunden zu sein, können Nutzer einfach beschreiben, was sie segmentieren möchten, und das Modell die Arbeit erledigen lassen. Das spart Zeit und verringert den manuellen Aufwand. PCS hat zwar noch Einschränkungen, verändert aber bereits den praktischen Einsatz der Segmentierung und dürfte künftig zu einem zentralen Bestandteil von Bildverarbeitungssystemen werden.
Entdecke mehr über KI in unserem GitHub-Repository und werde Teil unserer Community. In unseren Lösungsübersichten erfährst du mehr über KI in der Robotik und Computer Vision in der Fertigung. Entdecke unsere Lizenzoptionen und starte noch heute mit visueller KI!
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









