Esporta e ottimizza Ultralytics YOLOv8 per l'inferenza su Intel OpenVINO
Ottimizza il tuo modello Ultralytics YOLOv8 per l'inferenza usando OpenVINO. Segui la nostra guida per convertire i modelli PyTorch in ONNX e ottimizzarli per applicazioni in tempo reale.
In questo articolo del blog vedremo come esportare e ottimizzare il tuo modello Ultralytics YOLOv8 pre-addestrato o addestrato su dati personalizzati per l'inferenza con OpenVINO. Se utilizzi un sistema basato su Intel, con CPU o GPU, questa guida ti mostrerà come velocizzare significativamente il tuo modello con il minimo sforzo.
Perché ottimizzare Ultralytics YOLOv8 con OpenVINO?#
Ottimizzare il tuo modello Ultralytics YOLOv8 con OpenVINO può offrire un aumento della velocità fino a 3 volte nelle attività di inferenza, in particolare se utilizzi una CPU Intel. Questo incremento delle prestazioni può fare una grande differenza nelle applicazioni in tempo reale, dal rilevamento degli oggetti alla segmentazione e ai sistemi di sicurezza.
Passaggi per esportare e ottimizzare il tuo modello Ultralytics YOLOv8#
Comprendere il processo#
Prima di tutto, analizziamo il processo. Convertiremo un modello PyTorch in ONNX e lo ottimizzeremo quindi utilizzando OpenVINO. Questo processo prevede alcuni semplici passaggi e può essere applicato a diversi modelli e formati, tra cui TensorFlow, PyTorch, Caffe e ONNX.
Esportazione del modello#
Consultando la documentazione di Ultralytics, scopriamo che per esportare un modello YOLOv8 è necessario utilizzare il metodo export del framework Ultralytics. Questo metodo consente di convertire il modello da PyTorch a ONNX e infine di ottimizzarlo per OpenVINO. Il risultato è un modello che viene eseguito molto più velocemente, sfruttando il potente hardware Intel.
Installazione delle dipendenze#
Prima di eseguire lo script di esportazione, devi assicurarti che tutte le dipendenze necessarie siano installate. Queste includono la libreria Ultralytics, ONNX e OpenVINO. L'installazione di questi pacchetti è un processo semplice che può essere eseguito tramite pip, il programma di installazione dei pacchetti Python.
Esecuzione dello script di esportazione#
Dopo aver configurato l'ambiente, puoi eseguire lo script di esportazione. Questo script convertirà il tuo modello PyTorch in ONNX e quindi in OpenVINO. Il processo è semplice e consiste nel chiamare una singola funzione per gestire l'esportazione. Il framework Ultralytics facilita la conversione e l'ottimizzazione dei modelli, garantendo le migliori prestazioni con il minimo sforzo.
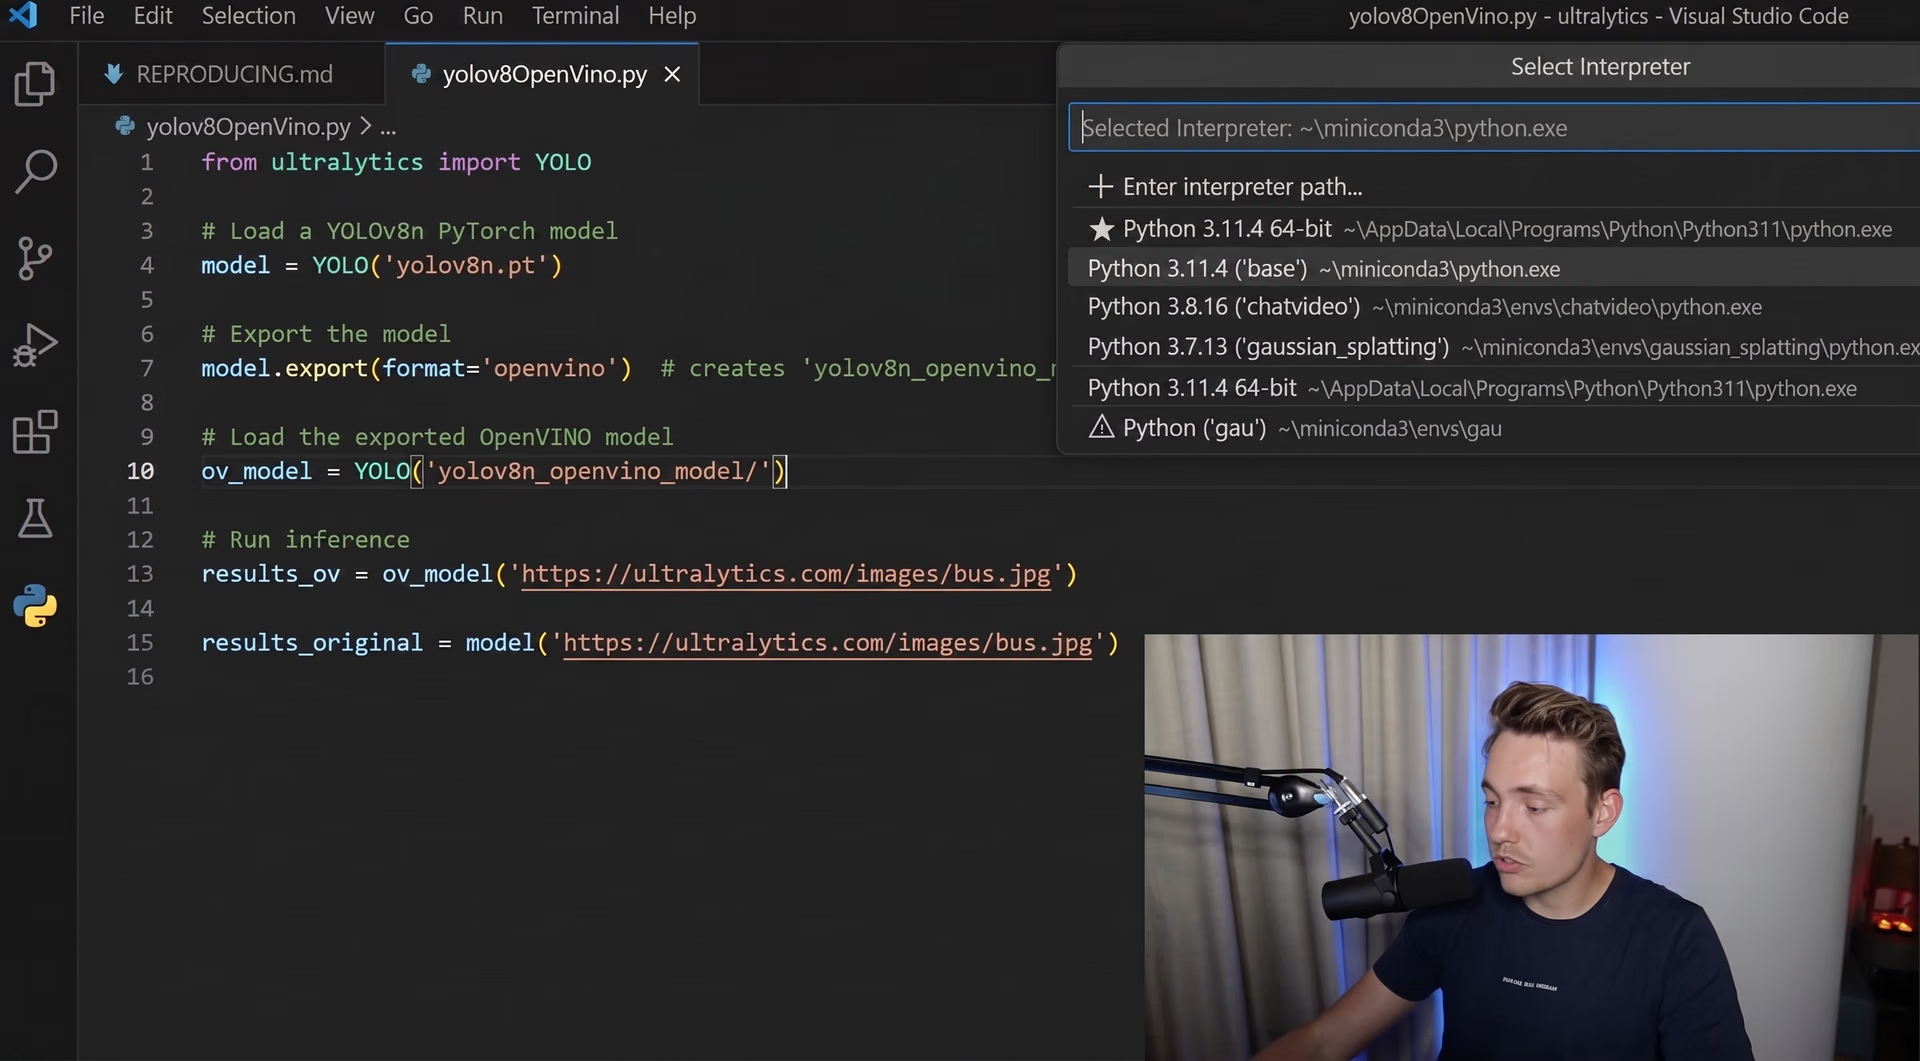
Fig. 1. Nicolai Nielsen illustra come eseguire lo script di esportazione.
Confronto delle prestazioni#
Dopo l'esportazione, è essenziale confrontare le prestazioni dei modelli originale e ottimizzato. Misurando il tempo di inferenza di entrambi i modelli, puoi vedere chiaramente i miglioramenti delle prestazioni. In genere, il modello OpenVINO mostrerà una significativa riduzione del tempo di inferenza rispetto al modello PyTorch originale. Questo è particolarmente vero per i modelli più grandi, nei quali l'incremento delle prestazioni è più evidente.
Applicazioni e vantaggi nel mondo reale#
L'ottimizzazione dei modelli Ultralytics YOLOv8 con OpenVINO è particolarmente vantaggiosa per le applicazioni che richiedono l'elaborazione in tempo reale. Ecco alcuni esempi:
- Sistemi di sicurezza: il rilevamento degli oggetti in tempo reale può avvisare istantaneamente il personale di sicurezza, migliorando la sicurezza e la reattività.
- Veicoli automatizzati: velocità di inferenza più elevate migliorano la reattività dei sistemi di guida autonoma, rendendoli più sicuri e affidabili.
- Sanità: l'elaborazione rapida delle immagini per gli strumenti diagnostici può salvare vite fornendo risultati più rapidamente e consentendo interventi tempestivi.
Implementando queste ottimizzazioni, non solo migliori le prestazioni, ma aumenti anche l'affidabilità e l'efficienza delle tue applicazioni. Questo può portare a esperienze utente migliori, maggiore produttività e soluzioni più innovative.
Conclusioni#
Esportare e ottimizzare un modello Ultralytics YOLOv8 per OpenVINO è un modo efficace per sfruttare l'hardware Intel e realizzare applicazioni di AI più veloci ed efficienti. Con pochi semplici passaggi, puoi trasformare le prestazioni del tuo modello e applicarlo efficacemente a scenari reali.
Assicurati di consultare altri tutorial e guide di Ultralytics per continuare a migliorare i tuoi progetti di AI. Visita il nostro repository GitHub e unisciti alla community Ultralytics per ulteriori informazioni e aggiornamenti. Innoviamo insieme!
Ricorda: ottimizzare i tuoi modelli non significa solo aumentare la velocità, ma anche sbloccare nuove possibilità e garantire che le tue soluzioni di AI siano solide, efficienti e pronte per il futuro.








