Come Ultralytics YOLO26 si addestra in modo più intelligente con ProgLoss, STAL e MuSGD
Scopri come Ultralytics YOLO26 si addestra in modo più affidabile grazie al bilanciamento progressivo della loss, all'assegnazione delle etichette attenta agli oggetti piccoli e all'ottimizzatore MuSGD.
 Abirami Vina10 min di lettura
La scorsa settimana abbiamo rilasciato Ultralytics YOLO26, un modello di visione artificiale in tempo reale progettato per dare priorità all'edge. Come i precedenti modelli Ultralytics YOLO, tra cui Ultralytics YOLO11, YOLO26 supporta le principali attività di visione artificiale note agli utenti, tra cui rilevamento degli oggetti, segmentazione delle istanze e stima della posa.
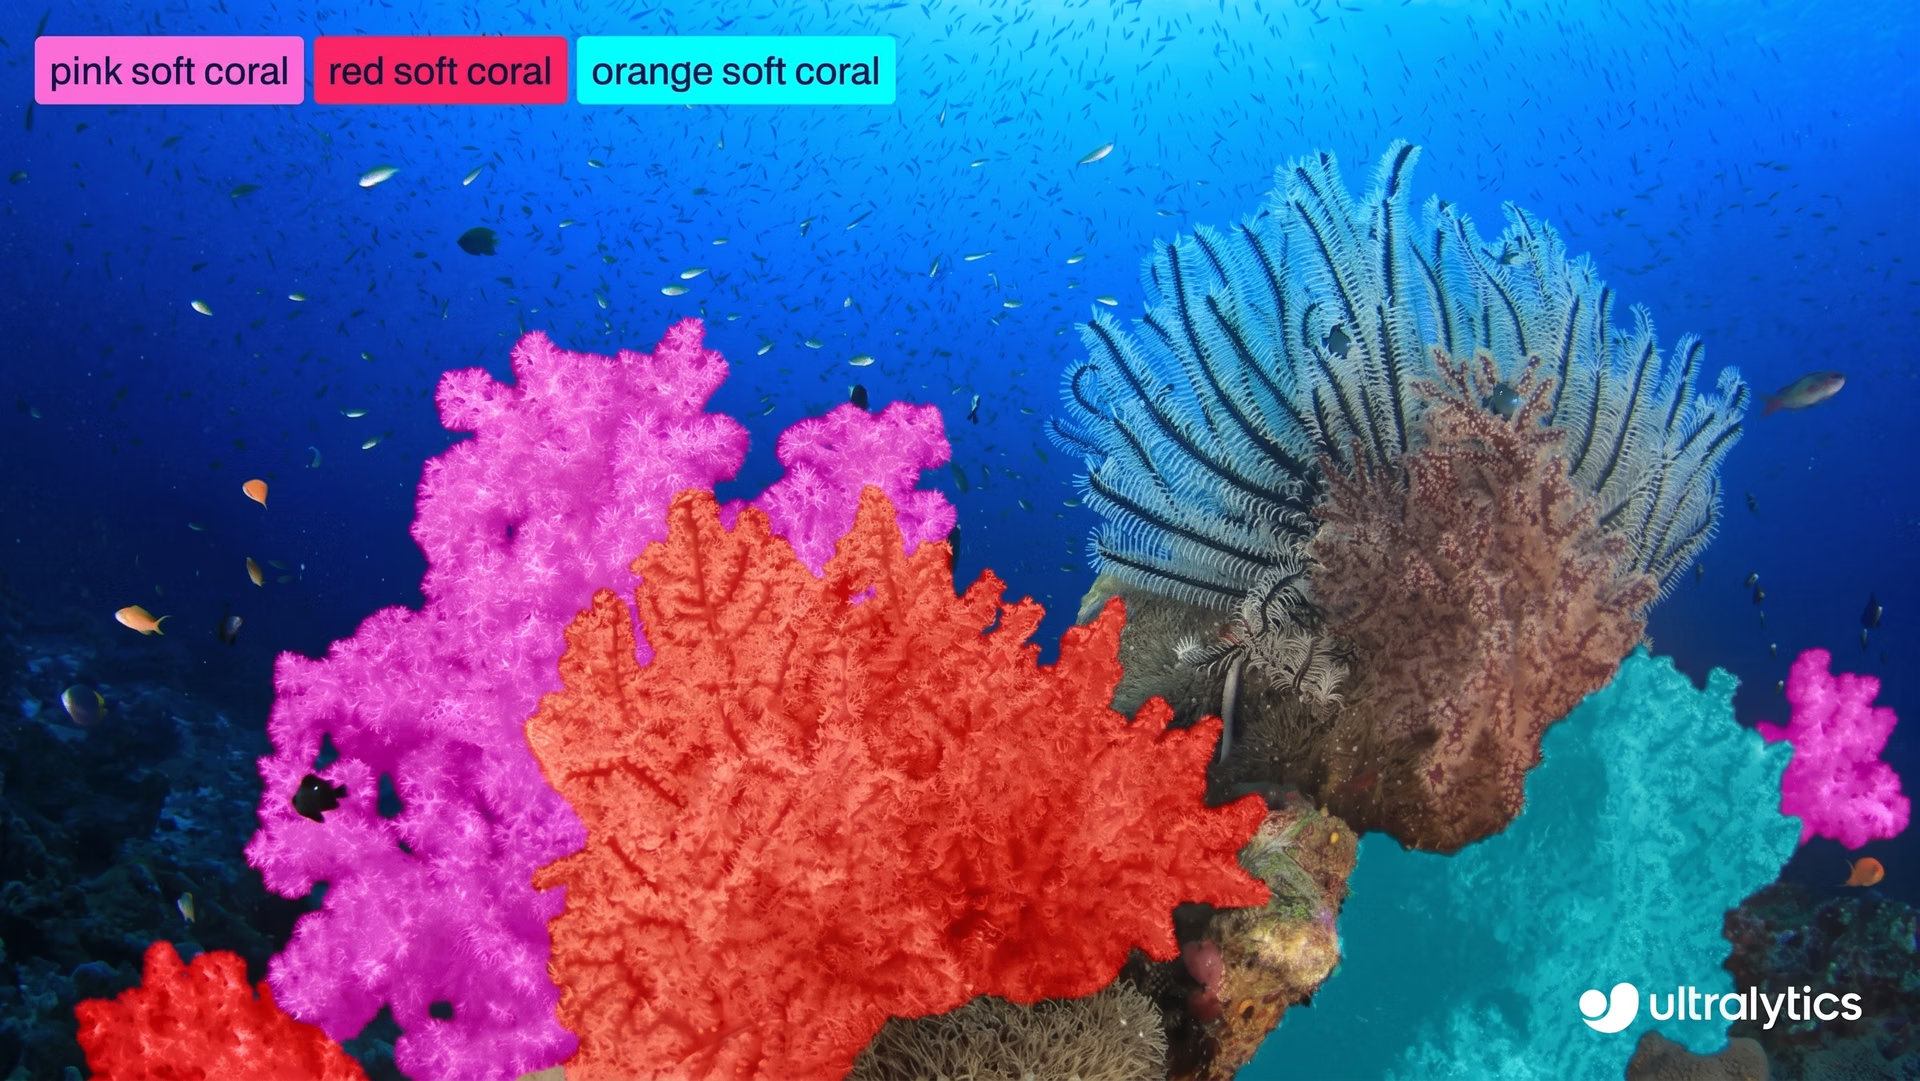
Fig. 1. Esempio di utilizzo di Ultralytics YOLO26 per segmentare gli oggetti in un’immagine.
Ultralytics YOLO26, però, non è un semplice aggiornamento incrementale. Anche se le attività supportate possono sembrare familiari, questo nuovo modello segna un passo avanti nel modo in cui vengono addestrati i modelli di visione artificiale. Con YOLO26, l'obiettivo va oltre l'efficienza dell'inferenza e punta a rendere più stabile l'addestramento.
Ultralytics YOLO26 è stato progettato tenendo conto dell’intero ciclo di vita dell’addestramento. Questo si traduce in una convergenza più rapida, sessioni di addestramento più affidabili e un comportamento coerente del modello. Questi miglioramenti sono particolarmente importanti nei flussi di lavoro reali, in cui l’affidabilità dell’addestramento incide direttamente sulla rapidità con cui è possibile iterare sui modelli e distribuirli.
Per consentirlo, Ultralytics YOLO26 introduce diverse innovazioni mirate per l’addestramento, come il bilanciamento progressivo della loss (ProgLoss), l’assegnazione delle etichette sensibile agli oggetti piccoli (STAL) e l’ottimizzatore MuSGD. Nel loro insieme, queste modifiche migliorano il bilanciamento della loss di apprendimento, l’assegnazione delle etichette e il comportamento dell’ottimizzazione nel tempo.
In questo articolo vedremo come funziona ciascuno di questi meccanismi e perché rende Ultralytics YOLO26 più facile da addestrare e più affidabile su larga scala. Cominciamo!
Ultralytics YOLO26: progettato per addestrare in modo più intelligente, non solo per funzionare più velocemente#
Ultralytics YOLO26 semplifica in modo nativo l'intera pipeline di inferenza, eliminando la dipendenza da fasi di post-elaborazione come la soppressione non massima (NMS). Invece di generare numerose previsioni sovrapposte e filtrarle in seguito, YOLO26 produce direttamente dalla rete i rilevamenti finali.
Questo rende YOLO26 un modello end-to-end, in cui la previsione, la risoluzione dei duplicati e i risultati finali vengono appresi direttamente all’interno della rete. Ciò semplifica la distribuzione e migliora l’efficienza dell’inferenza, influenzando al contempo il modo in cui il modello apprende durante l’addestramento.
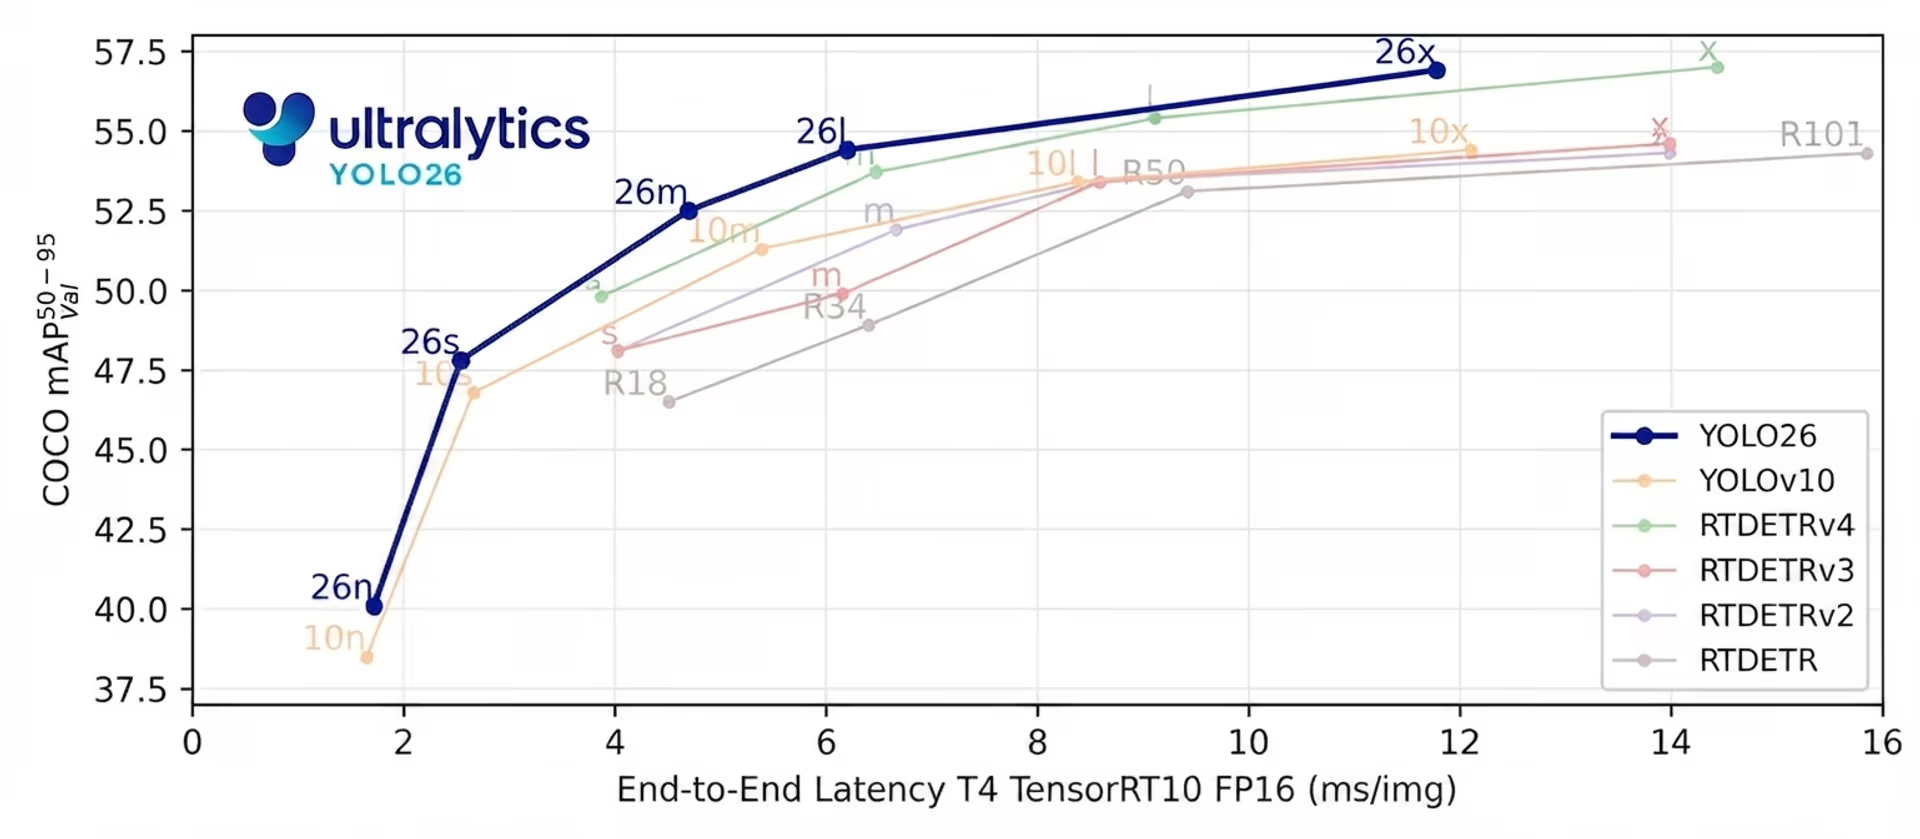
Fig. 2. YOLO26 offre un'inferenza end-to-end all'avanguardia e senza NMS (Fonte)
In un sistema end-to-end come questo, addestramento e inferenza sono strettamente collegati. Poiché non è presente una fase esterna di post-elaborazione che corregga in seguito le previsioni, il modello deve imparare a prendere decisioni chiare e sicure già durante l'addestramento.
Questo rende particolarmente importante l'allineamento tra gli obiettivi di addestramento e il comportamento in inferenza. Qualsiasi discrepanza tra il modo in cui il modello viene addestrato e quello in cui viene utilizzato in fase di inferenza può causare un apprendimento instabile o una convergenza più lenta.
Ultralytics YOLO26 affronta questo aspetto progettando fin dall'inizio il processo di addestramento in funzione dell'utilizzo nel mondo reale. Invece di concentrarsi solo sulla velocità di inferenza, il sistema di addestramento è progettato per supportare un apprendimento stabile nel corso di lunghe esecuzioni, una convergenza coerente tra modelli di dimensioni diverse, da Nano a Extra Large, e prestazioni robuste su dataset eterogenei.
In che modo due head di addestramento migliorano l'apprendimento in Ultralytics YOLO26#
Una delle principali innovazioni nell'addestramento di Ultralytics YOLO26 si basa su un approccio con due head di addestramento, già utilizzato nei precedenti modelli YOLO. Nei modelli di rilevamento degli oggetti, un head è la parte della rete responsabile delle previsioni.
In altre parole, gli head di rilevamento imparano a prevedere dove si trovano gli oggetti in un'immagine e di quali oggetti si tratta. Lo fanno stimando le coordinate dei riquadri di delimitazione, ovvero imparando a stimare la posizione e le dimensioni di ciascun oggetto nell'immagine di input.
Durante l'addestramento, il modello apprende minimizzando una loss, una misura numerica della distanza tra le sue previsioni e le risposte corrette, o ground truth. Una loss più bassa significa che le previsioni del modello sono più vicine alla ground truth, mentre una loss più alta indica errori maggiori. Il calcolo della loss guida l'aggiornamento dei parametri del modello durante l'addestramento.
Ultralytics YOLO26 utilizza due head di rilevamento durante l'addestramento, che condividono lo stesso modello sottostante ma hanno funzioni diverse. L'head one-to-one è quello utilizzato in fase di inferenza. Impara ad associare ogni oggetto a una singola previsione sicura, una caratteristica essenziale per il design end-to-end e senza NMS di YOLO26.
L'head one-to-many, invece, viene utilizzato solo durante l'addestramento. Consente di associare più previsioni allo stesso oggetto, fornendo una supervisione più densa. Questo segnale di apprendimento più ricco aiuta a stabilizzare l'addestramento e a migliorare la precisione, soprattutto nelle fasi iniziali.
In Ultralytics YOLO26, entrambi gli head utilizzano lo stesso calcolo della loss per la regressione dei riquadri e la classificazione. Le implementazioni precedenti applicavano un bilanciamento fisso tra questi due segnali di loss per tutta la durata dell'addestramento.
Nella pratica, però, l'importanza di ciascun head cambia nel tempo. La supervisione densa è più utile all'inizio, mentre nelle fasi successive dell'addestramento diventa più importante l'allineamento con il comportamento in inferenza. Ultralytics YOLO26 è progettato tenendo conto di questo principio, che determina direttamente il modo in cui ribilancia i segnali di apprendimento man mano che l'addestramento procede.
Ultralytics YOLO26 utilizza il bilanciamento progressivo della loss#
Come gestisce Ultralytics YOLO26 queste diverse esigenze di apprendimento durante l'addestramento? Utilizza il bilanciamento progressivo della loss per regolare nel tempo il peso dei segnali di apprendimento.
ProgLoss funziona modificando dinamicamente il contributo di ciascun head alla loss totale man mano che l'addestramento procede. All'inizio viene dato più peso all'head one-to-many per stabilizzare l'apprendimento e migliorare il richiamo. Con il proseguire dell'addestramento, il bilanciamento si sposta gradualmente verso l'head one-to-one, allineando maggiormente l'addestramento al comportamento in inferenza.
Questa transizione graduale permette a Ultralytics YOLO26 di apprendere nell'ordine corretto. Invece di costringere il modello a ottimizzare contemporaneamente obiettivi in competizione, il bilanciamento progressivo della loss dà priorità al segnale di apprendimento più utile in ogni fase dell'addestramento. Il risultato è una convergenza più fluida, meno sessioni di addestramento instabili e prestazioni finali più coerenti.
Come STAL aiuta Ultralytics YOLO26 ad apprendere dagli oggetti minuscoli#
Un altro interessante miglioramento nell'addestramento di Ultralytics YOLO26 riguarda il modo in cui il modello assegna i target di addestramento alle previsioni, un processo noto come assegnazione delle etichette. Questo processo abbina gli oggetti della ground truth alle previsioni candidate, spesso chiamate anchor.
Questi abbinamenti determinano quali previsioni ricevono supervisione e contribuiscono alla loss. Ultralytics YOLO26 si basa su un metodo esistente di assegnazione delle etichette chiamato apprendimento dell'allineamento dei task (TAL), progettato per allineare meglio classificazione e localizzazione durante l'addestramento.
Sebbene TAL funzioni bene per la maggior parte degli oggetti, l'addestramento ha rivelato un'importante limitazione. Durante la fase di abbinamento, gli oggetti molto piccoli potevano essere completamente esclusi. Nella pratica, spesso gli oggetti più piccoli di circa 8 pixel in un'immagine di input da 640 pixel non ricevevano alcuna assegnazione di anchor. In questi casi, il modello riceve poca o nessuna supervisione per tali oggetti, rendendo difficile imparare a rilevarli in modo affidabile.
Per risolvere questo problema, Ultralytics YOLO26 introduce Small-Target-Aware Label Assignment (STAL). STAL modifica il processo di assegnazione per evitare che gli oggetti piccoli vengano ignorati durante l'addestramento. In particolare, durante la selezione dei candidati, aumenta a 16 pixel la larghezza o l'altezza di qualsiasi riquadro inferiore a 8 pixel, continuando però a usare il riquadro originale per l'abbinamento e la regressione. In questo modo, anche gli oggetti minuscoli contribuiscono in modo costante alla funzione di perdita dell'addestramento.
Rafforzando la supervisione dei target piccoli, STAL migliora la stabilità dell'apprendimento e le prestazioni di rilevamento negli scenari in cui sono comuni oggetti piccoli o lontani. Questo miglioramento è particolarmente importante per le applicazioni YOLO26 progettate prima di tutto per l'edge, come l'imaging aereo, la robotica e i sistemi dell'Internet delle cose (IoT), in cui gli oggetti sono spesso piccoli, lontani o parzialmente visibili e un rilevamento affidabile è fondamentale.
Ultralytics YOLO26 introduce l'ottimizzatore MuSGD#
Per favorire un addestramento più stabile e prevedibile, Ultralytics YOLO26 introduce anche un nuovo ottimizzatore chiamato MuSGD. Questo ottimizzatore è progettato per migliorare la convergenza e l'affidabilità dell'addestramento nei modelli di rilevamento end-to-end, soprattutto quando aumentano le dimensioni del modello e la complessità dell'addestramento.
Per consentire a una rete neurale di apprendere e aggiornare i propri pesi durante l'addestramento, calcoliamo un errore, chiamato anche loss. Il modello misura quanto sono errate le sue previsioni tramite un valore di loss, calcola i gradienti che indicano come modificare i parametri e infine aggiorna tali parametri per ridurre l'errore. La discesa stocastica del gradiente (SGD) è un ottimizzatore ampiamente usato per eseguire questi aggiornamenti, rendendo l'addestramento efficiente e scalabile.
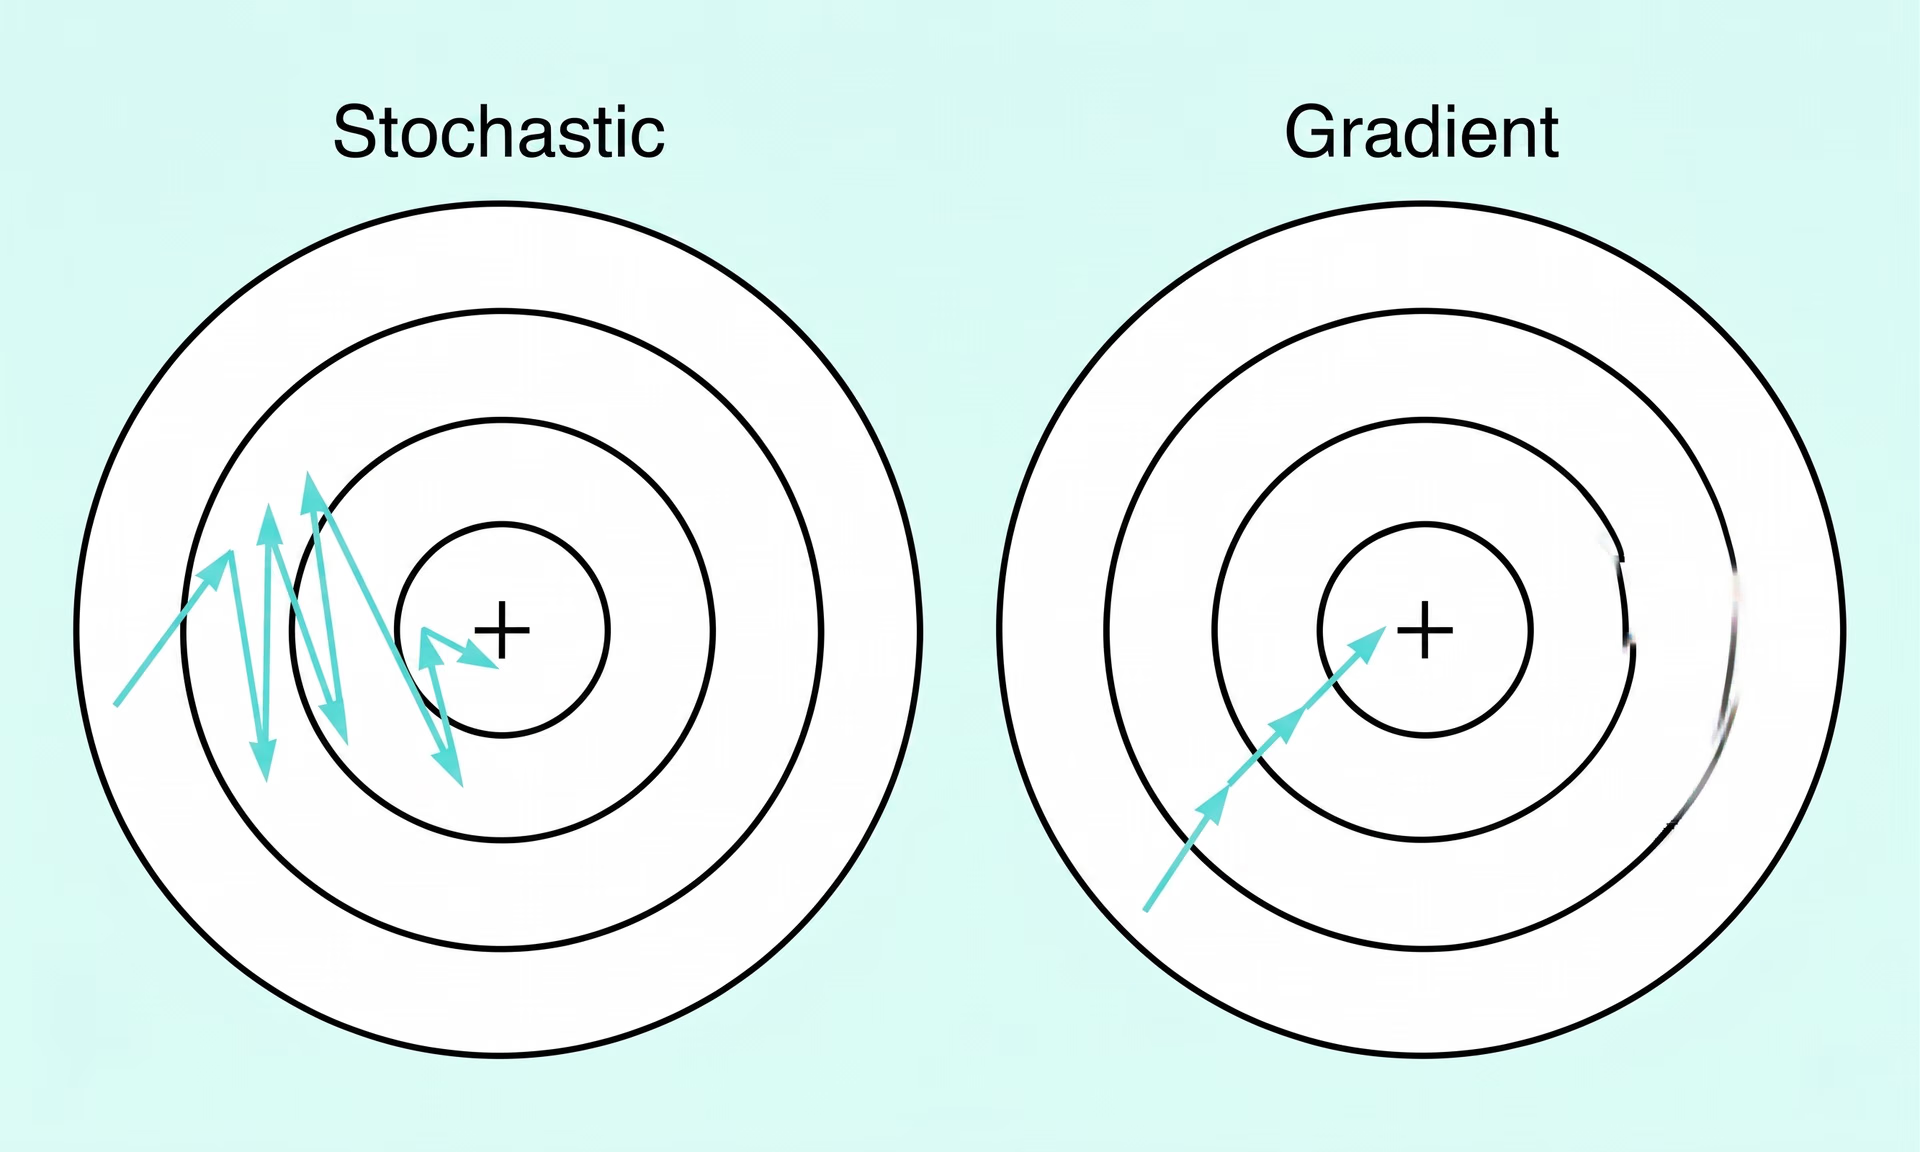
Fig. 3. Discesa stocastica del gradiente rispetto alla discesa del gradiente (Fonte)
MuSGD parte da queste basi consolidate e integra idee di ottimizzazione ispirate a Muon, un metodo usato per addestrare modelli linguistici di grandi dimensioni (LLM). Queste idee sono state influenzate da progressi recenti, come Kimi K2 di Moonshot AI, che ha mostrato un comportamento di addestramento migliore grazie ad aggiornamenti dei parametri più strutturati.
Ultralytics YOLO26 utilizza una strategia di aggiornamento ibrida. Alcuni parametri vengono aggiornati combinando aggiornamenti ispirati a Muon e SGD, mentre per altri si usa solo SGD. In questo modo YOLO26 può introdurre una struttura aggiuntiva nel processo di ottimizzazione, mantenendo al contempo la robustezza e le capacità di generalizzazione che hanno reso efficace SGD.
Il risultato è un'ottimizzazione più fluida, una convergenza più rapida e un comportamento di addestramento più prevedibile per tutte le dimensioni dei modelli: MuSGD è quindi uno degli elementi chiave che rendono Ultralytics YOLO26 più facile da addestrare e più affidabile su larga scala.
L'importanza delle innovazioni di Ultralytics YOLO26 nell'addestramento#
Le innovazioni di Ultralytics YOLO26 nell'addestramento, insieme a caratteristiche chiave come il design end-to-end, senza NMS e progettato prima di tutto per l'edge, rendono il modello più facile da addestrare e più affidabile su larga scala. Ti starai chiedendo cosa significhi davvero per le applicazioni di visione artificiale.
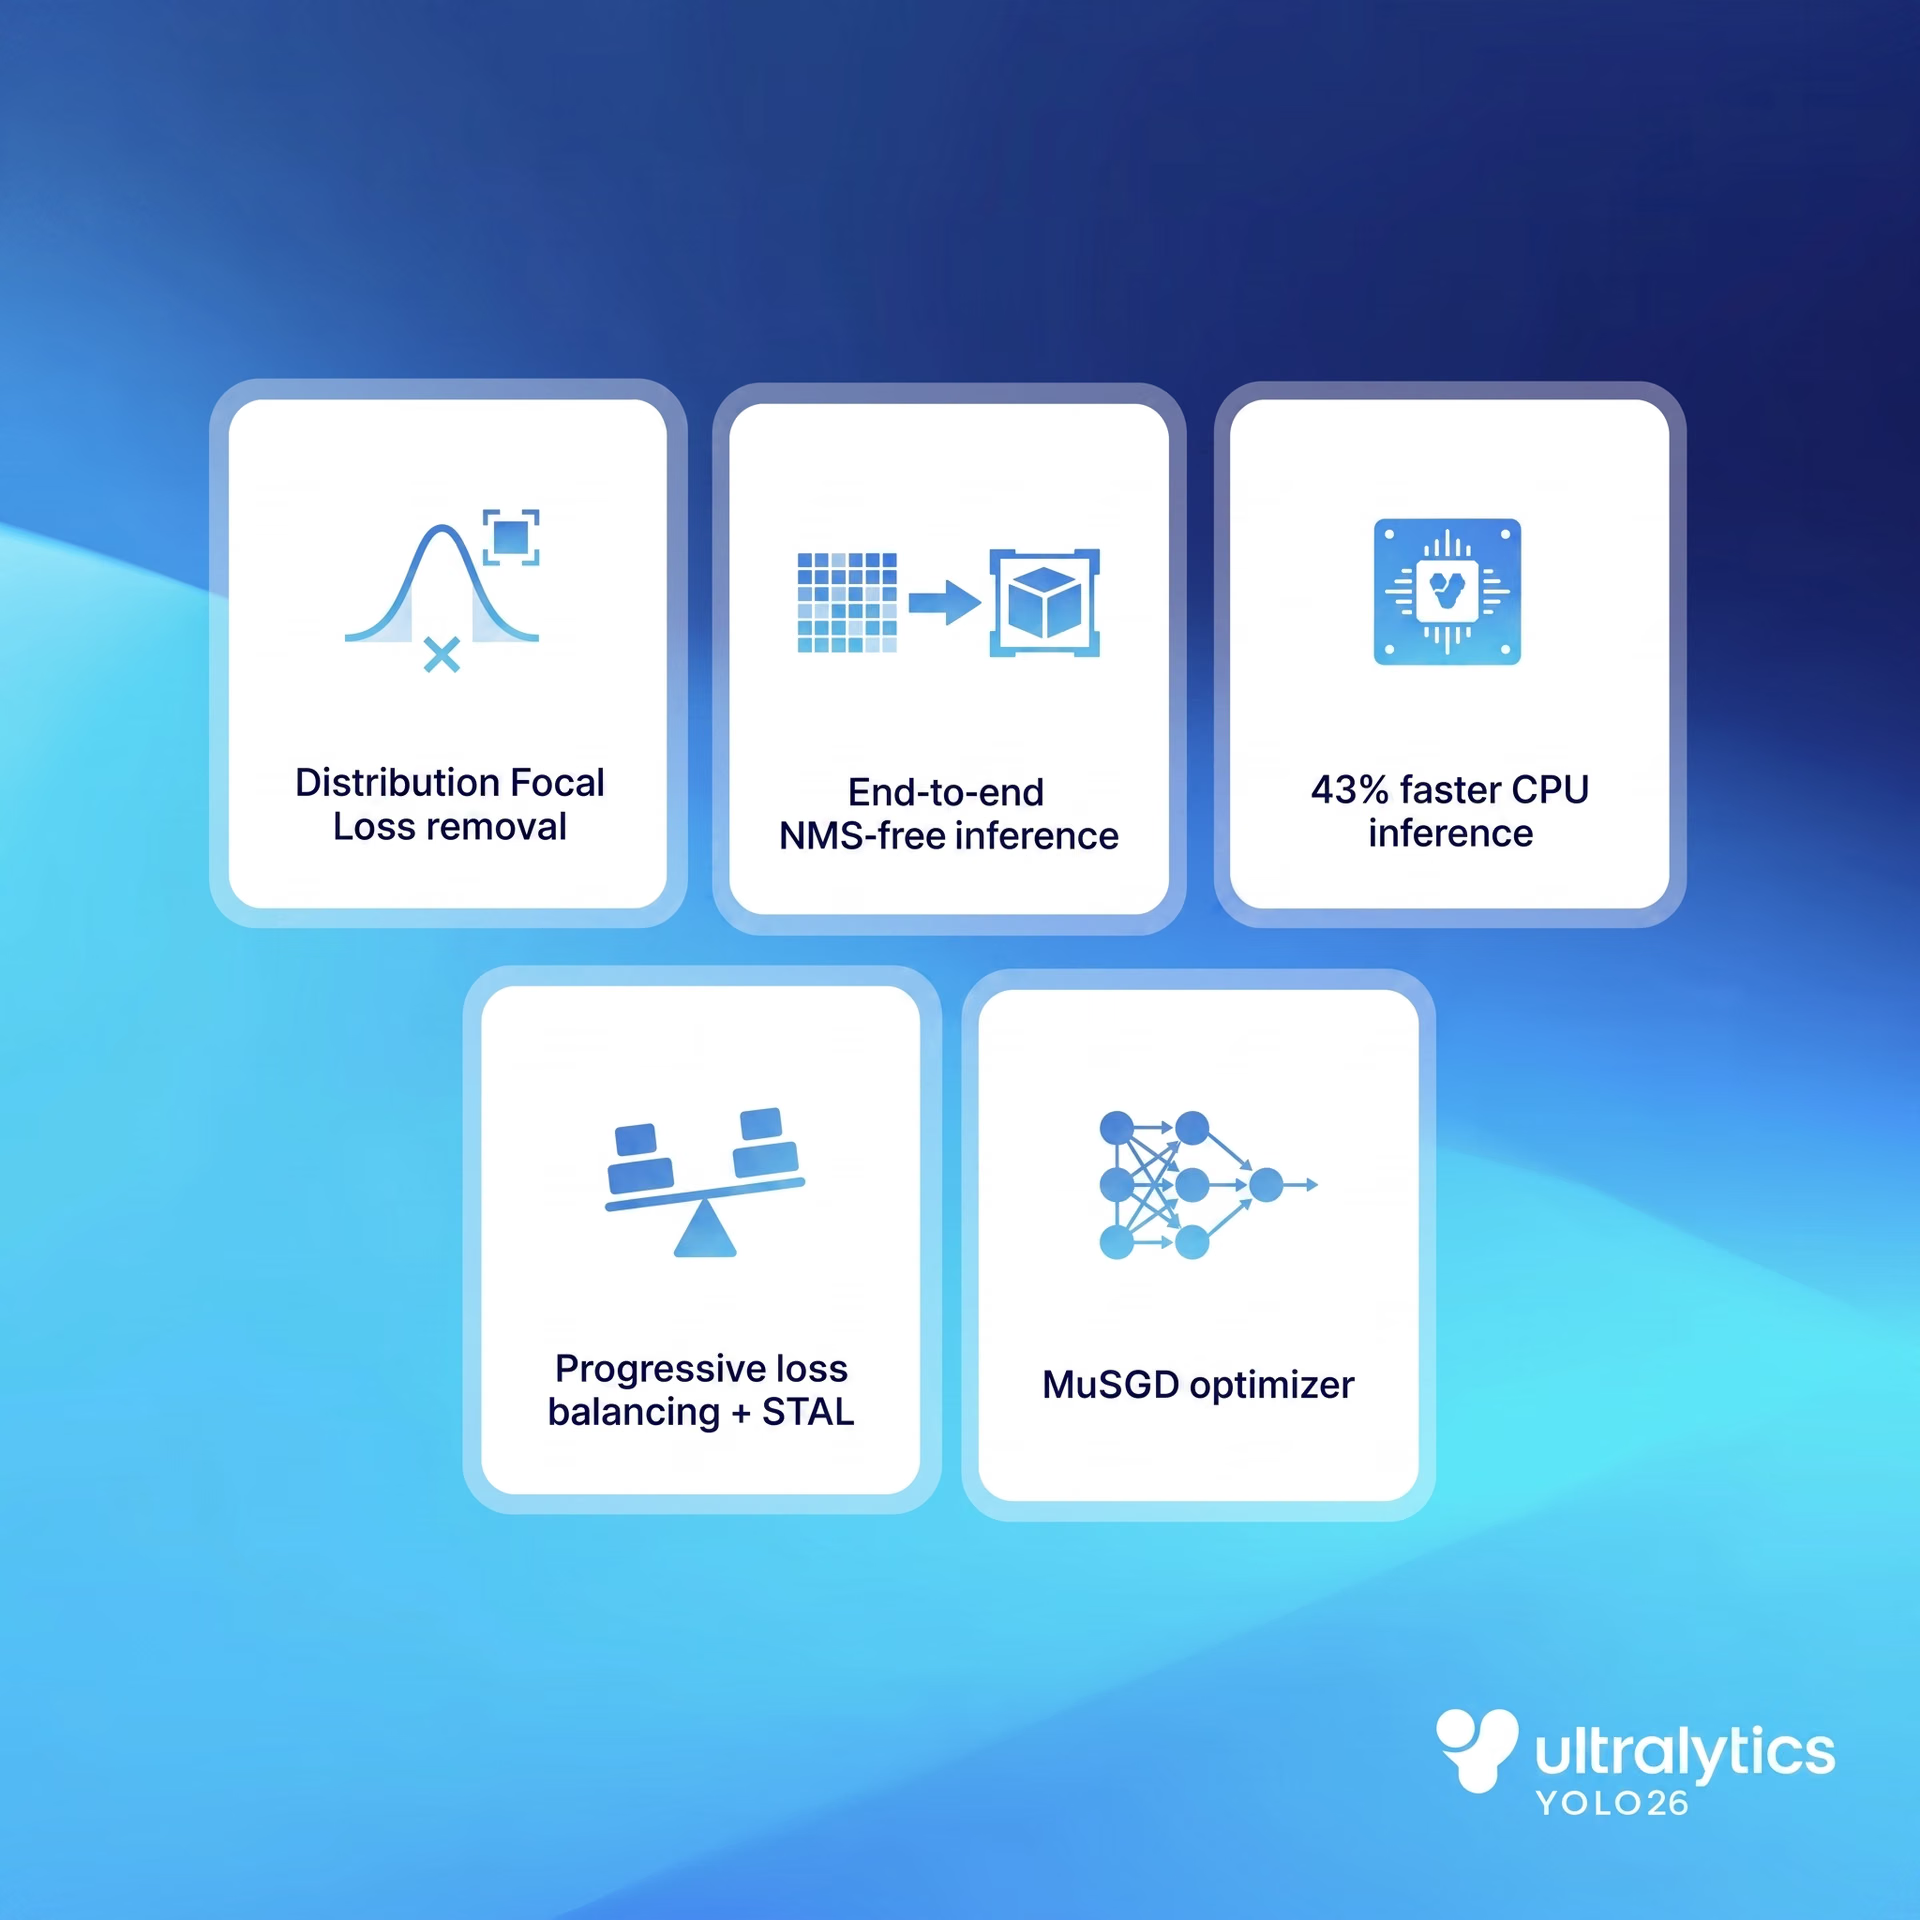
Fig. 4. Uno sguardo alle caratteristiche principali di YOLO26 (Fonte)
In pratica, rende molto più semplice portare la visione artificiale direttamente nei luoghi in cui viene effettivamente utilizzata. I modelli si addestrano in modo più prevedibile, si adattano con maggiore coerenza alle diverse dimensioni e sono più facili da adattare a nuovi dataset. Questo riduce gli ostacoli tra sperimentazione e distribuzione, soprattutto negli ambienti in cui affidabilità ed efficienza sono importanti quanto le prestazioni pure.
Per esempio, nelle applicazioni di robotica e visione industriale, spesso è necessario riaddestrare i modelli di frequente quando cambiano gli ambienti, i sensori o le attività. Con Ultralytics YOLO26, i team possono iterare più rapidamente senza preoccuparsi di sessioni di addestramento instabili o di comportamenti incoerenti tra modelli di dimensioni diverse.
Punti chiave#
L'affidabilità dei sistemi di visione artificiale dipende tanto dal modo in cui vengono addestrati i modelli quanto dalle loro prestazioni durante l'inferenza. Migliorando il bilanciamento dei segnali di apprendimento, la gestione degli oggetti piccoli e il processo di ottimizzazione, Ultralytics YOLO26 rende l'addestramento più stabile e facile da scalare. La ricetta di addestramento di YOLO26 documenta le impostazioni usate per i checkpoint ufficiali. L'attenzione all'affidabilità dell'addestramento aiuta i team a passare più agevolmente dalla sperimentazione alla distribuzione nel mondo reale, soprattutto nelle applicazioni progettate per dare priorità all'edge.
Vuoi saperne di più sull'IA? Visita il nostro repository GitHub per scoprire di più. Entra a far parte della nostra community attiva e scopri le innovazioni in settori come l'IA nella logistica e la visione artificiale nell'industria automobilistica. Per iniziare oggi con la visione artificiale, dai un'occhiata alle nostre opzioni di licenza.
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









