Sfruttare l’apprendimento per rinforzo nei progetti di visione artificiale
Scopri come funziona l'apprendimento per rinforzo e come si combina con la visione artificiale nei robot di magazzino, nei veicoli autonomi e nella robotica chirurgica, oltre ai relativi compromessi.
 Abirami Vina9 min di lettura
Un modo semplice per spiegare l’intelligenza artificiale (AI) è definirla come un campo che si concentra sulla riproduzione del modo in cui gli esseri umani pensano e apprendono. Da qui nasce l’idea delle tecniche di apprendimento nell’AI, ovvero metodi diversi che consentono alle macchine di migliorare le proprie prestazioni nel tempo, proprio come fanno le persone.
In precedenza abbiamo esaminato le principali tecniche di apprendimento dell’AI, tra cui l’apprendimento supervisionato, non supervisionato, per rinforzo e per trasferimento, e il ruolo importante che ciascuna svolge nell’aiutare i modelli AI a elaborare informazioni e prendere decisioni.
Oggi approfondiremo l'apprendimento per rinforzo, una tecnica che insegna ai sistemi di AI ad apprendere dall'esperienza interagendo con un ambiente e migliorando in base al feedback. In particolare, vedremo come applicare l'apprendimento per rinforzo alle applicazioni di visione artificiale, ovvero sistemi che consentono alle macchine di interpretare e comprendere le informazioni visive del mondo.
La combinazione di concetti come l’apprendimento per rinforzo e la computer vision apre nuove possibilità interessanti ed è un settore di ricerca attivo. Consente ai sistemi AI di riconoscere ciò che vedono e prendere decisioni informate sulla base delle informazioni visive.
Che cos’è l’apprendimento per rinforzo?#
L’apprendimento per rinforzo è un ramo del machine learning in cui un agente AI impara compiendo azioni e ricevendo feedback sotto forma di premi o penalità. L’obiettivo è capire quali azioni portano ai risultati migliori nel tempo.
Puoi immaginare l’apprendimento per rinforzo come l’addestramento di un cane. Quando il cane si siede a comando, gli dai un premio. Dopo un po’, il cane impara che sedersi porta a una ricompensa. Nell’apprendimento per rinforzo, l’agente o il modello AI è come il cane, l’ambiente è il mondo che lo circonda e la ricompensa gli permette di capire se ha fatto la scelta giusta.
È diverso dall’apprendimento supervisionato, in cui al modello AI vengono mostrati molti esempi con le risposte corrette. Ad esempio, al modello potrebbe essere mostrata l’immagine di un cane e potrebbe essergli detto: «Questo è un cane».
L’apprendimento per rinforzo, invece, non si basa su dati etichettati. Consiste piuttosto nell’imparare provando diverse azioni e apprendendo dai risultati, proprio come quando si gioca e si cerca di capire quali mosse aiutano a vincere.
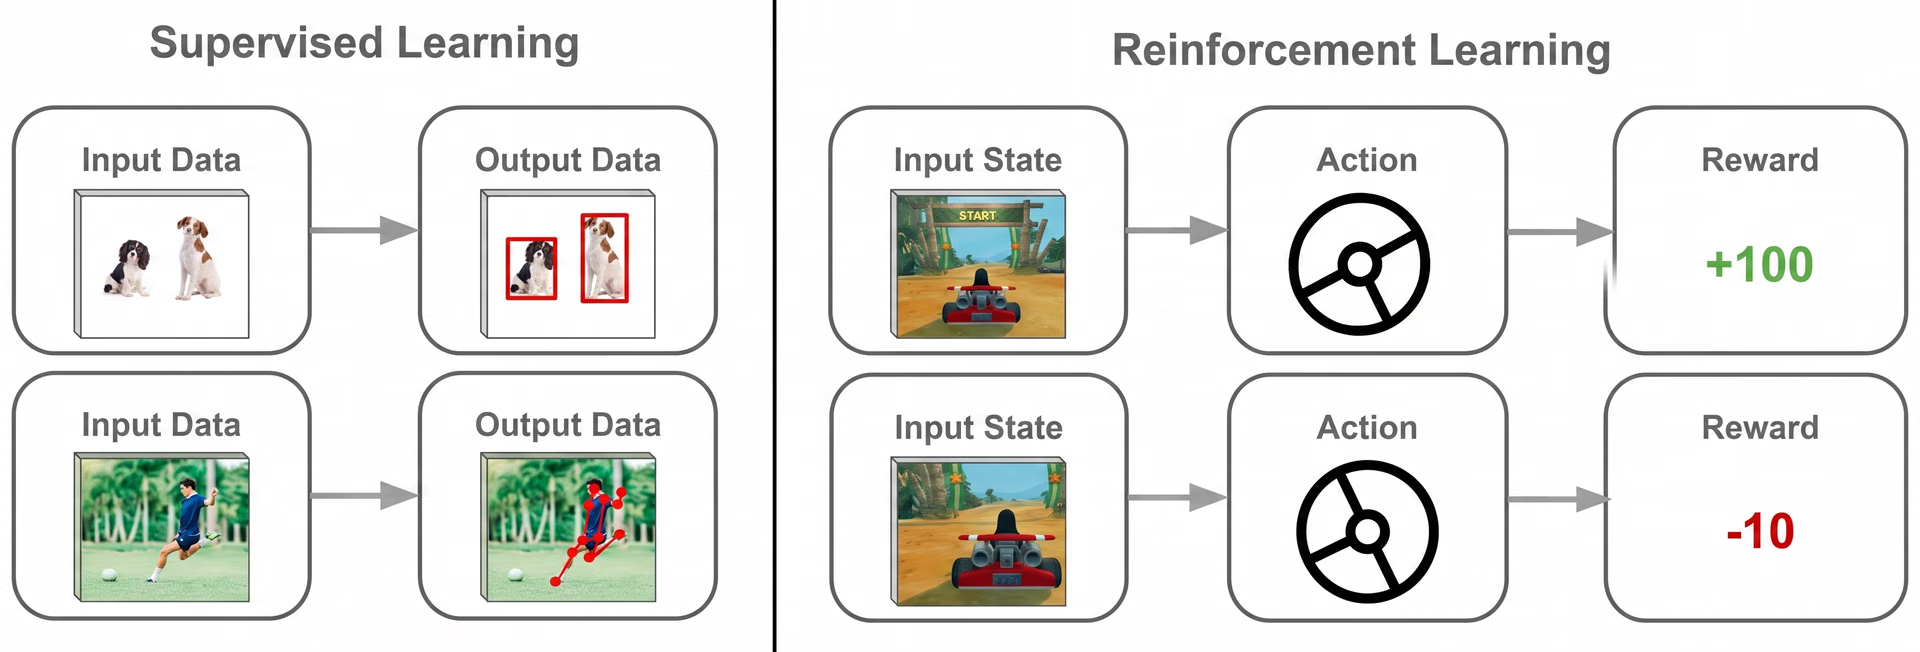
Fig 1. Apprendimento per rinforzo e apprendimento supervisionato a confronto.
L’apprendimento per rinforzo è fondamentale per le attività in cui le decisioni vengono prese passo dopo passo e ogni scelta modifica ciò che accade in seguito. Questo tipo di apprendimento viene utilizzato nei videogiochi strategici per rendere il gioco più impegnativo e coinvolgente per i giocatori.
Come funziona l’apprendimento per rinforzo nelle soluzioni AI#
Pensa a come impari ad andare in bicicletta. All’inizio potresti cadere. Ma con la pratica inizi a capire cosa ti aiuta a mantenere l’equilibrio. Più vai in bici, più diventi bravo. Impari facendo, non limitandoti a ricevere istruzioni.
L'apprendimento per rinforzo funziona in modo simile nell'AI. Si apprende dall'esperienza: provando azioni diverse, osservando cosa succede e migliorando gradualmente la capacità di fare le scelte giuste nel tempo.
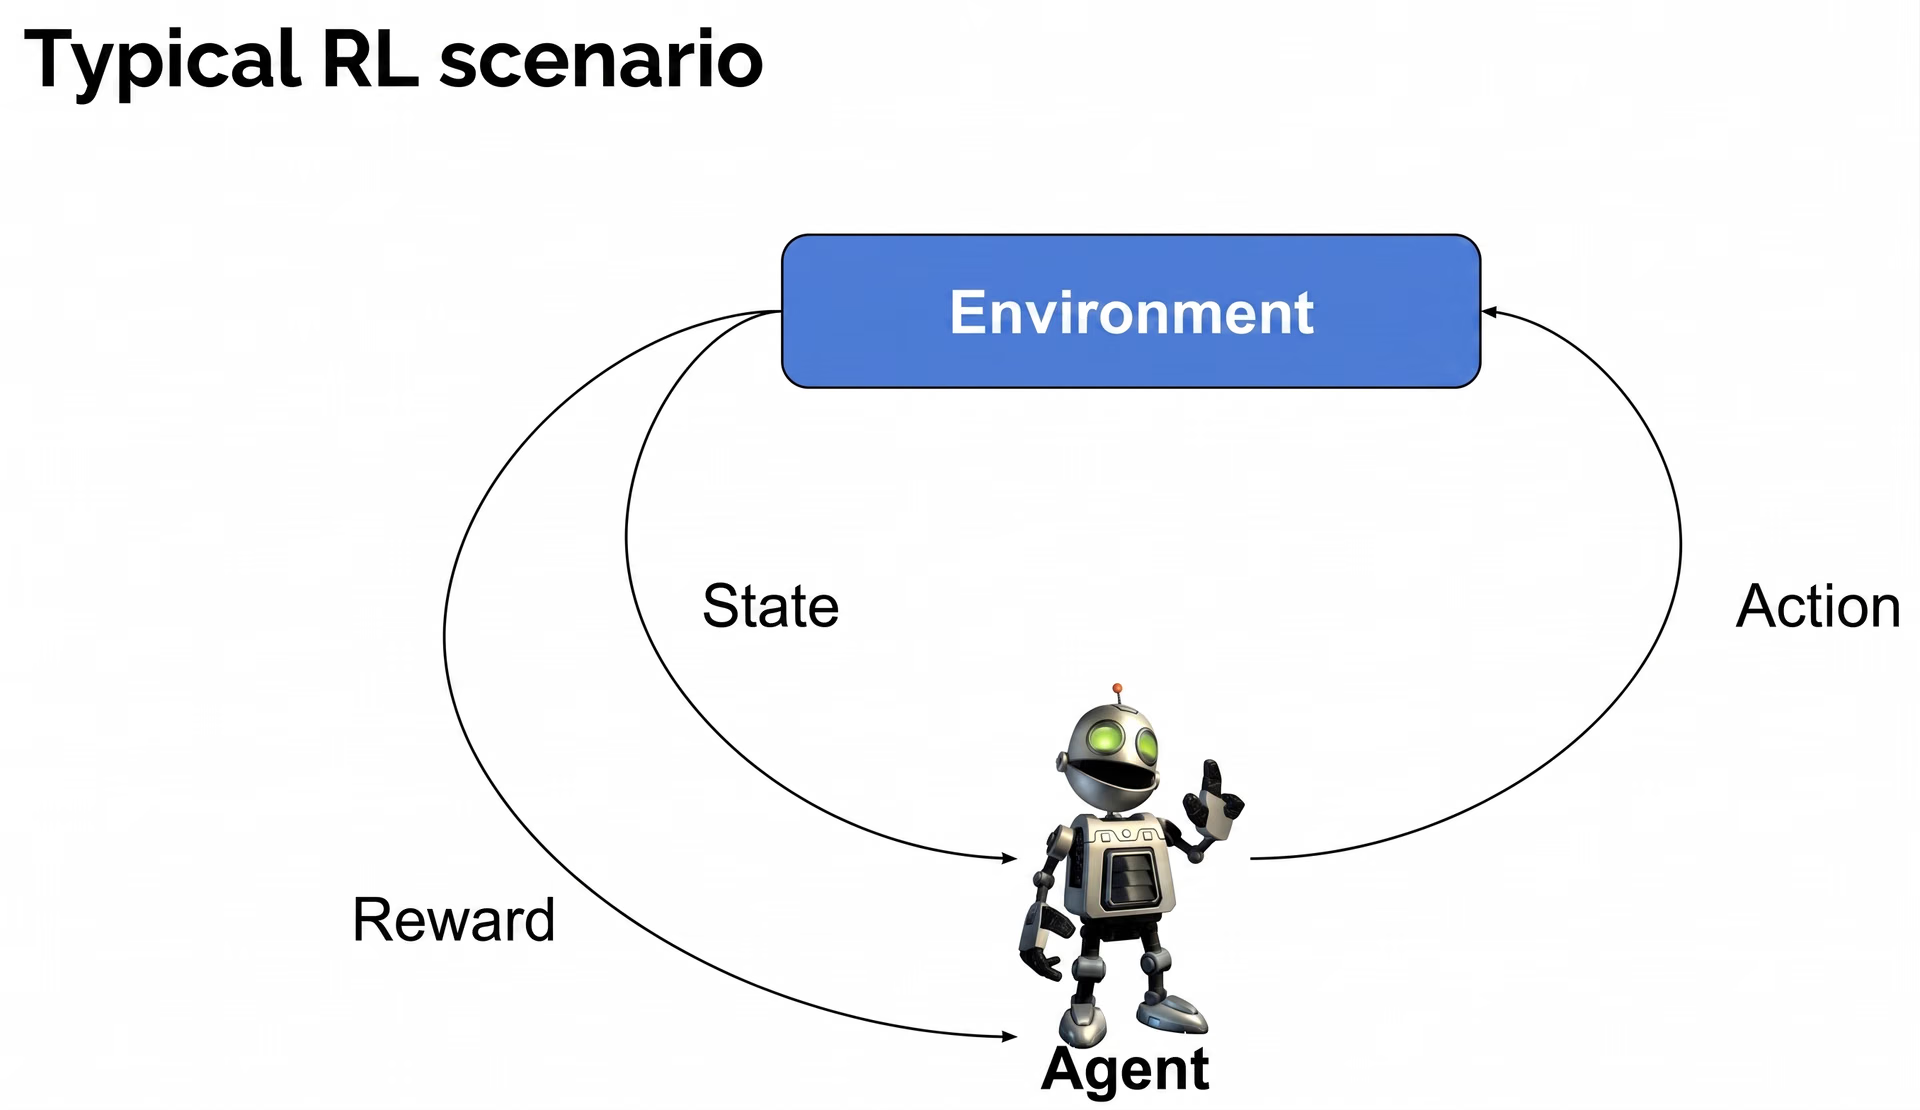
Fig 2. Come funziona l’apprendimento per rinforzo.
Ecco una panoramica di alcuni dei componenti chiave dell’apprendimento per rinforzo:
- Agente: L’agente è il soggetto che apprende o prende decisioni. Interagisce con l’ambiente compiendo azioni e mira a raggiungere un obiettivo specifico.
- Ambiente: L’ambiente comprende tutto ciò con cui l’agente interagisce. Cambia in risposta alle azioni dell’agente e fornisce un riscontro in base ai risultati.
- Stato: Uno stato rappresenta un’istantanea della situazione corrente nell’ambiente. L’agente osserva lo stato per comprendere ciò che lo circonda e determinare quale azione compiere in seguito.
- Azione: Un’azione è una mossa o una decisione dell’agente che influisce sull’ambiente. Ogni azione porta a un nuovo stato e può influenzare le ricompense future.
- Ricompensa: Una ricompensa è semplicemente un riscontro dell’ambiente che indica all’agente se la sua azione è stata vantaggiosa o meno. Le ricompense positive incoraggiano l’agente a ripetere le azioni efficaci, mentre quelle negative lo dissuadono da quelle poco efficaci.
- Politica: Una politica è la strategia che l’agente segue per scegliere le azioni in base allo stato corrente. Nel tempo, l’agente perfeziona la propria politica per massimizzare le ricompense totali che può ottenere.
Usando insieme questi componenti, l'apprendimento per rinforzo consente ai sistemi di AI di apprendere comportamenti efficaci attraverso tentativi ed errori continui. A ogni tentativo, l'agente migliora nella selezione delle azioni che portano a ricompense più elevate e a risultati migliori.
Innovazioni nell’apprendimento per rinforzo nella visione artificiale#
La visione artificiale viene utilizzata per attività come il rilevamento di oggetti nelle immagini, la classificazione di ciò che appare in una foto e la segmentazione di un’immagine in parti diverse. I modelli di visione artificiale come Ultralytics YOLO11 supportano queste attività e possono essere utilizzati per creare applicazioni d’impatto in grado di ricavare informazioni visive.
Tuttavia, quando queste attività di AI per la visione vengono combinate con l'apprendimento per rinforzo, si ottiene una soluzione di AI che non si limita a vedere: impara anche ad agire sulla base delle informazioni visive e migliora nel tempo.
Un esempio interessante di apprendimento per rinforzo nelle applicazioni di visione artificiale è l'uso di robot nei magazzini. I robot dotati di telecamere e sistemi di visione artificiale possono analizzare l'ambiente circostante, rilevare la posizione di ogni articolo, identificarne la forma e le dimensioni e capire come è collocato sullo scaffale.
Ogni volta che il robot tenta di raccogliere un articolo, riceve un feedback: il tentativo riesce se l'articolo viene raccolto correttamente, oppure fallisce se cade. Nel tempo, il robot impara quali azioni funzionano meglio per i diversi articoli. Invece di seguire una serie fissa di istruzioni, migliora continuamente grazie all'esperienza.
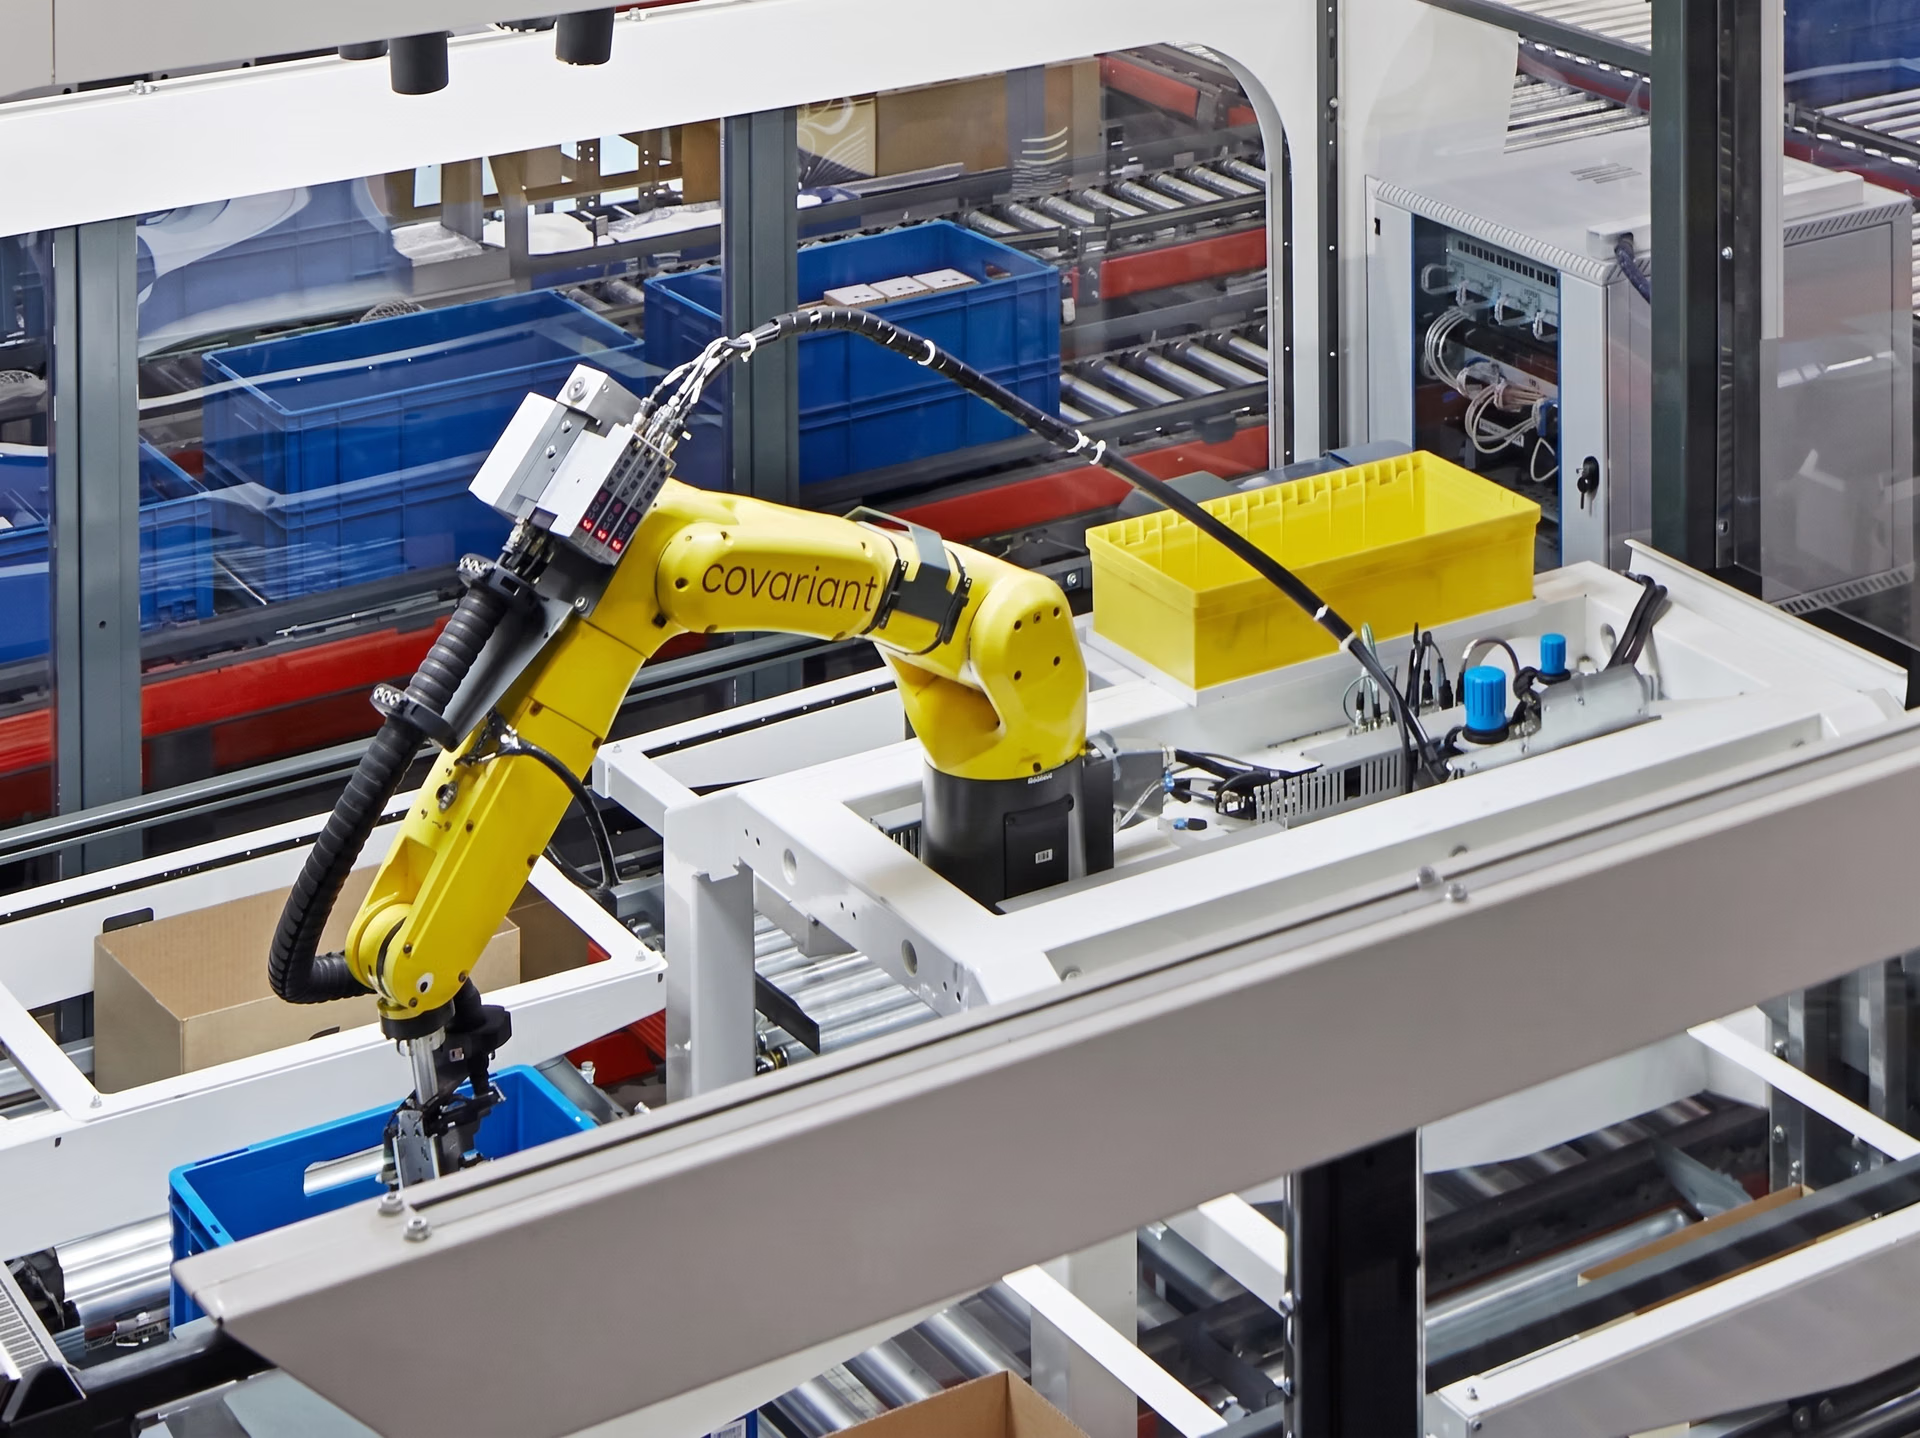
Fig. 3 Un braccio robotico che usa la Vision AI e l’apprendimento per rinforzo per raccogliere oggetti.
Applicazioni dell’apprendimento per rinforzo nella visione artificiale#
Ora che abbiamo capito meglio cos’è l’apprendimento per rinforzo e quale ruolo svolge nella visione artificiale, vediamo più da vicino alcuni esempi di applicazioni che combinano apprendimento per rinforzo e visione artificiale.
Integrare Vision AI e apprendimento per rinforzo per veicoli più intelligenti#
I veicoli autonomi possono affidarsi sia all'AI per la visione per comprendere l'ambiente circostante, sia all'apprendimento per rinforzo per prendere decisioni in base a ciò che vedono. AWS DeepRacer è un ottimo esempio di questa applicazione.
AWS DeepRacer è un’auto da corsa completamente autonoma in scala 1:18 che impara a guidare usando una telecamera e l’apprendimento per rinforzo. Invece di ricevere istruzioni su cosa fare, capisce come procedere da sola provando, commettendo errori e imparando da essi.
La telecamera di questa minuscola auto funziona come un paio di occhi e riprende il tracciato davanti a sé. In base a ciò che vede, l’auto impara a sterzare e a regolare la velocità. Migliora a ogni giro. Per esempio, può imparare ad affrontare le curve più larghe o a rallentare prima delle curve strette, facendo tesoro dei tentativi precedenti.
L’addestramento di DeepRacer inizia in un ambiente virtuale, dove il modello si esercita e affina le proprie abilità di guida. Una volta raggiunto un determinato livello di prestazioni, queste abilità vengono trasferite ai circuiti reali con auto fisiche.
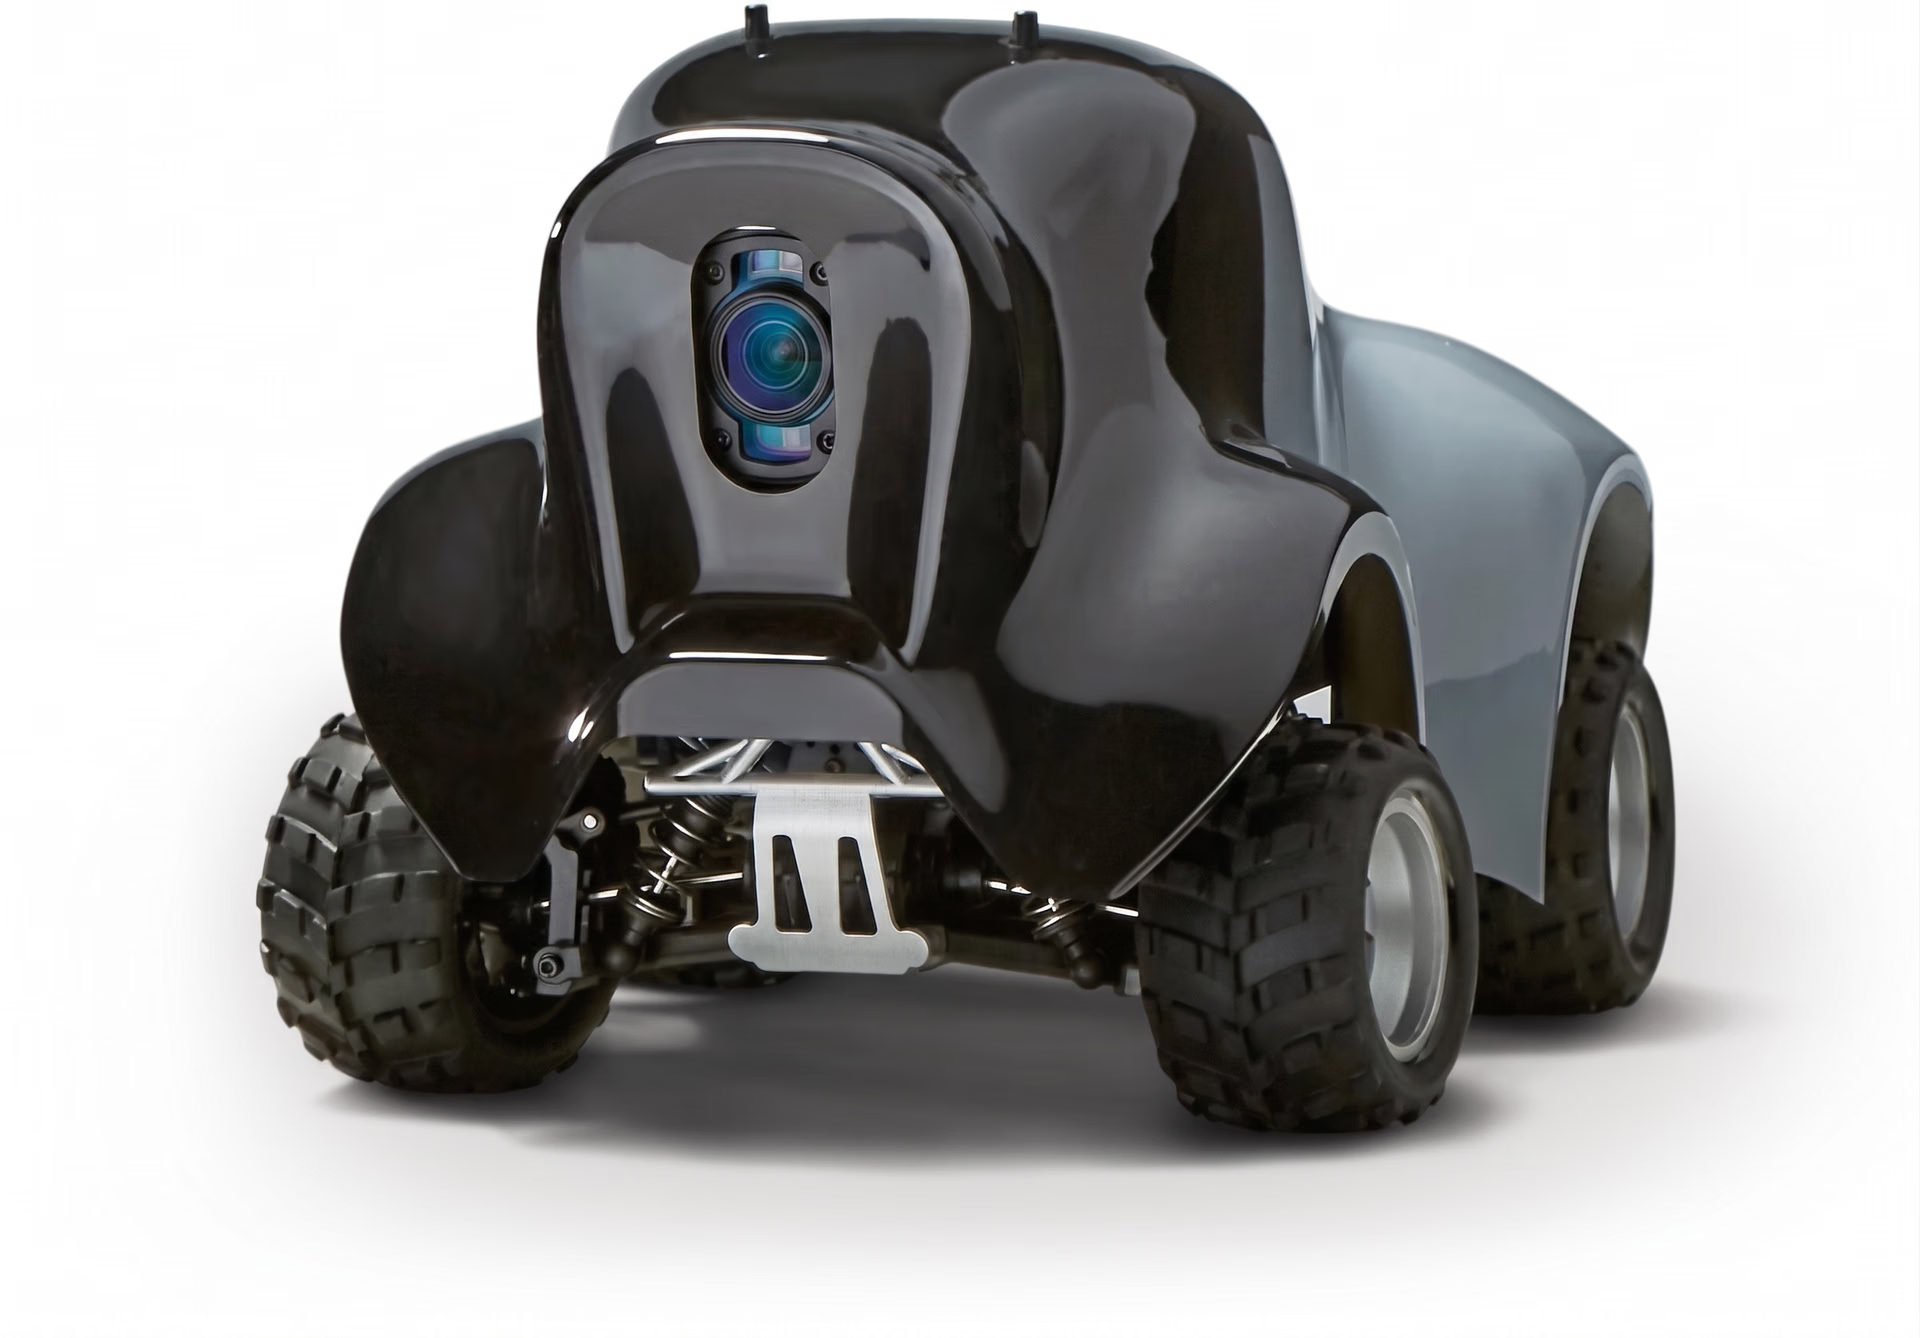
Fig. 4 AWS DeepRacer usa la visione artificiale e l’apprendimento per rinforzo per guidare in autonomia. Fonte dell’immagine: Amazon.
Verso robot chirurgici autonomi#
Un ambito di ricerca promettente che sta attirando l'attenzione è l'integrazione dell'AI per la visione e dell'apprendimento per rinforzo nella chirurgia robotica. Al momento, questa applicazione è ancora in gran parte teorica. I ricercatori stanno eseguendo simulazioni in ambienti virtuali.
Tuttavia, i primi esperimenti stanno dando risultati promettenti e suggeriscono che, in futuro, i robot chirurgici potrebbero eseguire procedure complesse e delicate con maggiore precisione, adattabilità e un intervento umano minimo.
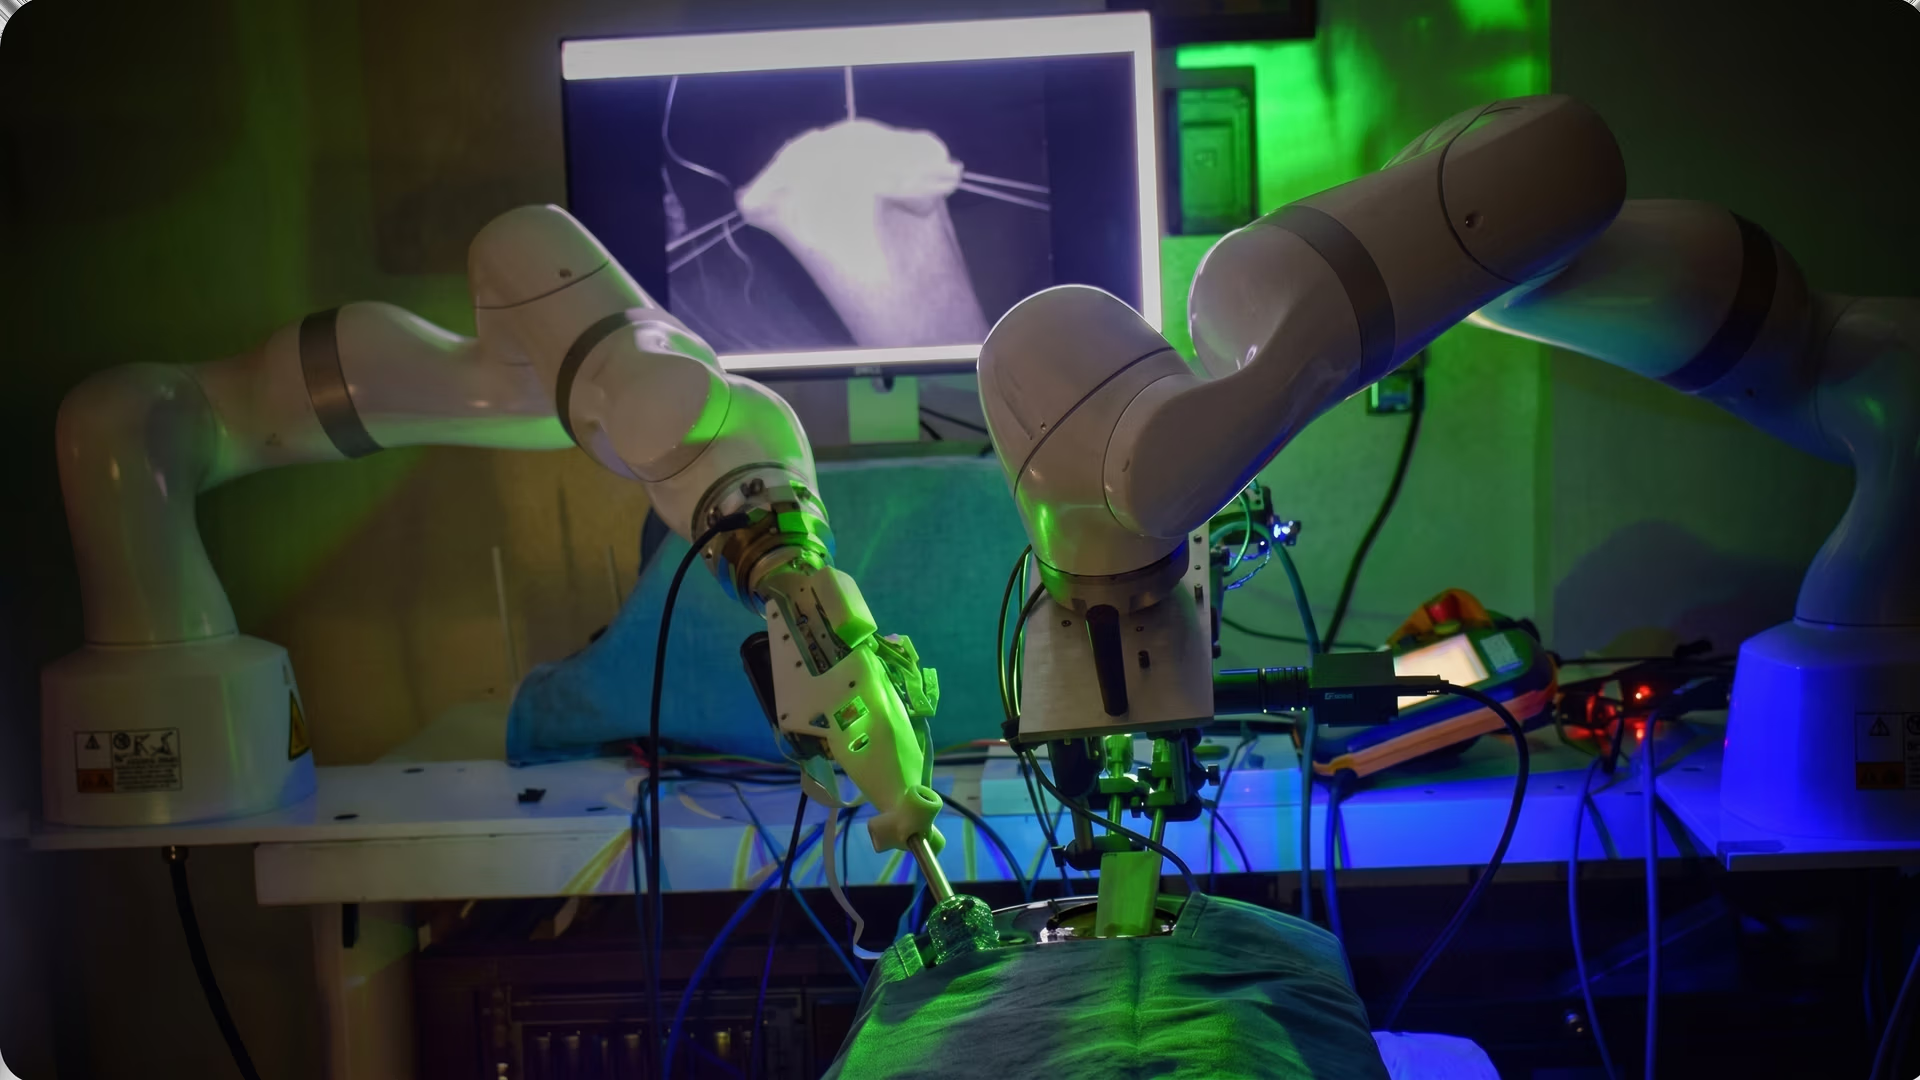
Fig. 5 I robot chirurgici diventano sempre più avanzati.
Ad esempio, immagina una situazione in cui occorre sollevare con cautela una garza da un sito chirurgico. Un robot dotato di AI per la visione analizzerebbe prima la scena, usando la segmentazione per identificare la garza e i tessuti circostanti.
L’apprendimento per rinforzo aiuterebbe quindi il robot chirurgico a decidere come affrontare il compito, determinando l’angolazione migliore per afferrare la garza, la pressione da applicare e il modo di sollevarla senza interferire con le aree sensibili vicine. Nel tempo e con esercitazioni ripetute in ambienti simulati, il robot potrebbe imparare a eseguire questi movimenti delicati e critici con abilità e sicurezza sempre maggiori.
Vantaggi e svantaggi dell’apprendimento per rinforzo nella Vision AI#
L'apprendimento per rinforzo consente ai sistemi di AI per la visione di andare oltre il semplice riconoscimento e iniziare a prendere decisioni in base a ciò che vedono. Questo apre nuove possibilità in ambiti come la robotica, l'automazione e l'interazione in tempo reale.
Ecco alcuni dei principali vantaggi dell'integrazione dell'apprendimento per rinforzo nei flussi di lavoro dell'AI per la visione:
- Minore dipendenza dai dati etichettati: Questi sistemi possono apprendere interagendo, quindi non hanno bisogno di enormi set di dati etichettati per iniziare.
- Gestisce meglio l’incertezza: L’apprendimento per rinforzo può gestire informazioni visive incomplete o rumorose adattando le azioni in base al riscontro, anziché affidarsi solo a dati perfetti.
- Favorisce l’apprendimento a lungo termine: Aiuta i modelli a migliorare nel tempo apprendendo da sequenze di azioni, anziché da decisioni isolate.
D’altra parte, ecco alcuni limiti dell’apprendimento per rinforzo da tenere in considerazione:
- Problema dell’assegnazione del credito: Può essere difficile per l’agente capire quali azioni specifiche abbiano contribuito al risultato finale, soprattutto nelle sequenze decisionali lunghe.
- Rischio di esplorazione non sicura: Durante l’addestramento, l’agente potrebbe tentare azioni pericolose o indesiderate, inaccettabili in applicazioni reali come la sanità o la guida autonoma.
- Convergenza lenta: Il modello può impiegare molto tempo per raggiungere prestazioni soddisfacenti, soprattutto nelle attività complesse prestazioni.
Punti chiave#
L’apprendimento per rinforzo nei progetti di visione artificiale consente ai sistemi di IA di comprendere l’ambiente circostante e imparare ad agire attraverso l’esperienza. Con modelli come Ultralytics YOLO11 che offrono il rilevamento di oggetti in tempo reale, il sistema può prendere decisioni informate in base a ciò che vede.
Questo approccio supera i metodi tradizionali, consentendo all'AI di migliorare attraverso tentativi e feedback invece di affidarsi esclusivamente a dati etichettati. Favorisce l'apprendimento continuo e contribuisce a creare sistemi di AI per la visione più flessibili, adattabili e intelligenti, che migliorano nel tempo.
Unisciti alla nostra community in crescita. Visita il nostro repository GitHub per approfondire l'AI. Vuoi avviare i tuoi progetti di visione artificiale? Scopri le nostre opzioni di licenza. Scopri di più sull'AI nel settore manifatturiero e sull'AI per la visione nel settore automobilistico nelle nostre pagine delle soluzioni.
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









