I 5 migliori consigli per eseguire il deployment di YOLO26 in modo efficiente su edge e cloud
Scopri i 5 principali consigli pratici per eseguire il deployment di Ultralytics YOLO26 in modo efficiente su edge e cloud, dalla scelta del workflow e del formato di esportazione fino alla quantizzazione.
Il mese scorso, Ultralytics ha lanciato ufficialmente Ultralytics YOLO26, stabilendo un nuovo standard per l'IA per la visione, un ramo dell'intelligenza artificiale che consente alle macchine di interpretare e comprendere le informazioni visive provenienti da immagini e video. Anziché limitarsi a catturare filmati, i modelli di visione artificiale come i modelli Ultralytics YOLO supportano attività di visione quali il rilevamento degli oggetti, la segmentazione delle istanze, la stima della posa e la classificazione delle immagini.
Progettato per gli ambienti in cui la visione artificiale viene effettivamente eseguita, ovvero dispositivi, telecamere, robot e sistemi di produzione, Ultralytics YOLO26 è un modello all'avanguardia che offre inferenza più rapida sull'unità di elaborazione centrale (CPU), implementazione semplificata e prestazioni efficienti end-to-end in ambienti reali. I modelli YOLO26 sono stati inoltre progettati per facilitare il passaggio delle soluzioni di visione artificiale dalla sperimentazione alla produzione.
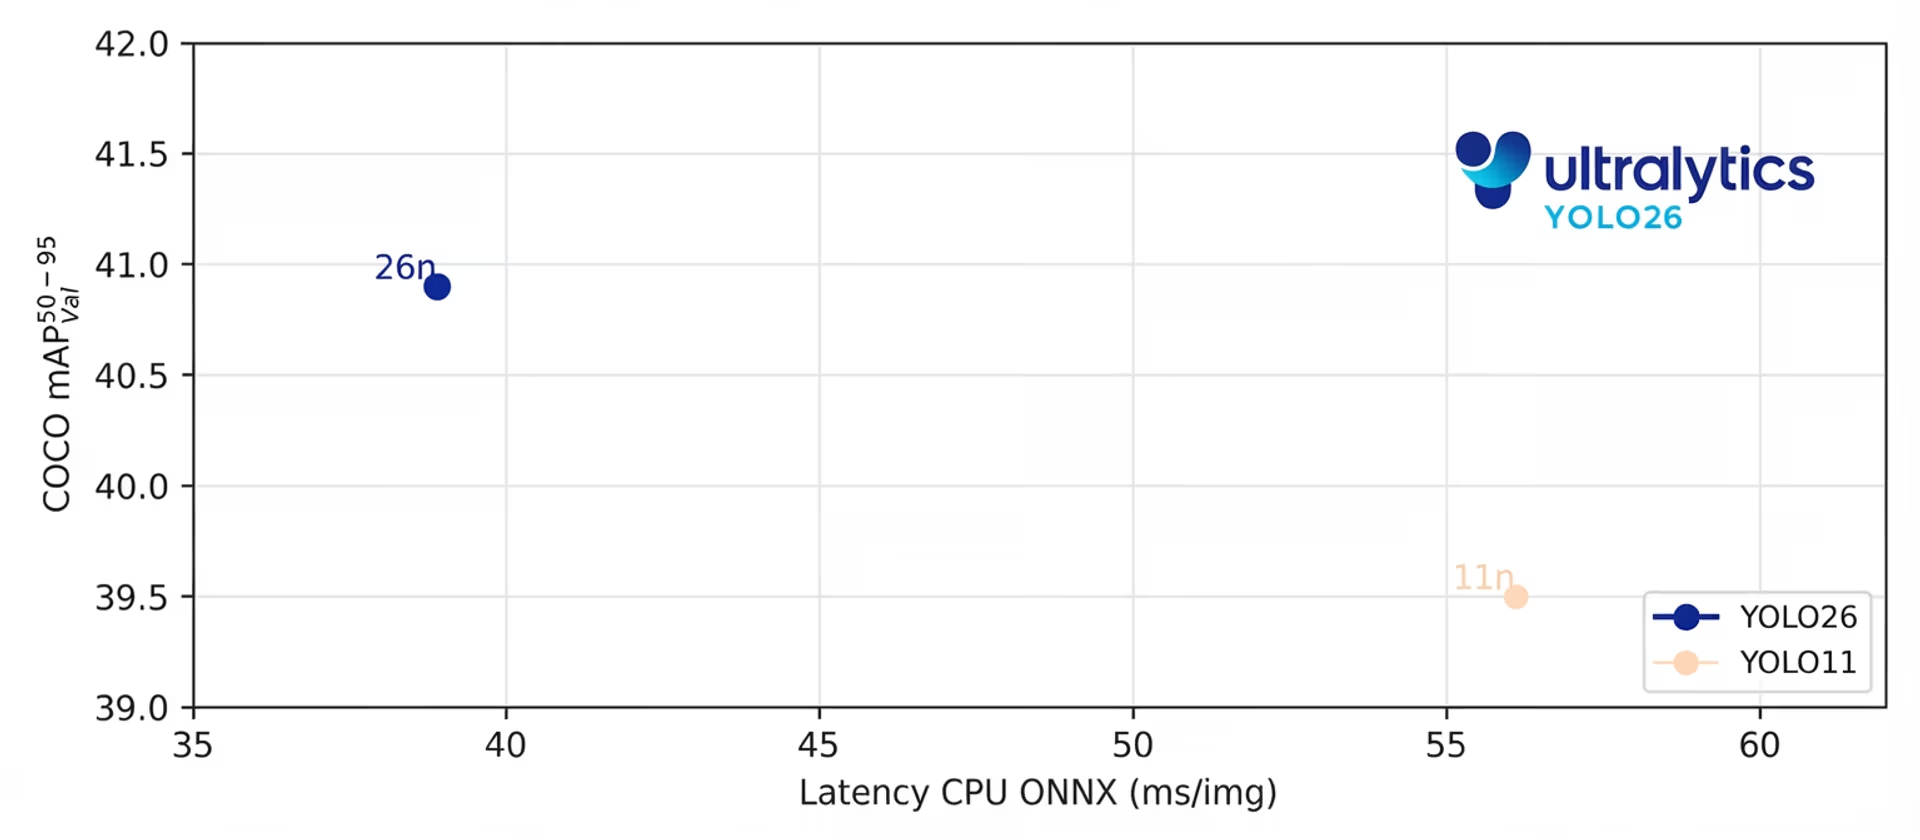
Fig. 1. Il modello nano YOLO26 offre un'inferenza su CPU fino al 43% più rapida rispetto a YOLO11. (Fonte)
L'implementazione dei modelli comporta in genere diverse considerazioni, come la scelta dell'hardware giusto, la selezione di un formato di esportazione appropriato, l'ottimizzazione delle prestazioni e la convalida dei risultati in condizioni reali. Affrontare questi passaggi durante l'implementazione di YOLO26 è semplice grazie al pacchetto Python di Ultralytics, che semplifica l'addestramento, l'inferenza e l'esportazione dei modelli per più destinazioni di implementazione.
Tuttavia, anche con flussi di lavoro semplificati, è fondamentale prendere le decisioni giuste in materia di implementazione. In questo articolo esamineremo cinque consigli pratici per aiutarti a implementare Ultralytics YOLO26 in modo efficiente in ambienti edge e cloud, garantendo prestazioni di IA per la visione affidabili e scalabili in produzione. Iniziamo!
Che cos'è l'implementazione dei modelli nella visione artificiale?#
Prima di esaminare le strategie di implementazione per Ultralytics YOLO26, facciamo un passo indietro e cerchiamo di capire cosa significa implementazione dei modelli nella visione artificiale.
L'implementazione dei modelli è il processo di trasferimento di un modello di deep learning addestrato da un ambiente di sviluppo a un'applicazione reale, dove può elaborare nuove immagini o flussi video e generare continuamente previsioni. Anziché eseguire esperimenti su dataset statici, il modello diventa parte di un sistema operativo in tempo reale.
Nella visione artificiale, ciò significa spesso integrare il modello con telecamere, dispositivi di IA edge, API o infrastrutture cloud. Il modello deve operare entro i limiti dell'hardware, soddisfare i requisiti di latenza e mantenere prestazioni costanti in condizioni reali variabili.
Comprendere questo passaggio dalla sperimentazione alla produzione è essenziale, perché le decisioni relative all'implementazione influiscono direttamente sulle prestazioni del modello al di fuori di un laboratorio o di una configurazione sperimentale.
Comprendere i flussi di lavoro per l'implementazione di Ultralytics YOLO26#
Vediamo ora in cosa consiste effettivamente un flusso di lavoro per l'implementazione di Ultralytics YOLO26. In parole semplici, è la sequenza di passaggi che porta un'immagine dall'acquisizione all'analisi e alla trasformazione in una previsione.
In una configurazione tipica, una telecamera acquisisce un'immagine o un fotogramma video. I dati vengono quindi preelaborati, ad esempio ridimensionandoli o formattandoli correttamente, prima di essere passati a Ultralytics YOLO26 per l'inferenza.
Il modello analizza l'input e produce output come riquadri di delimitazione, maschere di segmentazione o punti chiave. Questi risultati possono quindi essere utilizzati per attivare azioni, come l'invio di avvisi, l'aggiornamento di una dashboard o la guida di un sistema robotico.
Il luogo in cui viene eseguito questo flusso di lavoro dipende dalla tua strategia di implementazione. Ad esempio, in un'implementazione edge, l'inferenza avviene direttamente sul dispositivo o vicino alla telecamera, contribuendo a ridurre la latenza e migliorare la privacy dei dati.
In un'implementazione cloud, invece, le immagini o i fotogrammi video vengono inviati a server remoti per l'elaborazione, consentendo una maggiore scalabilità e una gestione centralizzata. Alcuni sistemi adottano un approccio ibrido, eseguendo un'elaborazione leggera sull'edge e carichi di lavoro più pesanti nel cloud.
Esplorare le varianti dei modelli Ultralytics YOLO26#
Per prendere decisioni informate sull'implementazione, è importante capire anche che puoi scegliere tra diverse varianti dei modelli Ultralytics YOLO26.
I modelli Ultralytics YOLO sono disponibili subito in più dimensioni, semplificando la scelta della versione più adatta al tuo hardware e ai tuoi requisiti di prestazioni. YOLO26 è disponibile in cinque varianti: Nano (n), Small (s), Medium (m), Large (l) ed Extra Large (x).
I modelli più piccoli, come YOLO26n, sono ottimizzati per l'efficienza e sono ideali per dispositivi edge, dispositivi dell'Internet delle cose (IoT), sistemi embedded e sistemi basati su una CPU, dove sono importanti una bassa latenza e un minore consumo energetico. Offrono prestazioni elevate mantenendo al minimo l'utilizzo delle risorse.
I modelli più grandi, come YOLO26l e YOLO26x, sono progettati per offrire una maggiore accuratezza e gestire scene più complesse. Queste varianti offrono in genere le prestazioni migliori sui sistemi dotati di unità di elaborazione grafica (GPUs) o negli ambienti cloud, dove sono disponibili maggiori risorse di calcolo.
La scelta della dimensione del modello dipende dai tuoi obiettivi di implementazione. Se velocità ed efficienza su hardware con risorse limitate sono le tue priorità principali, una variante più piccola potrebbe essere ideale. Se la tua applicazione richiede la massima accuratezza e hai accesso a hardware più potente, un modello più grande potrebbe essere la scelta migliore.
Consigli per implementare Ultralytics YOLO26 in modo efficiente#
Ora che comprendiamo meglio le varianti dei modelli Ultralytics YOLO26 e i flussi di lavoro per l'implementazione, esploriamo alcuni consigli pratici per implementare YOLO26 in modo efficiente negli ambienti edge e cloud.
Consiglio 1: valuta le opzioni di implementazione del modello#
Una delle prime decisioni da prendere durante l'implementazione di Ultralytics YOLO26 riguarda il luogo in cui verrà eseguito il modello. L'ambiente di implementazione influisce direttamente su prestazioni, latenza, privacy e scalabilità.
Inizia valutando il tuo flusso di lavoro. La tua applicazione richiede una bassa latenza, ovvero previsioni generate quasi istantaneamente dopo l'acquisizione di un'immagine?
Ad esempio, nella robotica o nei sistemi di sicurezza, anche piccoli ritardi possono influire sulle prestazioni. In questi casi, un'implementazione edge è spesso l'opzione migliore. Eseguire l'inferenza direttamente su un dispositivo o vicino alla telecamera riduce il tempo necessario per elaborare i dati ed evita di inviare le immagini tramite Internet, migliorando anche la privacy.
D'altra parte, l'implementazione cloud offre maggiore scalabilità e potenza di calcolo. I server cloud possono elaborare grandi volumi di immagini, gestire più flussi video e supportare un throughput maggiore.
Ad esempio, in agricoltura, un agricoltore potrebbe raccogliere migliaia di immagini di foglie e analizzarle in batch per determinare se le colture mostrano segni di malattia. In questo tipo di scenario, le prestazioni immediate in tempo reale potrebbero non essere necessarie, rendendo l'elaborazione cloud una scelta pratica e scalabile.
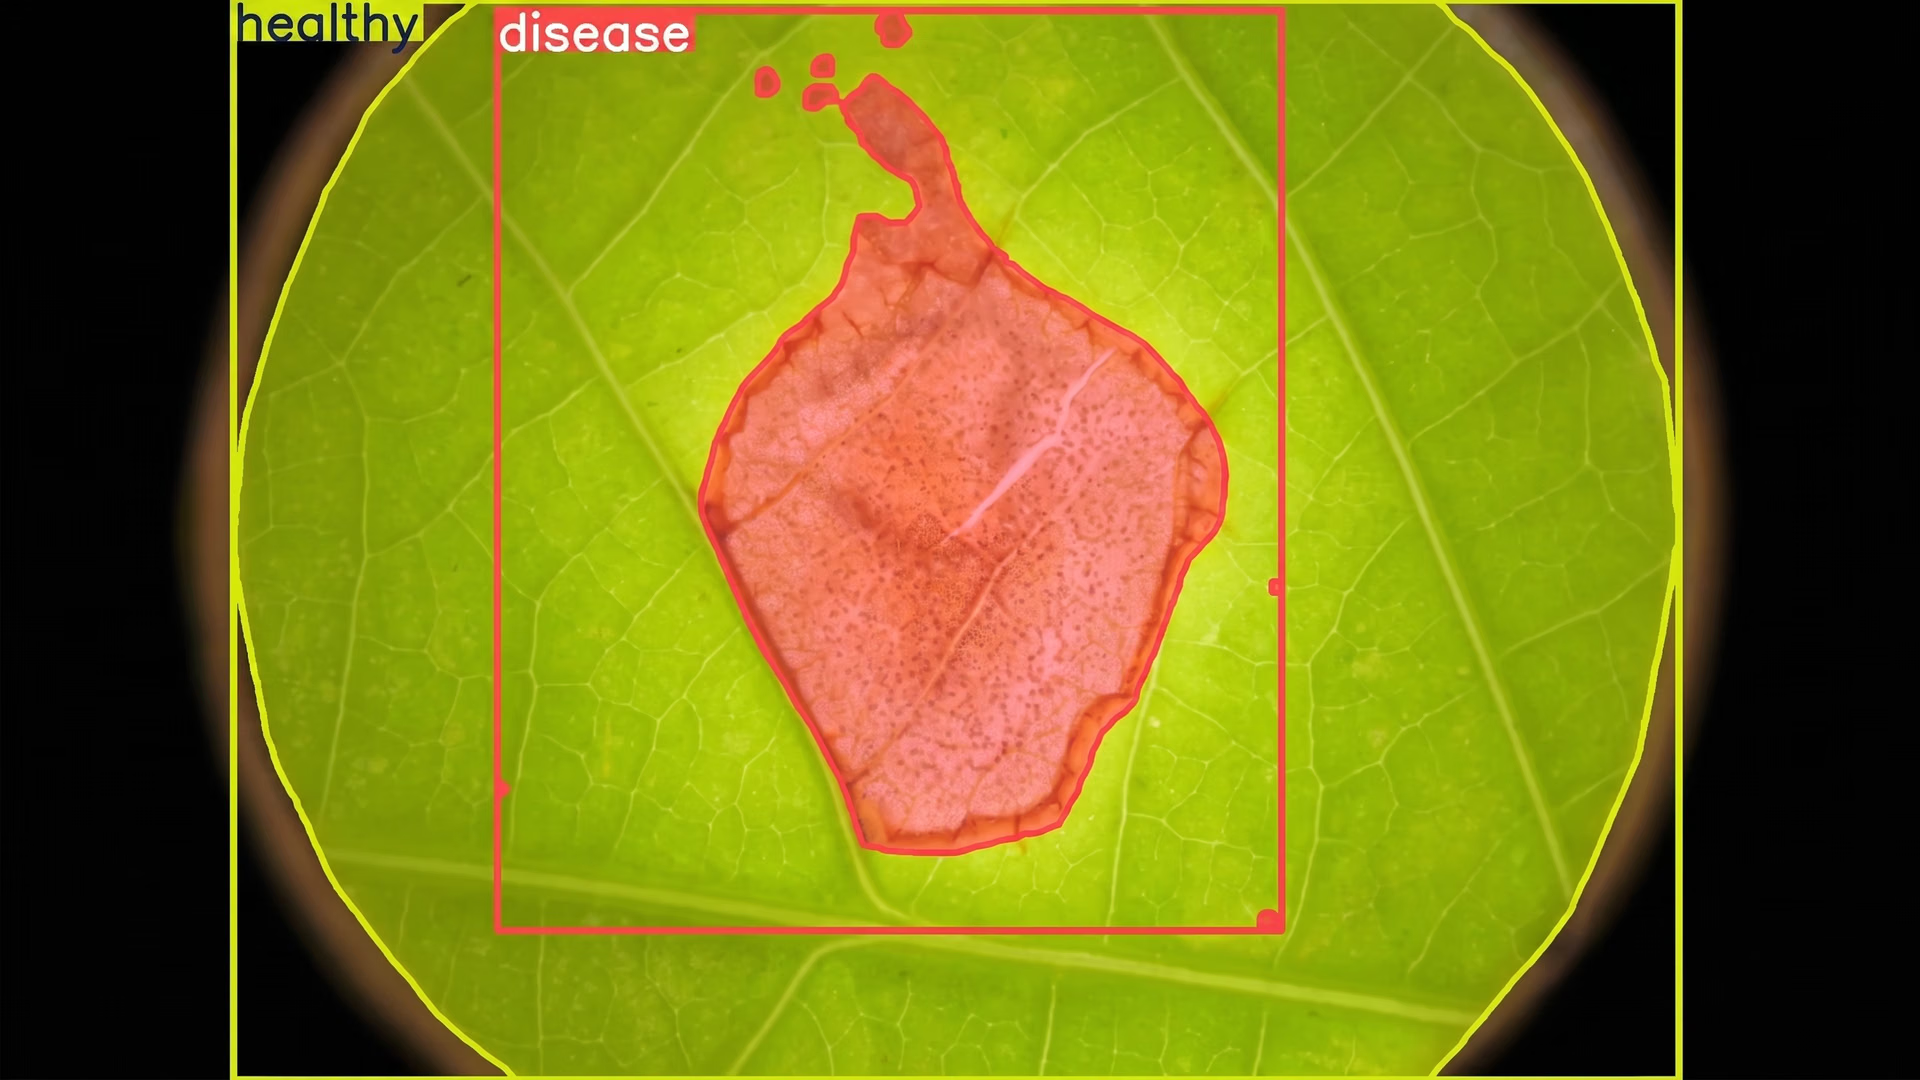
Fig. 2. Un esempio di utilizzo di Ultralytics YOLO26 per analizzare immagini di foglie
Tuttavia, l'invio dei dati a server remoti introduce latenza di rete, ovvero il ritardo causato dalla trasmissione delle immagini via Internet e dalla ricezione delle previsioni. Per le applicazioni non sensibili al fattore tempo, questo compromesso può essere accettabile.
Esistono anche opzioni intermedie tra edge puro e cloud puro. Alcune aziende utilizzano infrastrutture on-premise situate vicino al luogo in cui vengono generati i dati. Altre realizzano pipeline ibride, eseguendo un filtraggio leggero sull'edge e inviando i dati selezionati al cloud per un'analisi più approfondita.
La scelta dell'opzione di implementazione giusta dipende dai requisiti della tua applicazione. Definendo chiaramente le tue esigenze in termini di velocità, privacy e scalabilità, puoi selezionare una strategia che garantisca prestazioni affidabili di Ultralytics YOLO26 in condizioni reali.
Consiglio 2: scegli il formato di esportazione adatto al tuo hardware#
Dopo aver deciso dove verrà eseguito il modello, il passaggio successivo consiste nello scegliere il formato di esportazione giusto. Esportare un modello significa convertirlo dal formato utilizzato durante l'addestramento a un formato ottimizzato per l'implementazione.
I modelli Ultralytics YOLO26 vengono creati e addestrati nativamente in PyTorch, ma gli ambienti di produzione spesso si affidano a runtime specializzati, più adatti a hardware specifici. Questi runtime sono progettati per migliorare la velocità di inferenza, ridurre l'utilizzo della memoria e garantire la compatibilità con il dispositivo di destinazione.
Convertire YOLO26 nel formato appropriato consente di eseguirlo in modo efficiente al di fuori dell'ambiente di addestramento. Il pacchetto Python di Ultralytics rende questo processo semplice. Supporta un'ampia gamma di integrazioni per creare e implementare progetti di visione artificiale.
Se vuoi esplorare queste integrazioni più in dettaglio, puoi consultare la documentazione ufficiale di Ultralytics. Include tutorial passo passo, indicazioni specifiche per l'hardware ed esempi pratici per aiutarti a passare dallo sviluppo alla produzione con sicurezza.
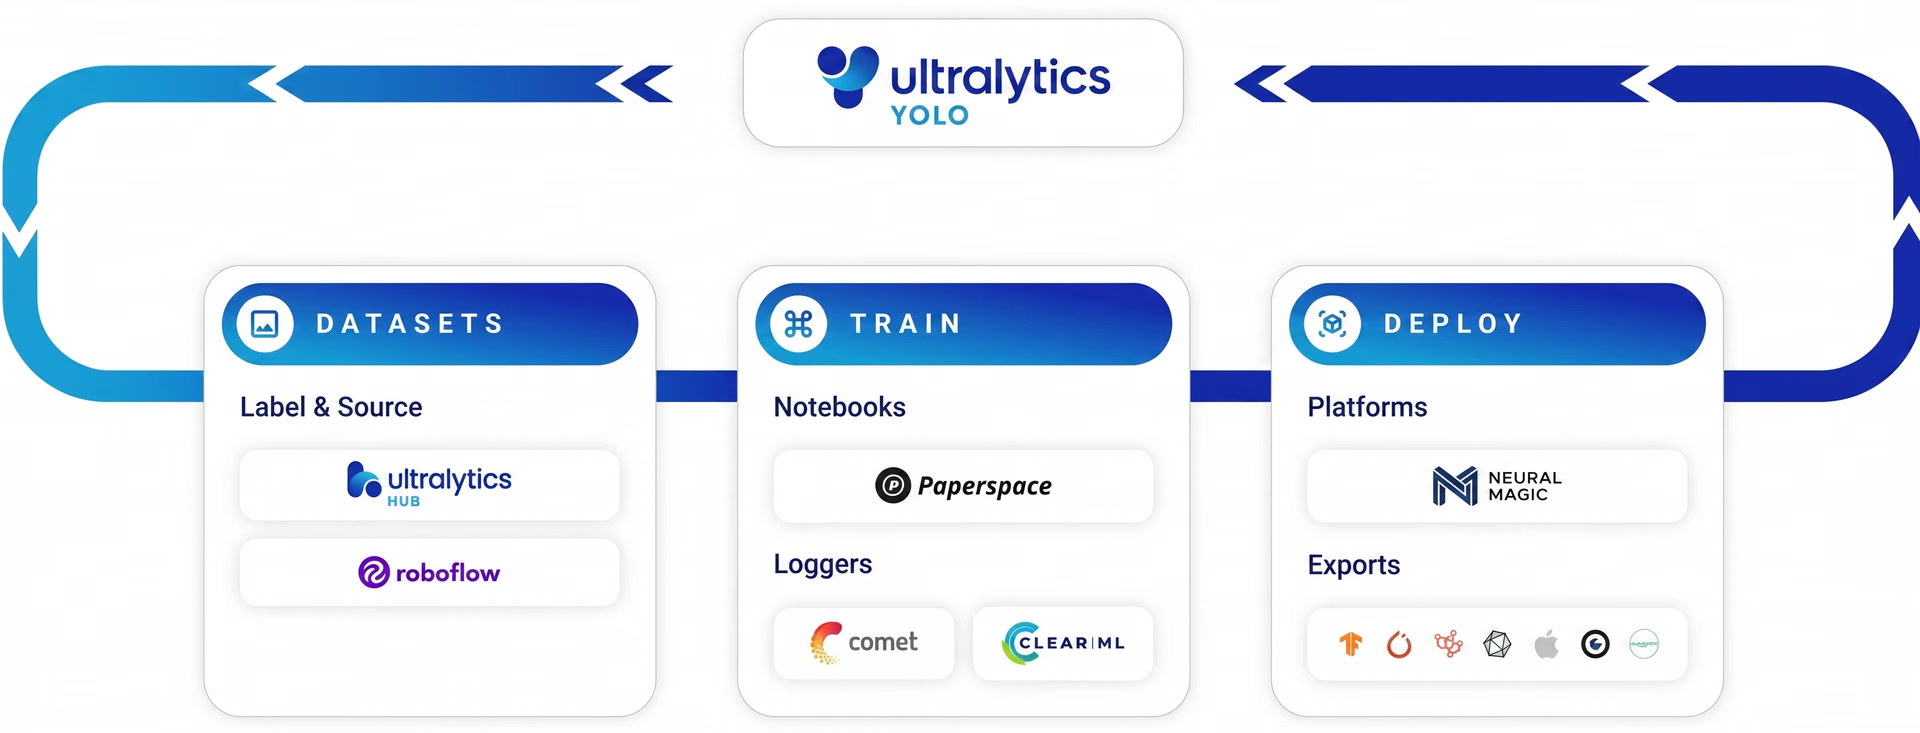
Fig. 3. Ultralytics supporta diverse integrazioni (Fonte)
In particolare, il pacchetto Python di Ultralytics supporta l'esportazione di Ultralytics YOLO26 in più formati, adattati a diverse piattaforme hardware. Ad esempio, il formato di esportazione ONNX abilita la compatibilità multipiattaforma, il formato di esportazione TensorRT è ottimizzato per le GPU NVIDIA e i dispositivi edge NVIDIA Jetson, mentre il formato di esportazione OpenVINO è progettato per l'hardware Intel.
Alcuni dispositivi supportano più di un formato di esportazione, ma le prestazioni possono variare a seconda di quello scelto. Invece di selezionare un formato per impostazione predefinita, chiediti: quale opzione è più efficiente per il tuo dispositivo?
Un formato potrebbe offrire un'inferenza più rapida, mentre un altro potrebbe garantire una migliore efficienza della memoria o un'integrazione più semplice nella pipeline esistente. Per questo è importante associare il formato di esportazione al tuo hardware e al tuo ambiente di implementazione specifici.
Dedicare del tempo a testare diverse opzioni di esportazione sul dispositivo di destinazione può fare una differenza significativa nelle prestazioni reali. Un formato di esportazione adeguato contribuisce a garantire che Ultralytics YOLO26 venga eseguito in modo efficiente, affidabile e alla velocità richiesta dalla tua applicazione.
Consiglio 3: chiediti se il modello necessita della quantizzazione#
Dopo aver selezionato un formato di esportazione, è consigliabile determinare anche se il modello debba essere quantizzato.
La quantizzazione dei modelli riduce la precisione numerica dei pesi e dei calcoli di un modello, convertendoli in genere da numeri in virgola mobile a 32 bit a formati a precisione inferiore, come 16 o 8 bit. Ciò contribuisce a ridurre le dimensioni del modello e l'utilizzo della memoria e a migliorare la velocità di inferenza, soprattutto sui dispositivi edge o sui sistemi basati su una CPU.
A seconda dell'hardware, del formato di esportazione e delle dipendenze del runtime, la quantizzazione può migliorare sensibilmente le prestazioni. Alcuni runtime sono ottimizzati per modelli a precisione inferiore, consentendo loro di funzionare più rapidamente e in modo più efficiente.
Tuttavia, se non viene applicata con attenzione, la quantizzazione può influire leggermente sull'accuratezza. Quando esegui la quantizzazione post-addestramento, assicurati di fornire le immagini di convalida. Queste immagini vengono utilizzate durante la calibrazione per aiutare il modello ad adattarsi alla precisione inferiore e mantenere previsioni stabili.
Consiglio 4: considera il data drift#
Anche il modello addestrato meglio può perdere prestazioni nel tempo a causa del data drift. Il data drift si verifica quando i dati che il modello rileva in produzione sono diversi da quelli sui quali è stato addestrato.
In altre parole, il mondo reale cambia, ma il tuo modello no. Di conseguenza, l'accuratezza può diminuire lentamente.
Ad esempio, potresti addestrare il modello Ultralytics YOLO26 utilizzando immagini acquisite durante il giorno. Se in seguito lo stesso modello viene utilizzato di notte, in condizioni di illuminazione diverse, le prestazioni potrebbero diminuire. Lo stesso problema può verificarsi a causa di variazioni negli angoli di ripresa, nelle condizioni meteorologiche, negli sfondi o nell'aspetto degli oggetti.
Il data drift è comune nei sistemi di IA per la visione utilizzati nel mondo reale. Gli ambienti sono raramente statici e piccoli cambiamenti possono influire sull'accuratezza del rilevamento. Per ridurre l'impatto del drift, puoi assicurarti che il dataset di addestramento rifletta il più fedelmente possibile le condizioni reali.
Includi immagini acquisite in diversi momenti della giornata, con condizioni di illuminazione differenti e in vari ambienti. Dopo l'implementazione, puoi continuare a monitorare le prestazioni e ad aggiornare o perfezionare il modello quando necessario.
Consiglio 5: esegui benchmark in condizioni reali#
Prima di implementare completamente il modello, puoi eseguire benchmark in condizioni reali.
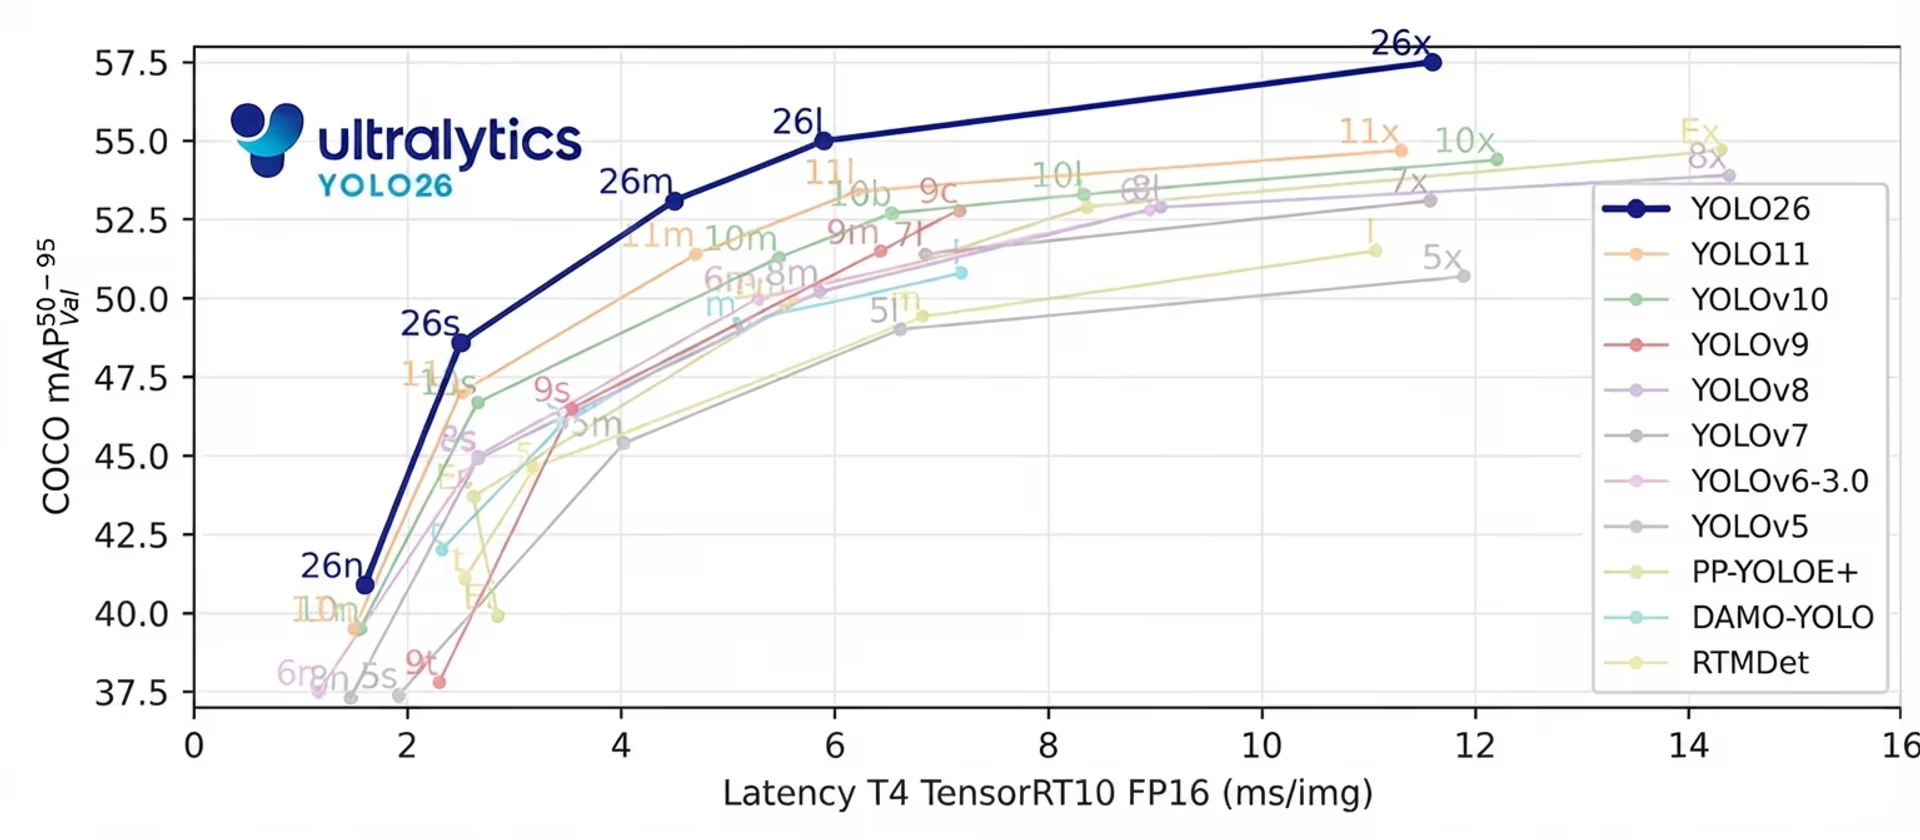
Fig. 4. Uno sguardo al benchmark di YOLO26 rispetto ad altri modelli (Fonte)
È comune testare le prestazioni in ambienti controllati utilizzando immagini campione o dataset di piccole dimensioni. Tuttavia, i sistemi reali spesso si comportano in modo diverso. Limitazioni hardware, ritardi di rete, più flussi video e input continuo possono influire sulle prestazioni.
Il benchmarking consiste nel misurare le prestazioni del modello sul dispositivo e nella configurazione effettivi in cui verrà eseguito. Ciò include il controllo della velocità di inferenza, della latenza complessiva, dell'utilizzo della memoria e della stabilità del sistema. È importante testare non solo il modello in sé, ma l'intera pipeline, inclusa la preelaborazione e qualsiasi fase di post-elaborazione.
Un modello può funzionare bene in un test su una singola immagine, ma avere difficoltà durante l'elaborazione continua di video in tempo reale. Allo stesso modo, le prestazioni su una potente macchina di sviluppo potrebbero non riflettere il comportamento del modello su un dispositivo edge a basso consumo.
Eseguendo benchmark in condizioni realistiche, puoi identificare tempestivamente i colli di bottiglia e apportare modifiche prima dell'entrata in produzione. Testare nello stesso ambiente in cui opererà Ultralytics YOLO26 contribuisce a garantire prestazioni affidabili, stabili e costanti in produzione.
Altre considerazioni importanti sull'implementazione dei modelli#
Ecco alcuni fattori aggiuntivi da tenere presenti quando implementi Ultralytics YOLO26:
- Monitoraggio e logging: configura strumenti di monitoraggio per tenere traccia di metriche come latenza, accuratezza e stato del sistema dopo l'implementazione.
- Sicurezza e privacy: implementa misure di protezione per salvaguardare i dati visivi sensibili, soprattutto quando utilizzi infrastrutture cloud o remote.
- Ottimizzazione dei colli di bottiglia della pipeline: valuta l'intera pipeline, inclusi moduli come preelaborazione, inferenza, post-elaborazione e trasferimento dei dati, poiché possono verificarsi ritardi al di fuori del modello stesso.
- Pianificazione della scalabilità: pianifica in anticipo la crescita, assicurandoti che il sistema sia in grado di gestire un aumento del traffico, ulteriori telecamere o carichi di lavoro ampliati.
Punti chiave#
Implementare YOLO26 in modo efficiente inizia dalla comprensione del luogo in cui verrà eseguito il modello e delle reali esigenze della tua applicazione. Scegliendo il giusto approccio di implementazione, associando il formato di esportazione al tuo hardware e testando le prestazioni in condizioni reali, puoi creare sistemi di IA per la visione affidabili e reattivi. Con la configurazione giusta, Ultralytics YOLO26 semplifica l'introduzione della visione artificiale veloce e pronta per la produzione nell'edge e nel cloud.
Unisciti alla nostra community ed esplora il nostro repository GitHub. Consulta le nostre pagine dedicate alle soluzioni per scoprire diverse applicazioni, come l'IA in agricoltura e la visione artificiale nel settore sanitario. Scopri le nostre opzioni di licenza e inizia oggi stesso a utilizzare l'IA per la visione!








