Capire i bias dell'IA e dei dataset nei sistemi di IA visiva
Scopri come i bias nei dataset influiscono sui modelli di visione artificiale e come Ultralytics YOLO11 aiuta a ridurli con un'augmentation intelligente e strumenti di addestramento flessibili.
I modelli di intelligenza artificiale (AI) stanno cambiando il nostro modo di risolvere i problemi, ma non sono perfetti. Dalle auto a guida autonoma agli strumenti diagnostici in ambito sanitario, ci affidiamo all'IA per interpretare i dati e prendere decisioni. Cosa succede quando sono i dati stessi a essere imperfetti?
I bias nell'IA sono schemi di incoerenza che si sviluppano nei modelli, spesso senza che nessuno se ne accorga. Questi bias possono portare i modelli a generare previsioni imprecise, incoerenti o persino dannose. Nella visione artificiale, i bias hanno spesso un'origine principale: il dataset. Se i dati usati per addestrare il modello sono sbilanciati o non rappresentativi, il modello rifletterà queste lacune.
Vediamo più da vicino come si forma il bias nei dataset, come influisce sui modelli di visione artificiale e quali misure possono adottare gli sviluppatori per rilevarlo e prevenirlo. Vedremo anche come modelli come Ultralytics YOLO11 possano contribuire alla creazione di sistemi di IA più equi e capaci di generalizzare meglio, ovvero di funzionare bene su dati nuovi e mai visti prima e servire tutti in modo più equo.
Che cos'è il bias nell'IA e perché è importante?#
Il bias nell'IA consiste in errori sistematici di un sistema di IA che producono risultati distorti o imprecisi. In parole più semplici, il modello inizia a privilegiare un tipo di input visivo rispetto ad altri, compromettendo l'equità del modello, non perché funzioni meglio, ma per via del modo in cui è stato addestrato.
Questo fenomeno è particolarmente comune nella visione artificiale, dove i modelli apprendono dai dati visivi. Se un dataset include soprattutto un solo tipo di oggetto, scena o persona, il modello apprende schemi che funzionano bene solo in quei casi.
Immagina un modello addestrato soprattutto su immagini del traffico nelle grandi città. Se viene utilizzato in una zona rurale, potrebbe classificare erroneamente configurazioni stradali insolite o non rilevare alcuni tipi di veicoli che non ha mai visto prima. Questo è un esempio concreto di bias nell'IA. Il bias riduce la precisione e limita la capacità di generalizzazione, ovvero la capacità di un modello di funzionare bene con input nuovi o diversi.
Nelle applicazioni in cui la precisione è essenziale, come l'assistenza sanitaria o la sicurezza, questi errori non sono solo frustranti: possono essere pericolosi. Affrontare i bias significa occuparsi di prestazioni, affidabilità e sicurezza.
In che modo il bias nei dataset influenza il comportamento dei modelli#
Quando parliamo di bias nei dataset, ci riferiamo allo squilibrio o ai limiti dei dati usati per addestrare un modello. Il bias nei dataset si verifica quando i dati di addestramento non rappresentano adeguatamente la diversità del mondo reale che dovrebbero modellare.
I modelli di visione artificiale non comprendono il mondo: comprendono gli schemi. Se le uniche immagini di cani che vedono sono golden retriever in giardino, potrebbero non riconoscere un husky su un sentiero innevato.
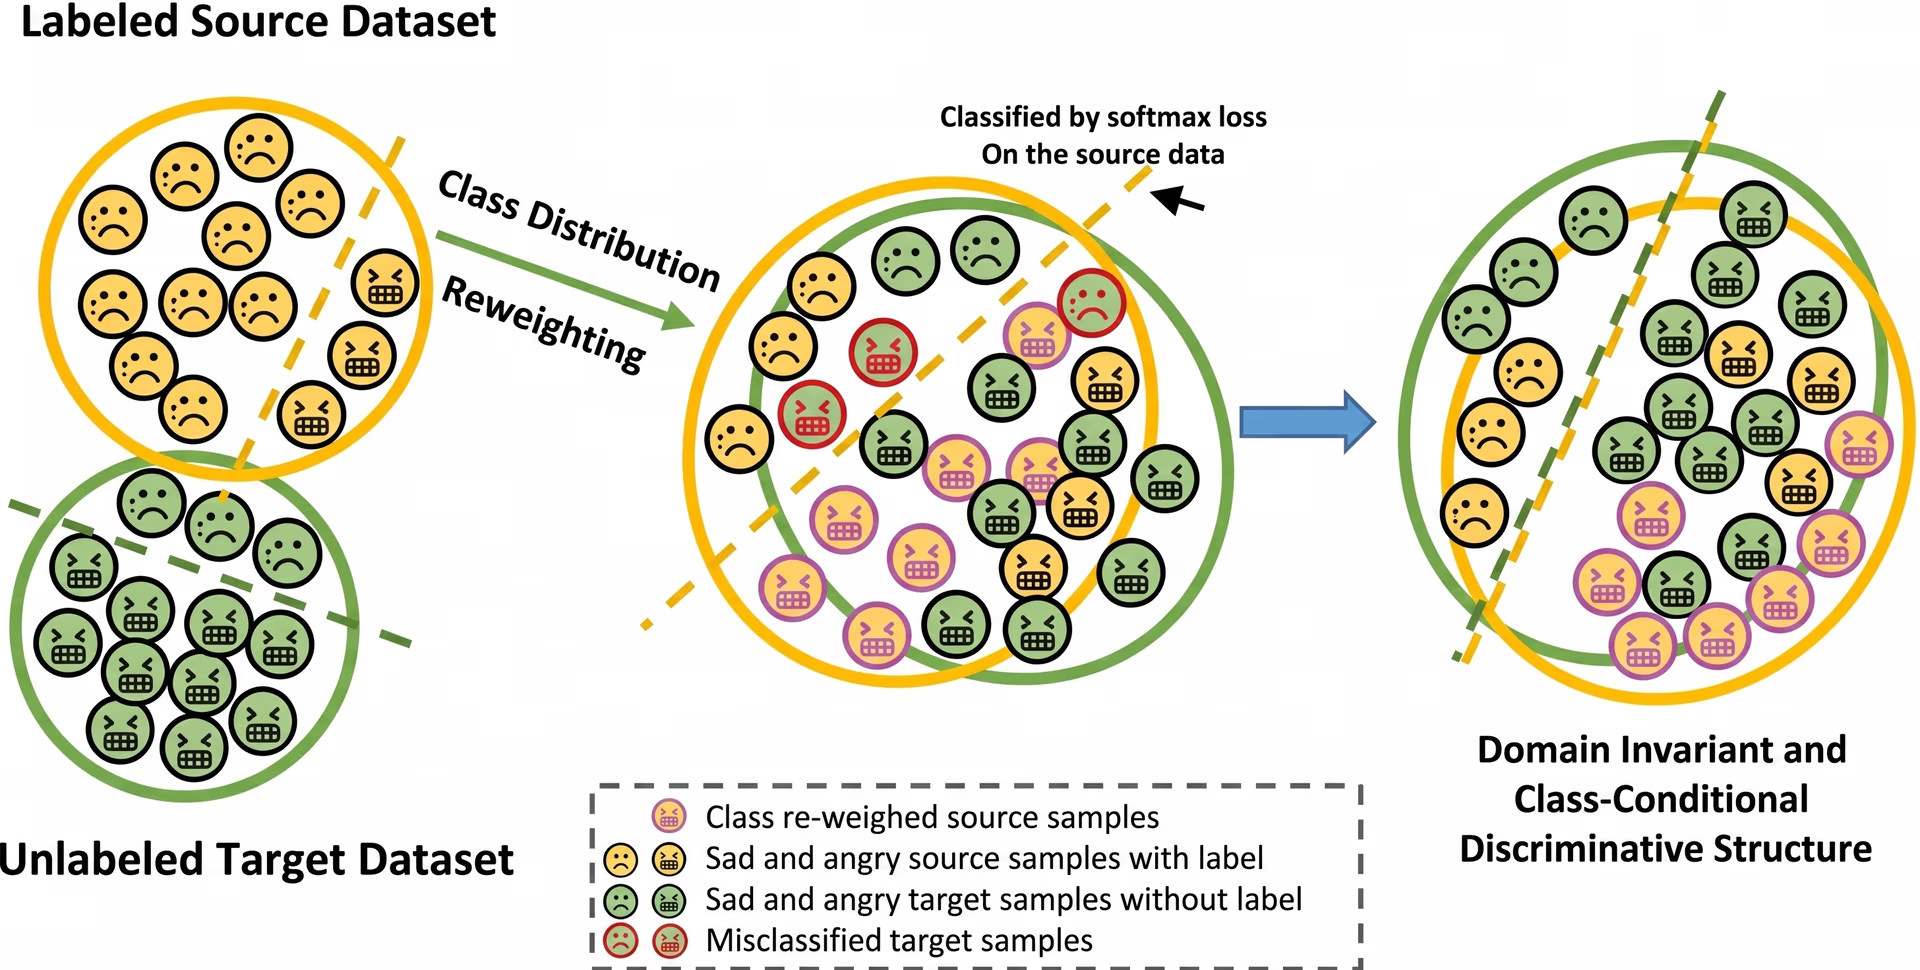
Fig. 1. Riassegnare i pesi ai dati di origine aiuta a ottenere una maggiore precisione del modello.
Questo mette in evidenza una delle principali sfide causate dal bias nei dataset. Il modello costruisce la propria comprensione in base a ciò che gli viene mostrato. Se i dati di addestramento non rappresentano la varietà del mondo reale, il comportamento del modello diventa limitato e meno efficace in condizioni non familiari.
I classificatori di immagini spesso hanno prestazioni nettamente peggiori quando vengono testati su un dataset diverso da quello usato per l'addestramento, anche se entrambi i dataset sono stati creati per la stessa attività. Piccole variazioni nell'illuminazione, negli sfondi o nelle angolazioni della telecamera possono causare cali evidenti di precisione. Questo dimostra quanto facilmente il bias nei dataset possa influire sulla capacità di generalizzazione di un modello.
Non si tratta di casi limite. Sono segnali che la pipeline dei dati conta tanto quanto l'architettura del modello.
Tipi di bias nei dati di addestramento dell'IA#
Il bias può manifestarsi in modo sottile durante lo sviluppo, spesso nella raccolta, nell'etichettatura o nella selezione dei dati. Di seguito sono riportati tre tipi principali di bias che possono influire sui tuoi dati di addestramento:
Bias di selezione#
Il bias di selezione può verificarsi quando il dataset non rappresenta la varietà presente nell'uso reale. Se un modello di rilevamento dei pedoni viene addestrato solo su immagini nitide scattate di giorno, non funzionerà bene di notte o nella nebbia. Il processo di selezione avrà quindi tralasciato casi fondamentali.
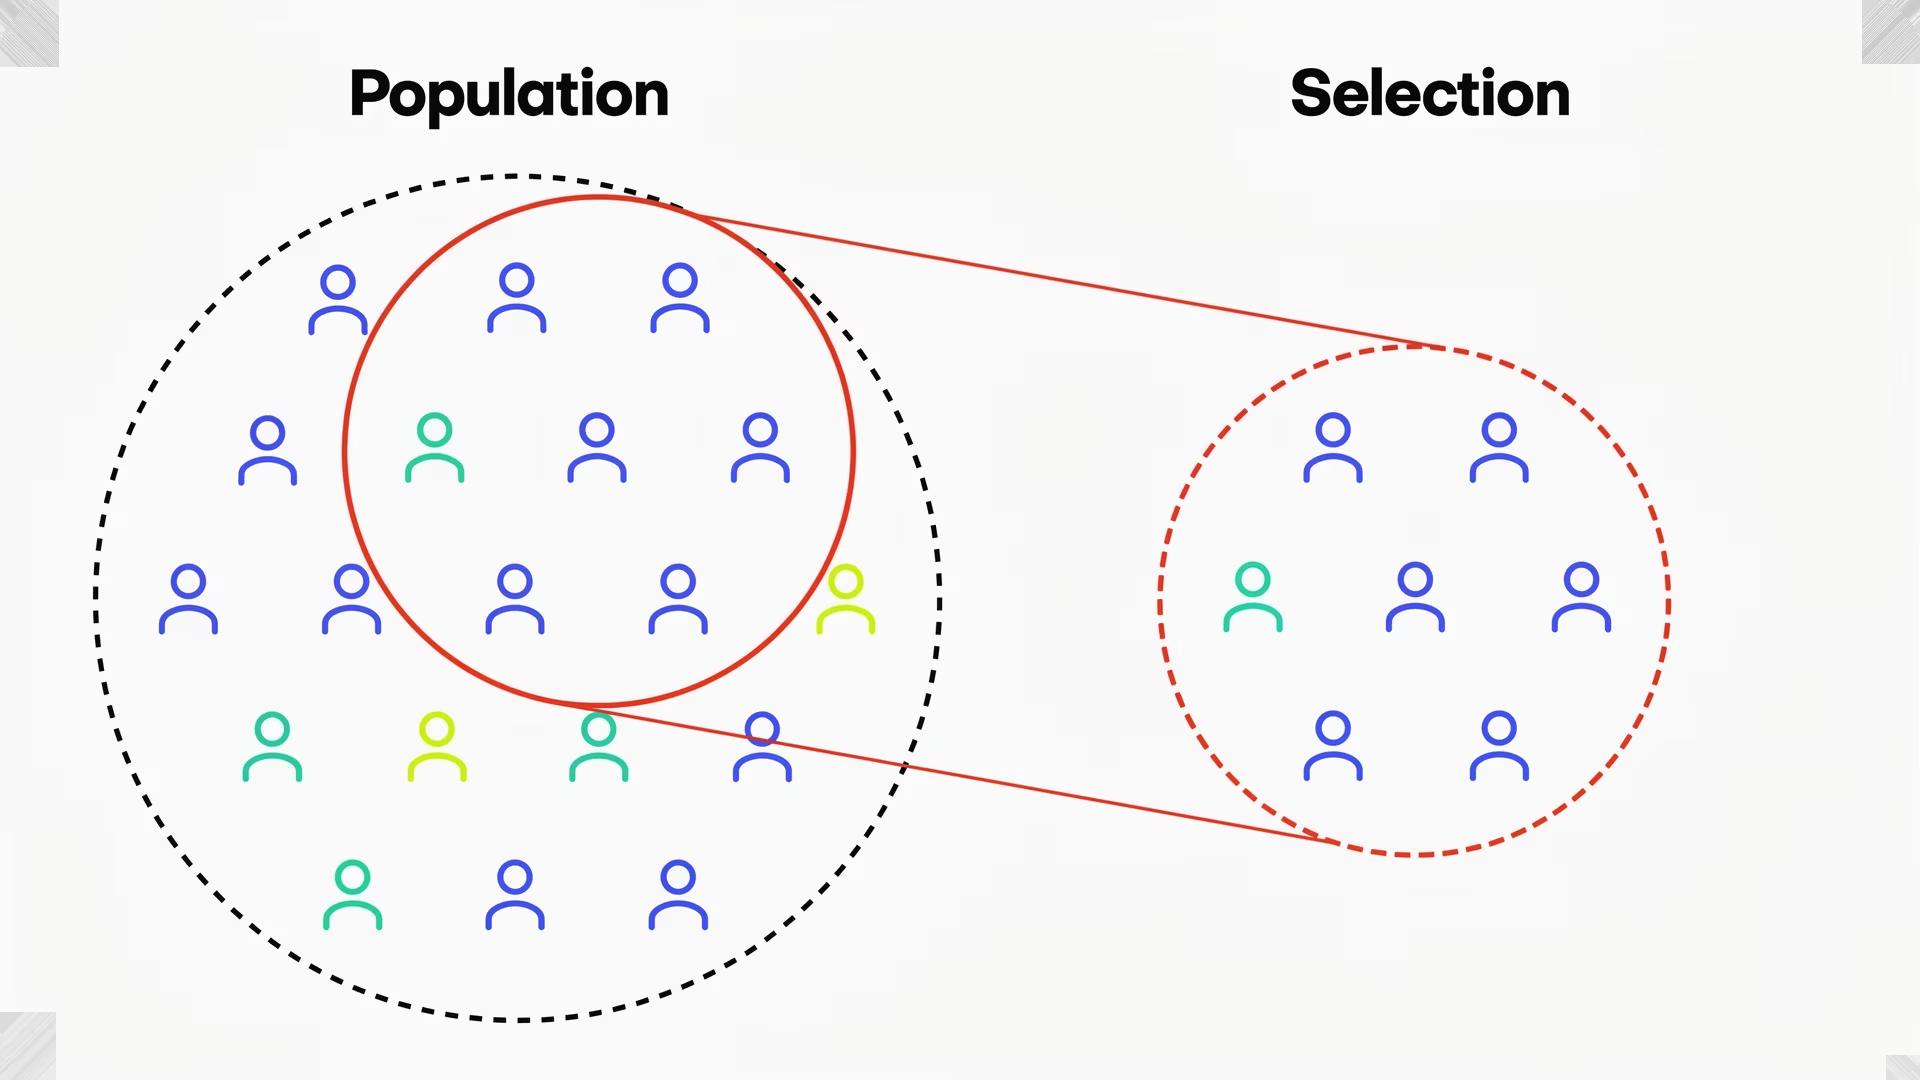
Fig. 2. Rappresentazione visiva del bias di selezione, in cui viene scelto solo un sottoinsieme poco diversificato.
Questo bias si verifica quando il dataset non coglie l'intera varietà degli scenari del mondo reale a causa delle modalità di raccolta dei dati. Per esempio, un modello di rilevamento dei pedoni addestrato solo su immagini nitide scattate di giorno potrebbe fallire in presenza di nebbia, neve o scarsa illuminazione. Succede spesso quando i dati vengono raccolti in condizioni ideali o comode, limitando la capacità del modello di funzionare in ambienti diversi. Ampliare la raccolta includendo contesti più vari aiuta a ridurre questo tipo di bias.
Può verificarsi anche nei dataset creati da fonti online, i cui contenuti possono essere fortemente sbilanciati verso determinate aree geografiche, lingue o contesti socioeconomici. Senza uno sforzo mirato per diversificare il dataset, il modello erediterà questi limiti.
Bias delle etichette#
Il bias delle etichette si verifica quando gli annotatori umani applicano etichette errate o incoerenti. Un'etichetta errata può sembrare innocua, ma se il problema si ripete spesso, il modello inizia ad apprendere associazioni sbagliate.
Etichette incoerenti possono confondere il modello durante l'addestramento, soprattutto in attività complesse come il rilevamento degli oggetti. Per esempio, un annotatore potrebbe etichettare un veicolo come "auto", mentre un altro potrebbe chiamarne uno simile "camion". Queste incoerenze compromettono la capacità del modello di apprendere schemi affidabili e riducono la precisione durante l'inferenza.
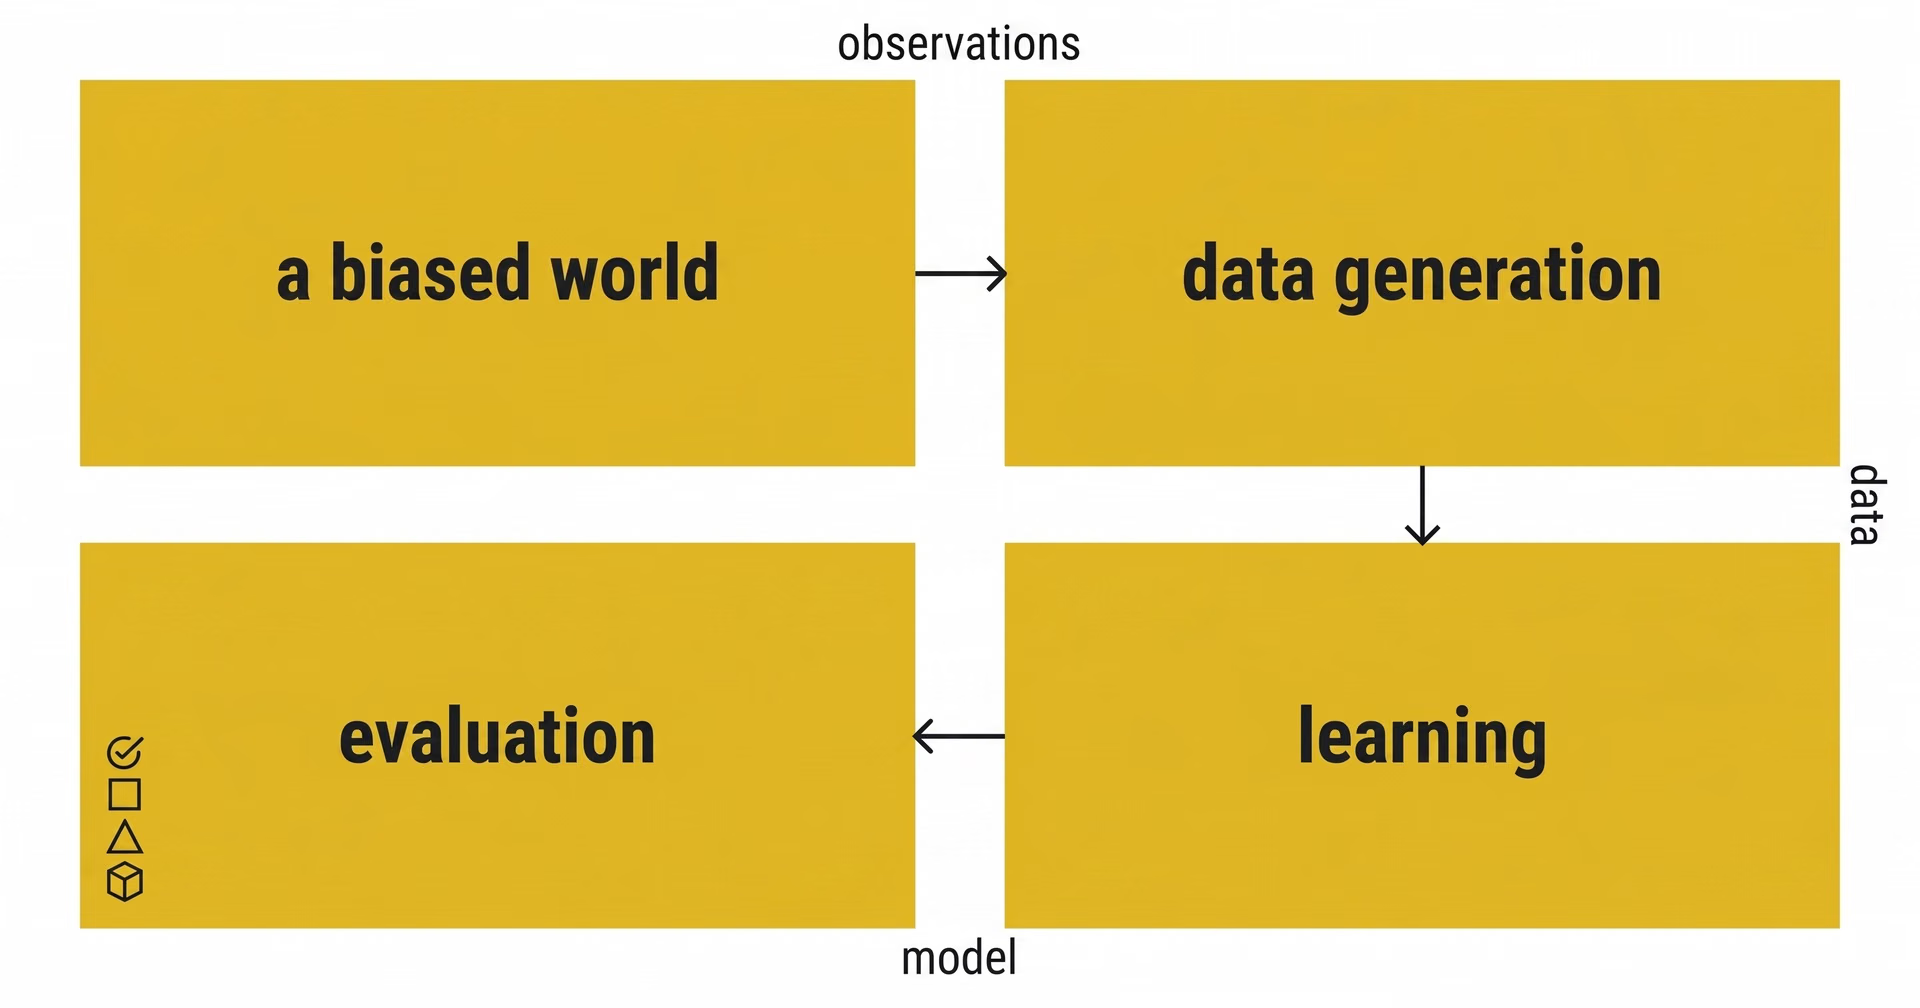
Fig. 3. Il bias nelle pipeline dei dati deriva dagli squilibri del mondo reale.
Il bias delle etichette può emergere anche da linee guida di annotazione poco chiare o da interpretazioni diverse degli stessi dati. Definire standard di etichettatura ben documentati ed eseguire controlli di qualità può ridurre notevolmente queste difficoltà.
La formazione continua degli annotatori e l'uso dell'etichettatura consensuale, in cui più annotatori esaminano ogni campione, sono due strategie efficaci per ridurre al minimo il bias delle etichette e migliorare la qualità dei dataset.
Bias di rappresentazione#
Il bias di rappresentazione riflette spesso disuguaglianze sociali più ampie. I dati raccolti nelle aree più ricche o connesse potrebbero non cogliere la varietà delle popolazioni o degli ambienti meno rappresentati. Per affrontare questo bias è necessario includere intenzionalmente gruppi e contesti trascurati.
Il bias di rappresentazione si verifica quando determinati gruppi o classi sono sottorappresentati nel dataset. Possono essere gruppi demografici, categorie di oggetti o condizioni ambientali. Se un modello vede solo una tonalità di pelle, un tipo di oggetto o uno stile di sfondo, le sue previsioni rifletteranno questo squilibrio.
Possiamo osservare questo tipo di bias quando alcuni gruppi o categorie sono presenti in quantità molto inferiori rispetto ad altri. Ciò può orientare le previsioni del modello verso gli esempi predominanti nel dataset. Per esempio, un modello di riconoscimento facciale addestrato soprattutto su un gruppo demografico potrebbe avere difficoltà a funzionare con precisione per tutti gli utenti. A differenza del bias di selezione, legato alla varietà dei dati, il bias di rappresentazione riguarda l'equilibrio tra i gruppi.
Le verifiche della diversità e le strategie mirate di ampliamento dei dati possono aiutare a garantire che tutti i gruppi demografici e le categorie pertinenti siano rappresentati adeguatamente nel dataset di addestramento.
Come rilevare e ridurre il bias nei dataset#
Nelle applicazioni del mondo reale, il bias nell'IA non si limita a qualche previsione errata. Può portare alla creazione di sistemi che funzionano bene per alcune persone, ma non per tutte.
Nell'IA per il settore automobilistico, i modelli di rilevamento possono avere prestazioni incoerenti con diversi gruppi di pedoni, con conseguenti livelli di sicurezza inferiori per le persone sottorappresentate. Il problema non è l'intento del modello, ma gli input visivi su cui è stato addestrato. Anche in agricoltura, il bias nel rilevamento degli oggetti può portare a identificare male le colture in condizioni diverse di illuminazione o meteo. Sono conseguenze comuni dell'addestramento dei modelli su dataset limitati o sbilanciati.
Correggere i bias nell'IA inizia dal capire dove cercare. Se nel tuo set di addestramento mancano esempi fondamentali o è eccessivamente rappresentata una gamma ristretta, il modello rifletterà queste lacune. Ecco perché rilevare i bias nell'IA è un passaggio fondamentale di ogni pipeline di sviluppo.
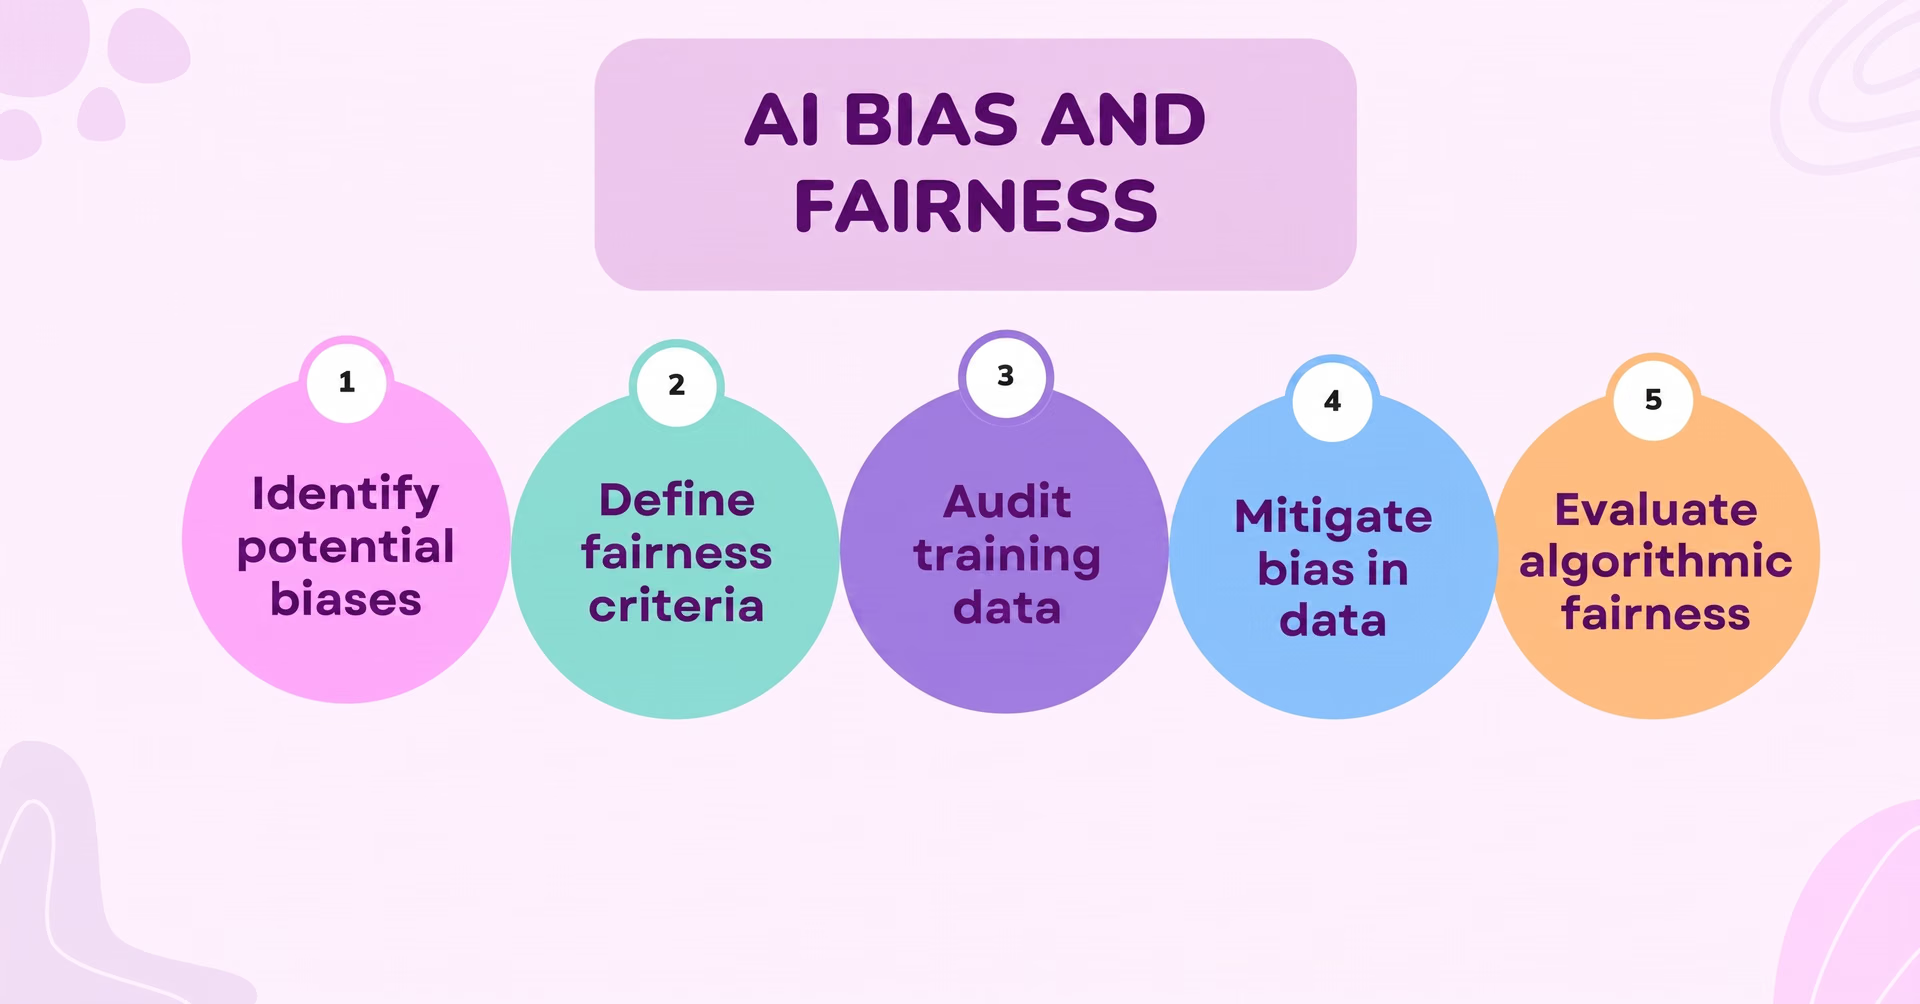
Fig. 4. Passaggi chiave per ridurre i bias nell'IA e migliorare l'equità.
Inizia analizzando il tuo dataset. Esamina la distribuzione di classi, ambienti, illuminazione, dimensioni degli oggetti e gruppi demografici. Se una categoria prevale, è probabile che il tuo modello abbia prestazioni peggiori sulle altre.
Poi, esamina le prestazioni. Il modello funziona peggio in determinati contesti o con tipi specifici di oggetti? In tal caso, è un segnale di bias appreso, che di solito rimanda ai dati.
La valutazione per sottoinsiemi è fondamentale. Un modello potrebbe riportare una precisione media del 90%, ma raggiungere solo il 60% per uno specifico gruppo o in una determinata condizione. Senza esaminare questi sottoinsiemi, non te ne accorgeresti mai.
Usare metriche di equità durante l'addestramento e la valutazione è un altro strumento efficace. Queste metriche vanno oltre i punteggi standard di precisione e valutano il comportamento del modello nei diversi sottoinsiemi di dati. Aiutano a individuare i punti ciechi che altrimenti potrebbero passare inosservati.
La trasparenza sulla composizione dei dataset e sui test dei modelli porta a modelli migliori.
Migliorare l'equità con la diversità dei dati e l'aumento dei dati#
Una volta identificati i bias, il passo successivo è colmare le lacune. Uno dei modi più efficaci per farlo è aumentare la diversità dei dati nei modelli di IA. Questo significa raccogliere più campioni da scenari sottorappresentati, che si tratti di immagini mediche provenienti da popolazioni diverse o di condizioni ambientali insolite.
Aggiungere altri dati può essere utile, soprattutto se aumenta la diversità. Tuttavia, migliorare l'equità dipende anche dal raccogliere i tipi di esempi giusti. Questi dovrebbero riflettere le variazioni del mondo reale che il modello probabilmente incontrerà.
L'aumento dei dati è un'altra strategia utile. Capovolgere e ruotare le immagini, modificare l'illuminazione e ridimensionare gli oggetti può aiutare a simulare diverse condizioni del mondo reale. L'aumento dei dati non solo rende il dataset più vario, ma aiuta anche il modello a diventare più robusto rispetto ai cambiamenti di aspetto, illuminazione e contesto.
La maggior parte delle pipeline di addestramento moderne include per impostazione predefinita l'aumento dei dati, ma per renderlo efficace ai fini dell'equità è fondamentale usarlo in modo strategico, per esempio concentrandosi su modifiche adatte alle esigenze specifiche dell'attività.
Usare dati sintetici per colmare le lacune#
I dati sintetici sono dati generati artificialmente che imitano esempi del mondo reale. Possono essere utili quando determinati scenari sono troppo rari o delicati per essere acquisiti sul campo.
Per esempio, se stai creando un modello per rilevare difetti rari nei macchinari o violazioni del codice della strada in situazioni limite, puoi simulare questi casi con dati sintetici. In questo modo il modello può apprendere da eventi che potrebbe incontrare raramente nel set di addestramento.
Alcuni studi hanno rilevato che introdurre dati sintetici mirati nell'addestramento può ridurre il bias nei dataset e migliorare le prestazioni in diversi gruppi demografici e ambienti.
I dati sintetici danno i risultati migliori se affiancati da campioni del mondo reale. Integrano il tuo dataset, ma non lo sostituiscono.
In che modo Ultralytics YOLO11 supporta un'IA etica#
La creazione di modelli di IA imparziali dipende anche dagli strumenti che usi. Ultralytics YOLO11 è progettato per essere flessibile, facile da ottimizzare e altamente adattabile, caratteristiche che lo rendono particolarmente adatto a ridurre il bias nei dataset.
Ultralytics YOLO11 supporta tecniche avanzate di aumento dei dati durante l'addestramento del modello, introducendo contesti visivi diversificati ed esempi combinati per migliorare la capacità di generalizzazione del modello e ridurre l'overfitting.
Ultralytics YOLO11 presenta anche un'architettura del backbone e del neck migliorata, per un'estrazione delle caratteristiche più efficace. Questo aggiornamento aumenta la capacità del modello di rilevare dettagli di precisione, un aspetto fondamentale negli scenari sottorappresentati o limite, in cui i modelli standard possono avere difficoltà.
Poiché Ultralytics YOLO11 è semplice da riaddestrare e distribuire negli ambienti edge e cloud, i team possono individuare le lacune nelle prestazioni e aggiornare rapidamente il modello quando sul campo viene rilevato un bias.
Un'IA equa non è un obiettivo da raggiungere una volta per tutte. È un ciclo di valutazione, apprendimento e adattamento. Strumenti come Ultralytics YOLO11 aiutano a rendere questo ciclo più rapido e produttivo.
Punti chiave#
I bias nell'IA influiscono su tutto, dall'equità alle prestazioni. I bias nella visione artificiale spesso derivano dal modo in cui i dataset vengono raccolti, etichettati e bilanciati. Fortunatamente, esistono metodi collaudati per rilevarli e ridurli.
Inizia verificando i tuoi dati e testando le prestazioni del modello in diversi scenari. Usa una raccolta mirata dei dati, l'aumento dei dati e i dati sintetici per creare una copertura di addestramento migliore.
Ultralytics YOLO11 supporta questo flusso di lavoro semplificando l'addestramento di modelli personalizzati, l'applicazione di tecniche efficaci di aumento dei dati e la risposta rapida quando viene rilevato un bias.
Creare un'IA equa non è solo la cosa giusta da fare: è anche il modo per creare sistemi più intelligenti e affidabili.
Unisciti alla nostra community in continua crescita! Esplora il nostro repository GitHub per saperne di più sull'IA. Vuoi iniziare i tuoi progetti di visione artificiale? Scopri le nostre opzioni di licenza. Visita le nostre pagine dedicate alle soluzioni per scoprire l'IA nella produzione e l'IA visiva in agricoltura!









