Che cos'è la distillazione dei dataset? Una panoramica rapida
Scopri come la distillazione dei dataset accelera l'addestramento dei modelli e riduce i costi di calcolo, sostituendo grandi dataset con un piccolo insieme ottimizzato di campioni sintetici.
 Abirami Vina16 min di lettura
L'addestramento dei modelli può sembrare la parte più dispendiosa in termini di tempo del lavoro di un data scientist. In realtà, la maggior parte del tempo, spesso dal 60% all'80%, viene dedicata a preparare i dati: raccoglierli, pulirli e organizzarli per la modellazione. Man mano che i dataset crescono, aumenta anche il tempo necessario alla preparazione, rallentando gli esperimenti e rendendo più difficile iterare.
Per affrontare questo problema, i ricercatori cercano da anni modi per semplificare l'addestramento. Approcci come i dati sintetici, la compressione dei dataset e metodi di ottimizzazione migliori mirano a ridurre i costi e le difficoltà di gestione dei dataset su larga scala e ad accelerare i flussi di lavoro di machine learning.
Una domanda fondamentale è se sia possibile ridurre drasticamente le dimensioni di un dataset ottenendo comunque le stesse prestazioni dell'addestramento di un modello sui dati completi. La distillazione dei dataset è una risposta promettente.
Crea una versione compatta di un dataset di addestramento, preservando i pattern essenziali che il modello deve apprendere per funzionare efficacemente. Offre un modo per velocizzare l'addestramento, ridurre il fabbisogno di calcolo e sperimentare con maggiore efficienza. Puoi pensarla come un piccolo promemoria di studio per il modello: un insieme ridotto di esempi di dati sintetici, progettato per insegnare gli stessi pattern fondamentali del dataset completo.
In questo articolo vedremo come funziona la distillazione dei dataset e in che modo supporta l’apprendimento automatico e il deep learning scalabili nelle applicazioni del mondo reale.
Capire la distillazione dei dataset#
La distillazione dei dataset è un processo che condensa un grande dataset di addestramento in un insieme di dati molto più piccolo, che insegna comunque al modello quasi le stesse informazioni del dataset originale. Molti ricercatori chiamano questo processo anche condensazione dei dataset, perché l'obiettivo è catturare i pattern essenziali presenti nell'intero dataset.
Un dataset distillato è diverso dai dati sintetici generati casualmente o dalla semplice selezione di un sottoinsieme più piccolo di immagini reali. Non è un dataset fittizio casuale né una copia ridotta dell'originale.
Al contrario, viene ottimizzato intenzionalmente per catturare i pattern più importanti. Durante il processo, ogni pixel e caratteristica viene regolato e ottimizzato, così che una rete neurale addestrata sui dati distillati apprenda quasi come se fosse stata addestrata sull'intero dataset.
Questa idea è apparsa per la prima volta in un articolo pubblicato su arXiv nel 2018, a firma di Tongzhou Wang, Jun-Yan Zhu, Antonio Torralba e Alexei A. Efros. I primi test hanno usato dataset semplici come MNIST e CIFAR-10, rendendo facile dimostrare che pochi campioni distillati potevano sostituire migliaia di immagini reali.
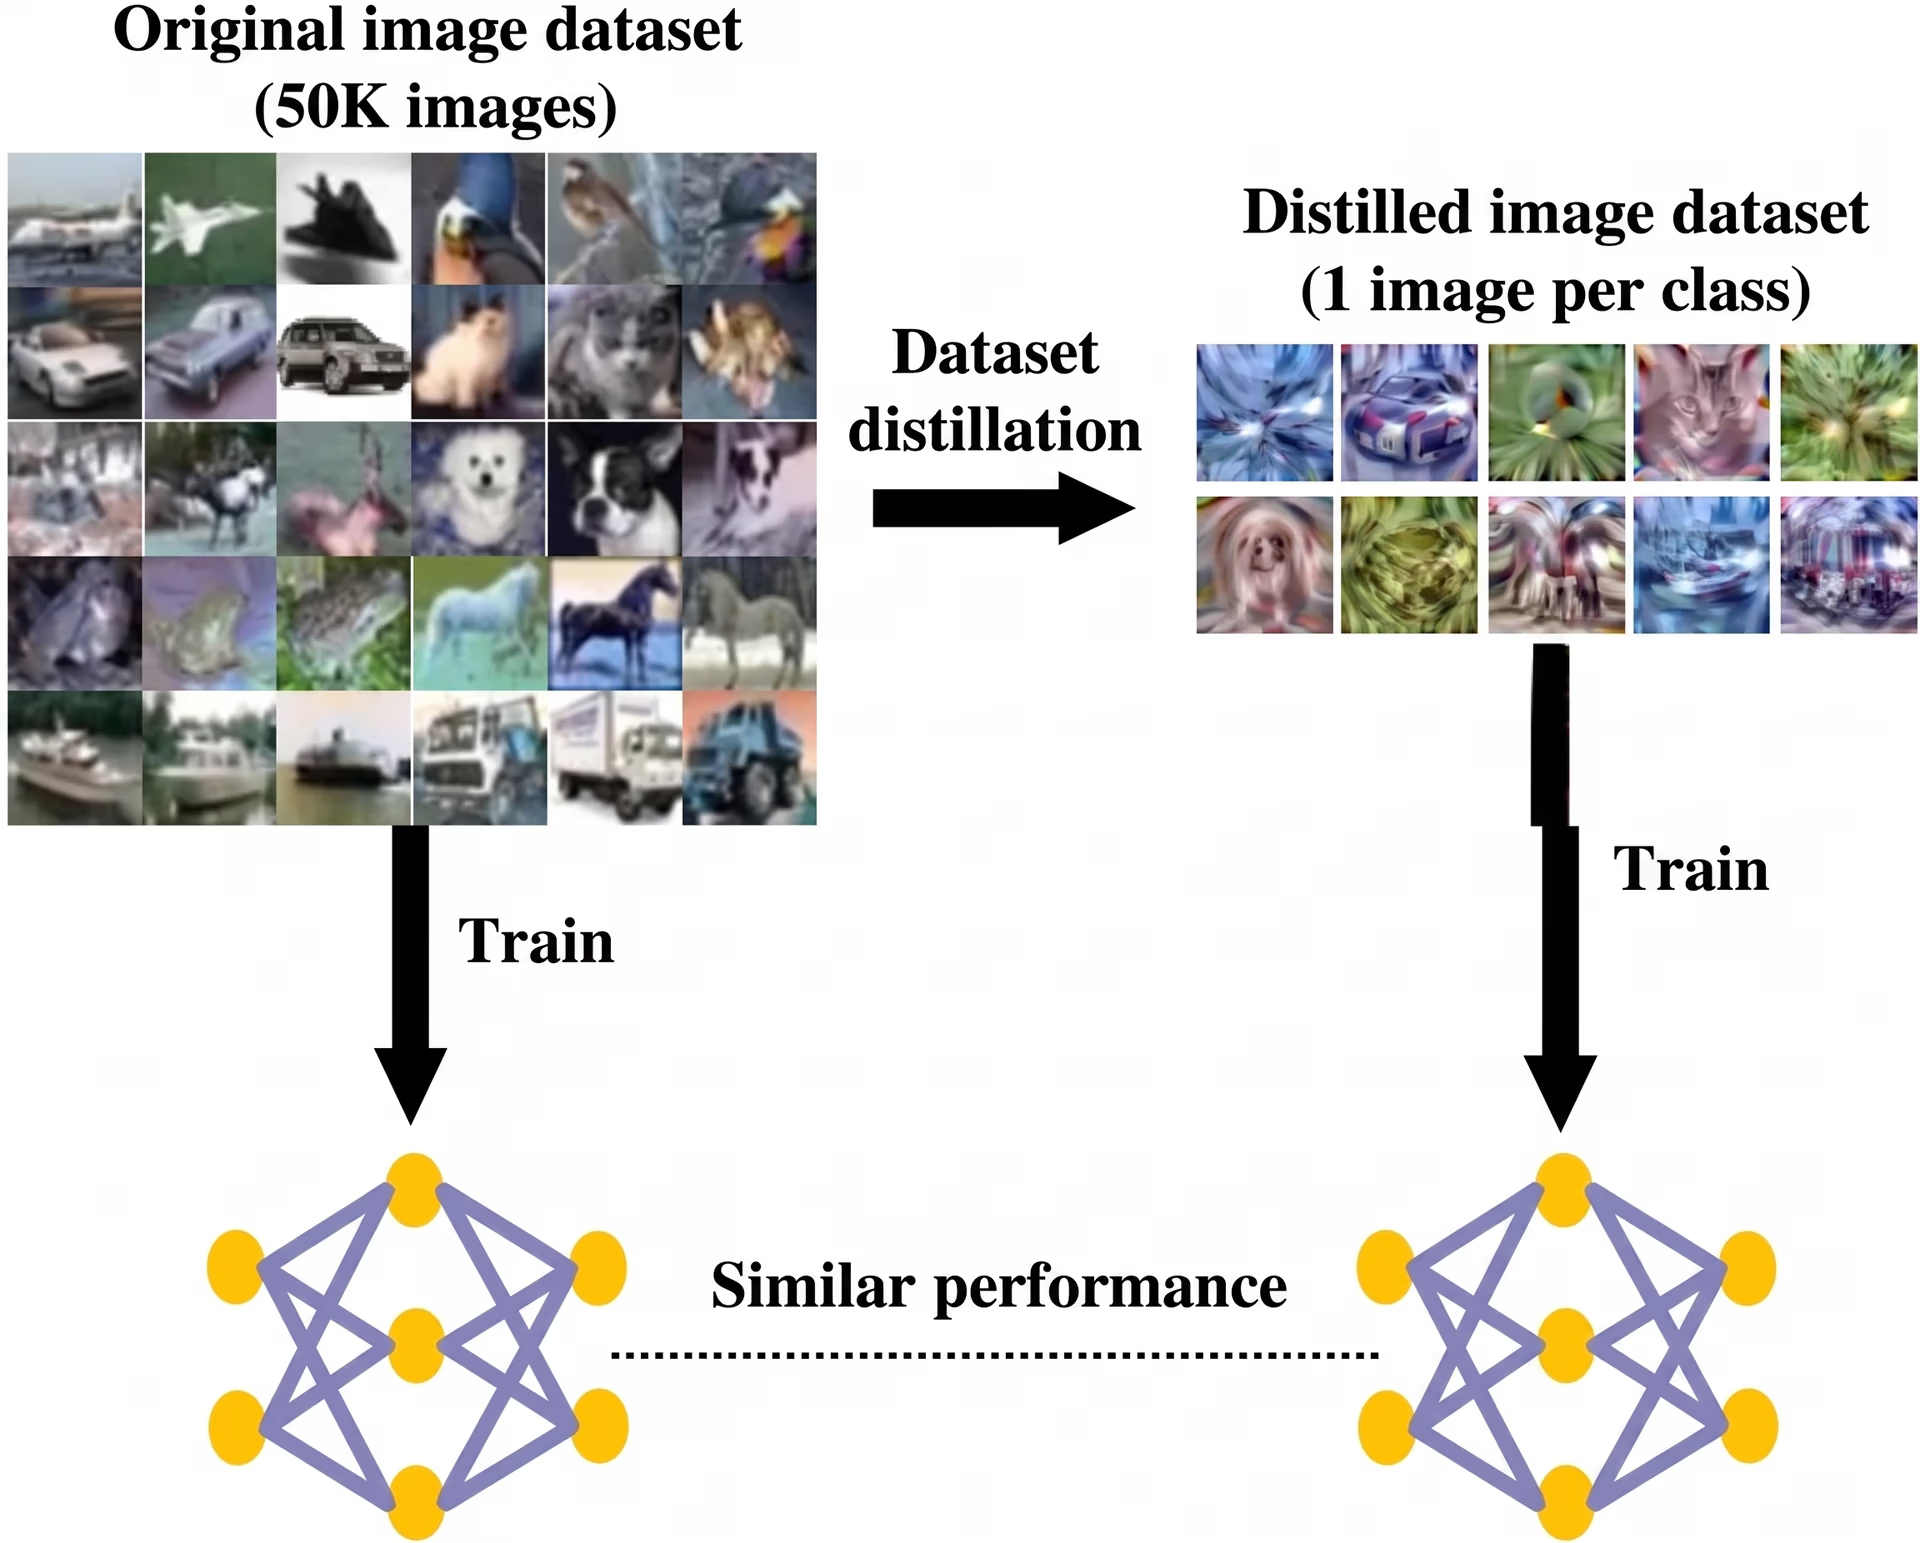
Fig. 1. Uso della distillazione dei dataset per i dati delle immagini (Fonte)
Da allora, gli studi successivi hanno ampliato ulteriormente la distillazione dei dataset, anche con metodi presentati a ICML e ICLR che rendono la condensazione più efficiente e scalabile.
L'importanza della distillazione dei dataset#
La distillazione dei dataset migliora l'efficienza dell'addestramento e accelera i cicli di sviluppo. Riducendo la quantità di dati da cui un modello deve apprendere, diminuisce i requisiti computazionali.
È particolarmente utile per l'apprendimento continuo, in cui i modelli vengono aggiornati nel tempo; per la ricerca di architetture neurali, in cui si testano numerosi design di modelli; e per l'addestramento edge, in cui i modelli vengono eseguiti su dispositivi di piccole dimensioni con memoria e potenza limitate. Nel complesso, questi vantaggi rendono la distillazione dei dataset un'ottima soluzione per l'inizializzazione rapida, il fine-tuning veloce e la creazione di prototipi iniziali in molti flussi di lavoro di machine learning.
Panoramica sul funzionamento della distillazione dei dataset#
La distillazione dei dataset crea campioni di addestramento sintetici, ovvero generati artificialmente. Questi campioni aiutano il modello ad apprendere in modo molto simile a quando viene addestrato su dati reali. Il processo tiene traccia di tre fattori chiave durante il normale addestramento.
Il primo è la funzione di perdita, ovvero il punteggio di errore del modello che indica quanto sono sbagliate le sue previsioni. Il secondo sono i parametri del modello, cioè i pesi interni della rete che vengono aggiornati durante l'apprendimento.
Il terzo è la traiettoria di addestramento, che descrive come cambiano nel tempo, passo dopo passo, l'errore e i pesi. I campioni sintetici vengono quindi ottimizzati affinché, quando il modello viene addestrato su di essi, l'errore diminuisca e i pesi si aggiornino come farebbero con il dataset completo.
La distillazione dei dataset, passo dopo passo#
Ecco uno sguardo più approfondito al funzionamento del processo di distillazione dei dataset:
- Passaggio 1 - Inizializzazione dei pixel sintetici: Il processo inizia con immagini sintetiche che fungono da input apprendibili. Inizialmente, queste immagini hanno poca struttura e sembrano tele bianche. Col tempo vengono ottimizzate fino a diventare esempi informativi.
- Passaggio 2 - Ottimizzazione con gradient matching e backpropagation: Quando il modello viene addestrato su queste immagini sintetiche, produce gradienti che indicano come modificare ciascun pixel per riprodurre meglio il comportamento di addestramento dei dati reali. La backpropagation è il metodo con cui la rete impara dagli errori. Propaga l'errore all'indietro attraverso il modello per determinare quali pixel e pesi lo hanno causato, quindi li aggiorna leggermente. Usando questi gradienti, la backpropagation modifica passo dopo passo le immagini sintetiche, rendendole più informative per l'addestramento.
- Passaggio 3 - Allineamento del comportamento tra i passaggi di addestramento: Il metodo allinea anche le traiettorie di addestramento, ovvero le modifiche passo dopo passo che il modello attraversa durante l'apprendimento. In questo modo il dataset distillato guida il modello lungo un percorso di apprendimento simile a quello che seguirebbe con il dataset completo.
- Passaggio 4 - Validazione e generalizzazione: Infine, il dataset distillato viene valutato su dati di validazione reali per verificare le prestazioni del modello addestrato su nuovi esempi. Questo controllo assicura che i dati sintetici insegnino pattern generali e funzionali, invece di indurre il modello a memorizzare campioni specifici.
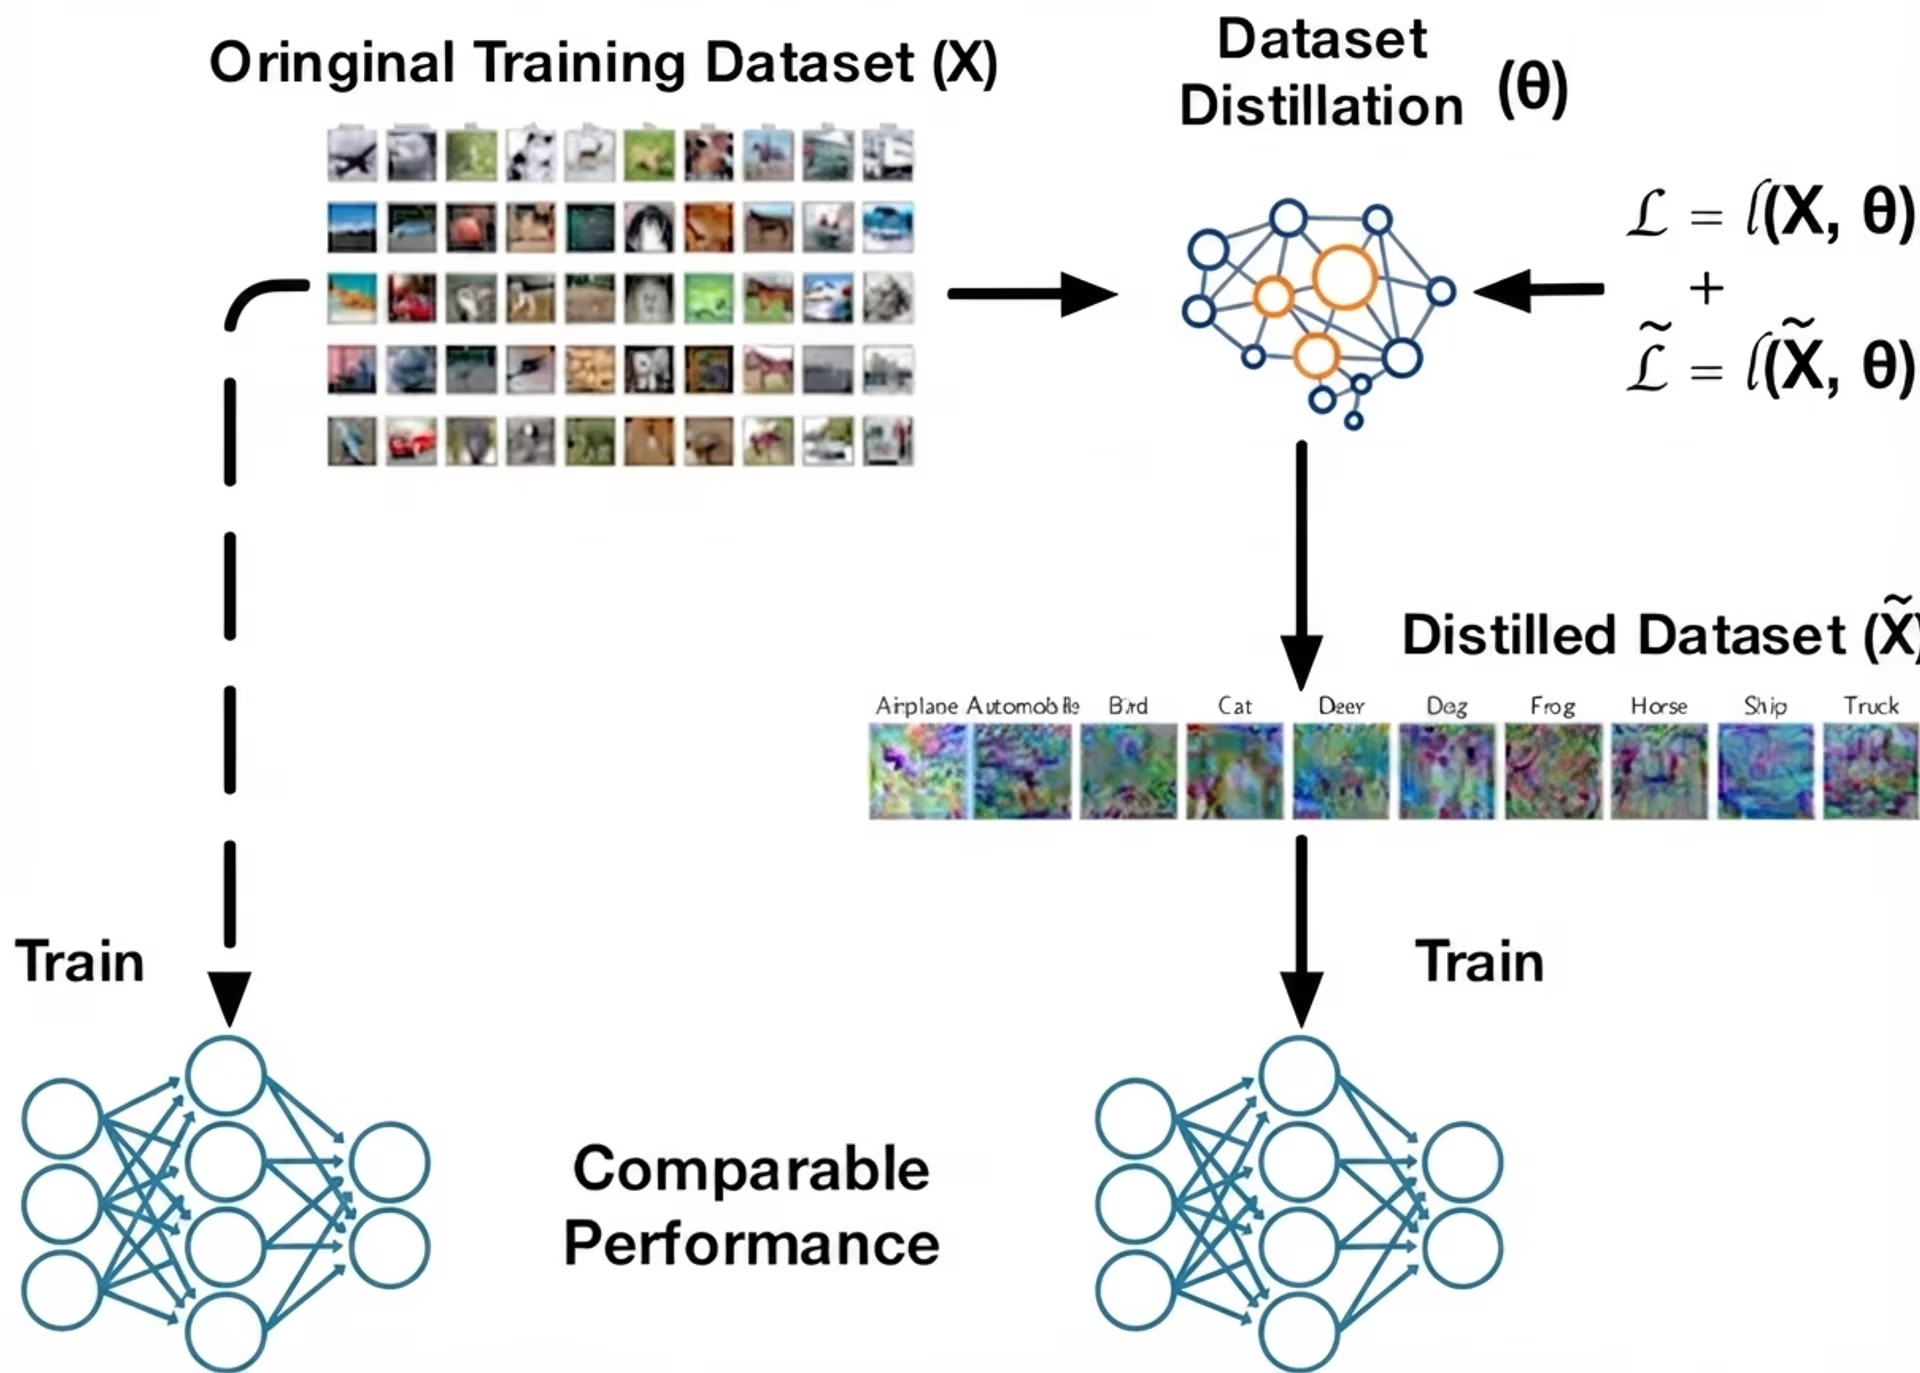
Fig. 2. Uno sguardo alla distillazione dei dataset (Fonte)
Principali metodologie di distillazione dei dataset#
Tutti i metodi di distillazione dei dataset si basano sulla stessa idea fondamentale, anche se usano algoritmi diversi per realizzarla. La maggior parte degli approcci rientra in tre categorie: allineamento delle prestazioni, allineamento della distribuzione e allineamento dei parametri.
Vediamo ora ciascun metodo e il suo funzionamento.
Allineamento delle prestazioni#
Nella distillazione dei dataset, l'allineamento delle prestazioni si concentra sulla creazione di un set di addestramento piccolo e ottimizzato che consenta al modello di raggiungere un'accuratezza quasi uguale a quella ottenuta con l'addestramento sull'intero dataset originale. Invece di selezionare un sottoinsieme casuale, i campioni distillati vengono ottimizzati affinché un modello addestrato su di essi produca previsioni simili, un andamento della perdita durante l'addestramento simile o un'accuratezza finale simile a quella di un modello addestrato sul dataset originale.
Il meta-learning è un metodo comune per migliorare questo processo. Il dataset distillato viene aggiornato attraverso episodi di addestramento ripetuti, così da risultare efficace in molte situazioni possibili.
Durante questi episodi, il metodo simula l'apprendimento di un modello studente a partire dai campioni distillati correnti, verifica le prestazioni dello studente sui dati reali e poi modifica i campioni distillati affinché diventino insegnanti migliori. Col tempo, il set distillato impara a favorire un apprendimento rapido e una forte generalizzazione, anche quando il modello studente parte da pesi iniziali diversi o usa un'architettura differente. Questo rende il dataset distillato più affidabile e non vincolato a una singola esecuzione dell'addestramento.
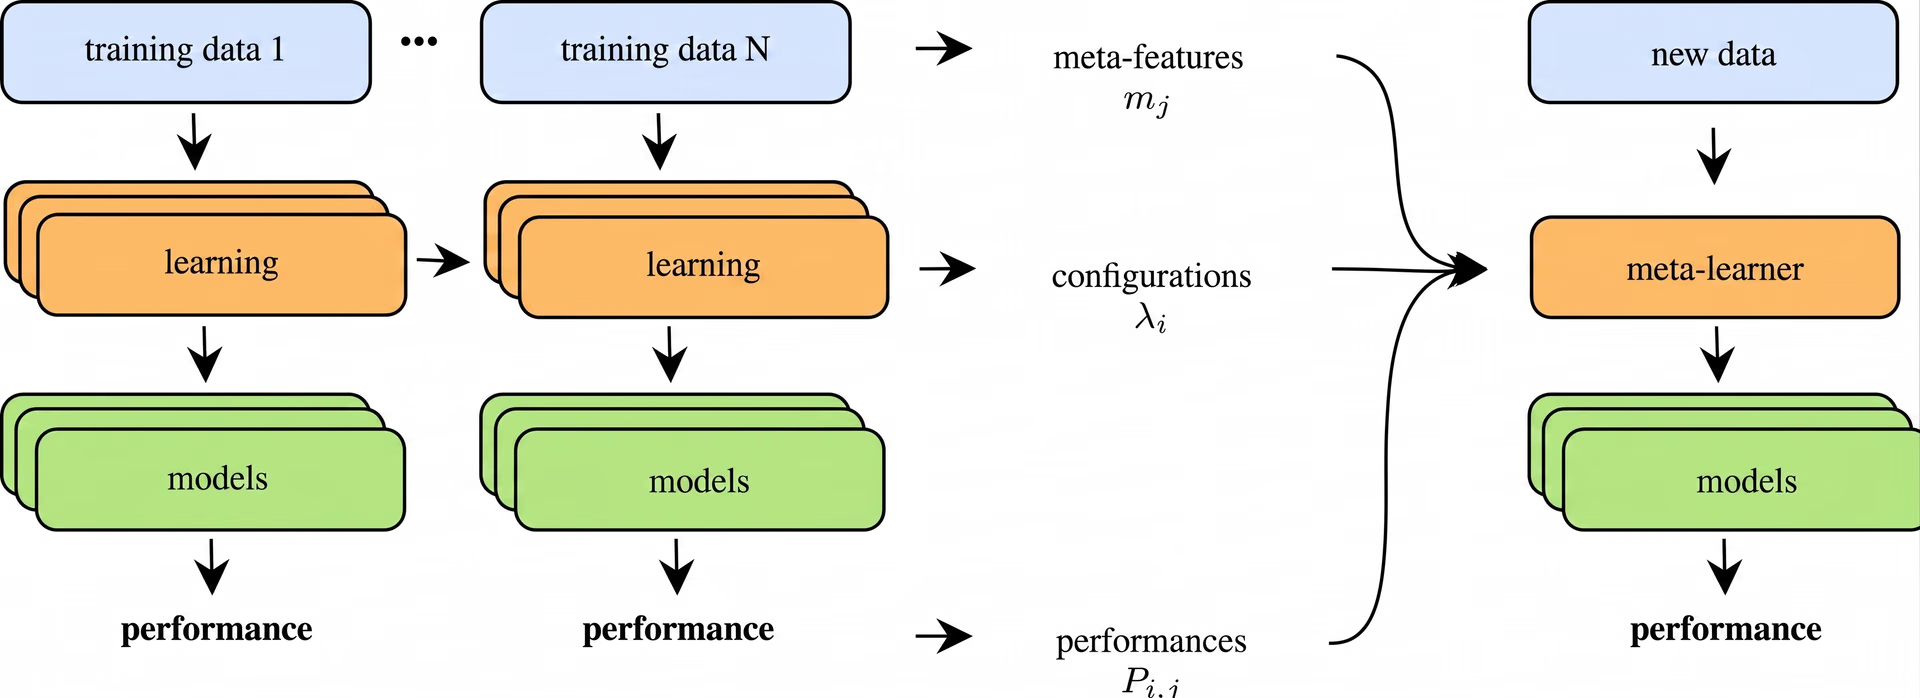
Fig. 3. Il processo di meta-learning (Fonte)
Tecniche di allineamento della distribuzione#
L'allineamento della distribuzione, invece, genera dati sintetici che riproducono i pattern statistici del dataset reale. Anziché concentrarsi solo sull'accuratezza finale del modello, questo approccio si focalizza sulle caratteristiche interne generate da una rete neurale durante l'apprendimento.
Vediamo ora le due tecniche alla base dell'allineamento della distribuzione.
Corrispondenza della distribuzione su un singolo livello#
La corrispondenza della distribuzione su un singolo livello si concentra su un unico livello di una rete neurale e confronta le caratteristiche che produce per i dati reali e quelli sintetici. Queste caratteristiche, chiamate anche attivazioni, rappresentano ciò che il modello ha appreso in quel punto della rete.
Facendo sì che i dati sintetici producano attivazioni simili, il metodo incoraggia il dataset distillato a riflettere gli stessi pattern importanti del dataset originale. In pratica, i campioni sintetici vengono aggiornati ripetutamente finché le attivazioni del livello scelto non corrispondono da vicino a quelle ottenute dalle immagini reali.
Questo approccio è relativamente semplice perché allinea un solo livello di rappresentazione alla volta. Può funzionare particolarmente bene con dataset più piccoli o attività per cui non è necessario abbinare gerarchie di caratteristiche profonde e articolate in più fasi. Allineando chiaramente un unico spazio delle caratteristiche, la corrispondenza su un singolo livello fornisce un segnale stabile e significativo per l'apprendimento con il dataset distillato.
Corrispondenza della distribuzione su più livelli#
La corrispondenza della distribuzione su più livelli amplia l'idea di confrontare dati reali e sintetici applicandola a diversi livelli di una rete neurale anziché a uno solo. I vari livelli acquisiscono informazioni di tipo diverso, dai bordi e dalle texture semplici dei primi livelli alle forme e ai pattern più complessi dei livelli profondi.
Abbinando le caratteristiche di questi livelli, il dataset distillato viene ottimizzato per riflettere ciò che il modello apprende a più livelli. Poiché allinea le caratteristiche lungo tutta la rete, questo approccio aiuta i dati sintetici a preservare segnali più ricchi, su cui il modello fa affidamento per distinguere le classi.
Questo è particolarmente utile nella visione artificiale, cioè nelle attività in cui i modelli imparano a comprendere immagini e video, perché i pattern utili sono distribuiti su molti livelli. Quando le distribuzioni delle caratteristiche corrispondono bene a diverse profondità, il dataset distillato funge da sostituto più efficace e affidabile dei dati di addestramento originali.
Metodi di corrispondenza dei parametri#
Un'altra categoria importante della distillazione dei dataset è la corrispondenza dei parametri. Invece di abbinare l'accuratezza o le distribuzioni delle caratteristiche, abbina il modo in cui i pesi di un modello cambiano durante l'addestramento. Facendo sì che l'addestramento sul dataset distillato produca aggiornamenti dei parametri simili a quelli dell'addestramento sui dati reali, il modello segue un percorso di apprendimento quasi identico.
Esaminiamo ora i due principali metodi di corrispondenza dei parametri.
Corrispondenza a un singolo passo#
La corrispondenza a un singolo passo confronta cosa succede ai pesi di un modello dopo un solo passo di addestramento sui dati reali. Il dataset distillato viene quindi ottimizzato in modo che un modello addestrato su di esso per un passo produca un aggiornamento dei pesi molto simile. Poiché si concentra solo su questo singolo aggiornamento, il metodo è semplice e veloce da eseguire.
Lo svantaggio è che un solo passo non rappresenta l'intero processo di apprendimento, soprattutto nelle attività più difficili, in cui il modello ha bisogno di molti aggiornamenti per acquisire caratteristiche più ricche. Per questo, la corrispondenza a un singolo passo tende a funzionare meglio con problemi più semplici o dataset più piccoli, in cui è possibile acquisire rapidamente pattern utili.
Corrispondenza dei parametri su più passi#
Al contrario, la corrispondenza dei parametri su più passi considera come cambiano i pesi di un modello durante diversi passi di addestramento, non uno soltanto. Questa sequenza di aggiornamenti costituisce la traiettoria di addestramento del modello.
Il dataset distillato viene creato in modo che, quando un modello si addestra sui campioni sintetici, la sua traiettoria segua da vicino quella che avrebbe seguito sui dati reali. Abbinando un tratto più lungo del processo di apprendimento, il dataset distillato acquisisce una parte maggiore della struttura del processo di addestramento originale.
Poiché rappresenta lo sviluppo dell'apprendimento nel tempo, la corrispondenza su più passi in genere funziona meglio con dataset più grandi o complessi, per i quali i modelli hanno bisogno di molti aggiornamenti per acquisire pattern utili. Richiede più calcolo perché deve tenere traccia di più passi, ma spesso produce dataset distillati che generalizzano meglio e offrono prestazioni superiori rispetto alla corrispondenza a un singolo passo.
Come funzionano la generazione e l'ottimizzazione dei dataset sintetici#
Dopo aver approfondito i principali approcci di distillazione, possiamo vedere come vengono creati i dati sintetici. Nella distillazione dei dataset, i campioni sintetici vengono ottimizzati per acquisire il segnale di apprendimento più importante, così un piccolo insieme può sostituire un dataset molto più grande.
Vediamo ora come vengono generati e valutati questi dati distillati.
Creazione e valutazione delle immagini distillate#
Durante la distillazione dei dataset, i pixel sintetici vengono aggiornati nel corso di molti passi di addestramento. La rete neurale apprende dalle immagini sintetiche correnti e invia un feedback basato sul gradiente, che indica come modificare ogni pixel per riprodurre meglio i pattern del dataset reale.
Questo è possibile perché il processo è differenziabile (cioè ogni passaggio è continuo e ha gradienti ben definiti, quindi piccole modifiche ai pixel portano a cambiamenti prevedibili nella loss), consentendo al modello di modificare gradualmente i dati sintetici durante la discesa del gradiente.
Con il proseguire dell'ottimizzazione, le immagini sintetiche iniziano ad acquisire una struttura significativa, comprese forme e texture riconosciute dal modello. Queste immagini sintetiche raffinate vengono spesso usate per attività di classificazione delle immagini, perché acquisiscono gli indizi visivi fondamentali che un classificatore deve apprendere.
I dataset distillati vengono valutati addestrando modelli su di essi e confrontando i risultati con quelli dei modelli addestrati sui dati reali. I ricercatori misurano l'accuratezza di validazione e verificano se l'insieme sintetico preserva le caratteristiche discriminanti (i pattern o i segnali su cui il modello fa affidamento per distinguere una classe dall'altra) necessarie a separare le classi. Verificano anche la stabilità e la capacità di generalizzazione in diverse esecuzioni o configurazioni del modello, per assicurarsi che i dati distillati non causino overfitting.
Applicazioni reali della distillazione dei dati#
Esaminiamo ora alcuni esempi di come i dataset distillati accelerino l'addestramento e riducano i costi di calcolo mantenendo prestazioni elevate, anche quando i dati sono limitati o altamente specializzati.
Uso della distillazione dei dataset nelle applicazioni di visione artificiale#
Nella visione artificiale, l'obiettivo è addestrare i modelli a comprendere dati visivi come immagini e video. Questi modelli apprendono pattern come bordi, texture, forme e oggetti, per poi usarli in attività come la classificazione delle immagini, il rilevamento degli oggetti o la segmentazione. Poiché i problemi di visione presentano spesso un'enorme variabilità nell'illuminazione, negli sfondi e nei punti di vista, i sistemi di visione artificiale in genere richiedono dataset ampi per generalizzare bene, rendendo l'addestramento costoso e lento.
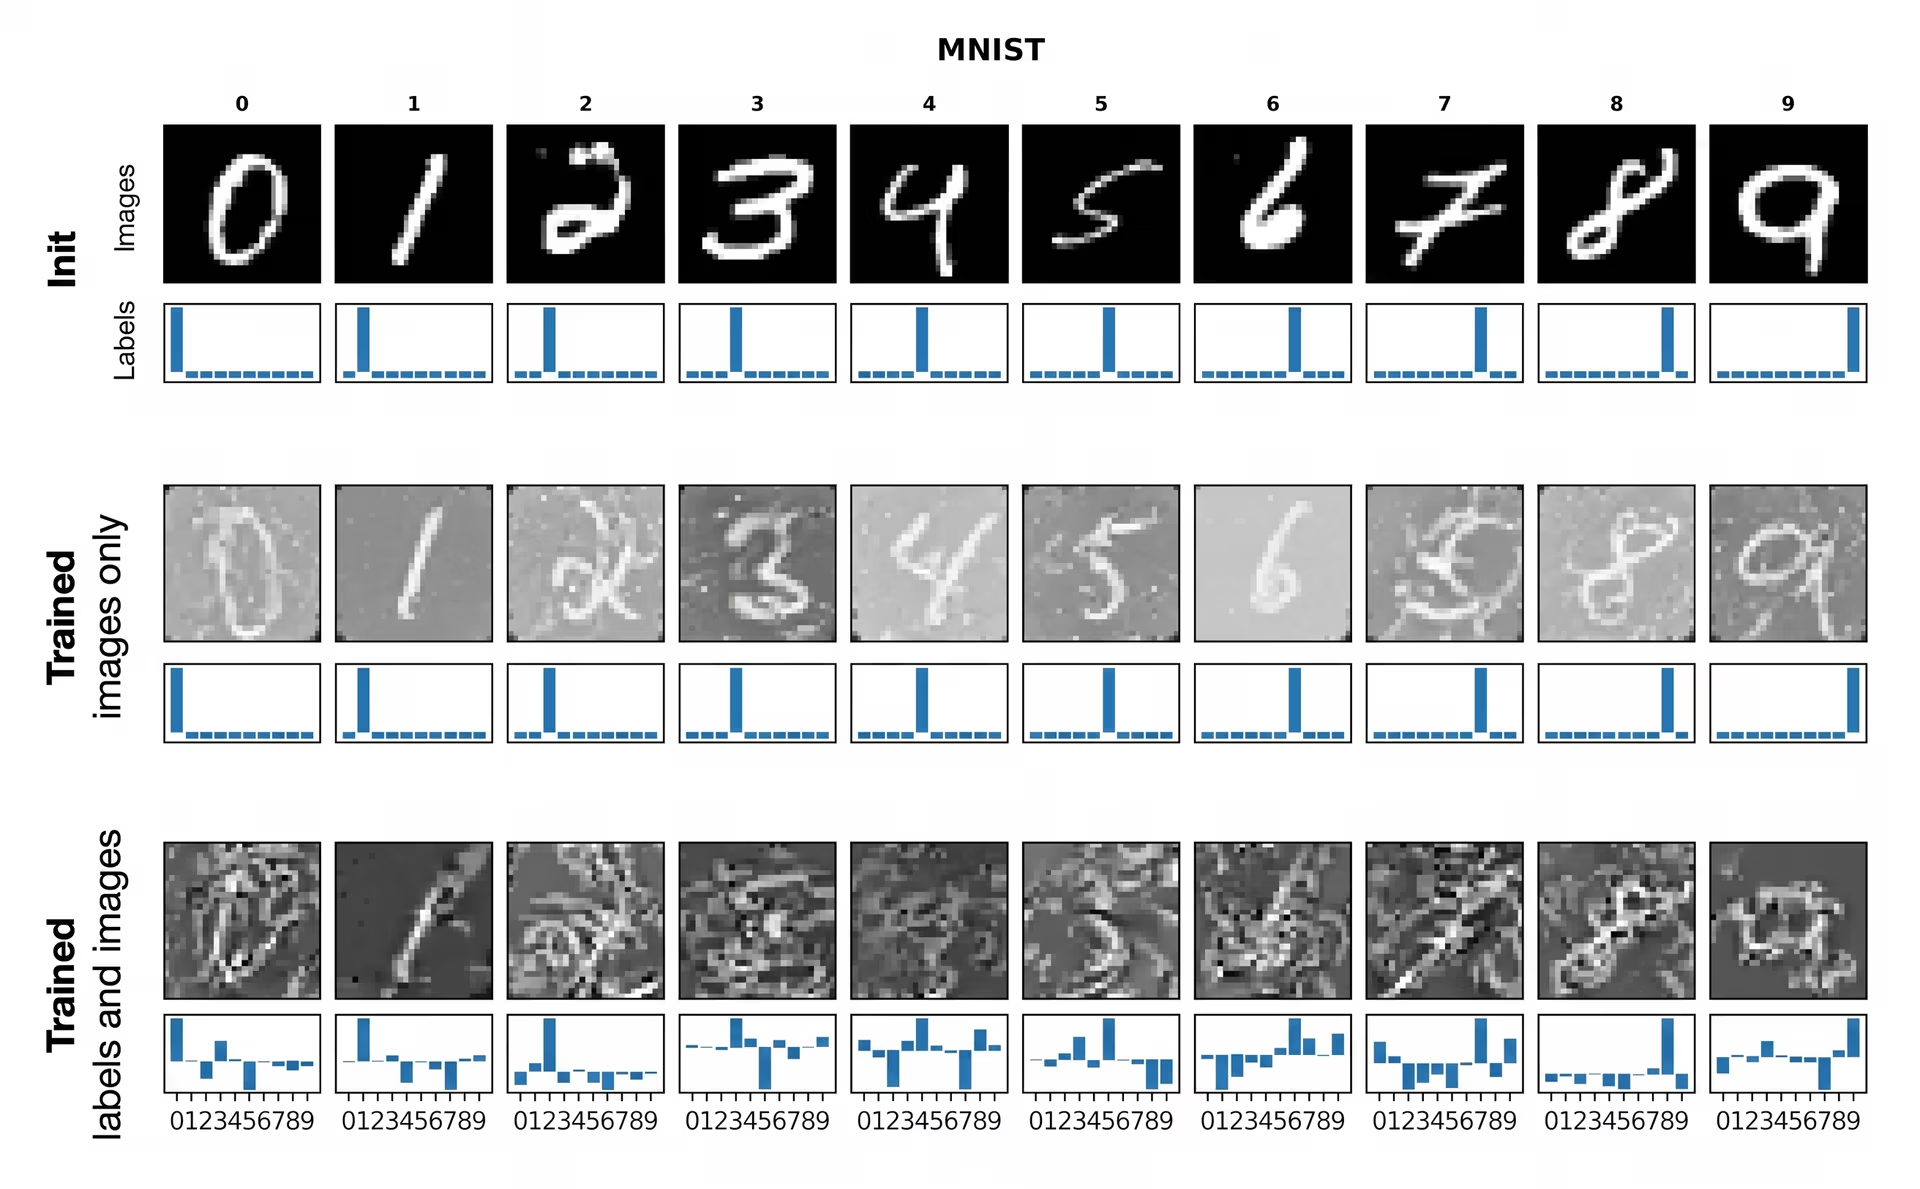
Fig. 4. Un esempio di distillazione di un dataset (Fonte)
Nei casi d'uso della classificazione delle immagini, come le scansioni mediche, il monitoraggio della fauna selvatica o il rilevamento di difetti in fabbrica, i modelli spesso devono affrontare un difficile compromesso tra accuratezza e costi di addestramento. Queste attività comportano in genere dataset enormi.
La distillazione dei dataset può comprimere il set di addestramento originale in poche immagini sintetiche che contengono comunque gli indizi visivi più importanti per il classificatore. Su benchmark di grandi dimensioni come ImageNet, è stato dimostrato che i set distillati, composti da appena il 4,2% delle immagini originali, mantengono un'elevata accuratezza di classificazione. Ciò significa che un piccolo proxy sintetico può sostituire milioni di campioni reali richiedendo molte meno risorse di calcolo.
Ricerca dell'architettura neurale#
La ricerca dell’architettura neurale, o NAS, è una tecnica che esplora automaticamente numerose architetture di reti neurali per individuare quella più adatta a un’attività. Poiché la NAS deve addestrare e valutare molti modelli candidati, eseguirla su dataset completi può essere lento e richiedere un’enorme quantità di calcoli.
La distillazione dei dataset è utile perché crea un piccolo set di addestramento sintetico che conserva comunque il segnale di apprendimento principale dei dati originali, permettendo di testare ogni architettura candidata molto più rapidamente. In questo modo, la NAS può confrontare le architetture in modo efficiente mantenendo ragionevolmente affidabili le classifiche delle architetture migliori e peggiori, riducendo i costi della ricerca senza compromettere troppo la qualità finale del modello.
Apprendimento continuo e distribuzione su dispositivi edge#
I sistemi di apprendimento continuo, ovvero modelli che continuano ad aggiornarsi man mano che arrivano nuovi dati anziché essere addestrati una sola volta, richiedono aggiornamenti rapidi e con un uso efficiente della memoria. Anche i dispositivi edge, come telecamere, telefoni e sensori, devono fare i conti con limiti simili, perché dispongono di risorse di calcolo e archiviazione limitate.
La distillazione dei dataset è utile in entrambi i casi perché comprime un ampio set di addestramento in uno sintetico molto piccolo, così i modelli possono adattarsi o riaddestrarsi usando un piccolo set di replay anziché il dataset completo. Per esempio, uno studio sul meta-apprendimento basato su kernel ha dimostrato che appena 10 campioni distillati possono raggiungere un'accuratezza superiore al 64% su CIFAR-10, un benchmark standard per la classificazione delle immagini. Poiché il set di replay è così compatto, gli aggiornamenti diventano molto più rapidi e pratici, soprattutto quando i modelli devono essere aggiornati spesso.
La distillazione dei dataset può essere abbinata anche alla distillazione della conoscenza per i modelli linguistici di grandi dimensioni. Un piccolo dataset distillato può conservare i segnali più importanti del modello insegnante, così da addestrare o aggiornare in modo più efficiente un modello studente compresso senza perdere gran parte delle prestazioni. Essendo molto piccoli, questi dataset sono particolarmente utili sui dispositivi edge o direttamente sul dispositivo, dove le risorse di archiviazione e calcolo sono limitate, ma si vuole comunque mantenere accurato il modello dopo gli aggiornamenti.
Pro e contro della distillazione dei dati#
Ecco alcuni vantaggi della distillazione dei dataset:
- Ideale per esperimenti rapidi. Puoi testare nuove architetture, loss o iperparametri senza dover riaddestrare ogni volta un modello su un dataset enorme.
- Possibile vantaggio per la privacy. Condividere campioni sintetici distillati può essere più sicuro che condividere dati reali degli utenti, perché gli esempi originali non vengono esposti direttamente.
- Spesso più efficace della semplice selezione di un sottoinsieme. Invece di limitarsi a selezionare esempi, la distillazione li ottimizza attivamente per renderli il più informativi possibile.
La distillazione dei dataset offre diversi vantaggi, ma ecco alcuni limiti da tenere presenti:
- Overfitting. I dati distillati spesso funzionano meglio con l’architettura usata durante la distillazione e potrebbero trasferirsi male a modelli molto diversi.
- Sensibilità agli iperparametri. I risultati possono dipendere molto da fattori come il tasso di apprendimento, l'inizializzazione o il numero di passi di distillazione.
- Difficoltà di adattamento alla complessità del mondo reale. I metodi che funzionano bene sui benchmark possono perdere accuratezza con dataset ampi, eterogenei o ad alta risoluzione.
Punti chiave#
La distillazione dei dataset permette a un piccolo insieme di campioni sintetici di insegnare a un modello quasi con la stessa efficacia di un dataset completo. Questo rende il machine learning più rapido, efficiente e facile da scalare. Man mano che i modelli crescono e richiedono più dati, i dataset distillati offrono un modo pratico per ridurre i costi di calcolo senza sacrificare l'accuratezza.
Unisciti alla nostra community e dai un'occhiata al nostro repository GitHub per scoprire di più sull'AI. Se vuoi realizzare un tuo progetto di AI per la visione, consulta le nostre opzioni di licenza. Scopri di più sulle applicazioni come l'AI in ambito sanitario e l'AI per la visione nel commercio al dettaglio visitando le nostre pagine dedicate alle soluzioni.
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









