Ultralytics Platform: implementar modelos de visão computacional em qualquer região
Aprenda a implementar os seus modelos de visão computacional em qualquer região utilizando a Ultralytics Platform, para uma implementação de IA escalável, rápida e flexível.
No início desta semana, a Ultralytics lançou a Ultralytics Platform, um novo ambiente completo concebido para acelerar a implementação de sistemas de visão computacional (CV), simplificando todas as etapas do fluxo de trabalho de IA de visão, desde a preparação dos dados e o desenvolvimento do modelo até à implementação.
Uma das principais motivações para desenvolver a Ultralytics Platform é que levar uma solução de visão computacional que permite às máquinas analisar imagens e vídeos desde a ideia até à geração de impacto envolve mais do que criar um modelo robusto. Depois de treinado e validado, o modelo tem de ser implementado para que as aplicações possam enviar imagens, receber previsões e executar inferências de forma fiável em ambientes reais.
É nesta fase do ciclo de vida do machine learning que os modelos de visão computacional deixam de ser apenas experimentais e começam a alimentar sistemas práticos. Mesmo que etapas anteriores, como a preparação do conjunto de dados, a anotação, o treino do modelo e os testes, decorram sem problemas, sem uma forma fiável de implementar os modelos, esses resultados não conseguem fazer a diferença.
A realidade em muitos projetos de visão computacional é que a implementação pode ser uma das etapas mais complexas do fluxo de trabalho.
As equipas precisam frequentemente de configurar APIs de inferência, gerir recursos computacionais, implementar modelos perto dos utilizadores para reduzir a latência e monitorizar o desempenho depois de os sistemas entrarem em produção.
A Ultralytics Platform simplifica e automatiza este processo ao disponibilizar várias opções de implementação, incluindo formatos de exportação de modelos, serviços de inferência partilhados e endpoints dedicados em regiões de todo o mundo. Com infraestrutura gerida e monitorização integrada, as equipas podem passar facilmente de modelos treinados para sistemas de visão computacional prontos para produção.
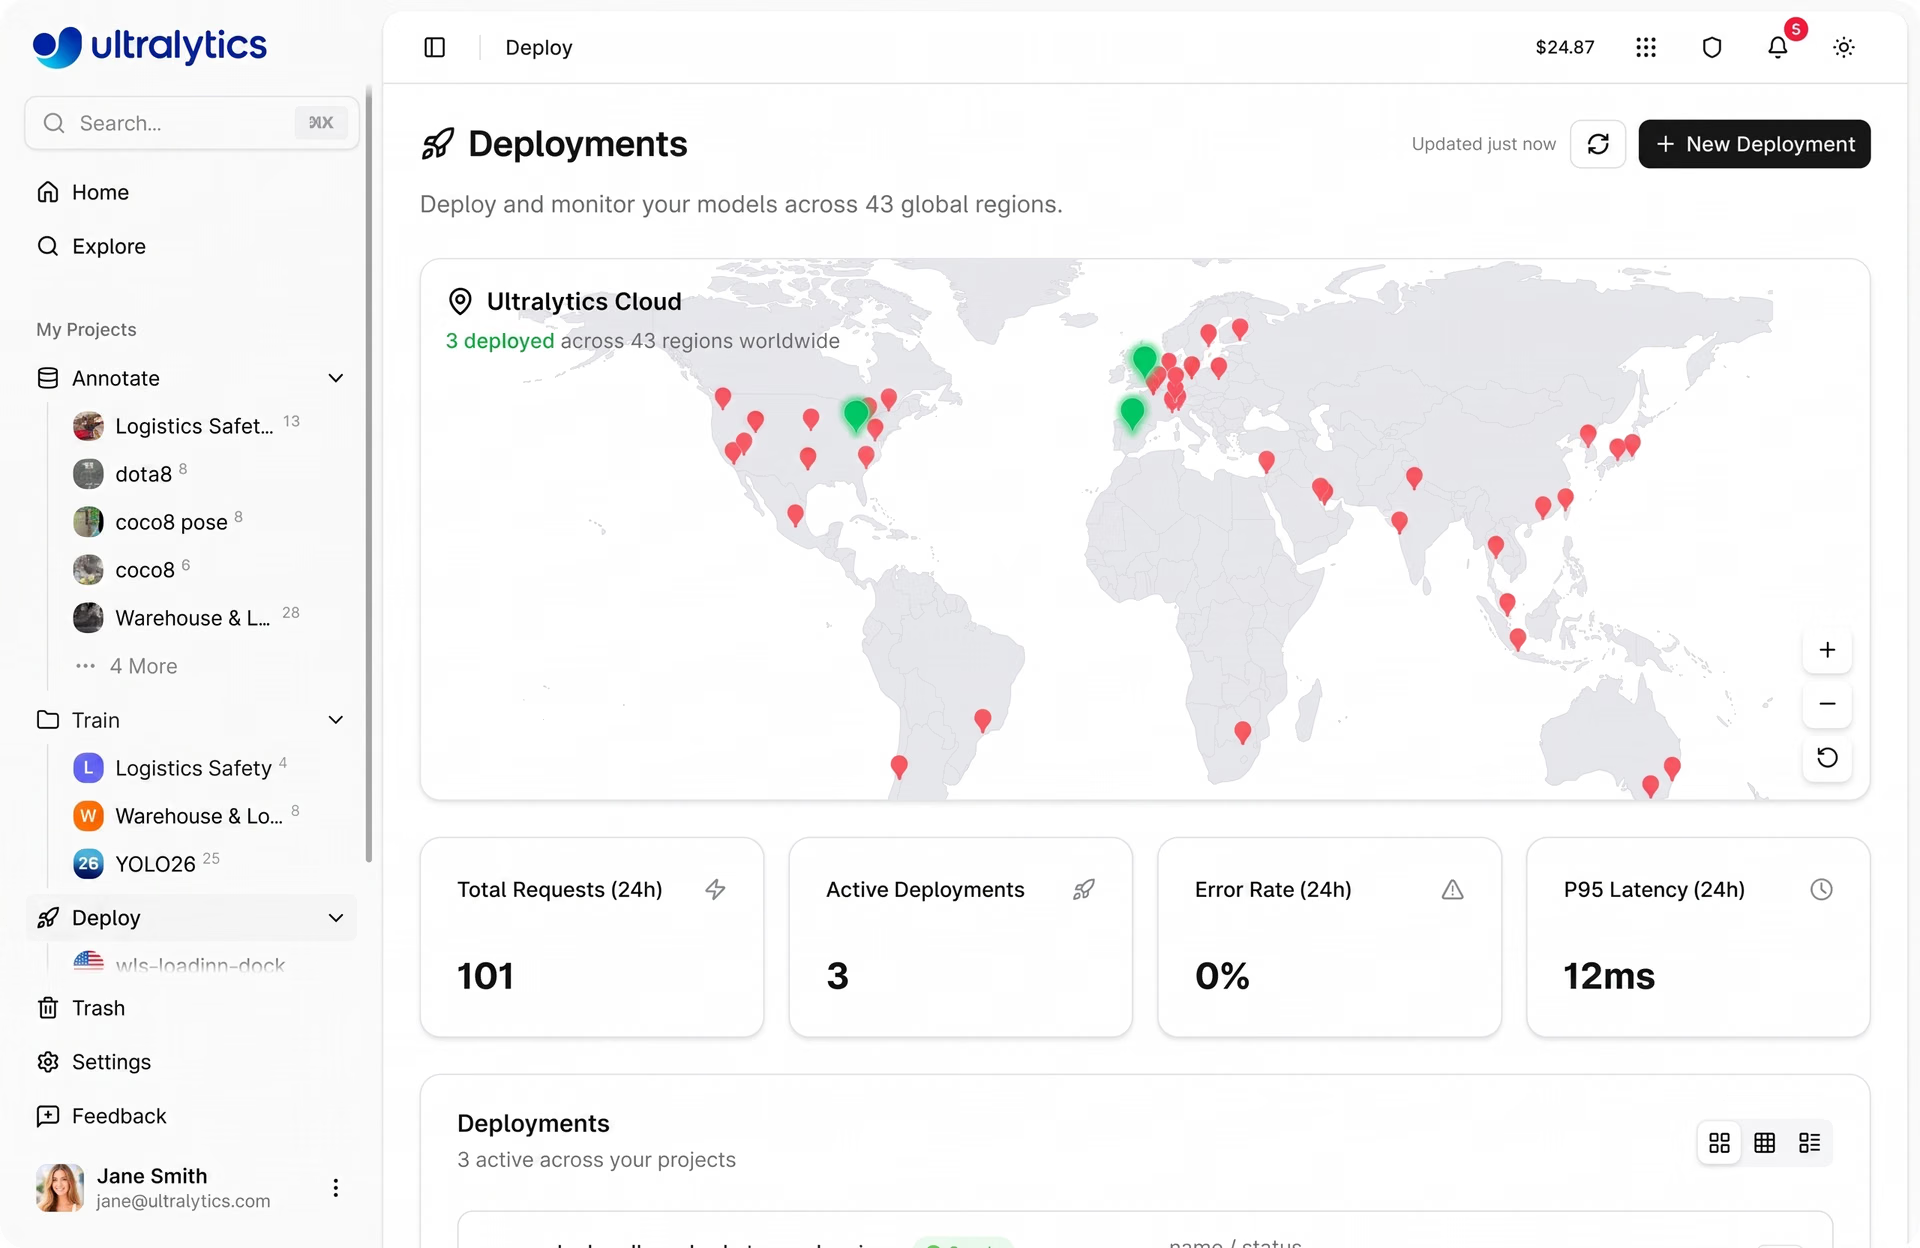
Fig. 1. Uma vista da implementação de modelos com a Ultralytics Platform (Fonte)
Neste artigo, vamos explorar como implementar modelos de visão computacional em qualquer região utilizando endpoints dedicados na Ultralytics Platform. Vamos começar!
O que é a implementação de modelos de CV?#
Antes de vermos como implementar modelos de deep learning com a Ultralytics Platform, vamos compreender melhor o que significa, na prática, implementar um modelo de visão computacional.
A implementação de modelos de visão computacional é o processo de pegar num modelo treinado e disponibilizá-lo para utilização no mundo real. Em vez de ser executado apenas num ambiente de treino, o modelo é configurado para que as aplicações lhe possam enviar imagens ou vídeos e receber previsões em resposta.
Por exemplo, um modelo pode detetar objetos numa imagem, realizar segmentação de imagens, identificar itens num armazém ou reconhecer padrões em imagens de vídeo. Na maioria dos sistemas reais, isto acontece através de uma API ou endpoint de inferência.
Uma aplicação envia uma imagem para o modelo, o modelo processa-a e devolve uma previsão em milissegundos. É isto que permite que modelos de visão computacional como o Ultralytics YOLO viabilizem aplicações em tempo real.
Os modelos podem ser implementados em diferentes ambientes, dependendo do caso de utilização. Alguns são executados na cloud (através de plataformas cloud) e podem ser acedidos por muitas aplicações, enquanto outros são executados em dispositivos edge, como câmaras locais, robôs ou sistemas incorporados que precisam de previsões locais rápidas.
Opções de implementação de modelos de IA na Ultralytics Platform#
Embora a Ultralytics Platform resolva muitos dos desafios enfrentados pela comunidade de visão computacional, especialmente no que diz respeito à implementação de modelos, disponibiliza formas flexíveis de executar inferências, dependendo das necessidades da tua aplicação.
Eis uma breve análise das opções de implementação de modelos disponíveis na plataforma:
- Exportação de modelos: podes exportar modelos para 17 formatos diferentes, incluindo ONNX, TensorRT, CoreML e TFLite, o que permite executar modelos numa ampla variedade de ambientes, como dispositivos edge, incluindo Raspberry Pi e NVIDIA Jetson, aplicações móveis, contentores Docker e infraestrutura personalizada.
- Inferência partilhada: a plataforma permite executar previsões através de um serviço gerido de inferência partilhada, ideal para testar modelos rapidamente.
- Endpoints dedicados: implementa facilmente modelos como serviços independentes com URLs de API exclusivos, que podem ser executados em 43 regiões de todo o mundo, com dimensionamento automático, monitorização e verificações de integridade integrados para implementações em produção.
Implementação com endpoints dedicados#
Uma das formas mais escaláveis de executar modelos pré-treinados ou modelos de visão computacional treinados à medida em produção na Ultralytics Platform é através de endpoints dedicados. Um endpoint dedicado permite implementar um modelo treinado como um serviço próprio, para que as aplicações lhe possam enviar imagens e receber previsões através de uma API.
Em vez de executar um modelo apenas num ambiente de treino ou num notebook local, implementá-lo como endpoint torna-o acessível a aplicações reais. Por exemplo, um sistema de armazém poderia enviar imagens de encomendas para deteção de objetos, uma câmara inteligente poderia analisar frames de vídeo ou um sistema robótico poderia utilizar previsões para orientar ações.
Cada endpoint dedicado é executado como um serviço de inquilino único, o que significa que a infraestrutura que executa o teu modelo não é partilhada com outros utilizadores. Isto proporciona um desempenho mais previsível e facilita a monitorização do comportamento do modelo em produção.
Compreender a funcionalidade dos endpoints de inferência dedicados#
Podes pensar num endpoint dedicado como um serviço alojado para o teu modelo. A Ultralytics Platform fornece um URL de endpoint exclusivo que funciona como ponto de entrada para as aplicações.
Quando uma aplicação envia um pedido para esse URL, inclui uma imagem e parâmetros opcionais, como limiares de confiança ou o tamanho da imagem, juntamente com uma chave de API para autenticação.
O serviço executa a inferência na imagem utilizando o teu modelo e devolve as previsões numa resposta estruturada. Esta configuração permite aos programadores integrar modelos de visão computacional em sistemas reais utilizando ferramentas web padrão.
As aplicações podem enviar pedidos utilizando Python, JavaScript, cURL ou outros clientes HTTP, o que facilita a ligação dos modelos a dashboards, sistemas robóticos ou aplicações cloud. Como o endpoint é executado de forma independente, também pode suportar dimensionamento, monitorização e implementação global, ajudando as equipas a criar sistemas de visão computacional fiáveis para produção.
A implementação multirregional melhora a inferência em tempo real#
Uma das principais vantagens dos endpoints dedicados na Ultralytics Platform é a possibilidade de implementar modelos em 43 regiões de todo o mundo. Estas regiões abrangem várias partes do mundo, incluindo a América do Norte, a América do Sul, a Europa, a Ásia-Pacífico e o Médio Oriente e África.
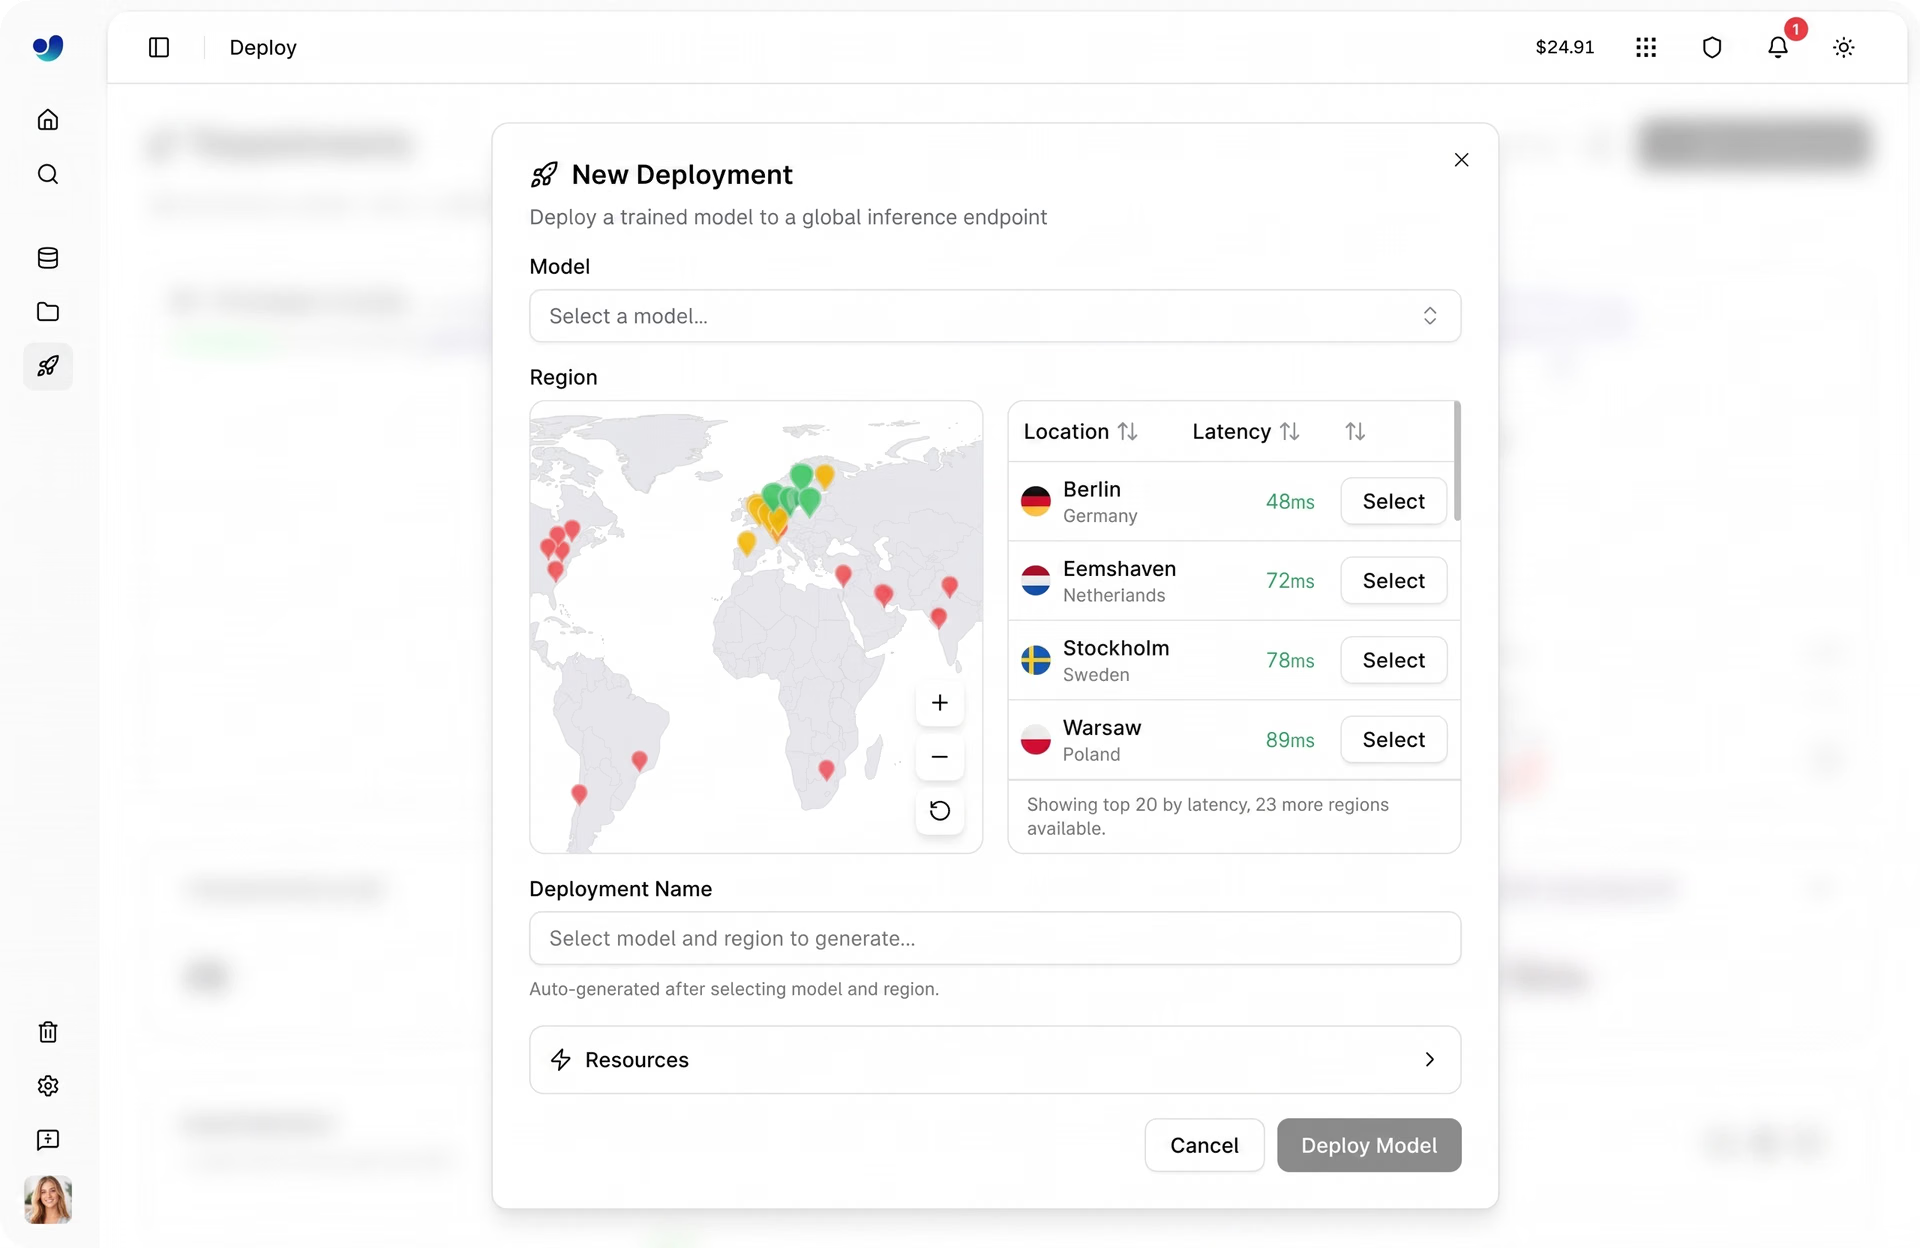
Fig. 2. A Ultralytics Platform suporta 43 regiões de todo o mundo (Fonte)
Implementar modelos em regiões mais próximas do local onde as aplicações são executadas ajuda a reduzir a latência, ou seja, o tempo necessário para uma aplicação enviar uma imagem e receber uma previsão. Também pode ajudar as organizações a cumprir requisitos de privacidade e residência dos dados, mantendo o processamento dos dados mais próximo da sua origem.
A baixa latência é importante para muitas aplicações de visão computacional que dependem de inferência em tempo real, como sistemas robóticos, dispositivos da Internet das Coisas (IoT), fluxos de inspeção industrial e infraestruturas de cidades inteligentes.
Por exemplo, se uma aplicação for utilizada principalmente na Europa, implementar o modelo numa região europeia pode melhorar significativamente os tempos de resposta em comparação com a execução do modelo numa região distante.
Como implementar em qualquer região com a Ultralytics Platform#
Implementar um modelo numa região específica é simples e normalmente demora apenas alguns minutos. A plataforma trata da configuração da infraestrutura para que os programadores se possam concentrar na integração do modelo nas suas aplicações. Vamos percorrer os passos envolvidos.
Passo 1: Treinar ou carregar um modelo#
Antes de implementar, precisas de ter um modelo treinado disponível no teu projeto. Pode ser um modelo treinado diretamente na Ultralytics Platform, um modelo carregado depois de ter sido treinado noutro local ou um modelo clonado de um projeto da comunidade encontrado no separador “Explore”, onde projetos públicos partilhados por outros utilizadores podem ser copiados para a tua própria conta com um único clique.
Quando o modelo estiver pronto, abre a respetiva página do modelo dentro do teu projeto para prosseguir.
Passo 2: Abrir o separador Deploy#
Acede ao separador Deploy do modelo. Esta secção da plataforma permite configurar e iniciar implementações.
Nessa página, encontrarás uma tabela de regiões e um mapa interativo que mostra os locais de implementação disponíveis em todo o mundo. A plataforma mede a latência a partir da tua localização e ordena as regiões em conformidade, para te ajudar a escolher a região mais adequada.
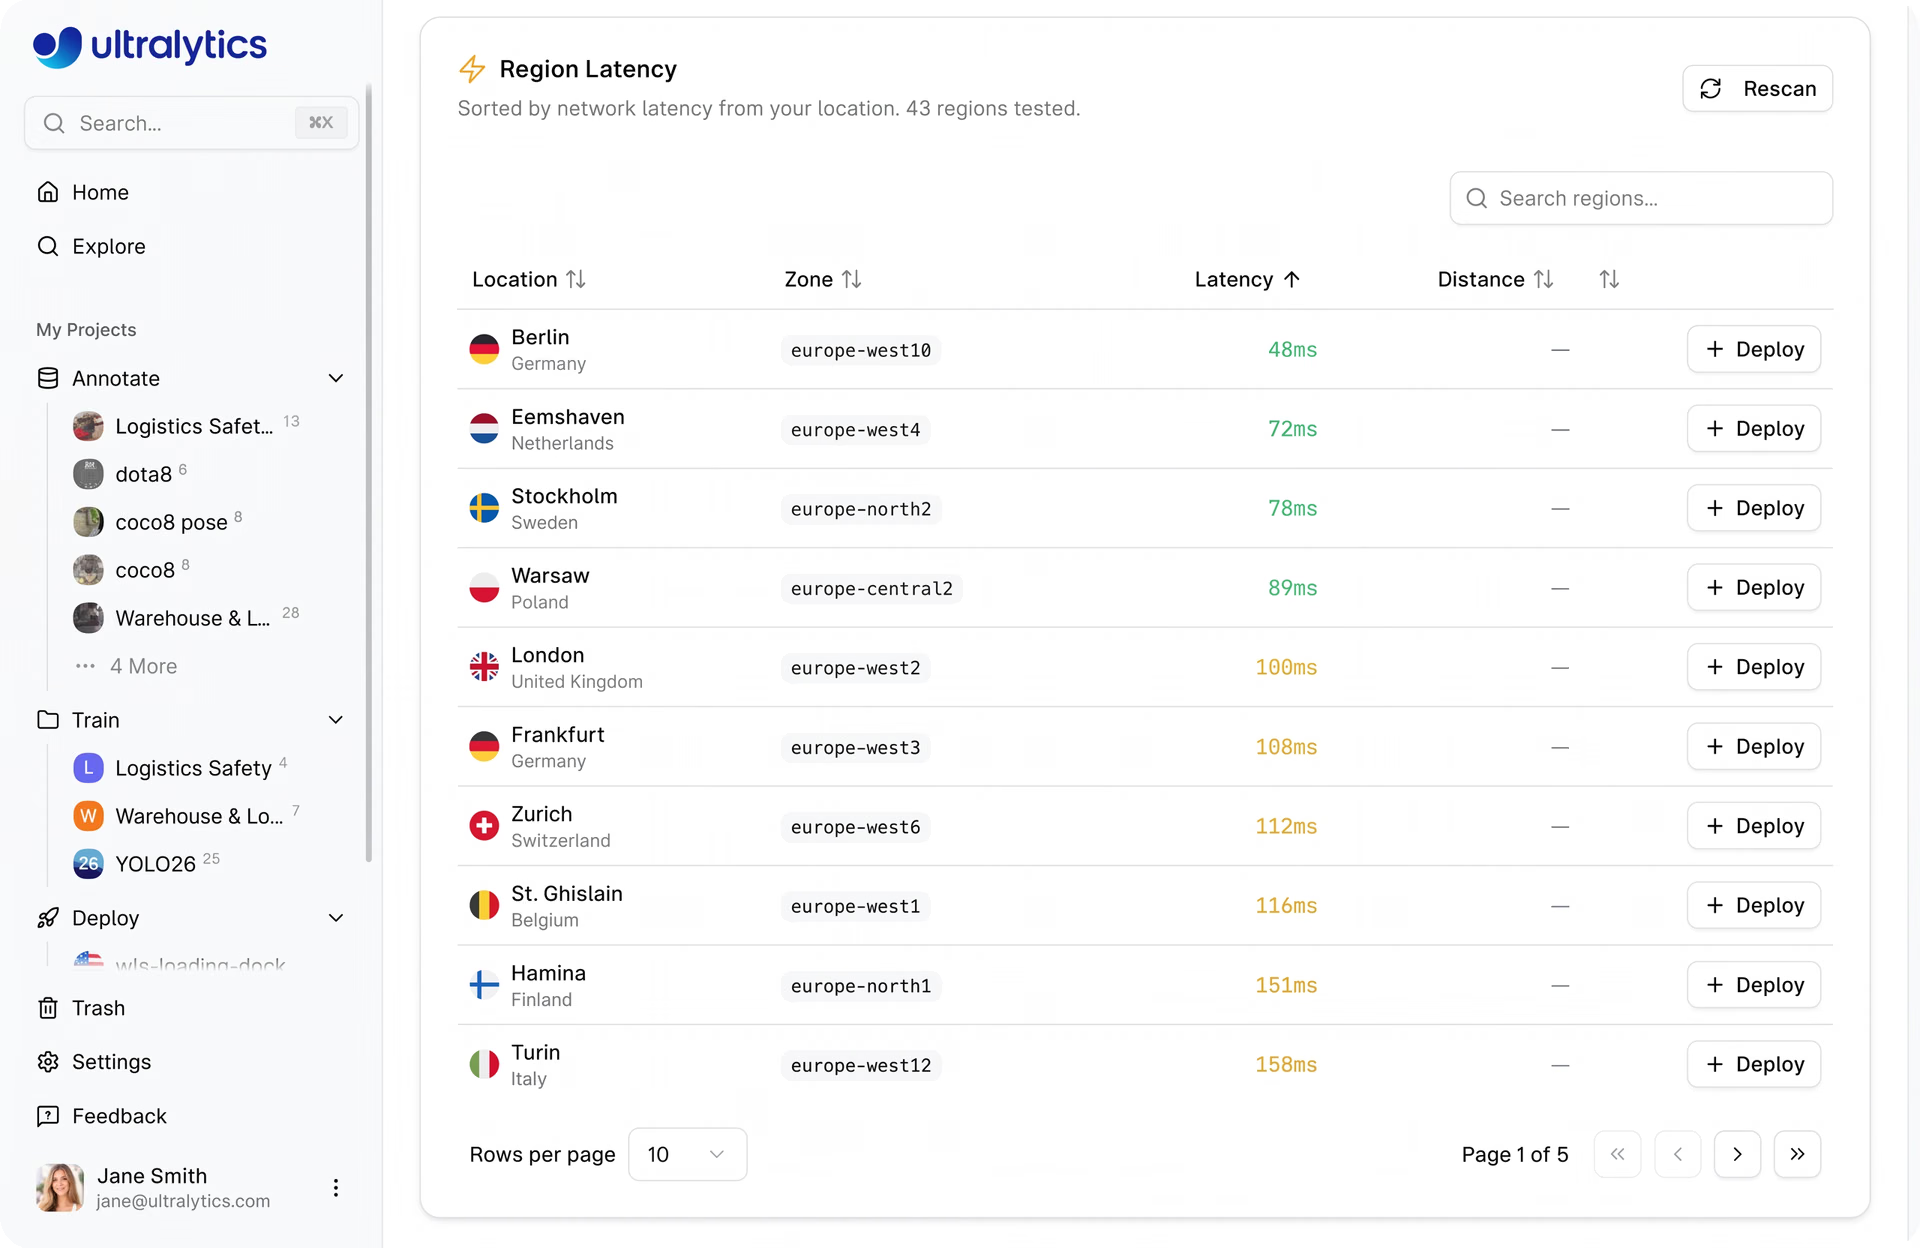
Fig. 3. Regiões ordenadas por latência na Ultralytics Platform (Fonte)
Passo 3: Escolher uma região de implementação#
Seleciona uma região com base no local onde se encontram os teus utilizadores ou aplicações. Implementar o modelo mais perto da origem dos pedidos pode reduzir significativamente os tempos de resposta.
Passo 4: Implementar o endpoint#
Depois de selecionares a região e confirmares a configuração, podes clicar em Deploy.
A plataforma prepara então o ambiente de implementação, obtém a imagem do modelo, inicia o serviço e executa uma verificação de integridade para garantir que o endpoint está pronto. Este processo demora normalmente cerca de um a dois minutos.
Quando a implementação estiver concluída, a plataforma gera um URL de endpoint exclusivo que as aplicações podem utilizar para enviar pedidos de inferência.
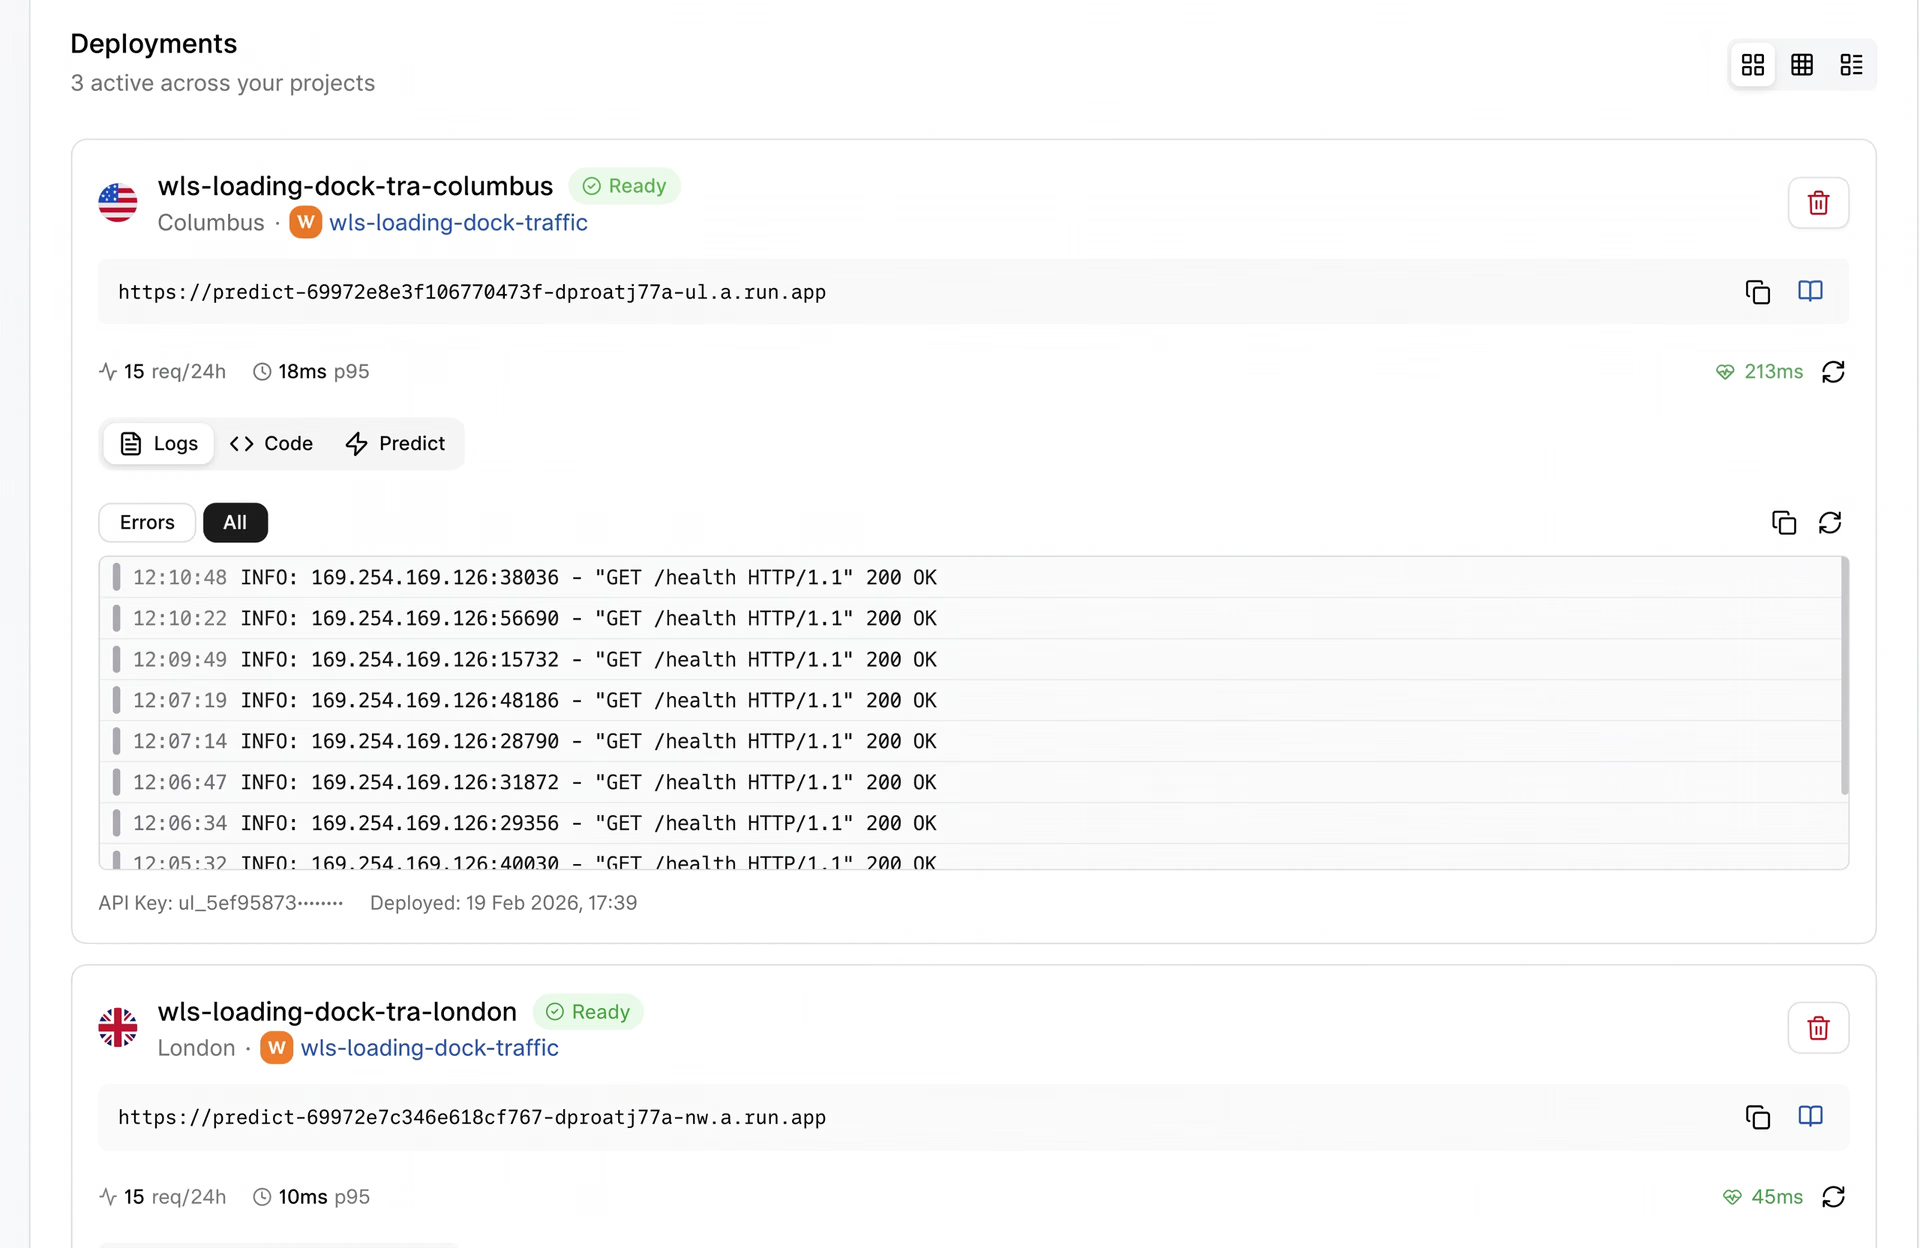
Fig. 4. Exemplo de um endpoint implementado (Fonte)
Passo 5: Começar a enviar pedidos de inferência#
Com o endpoint em execução, as aplicações podem começar a enviar imagens para o modelo utilizando o endpoint da REST API fornecido e uma chave de API transmitida no cabeçalho Authorization. O endpoint processa cada pedido e devolve previsões, como objetos detetados, caixas delimitadoras ou outros resultados específicos da tarefa.
Para mais informações relacionadas com a implementação de modelos, consulta a documentação oficial da Ultralytics Platform.
Monitorizar o desempenho e as métricas dos modelos para endpoints implementados#
Depois de um modelo de visão computacional ser implementado, monitorizar o seu desempenho torna-se uma parte importante da manutenção da fiabilidade e robustez do sistema. Mesmo um modelo bem treinado precisa de ser observado em produção para garantir que continua a responder rapidamente, a processar corretamente os pedidos recebidos e a fornecer previsões precisas.
A Ultralytics Platform disponibiliza ferramentas de monitorização integrada que dão às equipas visibilidade sobre o desempenho dos endpoints implementados. A página Deploy da plataforma funciona como um dashboard de monitorização, oferecendo uma vista centralizada de todos os endpoints em execução, juntamente com métricas essenciais que ajudam a acompanhar o estado e a utilização do sistema.
Eis algumas das métricas que podes monitorizar utilizando a Platform:
- Latência P95: esta métrica mede o tempo de resposta no lado do servidor correspondente ao percentil 95 dos pedidos de inferência. Fornece informações sobre o tempo que demora a maioria dos pedidos de inferência e identifica abrandamentos de desempenho.
- Taxa de erros: representa a percentagem de pedidos que falharam ou devolveram erros durante a janela de monitorização selecionada. Monitorizar as taxas de erro permite às equipas detetar rapidamente problemas nas implementações ou nos pedidos recebidos.
- Total de pedidos: esta métrica apresenta o número total de pedidos de inferência processados nos endpoints implementados durante o período selecionado (por exemplo, nas últimas 24 horas). Ajuda as equipas a compreender os níveis de tráfego e a frequência com que os seus modelos estão a ser utilizados.
Além destas métricas, a plataforma também disponibiliza verificações de integridade dos endpoints e registos de implementação. As verificações de integridade indicam se um endpoint está a responder corretamente, enquanto os registos fornecem informações detalhadas sobre os pedidos recentes e a atividade do sistema.
Principais conclusões#
Implementar modelos de visão computacional é um passo crucial para transformar modelos treinados em sistemas que alimentam aplicações do mundo real. Com a Ultralytics Platform, as equipas podem implementar facilmente modelos através de endpoints dedicados em 43 regiões de todo o mundo, executar inferências em tempo real através de APIs e monitorizar o desempenho a partir de um único ambiente. Ao combinar opções de implementação flexíveis, monitorização integrada e infraestrutura escalável, a plataforma ajuda os programadores a passar mais rapidamente de modelos de machine learning treinados para aplicações de visão computacional fiáveis.
Faz parte da nossa comunidade em crescimento! Explora o nosso repositório do GitHub para saberes mais sobre IA. Se procuras criar soluções de visão computacional, consulta as nossas opções de licenciamento. Descobre as vantagens da visão computacional na área da saúde e vê como a IA na logística está a fazer a diferença!








