Como exportar modelos Ultralytics YOLO usando a Ultralytics Platform
Exporte modelos de IA visual com facilidade usando a Ultralytics Platform. Veja como preparar modelos em poucos cliques para implantação em dispositivos de borda, dispositivos móveis e na nuvem.
No mês passado, lançamos a Ultralytics Platform, um espaço de trabalho unificado projetado para simplificar todo o fluxo de trabalho de visão computacional. Ela reúne os principais recursos de IA para visão computacional, incluindo gerenciamento de conjuntos de dados, anotação, treinamento de modelos, testes, implantação e monitoramento, em uma única interface simplificada.
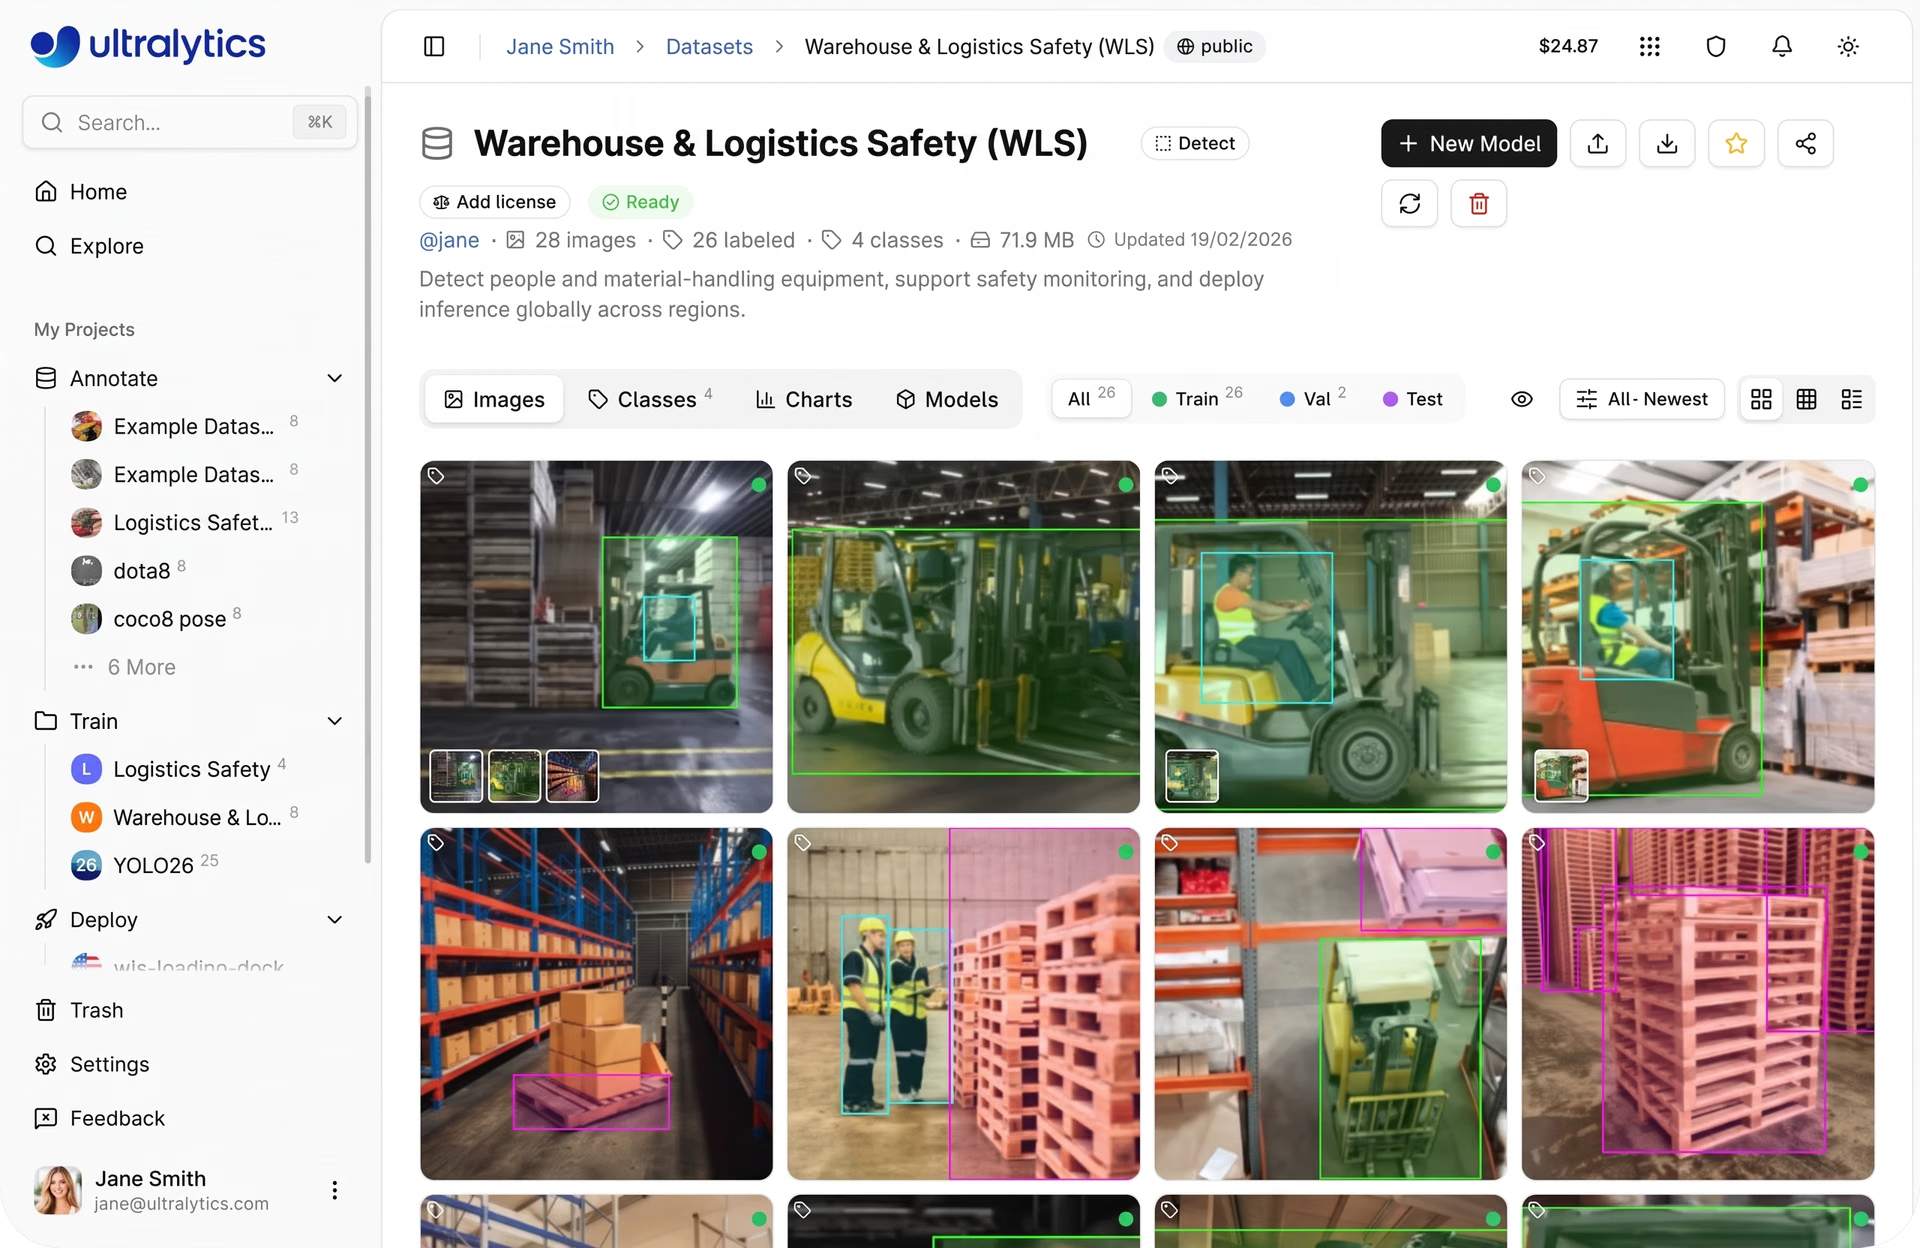
Fig. 1. Uma visão geral da Ultralytics Platform (Fonte)
Como parte desse fluxo de trabalho completo, a implantação desempenha um papel fundamental na transição dos modelos da experimentação para o uso no mundo real. Anteriormente, exploramos as diferentes opções de implantação disponíveis na plataforma, incluindo inferência compartilhada por meio de APIs, endpoints dedicados para implantações escaláveis em produção e exportação de modelos para execução em dispositivos de borda ou infraestrutura externa.
Agora, vamos analisar mais de perto a exportação de modelos e como ela viabiliza a implantação em diferentes ambientes. Ao contrário da inferência e dos endpoints dedicados, que executam modelos na infraestrutura gerenciada pela Ultralytics Platform, a exportação de modelos permite implantá-los e executá-los em ambientes externos, como dispositivos de borda, aplicativos móveis e infraestrutura personalizada.
Antes de os modelos serem executados nesses ambientes, eles precisam ser convertidos para formatos compatíveis com o ambiente de execução de destino. Cada configuração de implantação tem seus próprios requisitos, desde formatos leves para dispositivos móveis e de borda até formatos de alto desempenho para sistemas na nuvem e baseados em GPU.
Tradicionalmente, esse processo pode ser demorado e envolver scripts, dependências e várias ferramentas. Com a Ultralytics Platform, a exportação é muito mais simples. Os modelos podem ser convertidos e otimizados com apenas alguns cliques, sem configuração adicional.
Neste artigo, vamos explicar o que significa a exportação de modelos, quais formatos a Ultralytics Platform oferece e como escolher o mais adequado para seu caso de uso. Vamos começar!
Visão geral da exportação de modelos#
Exportar um modelo envolve converter um modelo pré-treinado ou treinado sob medida para um formato utilizável fora da estrutura original. Os modelos Ultralytics YOLO são criados com PyTorch e armazenados em seu formato nativo, que funciona bem para treinamento, avaliação e experimentação no ecossistema PyTorch.
No entanto, os ambientes de implantação geralmente têm requisitos diferentes de ambientes de execução e hardware. Por isso, o formato usado durante o treinamento nem sempre é adequado para a implantação.
Por exemplo, um aplicativo móvel pode precisar de um formato leve, otimizado para baixo consumo de energia, enquanto um aplicativo baseado em navegador precisa de um formato que funcione com eficiência em ambientes web.
Dispositivos de borda, como câmeras e sistemas embarcados, se beneficiam de modelos compactos e rápidos, enquanto os sistemas na nuvem são projetados para inferência de alto desempenho. Para atender a esses diferentes cenários, os modelos precisam ser exportados para formatos compatíveis.
Por que a opção de exportar modelos é mais importante do que nunca#
Hoje, os modelos de visão computacional estão sendo implantados mais perto de onde os dados são gerados, especialmente em dispositivos de borda. Smartphones executam aplicações de visão em tempo real, câmeras de CFTV realizam monitoramento no próprio dispositivo e sistemas autônomos dependem de decisões instantâneas.
No entanto, a implantação nesses ambientes traz seus próprios desafios. Dispositivos de borda têm capacidade computacional limitada, requisitos rigorosos de latência e restrições de memória e consumo de energia. Um modelo que apresenta bom desempenho durante o treinamento, com recursos suficientes, pode não funcionar com eficiência nessas condições restritas.
Exportar um modelo para o formato adequado pode ajudar a resolver esses desafios. Com a conversão apropriada, o modelo pode ser otimizado para ganhar velocidade, ter seu tamanho reduzido e se tornar compatível com hardware específico.
Ao mesmo tempo, a exportação oferece flexibilidade. O mesmo modelo pode ser adaptado a diferentes ambientes de implantação, convertendo-o para vários formatos de acordo com requisitos específicos.
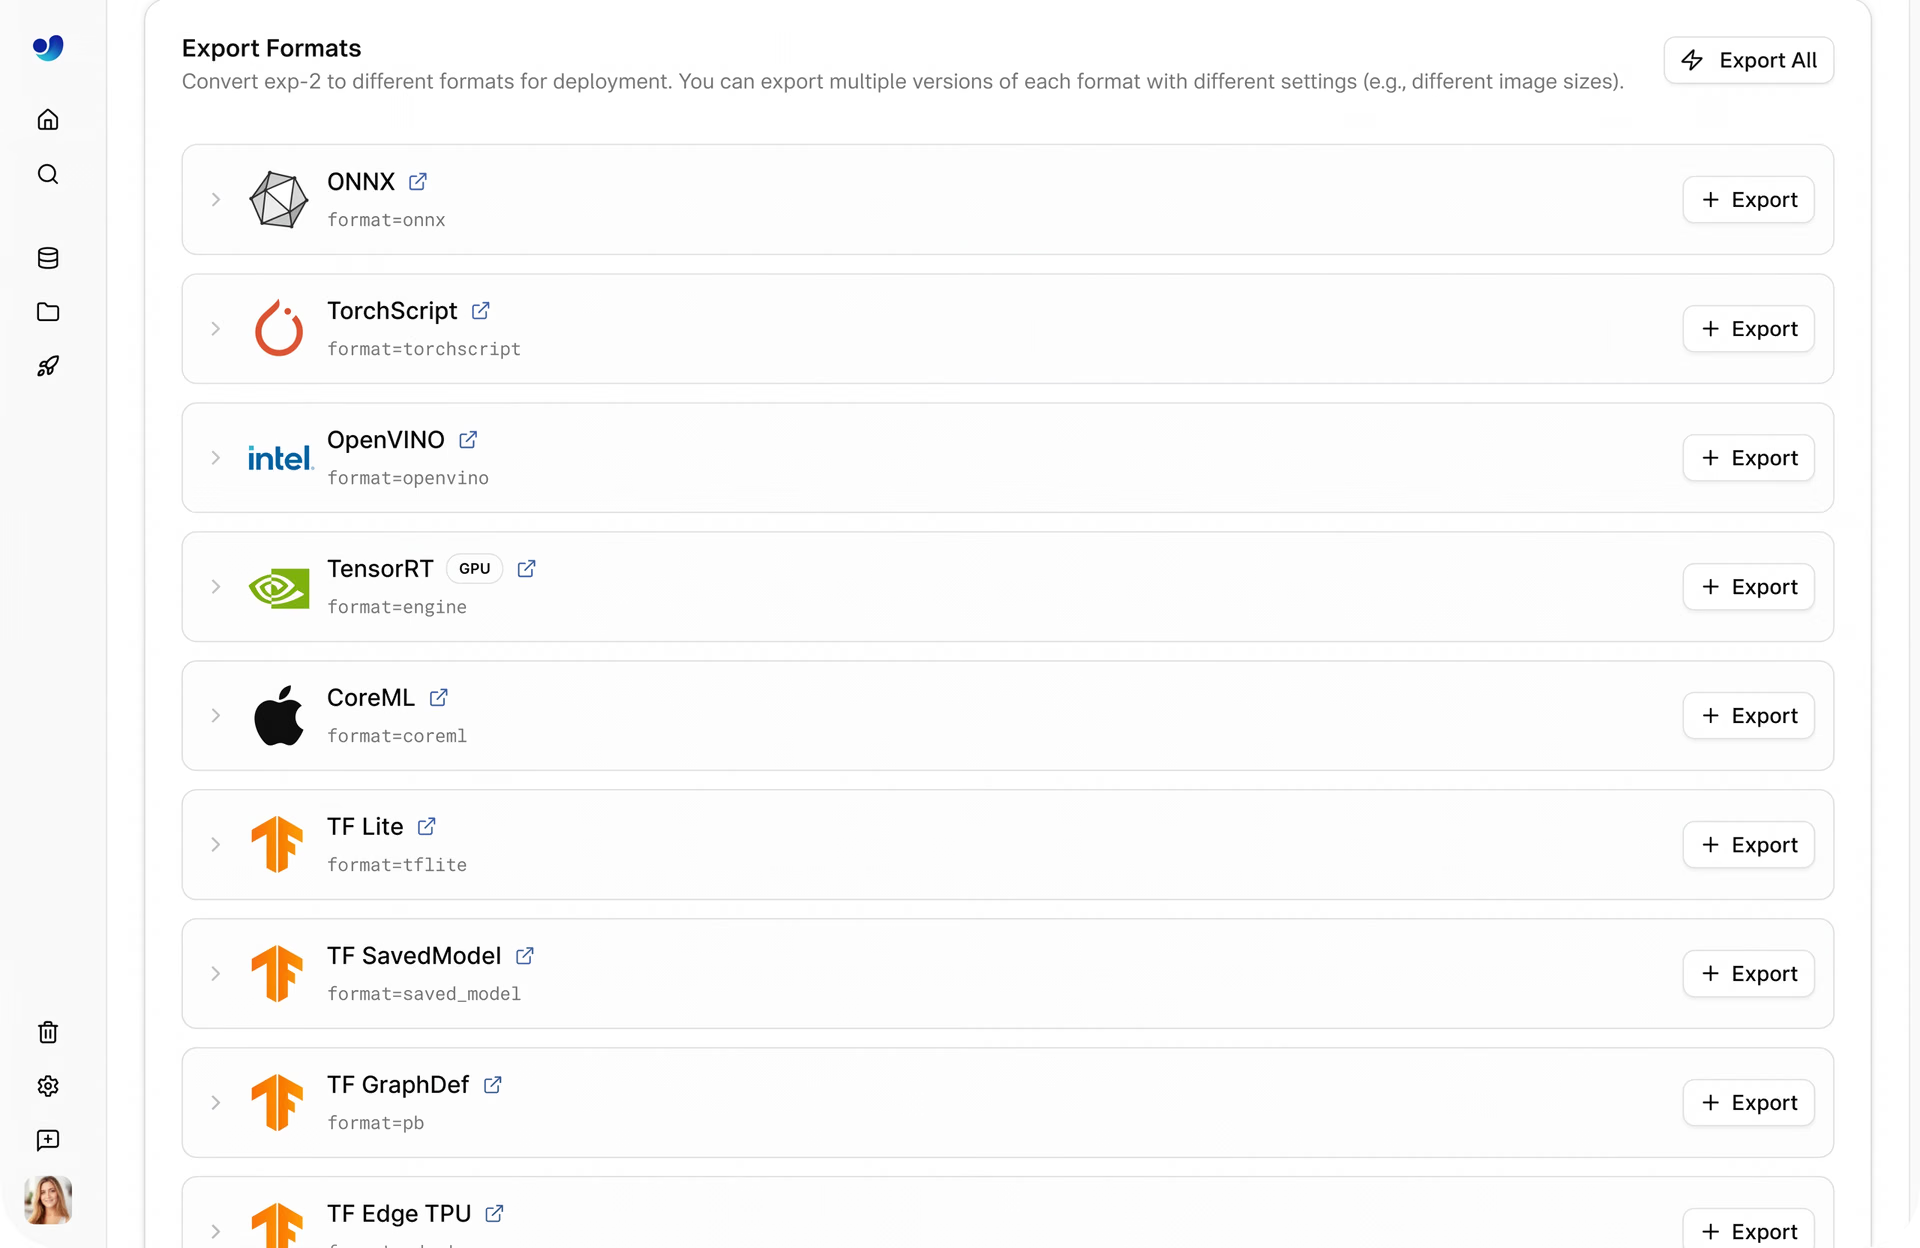
Fig. 2. Alguns dos formatos de exportação disponíveis na Ultralytics Platform (Fonte)
Por exemplo, o formato de modelo NCNN é otimizado para dispositivos móveis e de borda, com baixo uso de recursos. Já o formato OpenVINO é voltado para hardware Intel e oferece melhor desempenho em unidades centrais de processamento (CPUs), unidades de processamento gráfico (GPUs) e unidades de processamento neural (NPUs).
Na maioria dos casos, alcançar esse nível de flexibilidade significava lidar com conversões manuais, dependências e várias ferramentas, o que tornava o processo demorado e complexo. A Ultralytics Platform simplifica esse fluxo de trabalho, tornando a exportação de modelos mais acessível e fácil de gerenciar.
Como a Ultralytics Platform simplifica a exportação de modelos#
Em geral, a exportação de modelos é tratada como uma etapa separada e complexa nos fluxos de trabalho de visão computacional. A Ultralytics Platform muda isso ao integrar a opção de exportar um modelo diretamente em um único espaço de trabalho que abrange desde o treinamento até a implantação.
Uma de suas principais vantagens é a experiência de exportação sem código. Não é necessário escrever scripts, gerenciar ambientes nem usar comandos específicos de uma estrutura. Os modelos podem ser exportados com apenas alguns cliques, por meio de uma interface simples.
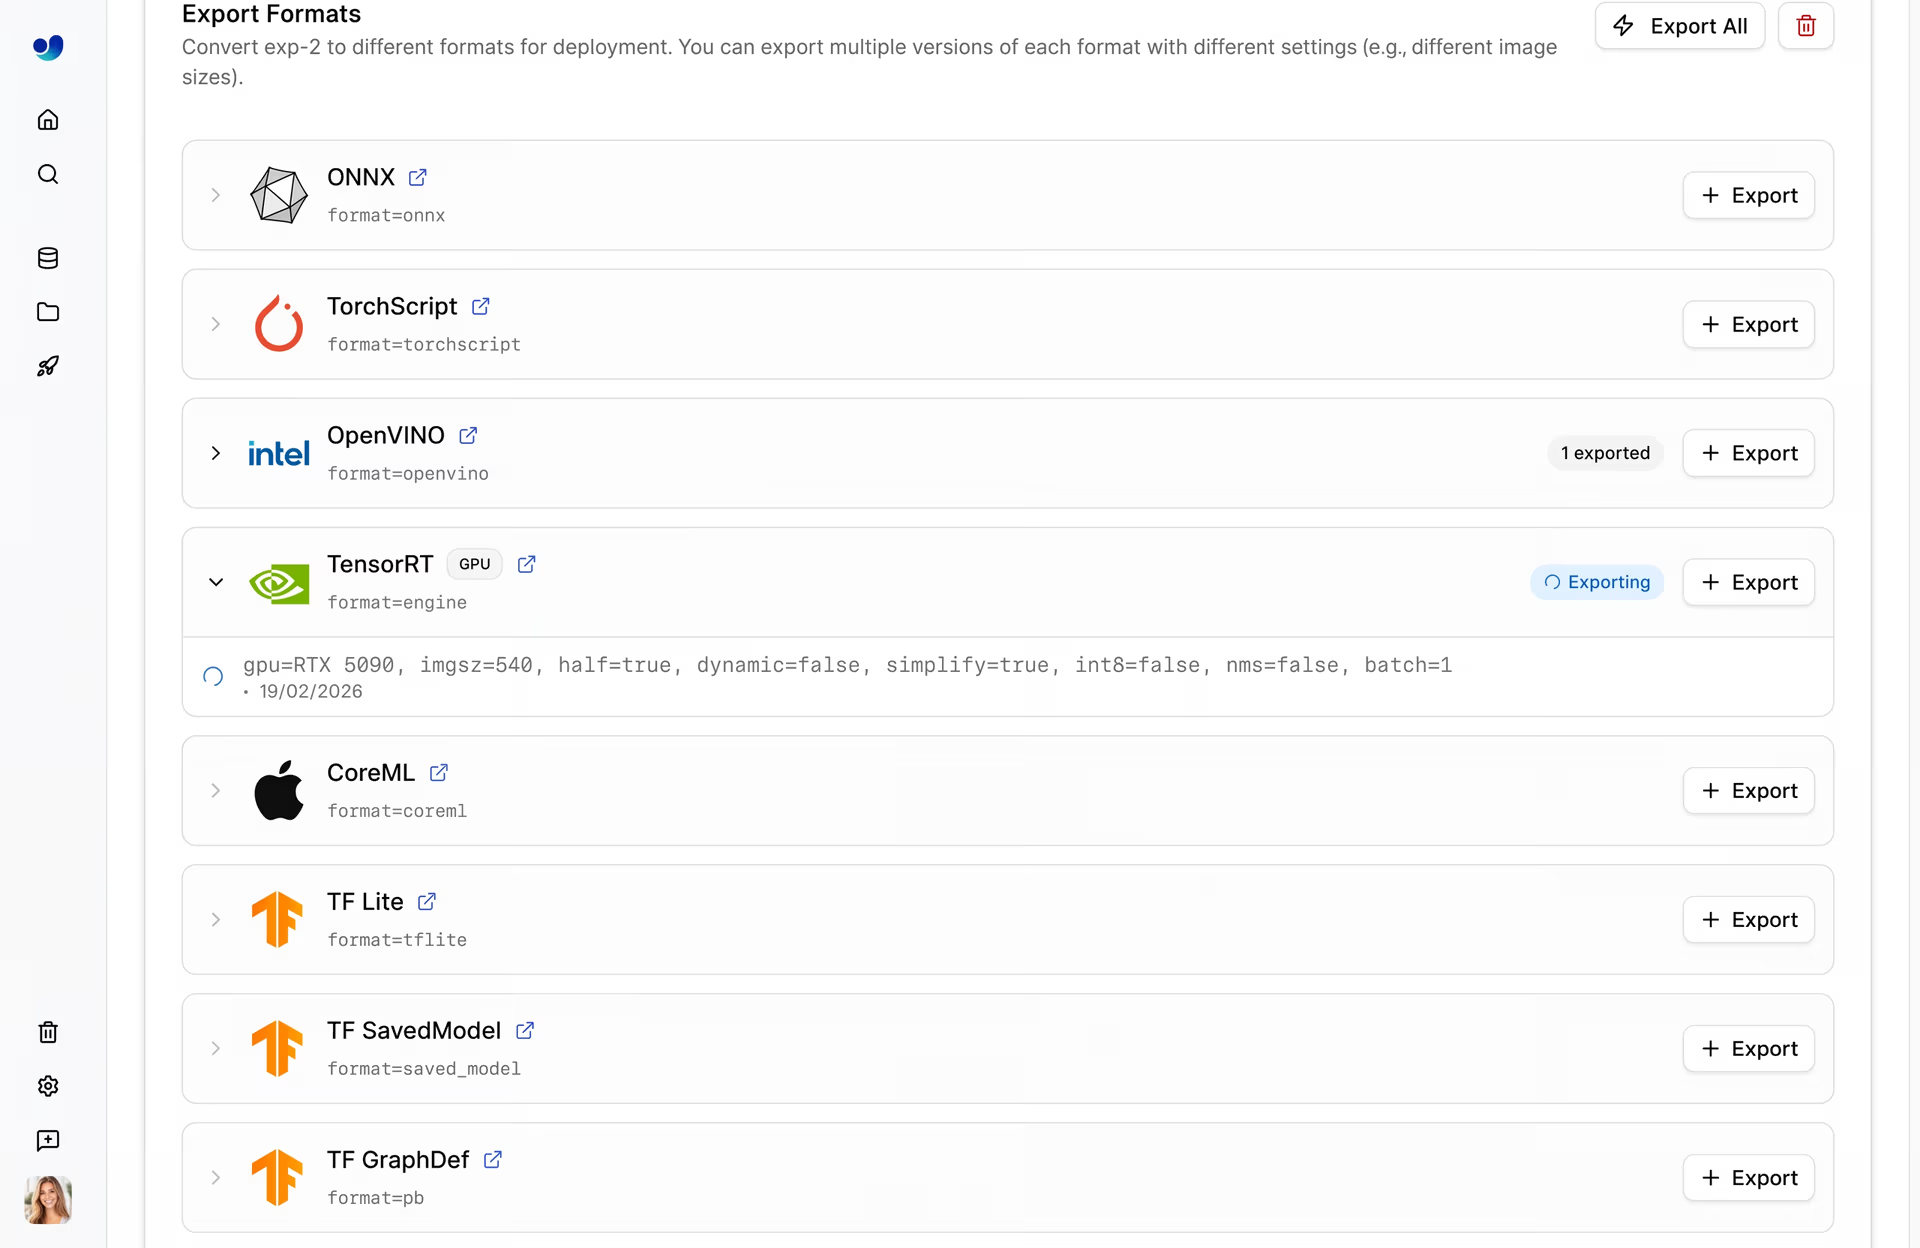
Fig. 3. Exemplo de exportação de um modelo pela Ultralytics Platform (Fonte)
Nos bastidores, a plataforma cuida da maior parte do trabalho. Tarefas que normalmente exigiriam várias ferramentas e configuração manual são simplificadas em um único processo. Você não precisa instalar dependências adicionais nem lidar com problemas de compatibilidade, o que facilita muito a transição de um modelo treinado para uma solução pronta para produção.
Formatos de exportação de modelos compatíveis com a Ultralytics Platform#
A Ultralytics Platform é compatível com 21 formatos de exportação, facilitando a preparação de modelos para uma ampla variedade de ambientes de implantação sem complexidade adicional.
Veja a seguir uma visão geral de alguns dos formatos de exportação mais usados:
- Multiplataforma e interoperabilidade: ONNX e TorchScript são amplamente usados para executar modelos em diferentes estruturas e ambientes. ONNX funciona como uma ponte entre ecossistemas, facilitando a transferência de modelos entre ferramentas, enquanto TorchScript permite executar modelos PyTorch em produção sem exigir um ambiente de execução Python.
- Inferência de alto desempenho em GPUs: TensorRT foi projetado para GPUs NVIDIA e se concentra em otimizar modelos para baixa latência e alta taxa de processamento. Ele oferece suporte a técnicas como redução de precisão e fusão de camadas para acelerar a inferência, sendo uma ótima opção para aplicações em tempo real e em escala de produção.
- Implantação em dispositivos móveis e de borda: CoreML, LiteRT (TensorFlow Lite) e NCNN são otimizados para dispositivos com capacidade computacional e memória limitadas. Esses formatos reduzem o tamanho dos modelos e aumentam a eficiência, permitindo um bom desempenho em smartphones, sistemas embarcados e hardware de borda. CoreML costuma ser usado nos ecossistemas Apple, enquanto LiteRT é comum no Android.
- Execução otimizada para hardware: OpenVINO é voltado para hardware Intel, incluindo CPUs, GPUs e VPUs, e ajuda a melhorar a velocidade e a eficiência da inferência nesses dispositivos. Formatos específicos para hardware como esse são úteis quando você precisa obter o melhor desempenho possível de um sistema específico.
- Ambientes de execução específicos de estruturas e especializados: Formatos como PaddlePaddle e ExecuTorch atendem a ecossistemas e necessidades de implantação específicos, incluindo a execução eficiente de modelos em dispositivos de borda ou a integração com determinadas pilhas de aprendizado profundo.
Como exportar um modelo usando a Ultralytics Platform#
Exportar um modelo na Ultralytics Platform é um processo simples, realizado pela interface do usuário. Todo o fluxo de trabalho é gerenciado pela interface, sem necessidade de scripts ou ferramentas de linha de comando.
Veja como exportar um modelo usando a plataforma:
- Faça login e escolha seu modelo: Acesse seu projeto e abra o modelo treinado que você quer exportar.
- Acesse a guia Exportar: No painel do modelo, clique na guia Exportar para ver as opções de exportação disponíveis.
- Selecione um formato de exportação: Escolha um formato como ONNX, TensorRT ou CoreML, de acordo com suas necessidades de implantação.
- Configure as definições de exportação (opcional): Ajuste parâmetros como o tamanho da imagem, a precisão ou o tamanho do lote para otimizar o desempenho.
- Inicie o processo de exportação: Clique em “Iniciar exportação” para começar. A plataforma realiza a conversão automaticamente.
- Baixe o modelo exportado: Quando a exportação terminar, você poderá baixar o modelo e usá-lo no seu pipeline de implantação.
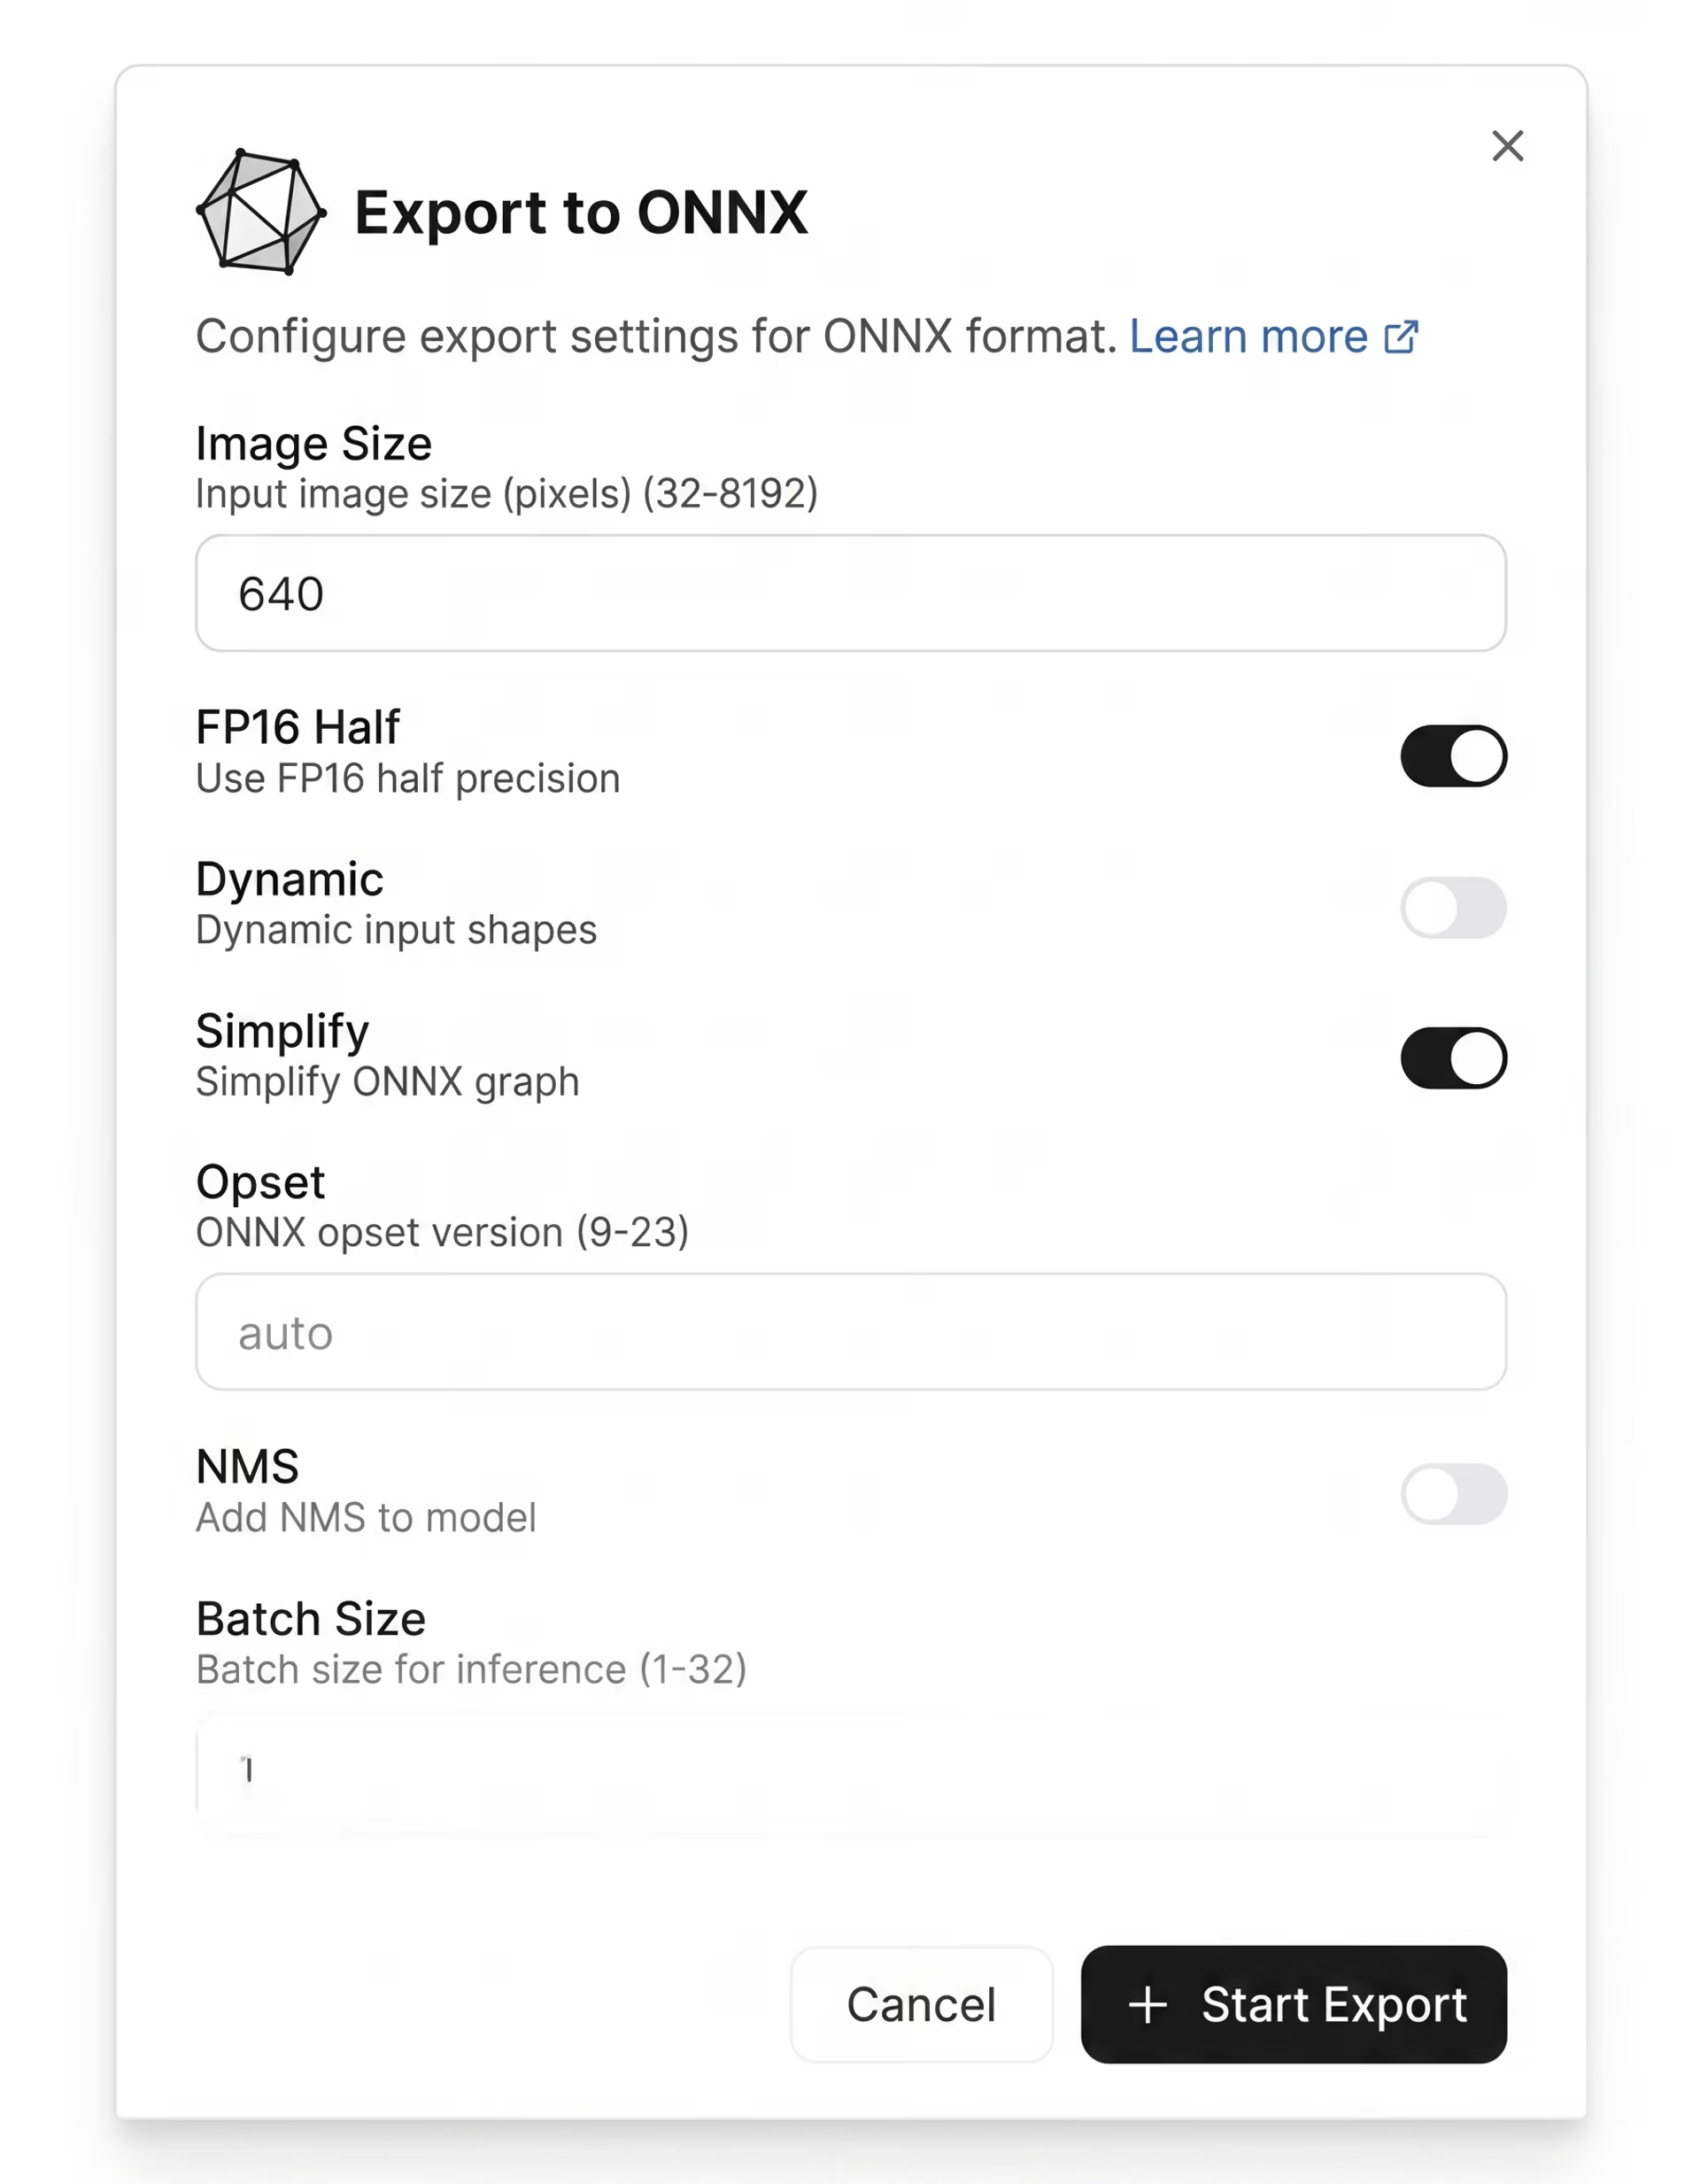
Fig. 4. Visão geral da configuração das definições de exportação na Ultralytics Platform
Como escolher o formato de exportação adequado#
Ao explorar os diferentes formatos de exportação compatíveis com a Ultralytics Platform, você pode se perguntar qual escolher. A resposta depende de onde e como você planeja usar seu modelo.
Veja alguns fatores a considerar:
- Requisitos de latência: Para aplicações em tempo real, como análise de vídeo ou sistemas autônomos, a baixa latência é fundamental. Formatos otimizados para inferência de alto desempenho, como TensorRT, costumam ser mais adequados.
- Limitações de hardware: Dispositivos com memória e capacidade de processamento limitadas, como celulares ou sistemas embarcados, precisam de formatos leves como LiteRT ou NCNN.
- Tamanho do modelo e consumo de energia: Ao trabalhar com dispositivos de borda, o tamanho do modelo e o consumo de energia se tornam importantes. Modelos menores e otimizados ajudam a garantir um desempenho consistente sem esgotar os recursos.
- Ambiente de implantação: Se o modelo precisar ser executado em diferentes plataformas, formatos como ONNX oferecem flexibilidade. Para casos de uso específicos de uma plataforma, como aplicativos para iOS, CoreML costuma ser a melhor opção.
Não existe um formato ideal para todas as situações. A escolha depende de equilibrar desempenho, compatibilidade e as limitações do ambiente de destino. A Ultralytics Platform facilita esse processo, permitindo testar e comparar diferentes formatos sem esforço adicional.
Principais conclusões#
A exportação é uma etapa fundamental para preparar seu modelo para uso no mundo real em diferentes ambientes. Com a Ultralytics Platform, esse processo fica muito mais simples, permitindo converter e otimizar modelos sem configuração adicional nem complexidade. Ao escolher o formato adequado para seu caso de uso, você pode garantir que seu modelo funcione com eficiência em qualquer ambiente de implantação.
Faça parte da nossa crescente comunidade e confira nosso repositório no GitHub para saber mais sobre visão computacional. Explore nossas páginas de soluções para conhecer aplicações como IA em robótica e visão computacional em logística. Conheça nossas opções de licenciamento e comece a desenvolver com IA para visão computacional!









