Endpoints de inferência dedicados vs. inferência compartilhada para implantação
Descubra quando escolher endpoints de inferência dedicados na Ultralytics Platform para implantar IA visual de forma escalável e com baixa latência, em vez de usar inferência compartilhada.
Recentemente, apresentámos a Ultralytics Platform, uma solução completa que reúne todo o fluxo de trabalho de visão computacional num só lugar, desde a preparação de conjuntos de dados e o treinamento de modelos até à inferência, implantação e monitoramento.
Desenvolvida com base no feedback da comunidade de visão computacional, a plataforma foi concebida para simplificar cada etapa do desenvolvimento, oferecendo recursos integrados que dão suporte a todo o ciclo de vida das aplicações de IA visual.
Por exemplo, depois de treinar um modelo, o passo seguinte é implantá-lo para que possa ser usado para executar inferências e fazer previsões em aplicações do mundo real. A plataforma simplifica esse processo ao oferecer várias opções de implantação.
Podes exportar modelos para executá-los no teu próprio ambiente, usar a inferência compartilhada para testes rápidos ou implantar endpoints dedicados para aplicações escaláveis e prontas para produção. Cada uma dessas opções de implantação permite executar inferências de IA, mas foi concebida para diferentes etapas e casos de uso.
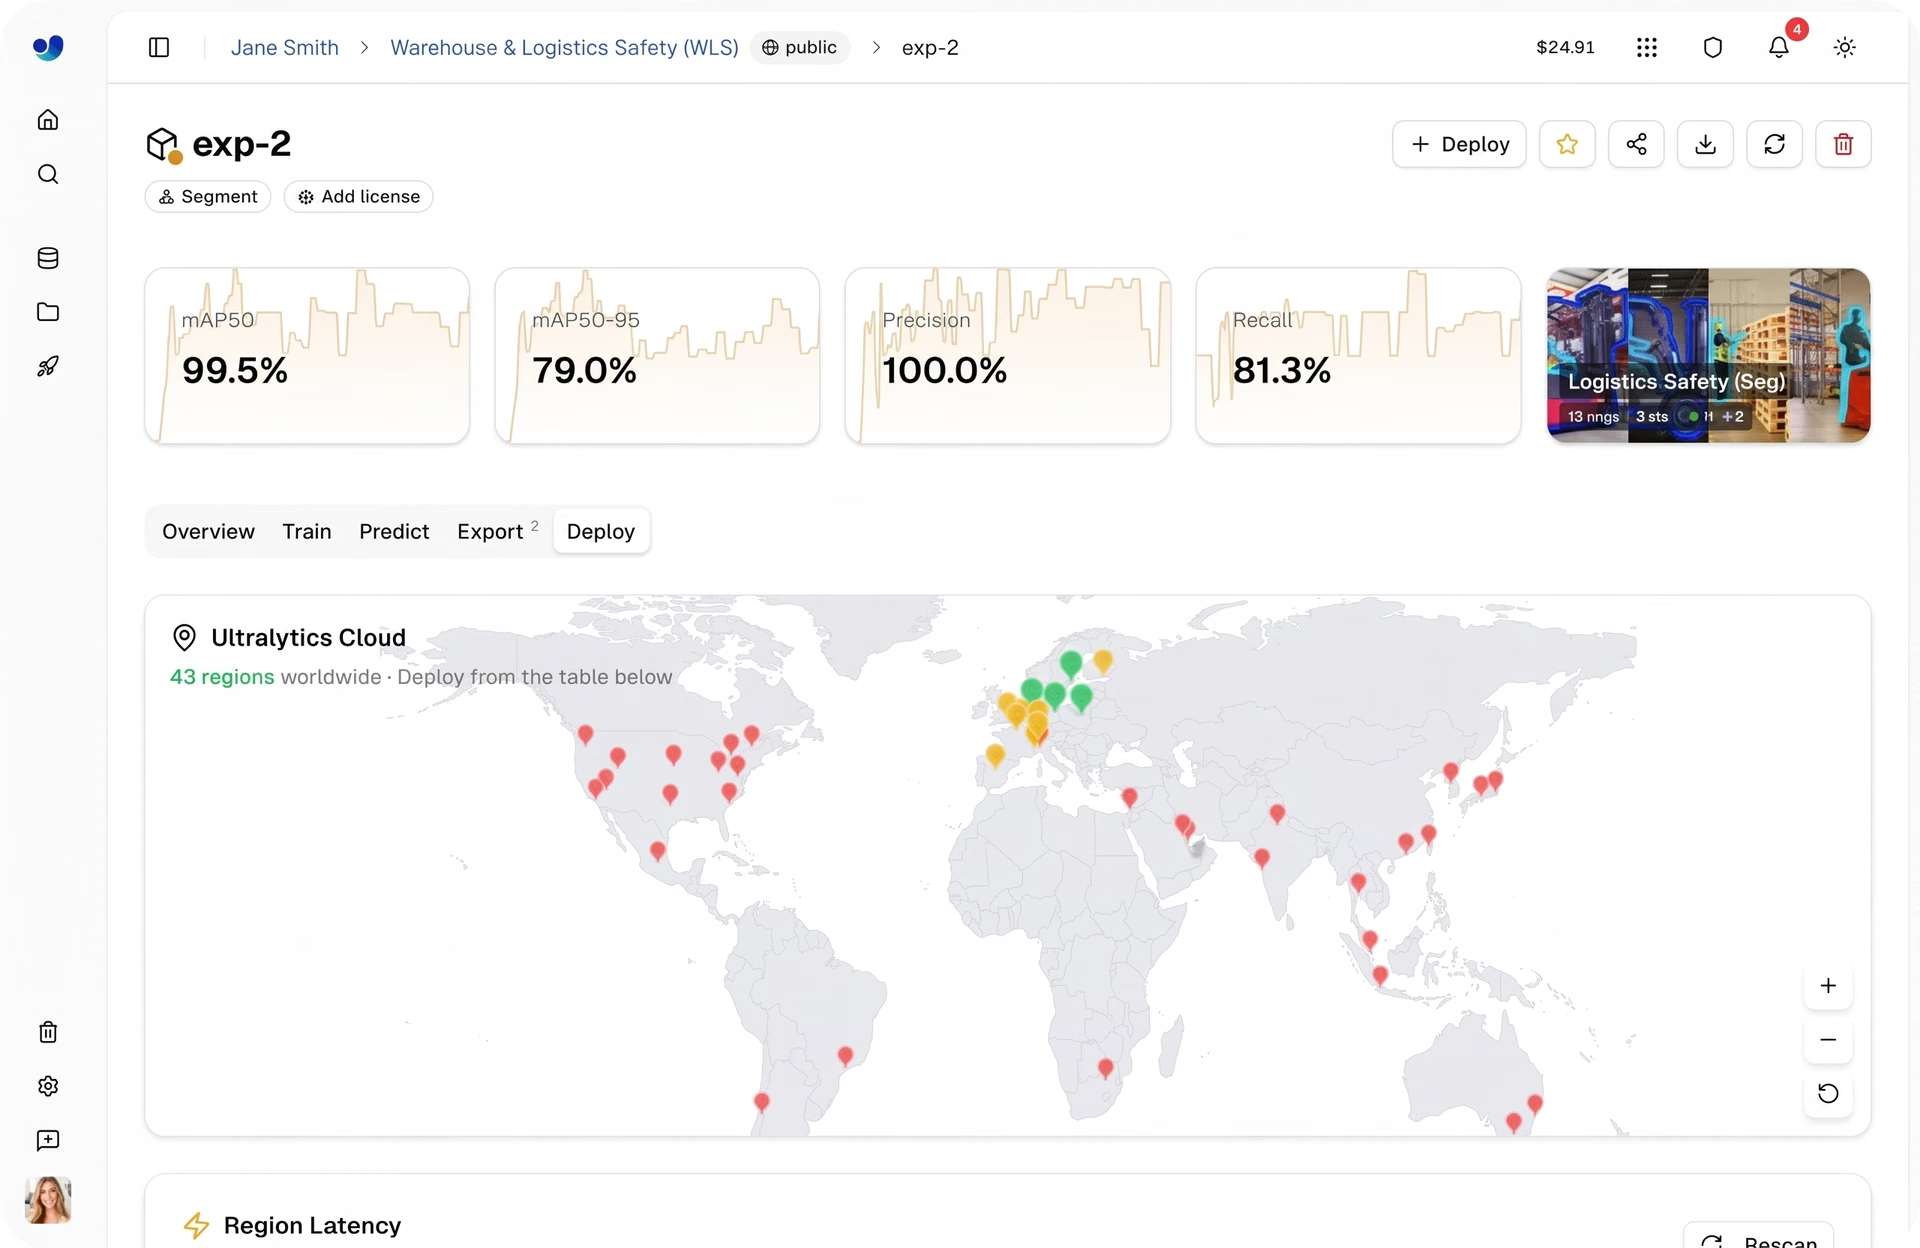
Fig. 1. A Ultralytics Platform possibilita a implantação global e escalável de modelos de IA visual (Fonte)
A exportação de modelos dá-te controle total para executá-los na tua própria infraestrutura; a inferência compartilhada facilita os testes e a experimentação sem configuração; e os endpoints dedicados foram desenvolvidos para cargas de trabalho de produção confiáveis e em grande escala.
À primeira vista, a inferência compartilhada e os endpoints dedicados podem parecer bastante semelhantes. Ambos permitem enviar solicitações de API ao teu modelo e receber previsões estruturadas, facilitando a integração da IA visual às aplicações.
No entanto, à medida que as cargas de trabalho crescem e as aplicações de visão computacional começam a processar solicitações de inferência em tempo real, as diferenças entre essas opções tornam-se mais importantes. Neste artigo, vamos analisar mais de perto a inferência compartilhada e os endpoints dedicados, comparar as duas opções, explicar quando usar cada uma e mostrar por que os endpoints dedicados se tornam a melhor escolha à medida que as aplicações crescem.
Visão geral da implantação com inferência compartilhada#
A inferência compartilhada é uma forma simples de executar inferências de IA nos teus modelos sem configurar infraestrutura nem te preocupares com tipos de GPU, integração de frameworks ou configuração do ambiente de execução. Depois que o modelo estiver treinado ou ajustado, podes usá-lo para fazer previsões diretamente pela plataforma.
Nessa configuração, o teu modelo é executado em recursos computacionais compartilhados por vários locatários em algumas regiões principais, como os EUA, a Europa e a Ásia-Pacífico. As solicitações são encaminhadas automaticamente para os serviços disponíveis, por isso não precisas configurar instâncias de GPU nem ambientes de execução. A plataforma trata de tudo, facilitando o início.
Ao usar a inferência compartilhada, envias solicitações ao teu modelo por meio de uma REST API, usando ferramentas como Python ou CLI, e recebes saídas JSON estruturadas, como objetos detectados, pontuações de confiança e outros detalhes das previsões. Isso facilita testar modelos e integrá-los às aplicações.
Como o sistema é compartilhado, ele foi concebido para desenvolvimento, testes e uso leve. É adequado para validar previsões e criar as primeiras integrações. Ao mesmo tempo, o desempenho pode variar conforme a carga do sistema, e o uso é limitado a 20 solicitações por minuto por chave de API, o que torna essa opção menos adequada para cargas de trabalho de produção com alto volume de solicitações.
Em geral, a inferência compartilhada é mais adequada para o desenvolvimento em estágio inicial, quando o foco é entender e aprimorar o modelo antes de passar para aplicações em maior escala.
Implanta modelos globalmente com endpoints dedicados#
Os endpoints dedicados são serviços de inferência de locatário único, nos quais os teus modelos de IA visual são executados em recursos computacionais isolados. Em vez de compartilhar a infraestrutura, cada endpoint tem o seu próprio ambiente de execução, com recursos configuráveis, como CPU e memória, dando-te mais controle sobre o desempenho.
Ao implantar um modelo como endpoint dedicado, é atribuído a ele um URL de API exclusivo e a tua chave de API é usada para autenticação, o que facilita a integração às aplicações. Esses endpoints podem ser implantados em 43 regiões globais, permitindo executar inferências mais perto dos teus utilizadores e reduzir a latência.
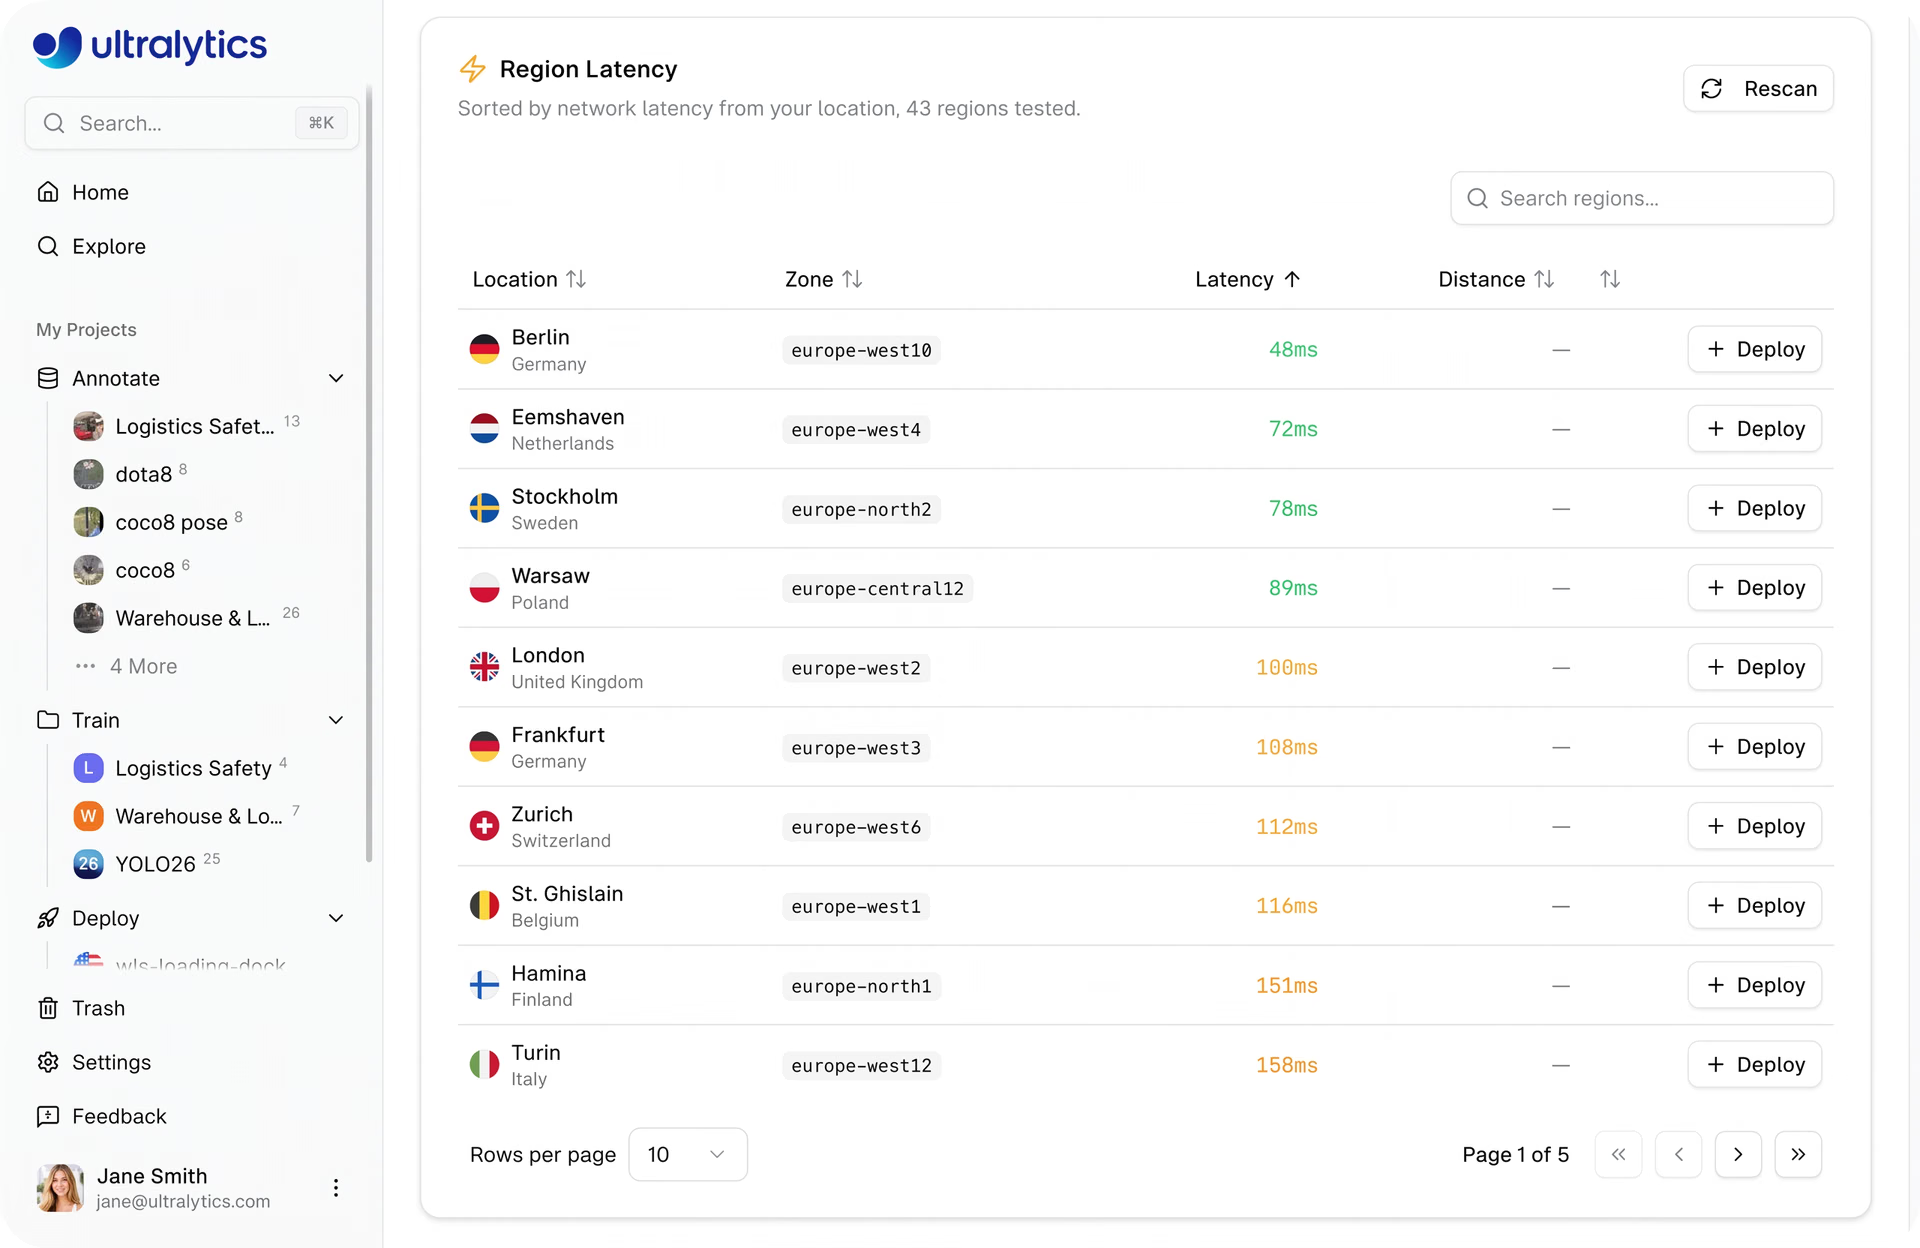
Fig. 2. Podes implantar endpoints dedicados em 43 regiões globais (Fonte)
Uma das principais vantagens é o escalonamento automático. Os endpoints ajustam-se automaticamente às solicitações recebidas, aumentando a escala para lidar com mais tráfego e reduzindo-a quando a procura diminui. Com a redução automática a zero ativada por padrão, os endpoints podem ser desligados quando ficam inativos e reiniciados quando necessário, ajudando a otimizar o uso dos recursos.
Em outras palavras, os endpoints dedicados foram concebidos para cargas de trabalho de produção. Em comparação com a inferência compartilhada, oferecem latência baixa e consistente, maior capacidade de processamento e mais confiabilidade.
Além disso, os endpoints dedicados não têm limites de taxa. As solicitações vão diretamente para o teu endpoint, por isso o volume de tráfego que podes processar depende da tua configuração e do escalonamento, e não de limites fixos.
Além disso, o monitoramento integrado, os registros, as verificações de integridade e o comportamento previsível do ambiente de execução e da inicialização facilitam o acompanhamento do desempenho e a manutenção de implantações estáveis em todos os planos. No plano gratuito, as inicializações a frio normalmente levam entre 5 e 45 segundos, enquanto os endpoints do plano Pro permanecem ativos, proporcionando um desempenho de inferência mais rápido e previsível.
Em resumo, os endpoints dedicados são ideais para aplicações de IA visual em tempo real que exigem inferência confiável, escalável e de alto desempenho.
Inferência compartilhada vs. endpoints dedicados: principais diferenças#
Veja mais de perto como a inferência compartilhada e os endpoints dedicados se comparam:
- Latência: a latência pode variar em ambientes compartilhados devido ao compartilhamento de recursos, enquanto os endpoints dedicados oferecem respostas mais consistentes e com baixa latência.
- Regiões: a inferência compartilhada está disponível em algumas regiões (EUA, UE, AP), enquanto os endpoints dedicados permitem a implantação em 43 regiões globais.
- Escalabilidade: o escalonamento da inferência compartilhada não é configurável, enquanto os endpoints dedicados se ajustam automaticamente ao tráfego recebido.
- Limites de taxa: a inferência compartilhada tem um limite de taxa (20 solicitações ou chamadas de API por minuto por chave de API), enquanto os endpoints dedicados não têm limites de taxa definidos pela plataforma.
- Preços: a inferência compartilhada está incluída sem custo adicional para testes e desenvolvimento, enquanto os endpoints dedicados oferecem mais controle e escalabilidade, com custos que dependem da configuração dos recursos e das necessidades de implantação.
Por que os endpoints dedicados são melhores para cargas de trabalho de produção#
À medida que as aplicações de IA e aprendizado de máquina passam dos testes para o uso no mundo real, o desempenho, a escalabilidade e a confiabilidade tornam-se essenciais. Por isso, os endpoints dedicados oferecem vantagens claras em relação à inferência compartilhada.
Com endpoints dedicados, o teu modelo pré-treinado ou personalizado é executado nos próprios recursos computacionais, por isso o desempenho não é afetado por outros utilizadores. Isso ajuda a manter a latência baixa e consistente, o que é importante para aplicações em tempo real, como análise de vídeo e sistemas de monitoramento.
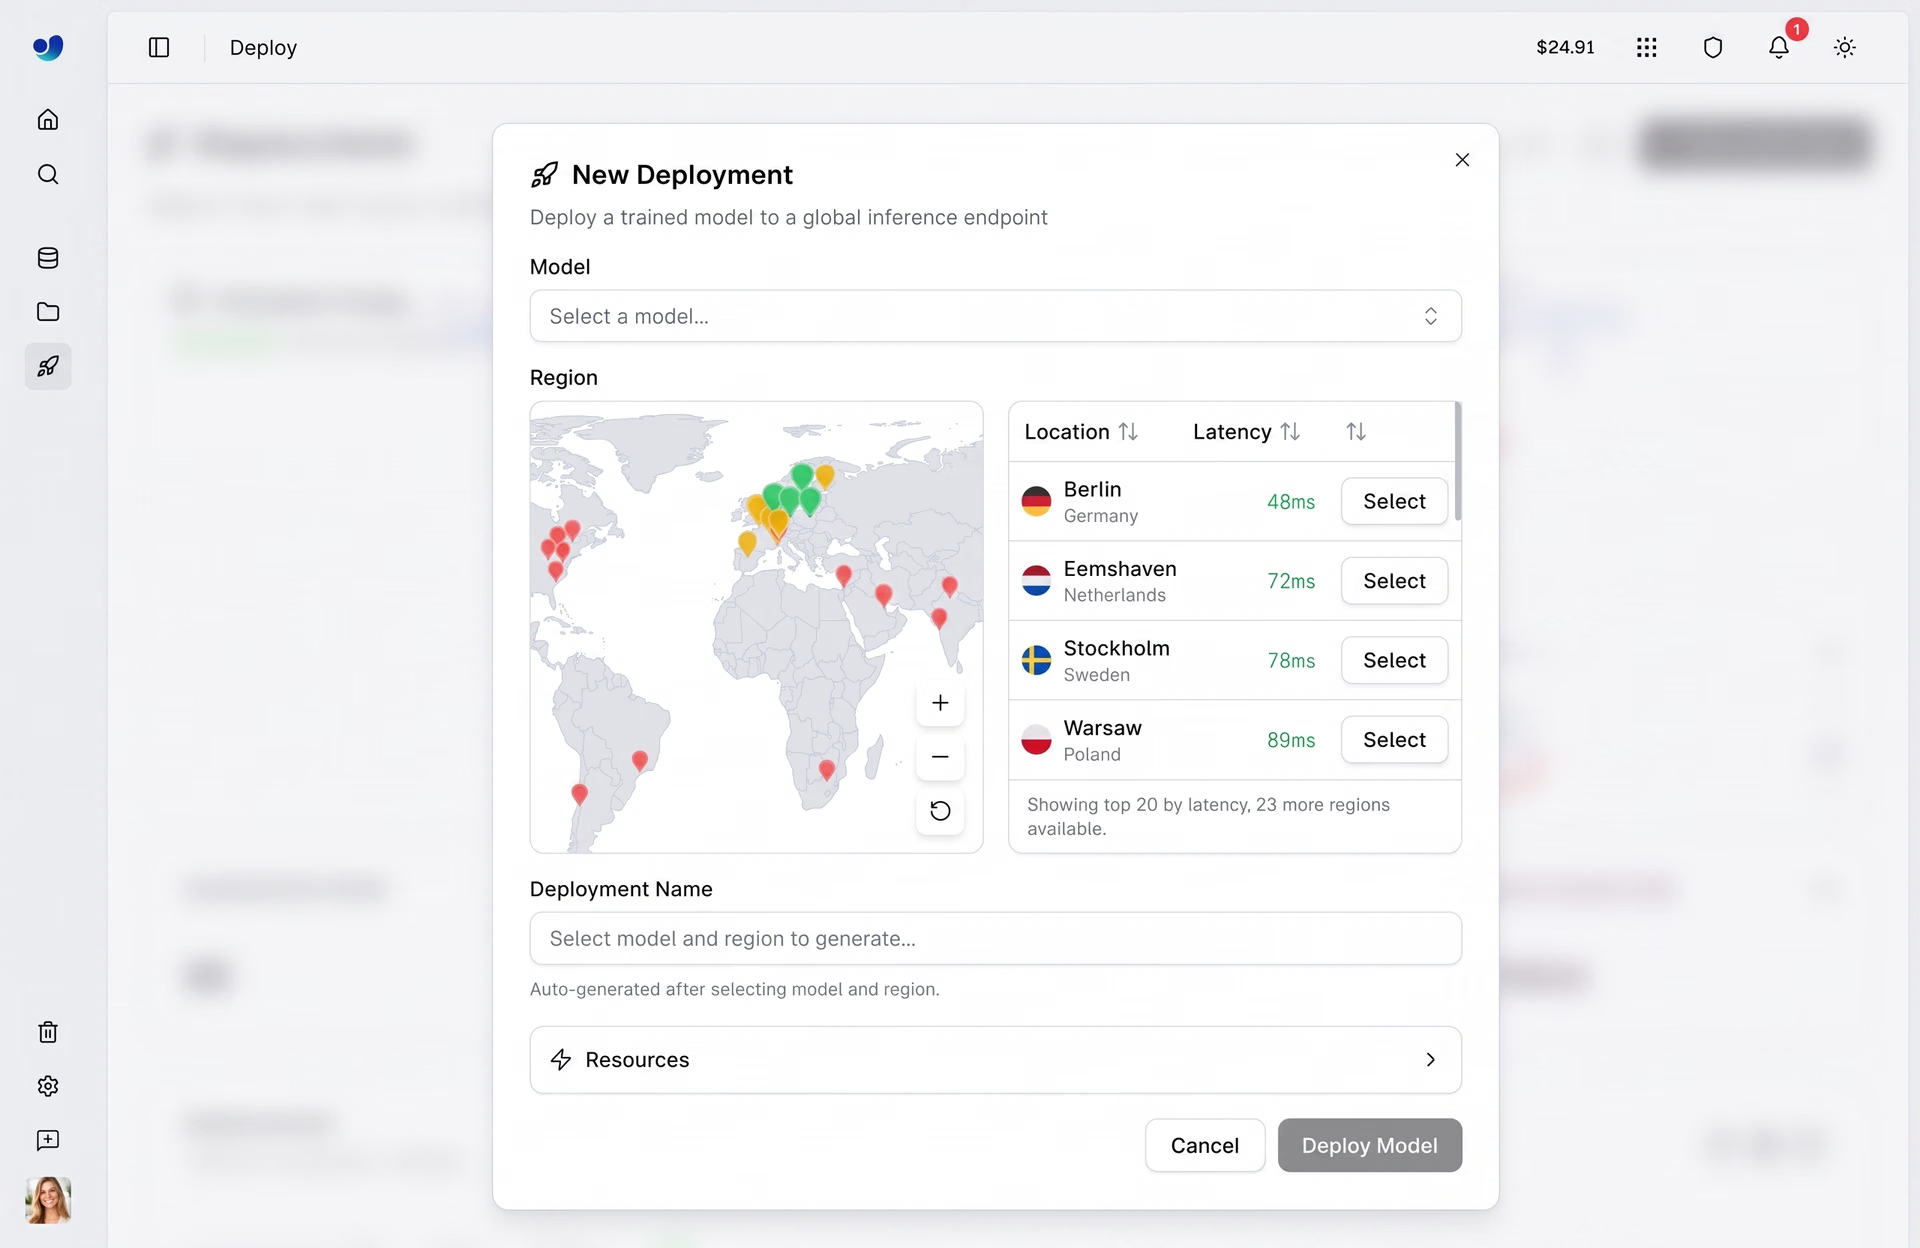
Fig. 3. Visão geral da implantação com um endpoint de inferência dedicado (Fonte)
Por exemplo, pensa num sistema de análise de varejo que processa transmissões de câmaras ao vivo em várias lojas. Ao implantar endpoints em 43 regiões globais, as inferências podem ser executadas mais perto de cada loja, reduzindo a latência e melhorando os tempos de resposta.
Com a inferência compartilhada, em que os recursos são compartilhados e as regiões são limitadas, o desempenho pode variar nos períodos de maior movimento.
Os endpoints dedicados também podem lidar com mais tráfego e ajustar-se automaticamente à procura. Com monitoramento, registros e verificações de integridade integrados, oferecem um desempenho mais previsível, sendo uma boa opção para cargas de trabalho de IA contínuas e em grande escala.
Onde a inferência compartilhada se encaixa no fluxo de trabalho de IA visual#
Ao explorar as diferenças entre a inferência compartilhada e os endpoints dedicados, talvez te perguntes onde a inferência compartilhada se encaixa no fluxo de trabalho geral de visão computacional.
Vamos voltar ao exemplo de análise de varejo. Antes de implantar uma solução de visão computacional em várias lojas, as equipas geralmente precisam testar o desempenho da solução com dados reais e aprimorá-la com base nos resultados.
A inferência compartilhada simplifica esse processo, permitindo enviar imagens de amostra ou quadros de vídeo das câmaras das lojas e analisar rapidamente as previsões sem configurar infraestrutura. Isso é especialmente útil para testar o comportamento do modelo, depurar previsões incorretas e validar os resultados em diferentes condições, como mudanças na iluminação ou no layout das lojas.
Com esse processo iterativo, as equipas podem melhorar a precisão e a confiabilidade do modelo antes de colocá-lo em produção. Quando o modelo tiver um bom desempenho nesses cenários de teste, poderá ser implantado em endpoints dedicados para uso em tempo real em vários locais.
A inferência compartilhada também pode ser adequada para aplicações com uso baixo ou esporádico. Por exemplo, uma pequena loja de varejo pode usá-la para analisar ocasionalmente o fluxo de pessoas ou observar a atividade dos clientes em horários específicos, sem precisar de uma implantação totalmente escalada. Nesses casos, ela oferece uma forma simples e econômica de executar inferências sob demanda.
Casos de uso reais de endpoints dedicados#
À medida que as aplicações de IA avançam para além dos testes, a escolha da implantação começa a afetar diretamente o desempenho, a escalabilidade e a experiência do utilizador. Os endpoints dedicados podem ser amplamente usados em vários setores porque oferecem desempenho estável, baixa latência e capacidade para lidar com cargas de trabalho em grande escala.
Estes são alguns casos de uso comuns que mostram como os endpoints dedicados podem ser usados em aplicações do mundo real:
- Varejo e análise de vídeo: uma rede de lojas pode usar visão computacional para acompanhar a movimentação dos clientes, identificar produtos populares e monitorar a atividade das lojas em tempo real. Os endpoints dedicados mantêm a inferência rápida e consistente em várias lojas, mesmo nos horários de pico.
- Manufatura e inspeção de qualidade: numa linha de produção, os modelos podem detectar defeitos ou anomalias à medida que os produtos avançam pelo sistema. Os endpoints dedicados permitem inferências contínuas em tempo real, ajudando as equipas a identificar problemas desde o início e manter a qualidade dos produtos sem desacelerar as operações.
- Saúde e diagnóstico por imagem: os prestadores de serviços de saúde e os laboratórios de diagnóstico podem usar modelos de visão computacional para analisar imagens médicas, como radiografias ou exames de imagem. Os endpoints dedicados oferecem desempenho confiável e consistente, essencial ao lidar com dados sensíveis e diagnósticos urgentes.
- Automação de armazéns e logística: armazéns de grande porte costumam operar vários sistemas idênticos, como esteiras transportadoras e linhas de triagem, que funcionam, na prática, como réplicas da mesma configuração. Os modelos de visão computacional podem monitorar cada réplica para detectar problemas, como bloqueios ou pacotes encaminhados incorretamente. Os endpoints dedicados garantem inferências consistentes em tempo real em todas as réplicas.
Transição da inferência compartilhada para endpoints dedicados#
Uma das principais vantagens da Ultralytics Platform é a facilidade de passar da inferência compartilhada para endpoints dedicados à medida que a tua aplicação cresce. Em vez de trocar de ferramentas ou reconstruir a configuração, podes passar para uma implantação pronta para produção no mesmo ambiente.
Depois de testar o modelo com inferência compartilhada, passar para um endpoint dedicado é o passo seguinte mais simples. Podes implantar o mesmo modelo num endpoint, escolher a região e os recursos computacionais que preferes e atualizar o URL do endpoint na tua aplicação. A integração geral continua semelhante, por isso quase não há mudanças na forma como envias solicitações ou processas respostas.
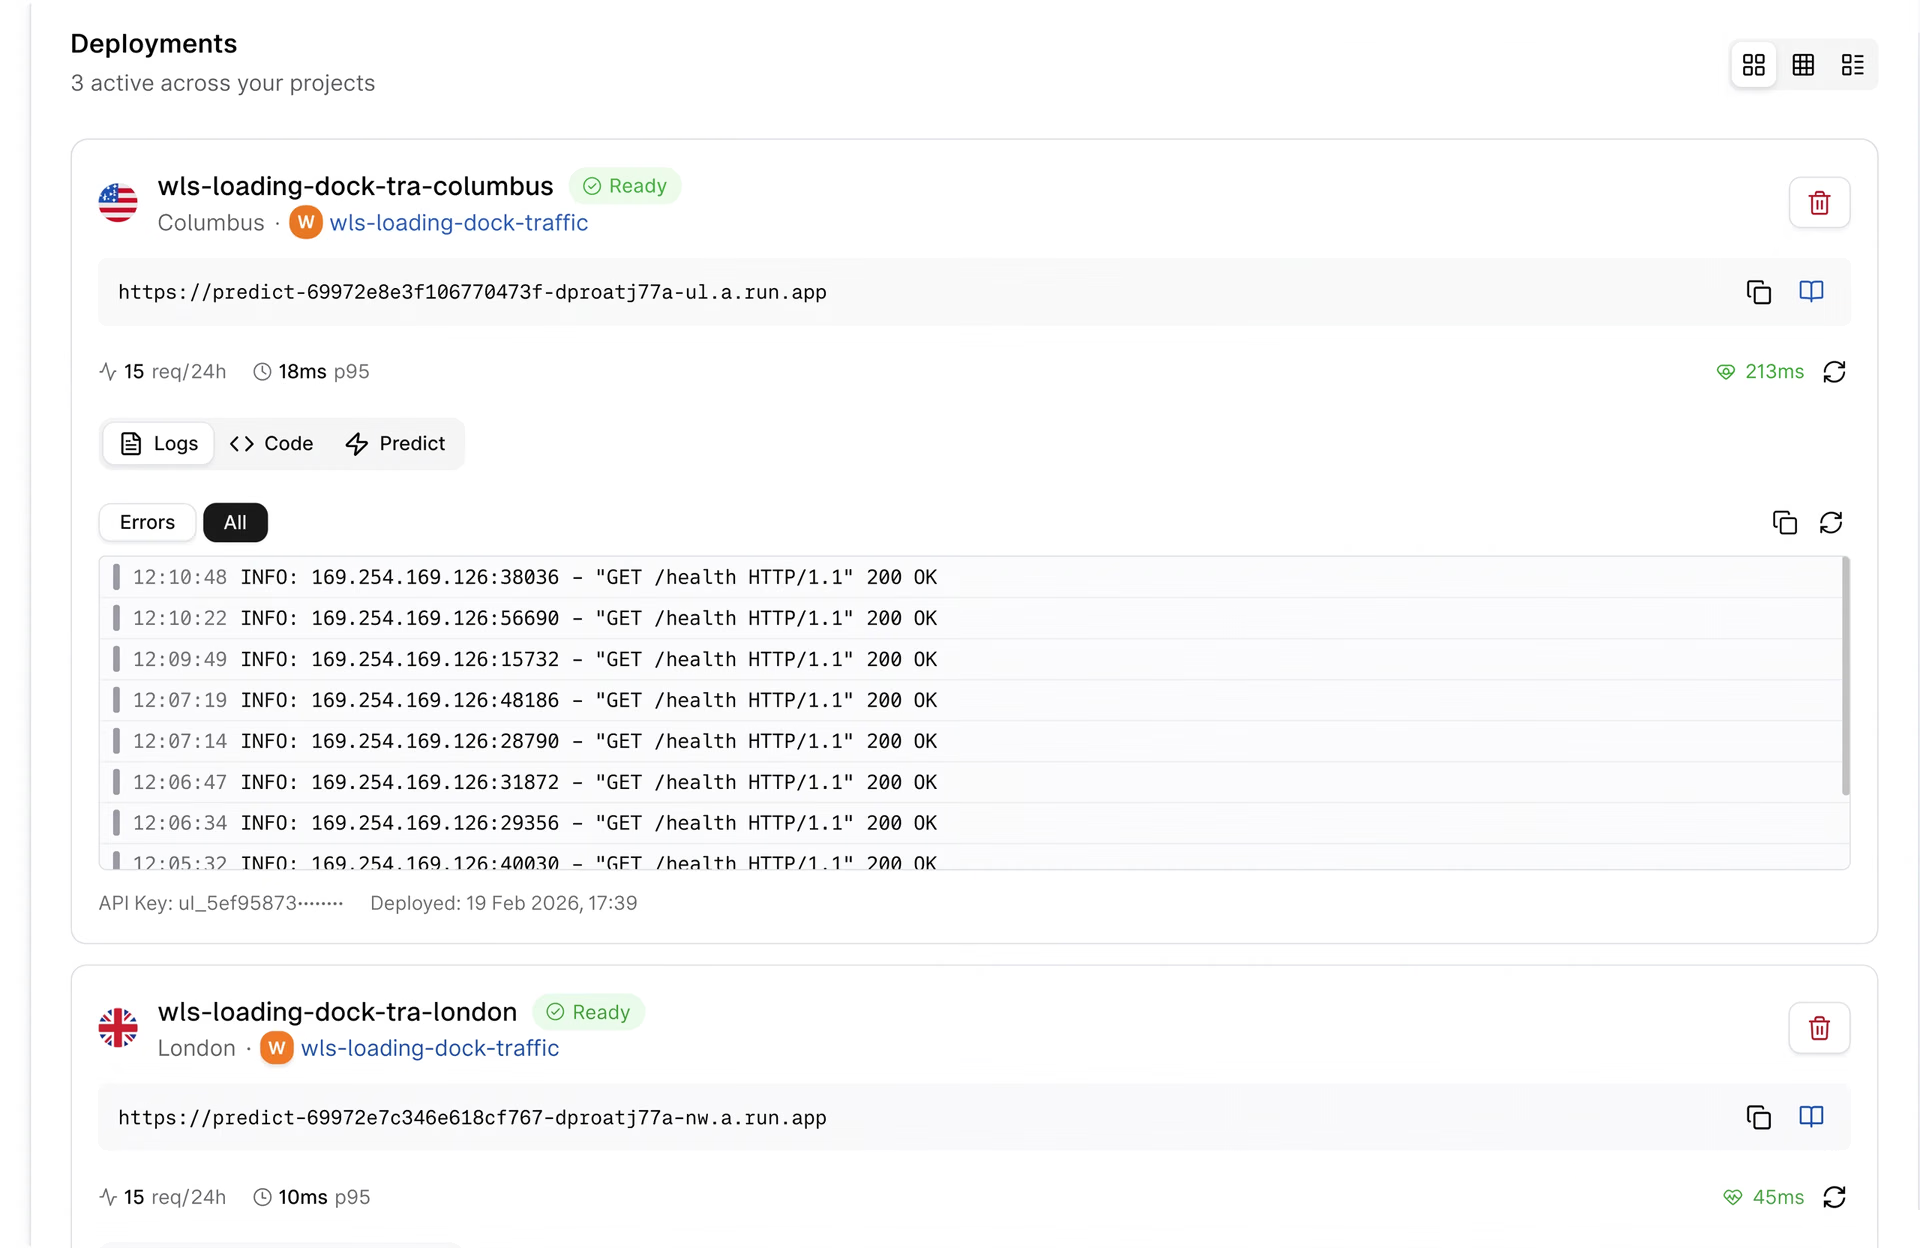
Fig. 4. Visualização do URL de um endpoint dedicado na Ultralytics Platform (Fonte)
Isso significa que podes passar dos testes à produção com apenas alguns cliques. À medida que a tua carga de trabalho aumenta ou a tua aplicação exige um desempenho mais consistente, podes passar para endpoints dedicados sem interromper o fluxo de trabalho existente.
Para saber mais sobre a implantação de modelos com endpoints dedicados na Ultralytics Platform, consulta a documentação oficial da Ultralytics Platform.
Principais conclusões#
A inferência compartilhada é um excelente ponto de partida para testes e experimentação, mas as cargas de trabalho de produção exigem mais consistência e escala. À medida que as aplicações crescem, os endpoints dedicados oferecem o desempenho e a confiabilidade necessários para atender às necessidades do uso no mundo real. Isso faz deles a melhor opção para a maioria das implantações de produção.
Junta-te à nossa comunidade e explora o nosso repositório do GitHub para saber mais sobre modelos de visão computacional. Lê sobre aplicações como IA na agricultura e visão computacional na robótica nas páginas das nossas soluções. Consulta as nossas opções de licenciamento e começa a trabalhar com IA visual.









