Treine modelos YOLO mais rapidamente com a Ultralytics Platform
Saiba como treinar modelos YOLO mais rapidamente com a Ultralytics Platform, um ambiente completo criado para acelerar o caminho dos dados à implantação.
 Abirami Vina17 min de leitura
Na semana passada, a Ultralytics apresentou o Ultralytics Platform, um espaço de trabalho unificado criado para simplificar a maneira como as equipes desenvolvem, treinam e implantam modelos de visão computacional. Em vez de alternar entre várias ferramentas, a plataforma reúne tudo em um só lugar, facilitando o caminho da ideia à implantação de modelos de IA aplicada à visão.
Isso é crucial porque a visão computacional está se tornando rapidamente uma parte essencial de vários setores. Ela viabiliza aplicações como inspeção na manufatura, análise de varejo e navegação autônoma.
Transformar essas aplicações baseadas em visão em sistemas confiáveis depende da qualidade do treinamento dos modelos. O treinamento de modelos consiste em aprender com dados rotulados para que o modelo reconheça padrões e faça previsões precisas. Em geral, modelos bem treinados têm melhor desempenho e geram resultados mais confiáveis em aplicações reais.
No entanto, treinar um modelo de visão computacional nem sempre é simples. O processo envolve vários aspectos, como configurar ambientes, selecionar recursos computacionais adequados, ajustar hiperparâmetros e acompanhar vários experimentos de treinamento. Quando essas etapas são distribuídas por diferentes ferramentas e sistemas, o fluxo de trabalho de treinamento rapidamente se torna complexo e difícil de gerenciar.
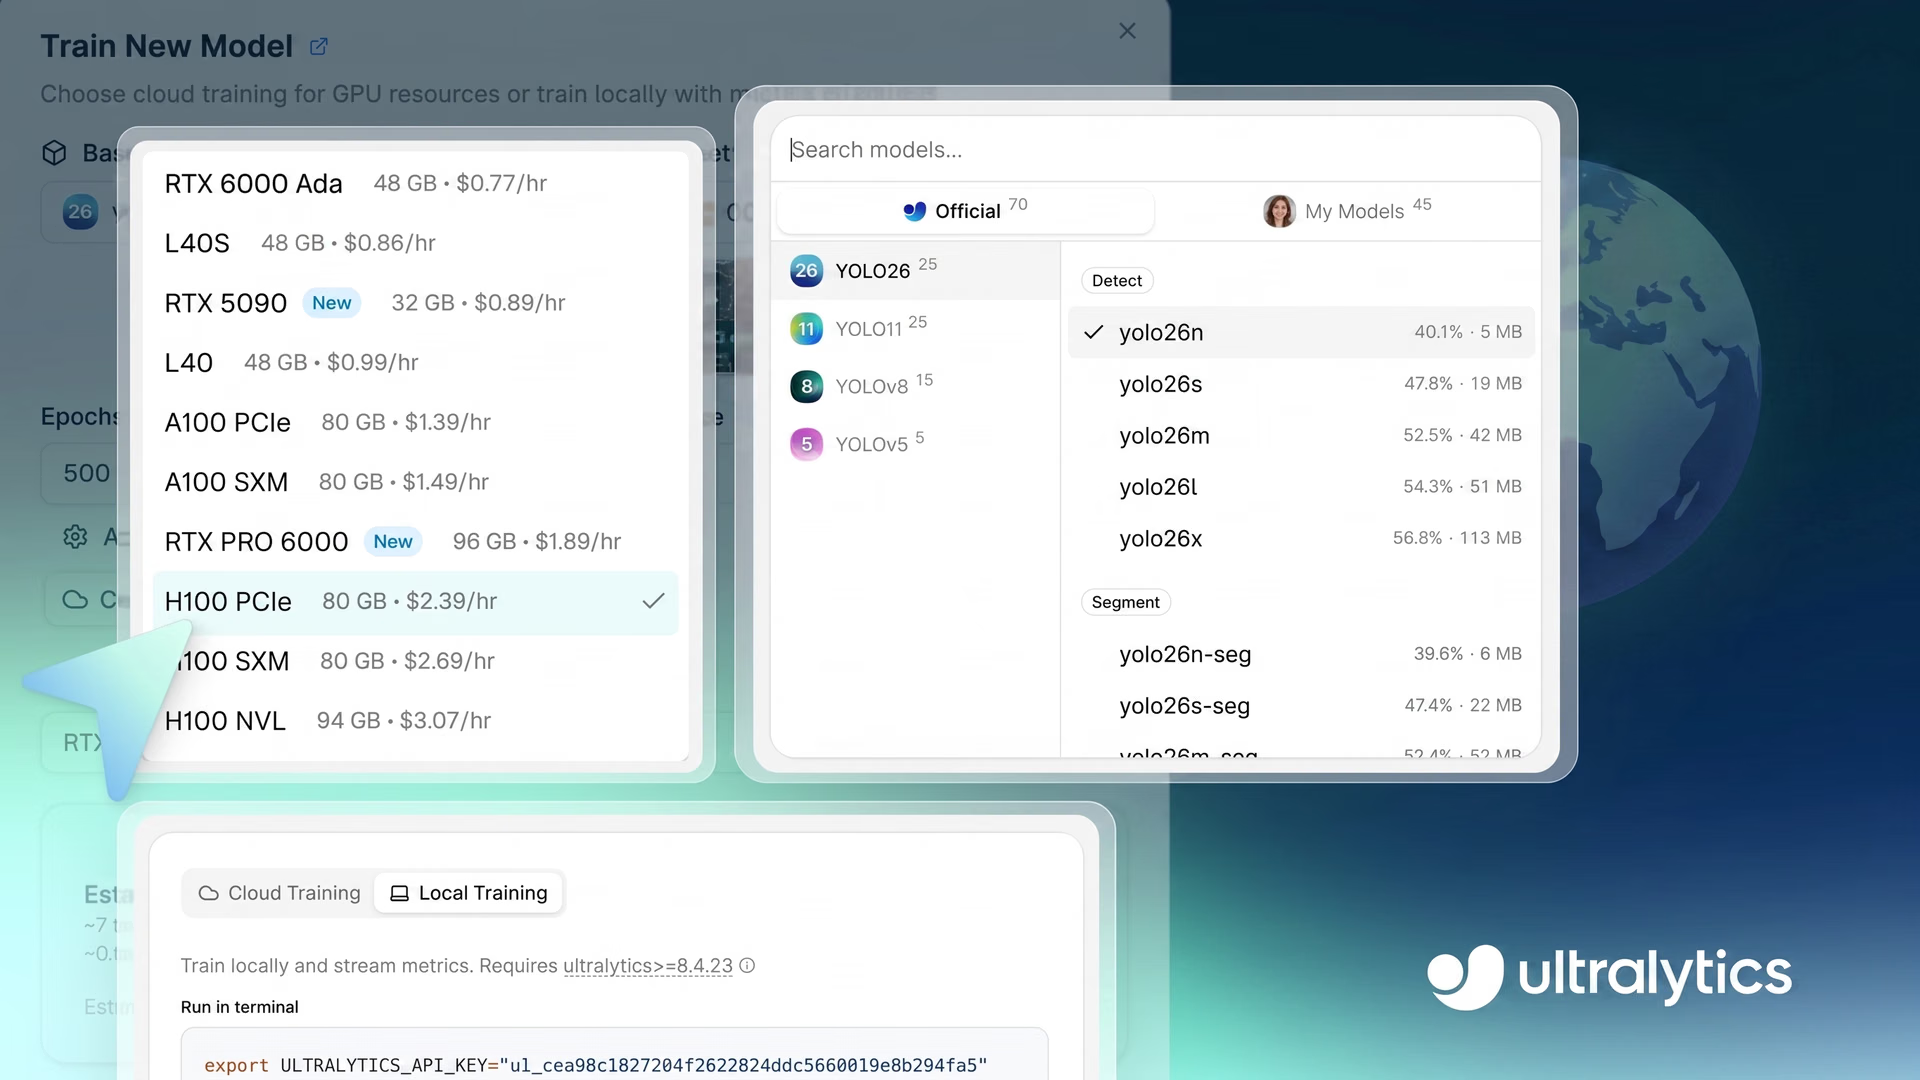
A Ultralytics Platform resolve esse problema reunindo todo o processo de treinamento em um único painel unificado. Você pode configurar, executar e monitorar tarefas de treinamento em um só lugar, seja na nuvem, localmente ou no Google Colab.
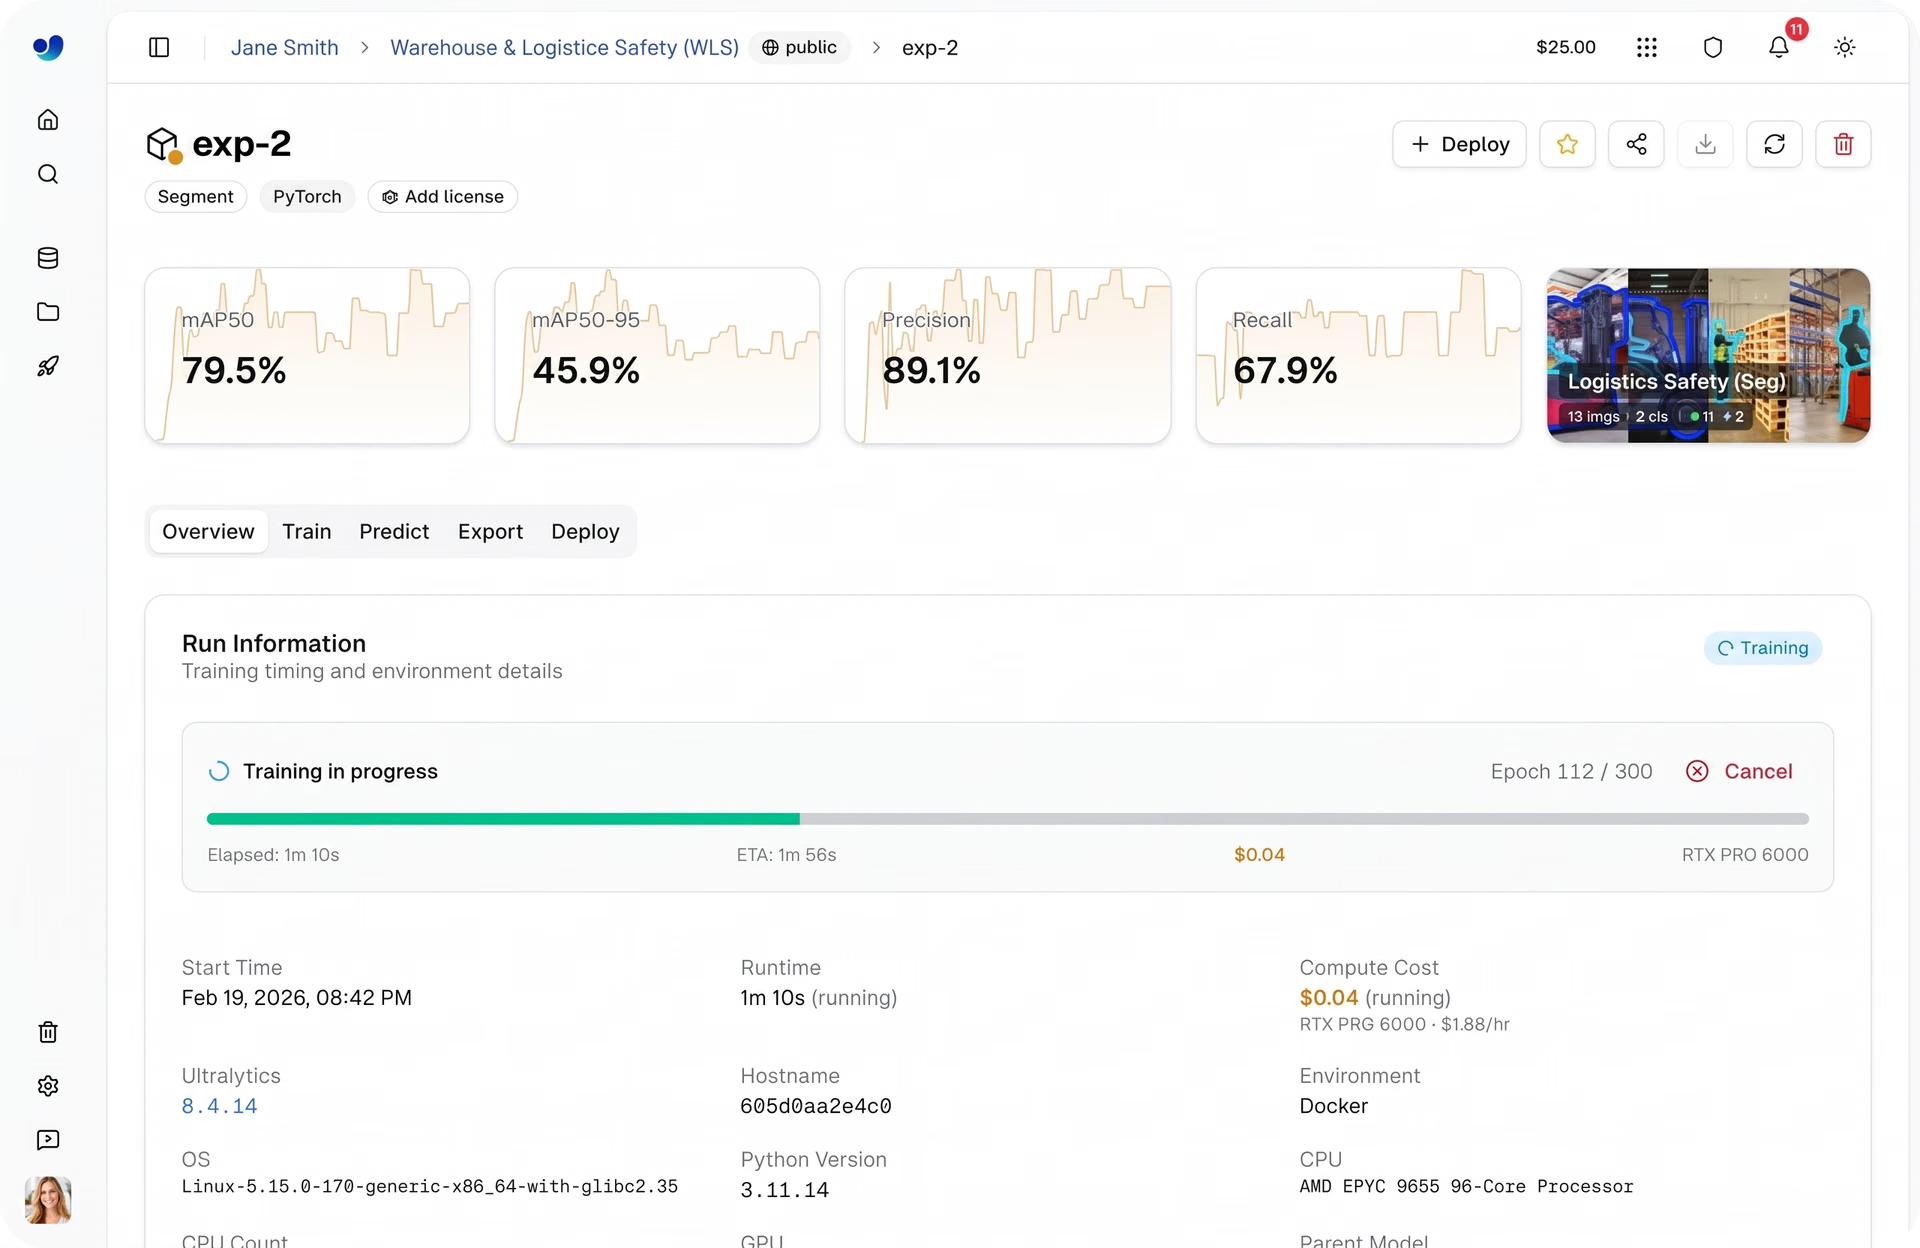
Fig. 1. Uma prévia do treinamento de modelos na Ultralytics Platform (Fonte)
Neste artigo, vamos explorar como o Ultralytics Platform simplifica o treinamento de modelos e por que ele pode dar uma vantagem aos seus projetos de IA aplicada à visão.
Modelos de visão computacional aprendem com dados por meio do treinamento#
Antes de explorar como funciona o treinamento de modelos na Ultralytics Platform, vamos dar um passo atrás e entender o que é o treinamento de modelos e o que ele envolve.
O treinamento de modelos é o processo pelo qual um modelo de visão computacional aprende a interpretar dados visuais. Ele analisa imagens ou vídeos e ajusta gradualmente seus parâmetros internos para realizar com precisão tarefas de visão, como detecção de objetos, segmentação de instâncias e classificação de imagens. Com o tempo, o modelo melhora ao aprender padrões diretamente dos dados que recebe.
A qualidade do treinamento depende muito dos conjuntos de dados. Você pode pensar em um conjunto de dados como um conjunto de cartões de estudo que um professor usaria para ensinar um aluno, em que cada exemplo ajuda o modelo a aprender o que deve procurar.
Um conjunto de dados típico de visão computacional inclui imagens, geralmente em formatos como JPG ou PNG, e anotações que descrevem o conteúdo de cada imagem. Essas anotações, muitas vezes armazenadas como arquivos JSON ou TXT, fornecem os rótulos e o contexto de que o modelo precisa para aprender com eficiência.
Mas o treinamento não consiste apenas em fornecer dados a um modelo. Ele envolve várias etapas importantes, desde preparar o conjunto de dados até selecionar o modelo certo e configurar o processo de treinamento. A seguir, vamos analisar algumas dessas etapas mais de perto.
Como os conjuntos de dados são preparados#
Pode parecer que, assim que você tem um conjunto de dados, já pode começar a treinar um modelo, mas antes é preciso seguir algumas etapas, como dividir o conjunto de dados.
Em geral, um conjunto de dados é dividido em três partes: conjunto de treinamento, conjunto de validação e conjunto de teste. As imagens de treinamento são usadas para ensinar padrões dos dados ao modelo, enquanto o conjunto de validação ajuda a monitorar e ajustar o desempenho durante o treinamento.
O conjunto de teste é usado ao final para avaliar o desempenho do modelo em dados completamente novos, que ele ainda não viu. Essa configuração ajuda a garantir que o modelo não apenas memorize os dados, mas também consiga generalizar para situações reais.
Como selecionar o modelo certo para o treinamento#
Outra etapa importante antes do treinamento é escolher o modelo que você quer usar. Em muitos casos, isso significa selecionar um modelo pré-treinado. Modelos como os modelos Ultralytics YOLO já foram treinados com grandes conjuntos de dados e aprenderam padrões visuais gerais, o que os torna um ótimo ponto de partida.
Usar esses modelos é um exemplo de aprendizado por transferência, em que você aproveita conhecimentos existentes e adapta o modelo à sua tarefa específica. Essa abordagem ajuda a acelerar o treinamento e melhorar os resultados, especialmente quando há poucos dados disponíveis.
Esses modelos também estão disponíveis em diferentes tamanhos, cada um oferecendo um equilíbrio entre velocidade e precisão. Modelos menores são mais rápidos e eficientes, enquanto os maiores tendem a oferecer maior precisão, mas exigem mais recursos computacionais.
Como configurar os parâmetros de treinamento para modelos de visão#
Depois de preparar o conjunto de dados e selecionar um modelo, a próxima etapa é configurar como o modelo vai aprender.
Um modelo de visão computacional é treinado com um conjunto de parâmetros que determinam como ele processa os dados, atualiza seus pesos e melhora ao longo do tempo. Essas configurações afetam diretamente a velocidade do treinamento e a precisão final, sendo essenciais para alcançar bons resultados.
Veja alguns dos parâmetros de treinamento mais usados:
- Épocas: Representam quantas vezes o modelo percorre todo o conjunto de dados durante o treinamento. Aumentar o número de épocas dá ao modelo mais oportunidades de aprender padrões a partir dos dados.
- Tamanho do lote: É o número de imagens processadas em conjunto em uma única etapa de treinamento. Lotes maiores podem acelerar o treinamento, mas exigem mais memória.
- Tamanho da imagem: Especifica a resolução das imagens de entrada usadas durante o treinamento. Resoluções maiores podem melhorar a precisão da detecção, mas aumentam o custo computacional.
- Taxa de aprendizado: É a taxa na qual o modelo atualiza seus parâmetros internos durante o treinamento. Valores muito altos ou muito baixos podem tornar o treinamento instável.
- Otimizador: É o algoritmo responsável por atualizar os parâmetros do modelo com base no erro calculado em cada iteração do treinamento.
Nos fluxos de trabalho baseados em Ultralytics YOLO, essas configurações são passadas como argumentos de treinamento, enquanto o conjunto de dados é descrito em um arquivo YAML. Esse arquivo especifica os caminhos dos conjuntos de dados, os nomes das classes e a divisão dos dados. Ele funciona como uma configuração central que informa ao modelo como interpretar o conjunto de dados.
De fluxos de trabalho fragmentados a uma experiência unificada com a Ultralytics Platform#
Acabamos de abordar algumas das principais etapas do treinamento de um modelo de visão computacional, desde preparar conjuntos de dados até selecionar um modelo e configurar os parâmetros de treinamento. Na prática, o processo costuma ir além, incluindo o acompanhamento de experimentos, a comparação de várias execuções de treinamento e o refinamento contínuo dos modelos ao longo do tempo.
Essas etapas raramente são realizadas em um só lugar. Os conjuntos de dados podem ser preparados em uma ferramenta, as execuções de treinamento realizadas em outro ambiente e o acompanhamento de experimentos gerenciado separadamente. À medida que os projetos crescem, essa fragmentação aumenta a complexidade, desacelera as iterações e dificulta a organização de tudo.
A Ultralytics Platform elimina essa complexidade ao reunir todo o fluxo de trabalho de treinamento em um único ambiente. Em vez de alternar entre ferramentas, você pode gerenciar conjuntos de dados, configurar o treinamento, executar experimentos e monitorar resultados em um só lugar.
A seguir, vamos ver como a Ultralytics Platform torna o treinamento de modelos mais inteligente.
Opções de treinamento compatíveis com a Ultralytics Platform#
Em aplicações reais, treinar um modelo de visão computacional geralmente exige ambientes flexíveis. Dependendo do tamanho do conjunto de dados, da complexidade do modelo e do hardware disponível, você pode optar por executar o treinamento na nuvem, em uma máquina local ou em ambientes externos de notebooks.
A Ultralytics Platform oferece as seguintes opções de treinamento para atender a essas necessidades:
- Treinamento na nuvem: O treinamento é executado em unidades de processamento gráfico (GPUs) gerenciadas pela Ultralytics na nuvem. Essa opção é ideal para conjuntos de dados maiores ou modelos mais complexos que exigem recursos computacionais significativos.
- Treinamento local: Essa opção usa o hardware disponível na sua máquina e é ideal para experimentos rápidos, testes de configurações ou trabalho com conjuntos de dados menores. Para cargas de trabalho mais escaláveis, o treinamento também pode ser executado no seu próprio ambiente de nuvem, como AWS ou GCP.
- Google Colab: Com a Ultralytics Platform, você pode executar o treinamento no ambiente de notebooks hospedados do Google Colab, usando um fluxo de trabalho flexível pelo navegador, sem precisar configurar uma máquina local.
Como explorar o treinamento na nuvem na Ultralytics Platform#
Em projetos de visão computacional, treinar modelos localmente ou em ambientes de notebooks nem sempre é fácil.
Por exemplo, no treinamento local, o desempenho depende totalmente do seu hardware, o que pode limitar a capacidade computacional e desacelerar os experimentos. GPUs são essenciais para um treinamento eficiente, mas nem toda configuração oferece acesso confiável a elas.
Embora ambientes de notebooks como o Google Colab ofereçam uma alternativa com GPUs baseadas na nuvem, as sessões costumam ser temporárias e podem interromper execuções de treinamento mais longas. À medida que os conjuntos de dados crescem e os fluxos de trabalho se tornam mais complexos, essas limitações podem rapidamente se transformar em gargalos, tornando o treinamento mais lento e menos confiável.
A Ultralytics Platform resolve esse problema com sua opção de treinamento na nuvem. Ela oferece um ambiente pronto para uso, com dependências Python e frameworks como PyTorch pré-configurados, permitindo iniciar o treinamento sem configuração adicional.
Em um único painel, você pode iniciar tarefas de treinamento e monitorar o progresso em tempo real. Assim, fica mais fácil se concentrar em melhorar seus modelos em vez de gerenciar a infraestrutura.
Agora, vamos ver como começar a treinar na nuvem com a Ultralytics Platform.
Etapa 1: Selecione um modelo base#
A primeira etapa é escolher um modelo base para sua execução de treinamento. Você pode selecionar um modelo Ultralytics YOLO pré-treinado, clonar um modelo da comunidade ou enviar seus próprios pesos pré-treinados para atender a requisitos personalizados.
A plataforma oferece suporte a todos os modelos Ultralytics YOLO, incluindo Ultralytics YOLO26, Ultralytics YOLO11, Ultralytics YOLOv8 e Ultralytics YOLOv5, cada um disponível em diferentes variantes de tamanho, como nano (n), small (s), medium (m), large (l) e extra-large (x). Como as diferentes variantes oferecem um equilíbrio entre velocidade e precisão, você pode escolher um modelo que atenda aos seus requisitos de desempenho e capacidade computacional.
Esses modelos são compatíveis com uma variedade de tarefas de visão computacional já conhecidas pelos usuários do Ultralytics YOLO, incluindo detecção de objetos, segmentação de instâncias, classificação de imagens, estimativa de pose e detecção de caixas delimitadoras orientadas (OBB).
Se você tiver requisitos personalizados, também poderá enviar seus próprios pesos de modelo pré-treinado. Assim, você pode continuar treinando ou ajustar um modelo existente, como um detector de objetos, na plataforma, em vez de começar do zero. Isso é especialmente útil se você já treinou um modelo em outro lugar ou quiser adaptá-lo a um caso de uso mais específico.
Etapa 2: Selecione um conjunto de dados#
A próxima etapa é selecionar um conjunto de dados para o treinamento. No Ultralytics Platform, você pode usar conjuntos de dados existentes, como o conjunto de dados COCO, clonar conjuntos de dados da comunidade ou carregar seu próprio conjunto de dados personalizado, desenvolvido para sua aplicação específica.
A plataforma oferece suporte a formatos de anotação comuns, como Ultralytics YOLO e COCO, e também processa imagens brutas caso você pretenda anotar dados personalizados diretamente na plataforma.
Depois do envio, os conjuntos de dados são processados automaticamente, incluindo validação, normalização, análise de rótulos e geração de estatísticas. Isso permite visualizar seus dados imediatamente, incluindo a distribuição das classes e a estrutura do conjunto de dados, e ajuda a garantir que tudo esteja pronto para o treinamento.
Os conjuntos de dados também são vinculados automaticamente às execuções de treinamento, permitindo acompanhar quais dados foram usados em cada modelo e manter a consistência entre os experimentos.
Etapa 3: Configure os parâmetros de treinamento#
Depois de escolher o conjunto de dados, você pode configurar os parâmetros de treinamento que controlam como o modelo aprende. Eles incluem épocas, tamanho do lote, tamanho da imagem e o nome da execução no registro de treinamento. Muitos desses parâmetros influenciam tanto a duração do treinamento quanto o desempenho final do modelo.
Para ter mais controle sobre o treinamento, a plataforma também permite ajustar parâmetros avançados, como taxa de aprendizado, tipo de otimizador, configurações de aumento de dados de cor e outras opções de treinamento. Essas configurações podem refinar o processo de treinamento para melhorar a precisão e a estabilidade do modelo.
Etapa 4: Selecione uma GPU#
Em seguida, você pode selecionar a configuração de GPU para a execução do treinamento. Escolher a GPU certa depende de fatores como o tamanho do conjunto de dados, o tamanho do lote, a resolução das imagens e a complexidade do modelo. Encontrar o equilíbrio certo ajuda a manter a eficiência do treinamento sem usar mais recursos computacionais do que o necessário.
A Ultralytics Platform oferece 26 opções de GPU com diferentes quantidades de VRAM (memória da GPU) e capacidade de processamento, atendendo desde tarefas pequenas até cargas de trabalho em grande escala.
Com isso, você pode adequar o hardware às suas necessidades específicas, seja para treinar modelos leves ou trabalhar com conjuntos de dados grandes e complexos. Para saber mais, confira a lista de GPUs disponíveis na página de documentação de treinamento da Platform da Ultralytics.
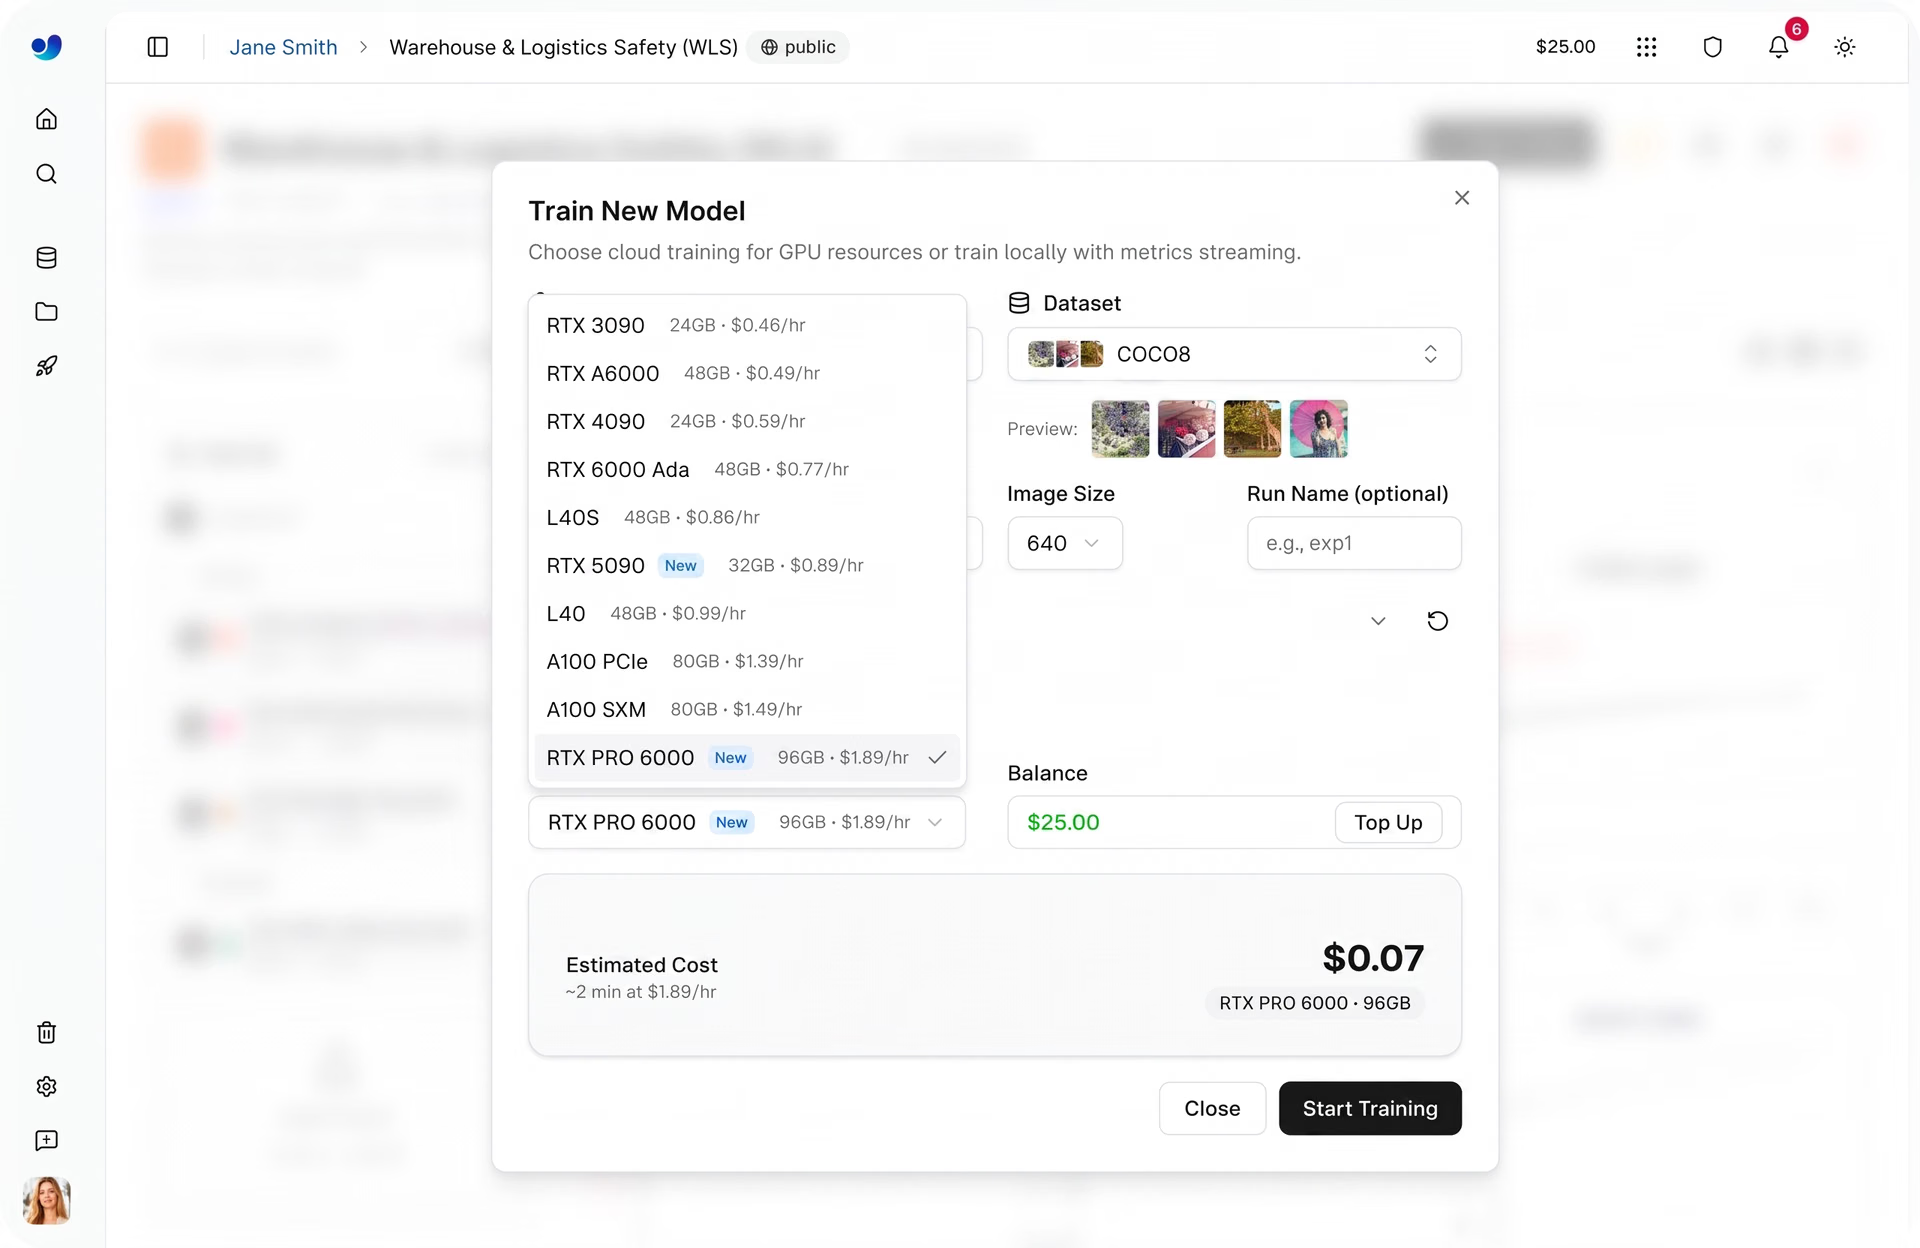
Fig. 2. Algumas das opções de GPU disponíveis na Ultralytics Platform (Fonte)
Etapa 5: Inicie o treinamento na nuvem#
Depois de selecionar o modelo, o conjunto de dados, os parâmetros de treinamento e a opção computacional, iniciar uma execução de treinamento é rápido. No painel, você pode iniciar o treinamento com um único clique, e a plataforma cuida do restante, inicializando o ambiente e executando a tarefa na GPU selecionada.
Quando o treinamento começa, você pode monitorar o progresso diretamente na plataforma. A guia Train oferece visibilidade em tempo real das principais métricas, incluindo métricas de desempenho, curvas de perda, uso do sistema e registros de treinamento ao vivo.
Para saber mais sobre treinamento local ou sobre como usar o Google Colab com a Ultralytics Platform, confira outros tutoriais na documentação oficial da Platform da Ultralytics.
Como avaliar e comparar modelos na Ultralytics Platform#
Depois que o treinamento termina, a próxima etapa é avaliar o desempenho do modelo. Na Ultralytics Platform, você pode comparar várias execuções de treinamento em um projeto, obtendo uma visão clara do desempenho de diferentes experimentos.
Durante o desenvolvimento de modelos, o treinamento costuma ser repetido várias vezes com configurações diferentes, como alterações na taxa de aprendizado, no tamanho do lote ou no tamanho do modelo, para melhorar os resultados. Cada execução gera um modelo ligeiramente diferente, por isso é essencial compará-los.
Os projetos funcionam como um ponto central onde modelos e experimentos são organizados em conjunto. Você pode acompanhar o progresso, analisar os resultados e manter o foco sem alternar entre diferentes ferramentas ou visualizações.
Nessa visualização unificada, você também pode analisar métricas de desempenho importantes, como precisão, revocação e mAP (precisão média), para entender como o modelo se comporta em diferentes classes. Você também pode comparar execuções de treinamento lado a lado para identificar quais configurações geram os melhores resultados.
Para complementar essas métricas, você pode usar a guia Predict para testar rapidamente modelos treinados com imagens ou dados de exemplo, o que ajuda a validar visualmente o desempenho e identificar possíveis problemas.
Com esses insights, você pode selecionar o modelo com melhor desempenho, normalmente salvo como o checkpoint “best.pt”, e avançar para a próxima etapa, seja uma avaliação adicional, o uso do modelo para inferência ou a implantação do modelo pela plataforma.
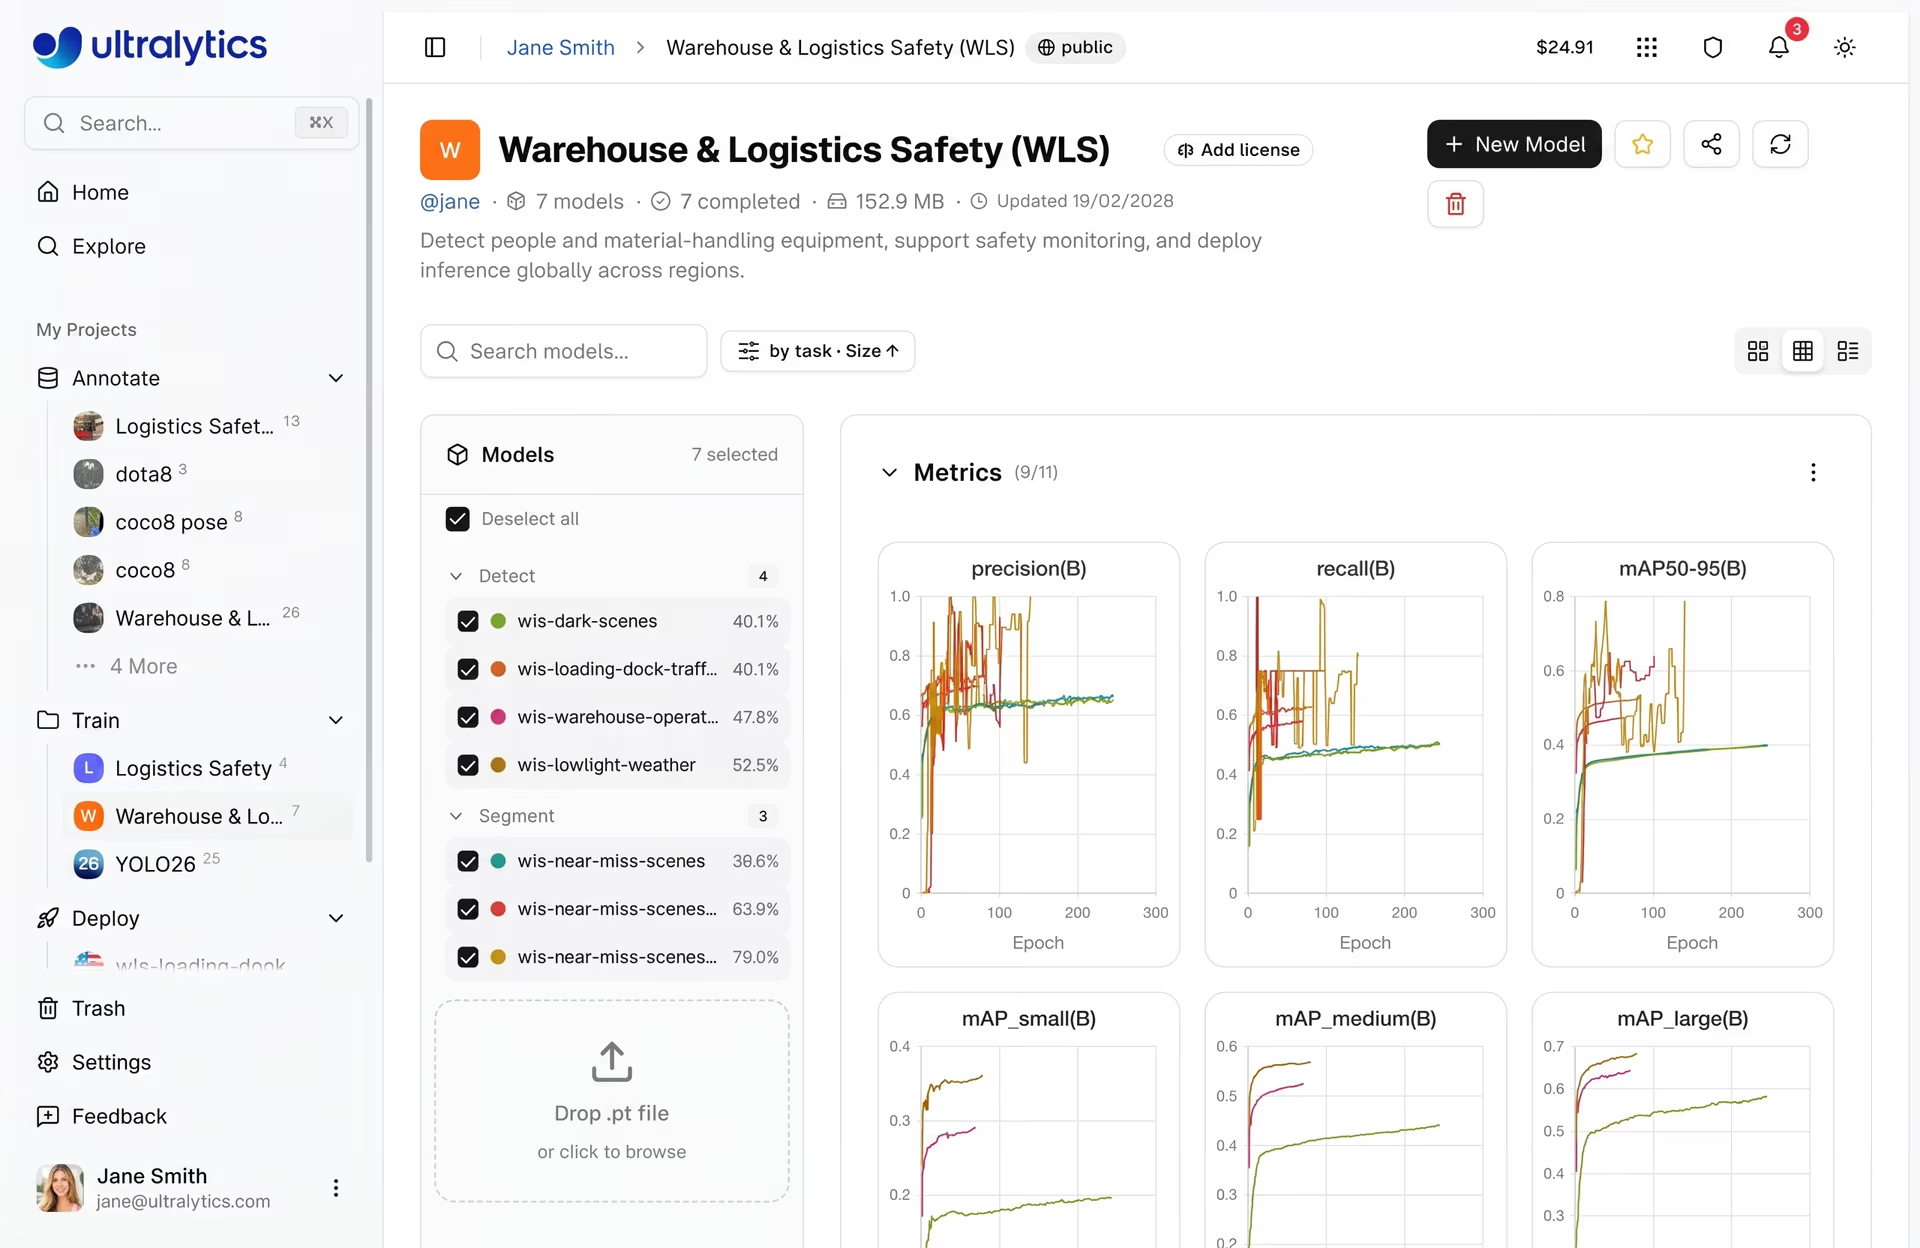
Fig. 3. Um exemplo de visualização de métricas na Ultralytics Platform (Fonte)
Estimativa do custo de treino na Ultralytics Platform#
Treinar modelos de deteção de objetos na nuvem gera custos computacionais, especialmente quando acedes a GPUs de alto desempenho. Para tornar este processo mais conveniente, a Ultralytics Platform apresenta uma estimativa de custos antes do início do treino.
A plataforma dá-te uma visão clara da utilização prevista, ajudando-te a planear cargas de trabalho, gerir orçamentos e evitar despesas inesperadas antes de iniciar um trabalho de treino. Eis como podes consultar os custos estimados antes de começar o treino.
Como é estimado o tempo de treino#
Para estimar os custos com precisão, a plataforma começa por calcular quanto tempo demora uma única época de treino. Isto depende de fatores como o tamanho do conjunto de dados, o tamanho do modelo, a resolução das imagens, o tamanho do lote e a velocidade da GPU selecionada.
Com estes dados, calcula o tempo estimado por época e extrapola-o para todo o treino. A duração total é calculada somando o tempo de todas as épocas e um pequeno tempo adicional de inicialização.
Este tempo adicional inclui tarefas como inicializar o ambiente, carregar conjuntos de dados e preparar a GPU, para que a estimativa reflita todo o processo de treino, não apenas o ciclo de treino.
Como é calculado o custo do treino#
Depois de estimar o tempo total de treino, a plataforma converte-o em custo com base na tarifa horária da GPU selecionada.
Ao combinar a duração do treinamento com o preço da GPU, você obtém uma estimativa clara do custo da execução antes mesmo de ela começar.
Com esta informação antecipada, é fácil ajustar a configuração, por exemplo, afinar os parâmetros de treino ou selecionar outra GPU, para equilibrar melhor o desempenho e o custo.
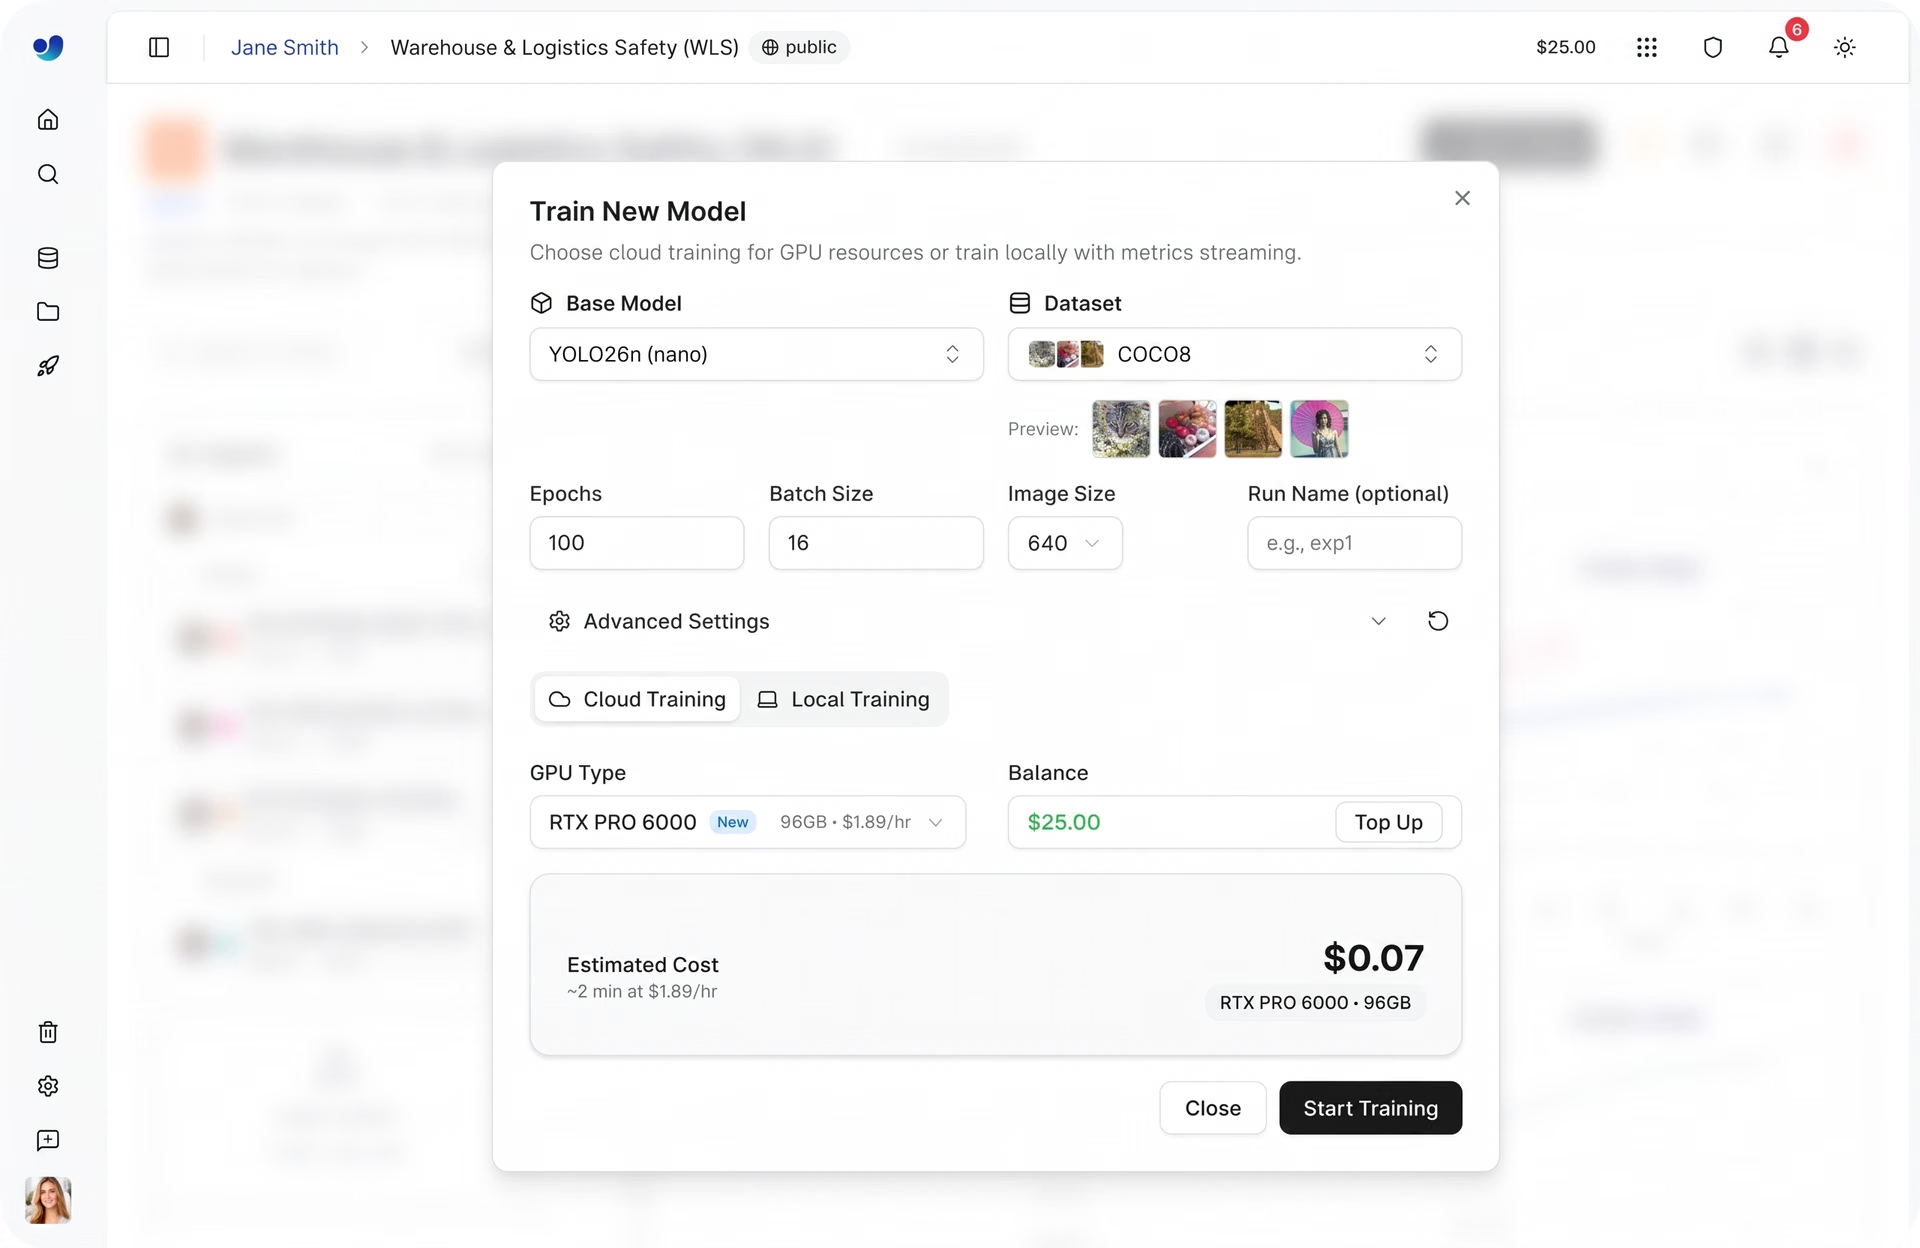
Fig. 4. Configuração do treino de modelos e estimativa de custos na Ultralytics Platform (Fonte)
Principais vantagens de utilizar a Ultralytics Platform para o treino de modelos#
Até aqui, explicamos as principais etapas do treinamento de modelos de visão computacional e como elas se integram no Ultralytics Platform.
Além destas funcionalidades essenciais, existem outras capacidades que melhoram o fluxo de trabalho de treino. Eis uma visão geral de algumas das principais vantagens de utilizar a Ultralytics Platform para treinar modelos:
- Reprodutibilidade de experiências integrada: Cada execução de treino é registada automaticamente com a sua configuração completa, incluindo o modelo, o conjunto de dados, os parâmetros e a configuração computacional. Assim, é fácil revisitar experiências e reproduzir resultados de forma fiável.
- Análise da evolução do treino: Em vez de veres apenas os resultados finais, podes acompanhar a evolução do desempenho ao longo das épocas, o que te ajuda a compreender melhor o comportamento do modelo durante o treino.
- Menos sobrecarga operacional: Ao tratar da configuração do ambiente, da gestão de dependências e da infraestrutura em segundo plano, a plataforma permite-te dedicar mais tempo ao desenvolvimento de modelos e menos à configuração.
- Organização centralizada de experiências: Os projetos oferecem um local único para gerir modelos, conjuntos de dados e execuções de treino, ajudando a manter as experiências organizadas à medida que os fluxos de trabalho se tornam mais complexos.
Principais conclusões#
O treino é uma das etapas mais importantes do ciclo de vida de um modelo de aprendizagem automática. Determina a precisão com que um modelo consegue reconhecer e interpretar dados visuais.
Ao combinar a configuração dos dados de treino, a monitorização, a comparação de experiências e a estimativa de custos num único ambiente, a Ultralytics Platform simplifica a criação de modelos de visão por computador de alto desempenho e a sua preparação para implementação.
Conhece a nossa comunidade em crescimento e o nosso repositório do GitHub para saber mais sobre visão computacional. Se queres desenvolver soluções de visão computacional, consulta as nossas opções de licenciamento. Explora as páginas das nossas soluções para saber mais sobre os benefícios da visão computacional na indústria e da IA na agricultura.
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









