Implementa modelos de visão computacional em 42 regiões do mundo
Leva modelos treinados dos testes no navegador aos endpoints de produção com apenas alguns cliques, com endpoints dedicados, monitorização da implementação e 22 formatos de exportação.
Implemente em escala global de produção
Coloque modelos treinados em produção com disponibilidade mundial, amplo suporte à exportação e o volume de uso comprovado pelo ecossistema Ultralytics.
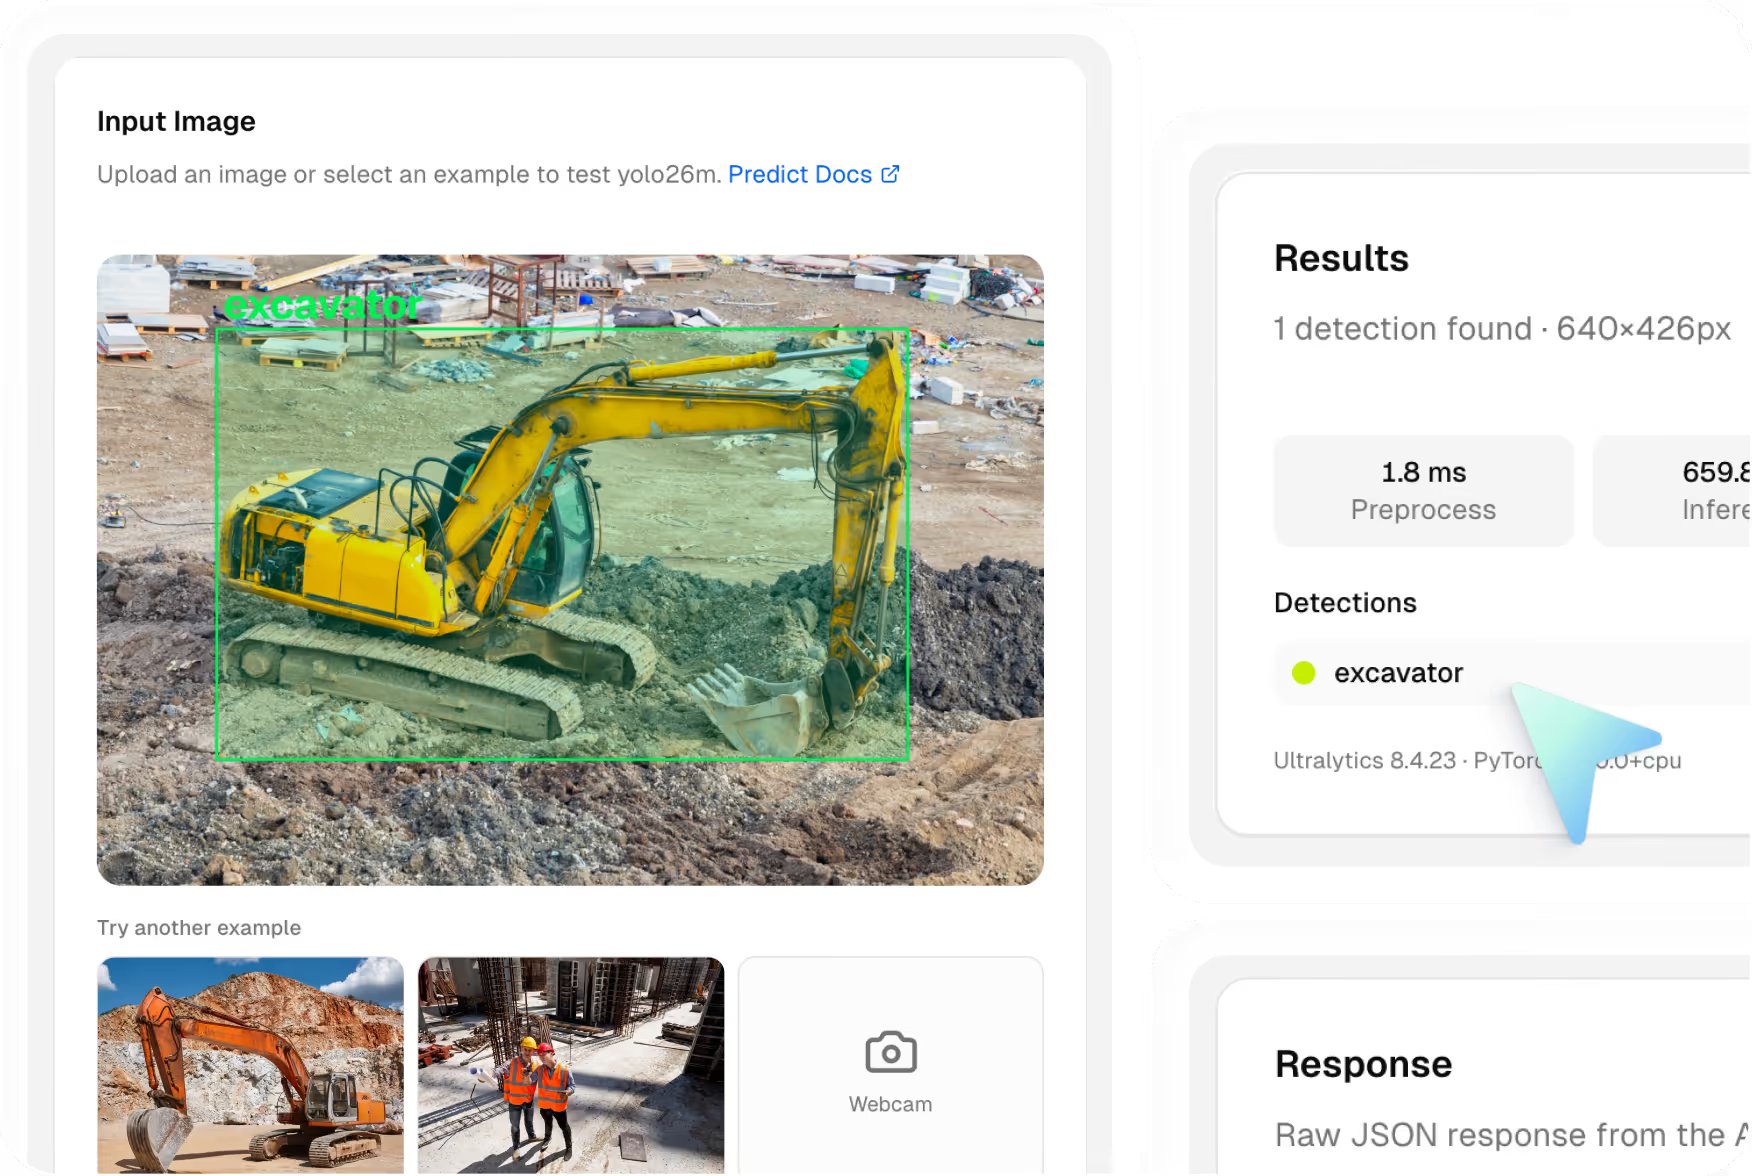
Testa o teu modelo no navegador
Todos os modelos treinados incluem a funcionalidade integrada do separador Predict. Carrega uma imagem ou abre a câmara; as caixas delimitadoras aparecem instantaneamente.
Implementa em 42 regiões do mundo
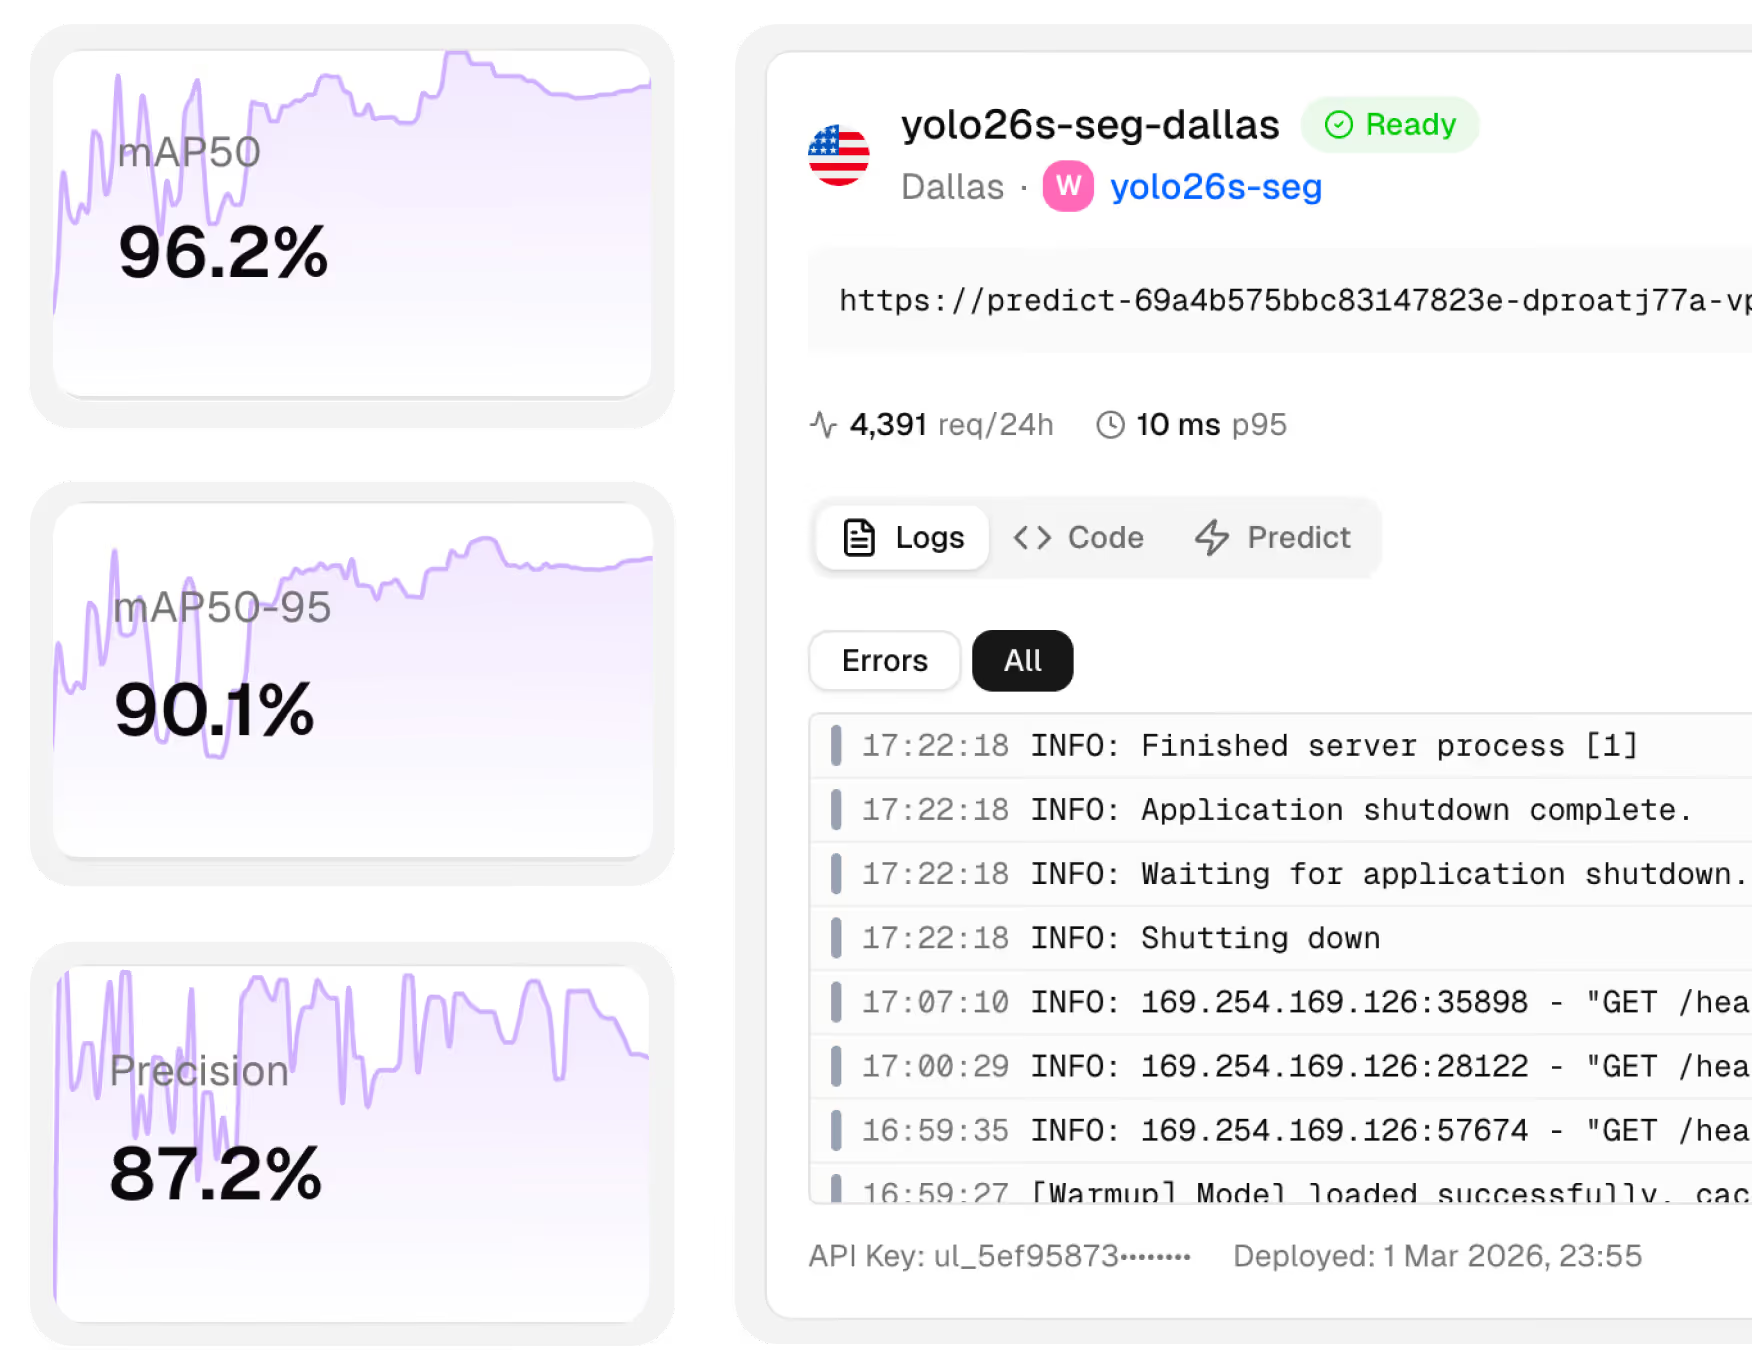
Implementa os teus modelos em endpoints dedicados nas Américas, na Europa, na Ásia-Pacífico e no Médio Oriente. Cada endpoint tem o seu próprio URL, CPU e memória configuráveis, e monitorização de pedidos, latência, erros e registos.
Endpoints dimensionados para a tua carga de trabalho
Começa com o tamanho incluído ou escolhe a CPU e a memória necessárias para cada endpoint.
- Escala automaticamente até zero:O tamanho incluído escala até zero quando está inativo e não tem custos de disponibilidade.
- Sem limite de taxa da API da Platform:Os pedidos vão diretamente para o teu endpoint, sem passar pelo limitador de taxa da API da Platform.
- Recursos configuráveis:Escolhe CPU (1-8 núcleos) e memória (2-32 GB) de acordo com a tua carga de trabalho. Os tamanhos personalizados mantêm uma instância ativa, com cobrança pela disponibilidade.
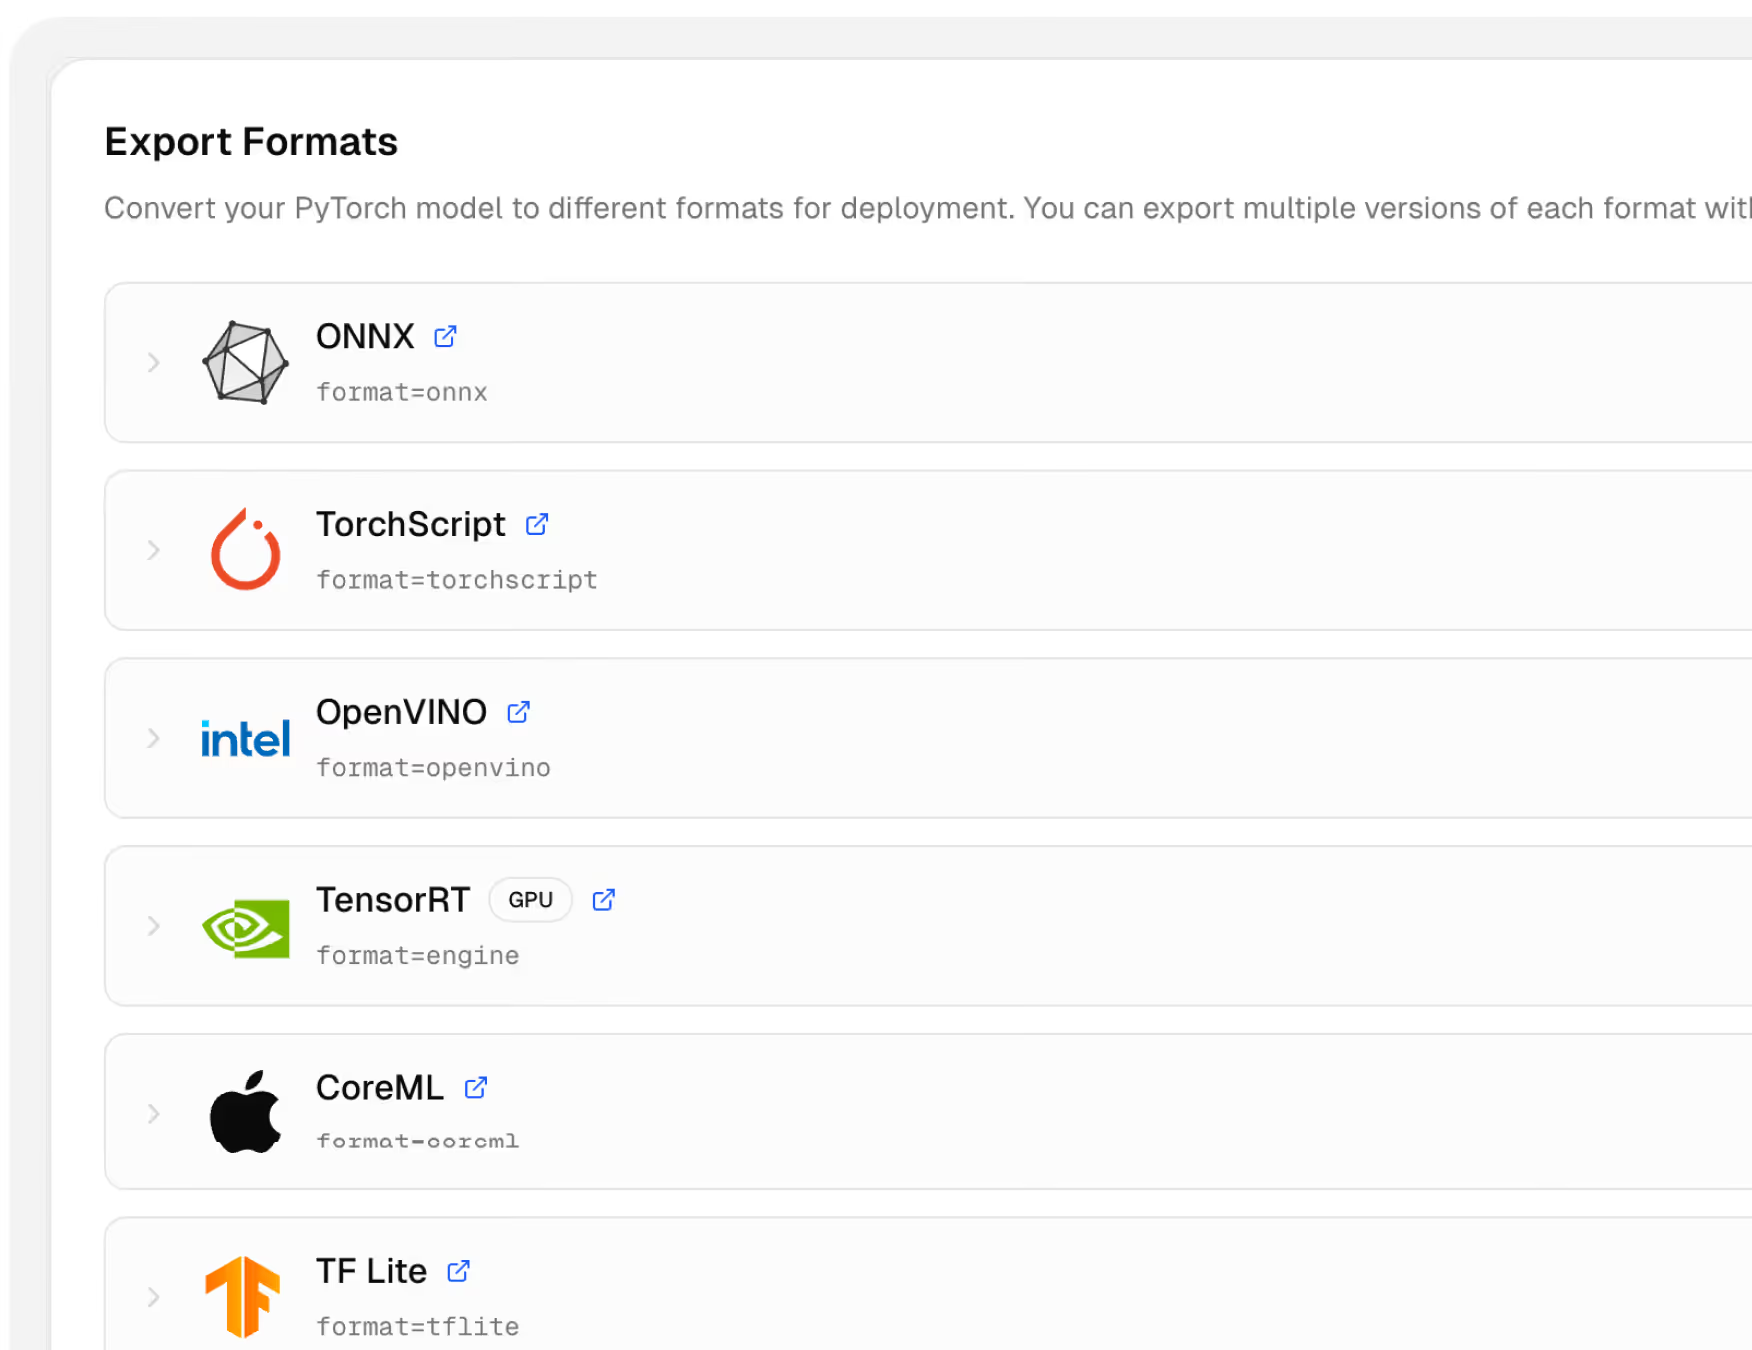
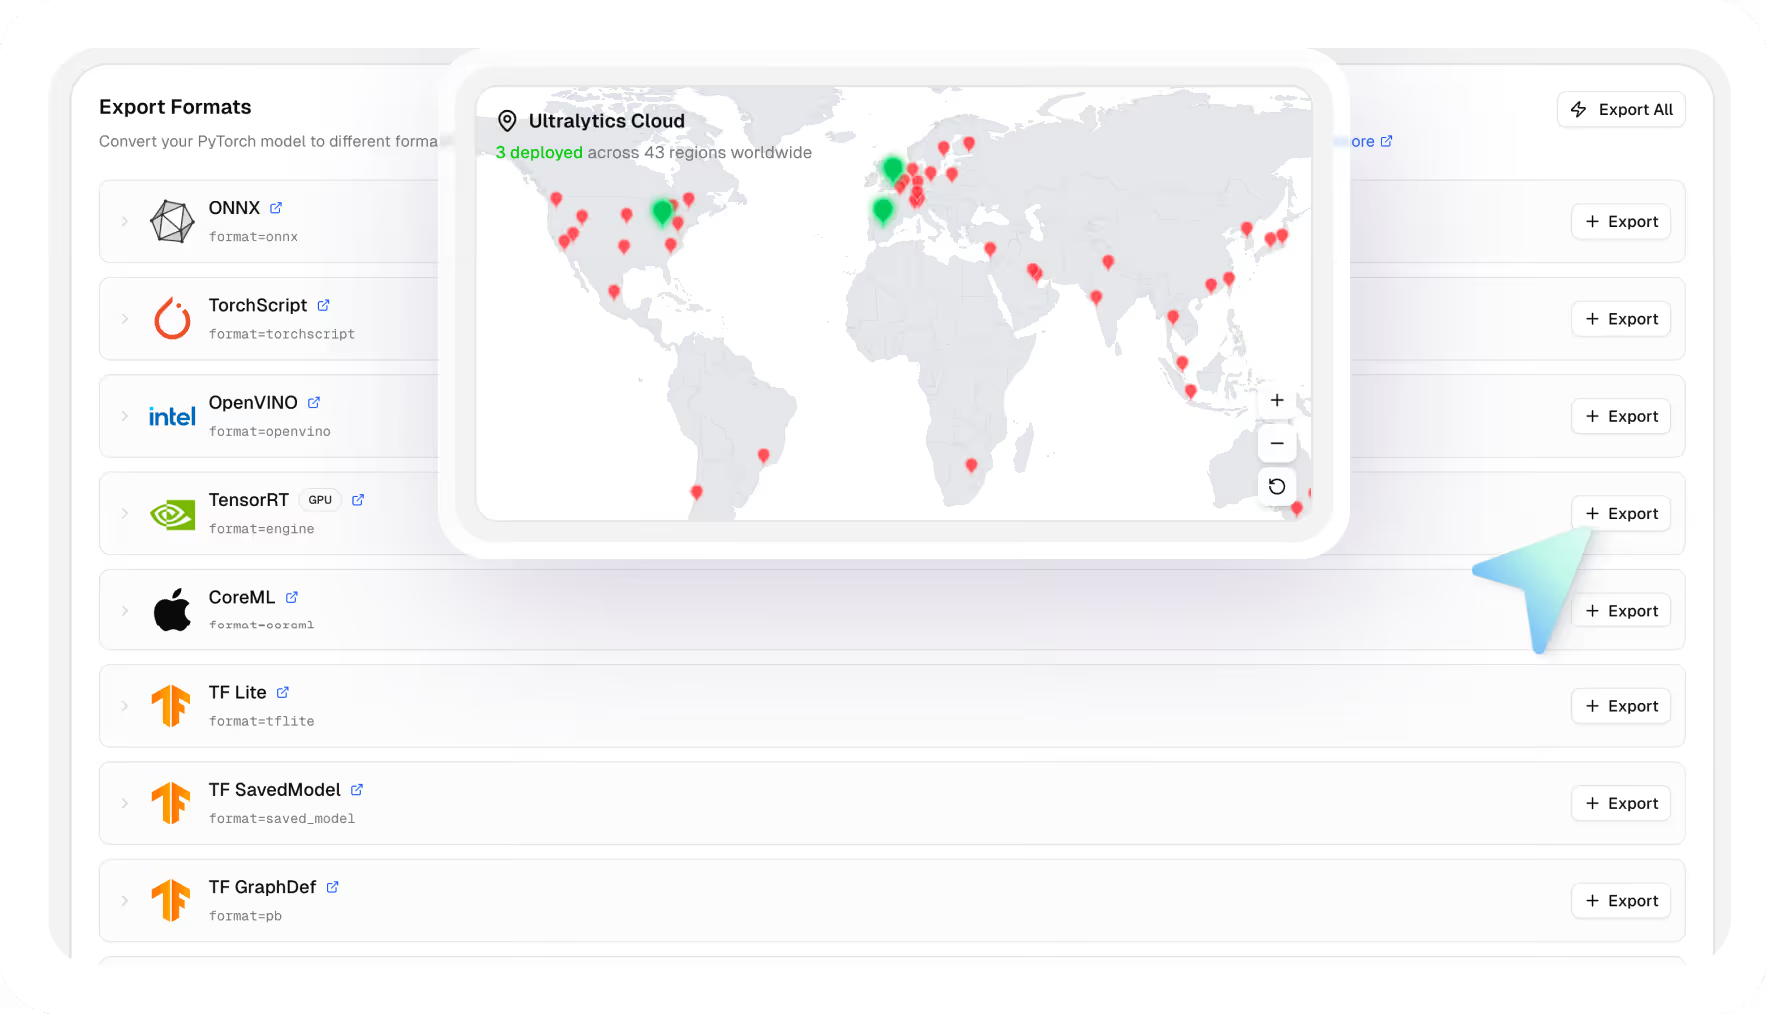
22 formatos de exportação. O teu modelo. Qualquer ambiente.
A Ultralytics Platform permite a implementação na cloud e na edge para obter alto desempenho. Todos os modelos YOLO da Ultralytics são otimizados nativamente para funcionar com eficiência em diferentes ambientes, oferecendo alta precisão, desempenho fiável e compatibilidade até mesmo com dispositivos edge com recursos computacionais limitados.
Monitoriza tudo em produção
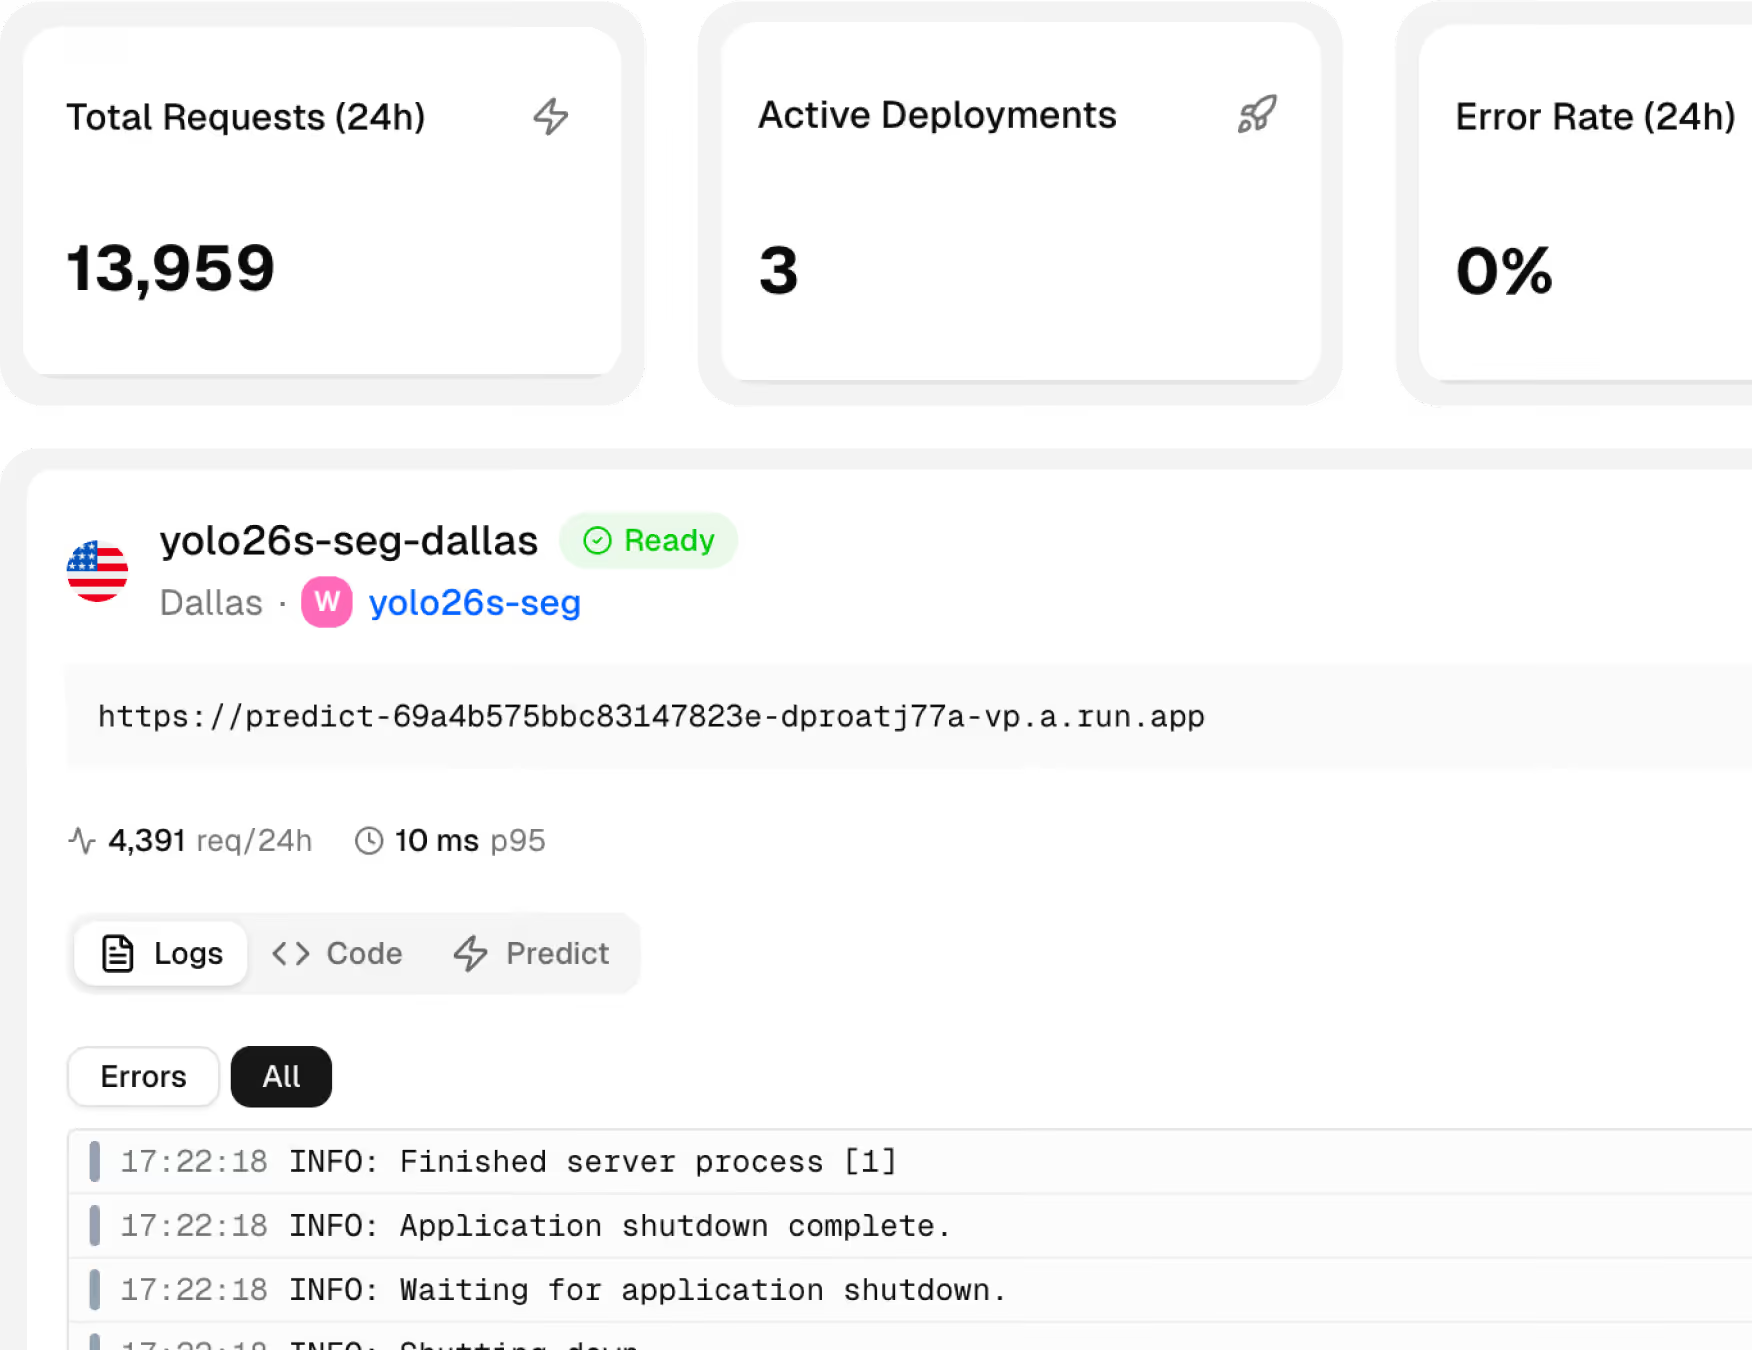
Acompanha pedidos, latência, erros e registos dos endpoints no painel de implementações. Os endpoints dedicados também fornecem estatísticas de previsões em tempo real e exemplos temporários que podes inspecionar e guardar num conjunto de dados.
- Pedidos, latência e erros:Volume HTTP das últimas 24 horas, latência P95 ponderada pelo volume e alertas de taxa de erros acima de 5%.
- Verificações de estado e registos:Estado do endpoint em tempo real com novas tentativas automáticas, além de registos filtrados por gravidade para diagnosticar problemas rapidamente.
- Exemplos temporários:Inspeciona previsões amostradas em endpoints dedicados. Os exemplos ficam na memória do endpoint; guarda as imagens úteis num conjunto de dados para as manter.
- Estatísticas de previsões:Contagens por classe, confiança, tempo de inferência e mapas de calor espaciais, quando suportados pela tarefa do modelo. As estatísticas são repostas quando a instância de serviço é substituída.
Integra em minutos
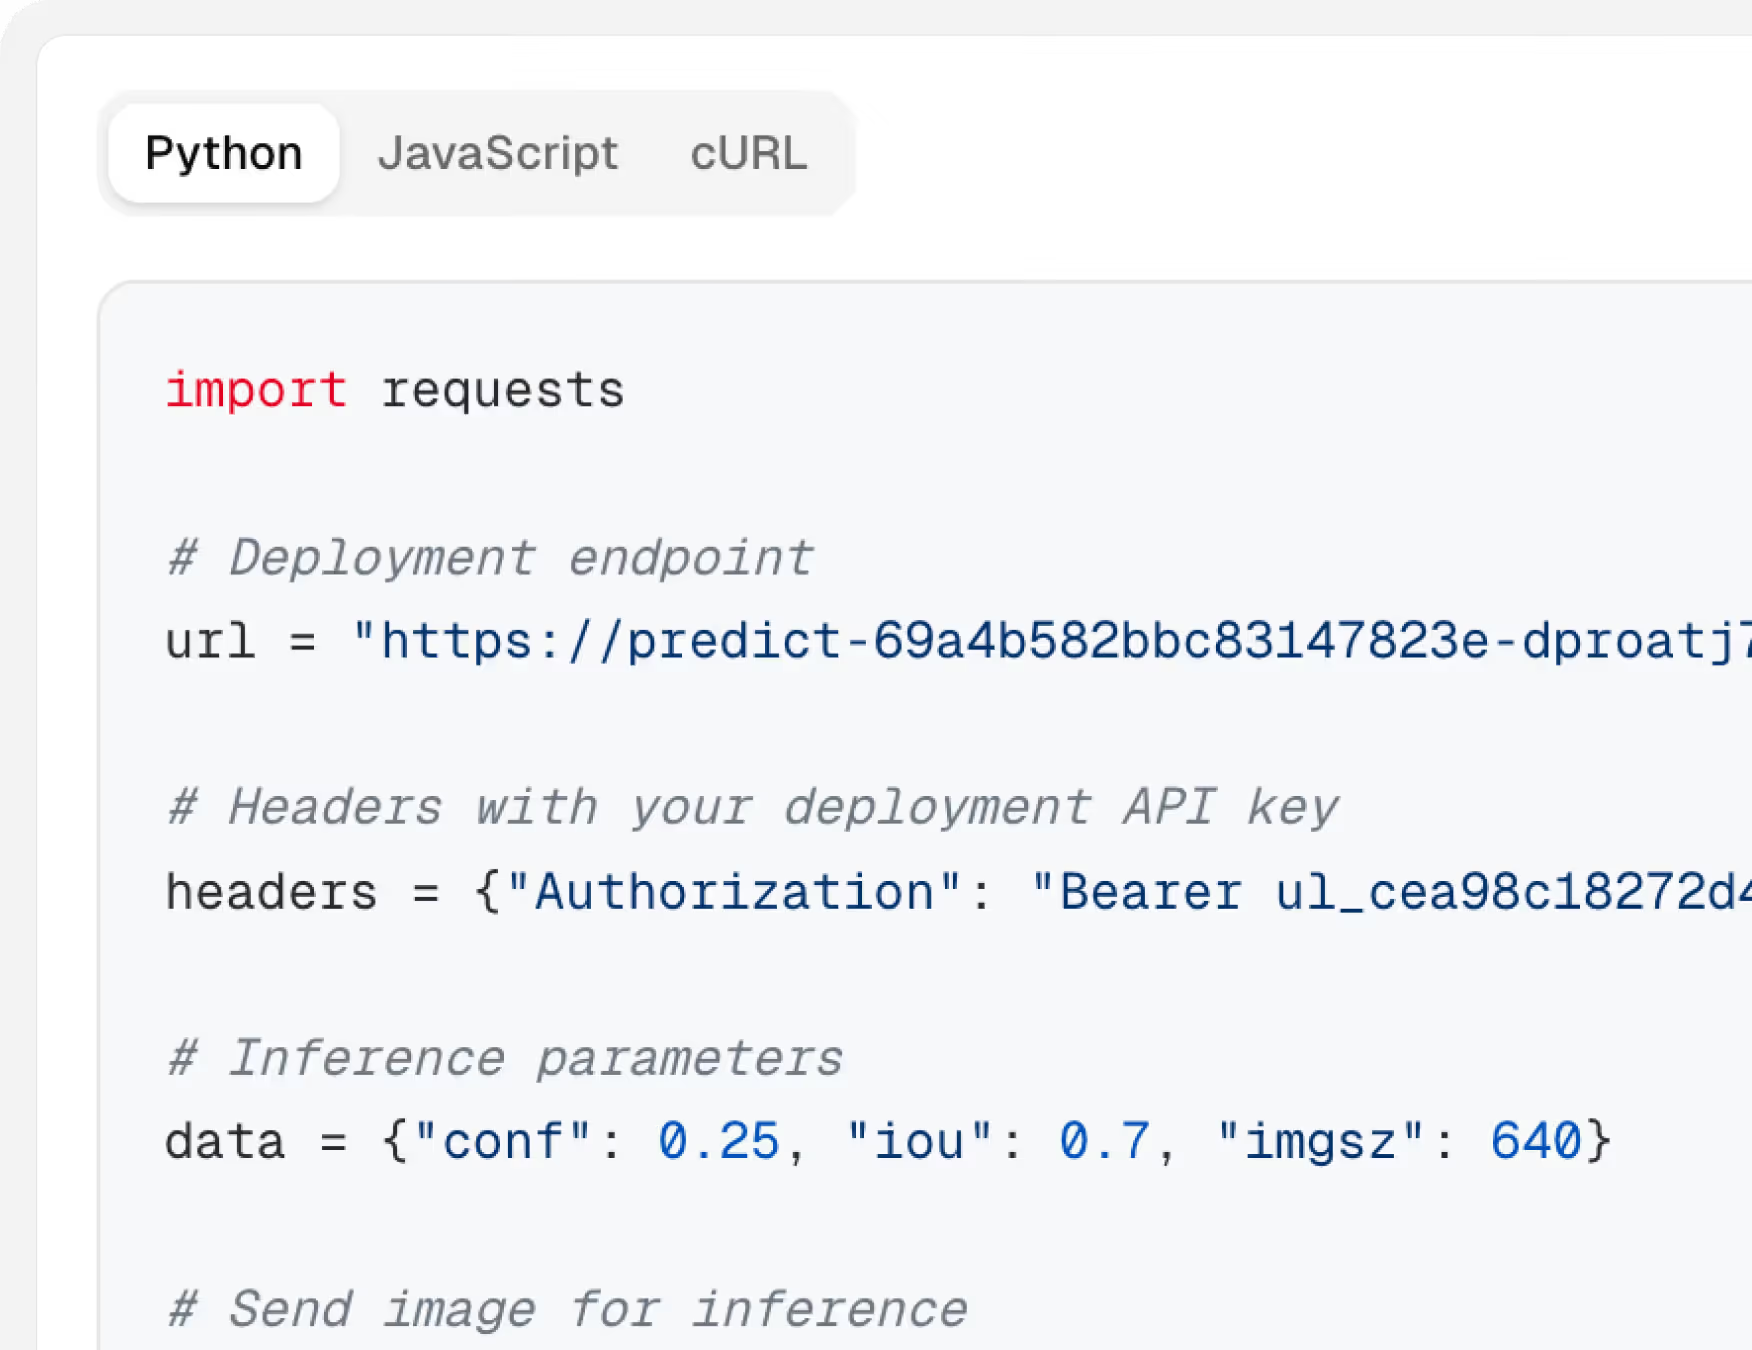
Cada endpoint implementado inclui exemplos de código gerados automaticamente em Python, JavaScript e cURL, preenchidos com o URL real do teu endpoint e a chave de API. Copia, cola e começa a enviar pedidos de inferência a partir de qualquer aplicação.
Experimente a inferência do YOLO26
Arrasta e larga uma imagem para ver a deteção de objetos em tempo real
Aprende a implementar!
Vê como testar um modelo treinado, implementá-lo num endpoint global e monitorizar pedidos, latência e previsões em tempo real.
O que nossos clientes dizem
A Ultralytics Platform foi revolucionária para nós. Ela facilita muito o trabalho dos nossos cientistas de dados para criar conjuntos de dados, treinar modelos novos rapidamente usando computação na nuvem, comparar experimentos com diferentes configurações de modelo e, por fim, identificar o melhor modelo para cada problema. Ela se tornou nosso principal ponto de partida para experimentos de detecção de objetos, segmentação de instâncias e segmentação semântica.
Tyler Biesel, Gerente de engenharia de software
Os modelos Ultralytics YOLO nos ajudaram a aumentar em 25,2% a velocidade de implementação do nosso serviço de IA. São fáceis de implantar e oferecem excelente desempenho no mundo real, proporcionando mais velocidade, precisão e escalabilidade sem comprometer o desempenho operacional.
O Ultralytics YOLO26 funciona perfeitamente na plataforma da Axelera, permitindo uma implantação mais rápida de IA de borda com o mínimo de esforço de integração. Esse é exatamente o tipo de colaboração entre hardware e software que ajuda os clientes a passar do desenvolvimento à produção mais rapidamente.
Alexis Crowell, CMO global e gerente-geral das Américas
Com o Ultralytics YOLOv8 nano, podemos retreinar na borda e lançar um novo modelo em horas, em vez de semanas, transferindo apenas uma fração dos dados. Essa combinação de precisão e tamanho reduzido é exatamente o que nossos ambientes exigem.
Com a Ultralytics, conseguimos aumentar a velocidade e obter mais precisão em comparação com outros modelos. A compatibilidade com várias estruturas — CUDA, TensorRT, ONNX, OpenVINO — foi muito útil para ajustar os pesos em P&D e, depois, otimizá-los para qualquer hardware disponível.
O desempenho dos modelos Ultralytics YOLO nos nossos microcontroladores STM32 abre novos horizontes para a visão computacional na borda. Com integração simplificada e suporte a diversas variantes de modelos, os desenvolvedores têm exatamente o que precisam para criar soluções escaláveis e responsivas de visão embarcada.

Eles transformam dados visuais em insights práticos com precisão e eficiência excepcionais. Ao combinar o Ultralytics YOLOv8 com o sensor IMX500 da SSS (Sony Semiconductor Solutions Corporation), essa parceria oferece poderosos recursos de IA diretamente no dispositivo, aprimorando a tomada de decisões em tempo real para empresas que dependem do processamento de dados visuais de alto desempenho.
Wei Tang, Gerente de desenvolvimento de negócios
Os modelos YOLO da Ultralytics são revolucionários no setor de IA. Os modelos YOLOv5 e YOLOv8 são preferidos pelos desenvolvedores pela facilidade de uso, pelo desempenho de ponta e pela precisão. Em conjunto com o OpenVINO, esses modelos têm potencial para oferecer o melhor desempenho imediato em CPUs modernas.
Precisas de treinar primeiro um modelo?
A Ultralytics Platform liga a anotação, o treino e a implementação numa única plataforma.
Explora soluções para o setor
Veja como as equipes aplicam a visão computacional da Ultralytics em ambientes de produção.

Visão computacional no desporto

Visão computacional para imagens aéreas

Visão computacional no setor aeroespacial

Visão computacional na segurança

Visão computacional na robótica

Visão computacional na logística

Visão computacional no varejo

Visão computacional na área da saúde

Visão computacional na manufatura

Visão computacional no setor automotivo

Visão computacional na agricultura
Segurança e conformidade de nível empresarial
Crie e implemente com confiança. Com certificação ISO 27001, atestação SOC 2 e suporte à conformidade com a HIPAA.
SOC 2 Type I
ISO 27001:2022
HIPAA
GDPR e CCPA
Perguntas frequentes
Sim. Implanta um modelo em até 42 regiões, conforme permitido pelo teu plano: 3 endpoints no Free, 10 no Pro e ilimitados no Enterprise, contabilizados em todo o teu espaço de trabalho. Implantar mais perto dos teus usuários pode reduzir a latência.
O tamanho padrão do endpoint (1 vCPU, 2 GiB) é gratuito, inclusive durante o atendimento de solicitações, e reduz a zero quando fica ocioso. Tamanhos personalizados, de até 8 vCPU e 32 GiB, mantêm uma instância ativa e são cobrados com créditos pelo tempo de atividade, inclusive o tempo ocioso; as tarifas dependem do tamanho e da região. A inferência compartilhada está incluída em todos os planos.
A inferência compartilhada é executada em um serviço multi-inquilino em 3 regiões e tem um limite de 20 solicitações por minuto por chave de API ou chamador, o que é adequado para testes. Um endpoint dedicado é um serviço de inquilino único em qualquer uma das 42 regiões, com URL e chave de API próprias. As solicitações enviadas diretamente a ele não estão sujeitas a esse limite, mas cada endpoint executa uma instância e pode rejeitar solicitações quando está ocupado; por isso, faz um teste de carga antes de usar em produção.
Um novo endpoint costuma ficar pronto em poucos minutos, dependendo do modelo e da região. Os endpoints de tamanho padrão reduzem a zero quando ficam ociosos; por isso, a primeira solicitação após um período de inatividade pode levar cerca de um minuto enquanto o endpoint inicia.
A implantação de modelos disponibiliza um modelo treinado para fazer previsões sobre novos dados, como imagens ou quadros de vídeo enviados por um aplicativo. Na Ultralytics Platform, podes testar um modelo no navegador, implantá-lo em um endpoint dedicado em qualquer uma das 42 regiões, chamá-lo do teu aplicativo e monitorá-lo, tudo no mesmo espaço de trabalho.
Envia imagens ou arquivos de vídeo compatíveis para a REST API do teu endpoint; os modelos de profundidade aceitam apenas imagens. Cada página de implantação tem exemplos em Python, JavaScript e cURL. Os proprietários do espaço de trabalho também podem executar um endpoint a partir de uma webcam ou de uma câmera RTSP acessível pela internet, na aba Predict (endereços de rede local não são compatíveis), e endpoints de tamanho personalizado podem continuar monitorando uma câmera IP em segundo plano.
Sim. Exporta o teu modelo para o hardware de destino e executa-o nos teus próprios servidores ou dispositivos de borda, inclusive sem conexão. Os formatos incluem TensorRT para NVIDIA Jetson, OpenVINO, CoreML, LiteRT, NCNN, RKNN, Hailo e Qualcomm; os formatos disponíveis dependem do modelo e da tarefa. Para usá-lo em produtos proprietários sem as obrigações da AGPL-3.0, é necessária uma licença Enterprise da Ultralytics.
Começa a implementar hoje!
Leve os seus modelos treinados para produção em 42 regiões globais, com endpoints dedicados e monitoramento de implantações.