Gerenciamento inteligente de conjuntos de dados em visão computacional com a Ultralytics Platform
Saiba como usar a Ultralytics Platform para melhorar o gerenciamento de conjuntos de dados em seus projetos de visão computacional. Acompanhe, compare e aprimore seus conjuntos de dados com facilidade.
 Abirami Vina18 min de leitura
A IA de visão, ou visão computacional, evoluiu muito desde os primeiros dias, passando de uma área de pesquisa experimental a uma tecnologia essencial para aplicações do mundo real. Hoje, entusiastas de IA podem criar modelos poderosos para tarefas como detecção de objetos e segmentação de instâncias usando ferramentas e frameworks acessíveis.
No entanto, à medida que essas aplicações passam da experimentação à produção, o gerenciamento de conjuntos de dados continua sendo um desafio fundamental e muitas vezes negligenciado. Com o crescimento em tamanho e complexidade dos conjuntos de dados de visão computacional, as equipes costumam ter dificuldade para manter anotações consistentes, acompanhar alterações entre versões e garantir a qualidade geral dos dados.
Mesmo modelos avançados podem ter desempenho inferior em ambientes reais se os dados usados no treinamento estiverem incompletos, desequilibrados ou mal gerenciados. Essa diferença crescente entre o desempenho no desenvolvimento e a confiabilidade no mundo real é o motivo pelo qual é necessário adotar uma abordagem mais estruturada para o gerenciamento de conjuntos de dados.
Outra limitação comum é que a coleta, a anotação e o treinamento de dados costumam ser feitos com ferramentas separadas. Um fluxo de trabalho fragmentado dificulta o gerenciamento eficiente dos conjuntos de dados, aumenta o risco de inconsistências e torna as iterações mais lentas.
Para resolver gargalos em IA de visão, como o gerenciamento de conjuntos de dados e os fluxos de trabalho fragmentados, lançamos recentemente a Ultralytics Platform. Ela é um ambiente de trabalho completo que reúne gerenciamento de conjuntos de dados, anotação, treinamento, implantação e monitoramento em um único fluxo de trabalho integrado.
Ao conectar cada etapa do ciclo de vida da visão computacional, fica mais fácil acompanhar alterações nos conjuntos de dados, comparar o desempenho entre versões e aprimorar continuamente os dados para obter melhores resultados.
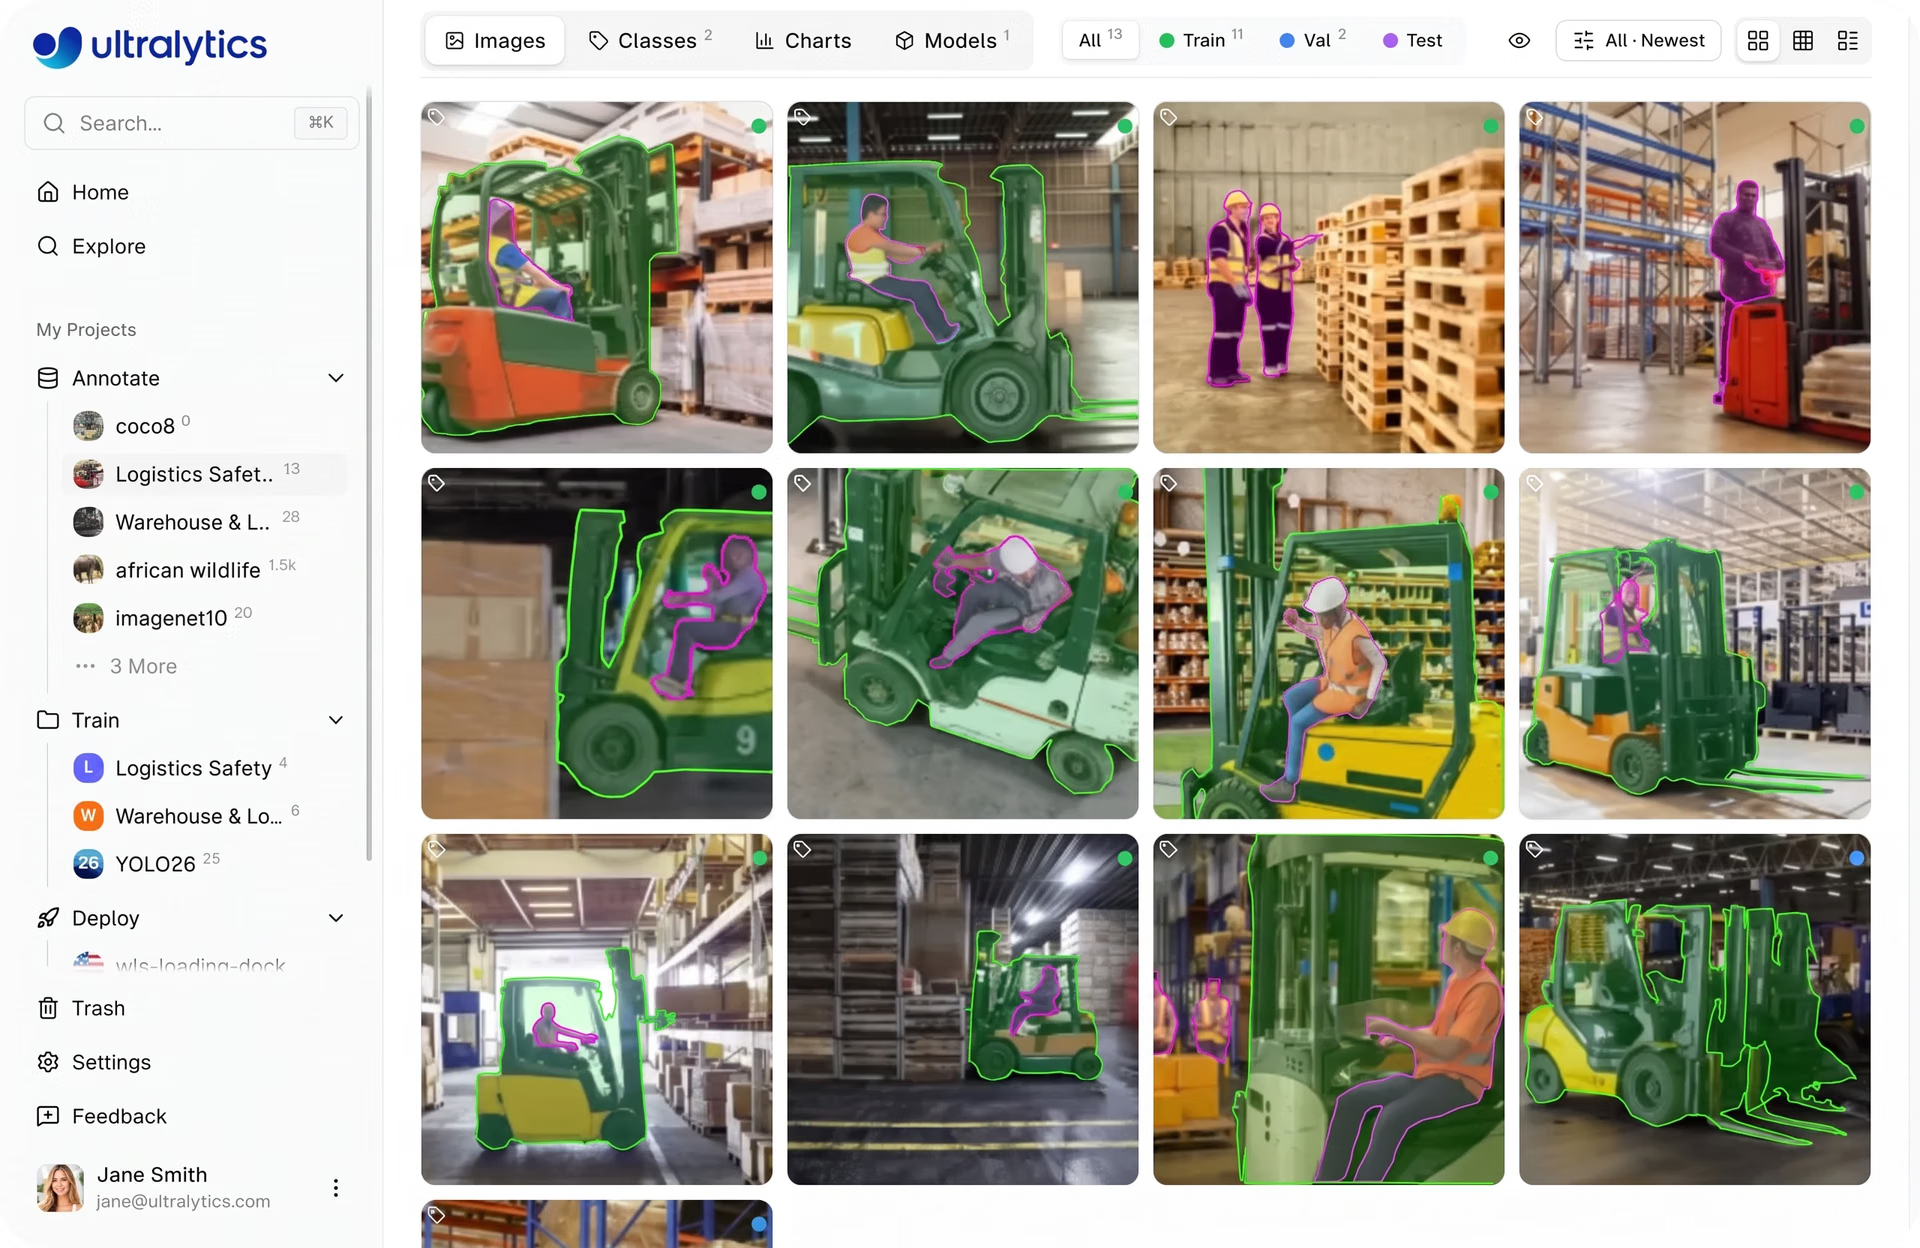
Fig. 1. Exemplo de visualização das imagens do seu conjunto de dados na Ultralytics Platform (Fonte)
Neste artigo, vamos explorar como a Ultralytics Platform ajuda você a acompanhar, comparar e melhorar seus conjuntos de dados para criar modelos de visão computacional mais confiáveis.
A importância do gerenciamento de conjuntos de dados em visão computacional#
O desempenho de um modelo de visão computacional está diretamente relacionado aos dados usados no treinamento. A precisão do modelo, ou seja, a frequência com que as previsões estão corretas, depende não apenas do algoritmo, mas também de quanto o conjunto de dados representa as condições do mundo real.
Em poucas palavras, um modelo aprende padrões diretamente dos dados, então quaisquer lacunas, vieses ou inconsistências no conjunto de dados podem influenciar suas previsões. Em outras palavras, dados de baixa qualidade, anotações incorretas ou uma cobertura limitada das variações do mundo real nas imagens, como diferentes condições de iluminação, ângulos dos objetos, planos de fundo ou níveis de oclusão, podem reduzir significativamente a precisão, mesmo quando a arquitetura do modelo é robusta.
Isso também se aplica ao ajuste fino de um modelo, em que um modelo pré-treinado passa por treinamento adicional com dados novos ou atualizados para se adaptar melhor a um caso de uso ou ambiente específico. Como a precisão do modelo depende tanto dos dados, gerenciá-los adequadamente é essencial.
O gerenciamento de conjuntos de dados inclui organizar, rotular e atualizar os dados continuamente para mantê-los precisos e relevantes. Isso facilita a melhoria do desempenho ao longo do tempo, especialmente ao retreinar ou ajustar modelos com novos dados.
Como a qualidade dos conjuntos de dados afeta a confiabilidade no mundo real#
Casos de uso de visão computacional, como sistemas de monitoramento de segurança, são um ótimo exemplo de por que o gerenciamento adequado de dados é fundamental. Esses sistemas precisam funcionar de forma confiável em diversas condições do mundo real, incluindo diferentes ambientes de iluminação, ângulos de câmera, níveis de aglomeração e oclusões parciais.
Se os dados de treinamento não abrangerem essas variações ou não forem diversificados quanto à aparência dos objetos em diferentes cenas e condições, o modelo poderá ter dificuldade para detectar objetos com precisão. Por exemplo, um modelo treinado principalmente com cenas bem iluminadas e desobstruídas pode ter um desempenho ruim em ambientes com pouca luz ou muito movimentados. Em sistemas de segurança, isso pode levar à perda de eventos ou a alertas falsos.
Para evitar isso, é importante manter conjuntos de dados que sejam não apenas limpos e rotulados com precisão, mas também bem equilibrados e atualizados continuamente. Isso significa identificar lacunas nos dados, adicionar novos exemplos conforme as condições mudam e garantir que diferentes classes e ambientes estejam representados de maneira equilibrada.
Com um conjunto de dados mais completo e estruturado, os modelos ficam mais preparados para lidar com a variabilidade do mundo real e gerar previsões mais confiáveis.
Principais aspectos do gerenciamento de conjuntos de dados#
Então, como é o gerenciamento de conjuntos de dados na prática? Ele envolve organizar, rotular e manter os dados para que possam ser usados com eficiência durante todo o processo de desenvolvimento do modelo.
A organização dos dados, por exemplo, inclui estruturar o conjunto de dados e dividi-lo em conjuntos de treinamento, validação e teste. O conjunto de treinamento é usado para ensinar o modelo, o conjunto de validação é usado para monitorar o desempenho e orientar ajustes durante o desenvolvimento, e o conjunto de teste é usado para avaliar o desempenho do modelo final em dados totalmente inéditos.
Já a rotulagem envolve anotar imagens com informações como rótulos de classe, caixas delimitadoras ou máscaras de segmentação. Como o modelo aprende com essas anotações, a precisão e a consistência são essenciais para ajudá-lo a aprender padrões significativos e fazer previsões confiáveis.
Além disso, manter o conjunto de dados envolve revisar e atualizar os dados ao longo do tempo. Isso pode incluir corrigir erros de anotação, remover dados duplicados ou de baixa qualidade e adicionar novos exemplos para abranger casos ausentes ou condições em mudança.
De forma mais ampla, o gerenciamento de conjuntos de dados é um processo contínuo. À medida que os modelos são avaliados e novos dados são coletados, os conjuntos de dados precisam ser atualizados para refletir as condições e os casos extremos do mundo real. Acompanhar essas atualizações e comparar diferentes versões ajuda as equipes a entender o que está melhorando o desempenho e onde são necessárias novas alterações.
Gerenciamento de conjuntos de dados com a Ultralytics Platform#
A Ultralytics Platform oferece um fluxo de trabalho estruturado para gerenciar conjuntos de dados em um único ambiente, abrangendo desde a preparação dos dados até a exportação. Ela foi projetada para atender tanto desenvolvedores individuais quanto equipes, facilitando o gerenciamento consistente de conjuntos de dados, seja trabalhando de forma independente ou colaborando em vários projetos.
Cada etapa foi projetada para simplificar a organização, o processamento e o uso dos conjuntos de dados ao longo do ciclo de vida do desenvolvimento do modelo. Ao reunir essas etapas em um só lugar, a plataforma reduz a fragmentação e facilita a manutenção da consistência entre os fluxos de trabalho.
Agora, vamos percorrer as principais etapas envolvidas e ver como a plataforma dá suporte a cada uma delas.
Como enviar conjuntos de dados para a Ultralytics Platform#
Começar a trabalhar com conjuntos de dados na plataforma é simples e flexível, com várias opções para importar ou reutilizar dados. Você pode enviar seus próprios dados ou começar mais rápido usando conjuntos de dados públicos disponíveis na plataforma. Também pode clonar conjuntos de dados existentes compartilhados pela comunidade e usá-los como base.
Os recursos comunitários da plataforma facilitam a exploração e a reutilização de trabalhos existentes. Com acesso a conjuntos de dados criados por outros usuários, incluindo milhões de imagens e anotações, você pode começar rapidamente sem precisar coletar e rotular tudo por conta própria. Ao clonar um conjunto de dados, você cria uma cópia no seu espaço de trabalho, que pode modificar e ampliar sem alterar o original.
Para uploads, a plataforma aceita imagens individuais, vídeos e arquivos compactados de conjuntos de dados, como ZIP, TAR ou GZ. Ela também oferece suporte a formatos de conjunto de dados amplamente usados, como YOLO e COCO, facilitando a importação de conjuntos de dados e anotações existentes sem conversões adicionais. Além disso, você pode enviar um conjunto de dados usando um arquivo NDJSON exportado da plataforma, o que facilita recriar ou reutilizar conjuntos de dados em diferentes projetos.
Depois que os dados são enviados, a plataforma os processa por meio de um pipeline estruturado. Esse processo inclui validar os formatos e tamanhos dos arquivos, redimensionar imagens quando necessário, analisar anotações e gerar estatísticas do conjunto de dados.
Por exemplo, os vídeos são convertidos em quadros para que possam ser usados no treinamento, enquanto as imagens são otimizadas e preparadas para facilitar a navegação e a análise. Após o processamento, os conjuntos de dados estão prontos para anotação, análise e treinamento de modelos na plataforma.
Anotação de dados na Ultralytics Platform#
Depois do upload, os conjuntos de dados podem ser revisados e anotados diretamente na plataforma. A plataforma inclui ferramentas integradas de anotação de imagens para várias tarefas de visão computacional, como detecção de objetos, segmentação de instâncias, segmentação semântica, classificação de imagens, estimativa de pose e detecção de caixas delimitadoras orientadas (OBB).
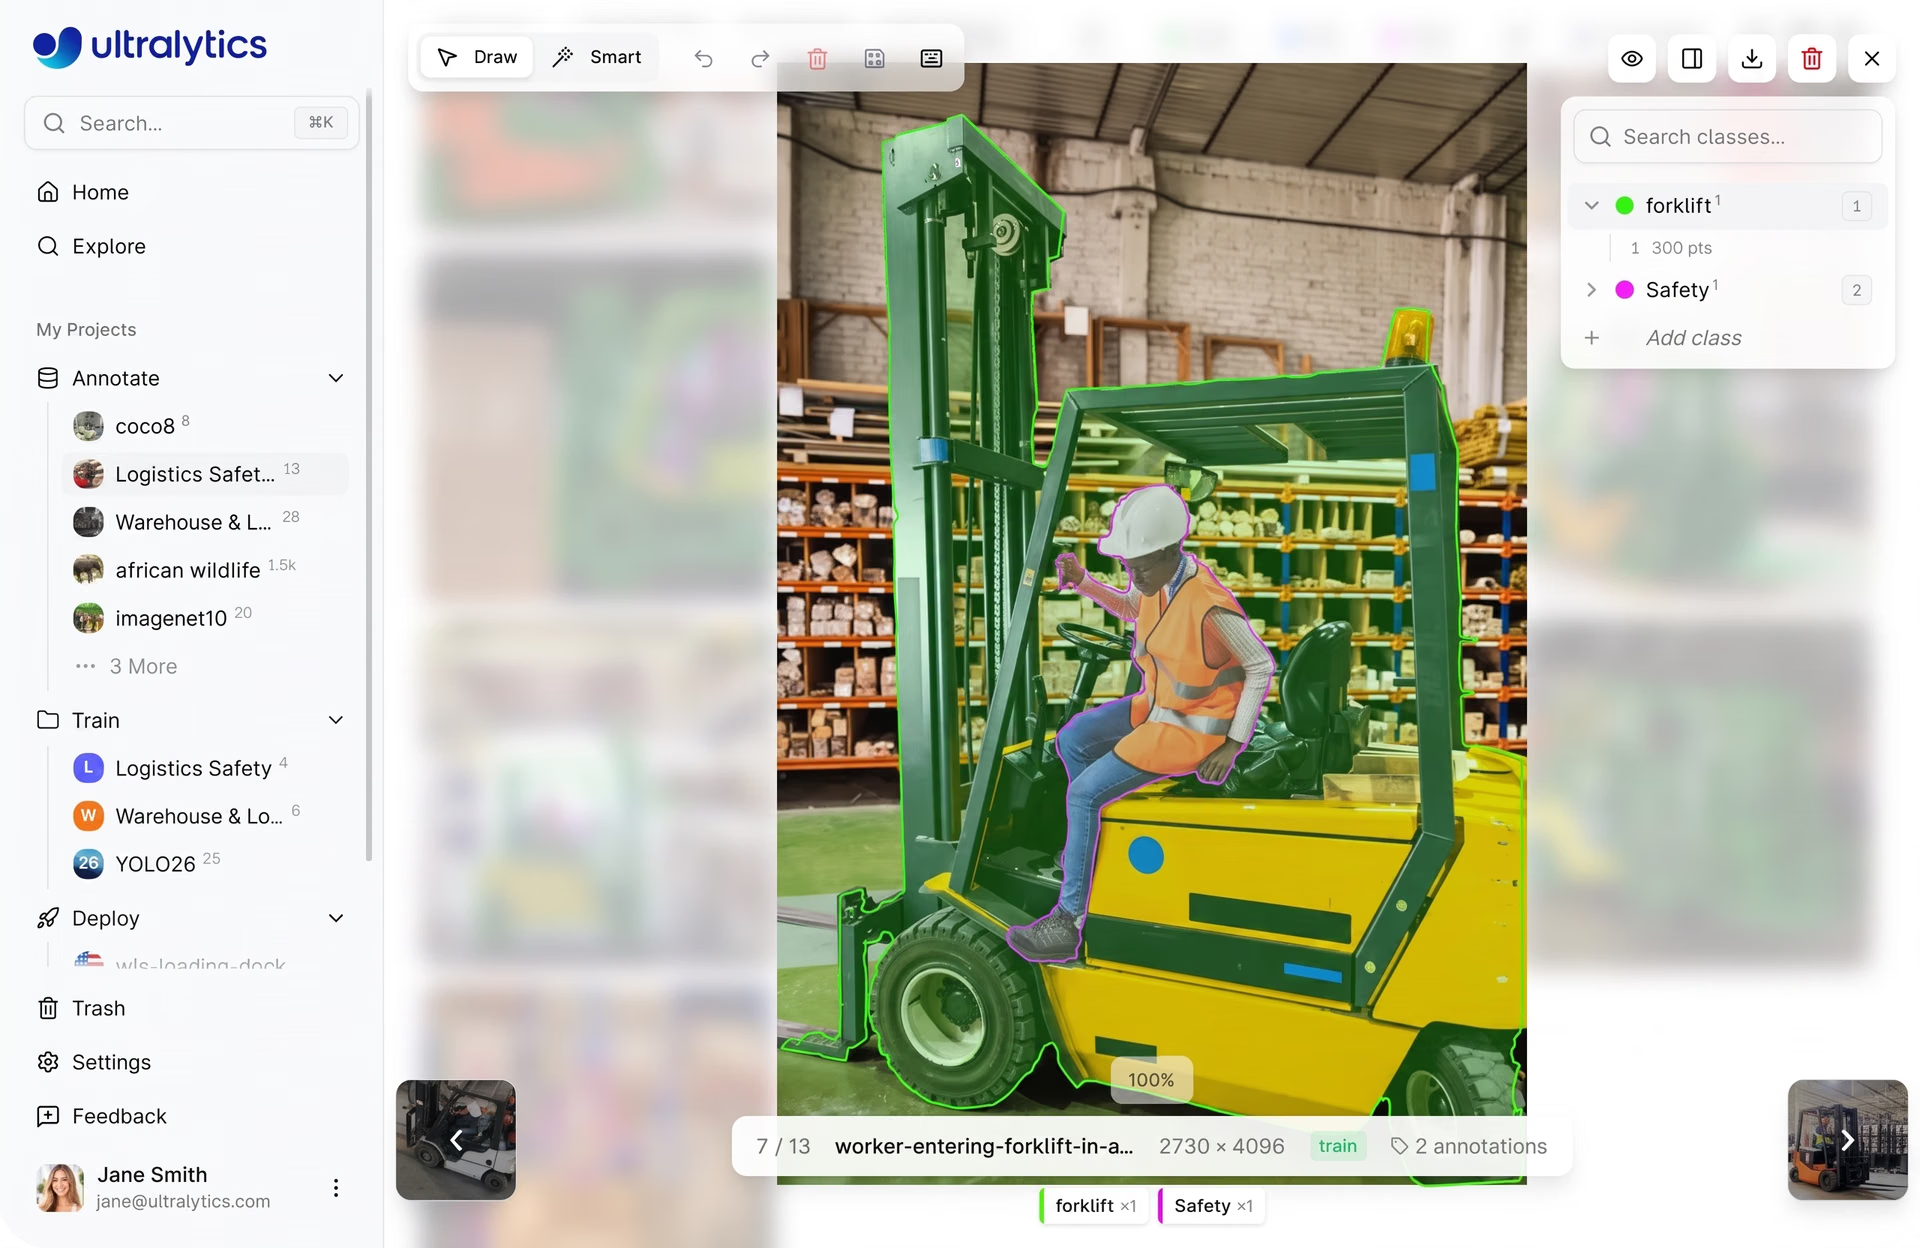
Fig. 2. Uso da Ultralytics Platform para rotulagem de dados (Fonte)
As anotações podem ser criadas manualmente com essas ferramentas ou agilizadas com recursos assistidos por IA, como a anotação inteligente baseada em SAM. Com o SAM, você pode gerar máscaras, caixas delimitadoras ou caixas orientadas interagindo com a imagem, o que ajuda a acelerar o processo de rotulagem sem comprometer a precisão.
Análise da qualidade dos conjuntos de dados com a Ultralytics Platform#
Além de preparar e anotar os dados, entender a qualidade do conjunto de dados é essencial para criar modelos de visão computacional confiáveis. Sem uma visão clara de fatores como distribuição de classes, qualidade das anotações, divisões do conjunto de dados e representação dos dados em diferentes condições, pode ser difícil identificar problemas que afetam o desempenho do modelo.
A Ultralytics Platform inclui recursos integrados que ajudam a analisar conjuntos de dados com mais eficiência. Esses insights estão disponíveis diretamente na interface do conjunto de dados, em abas como Imagens, Classes e Gráficos.
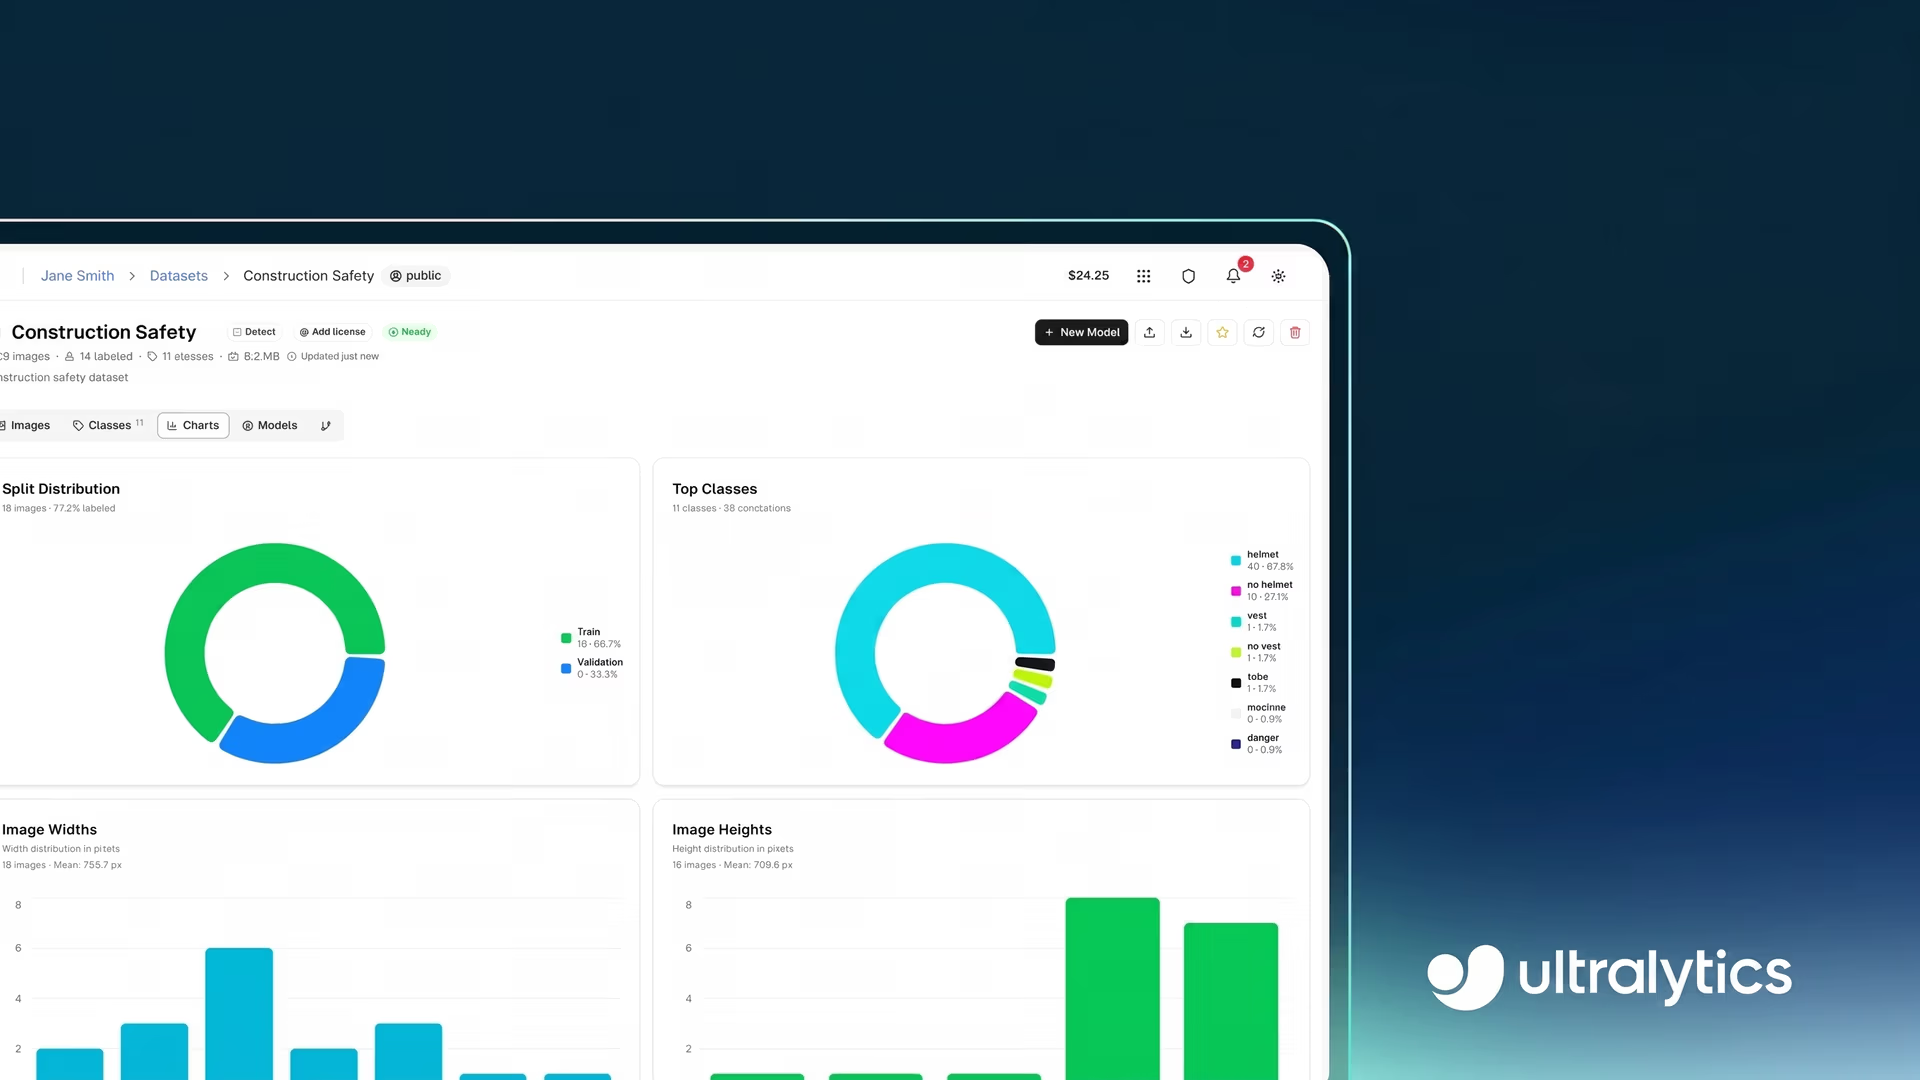
Na aba Gráficos, você pode ver estatísticas do conjunto de dados, como a distribuição entre os conjuntos de treinamento, validação e teste, a frequência das classes e mapas de calor das anotações que mostram onde os objetos aparecem nas imagens.
A aba Classes apresenta a quantidade de anotações por classe, facilitando a identificação de desequilíbrios entre classes. Já a aba Imagens mostra detalhes de cada imagem, como dimensões, quantidade de anotações e distribuição dos rótulos entre imagens individuais.
Esses insights facilitam a identificação de problemas como desequilíbrios entre classes, cenários ausentes ou distribuição irregular dos dados. Por exemplo, você pode perceber que certas classes têm pouquíssimos exemplos ou que a maioria das anotações está concentrada em áreas específicas de uma imagem.
Além da análise de dados, a plataforma oferece suporte à curadoria e ao aumento de dados, ou seja, ao refinamento dos conjuntos de dados por meio da correção ou remoção de dados problemáticos e da criação de variações de dados existentes para melhorar o desempenho do modelo. Essas melhorias podem ser feitas diretamente na plataforma atualizando anotações, adicionando novos dados ou reorganizando as divisões do conjunto de dados com base nos insights da análise.
Exportação de conjuntos de dados da Ultralytics Platform#
Depois que um conjunto de dados é preparado e validado, ele pode ser exportado para uso em diferentes ambientes. Isso permite usar seus dados de visão computacional onde preferir, seja para treinar modelos localmente, na nuvem ou em outras ferramentas e fluxos de trabalho.
A Ultralytics Platform exporta conjuntos de dados como arquivos Ultralytics NDJSON, um formato que pode ser usado diretamente para treinar com o pacote Python da Ultralytics e reimportado para a plataforma, facilitando a integração dos conjuntos de dados a diferentes fluxos de trabalho e ferramentas de treinamento.
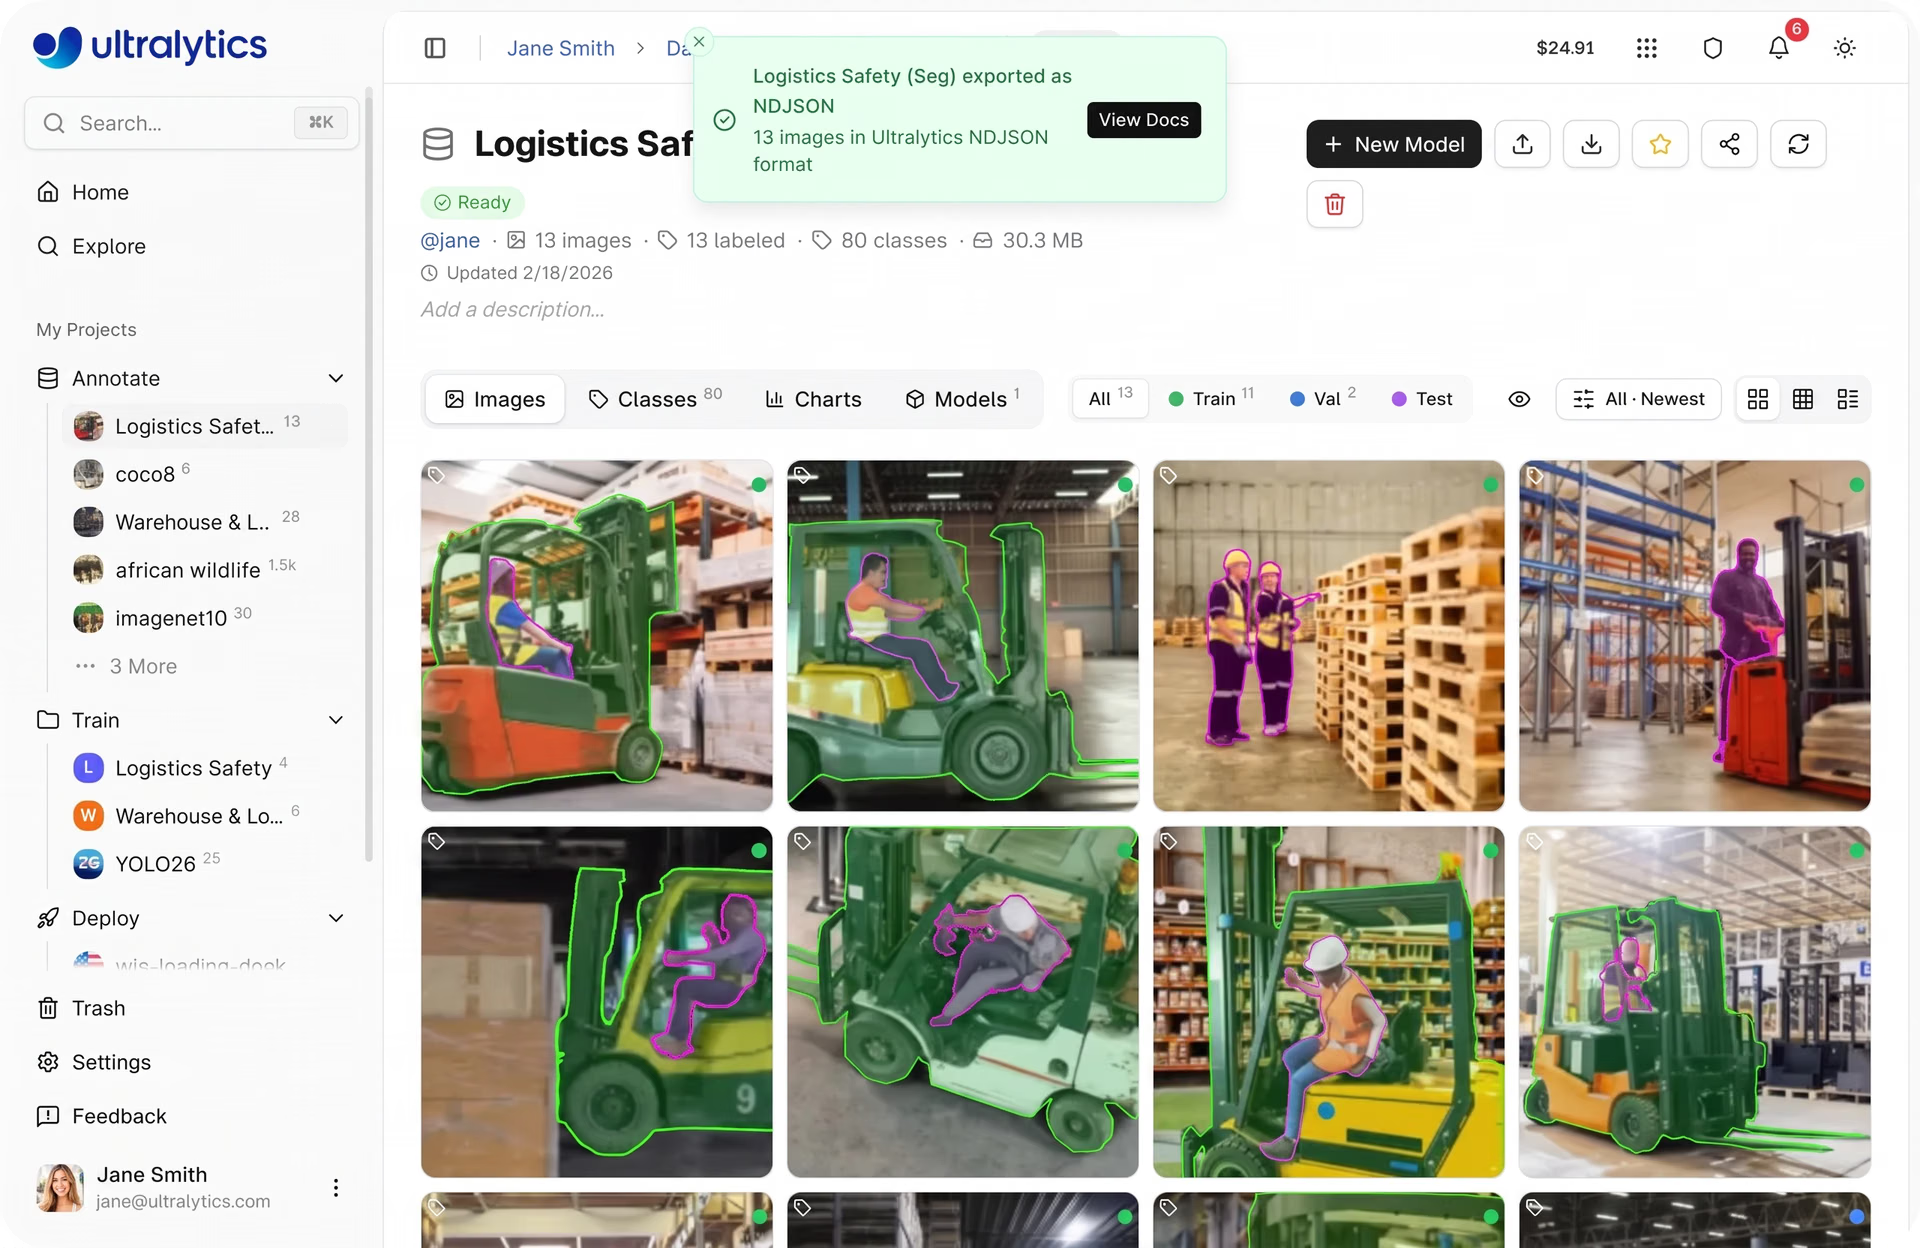
Fig. 3. Exportação de um conjunto de dados da Ultralytics Platform (Fonte)
A exportação de um conjunto de dados cria uma captura imutável dos dados em um momento específico, incluindo imagens, anotações e estrutura. Isso é útil porque os conjuntos de dados costumam mudar à medida que novos dados são adicionados, as anotações são atualizadas ou as divisões são ajustadas. Ao exportar uma captura, você preserva a versão exata do conjunto de dados usada em uma execução específica de treinamento.
Isso facilita a reprodução de resultados mais tarde, pois você pode treinar um modelo novamente com a mesma configuração de dados e comparar o desempenho entre diferentes versões do conjunto de dados. Por exemplo, você pode avaliar se adicionar novas imagens ou corrigir anotações realmente melhora a precisão do modelo, em vez de tentar adivinhar o que mudou.
Os conjuntos de dados exportados podem ser baixados e usados em ambientes de treinamento locais, na nuvem ou offline.
Melhoria da qualidade dos conjuntos de dados por meio de iterações na Ultralytics Platform#
Nos fluxos de trabalho de aprendizado de máquina e aprendizado profundo, o gerenciamento dos conjuntos de dados continua mesmo após a implantação, pois os dados do mundo real costumam ser diferentes dos dados usados durante o treinamento.
À medida que os modelos recebem novas entradas, as lacunas no conjunto de dados — como a ausência de condições de pouca luz, diferentes ângulos de câmera, oclusões ou cenas lotadas — e os erros de anotação ficam mais evidentes, tornando necessário refinar os dados ao longo do tempo.
Há várias maneiras de melhorar um conjunto de dados. Você pode adicionar novas imagens ou vídeos para abranger condições ausentes, como ambientes com pouca luz, diferentes ângulos de câmera, oclusões ou cenas lotadas, ajudando a reduzir pontos cegos nos dados.
Ao mesmo tempo, garantir que as anotações sejam precisas e consistentes — por exemplo, com objetos rotulados corretamente e caixas delimitadoras ou máscaras precisas — ajuda o modelo a aprender padrões mais confiáveis.
Normalmente, isso segue um ciclo simples: treinar o modelo, avaliar os resultados, identificar erros, aprimorar o conjunto de dados e retreinar o modelo. Cada etapa ajuda a revelar problemas como anotações incorretas, dados ausentes ou casos sub-representados.
Imagine que você esteja trabalhando em um sistema de monitoramento de prateleiras de varejo em tempo real, usado para detectar produtos nas lojas. As primeiras versões do conjunto de dados talvez não incluam certos tipos de produtos, condições de iluminação ou configurações de prateleiras lotadas. Durante a avaliação, você pode perceber que o modelo tem dificuldade para detectar itens nessas situações.
Para melhorar o desempenho, você pode coletar novas imagens que abranjam esses cenários ausentes e atualizar as anotações quando necessário. Com o tempo, repetir esse processo ajuda o modelo a se tornar mais preciso e confiável em condições reais.
A Ultralytics Platform oferece suporte a esse fluxo de trabalho conectando atualizações de conjuntos de dados ao treinamento e à avaliação. Com o acompanhamento integrado de experimentos e as métricas de desempenho, fica mais fácil monitorar o progresso e aprimorar continuamente os conjuntos de dados.
Acompanhamento de alterações nos conjuntos de dados com a Ultralytics Platform#
Falamos brevemente sobre como os conjuntos de dados evoluem ao longo do tempo como parte do processo de desenvolvimento do modelo. À medida que novos dados são adicionados, as anotações são refinadas e as classes são atualizadas, acompanhar essas alterações se torna essencial para manter a qualidade dos dados e garantir um desempenho consistente do modelo.
Veja alguns dos principais recursos da Ultralytics Platform que ajudam a acompanhar conjuntos de dados e controlar versões:
- Versionamento de conjuntos de dados: Você pode criar versões fixas dos conjuntos de dados como capturas em NDJSON. Cada versão registra detalhes importantes, como a quantidade de imagens, classes e anotações, além do tamanho do conjunto de dados em um momento específico. Essas versões ficam armazenadas e podem ser baixadas mais tarde, facilitando a reprodução de experimentos e a comparação de resultados entre diferentes estados do conjunto de dados.
- Aba Versões: Todas as versões dos conjuntos de dados são organizadas na aba Versões, onde você pode consultar o histórico de versões, adicionar descrições às alterações e acompanhar a evolução do conjunto de dados ao longo do tempo.
- Vinculação a modelos: A aba Modelos mostra todos os modelos treinados com um conjunto de dados, incluindo métricas como mAP e detalhes do treinamento. As versões dos conjuntos de dados são vinculadas às execuções de treinamento, ajudando você a entender como as alterações nos dados afetam o desempenho do modelo.
- Aba Erros: A aba Erros destaca os arquivos cujo processamento falhou, junto com os detalhes do erro e sugestões. Isso permite identificar e corrigir problemas, como arquivos corrompidos ou formatos não compatíveis, antes do treinamento.
- Interface do conjunto de dados (abas Imagens e Classes): Essas visualizações permitem navegar pelas imagens, revisar anotações, gerenciar rótulos de classe e analisar a distribuição das classes. Recursos como filtragem, ordenação e identificação de imagens sem anotações facilitam o monitoramento da qualidade do conjunto de dados ao longo do tempo.
- Estatísticas e gráficos: Visualizações de dados integradas, como a distribuição entre divisões, a frequência das classes e os mapas de calor das anotações, ajudam a acompanhar alterações na distribuição dos dados e identificar desequilíbrios à medida que o conjunto de dados evolui.
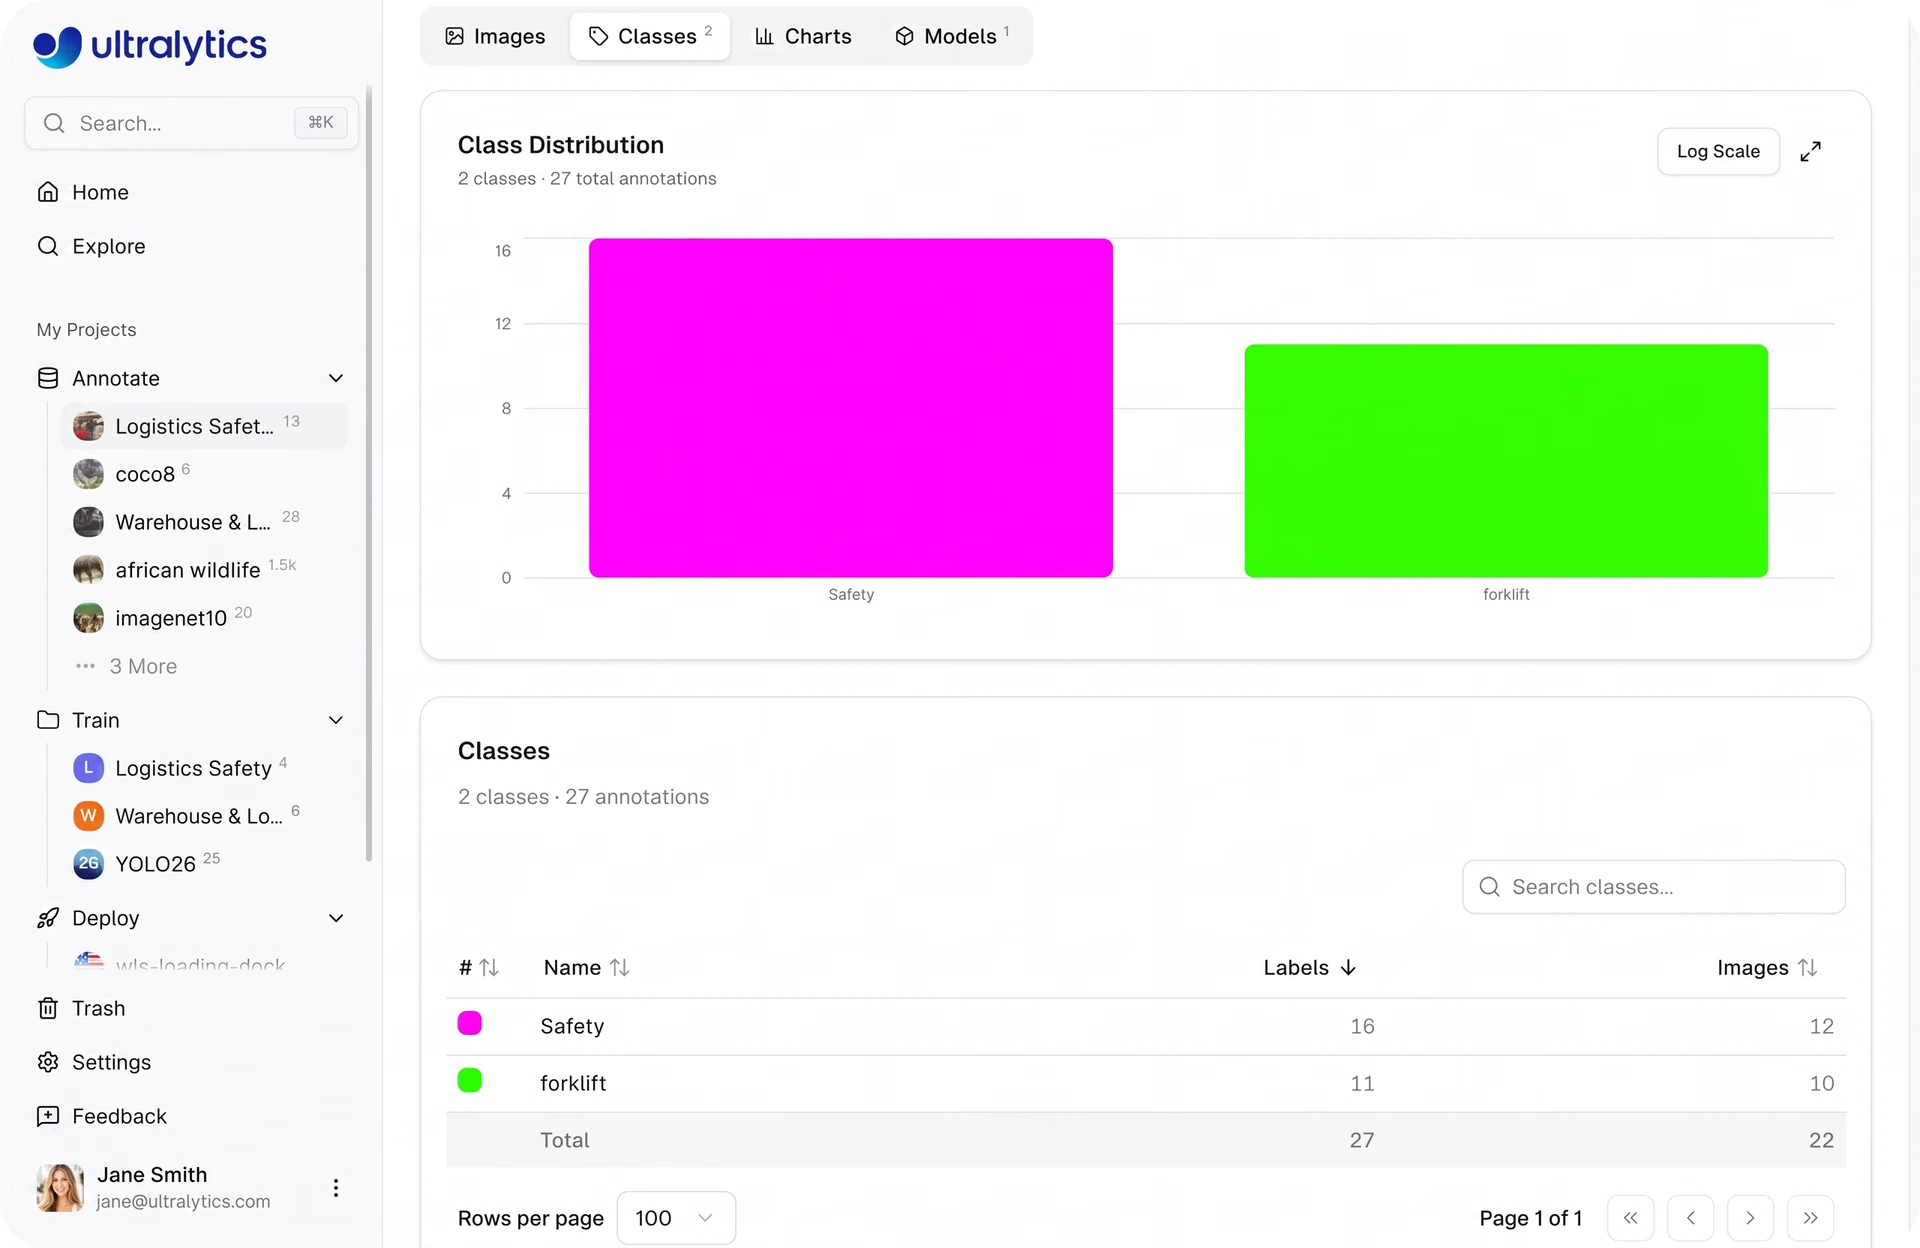
Fig. 4. Exemplo de análise da distribuição de classes de um conjunto de dados na Ultralytics Platform (Fonte)
Conexão entre conjuntos de dados, treinamento e implantação na Ultralytics Platform#
A Ultralytics Platform conecta diferentes etapas do desenvolvimento de modelos de IA em um único pipeline. Isso simplifica o processo de transformação de dados brutos em aplicações de IA de visão prontas para produção.
Depois de preparados e anotados, os conjuntos de dados podem ser usados para treinar modelos de visão computacional, como o Ultralytics YOLO26, diretamente na plataforma. Durante o treinamento, você pode monitorar métricas de desempenho, acompanhar experimentos e avaliar o aprendizado do modelo usando painéis integrados.
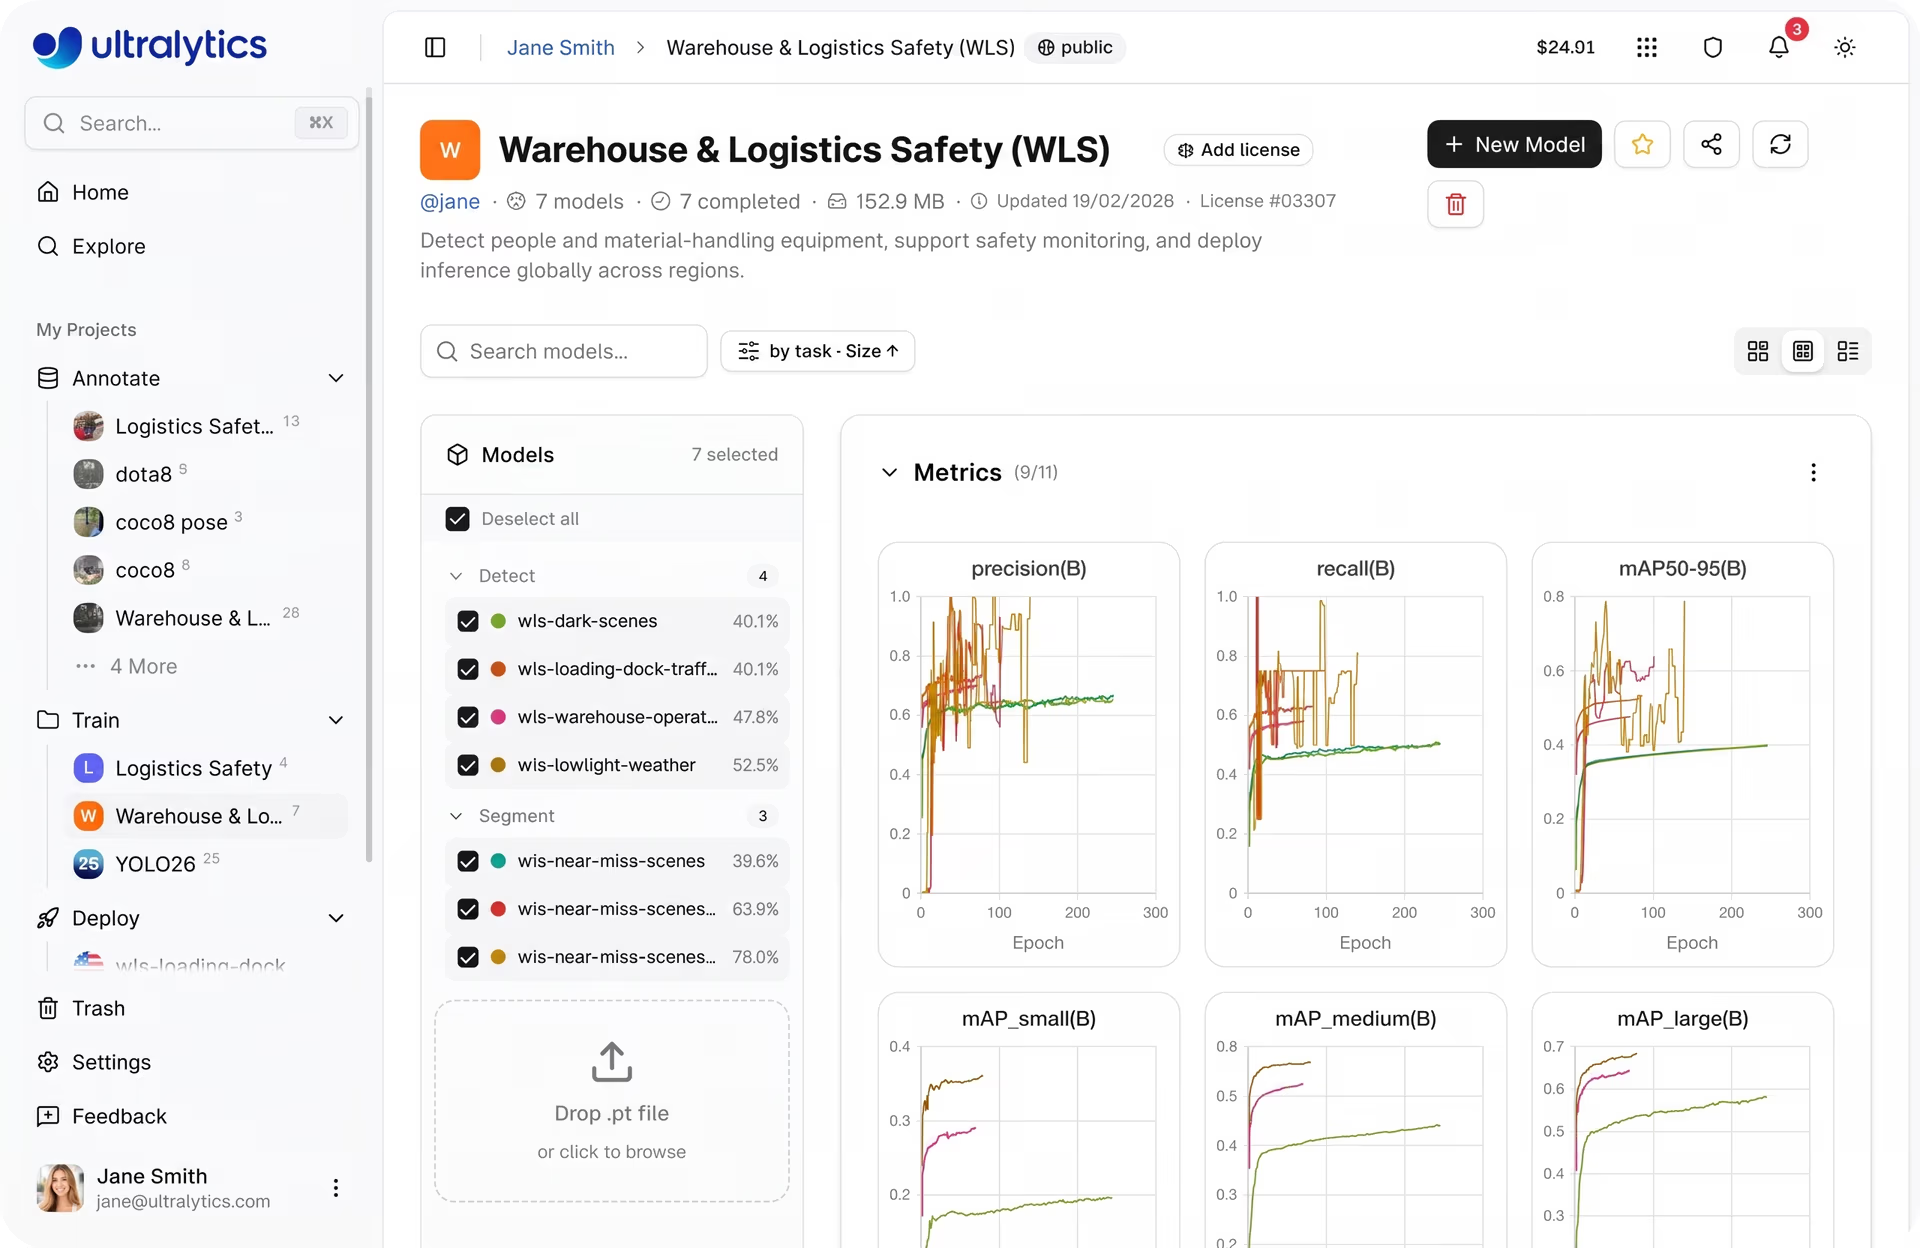
Fig. 5. Visão geral da visualização das métricas de treinamento do modelo na Ultralytics Platform (Fonte)
Após o treinamento, os modelos podem ser testados em novas imagens diretamente no navegador para avaliar previsões e identificar pontos a melhorar antes da implantação. Quando o desempenho do modelo é satisfatório, ele pode ser implantado em produção.
A plataforma oferece suporte à exportação de modelos para vários formatos ou à implantação deles por meio de serviços de inferência e endpoints dedicados, permitindo que sejam executados em diferentes ambientes.
Após a implantação, as ferramentas integradas de monitoramento ajudam a acompanhar o desempenho do sistema ao longo do tempo, incluindo métricas relacionadas ao uso e ao comportamento do modelo. Isso facilita a manutenção e a melhoria de sistemas de IA de visão em aplicações do mundo real.
Práticas recomendadas para gerenciar conjuntos de dados com a Ultralytics Platform#
Veja alguns fatores importantes a considerar ao gerenciar seus conjuntos de dados com a Ultralytics Platform:
- Use filtros para encontrar lacunas: Identifique dados sem rótulos ou sub-representados usando ferramentas de filtragem, facilitando a conclusão das anotações e melhorando a cobertura.
- Corrige os erros logo no início: usa a aba Errors para controlar a qualidade e identificar falhas no carregamento, ficheiros corrompidos ou formatos não suportados antes do treino.
- Atualiza os conjuntos de dados continuamente: adiciona novos dados, corrige anotações e inclui casos extremos à medida que surgem. Isto ajuda a melhorar a cobertura e garante que os modelos tenham um desempenho fiável em situações reais.
- Gere cuidadosamente as divisões dos conjuntos de dados: garante um bom equilíbrio entre os conjuntos de treino, validação e teste. Podes reorganizar as divisões manualmente ou usar a redistribuição automática quando necessário.
Para saber mais sobre a Ultralytics Platform, confira a documentação oficial da Ultralytics Platform.
Principais conclusões#
À medida que os projetos de visão computacional crescem, gerir os conjuntos de dados de forma eficaz torna-se tão importante como desenvolver modelos. Uma abordagem estruturada à gestão de conjuntos de dados ajuda a melhorar a qualidade dos dados, simplificar os fluxos de trabalho e favorecer um melhor desempenho dos modelos ao longo do tempo.
A Ultralytics Platform simplifica este processo ao reunir a gestão de conjuntos de dados, o treino e a implementação num único fluxo de trabalho. Com uma abordagem estruturada à gestão de conjuntos de dados, as equipas podem reduzir a complexidade, aumentar a eficiência e criar sistemas de visão computacional mais escaláveis e fiáveis.
Junta-te à nossa crescente comunidade e explora o nosso repositório do GitHub para acederes a recursos de IA. Para começares hoje a desenvolver com IA visual, consulta as nossas opções de licenciamento. Descobre como a IA na agricultura está a transformar a agricultura e como a IA visual na área da saúde está a moldar o futuro, visitando as nossas páginas de soluções.
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









