Como a Ultralytics Platform simplifica a implementação de modelos de visão computacional
Veja como a Ultralytics Platform reúne tudo o que é necessário para a implementação de modelos de visão computacional, desde os testes até às API prontas para produção.
A Ultralytics trabalha com a comunidade de visão computacional há anos, criando modelos e ferramentas que tornam a IA de visão mais acessível a todos. Com a Ultralytics Platform, estamos a levar esse trabalho mais longe ao reunir todo o fluxo de desenvolvimento de visão computacional num ambiente unificado, desde a gestão e anotação de conjuntos de dados até ao treino, validação e implementação de modelos.
Em particular, estamos entusiasmados por tornar mais fácil a implementação de modelos de visão computacional. À medida que a visão computacional continua a chegar a aplicações do mundo real, analisar imagens e vídeos fora de ambientes controlados continua a ser complexo.
Ao contrário dos ambientes de teste, onde as condições são previsíveis, os cenários do mundo real envolvem iluminação variável, entradas diferentes e cargas de trabalho imprevisíveis, tornando a implementação uma das partes mais desafiantes do fluxo de trabalho de visão.
A implementação envolve mais do que simplesmente disponibilizar um modelo para utilização. É necessário configurar processos capazes de lidar com dados do mundo real e garantir que tudo funciona corretamente à medida que a utilização e a escala dos projetos aumentam.
As equipas também precisam de acompanhar o desempenho e manter a fiabilidade ao longo do tempo. Isto implica muitas vezes alternar entre diferentes ferramentas de IA para testes, integração, implementação e monitorização, o que pode atrasar o desenvolvimento de modelos e acrescentar complexidade desnecessária.
Os fluxos de trabalho acabam por ficar fragmentados. A Ultralytics Platform unifica e simplifica este processo.
A plataforma oferece suporte integrado para disponibilização, testes e monitorização de modelos num único ambiente. As equipas podem validar modelos através de inferência no navegador, integrá-los em aplicações através de serviços de inferência partilhados e implementá-los em endpoints dedicados com funcionalidades de monitorização de desempenho.
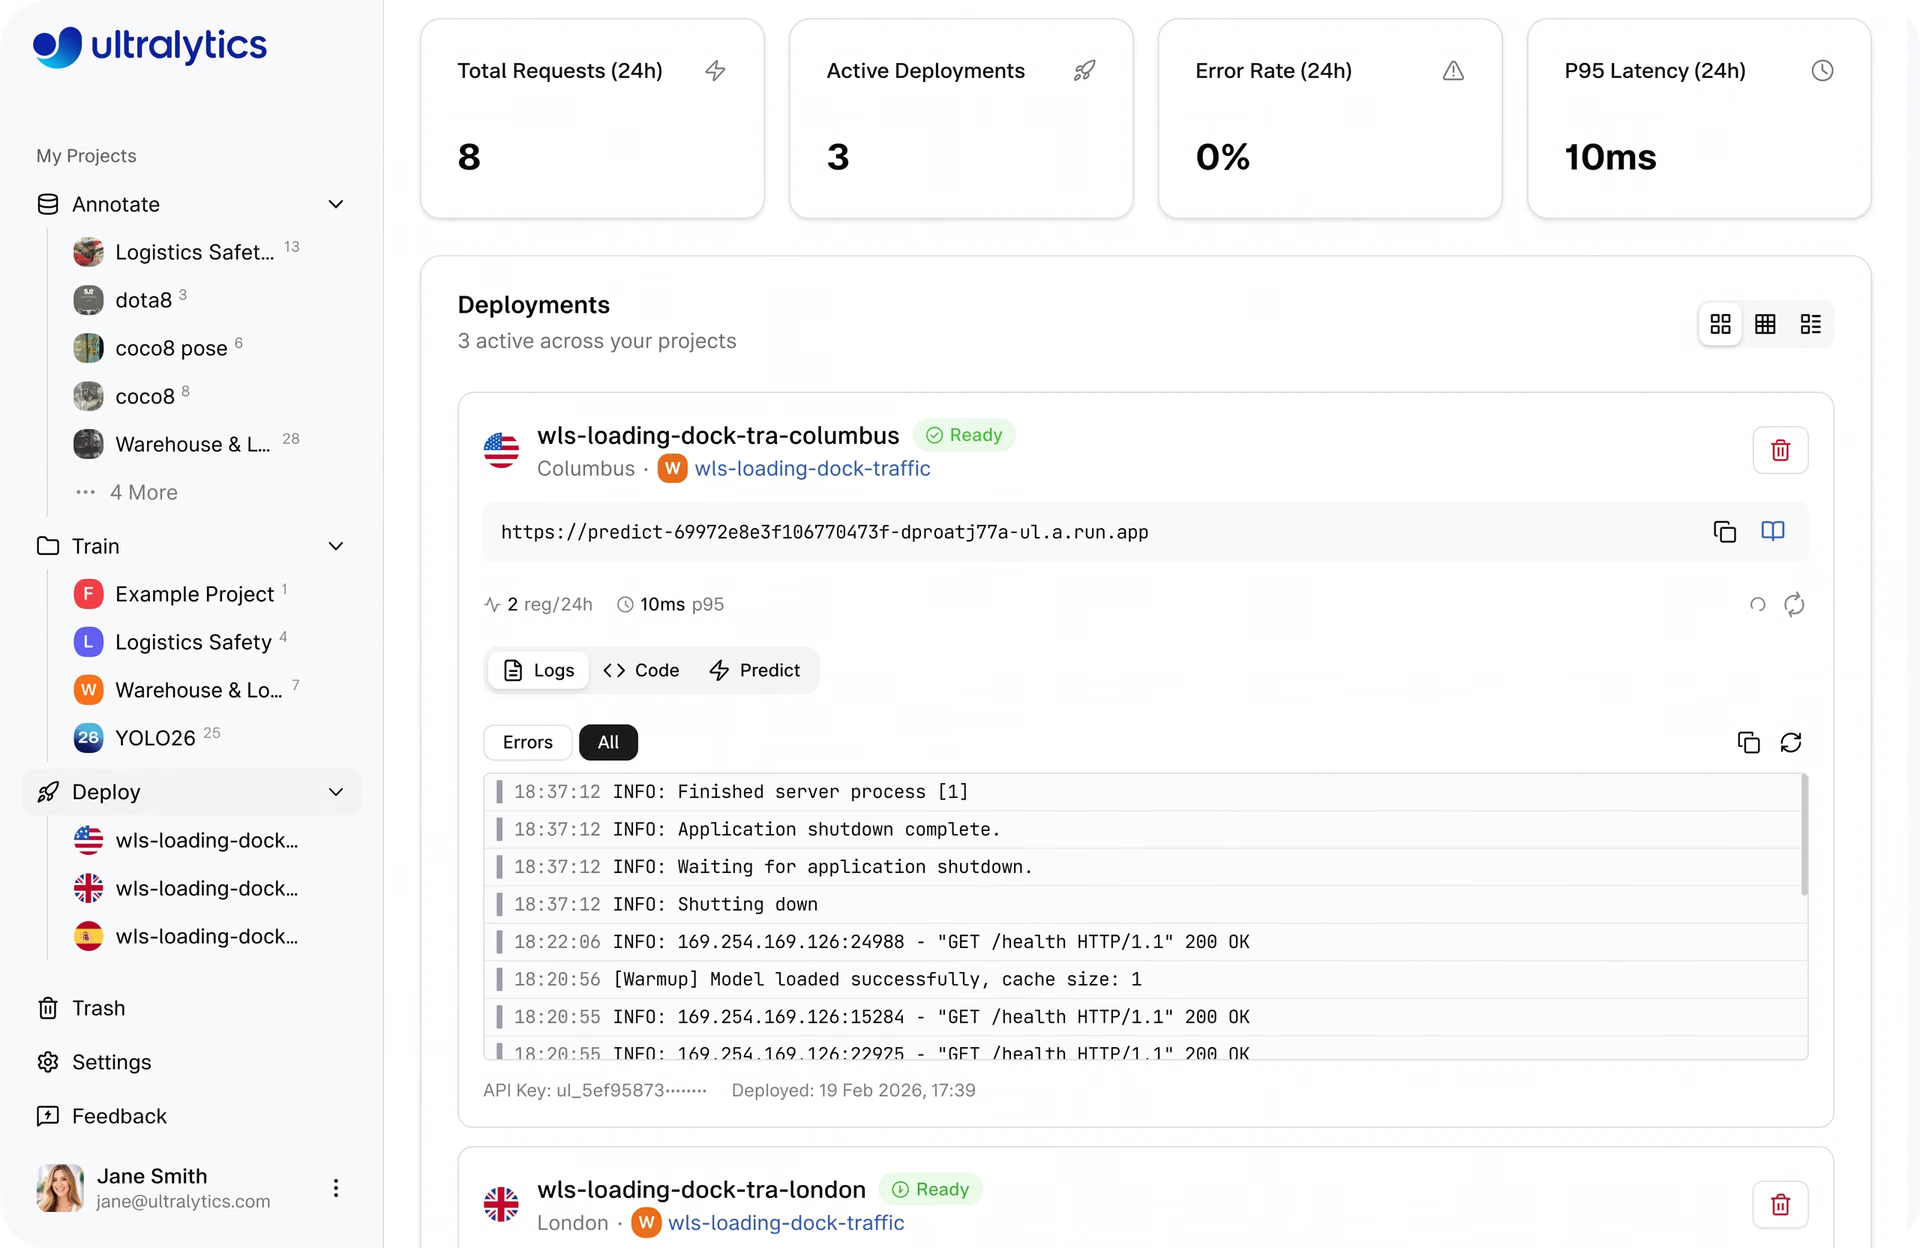
Fig. 1. Um olhar sobre a página de implementação na Ultralytics Platform (Fonte)
Neste artigo, vamos explorar como a Ultralytics Platform redefine a implementação de modelos de visão computacional, desde os testes e a integração até à implementação em produção e à monitorização. Vamos começar!
Uma visão geral da implementação de modelos de visão computacional#
Num ciclo de vida de machine learning, a implementação de modelos é a fase em que um modelo passa da experimentação para a utilização no mundo real. Para modelos de visão computacional desenvolvidos com deep learning e redes neuronais convolucionais, isto geralmente significa disponibilizá-los para processar imagens e vídeos em tempo real.
Depois de implementados, estes modelos recebem novos dados, que normalmente passam por etapas de pré-processamento, como redimensionamento, normalização ou formatação. Os dados processados são então enviados para o modelo, que aplica os padrões aprendidos durante o treino para gerar previsões de elevada precisão.
Dependendo do caso de utilização, isto pode incluir diferentes tarefas de visão computacional. Por exemplo, os modelos Ultralytics YOLO, como o Ultralytics YOLO26, suportam uma vasta gama de tarefas de visão, incluindo deteção de objetos, classificação de imagens, segmentação de instâncias, estimativa de pose e deteção de caixas delimitadoras orientadas (OBB).
Para tornar isto prático em aplicações do mundo real, os modelos precisam muitas vezes de ser integrados em sistemas capazes de processar eficientemente tanto o pré-processamento como a inferência. É aqui que a infraestrutura de implementação se torna essencial.
Em ambientes de produção, os modelos são normalmente acedidos através de REST APIs ou sistemas de disponibilização de modelos. Estas interfaces permitem que as aplicações enviem dados e recebam previsões de forma programática, facilitando a integração com aplicações externas, dispositivos IoT ou sistemas robóticos que dependem de compreensão visual em tempo real.
Limitações das ferramentas tradicionais de implementação de visão computacional#
A implementação de modelos de visão computacional pode parecer simples, mas, até agora, na prática tem sido bastante diferente. Considera uma configuração comum: os dados são primeiro captados por câmaras ou sensores, enviados para um modelo para inferência e depois devolvidos a uma aplicação como previsões.
Na realidade, cada uma destas etapas é frequentemente gerida por ferramentas e serviços separados. Um sistema pode tratar da captura de dados, outro gere a disponibilização do modelo, enquanto ferramentas adicionais são utilizadas para escalabilidade, monitorização e registo. Manter estes componentes ligados e a funcionar de forma fiável pode rapidamente tornar-se complexo.
À medida que a utilização cresce, esta complexidade aumenta. Gerir a infraestrutura, lidar com dependências e manter um desempenho consistente em todo o pipeline pode atrasar o desenvolvimento e dificultar a implementação de modelos de visão computacional em aplicações do mundo real.
A Ultralytics Platform reúne estes componentes num único ambiente unificado. Isto proporciona uma forma mais coesa de gerir todo o fluxo de trabalho de implementação, mantendo o desempenho e a fiabilidade em escala.
Opções de implementação de modelos disponibilizadas pela Ultralytics Platform#
Além de unificar o processo de implementação de modelos, a Ultralytics Platform também proporciona flexibilidade na forma como os modelos são implementados e utilizados.
Para suportar diferentes fases da implementação de modelos de visão computacional, a plataforma oferece quatro opções: testes no navegador com inferência instantânea, inferência partilhada através de APIs para desenvolvimento, endpoints dedicados para implementações de produção escaláveis em regiões globais e exportação de modelos para executar modelos em infraestruturas externas ou dispositivos edge.
Vamos então analisar mais detalhadamente como funciona cada uma destas opções.
Valida modelos rapidamente através do separador Predict#
Antes de passar um modelo para produção, é importante compreender o seu desempenho em dados novos e não vistos. A Ultralytics Platform inclui um separador Predict integrado que permite executar inferência diretamente no navegador, sem qualquer configuração, infraestrutura ou dependência.
O separador Predict torna a validação de modelos rápida e interativa. Podes carregar imagens, utilizar exemplos pré-carregados ou captar entradas com uma webcam, e a inferência é executada automaticamente assim que os dados são fornecidos.
Os resultados aparecem instantaneamente, com sobreposições visuais, pontuações de confiança e saídas detalhadas, proporcionando uma visão clara do comportamento do modelo.
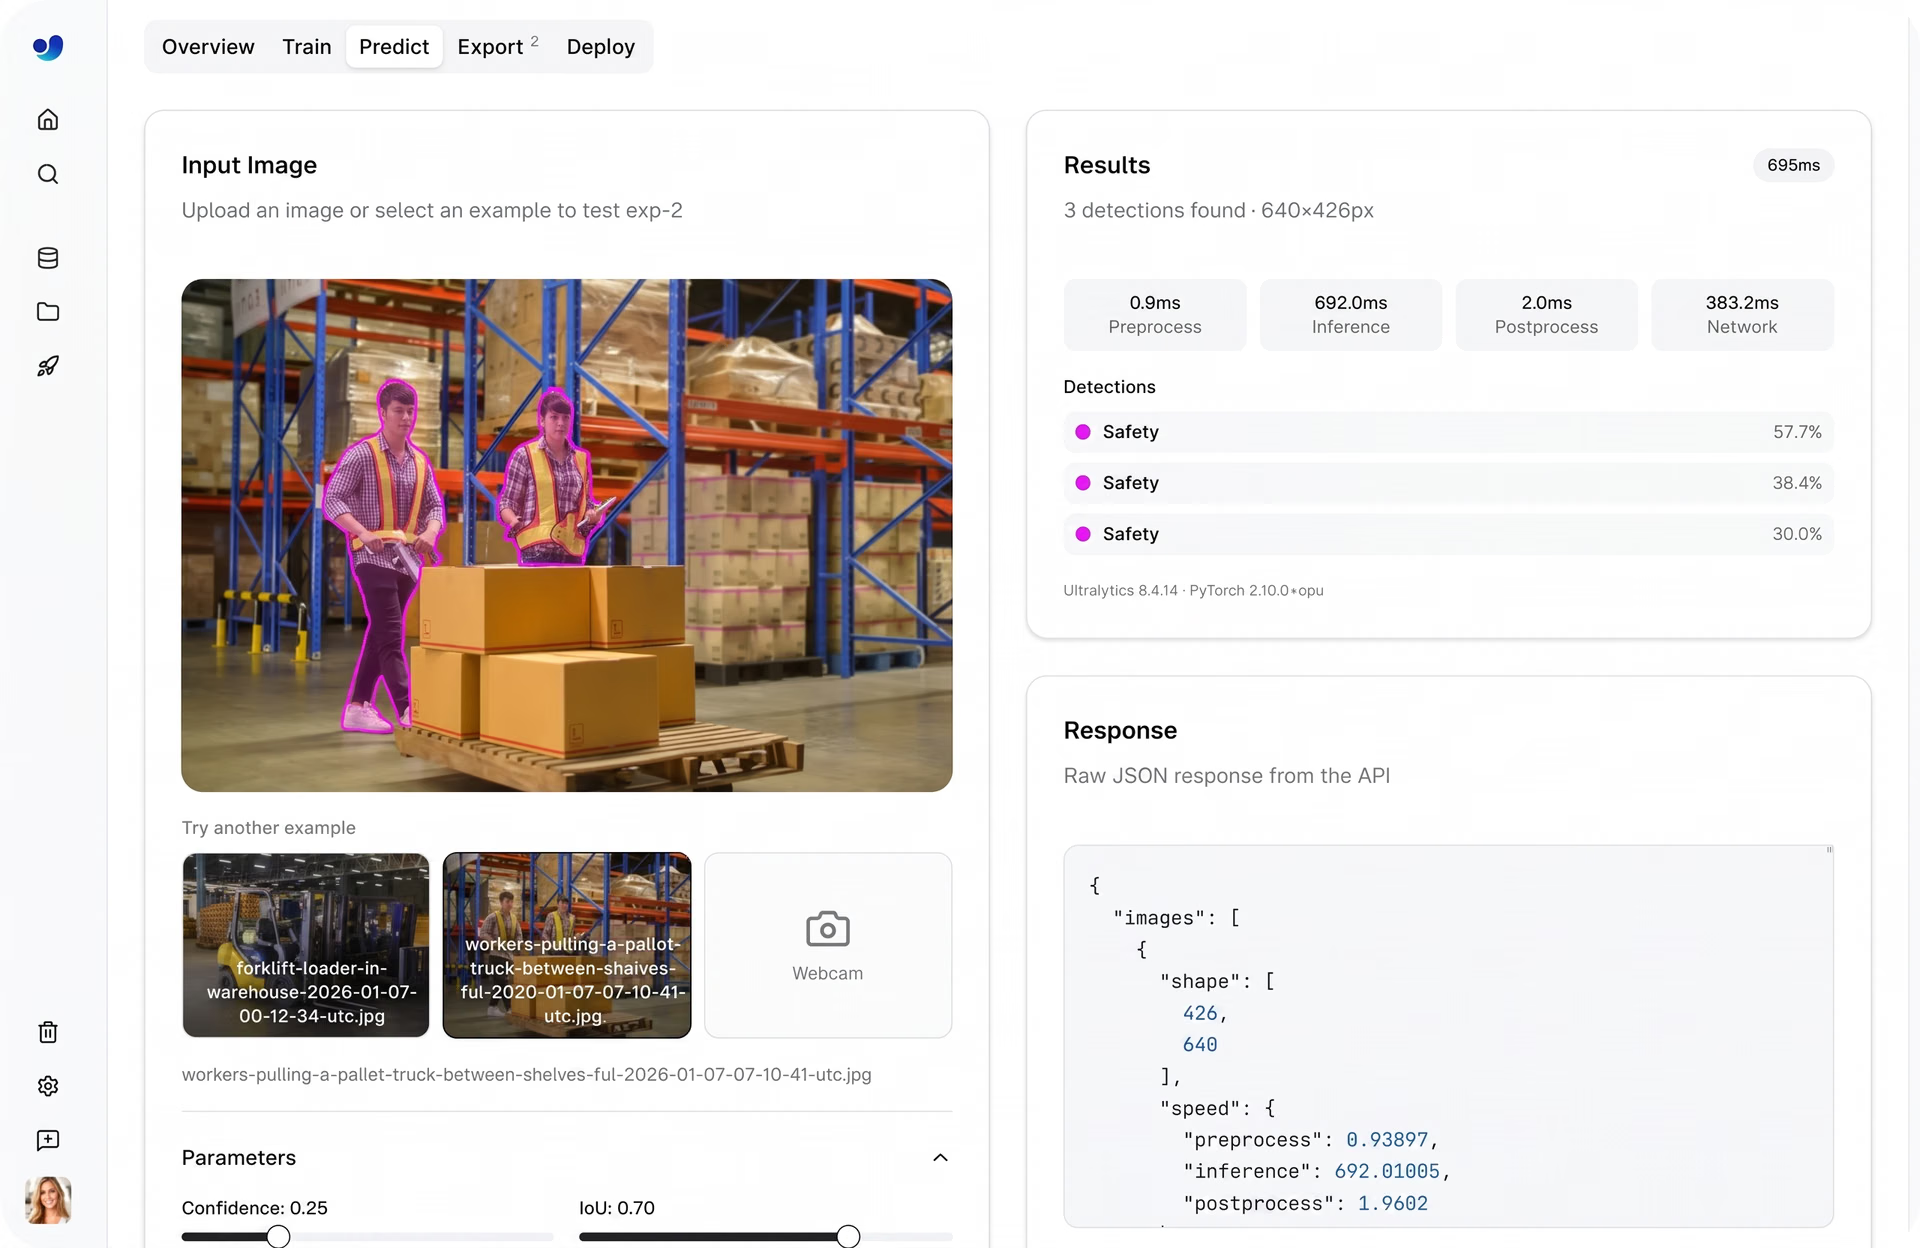
Fig. 2. Um exemplo de validação de um modelo através do separador Predict (Fonte)
Isto significa que, com apenas alguns cliques, podes testar diferentes entradas, ajustar parâmetros e avaliar o desempenho numa única interface antes de avançar para a implementação.
Execução de inferências partilhadas para testes ou utilização ligeira#
Imagina que treinaste um modelo e o validaste através do separador Predict. O passo seguinte consiste muitas vezes em começar a integrar esse modelo numa aplicação ou fluxo de trabalho.
Em vez de configurares uma infraestrutura ou gerires servidores, a Ultralytics Platform disponibiliza serviços de inferência partilhados que permitem enviar dados para o teu modelo e receber previsões através de REST APIs simples.
Nos bastidores, a inferência partilhada é executada num sistema multi-inquilino distribuído por algumas regiões principais, onde os pedidos são encaminhados automaticamente para o serviço disponível mais próximo. Isto ajuda a manter um desempenho responsivo e permite que utilizadores em diferentes localizações acedam aos modelos de forma consistente.
Podes enviar entradas utilizando pedidos HTTP padrão e receber saídas estruturadas em resposta, o que facilita a ligação de modelos a aplicações, scripts ou fluxos de automação. Esta configuração é uma excelente opção para desenvolvimento, testes, integrações ou utilizações mais ligeiras antes de avançar para implementações de produção mais escaláveis.
Implementa modelos globalmente através de endpoints dedicados#
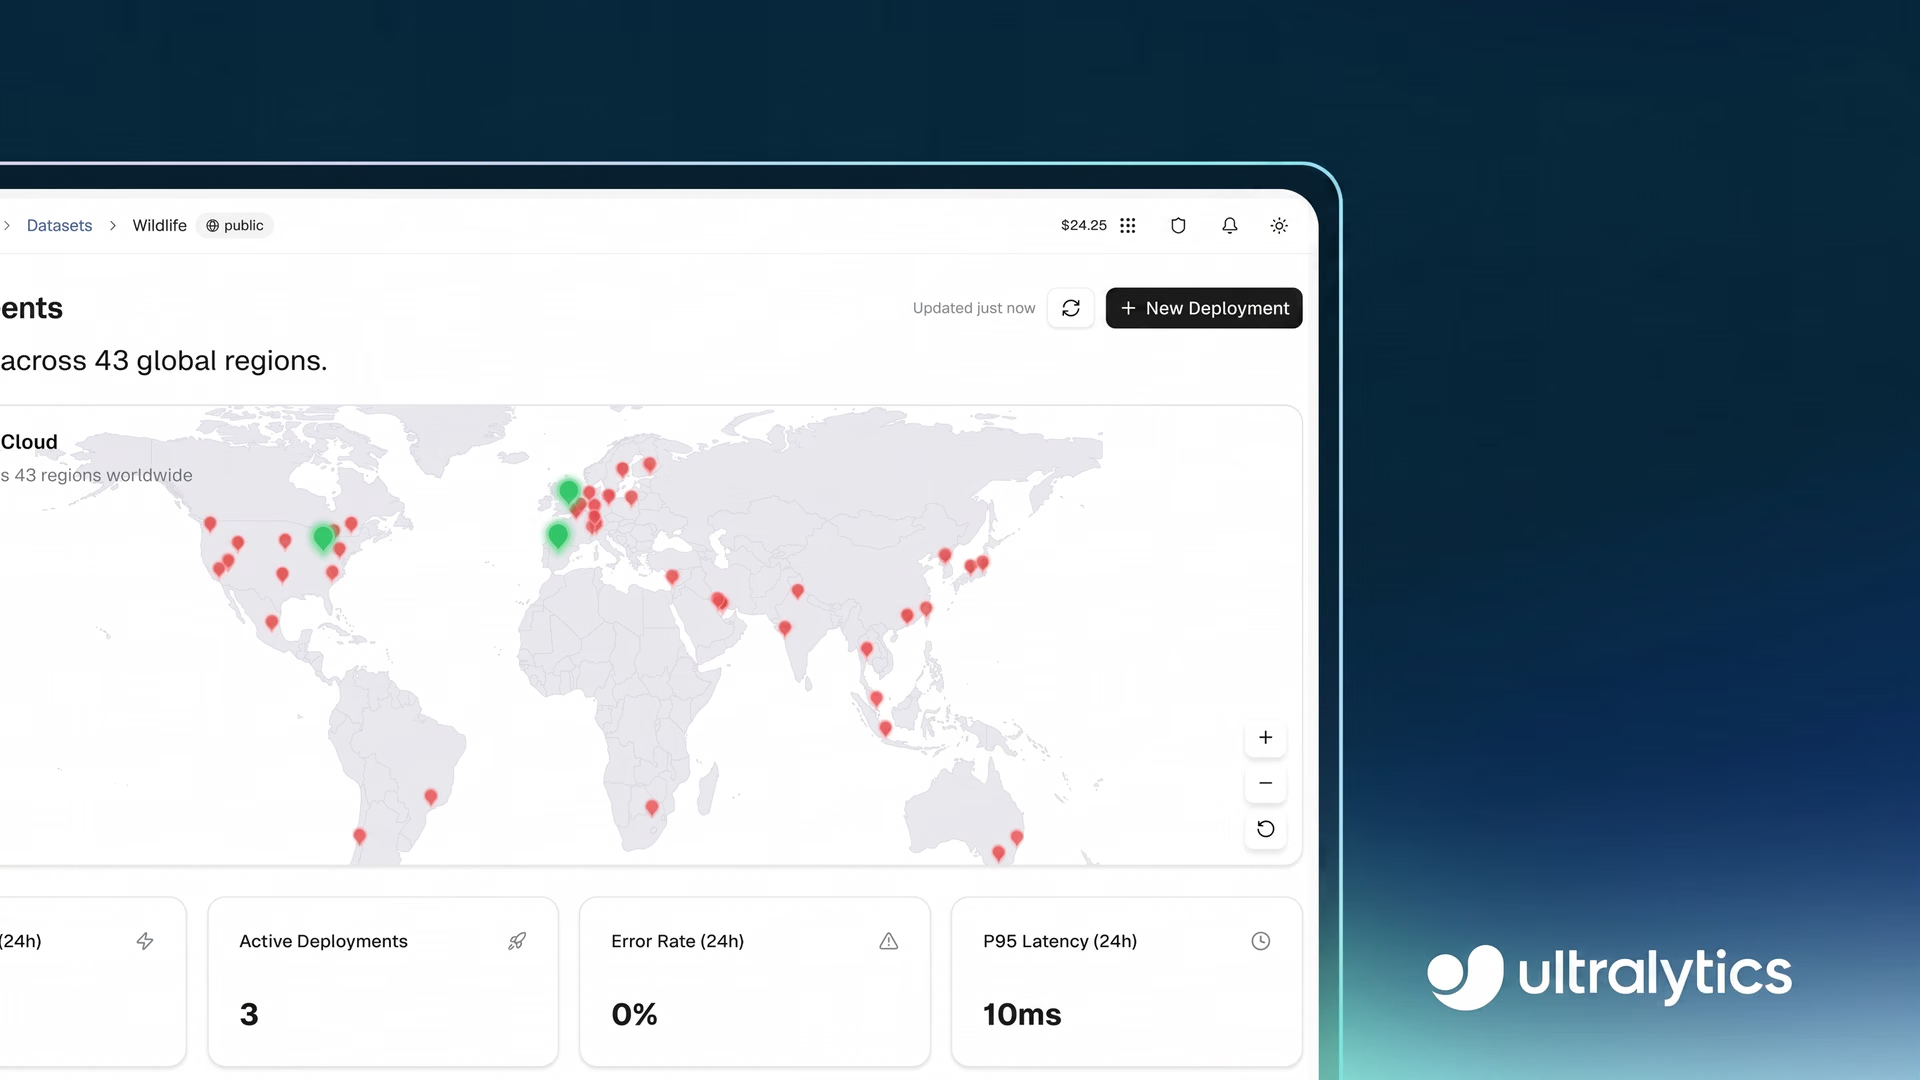
Quando um modelo está pronto para produção, precisa de lidar com o tráfego do mundo real de forma fiável e em escala. A Ultralytics Platform suporta isto através de endpoints dedicados, onde os modelos são executados como serviços de inquilino único em 43 regiões globais. Implementar os modelos mais perto dos utilizadores finais ajuda a reduzir a latência e a manter um desempenho consistente em diferentes localizações.
Cada endpoint é executado com os seus próprios recursos computacionais alocados e um URL exclusivo para pedidos de inferência. Este nível de controlo facilita o ajuste das implementações de acordo com as necessidades de desempenho, desde casos de utilização leves até aplicações mais exigentes e de elevado débito que necessitam de mais recursos computacionais.
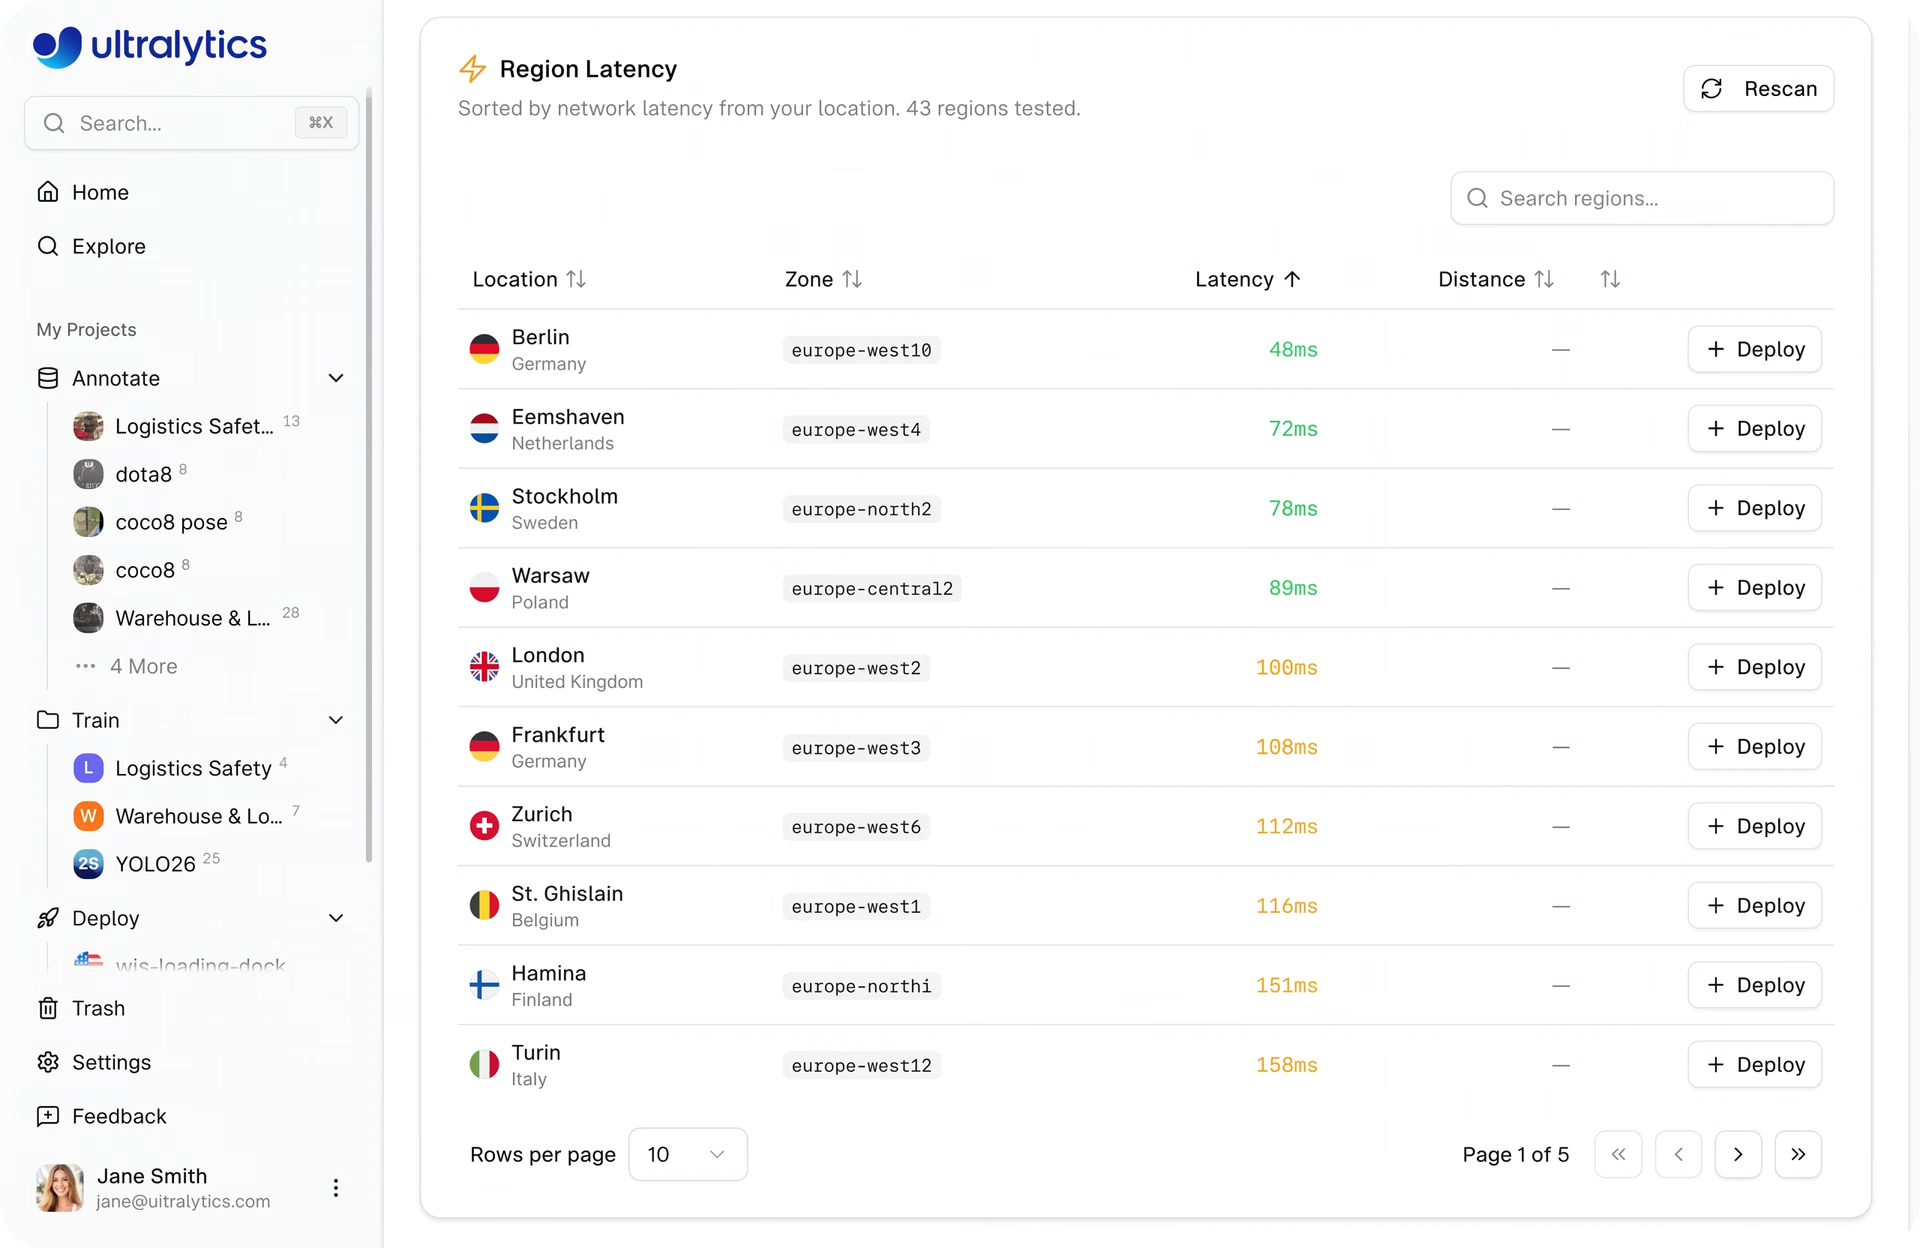
Fig. 3. Podes implementar modelos em 43 regiões globais através da Ultralytics Platform (Fonte)
No entanto, os endpoints dedicados foram concebidos para lidar autonomamente com cargas de trabalho variáveis, com escalabilidade automática que ajusta os recursos com base no tráfego recebido. Aumentam a escala durante períodos de elevada procura e reduzem-na quando a utilização diminui. Com a redução da escala para zero ativada por predefinição, os endpoints inativos são encerrados automaticamente e reiniciados quando chegam novos pedidos, ajudando a otimizar a utilização de recursos sem intervenção manual.
Exporta facilmente o teu modelo com a Ultralytics Platform#
Atualmente, a IA edge está a tornar-se cada vez mais essencial, à medida que mais aplicações dependem da execução de modelos diretamente em dispositivos como smartphones, câmaras e sistemas incorporados. Executar modelos localmente também pode ajudar a cumprir requisitos de privacidade de dados, uma vez que dados sensíveis, como imagens ou streams de vídeo, podem ser processados diretamente no dispositivo sem serem enviados para servidores externos.
Nestes cenários, os modelos precisam de ser executados fora da Ultralytics Platform, tornando a exportação de modelos uma parte crucial do processo de implementação. Os modelos Ultralytics YOLO são frequentemente treinados com Python e PyTorch e podem depois ser exportados para mais de 17 formatos diferentes, incluindo ONNX, TensorRT, CoreML e OpenVINO.
Esta vasta gama de formatos garante a compatibilidade com hardware diversificado, desde unidades de processamento gráfico (GPUs) de alto desempenho até dispositivos móveis e incorporados. Além disso, a exportação permite otimizar o desempenho para ambientes específicos.
Dependendo do formato, os modelos podem alcançar velocidades de inferência superiores, como um desempenho melhorado da GPU com TensorRT ou uma execução otimizada no CPU com ONNX e OpenVINO. Opções como a quantização FP16 e INT8 podem reduzir ainda mais o tamanho dos modelos e melhorar o débito, sendo especialmente úteis para implementações edge.
Na Ultralytics Platform, a exportação está integrada diretamente no fluxo de trabalho, permitindo gerar rapidamente modelos otimizados com apenas alguns cliques. As equipas podem passar do treino à execução de modelos em sistemas externos sem acrescentar sobrecarga adicional.
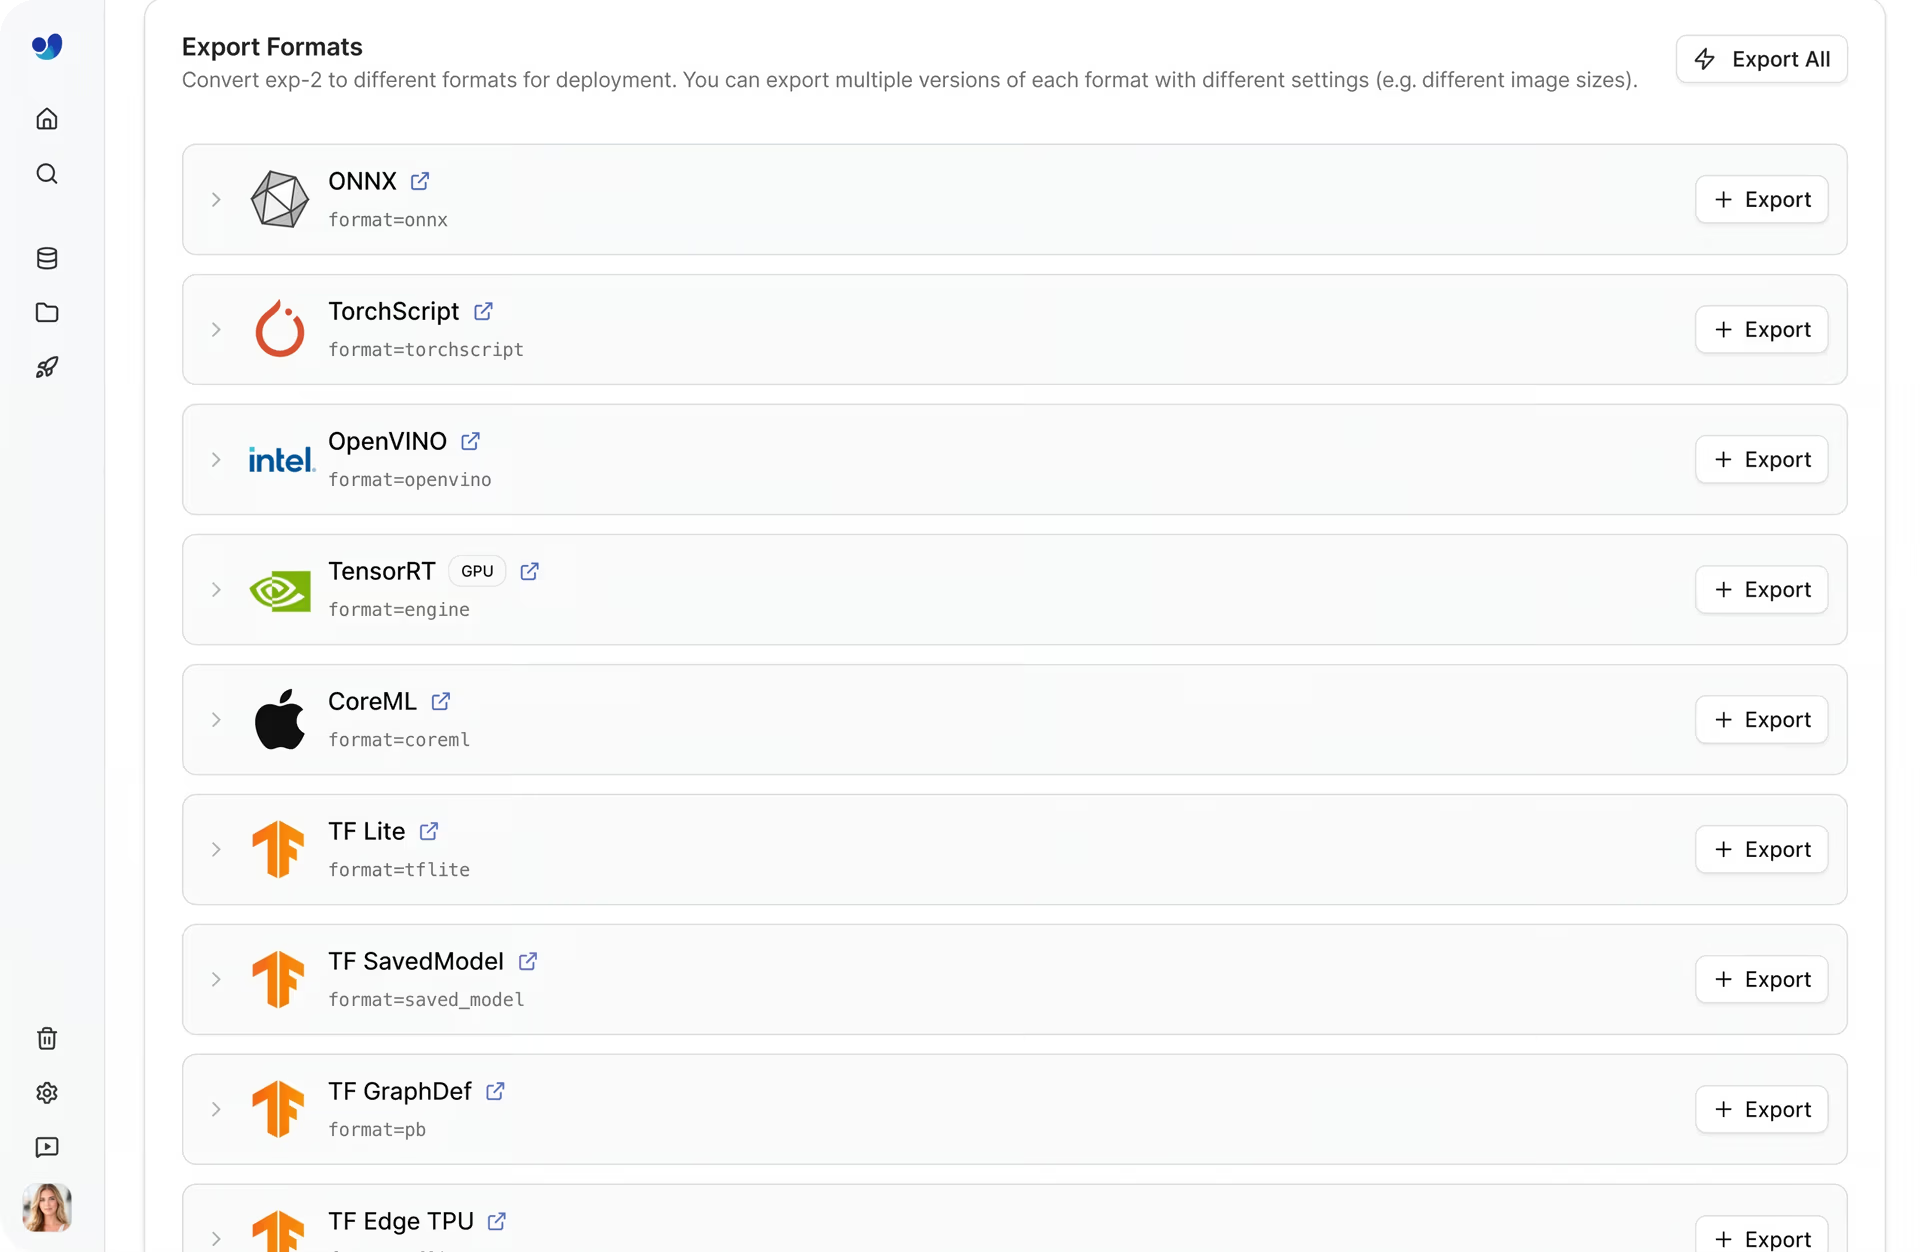
Fig. 4. Uma seleção de formatos de exportação na Ultralytics Platform.
Escolher a opção certa para a implementação de modelos#
Cada opção de implementação na Ultralytics Platform suporta uma fase diferente do fluxo de trabalho, desde os primeiros testes até à utilização em produção. Eis uma visão geral de quando podes utilizar cada uma:
- Separador Predict: É normalmente utilizado logo após o treino ou fine-tuning, quando queres validar o desempenho de um modelo em dados novos através de inferência no navegador.
- Inferência partilhada: Nesta fase, os modelos podem ser integrados em aplicações através de APIs, permitindo testar interações do mundo real durante o desenvolvimento.
- Endpoints dedicados: São utilizados para implementações de produção, nas quais os modelos precisam de desempenho consistente, recursos dedicados e capacidade de escalar em regiões globais.
- Exportação de modelos: Quando os modelos precisam de ser executados fora da plataforma, a opção de os exportar permite a implementação em dispositivos edge, aplicações móveis ou infraestruturas personalizadas.
As equipas avançam frequentemente por estas opções passo a passo, passando da validação à integração e, por fim, à implementação em produção, tudo dentro da plataforma.
Monitorizar modelos implementados através da Ultralytics Platform#
Por mais crítica que seja a implementação, o pipeline de visão não termina aí. Quando um modelo está a funcionar em produção, a monitorização contínua é fundamental para garantir que mantém um desempenho fiável ao longo do tempo.
A Ultralytics Platform disponibiliza ferramentas de monitorização integrada que dão às equipas uma visão clara do comportamento dos seus modelos de IA de visão ao longo do tempo, suportando um fluxo de trabalho mais estruturado de operações de machine learning (MLOps).
A página Deploy inclui um dashboard que acompanha métricas essenciais, como o total de pedidos, as implementações ativas, a latência das respostas e as taxas de erro. Estas informações ajudam as equipas a compreender os padrões de utilização, avaliar a capacidade de resposta do sistema e garantir um desempenho de baixa latência em diferentes cargas de trabalho.
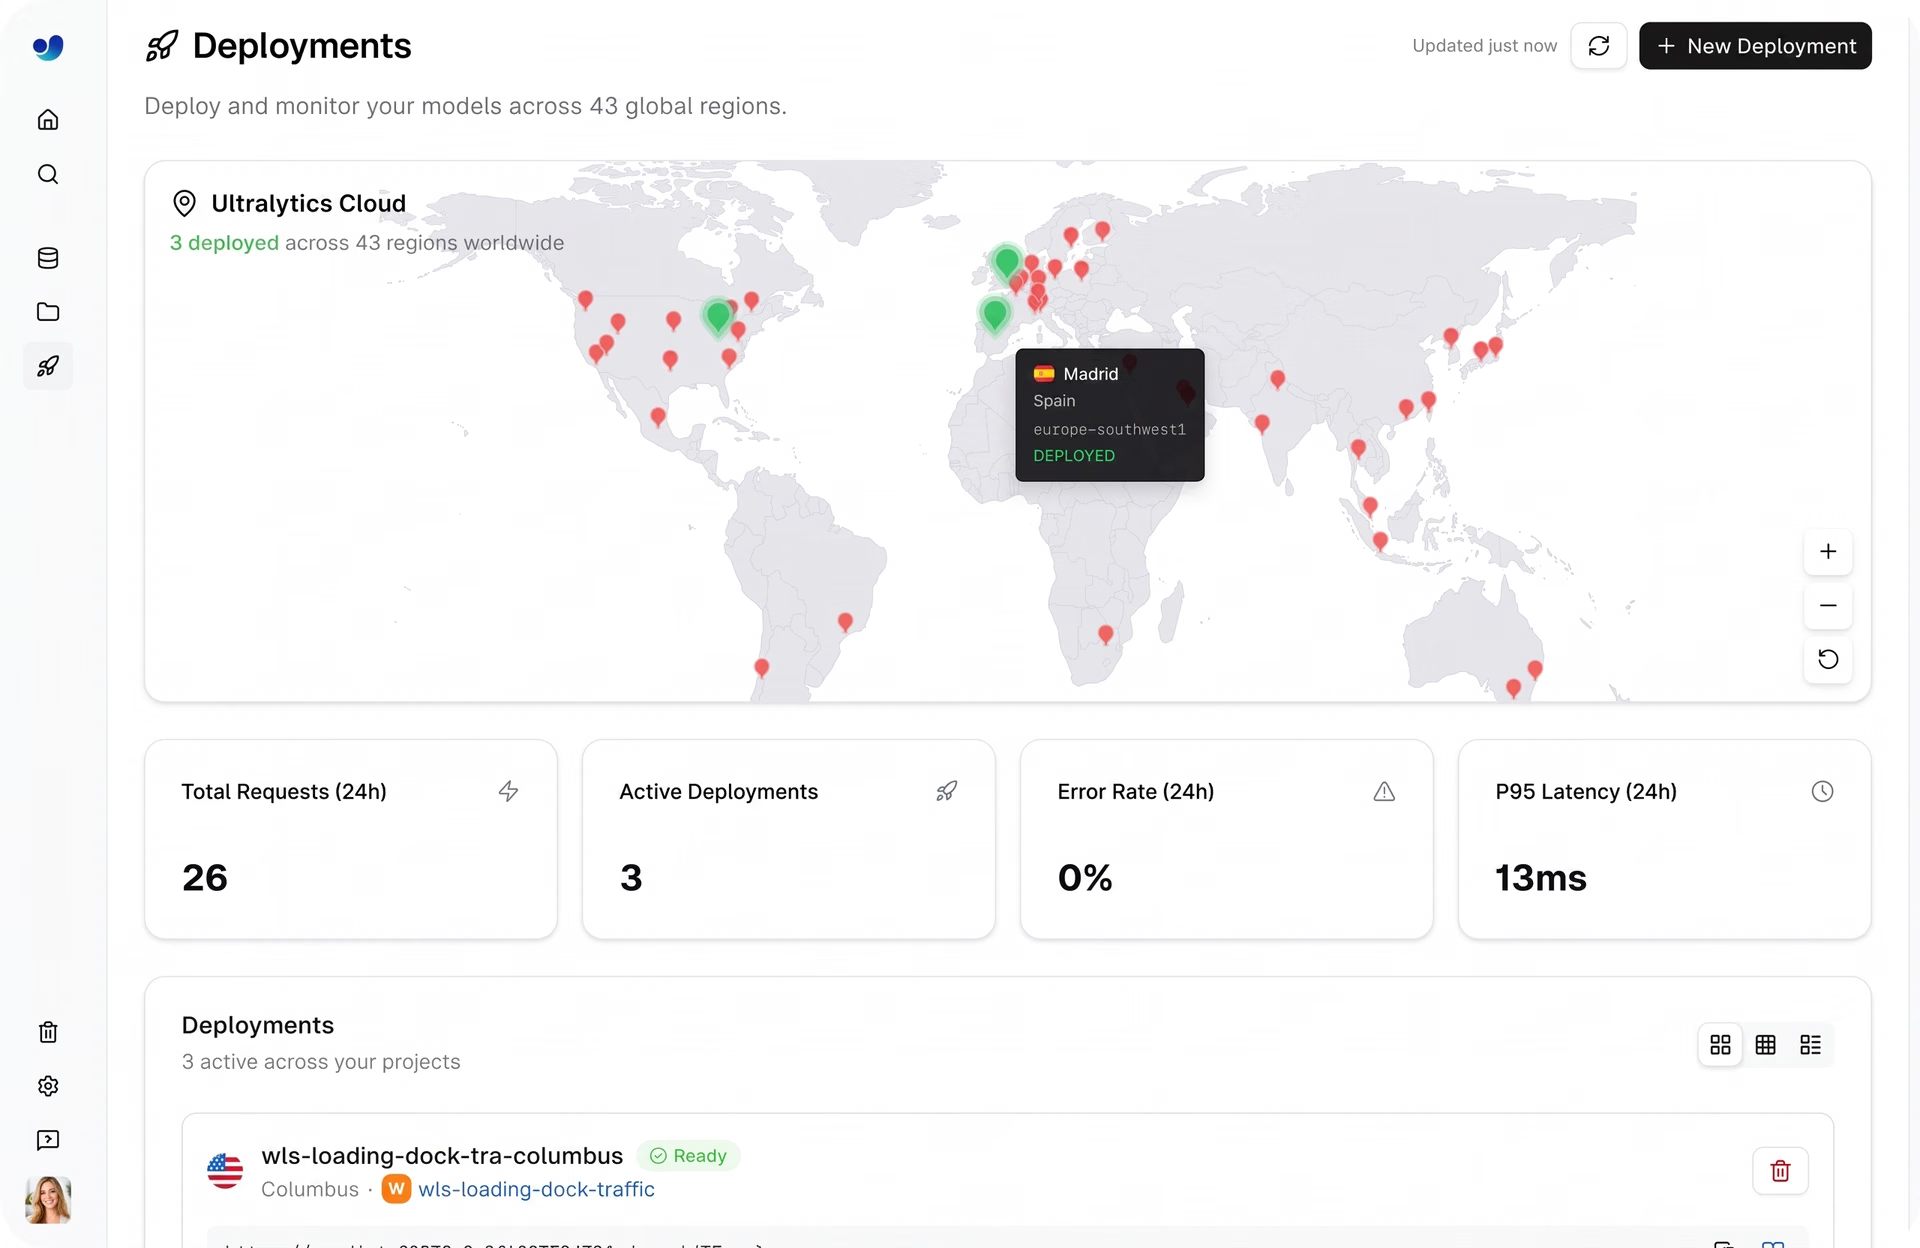
Fig. 5. A Ultralytics Platform facilita a monitorização de modelos implementados. (Fonte)
Cada endpoint dedicado também oferece observabilidade detalhada através de vistas individuais das implementações. Isto inclui acesso a registos, ao estado de saúde do modelo e a dados de desempenho em tempo real. Os registos podem ser utilizados para depurar problemas, rastrear pedidos falhados e identificar potenciais problemas relacionados com dependências ou infraestrutura.
À medida que os ambientes de produção evoluem, fatores como alterações nos dados de entrada, necessidades de escalabilidade ou mudanças nos padrões de utilização podem afetar a precisão e a robustez dos modelos. Ao monitorizar continuamente as métricas de desempenho, as equipas podem detetar anomalias, identificar estrangulamentos e tomar medidas corretivas, como otimizar o modelo ou ajustar os recursos, para manter uma disponibilização de modelos consistente e fiável.
Criar escalabilidade nas implementações de modelos de visão computacional#
Tradicionalmente, escalar sistemas de visão computacional significava juntar fluxos de trabalho e frameworks que nunca foram concebidos para funcionar em conjunto. Os pipelines de dados, os ciclos de treino, a infraestrutura de implementação e os sistemas de monitorização vivem frequentemente em locais separados, criando obstáculos em todas as fases.
O verdadeiro desafio não é apenas criar modelos, mas mantê-los em movimento. Passar dos dados para a produção, adaptar-se a novas entradas, lidar com uma procura crescente e melhorar continuamente sem abrandar.
O que se destaca na Ultralytics Platform é o facto de este movimento estar integrado. Em vez de tratar cada fase como um passo separado, a plataforma liga-as num ciclo contínuo em que os modelos podem ser desenvolvidos, implementados, observados e atualizados no mesmo ambiente.
Essa mudança altera a forma como as equipas escalam. Já não se trata de orquestrar ferramentas ou infraestruturas, mas de manter o ritmo à medida que os sistemas crescem.
Principais conclusões#
Integrar modelos de machine learning, como modelos de visão computacional, em aplicações do mundo real exige que sejam fiáveis, escaláveis e fáceis de gerir. A Ultralytics Platform simplifica este processo ao combinar várias funções, como disponibilização de modelos, implementação e monitorização, num único ambiente unificado. Com opções de implementação flexíveis e ferramentas integradas, as equipas podem passar da experimentação para a produção mais rapidamente e com menos complexidade.
Consulta a nossa comunidade e explora o nosso repositório do GitHub para saberes mais. Explora as nossas páginas de soluções para veres várias aplicações, como IA na área da saúde e visão computacional na logística. Descobre as nossas opções de licenciamento e começa a desenvolver hoje!








