Использование обучения с подкреплением в проектах компьютерного зрения
Узнай, как работает обучение с подкреплением и как оно сочетается с компьютерным зрением в складских роботах, автономных транспортных средствах и хирургической робототехнике, а также какие компромиссы приходится учитывать.
 Abirami Vina8 мин. чтения
Просто объяснить искусственный интеллект (AI) можно так: это область, цель которой — воссоздать то, как люди думают и учатся. Отсюда и возникла идея методов обучения в ИИ — различных способов, с помощью которых машины со временем повышают качество своей работы, как и люди.
Ранее мы рассматривали основные методы обучения ИИ, в том числе обучение с учителем, без учителя, с подкреплением и перенос обучения, а также то, какую важную роль каждый из них играет в обработке информации и принятии решений моделями ИИ.
Сегодня мы подробнее рассмотрим обучение с подкреплением — метод, который учит системы ИИ на собственном опыте: взаимодействовать со средой и совершенствоваться на основе обратной связи. В частности, мы изучим применение обучения с подкреплением в задачах компьютерного зрения — системах, которые позволяют машинам интерпретировать и понимать визуальную информацию об окружающем мире.
Сочетание таких направлений, как обучение с подкреплением и компьютерное зрение, открывает новые перспективы и активно исследуется. Благодаря этому системы ИИ могут распознавать увиденное и принимать обоснованные решения на основе визуальной информации.
Что такое обучение с подкреплением?#
Обучение с подкреплением — это направление машинного обучения, в котором ИИ-агент учится, выполняя действия и получая за них вознаграждения или штрафы. Его задача — определить, какие действия со временем приводят к наилучшим результатам.
Обучение с подкреплением можно сравнить с дрессировкой собаки. Когда собака садится по команде, ты даёшь ей лакомство. Через какое-то время она усваивает, что за то, что она села, полагается награда. В обучении с подкреплением роль собаки играет ИИ-агент или модель, окружающий мир — это среда, а награда помогает понять, правильно ли агент поступил.
Это отличается от обучения с учителем, при котором модели ИИ показывают множество примеров с правильными ответами. Например, модели могут показать изображение собаки и сказать: «Это собака».
Обучение с подкреплением, напротив, не опирается на размеченные данные. Вместо этого модель учится, пробуя разные действия и анализируя результаты, — примерно как в игре, где нужно понять, какие ходы помогут победить.
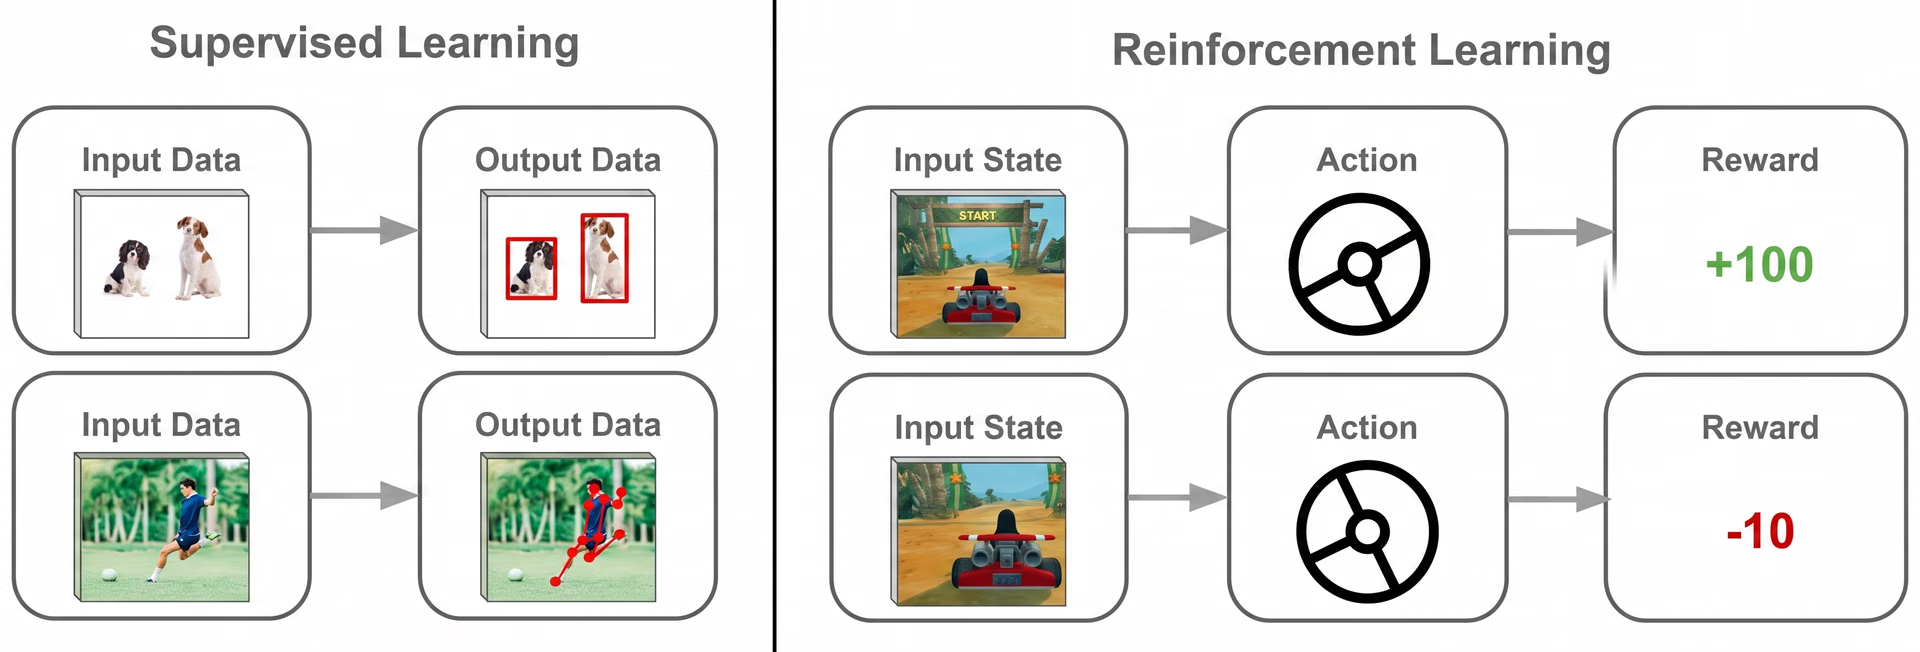
Рис. 1. Обучение с подкреплением и обучение с учителем.
Обучение с подкреплением крайне важно для задач, где решения принимаются шаг за шагом и каждый выбор влияет на дальнейший ход событий. Этот метод используют в стратегических видеоиграх, чтобы сделать игровой процесс сложнее и увлекательнее.
Как обучение с подкреплением работает в решениях на основе ИИ#
Представь, как ты учишься ездить на велосипеде. Сначала ты можешь упасть. Но с практикой начинаешь понимать, что помогает удерживать равновесие. Чем больше ты ездишь, тем лучше у тебя получается. Ты учишься на практике, а не только слушая указания.
Обучение с подкреплением работает в ИИ похожим образом. Система учится на опыте: пробует разные действия, наблюдает за результатами и постепенно лучше выбирает правильные действия.
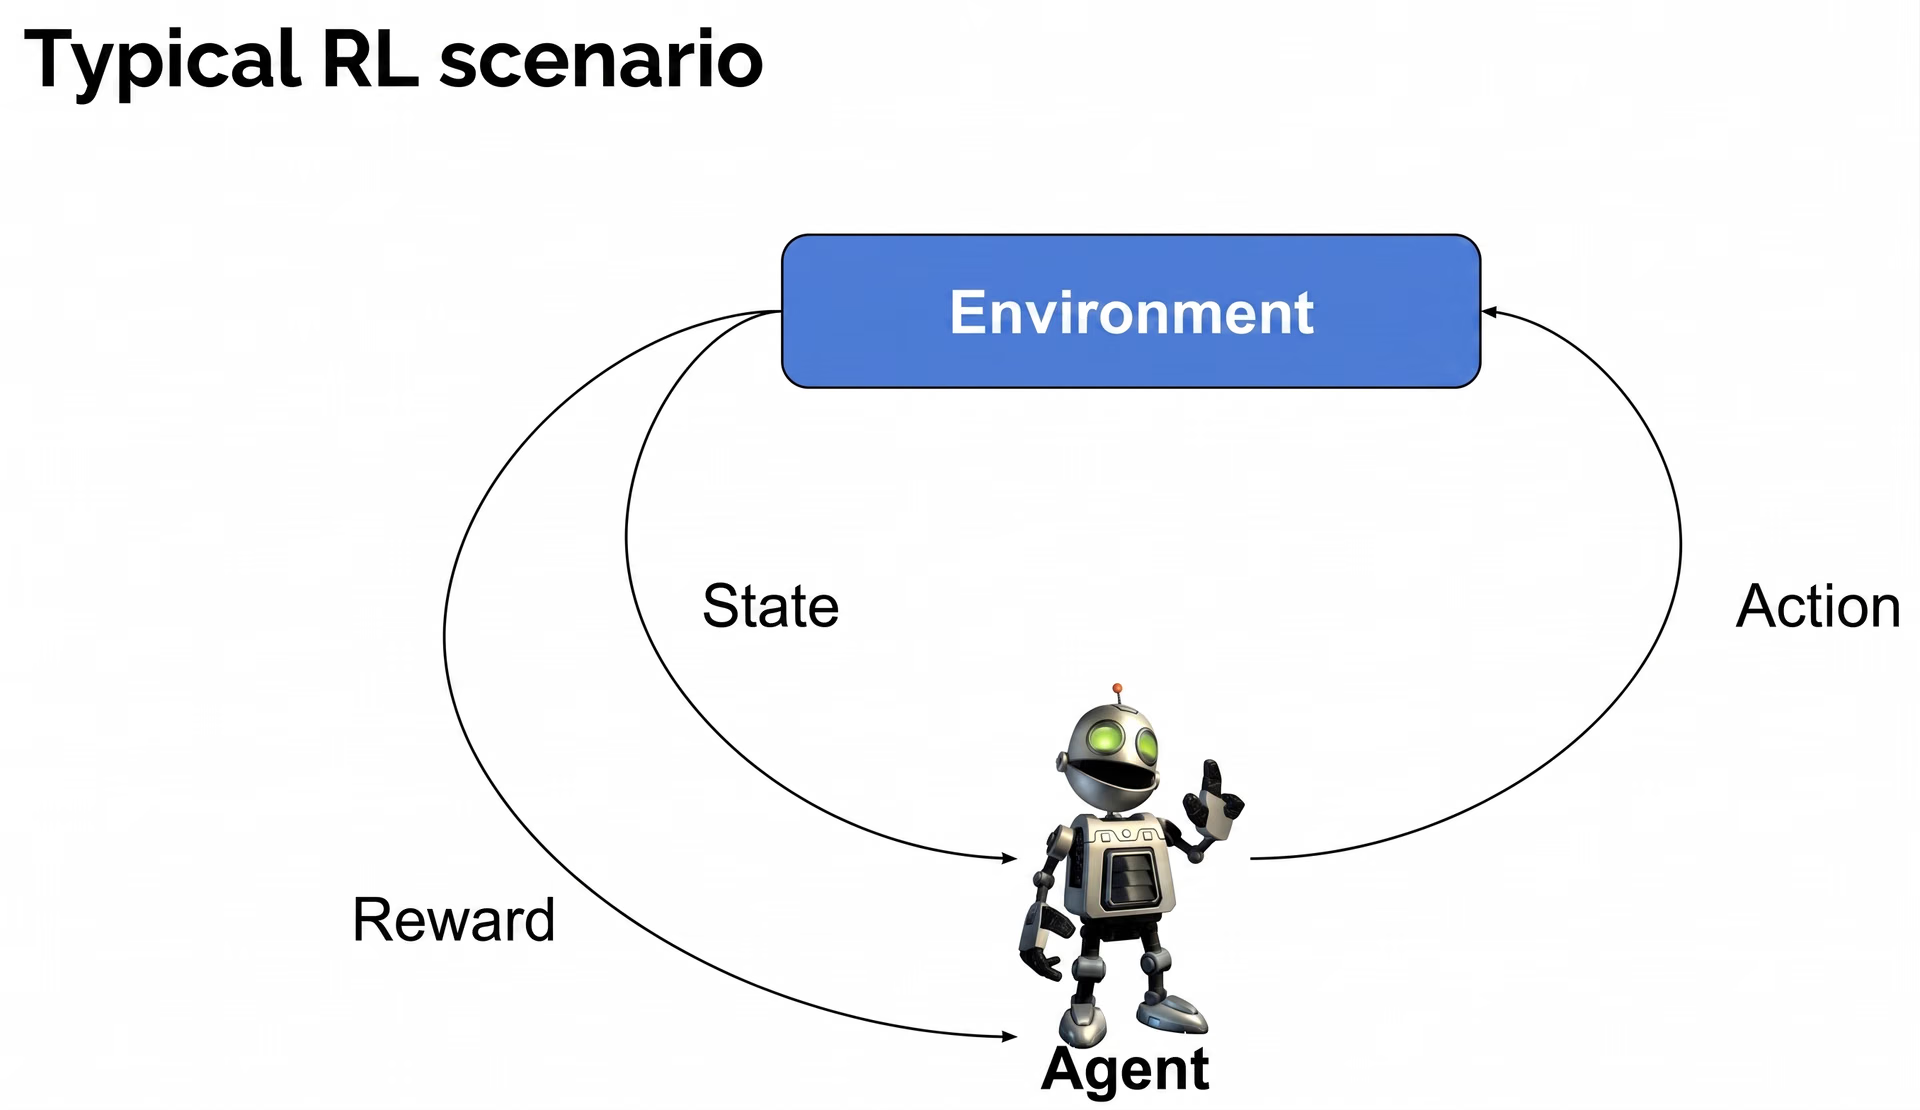
Рис. 2. Как работает обучение с подкреплением.
Рассмотрим некоторые ключевые компоненты обучения с подкреплением:
- Агент: агент — это обучающийся или лицо, принимающее решения. Он взаимодействует со средой, выполняя действия, и стремится достичь конкретной цели.
- Среда: среда включает всё, с чем взаимодействует агент. Она меняется в ответ на действия агента и предоставляет обратную связь по их результатам.
- Состояние: состояние отражает текущую ситуацию в среде. Агент наблюдает за состоянием, чтобы понять, что происходит вокруг, и определить, какое действие выполнить следующим.
- Действие: действие — это шаг или решение агента, которое влияет на среду. Каждое действие приводит к новому состоянию и может повлиять на будущие вознаграждения.
- Вознаграждение: вознаграждение — это обратная связь от среды, которая сообщает агенту, было ли его действие полезным. Положительные вознаграждения побуждают агента повторять удачные действия, а отрицательные — избегать неудачных.
- Политика: политика — это стратегия агента по выбору действий с учётом текущего состояния. Со временем агент совершенствует политику, чтобы максимизировать суммарное вознаграждение.
Совместное использование этих компонентов позволяет системам ИИ вырабатывать эффективное поведение методом непрерывных проб и ошибок. С каждой попыткой агент лучше выбирает действия, которые приводят к большему вознаграждению и лучшим результатам.
Инновации в компьютерном зрении на основе обучения с подкреплением#
Компьютерное зрение применяют для таких задач, как обнаружение объектов на изображениях, классификация содержимого фотографий и разделение изображения на области. Модели компьютерного зрения, такие как Ultralytics YOLO11, поддерживают эти задачи и помогают создавать полезные приложения для получения визуальных данных.
Однако, если объединить эти задачи Vision AI с обучением с подкреплением, получится решение на основе ИИ, которое не просто видит, но и учится действовать на основе визуальной информации и со временем совершенствуется.
Интересный пример применения обучения с подкреплением в компьютерном зрении — роботы на складах. Оснащённые камерами и системами компьютерного зрения роботы могут анализировать окружение, находить предметы, определять их форму и размер, а также понимать, как они расположены на полке.
Каждый раз, когда робот пытается взять предмет, он получает обратную связь: успех, если предмет удалось взять, или неудачу, если предмет упал. Со временем робот учится выбирать наиболее подходящие действия для разных предметов. Вместо выполнения фиксированного набора инструкций он постоянно совершенствуется на собственном опыте.
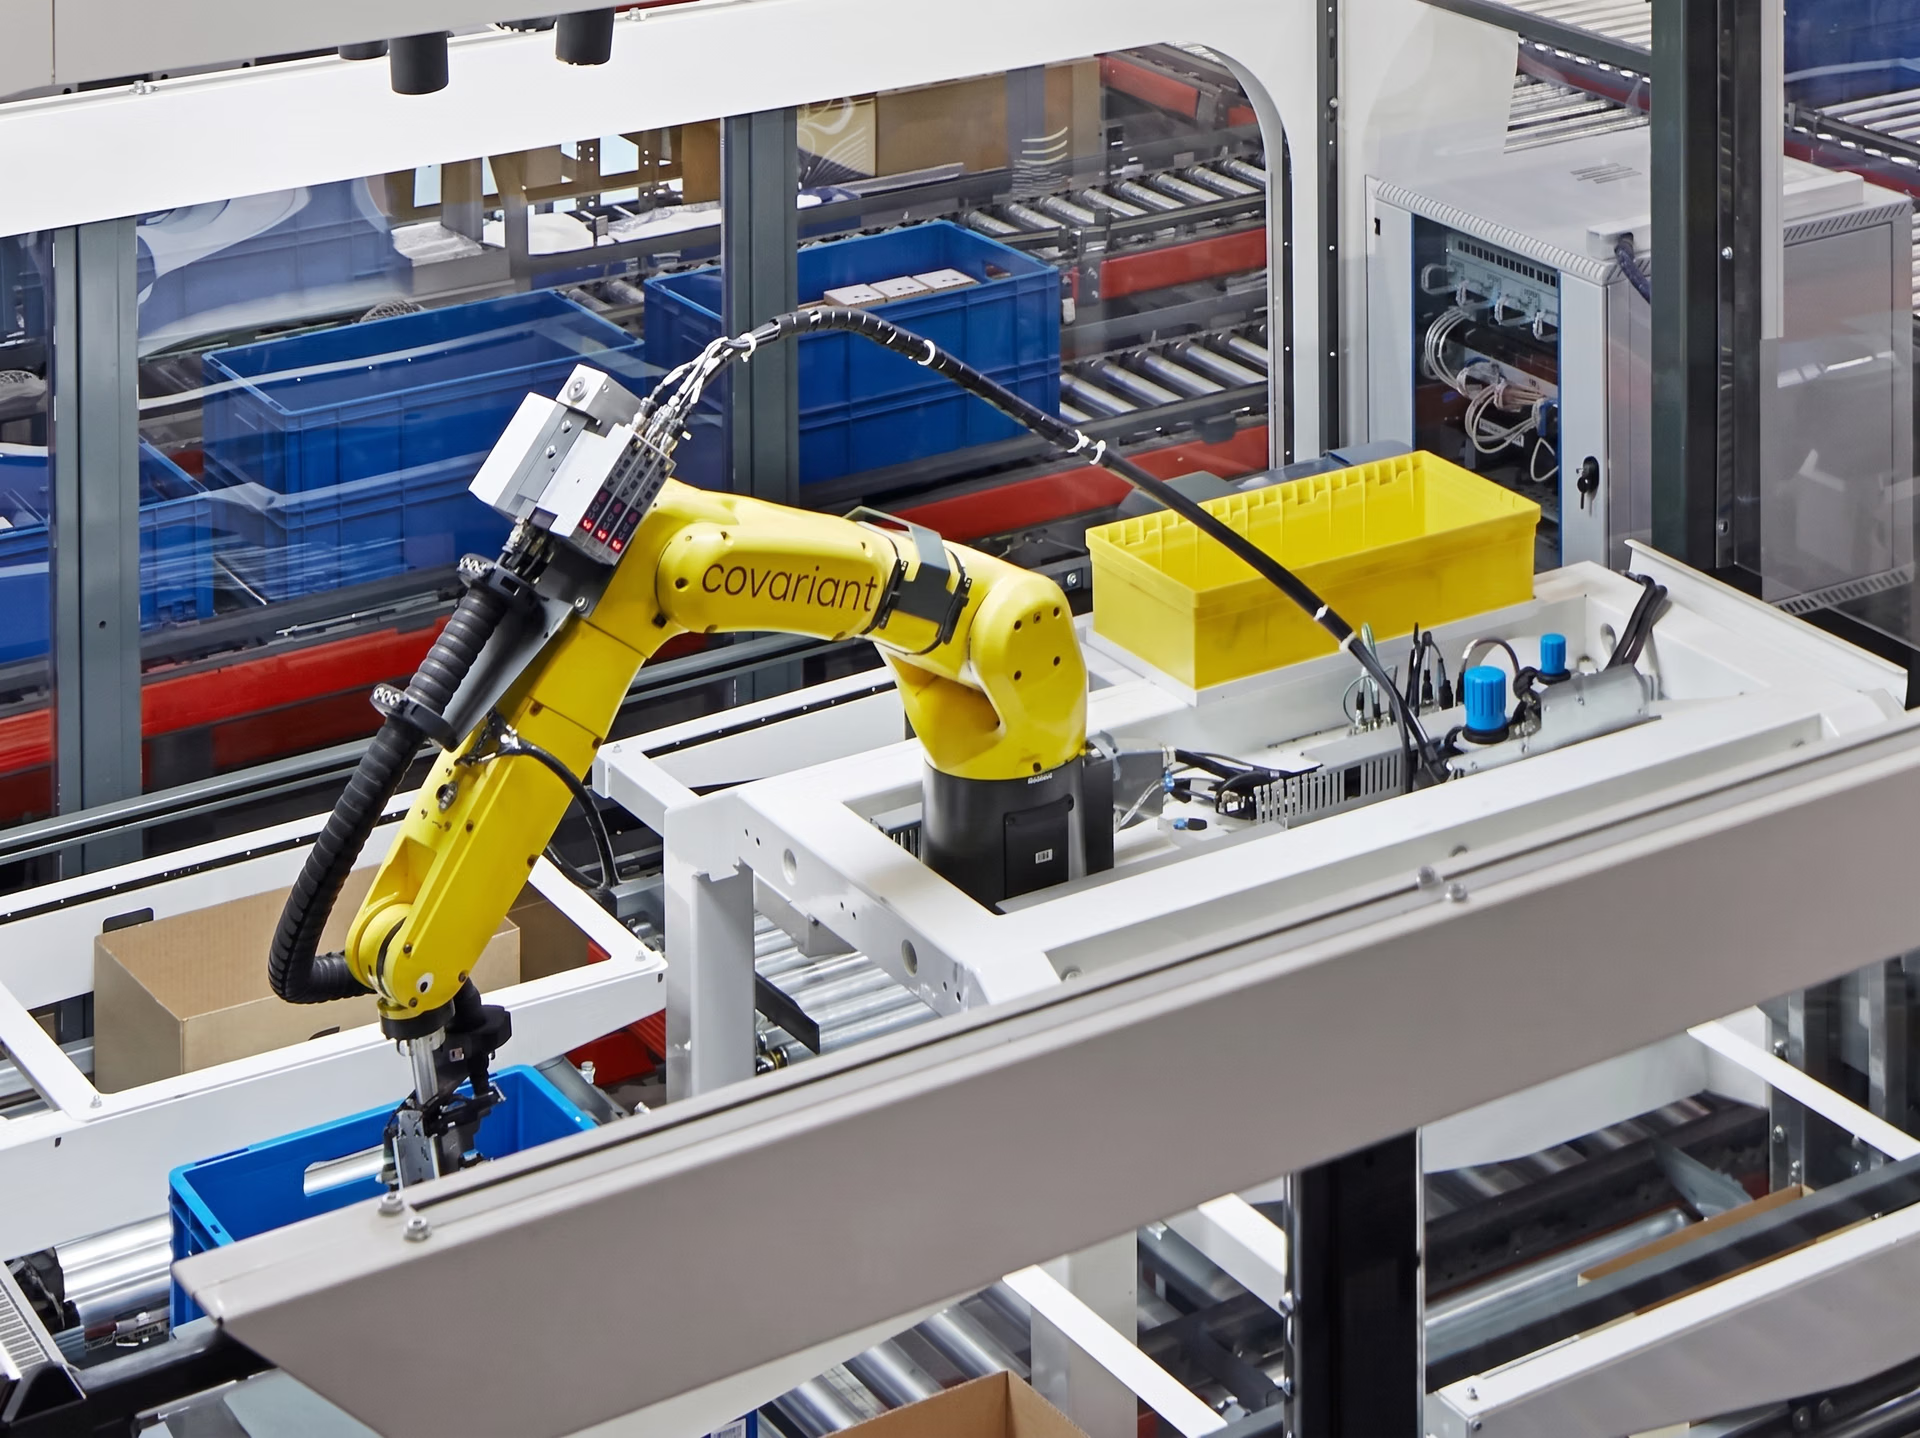
Рис. 3. Роботизированная рука использует Vision AI и обучение с подкреплением, чтобы поднимать объекты.
Применение обучения с подкреплением в компьютерном зрении#
Теперь, когда мы лучше понимаем, что такое обучение с подкреплением и какую роль оно играет в компьютерном зрении, рассмотрим примеры совместного применения обучения с подкреплением и компьютерного зрения.
Интеграция Vision AI и обучения с подкреплением для более интеллектуальных автомобилей#
Автономные транспортные средства могут использовать Vision AI для анализа окружения, а обучение с подкреплением — для принятия решений на основе увиденного. Отличный пример такой системы — AWS DeepRacer.
AWS DeepRacer — полностью автономный гоночный автомобиль в масштабе 1:18, который учится управлять собой с помощью камеры и обучения с подкреплением. Вместо того чтобы получать инструкции, он самостоятельно разбирается, что делать: пробует, ошибается и учится на своих ошибках.
Камера этой миниатюрной машины работает как пара глаз, снимая трассу впереди. По увиденному машина учится поворачивать и выбирать скорость. С каждым кругом она становится лучше. Например, на основе предыдущего опыта она может научиться проходить повороты по более широкой дуге или замедляться перед крутыми поворотами.
Обучение DeepRacer начинается в виртуальной среде, где модель отрабатывает и совершенствует навыки вождения. Достигнув определённого уровня, эти навыки переносят на реальные трассы с настоящими автомобилями.
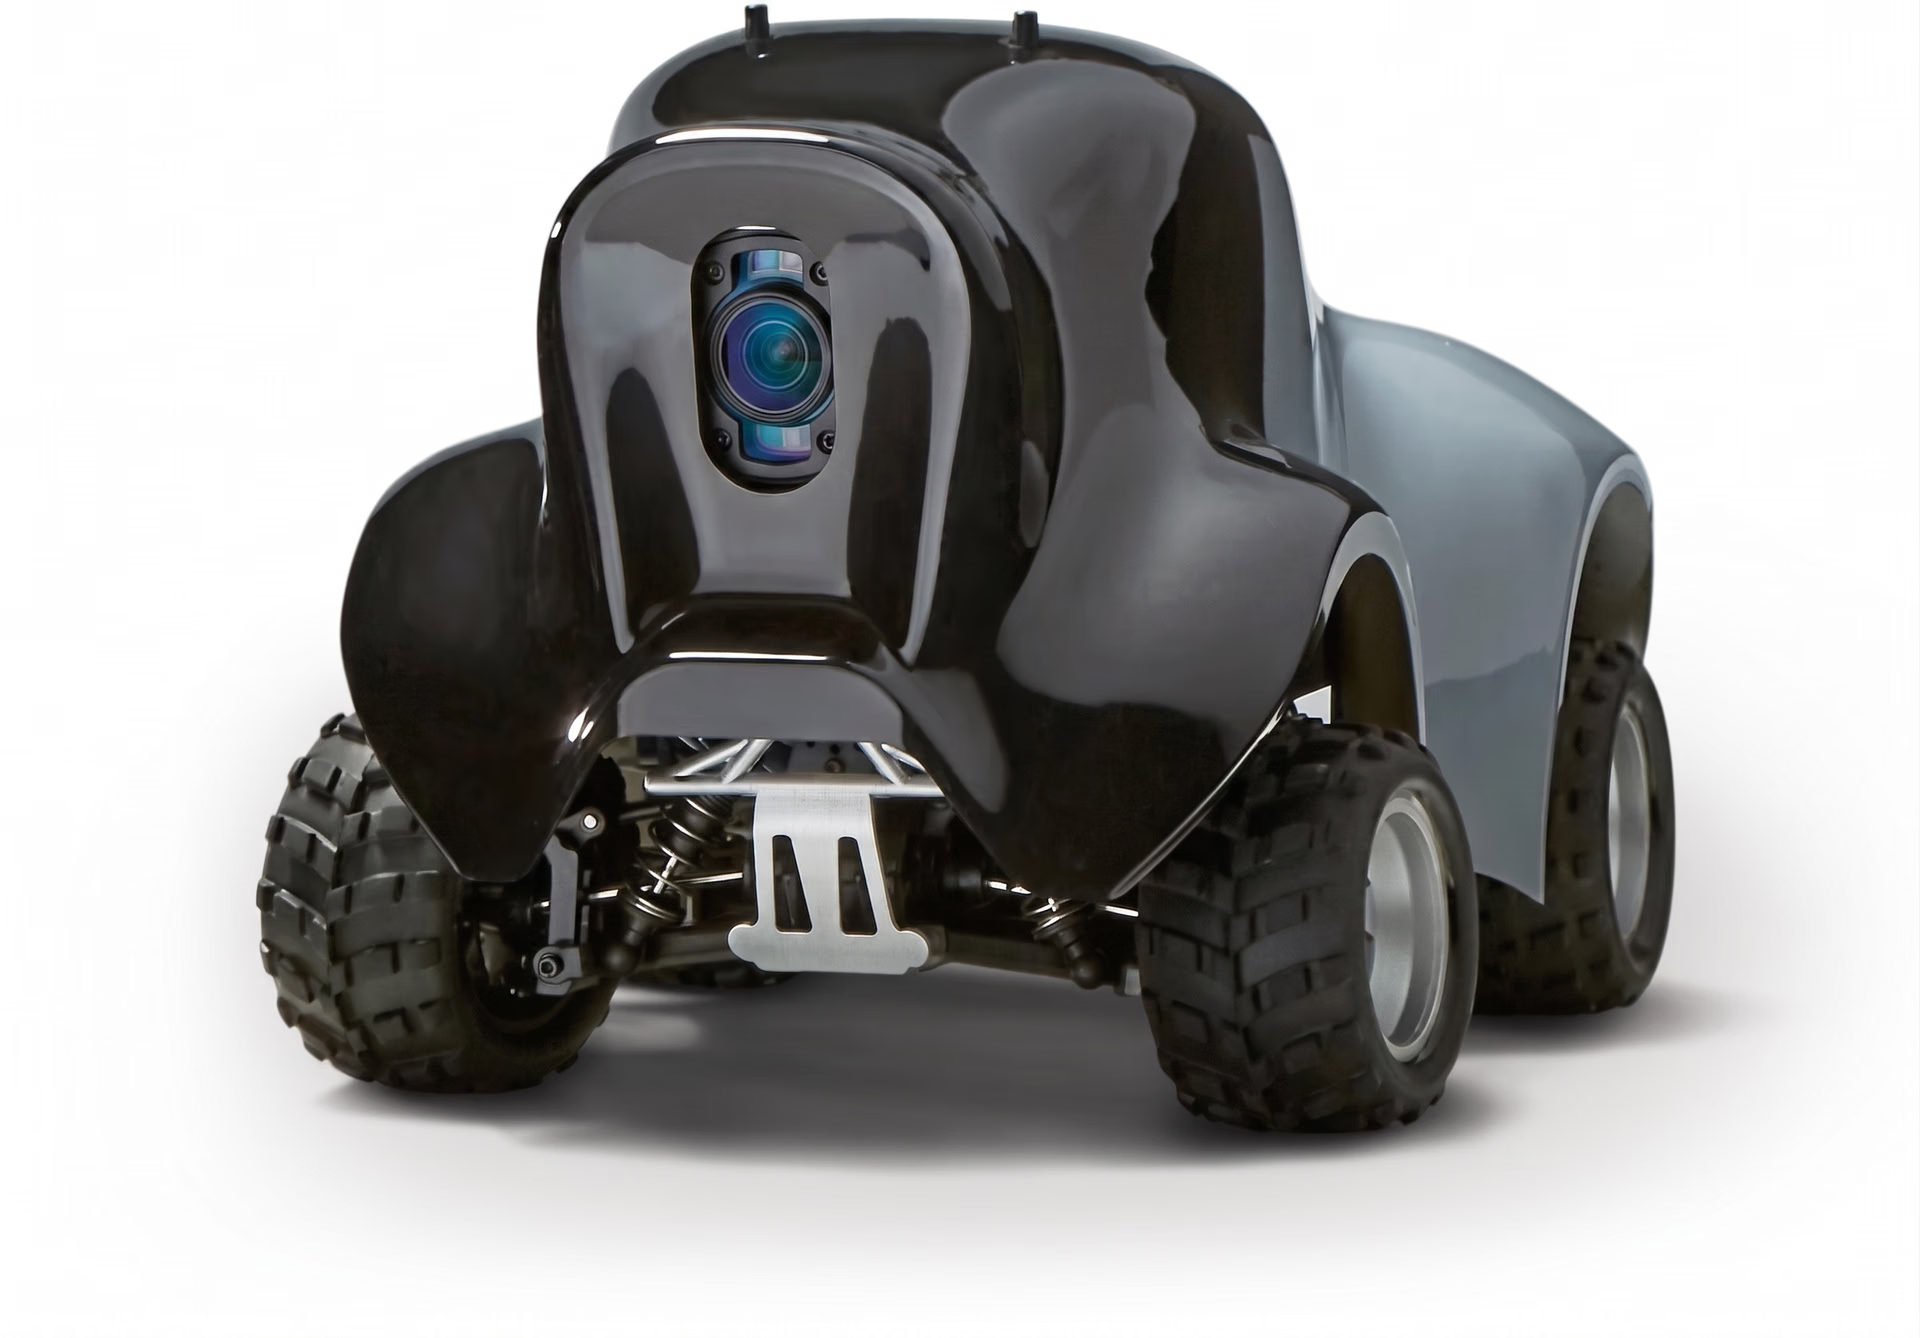
Рис. 4. AWS DeepRacer использует компьютерное зрение и обучение с подкреплением для автономного вождения. Источник изображения: Amazon.
На пути к автономным хирургическим роботам#
Перспективная область исследований, привлекающая всё больше внимания, — интеграция Vision AI и обучения с подкреплением в роботизированную хирургию. Пока это применение в основном остаётся теоретическим. Исследователи проводят симуляции в виртуальных средах.
Однако первые эксперименты показывают многообещающие результаты и позволяют предположить, что в будущем хирургические роботы смогут выполнять сложные и деликатные процедуры точнее, гибче и с минимальным участием человека.
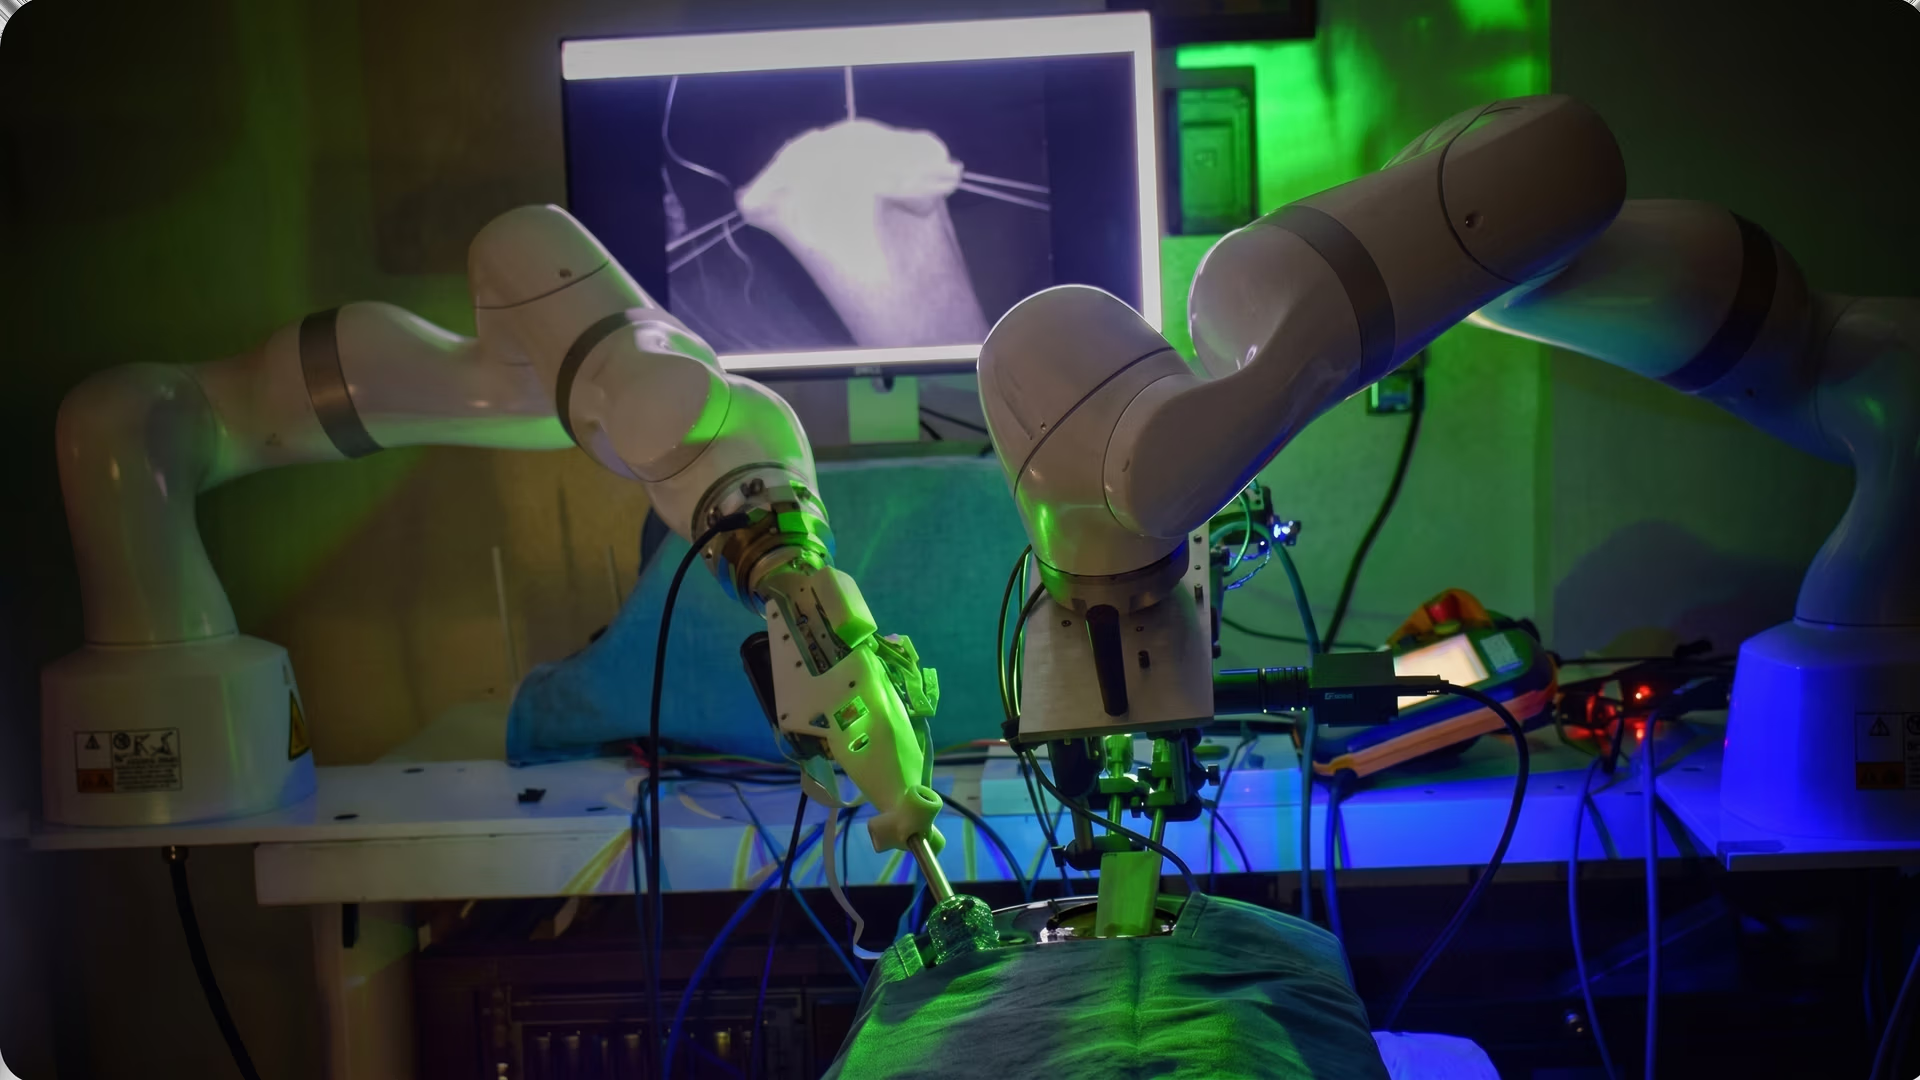
Рис. 5. Хирургические роботы становятся всё более совершенными.
Например, представь ситуацию, в которой нужно аккуратно поднять марлевую салфетку с места операции. Робот с Vision AI сначала проанализирует сцену, используя сегментацию, чтобы определить салфетку и окружающие ткани.
Затем обучение с подкреплением поможет хирургическому роботу определить, как выполнить задачу: выбрать оптимальный угол захвата салфетки, силу давления и способ её извлечения, не задев чувствительные участки поблизости. Со временем, многократно тренируясь в симулируемых средах, робот сможет всё увереннее и искуснее выполнять эти точные и важные движения.
Преимущества и недостатки обучения с подкреплением в Vision AI#
Обучение с подкреплением позволяет системам Vision AI выйти за рамки простого распознавания и начать принимать решения на основе увиденного. Это открывает новые возможности в робототехнике, автоматизации и взаимодействии в реальном времени.
Вот несколько ключевых преимуществ интеграции обучения с подкреплением в рабочие процессы Vision AI:
- Меньшая зависимость от размеченных данных: такие системы могут учиться в процессе взаимодействия, поэтому для начала работы им не нужны огромные наборы данных с разметкой.
- Лучше справляется с неопределённостью: обучение с подкреплением позволяет работать с неполной или зашумлённой визуальной информацией, корректируя действия на основе обратной связи, а не полагаясь только на идеальные данные.
- Поддержка долгосрочного обучения: модели совершенствуются со временем, обучаясь на последовательностях действий, а не только на решениях, принимаемых за один шаг.
С другой стороны, при использовании обучения с подкреплением стоит учитывать следующие ограничения:
- Проблема отнесения заслуг: агенту может быть трудно определить, какие именно действия привели к конечному результату, особенно в длинных последовательностях решений.
- Риск небезопасного исследования среды: во время обучения агент может пробовать опасные или нежелательные действия, недопустимые в реальных приложениях, например в здравоохранении или автономном вождении.
- Медленная сходимость: модели может потребоваться много времени, чтобы достичь хороших результатов, особенно при решении сложных задач.
Главные выводы#
Обучение с подкреплением в проектах компьютерного зрения позволяет системам ИИ понимать окружающую обстановку и учиться действовать на основе опыта. Модели, такие как Ultralytics YOLO11, обеспечивают обнаружение объектов в реальном времени, помогая системе принимать обоснованные решения на основе увиденного.
Этот подход выходит за рамки традиционных методов: ИИ совершенствуется благодаря пробам и обратной связи, а не полагается исключительно на размеченные данные. Он поддерживает непрерывное обучение и помогает создавать более гибкие, адаптивные и интеллектуальные системы Vision AI, которые со временем становятся лучше.
Присоединяйся к нашему растущему сообществу. Загляни в наш репозиторий GitHub, чтобы глубже погрузиться в ИИ. Хочешь начать собственные проекты в области компьютерного зрения? Изучи варианты лицензирования. Узнай больше о применении ИИ в производстве и Vision AI в автомобильной отрасли на страницах наших решений.
Автор
Создатель контента · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









