Khám phá khả năng phát hiện đối tượng nhỏ với Ultralytics YOLO11
Khám phá cách Ultralytics YOLO11 phát hiện đối tượng nhỏ nhanh và chính xác trong các ứng dụng thực tế như giám sát và robot.
 Abirami Vina18 phút đọc
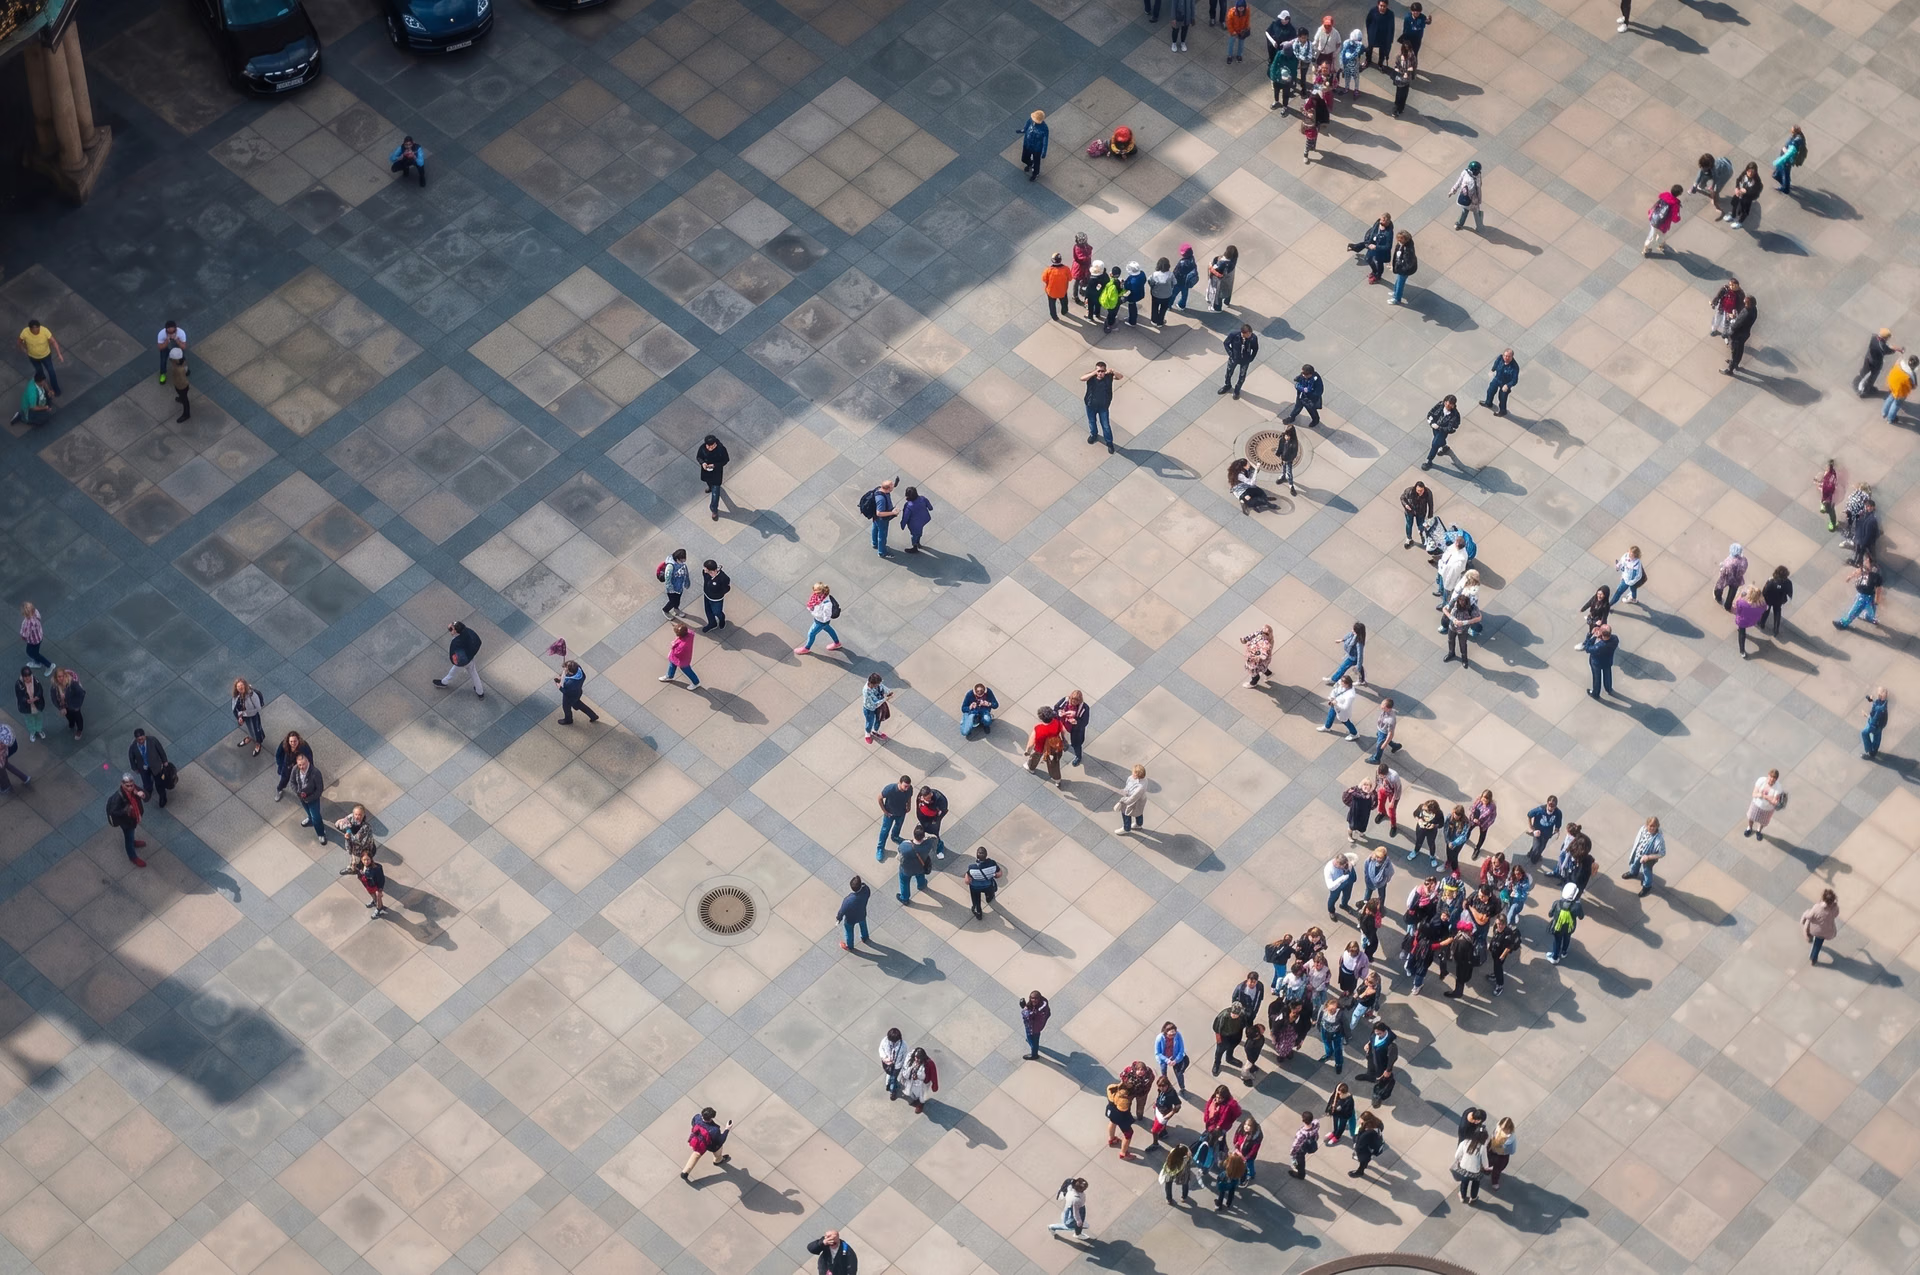
Drone tích hợp AI thị giác có thể bay cao hàng trăm mét so với mặt đất nhưng vẫn được kỳ vọng phát hiện một người chỉ xuất hiện trong video dưới dạng vài pixel. Đây thực sự là thách thức phổ biến trong các ứng dụng như robot, giám sát và viễn thám, nơi hệ thống phải nhận diện các đối tượng rất nhỏ trong ảnh.
Tuy nhiên, các model phát hiện đối tượng truyền thống có thể gặp khó khăn khi thực hiện việc này. Các đối tượng nhỏ trong ảnh và video cung cấp rất ít thông tin hình ảnh. Nói đơn giản, khi model phân tích chúng, sẽ không có nhiều chi tiết để học hoặc nhận diện.
Bên trong, các model này thường dựa trên kiến trúc mạng nơ-ron tích chập (CNN). Ảnh được đưa qua các lớp của mạng và chuyển thành feature map hoặc biểu diễn giản lược, làm nổi bật các mẫu liên quan thay vì pixel thô.
Khi ảnh đi sâu hơn qua mạng, các feature map này sẽ nhỏ dần. Điều đó giúp tính toán nhanh hơn, nhưng cũng khiến các chi tiết nhỏ có thể biến mất.
Với các đối tượng rất nhỏ, những chi tiết đó vô cùng quan trọng. Khi chúng biến mất, model thị giác máy tính có thể gặp khó khăn trong việc phát hiện đối tượng, dẫn đến BBox kém chính xác hoặc không nhất quán.
Điều này càng phức tạp hơn với các hệ thống thị giác máy tính đầu-cuối theo thời gian thực. Ảnh độ phân giải cao giúp bảo toàn chi tiết, nhưng làm chậm quá trình inference và đòi hỏi nhiều sức mạnh GPU hơn. Độ phân giải thấp giúp xử lý nhanh hơn, nhưng khiến các đối tượng nhỏ càng khó phát hiện.
Đây là bài toán cân bằng liên tục giữa tốc độ, độ chính xác và giới hạn phần cứng. Nhờ những tiến bộ công nghệ gần đây, các model thị giác máy tính như Ultralytics YOLO11 và Ultralytics YOLO26, đã được phát hành sau đó, được thiết kế để xử lý sự đánh đổi này hiệu quả hơn.
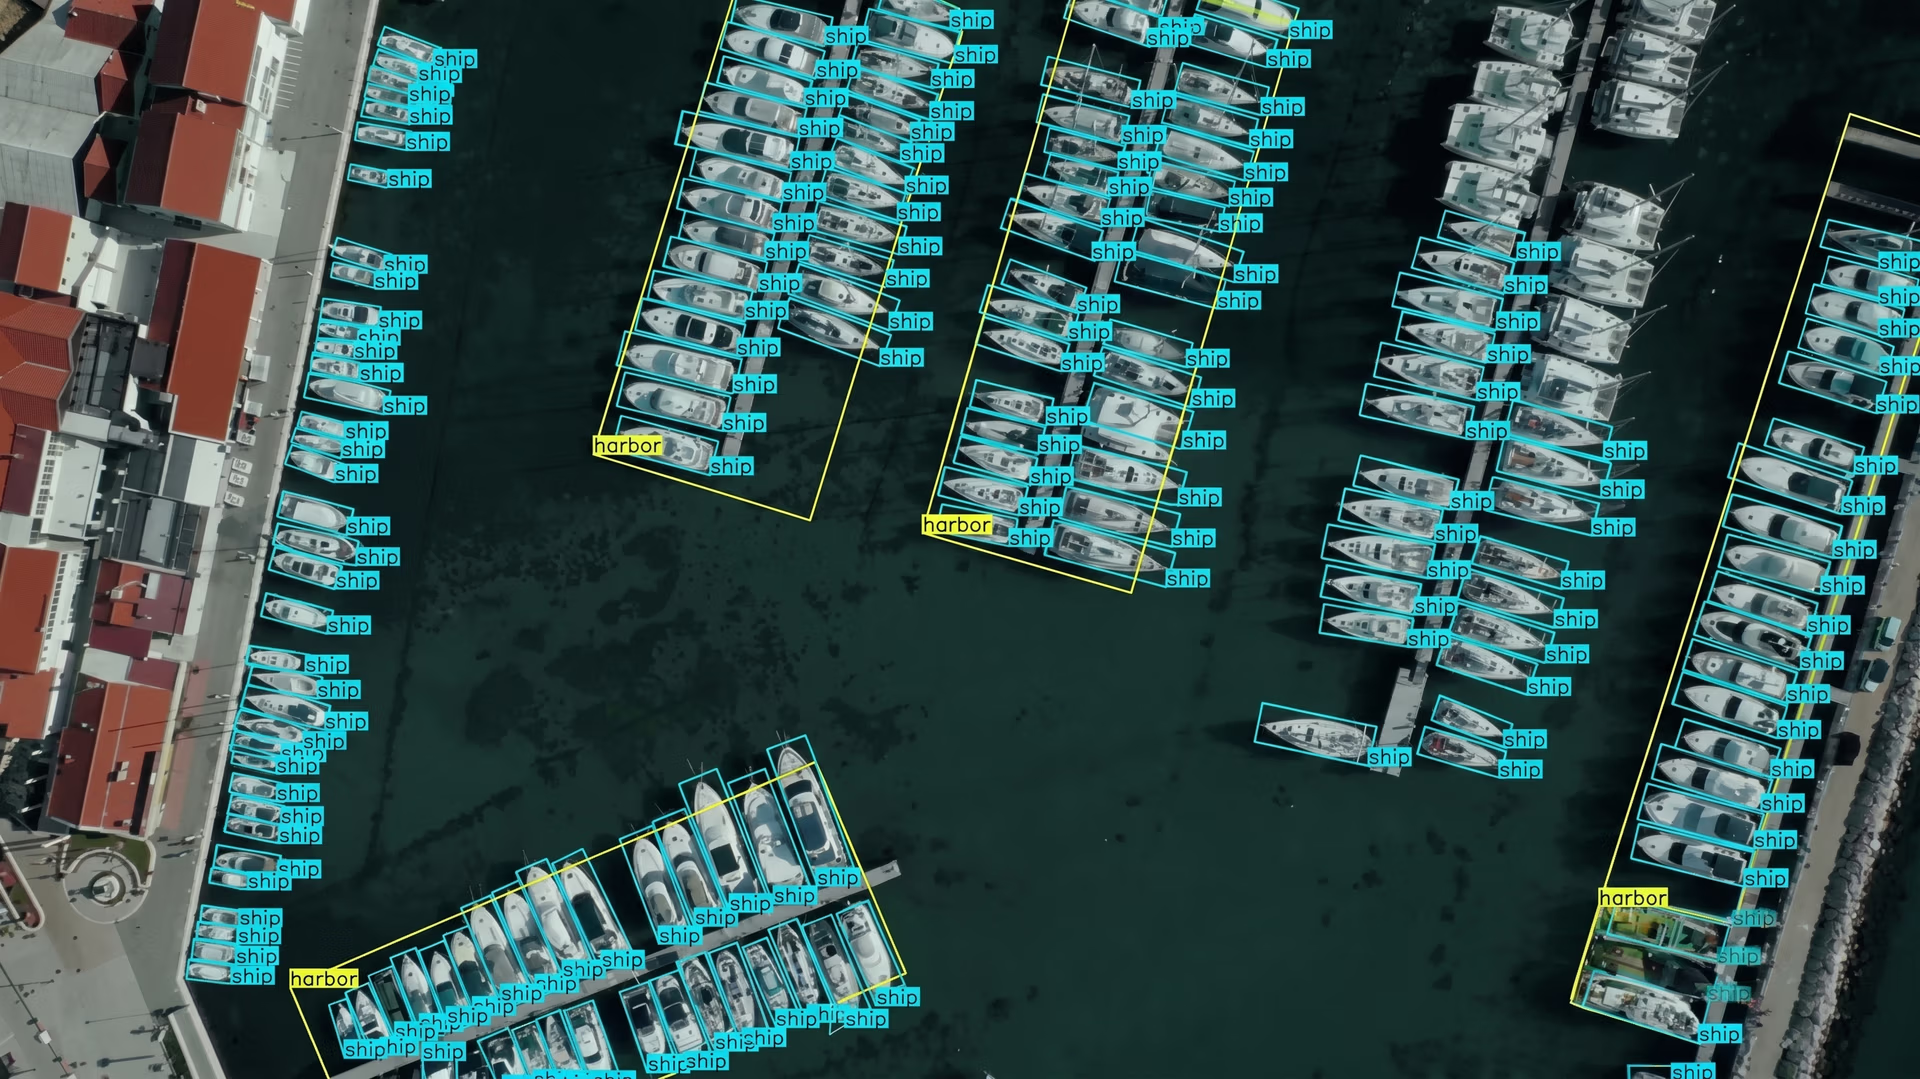
Hình 1. Sử dụng YOLO11 để phát hiện các đối tượng nhỏ trong ảnh hàng không (Nguồn)
Trong bài viết này, chúng ta sẽ tìm hiểu vì sao phát hiện vật thể nhỏ lại khó và cách Ultralytics YOLO11 có thể giúp việc đó dễ dàng hơn.
Phát hiện đối tượng nhỏ là gì và vì sao quan trọng?#
Phát hiện đối tượng nhỏ là một tác vụ trong thị giác máy tính, một nhánh của AI, tập trung vào việc nhận diện và định vị các đối tượng chiếm một phần rất nhỏ trong ảnh. Những đối tượng này thường chỉ được thể hiện bằng một số lượng pixel hạn chế trong ảnh; pixel là đơn vị nhỏ nhất của ảnh kỹ thuật số. Vì vậy, chúng khó phát hiện hơn các mục tiêu lớn và rõ nét hơn (thường chứa nhiều pixel hơn).
Ví dụ, phương tiện trong ảnh hàng không, dụng cụ trên sàn nhà máy hoặc người được camera giám sát góc rộng ghi lại đều có thể xuất hiện dưới dạng các đối tượng nhỏ trong ảnh. Việc phát hiện chúng rất quan trọng vì chúng thường chứa thông tin thiết yếu, và nhiều ứng dụng thực tế, chẳng hạn như giám sát, phụ thuộc vào khả năng phát hiện này để hoạt động chính xác.
Khi bỏ sót các đối tượng nhỏ, hiệu suất hệ thống và quá trình ra quyết định có thể bị ảnh hưởng. Giám sát phương tiện bay không người lái (UAV) là một ví dụ điển hình: bỏ sót một vật thể nhỏ đang di chuyển trên mặt đất có thể ảnh hưởng đến độ chính xác của điều hướng hoặc theo dõi.
Các thách thức liên quan đến việc phát hiện đối tượng nhỏ#
Các hệ thống trước đây sử dụng đặc trưng được thiết kế thủ công và phương pháp thị giác máy tính truyền thống, vốn gặp khó khăn trong các cảnh phức tạp hoặc đa dạng. Ngay cả ngày nay, dù model deep learning đã hoạt động tốt hơn nhiều, việc phát hiện các mục tiêu nhỏ vẫn khó khi chúng chỉ chiếm một phần rất nhỏ trong ảnh.
Tiếp theo, hãy cùng xem xét một số thách thức phổ biến xuất hiện trong nhiều tình huống thực tế khi phát hiện đối tượng nhỏ.
Kích thước, pixel và mất thông tin#
Đối tượng nhỏ chỉ chứa rất ít pixel, làm hạn chế lượng chi tiết hình ảnh mà model có thể học trong các giai đoạn như trích xuất đặc trưng. Do đó, các mẫu như cạnh, hình dạng và kết cấu khó phát hiện hơn, khiến đối tượng nhỏ dễ hòa lẫn vào hậu cảnh.
Khi ảnh đi qua các lớp tích chập của mạng nơ-ron, thông tin hình ảnh trong pixel dần được nén thành feature map. Điều này giúp model hoạt động hiệu quả, nhưng cũng khiến các chi tiết nhỏ mờ dần.
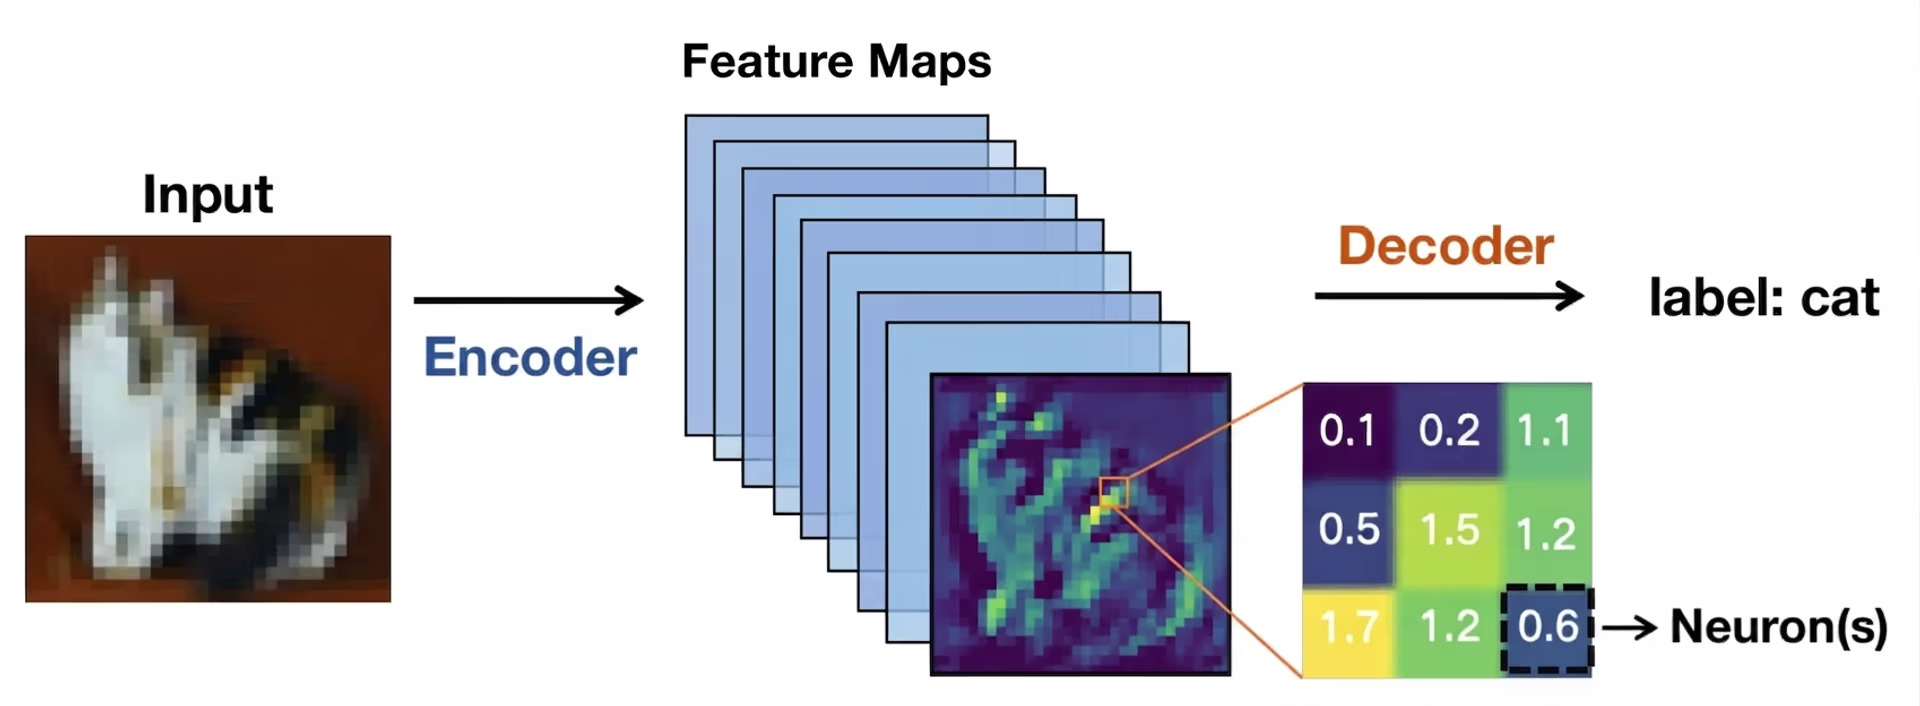
Hình 2. Feature map thể hiện các mẫu hình ảnh trong ảnh (Nguồn)
Với các mục tiêu nhỏ, những dấu hiệu quan trọng có thể biến mất trước khi mạng phát hiện kịp xử lý. Khi đó, việc định vị trở nên kém tin cậy hơn, và BBox có thể bị lệch, chồng lấp hoặc bỏ sót hoàn toàn các đối tượng mục tiêu.
Che khuất, biến thiên tỷ lệ và ngữ cảnh#
Các thách thức liên quan đến kích thước cũng thường bắt nguồn từ hiện tượng che khuất. Che khuất xảy ra khi các đối tượng, đặc biệt là đối tượng nhỏ, bị các đối tượng khác trong cảnh che một phần.
Điều này làm giảm diện tích nhìn thấy của mục tiêu, giới hạn thông tin mà bộ phát hiện đối tượng có thể sử dụng. Ngay cả một phần che khuất nhỏ cũng có thể khiến mạng phát hiện nhầm lẫn, đặc biệt khi kết hợp với đầu vào độ phân giải thấp. Một ví dụ thú vị có thể thấy trong các bộ dữ liệu UAV như VisDrone, nơi người đi bộ, xe đạp hoặc phương tiện có thể bị tòa nhà, cây cối hay các vật thể chuyển động khác che khuất một phần.
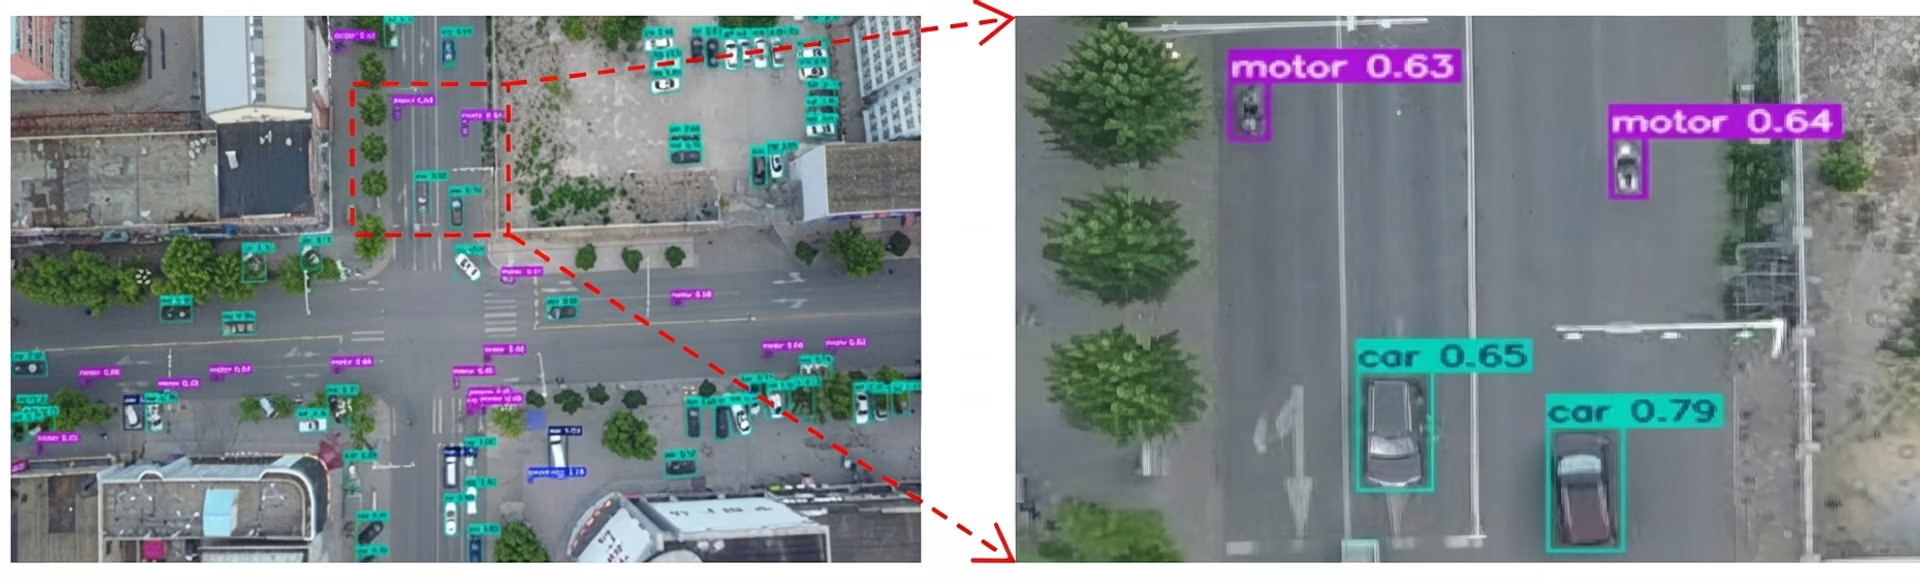
Hình 3. Ví dụ về các đối tượng nhỏ trong bộ dữ liệu VisDrone (Nguồn)
Tương tự, biến thiên tỷ lệ làm tăng thêm độ khó khi cùng một đối tượng xuất hiện rất nhỏ hoặc tương đối lớn tùy theo khoảng cách và vị trí camera. Bất chấp những trở ngại này, các thuật toán phát hiện vẫn phải nhận diện đối tượng nhỏ ở nhiều tỷ lệ khác nhau mà không làm giảm độ chính xác.
Ngữ cảnh cũng đóng vai trò quan trọng trong việc phát hiện. Chẳng hạn, các đối tượng lớn thường xuất hiện với bối cảnh rõ ràng, cung cấp những dấu hiệu hình ảnh hữu ích. Ngược lại, các mục tiêu nhỏ thường thiếu thông tin ngữ cảnh này, khiến việc nhận dạng mẫu khó hơn.
Vấn đề thước đo tiềm ẩn trong phát hiện đối tượng nhỏ#
Các metric đánh giá phổ biến, chẳng hạn như Intersection over Union (IoU), đo mức độ BBox dự đoán chồng lấp với BBox ground truth. IoU hoạt động tốt với các đối tượng lớn, nhưng có cách phản ứng khá khác biệt với đối tượng nhỏ.
Đối tượng nhỏ chỉ chiếm vài pixel, vì vậy ngay cả một dịch chuyển nhỏ của BBox dự đoán cũng có thể tạo ra sai số tương đối lớn và làm giảm mạnh điểm IoU. Điều này có nghĩa là đối tượng nhỏ thường không đạt ngưỡng IoU tiêu chuẩn dùng để tính dự đoán là chính xác, ngay cả khi đối tượng vẫn nhìn thấy trong ảnh.
Do đó, lỗi định vị dễ bị phân loại thành false positive hoặc false negative hơn. Những hạn chế này đã thúc đẩy các nhà nghiên cứu xem xét lại cách hệ thống phát hiện đối tượng đánh giá và xử lý các mục tiêu nhỏ khó phát hiện.
Đặc trưng đa tỷ lệ: Chìa khóa để phát hiện đối tượng nhỏ theo thời gian thực#
Khi các nhà nghiên cứu tìm cách cải thiện khả năng phát hiện vật thể nhỏ, họ nhận ra rằng việc bảo toàn và biểu diễn thông tin hình ảnh ở nhiều tỷ lệ là điều thiết yếu. Nhận định này cũng được thể hiện trong các nghiên cứu arXiv gần đây và các bài báo được trình bày tại những diễn đàn như các Hội nghị Quốc tế IEEE và Hội nghị Thị giác Máy tính Châu Âu (ECCV).
Khi ảnh đi sâu hơn qua mạng nơ-ron, các đối tượng nhỏ có thể mất chi tiết hoặc biến mất hoàn toàn. Vì vậy, các model thị giác máy tính hiện đại như Ultralytics YOLO11 đặc biệt chú trọng cải thiện khả năng trích xuất đặc trưng. Tiếp theo, hãy cùng tìm hiểu các khái niệm cốt lõi về feature map và mạng kim tự tháp đặc trưng để hiểu rõ hơn.
Feature map và biểu diễn tỷ lệ#
Khi ảnh đầu vào, chẳng hạn ảnh viễn thám, được đưa vào mạng nơ-ron, ảnh sẽ dần được chuyển thành feature map. Đây là các biểu diễn giản lược của ảnh, làm nổi bật những mẫu hình ảnh như cạnh, hình dạng và kết cấu.
Khi mạng đi sâu hơn, kích thước không gian của các feature map này giảm xuống. Việc giảm kích thước giúp model chạy hiệu quả và tập trung vào thông tin cấp cao. Tuy nhiên, feature map thu nhỏ và nằm sâu trong mạng cũng làm giảm chi tiết không gian.
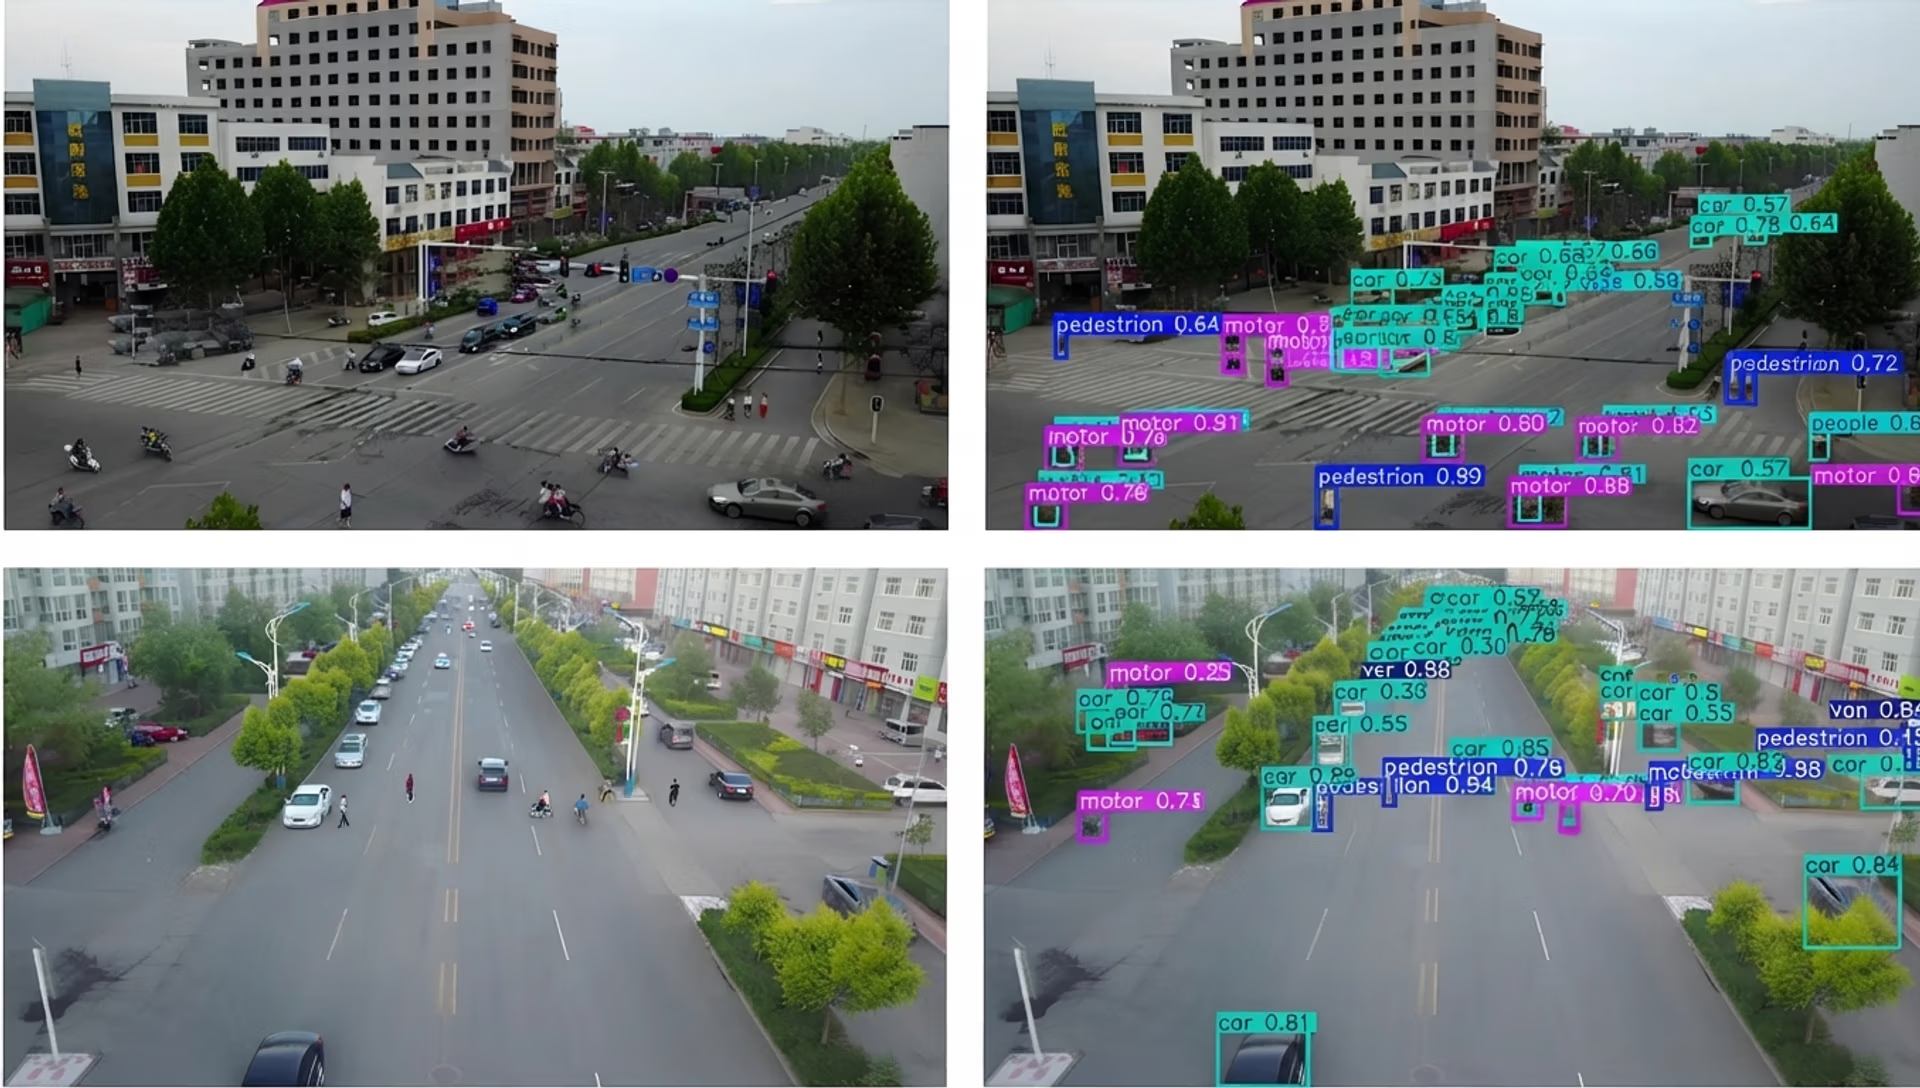
Hình 4. Trích xuất đặc trưng là yếu tố then chốt để phát hiện đối tượng nhỏ. (Nguồn)
Trong khi đối tượng lớn giữ lại đủ thông tin hình ảnh để phát hiện chính xác, các mục tiêu nhỏ có thể mất đi chi tiết quan trọng chỉ sau vài lớp mạng. Khi đó, model có thể khó nhận ra rằng đối tượng nhỏ thậm chí tồn tại. Đây là một trong những lý do chính khiến các model phát hiện đối tượng deep learning bỏ sót đối tượng nhỏ.
Mạng kim tự tháp đặc trưng và học đa tỷ lệ#
Mạng kim tự tháp đặc trưng, thường được gọi là FPN, được giới thiệu để khắc phục tình trạng mất chi tiết không gian. Chúng hoạt động như một module hỗ trợ, kết hợp thông tin từ nhiều lớp để model phát hiện đối tượng nhỏ hiệu quả hơn. Quá trình này còn được gọi là tổng hợp và hợp nhất đặc trưng.
Các lớp nông cung cấp chi tiết không gian tinh, trong khi các lớp sâu hơn bổ sung ngữ cảnh ngữ nghĩa, cho phép học đặc trưng đa tỷ lệ hiệu quả. Khác với upsampling đơn giản chỉ phóng to feature map, FPN bảo toàn thông tin có ý nghĩa và cải thiện khả năng phát hiện đối tượng nhỏ.
Các phương pháp hiện đại phát triển dựa trên ý tưởng này, sử dụng hợp nhất đặc trưng thích ứng và thiết kế nhận biết ngữ cảnh để tăng cường hơn nữa khả năng phát hiện mục tiêu nhỏ. Nói cách khác, FPN giúp model đồng thời nhận biết cả bức tranh tổng thể lẫn các chi tiết rất nhỏ. Tối ưu hóa này rất cần thiết khi đối tượng có kích thước nhỏ.
Quá trình phát triển của các model phát hiện đối tượng để xử lý đối tượng nhỏ#
Dưới đây là khái quát về quá trình phát triển và cải tiến của các model phát hiện đối tượng theo thời gian, giúp phát hiện tốt hơn các đối tượng có kích thước khác nhau, kể cả những đối tượng rất nhỏ:
- Các phương pháp phát hiện ban đầu: Những phương pháp phát hiện đối tượng đầu tiên dựa vào đặc trưng được thiết kế thủ công và thuật toán dựa trên quy tắc, bắt nguồn từ xử lý ảnh cổ điển. Vì các đặc trưng này cố định nên hiệu suất giảm khi xử lý các ảnh khác nhau.
- Sự ra đời của machine learning và deep learning: Việc ứng dụng machine learning và deep learning đánh dấu bước chuyển lớn trong nghiên cứu phát hiện đối tượng. Thay vì dựa vào các quy tắc định sẵn, mạng nơ-ron học biểu diễn hình ảnh trực tiếp từ dữ liệu huấn luyện, cải thiện khả năng thích ứng với các kích thước đối tượng và cảnh khác nhau.
- Mạng tích chập: Các mạng nơ-ron này học cách nhận biết mẫu trong ảnh. Mỗi lớp nắm bắt những chi tiết khác nhau, bắt đầu từ các cạnh và màu sắc đơn giản, rồi đến hình dạng, và cuối cùng là toàn bộ đối tượng, khiến chúng trở thành thành phần thiết yếu của thị giác máy tính hiện đại.
- Bộ phát hiện vật thể hai giai đoạn: Các bộ phát hiện hai giai đoạn, chẳng hạn như Faster R-CNN do Ren và cộng sự giới thiệu, trước tiên tạo ra các vùng ứng viên rồi phân loại chúng. Cách tiếp cận này cải thiện độ chính xác khi phát hiện vật thể nhỏ, nhưng làm tăng chi phí tính toán và giảm hiệu năng thời gian thực.
- Bộ phát hiện đối tượng một giai đoạn: Các bộ phát hiện một giai đoạn, chẳng hạn SSD (bộ phát hiện một lần) và dòng YOLO (Bạn chỉ nhìn một lần), bao gồm Ultralytics YOLOv5 và Ultralytics YOLOv8 ra mắt sau này, thực hiện phát hiện chỉ trong một lượt. Thiết kế này cải thiện đáng kể tốc độ inference trong khi vẫn duy trì độ chính xác cạnh tranh.
- Các model hiện đại tiên tiến nhất: Những model phát hiện đối tượng mới hơn chú trọng hơn vào hiệu suất thời gian thực và triển khai biên. Các phiên bản model Ultralytics YOLO gần đây, như Ultralytics YOLO11 và Ultralytics YOLO26, được thiết kế để cân bằng độ chính xác cao với suy luận độ trễ thấp, phù hợp để phát hiện đối tượng ở mọi kích thước, kể cả mục tiêu nhỏ, trên thiết bị có năng lực tính toán hạn chế.
Sử dụng Ultralytics YOLO11 cho các trường hợp ứng dụng phát hiện đối tượng nhỏ#
Giờ đây khi đã hiểu rõ hơn về cách thức hoạt động của việc phát hiện đối tượng nhỏ, hãy cùng xem một vài ứng dụng thực tế có thể sử dụng Ultralytics YOLO11.
UAV và ảnh hàng không#
Hãy hình dung một chiếc drone bay cao phía trên con phố đông đúc trong thành phố. Từ độ cao đó, ô tô, xe đạp và cả con người chỉ còn chiếm vài pixel trên màn hình.
Các module UAV và chụp ảnh hàng không thường ghi lại những cảnh như vậy, trong đó đối tượng cần quan tâm rất nhỏ và bị bao quanh bởi hậu cảnh phức tạp, khiến model thị giác máy tính khó phát hiện.
Trong những tình huống như vậy, Ultralytics YOLO11 có thể là lựa chọn model lý tưởng. Ví dụ, drone được trang bị model như YOLO11 và tinh chỉnh trên các dataset hàng không như VisDrone có thể giám sát giao thông theo thời gian thực, phát hiện phương tiện, người đi xe đạp và người đi bộ khi họ di chuyển trong khung cảnh, ngay cả khi mỗi đối tượng chỉ chiếm một phần nhỏ của ảnh. Điều này giúp ra quyết định nhanh hơn và thu được thông tin chính xác hơn trong các ứng dụng như quản lý giao thông, an toàn công cộng hoặc quy hoạch đô thị.
Robot học và tự động hóa#
Robot thường được sử dụng trong những môi trường đòi hỏi độ chính xác và thời điểm xử lý phải được đảm bảo. Trong các môi trường như nhà kho, nhà máy và trang trại, robot có thể cần nhận diện các vật thể rất nhỏ, chẳng hạn một chi tiết trên dây chuyền lắp ráp, nhãn trên kiện hàng hoặc chồi cây nhỏ ngoài đồng, rồi phản hồi nhanh chóng.
Việc phát hiện các đối tượng có kích thước này có thể phức tạp, đặc biệt khi chúng chỉ xuất hiện dưới dạng vài pixel trong luồng camera hoặc bị các đối tượng khác che khuất một phần. Bỏ sót những chi tiết nhỏ này có thể làm chậm quá trình tự động hóa hoặc ảnh hưởng đến khả năng hoàn thành tác vụ của robot.
Ultralytics YOLO11 có thể tạo ra khác biệt trong những tình huống này. Khả năng trích xuất đặc trưng được cải thiện và inference nhanh giúp robot phát hiện đối tượng nhỏ theo thời gian thực và hành động ngay lập tức.
Ultralytics YOLO11 cũng hỗ trợ phân đoạn instance, giúp robot hiểu chính xác hơn ranh giới đối tượng và điểm gắp, thay vì chỉ xác định BBox tổng quát. Ví dụ, cánh tay robot tích hợp YOLO11 có thể phát hiện các linh kiện nhỏ trên băng chuyền, phân đoạn chính xác hình dạng của chúng và gắp lên trước khi chúng di chuyển khỏi tầm với, giúp hệ thống duy trì hiệu suất và độ tin cậy.
Điều gì giúp Ultralytics YOLO11 hiệu quả trong việc phát hiện đối tượng nhỏ#
Với rất nhiều model thị giác máy tính hiện có, bạn có thể thắc mắc điều gì khiến Ultralytics YOLO11 nổi bật.
Dưới đây là một vài lý do khiến Ultralytics YOLO11 là lựa chọn phù hợp cho các ứng dụng cần phát hiện đối tượng nhỏ:
- Trích xuất đặc trưng tốt hơn: YOLO11 sử dụng kiến trúc backbone và neck được cải tiến để nâng cao khả năng trích xuất đặc trưng, giúp phát hiện đối tượng chính xác hơn.
- Hệ sinh thái và tính dễ sử dụng: Gói Python Ultralytics là một thư viện cung cấp các hàm tích hợp để tải, huấn luyện, validation và triển khai những model như YOLO11. Vì các quy trình này chỉ cần vài dòng code, các nhóm có thể nhanh chóng thử nghiệm và tinh chỉnh model để phát hiện đối tượng nhỏ.
- Tối ưu cho triển khai trên edge: Ultralytics YOLO11 có thể hoạt động hiệu quả trên các thiết bị edge như NVIDIA Jetson, Raspberry Pi và hệ thống camera công nghiệp. Nói đơn giản, model cho phép thực hiện các tác vụ vision AI theo thời gian thực trực tiếp trên thiết bị.
Các chiến lược thực tế khi phát hiện đối tượng nhỏ bằng Ultralytics YOLO11#
Ngoài việc sử dụng model như Ultralytics YOLO11, cách chuẩn bị annotation, dataset tổng thể và quy trình huấn luyện model có thể tạo ra khác biệt đáng kể về hiệu suất phát hiện. Trong quá trình suy luận, suy luận ảnh chia ô SAHI cũng có thể giúp phát hiện các đối tượng rất nhỏ trong ảnh độ phân giải cao.
Dưới đây là tổng quan nhanh về những điểm cần tập trung:
- Tăng cường dữ liệu phù hợp: Các phương pháp tăng cường dữ liệu nhẹ, chẳng hạn thay đổi tỷ lệ hoặc crop, có thể giúp model khái quát hóa tốt hơn trên ảnh mới. Tuy nhiên, tăng cường quy mô lớn quá mạnh có thể làm biến dạng hoặc loại bỏ đối tượng nhỏ, khiến model khó học hơn.
- Phân tích các trường hợp lỗi: Phân tích những trường hợp model bỏ sót hoặc nhận diện nhầm đối tượng giúp thiết lập đường cơ sở và tìm hiểu liệu vấn đề bắt nguồn từ bộ dữ liệu, thông tin bị mất trong quá trình trích xuất đặc trưng hay cần điều chỉnh các thiết lập huấn luyện.
- Cấu trúc bộ dữ liệu: Bộ dữ liệu của bạn cần có đủ ví dụ về đối tượng nhỏ để model học được các mẫu có ý nghĩa, đồng thời cần được cân bằng để đối tượng lớn không lấn át đối tượng nhỏ trong quá trình huấn luyện.
Điểm chính cần ghi nhớ#
Phát hiện đối tượng nhỏ rất khó vì các mục tiêu nhỏ mất chi tiết khi ảnh đi qua model thị giác máy tính. Ultralytics YOLO11 cải thiện khả năng bảo toàn các chi tiết này, giúp việc phát hiện đối tượng nhỏ đáng tin cậy hơn mà không ảnh hưởng đến hiệu suất thời gian thực. Sự cân bằng này cho phép YOLO11 hỗ trợ phát hiện chính xác và hiệu quả trong các ứng dụng thực tế.
Tham gia cộng đồng đang phát triển của chúng tôi! Khám phá repository GitHub để tìm hiểu thêm về AI. Khám phá những đổi mới như thị giác máy tính trong bán lẻ và AI trong ngành ô tô trên các trang giải pháp của chúng tôi. Để bắt đầu xây dựng với thị giác máy tính ngay hôm nay, hãy xem các tùy chọn cấp phép.
Được viết bởi
Nhà sáng tạo nội dung · Ultralytics
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









