Cách Ultralytics YOLO26 huấn luyện thông minh hơn với ProgLoss, STAL và MuSGD
Tìm hiểu cách Ultralytics YOLO26 huấn luyện đáng tin cậy hơn nhờ Progressive Loss Balancing, Small-Target-Aware Label Assignment và optimizer MuSGD.
Tuần trước, chúng tôi đã phát hành Ultralytics YOLO26, thiết lập tiêu chuẩn mới cho các model thị giác máy tính ưu tiên thiết bị biên và hoạt động theo thời gian thực. Tương tự các model YOLO của Ultralytics trước đây, chẳng hạn như Ultralytics YOLO11, YOLO26 hỗ trợ các tác vụ thị giác máy tính cốt lõi mà người dùng đã quen thuộc, bao gồm phát hiện đối tượng, phân đoạn instance và ước tính tư thế.
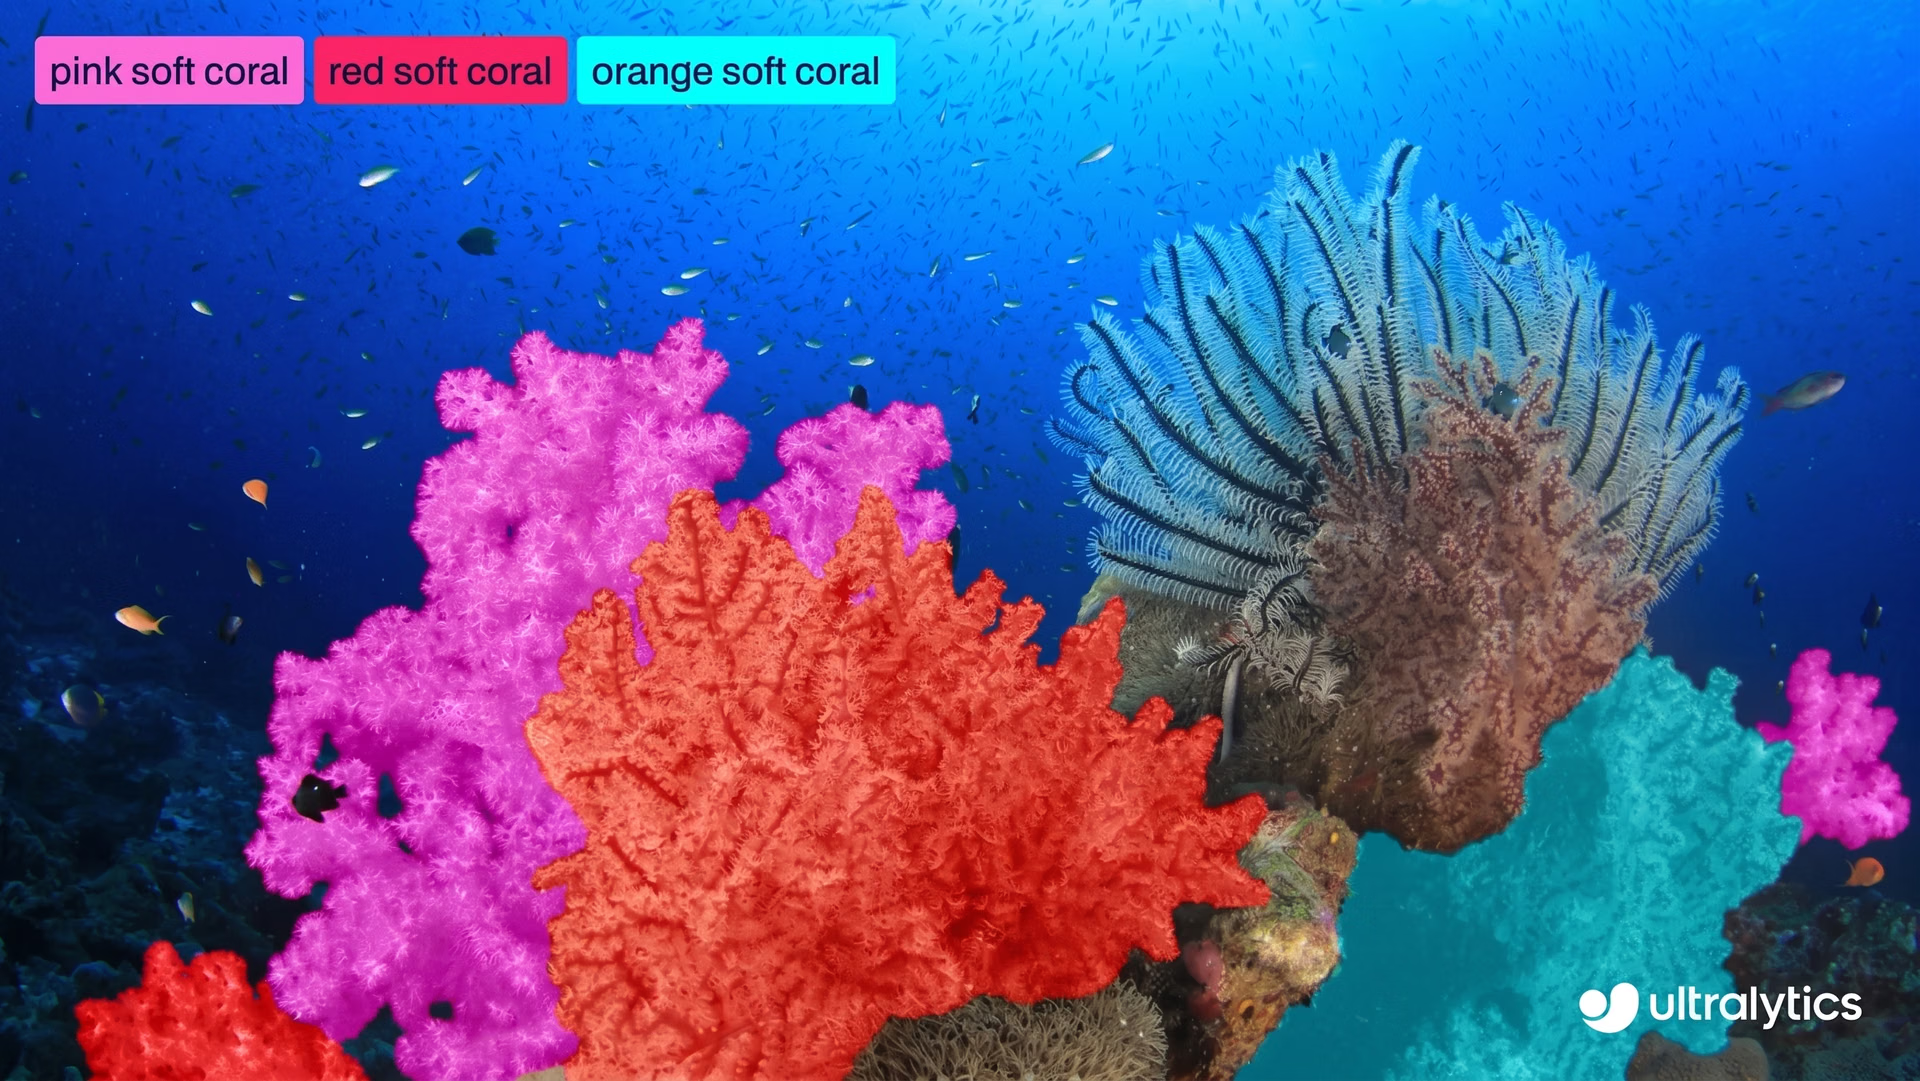
Hình 1. Ví dụ sử dụng Ultralytics YOLO26 để phân đoạn đối tượng trong ảnh.
Tuy nhiên, Ultralytics YOLO26 không chỉ là một bản cập nhật nhỏ. Dù các tác vụ được hỗ trợ có thể trông quen thuộc, model mới này đánh dấu một bước tiến đổi mới trong cách huấn luyện các model thị giác máy tính. Với YOLO26, trọng tâm không chỉ là hiệu quả suy luận mà còn là làm cho quá trình huấn luyện ổn định hơn.
Ultralytics YOLO26 được thiết kế dựa trên toàn bộ vòng đời huấn luyện. Điều này giúp hội tụ nhanh hơn, các lần chạy huấn luyện đáng tin cậy hơn và hành vi của model nhất quán hơn. Những cải tiến này đặc biệt quan trọng trong quy trình thực tế, nơi độ tin cậy của quá trình huấn luyện ảnh hưởng trực tiếp đến tốc độ lặp lại và triển khai model.
Để đạt được điều này, Ultralytics YOLO26 giới thiệu một số cải tiến huấn luyện có mục tiêu như Cân bằng Loss Tiến triển (ProgLoss), Gán nhãn có xét đến mục tiêu nhỏ (STAL) và optimizer MuSGD. Kết hợp với nhau, những thay đổi này cải thiện cách cân bằng loss trong quá trình học, cách gán nhãn và cách quá trình tối ưu hóa diễn biến theo thời gian.
Trong bài viết này, chúng ta sẽ tìm hiểu cách từng cơ chế hoạt động và lý do chúng giúp Ultralytics YOLO26 dễ huấn luyện hơn, đồng thời đáng tin cậy hơn khi mở rộng quy mô. Bắt đầu nào!
Ultralytics YOLO26: Được thiết kế để huấn luyện thông minh hơn, không chỉ chạy nhanh hơn#
Ultralytics YOLO26 đơn giản hóa toàn bộ pipeline suy luận ngay từ thiết kế bằng cách loại bỏ sự phụ thuộc vào các bước hậu xử lý như Non-Maximum Suppression. Thay vì tạo ra nhiều dự đoán chồng lấn rồi lọc chúng sau đó, YOLO26 trực tiếp tạo ra kết quả phát hiện cuối cùng từ mạng.
Điều này biến YOLO26 thành model end-to-end, trong đó quá trình dự đoán, xử lý trùng lặp và tạo đầu ra cuối cùng đều được học ngay bên trong mạng. Cách tiếp cận này đơn giản hóa việc triển khai và cải thiện hiệu quả suy luận, đồng thời định hình cách model học trong quá trình huấn luyện.
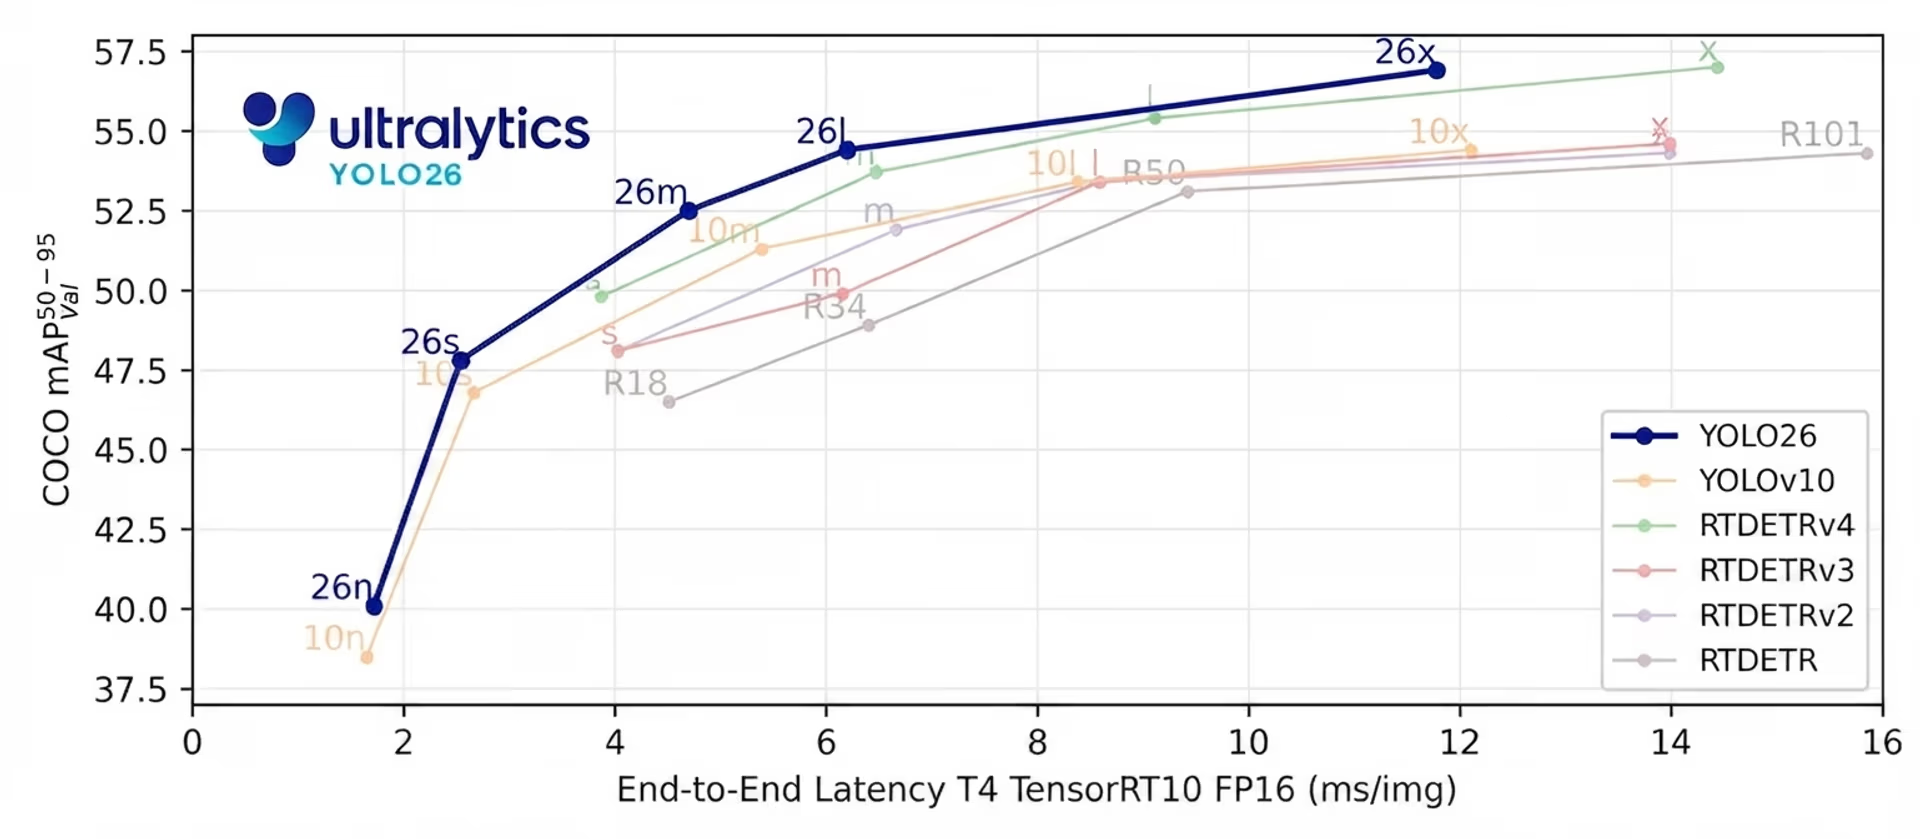
Hình 2. YOLO26 mang đến khả năng suy luận end-to-end, không cần NMS, hiện đại nhất (Nguồn)
Trong một hệ thống end-to-end như thế này, quá trình huấn luyện và suy luận có mối liên hệ chặt chẽ. Vì không có giai đoạn hậu xử lý bên ngoài để hiệu chỉnh dự đoán về sau, model phải học cách đưa ra quyết định rõ ràng và tự tin ngay trong quá trình huấn luyện.
Điều này khiến việc căn chỉnh mục tiêu huấn luyện với hành vi suy luận trở nên đặc biệt quan trọng. Bất kỳ sự không khớp nào giữa cách huấn luyện model và cách sử dụng model khi suy luận đều có thể dẫn đến quá trình học không ổn định hoặc hội tụ chậm hơn.
Ultralytics YOLO26 giải quyết vấn đề này bằng cách thiết kế quy trình huấn luyện dựa trên cách sử dụng trong thực tế ngay từ đầu. Thay vì chỉ tập trung vào tốc độ suy luận, hệ thống huấn luyện được xây dựng để hỗ trợ quá trình học ổn định trong các lượt huấn luyện dài, hội tụ nhất quán trên nhiều kích thước model từ Nano đến Extra Large và đạt hiệu năng mạnh mẽ trên các bộ dữ liệu đa dạng.
Hai detection head cải thiện khả năng học của Ultralytics YOLO26 như thế nào#
Một trong những cải tiến then chốt trong quá trình huấn luyện Ultralytics YOLO26 phát triển dựa trên phương pháp huấn luyện sử dụng hai head đã được áp dụng trong các model YOLO trước đây. Trong các model phát hiện đối tượng, head là phần của mạng chịu trách nhiệm tạo dự đoán.
Nói cách khác, detection head học cách dự đoán vị trí của đối tượng trong ảnh và xác định đó là đối tượng gì. Chúng thực hiện việc này bằng cách hồi quy tọa độ bounding box, tức là học cách ước tính vị trí và kích thước của từng đối tượng trong ảnh đầu vào.
Trong quá trình huấn luyện, model học bằng cách giảm thiểu loss, một giá trị số đo mức độ sai lệch giữa dự đoán của model với đáp án chính xác, hay ground truth. Loss thấp hơn nghĩa là dự đoán của model gần với ground truth hơn, còn loss cao hơn cho thấy sai số lớn hơn. Phép tính loss định hướng cách model cập nhật tham số trong quá trình huấn luyện.
Ultralytics YOLO26 sử dụng hai detection head trong quá trình huấn luyện; chúng dùng chung model nền tảng nhưng phục vụ các mục đích khác nhau. Head one-to-one được sử dụng khi suy luận. Head này học cách ghép mỗi đối tượng với một dự đoán duy nhất, có độ tin cậy cao, điều thiết yếu đối với thiết kế end-to-end, không cần NMS của YOLO26.
Trong khi đó, head one-to-many chỉ được sử dụng khi huấn luyện. Head này cho phép ghép nhiều dự đoán với cùng một đối tượng, nhờ đó cung cấp tín hiệu giám sát dày đặc hơn. Tín hiệu học phong phú hơn này giúp ổn định quá trình huấn luyện và cải thiện độ chính xác, đặc biệt là ở những giai đoạn đầu.
Trong Ultralytics YOLO26, cả hai head đều sử dụng cùng một phép tính loss cho hồi quy bounding box và phân loại. Các triển khai trước đây áp dụng tỷ lệ cân bằng cố định giữa hai tín hiệu loss này trong suốt quá trình huấn luyện.
Tuy nhiên, trên thực tế, mức độ quan trọng của từng head thay đổi theo thời gian. Giám sát dày đặc hữu ích nhất ở giai đoạn đầu, trong khi việc căn chỉnh với hành vi suy luận trở nên quan trọng hơn ở giai đoạn sau của quá trình huấn luyện. Ultralytics YOLO26 được thiết kế dựa trên nhận định này, dẫn trực tiếp đến cách model tái cân bằng các tín hiệu học khi quá trình huấn luyện tiến triển.
Ultralytics YOLO26 sử dụng Progressive Loss Balancing#
Vậy Ultralytics YOLO26 xử lý những nhu cầu học tập thay đổi này trong quá trình huấn luyện như thế nào? Model sử dụng Progressive Loss Balancing để điều chỉnh trọng số của các tín hiệu học theo thời gian.
ProgLoss hoạt động bằng cách điều chỉnh linh hoạt mức đóng góp của mỗi head vào tổng loss khi quá trình huấn luyện tiến triển. Ở giai đoạn đầu, head one-to-many được đặt trọng số cao hơn để ổn định quá trình học và cải thiện recall. Khi quá trình huấn luyện tiếp tục, tỷ lệ cân bằng dần chuyển sang head one-to-one, giúp việc huấn luyện căn chỉnh sát hơn với hành vi suy luận.
Quá trình chuyển đổi dần này giúp Ultralytics YOLO26 học theo đúng trình tự. Thay vì buộc model tối ưu đồng thời các mục tiêu cạnh tranh, Progressive Loss Balancing ưu tiên tín hiệu học hữu ích nhất ở mỗi giai đoạn huấn luyện. Kết quả là quá trình hội tụ mượt mà hơn, ít lượt huấn luyện bất ổn hơn và hiệu năng cuối cùng nhất quán hơn.
STAL giúp Ultralytics YOLO26 học từ các đối tượng siêu nhỏ như thế nào#
Một cải tiến thú vị khác trong quá trình huấn luyện Ultralytics YOLO26 liên quan đến cách model gán mục tiêu huấn luyện cho các dự đoán, một quy trình được gọi là gán nhãn. Quy trình này chịu trách nhiệm ghép các đối tượng ground truth với những dự đoán ứng viên, thường được gọi là anchor.
Các kết quả ghép này xác định dự đoán nào nhận được giám sát và đóng góp vào loss. Ultralytics YOLO26 phát triển dựa trên một phương pháp gán nhãn hiện có gọi là Task Alignment Learning (TAL), được thiết kế để căn chỉnh tốt hơn quá trình phân loại và định vị trong khi huấn luyện.
Mặc dù TAL hoạt động tốt với hầu hết đối tượng, quá trình huấn luyện đã cho thấy một hạn chế quan trọng. Trong quá trình ghép, các đối tượng rất nhỏ có thể bị loại bỏ hoàn toàn. Trên thực tế, các đối tượng nhỏ hơn khoảng 8 pixel trong ảnh đầu vào 640 pixel thường không được gán anchor nào. Khi điều này xảy ra, model nhận được rất ít hoặc không nhận được giám sát cho những đối tượng đó, khiến việc học cách phát hiện chúng một cách đáng tin cậy trở nên khó khăn.
Để giải quyết vấn đề này, Ultralytics YOLO26 giới thiệu Small-Target-Aware Label Assignment (STAL). STAL điều chỉnh quy trình gán nhãn để đảm bảo các đối tượng nhỏ không bị bỏ qua trong quá trình huấn luyện. Cụ thể, phương pháp này áp dụng tối thiểu bốn phép gán anchor cho các đối tượng nhỏ hơn 8 pixel. Điều này đảm bảo ngay cả những đối tượng siêu nhỏ cũng luôn đóng góp vào loss huấn luyện.
Bằng cách tăng cường giám sát cho các mục tiêu nhỏ, STAL cải thiện độ ổn định khi học và hiệu năng phát hiện trong các tình huống thường có đối tượng nhỏ hoặc ở xa. Cải tiến này đặc biệt quan trọng đối với các ứng dụng YOLO26 ưu tiên edge, chẳng hạn như ảnh chụp từ trên không, robot và các hệ thống Internet vạn vật (IoT), nơi đối tượng thường nhỏ, ở xa hoặc chỉ hiển thị một phần và việc phát hiện đáng tin cậy là rất quan trọng.
Ultralytics YOLO26 giới thiệu optimizer MuSGD#
Để hỗ trợ quá trình huấn luyện ổn định và dễ dự đoán hơn, Ultralytics YOLO26 cũng giới thiệu một optimizer mới có tên MuSGD. Optimizer này được thiết kế để cải thiện khả năng hội tụ và độ tin cậy khi huấn luyện các model phát hiện end-to-end, đặc biệt khi kích thước model và độ phức tạp của quá trình huấn luyện tăng lên.
Để mạng nơ-ron có thể học và từ đó điều chỉnh trọng số tương ứng trong quá trình huấn luyện, chúng ta tính toán sai số (còn gọi là "loss"). Vì vậy, model dùng giá trị loss để đo mức độ sai lệch trong dự đoán, tính gradient cho biết cách các tham số cần thay đổi, rồi cập nhật những tham số đó để giảm sai số. Gradient descent ngẫu nhiên (SGD) là một optimizer được sử dụng rộng rãi để thực hiện các cập nhật này, giúp quá trình huấn luyện hiệu quả và có khả năng mở rộng.
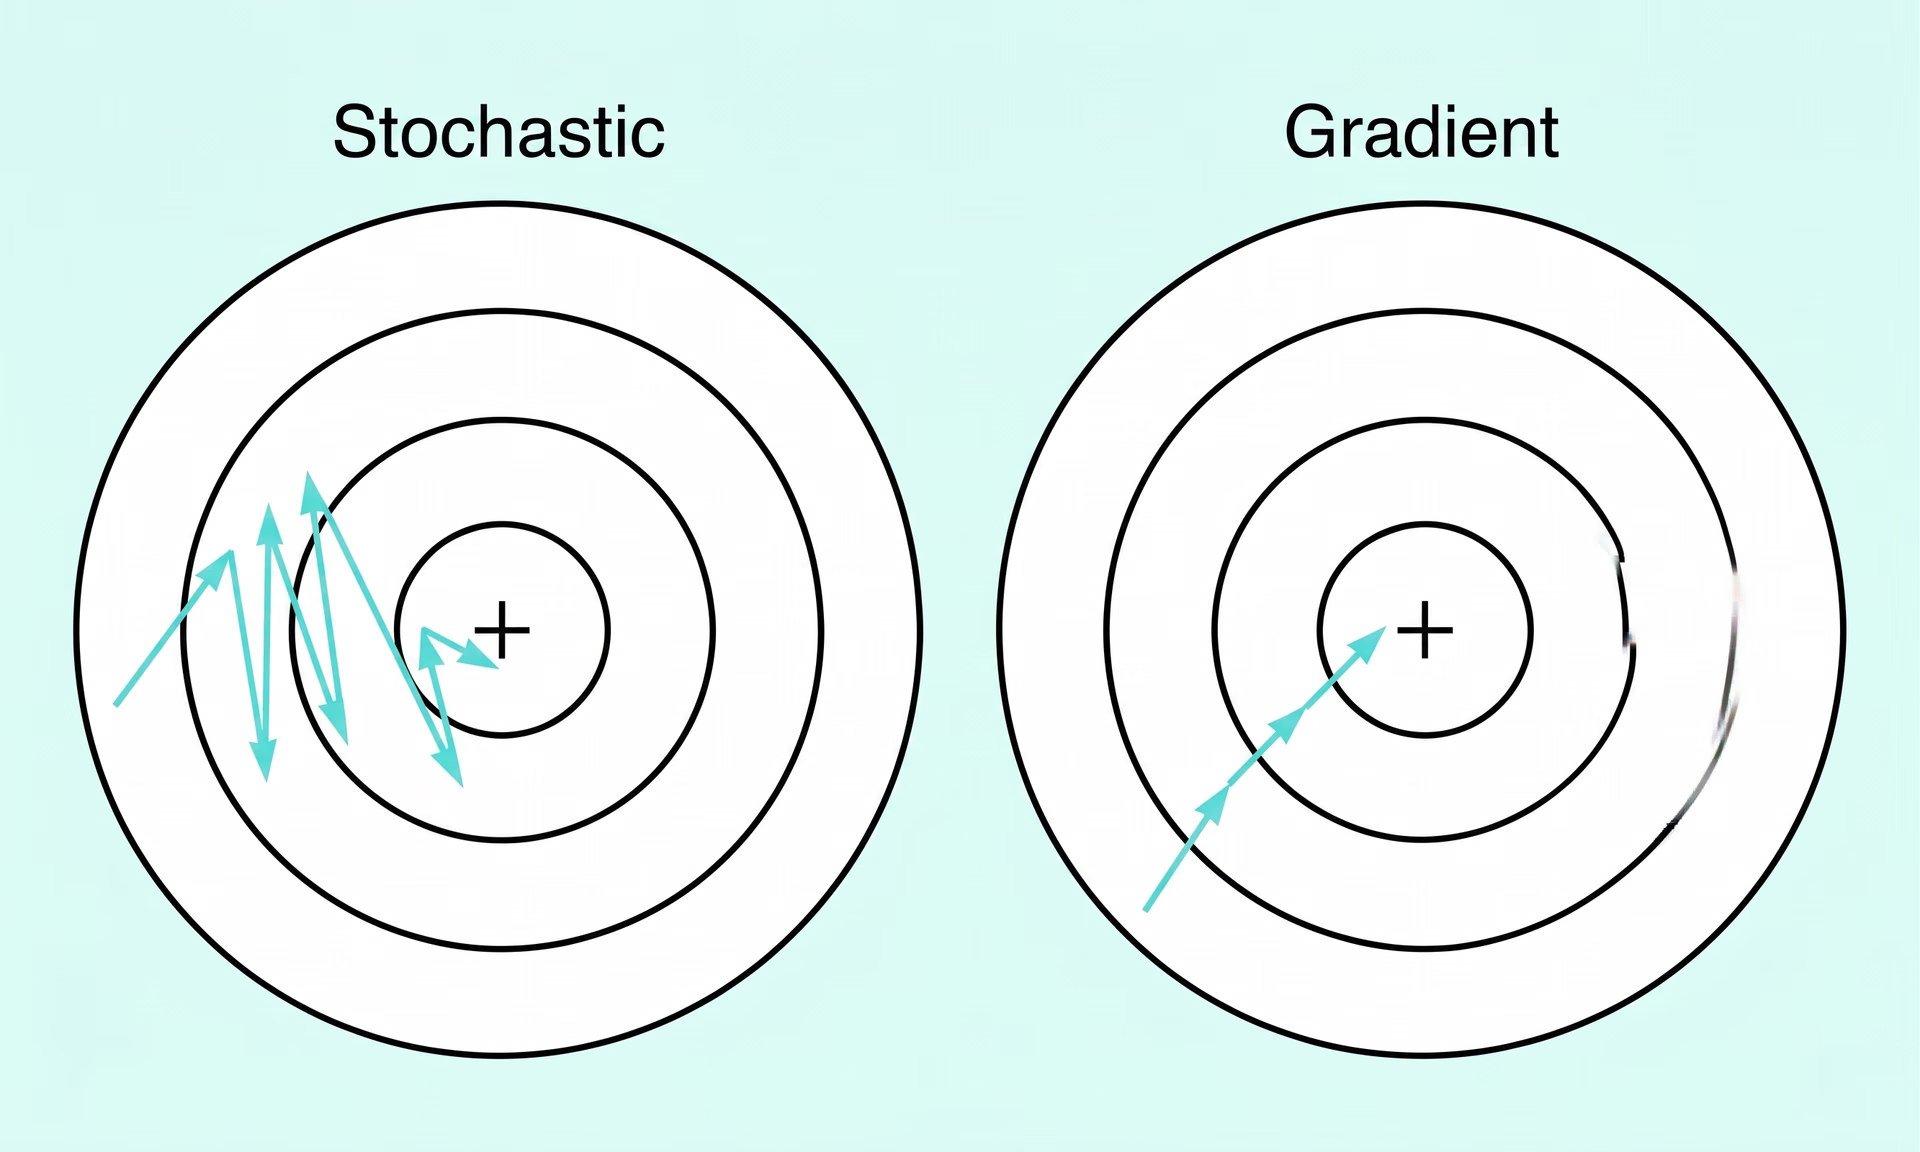
Hình 3. Gradient descent ngẫu nhiên so với gradient descent (Nguồn)
MuSGD phát triển dựa trên nền tảng quen thuộc này bằng cách tích hợp các ý tưởng tối ưu hóa lấy cảm hứng từ Muon, một phương pháp được sử dụng trong huấn luyện mô hình ngôn ngữ lớn. Các ý tưởng này chịu ảnh hưởng từ những tiến bộ gần đây như Kimi K2 của Moonshot AI, model cho thấy hành vi huấn luyện được cải thiện nhờ cập nhật tham số có cấu trúc hơn.
Ultralytics YOLO26 sử dụng chiến lược cập nhật kết hợp. Một số tham số được cập nhật bằng cách kết hợp các bước cập nhật lấy cảm hứng từ Muon với SGD, trong khi các tham số khác chỉ sử dụng SGD. Nhờ đó, YOLO26 có thể bổ sung cấu trúc cho quy trình tối ưu hóa mà vẫn duy trì độ mạnh mẽ và khả năng tổng quát hóa đã giúp SGD phát huy hiệu quả.
Kết quả là quá trình tối ưu hóa mượt mà hơn, hội tụ nhanh hơn và hành vi huấn luyện dễ dự đoán hơn trên nhiều kích thước model, khiến MuSGD trở thành yếu tố then chốt giúp Ultralytics YOLO26 dễ huấn luyện hơn và đáng tin cậy hơn ở quy mô lớn.
Tầm quan trọng của các cải tiến huấn luyện trong Ultralytics YOLO26#
Các cải tiến huấn luyện của Ultralytics YOLO26, kết hợp với những tính năng then chốt như thiết kế end-to-end, không cần NMS và ưu tiên edge, giúp model dễ huấn luyện hơn và đáng tin cậy hơn ở quy mô lớn. Có thể bạn đang tự hỏi điều đó thực sự có ý nghĩa gì đối với các ứng dụng thị giác máy tính.
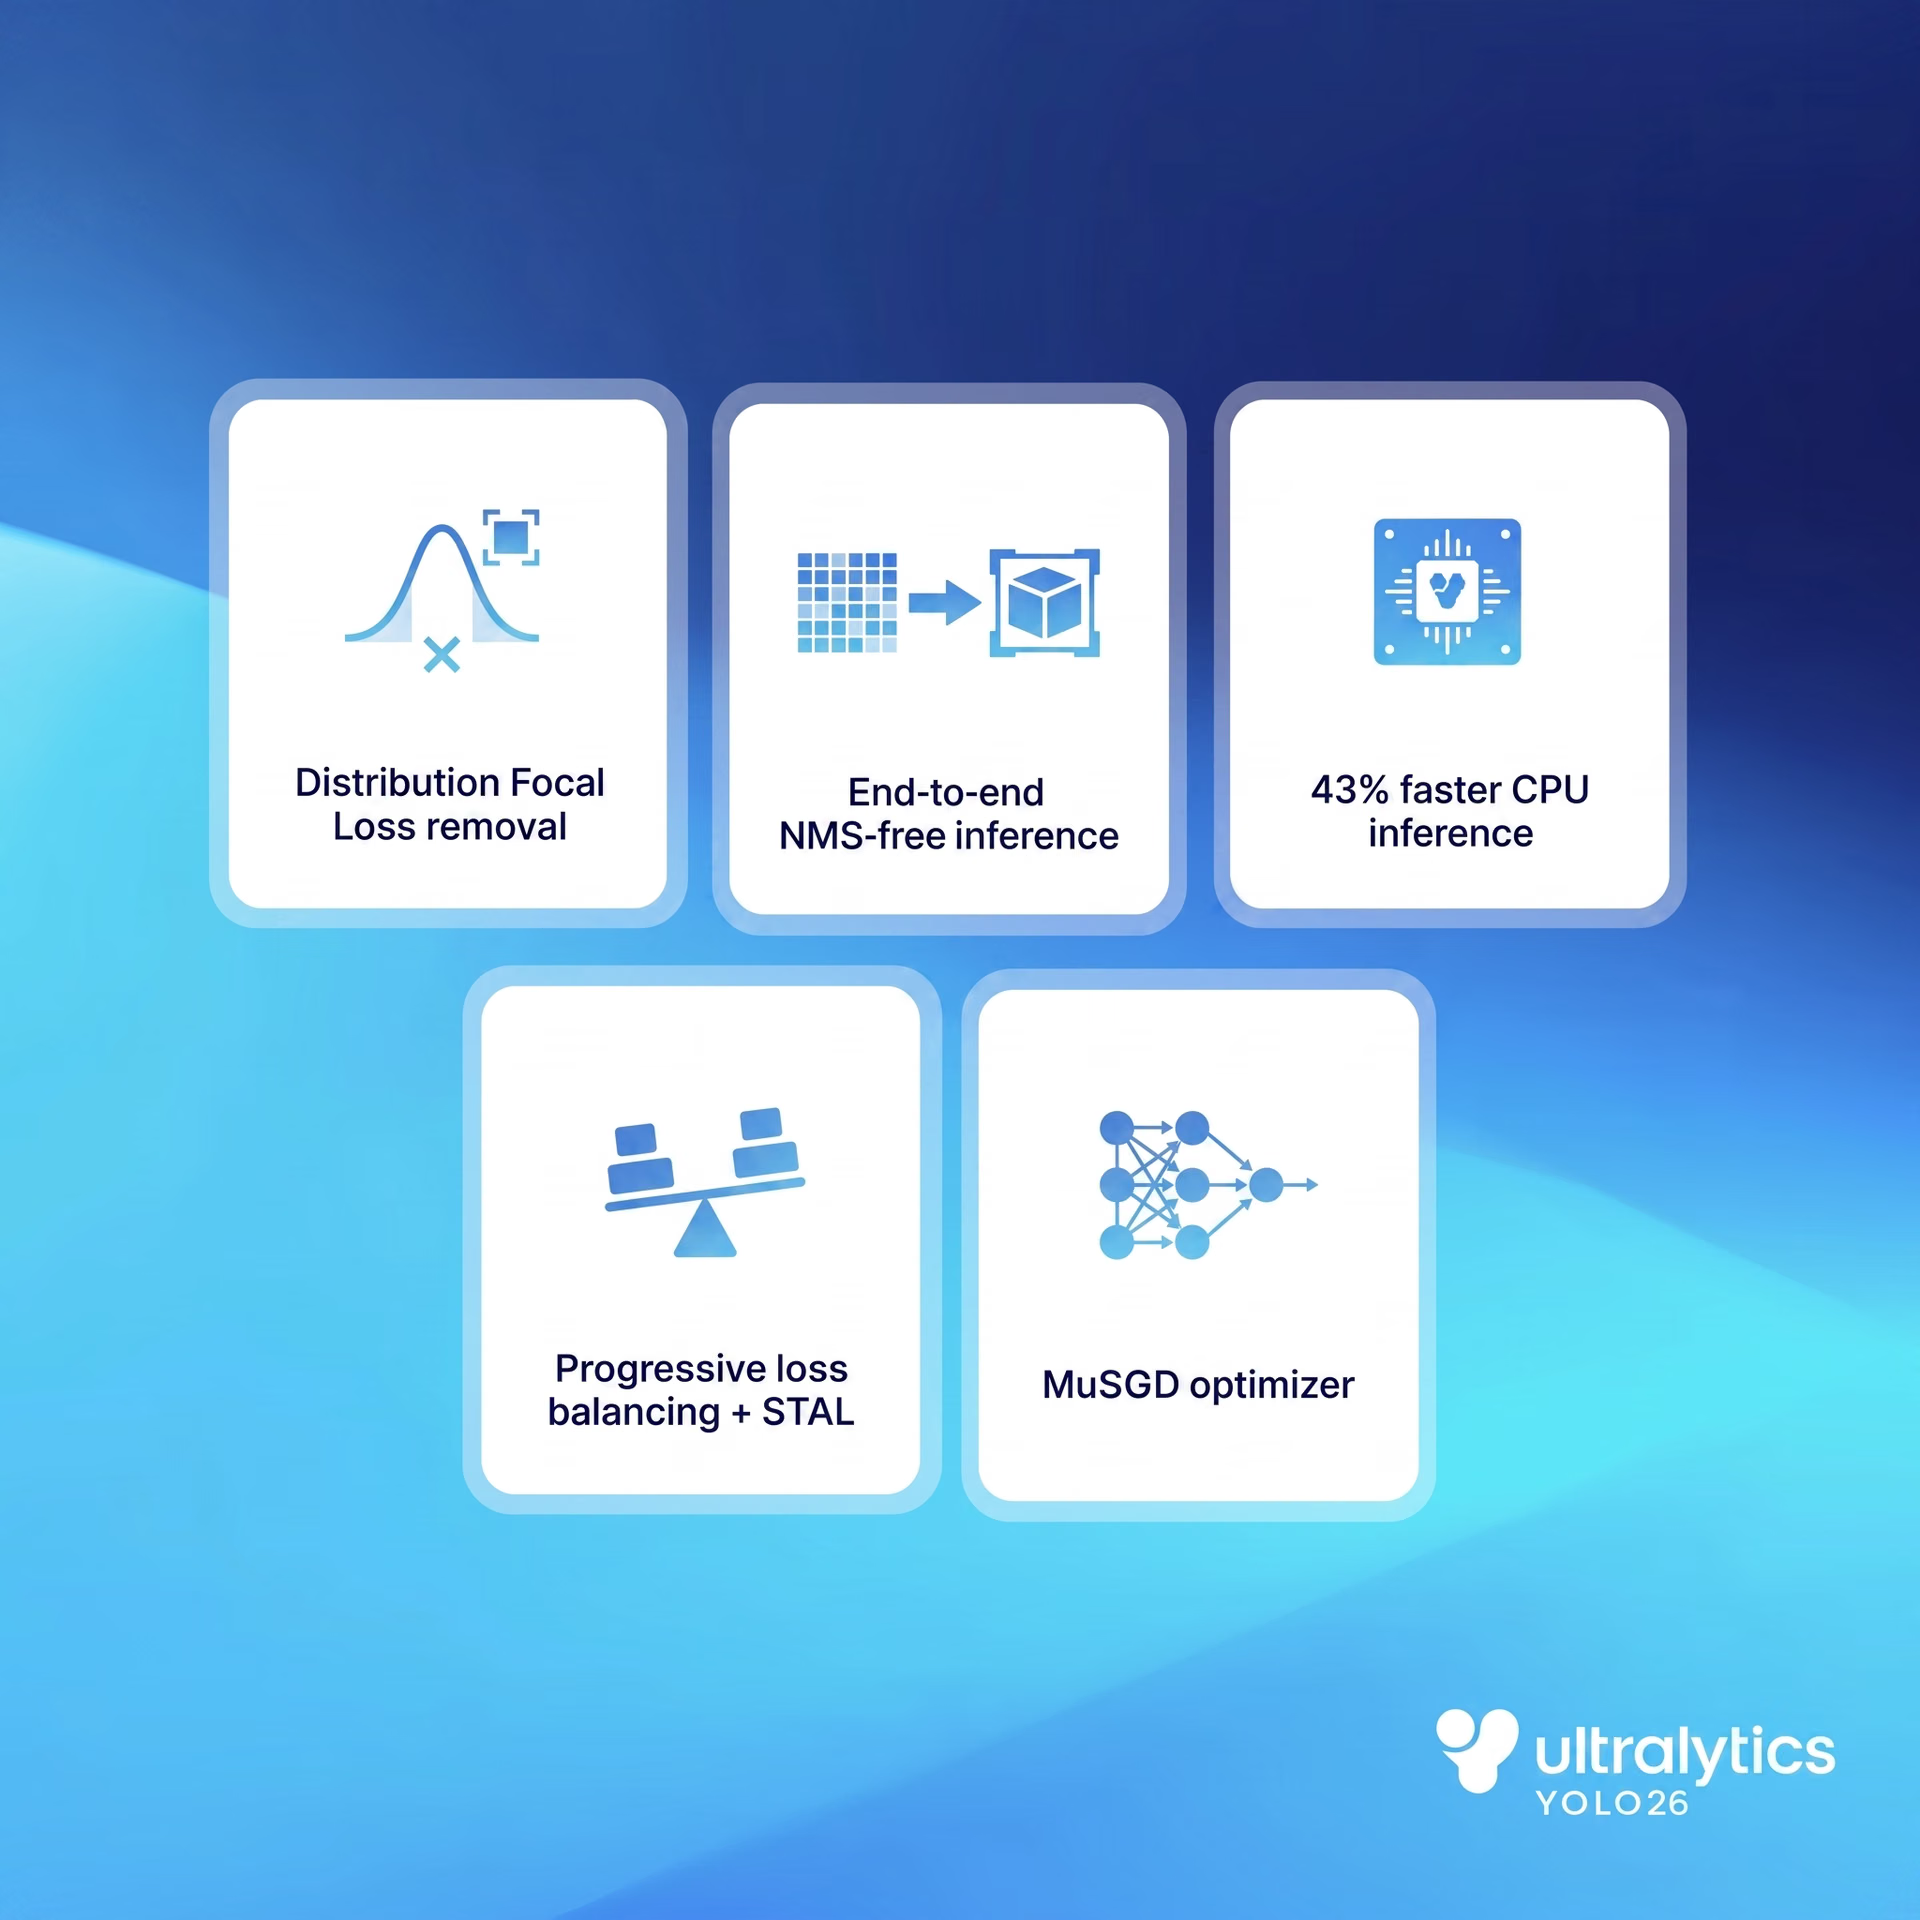
Hình 4. Các tính năng then chốt của YOLO26 (Nguồn)
Trên thực tế, điều này giúp triển khai thị giác máy tính dễ dàng hơn tại nơi hệ thống thực sự vận hành. Model được huấn luyện với khả năng dự đoán cao hơn, mở rộng nhất quán hơn trên nhiều kích thước và dễ dàng thích ứng với các bộ dữ liệu mới. Điều này giảm trở ngại giữa thử nghiệm và triển khai, đặc biệt trong những môi trường mà độ tin cậy và hiệu quả cũng quan trọng như hiệu năng thuần túy.
Ví dụ, trong các ứng dụng robot và thị giác công nghiệp, model thường cần được huấn luyện lại khi môi trường, cảm biến hoặc tác vụ thay đổi. Với Ultralytics YOLO26, các nhóm có thể lặp lại nhanh hơn mà không phải lo về các lượt huấn luyện bất ổn hoặc hành vi không nhất quán giữa các kích thước model.
Điểm chính cần ghi nhớ#
Các hệ thống thị giác máy tính đáng tin cậy phụ thuộc vào cách huấn luyện model cũng nhiều như vào hiệu năng của model khi suy luận. Bằng cách cải thiện việc cân bằng tín hiệu học, xử lý đối tượng nhỏ và tiến hành tối ưu hóa, Ultralytics YOLO26 giúp quá trình huấn luyện ổn định hơn và dễ mở rộng hơn. Việc tập trung vào huấn luyện đáng tin cậy giúp các nhóm chuyển đổi suôn sẻ hơn từ thử nghiệm sang triển khai thực tế, đặc biệt trong các ứng dụng ưu tiên edge.
Bạn muốn tìm hiểu về AI? Truy cập repository GitHub của chúng tôi để khám phá thêm. Tham gia cộng đồng sôi nổi của chúng tôi và tìm hiểu về những đổi mới trong các lĩnh vực như AI trong logistics và AI thị giác trong ngành ô tô. Để bắt đầu với thị giác máy tính ngay hôm nay, hãy xem các lựa chọn cấp phép của chúng tôi.









