Vì sao Ultralytics YOLO26 loại bỏ NMS và điều này thay đổi việc triển khai như thế nào
Khám phá cách Ultralytics YOLO26 hỗ trợ inference end-to-end thực sự mà không cần NMS, và lý do việc loại bỏ post-processing giúp đơn giản hóa quá trình export và triển khai trên edge.
Vào ngày 14 tháng 1, chúng tôi đã ra mắt Ultralytics YOLO26, thế hệ mới nhất của các model computer vision của chúng tôi. Với YOLO26, mục tiêu của chúng tôi không chỉ là cải thiện độ chính xác hoặc tốc độ, mà còn suy nghĩ lại về cách các model phát hiện đối tượng được xây dựng và triển khai trong các hệ thống thực tế.
Khi computer vision chuyển từ nghiên cứu sang production, các model ngày càng được kỳ vọng có thể chạy trên CPU, thiết bị edge, camera, robot và phần cứng nhúng. Trong những môi trường này, độ tin cậy, độ trễ thấp và khả năng triển khai dễ dàng cũng quan trọng không kém hiệu năng.
Ultralytics YOLO26 được thiết kế dựa trên thực tế này, sử dụng kiến trúc end-to-end tinh gọn nhằm loại bỏ độ phức tạp không cần thiết khỏi pipeline inference. Một trong những cải tiến quan trọng nhất của YOLO26 là loại bỏ Non-Maximum Suppression, thường được gọi là NMS.
Trong nhiều năm, NMS là một phần tiêu chuẩn của các hệ thống phát hiện đối tượng, được sử dụng như một bước post-processing để loại bỏ các detection trùng lặp. Mặc dù hiệu quả, nó cũng tạo thêm chi phí tính toán và thách thức triển khai, đặc biệt trên phần cứng edge.
Với YOLO26, chúng tôi đã áp dụng một cách tiếp cận khác. Bằng cách suy nghĩ lại về cách các prediction được tạo ra và model được train, chúng tôi hỗ trợ inference end-to-end thực sự, không cần NMS. Model trực tiếp tạo ra các detection cuối cùng mà không phụ thuộc vào các bước dọn dẹp bên ngoài hoặc các quy tắc được thiết kế thủ công. Điều này giúp YOLO26 nhanh hơn, dễ export hơn và đáng tin cậy hơn khi triển khai trên nhiều nền tảng phần cứng.
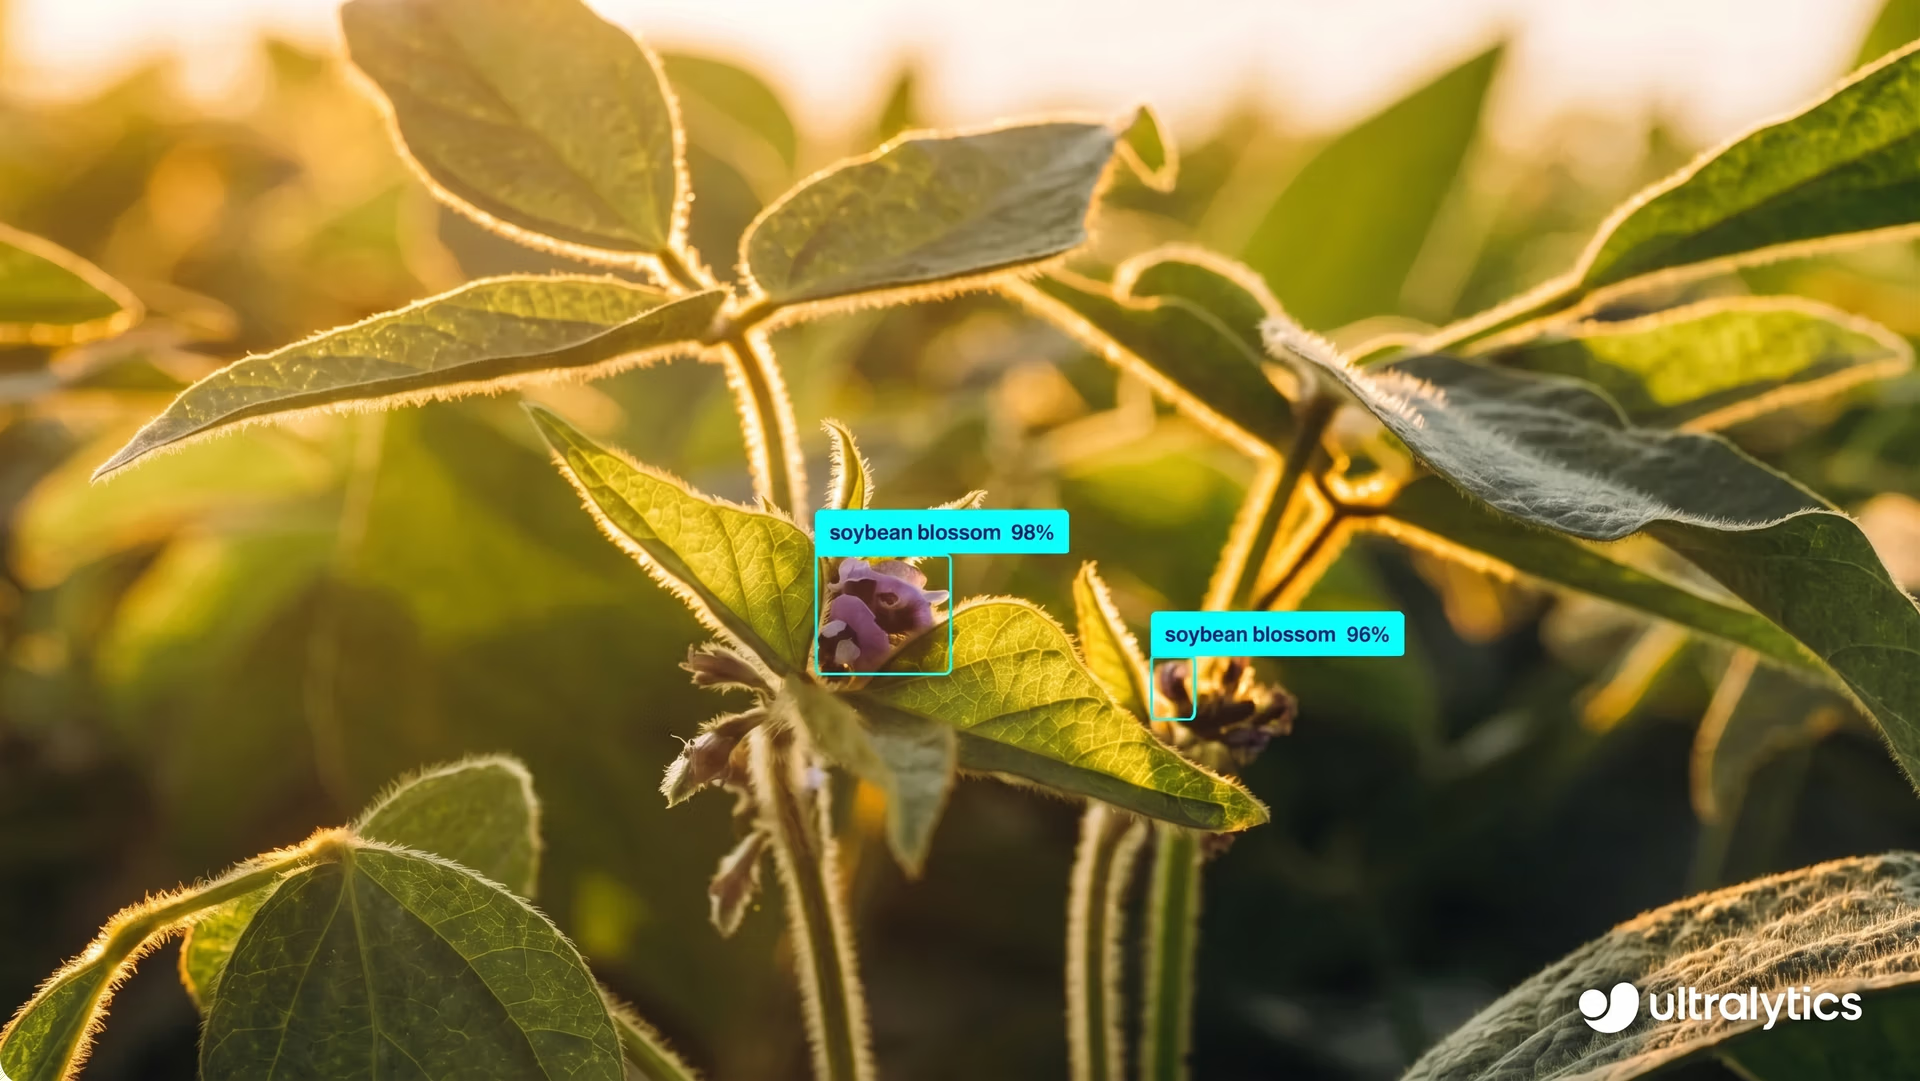
Hình 1. Phát hiện đối tượng trong ảnh bằng Ultralytics YOLO26.
Trong bài viết này, chúng ta sẽ tìm hiểu kỹ hơn về lý do các hệ thống phát hiện đối tượng truyền thống phụ thuộc vào NMS, cách NMS trở thành nút thắt cổ chai khi triển khai và cách Ultralytics YOLO26 loại bỏ nhu cầu dùng các giải pháp tình thế. Hãy bắt đầu!
Phát hiện đối tượng truyền thống tạo ra các detection trùng lặp#
Trước khi tìm hiểu NMS là gì và tại sao chúng tôi loại bỏ NMS trong Ultralytics YOLO26, hãy cùng lùi lại một bước để xem các model phát hiện đối tượng truyền thống tạo ra prediction như thế nào.
Các model phát hiện đối tượng truyền thống thường tạo ra nhiều bounding box chồng lấn cho cùng một đối tượng. Mỗi box có một confidence score riêng, dù tất cả đều tham chiếu đến cùng một đối tượng trong ảnh.
Điều này xảy ra vì một số lý do. Thứ nhất, model đưa ra prediction tại nhiều vị trí không gian và ở nhiều scale khác nhau cùng lúc. Điều này giúp model phát hiện các đối tượng có kích thước khác nhau, nhưng cũng có nghĩa là các vị trí lân cận có thể độc lập nhận diện cùng một đối tượng.
Thứ hai, nhiều hệ thống phát hiện đối tượng sử dụng các phương pháp dựa trên anchor, tạo ra số lượng lớn box ứng viên xung quanh mỗi vị trí. Mặc dù điều này tăng khả năng tìm thấy đối tượng một cách chính xác, nó cũng làm tăng số lượng prediction chồng lấn.
Cuối cùng, bản thân phương pháp phát hiện dựa trên grid vốn tự nhiên dẫn đến dư thừa. Khi một đối tượng nằm gần ranh giới của nhiều ô grid, một số ô có thể cùng dự đoán một box cho đối tượng đó, dẫn đến nhiều detection chồng lấn.
Vì vậy, output thô của model thường chứa nhiều box cho một đối tượng duy nhất. Để kết quả có thể sử dụng được, các prediction dư thừa này cần được lọc để chỉ còn lại một detection cuối cùng.
Tìm hiểu về Non-Maximum Suppression#
Sau khi model phát hiện đối tượng tạo ra nhiều bounding box chồng lấn cho cùng một đối tượng, các kết quả đó cần được dọn dẹp trước khi sử dụng. Đây là lúc Non-Maximum Suppression được áp dụng.
Non-Maximum Suppression là một bước post-processing chạy sau khi model hoàn tất việc tạo prediction. Mục đích của nó là giảm các detection trùng lặp để mỗi đối tượng được biểu diễn bằng một bounding box cuối cùng duy nhất.
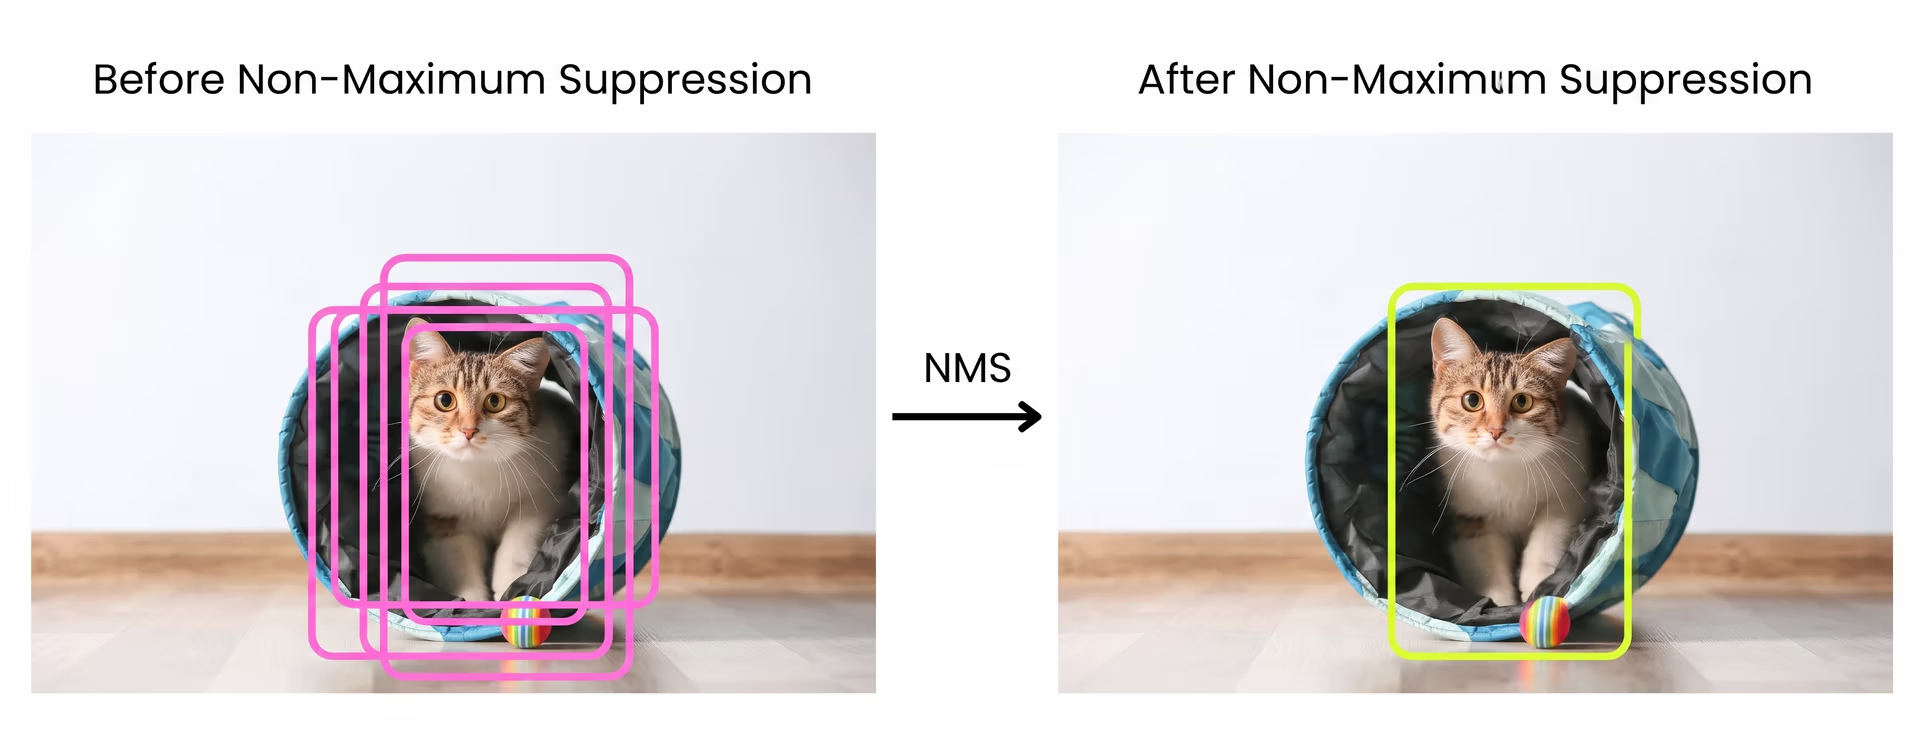
Hình 2. Tổng quan về NMS. Hình ảnh do tác giả thực hiện.
Quy trình này hoạt động bằng cách so sánh các bounding box dựa trên confidence score và mức độ chồng lấn của chúng. Các prediction có độ tin cậy rất thấp sẽ bị loại bỏ trước.
Các box còn lại sau đó được sắp xếp theo độ tin cậy, và box có score cao nhất được chọn làm detection tốt nhất. Box được chọn đó sẽ được so sánh với các box khác.
Nếu một box khác chồng lấn quá nhiều với nó, box đó sẽ bị suppress và loại bỏ. Mức độ chồng lấn thường được đo bằng Intersection over Union, một metric tính tỷ lệ giữa phần diện tích chung của hai box và tổng diện tích được cả hai box bao phủ. Quy trình này lặp lại cho đến khi chỉ còn các detection có độ tin cậy cao nhất và không chồng lấn.
Tại sao NMS làm phức tạp việc triển khai#
Mặc dù Non-Maximum Suppression giúp lọc các detection trùng lặp, nó cũng tạo ra những thách thức trở nên rõ rệt hơn khi model chuyển từ nghiên cứu sang triển khai trong thực tế.
Một trong những vấn đề lớn nhất là hiệu năng. NMS chạy sau inference và yêu cầu so sánh các bounding box với nhau để quyết định box nào được giữ lại.
Quy trình này tốn nhiều tài nguyên tính toán và khó parallelize một cách hiệu quả. Trên các thiết bị edge và hệ thống dựa trên CPU, phần việc bổ sung này có thể làm tăng độ trễ đáng kể, khiến việc đáp ứng các yêu cầu real-time trở nên khó khăn hơn.
NMS cũng làm tăng độ phức tạp khi triển khai. Vì không phải là một phần của chính model, NMS phải được triển khai riêng dưới dạng code post-processing.
Các runtime và nền tảng khác nhau xử lý NMS theo những cách khác nhau, thường khiến phải duy trì các implementation tùy chỉnh cho từng môi trường đích. Những gì hoạt động trong một thiết lập có thể hoạt động hơi khác trong thiết lập khác, khiến việc triển khai kém ổn định hơn và khó scale hơn.
Tối ưu hóa phần cứng là một thách thức khác. NMS không ánh xạ tốt lên các bộ tăng tốc AI chuyên dụng, vốn được thiết kế để chạy hiệu quả các phép toán neural network. Do đó, ngay cả khi model chạy nhanh trên phần cứng đã được tối ưu, NMS vẫn có thể trở thành nút thắt cổ chai, giới hạn hiệu năng tổng thể.
Ngoài những yếu tố này, NMS còn phụ thuộc vào các tham số được lựa chọn thủ công như ngưỡng confidence và ngưỡng chồng lấn. Các thiết lập này có thể ảnh hưởng đáng kể đến kết quả và thường cần được tinh chỉnh cho các dataset, ứng dụng hoặc phần cứng khác nhau. Điều này khiến hành vi trong các hệ thống production kém dễ dự đoán hơn và làm tăng chi phí cấu hình.
Giải thích về inference phát hiện đối tượng end-to-end#
Những hạn chế của Non-Maximum Suppression khiến chúng tôi suy nghĩ lại về cách các model phát hiện đối tượng nên hoạt động trong thời gian inference. Thay vì tạo ra nhiều prediction chồng lấn rồi dọn dẹp sau đó, chúng tôi đặt ra một câu hỏi nền tảng hơn.
Nếu model có thể trực tiếp tạo ra các detection cuối cùng thì sao? Câu hỏi này nằm ở trọng tâm của inference phát hiện đối tượng end-to-end. Trong một hệ thống end-to-end, model được train để xử lý toàn bộ quy trình phát hiện từ đầu đến cuối mà không phụ thuộc vào các bước dọn dẹp bên ngoài.
Thay vì tạo ra nhiều box ứng viên rồi lọc chúng sau inference, model tự học cách tạo ra một tập nhỏ các prediction có độ tin cậy cao và không chồng lấn. Các detection trùng lặp được giải quyết bên trong network thay vì bị loại bỏ bằng post-processing.
Các kiến trúc model mới hơn cho thấy cách tiếp cận này vừa khả thi vừa thực tế. Với chiến lược training phù hợp, model có thể học cách liên kết mỗi đối tượng với một prediction duy nhất thay vì nhiều prediction cạnh tranh, giảm sự dư thừa ngay từ nguồn.
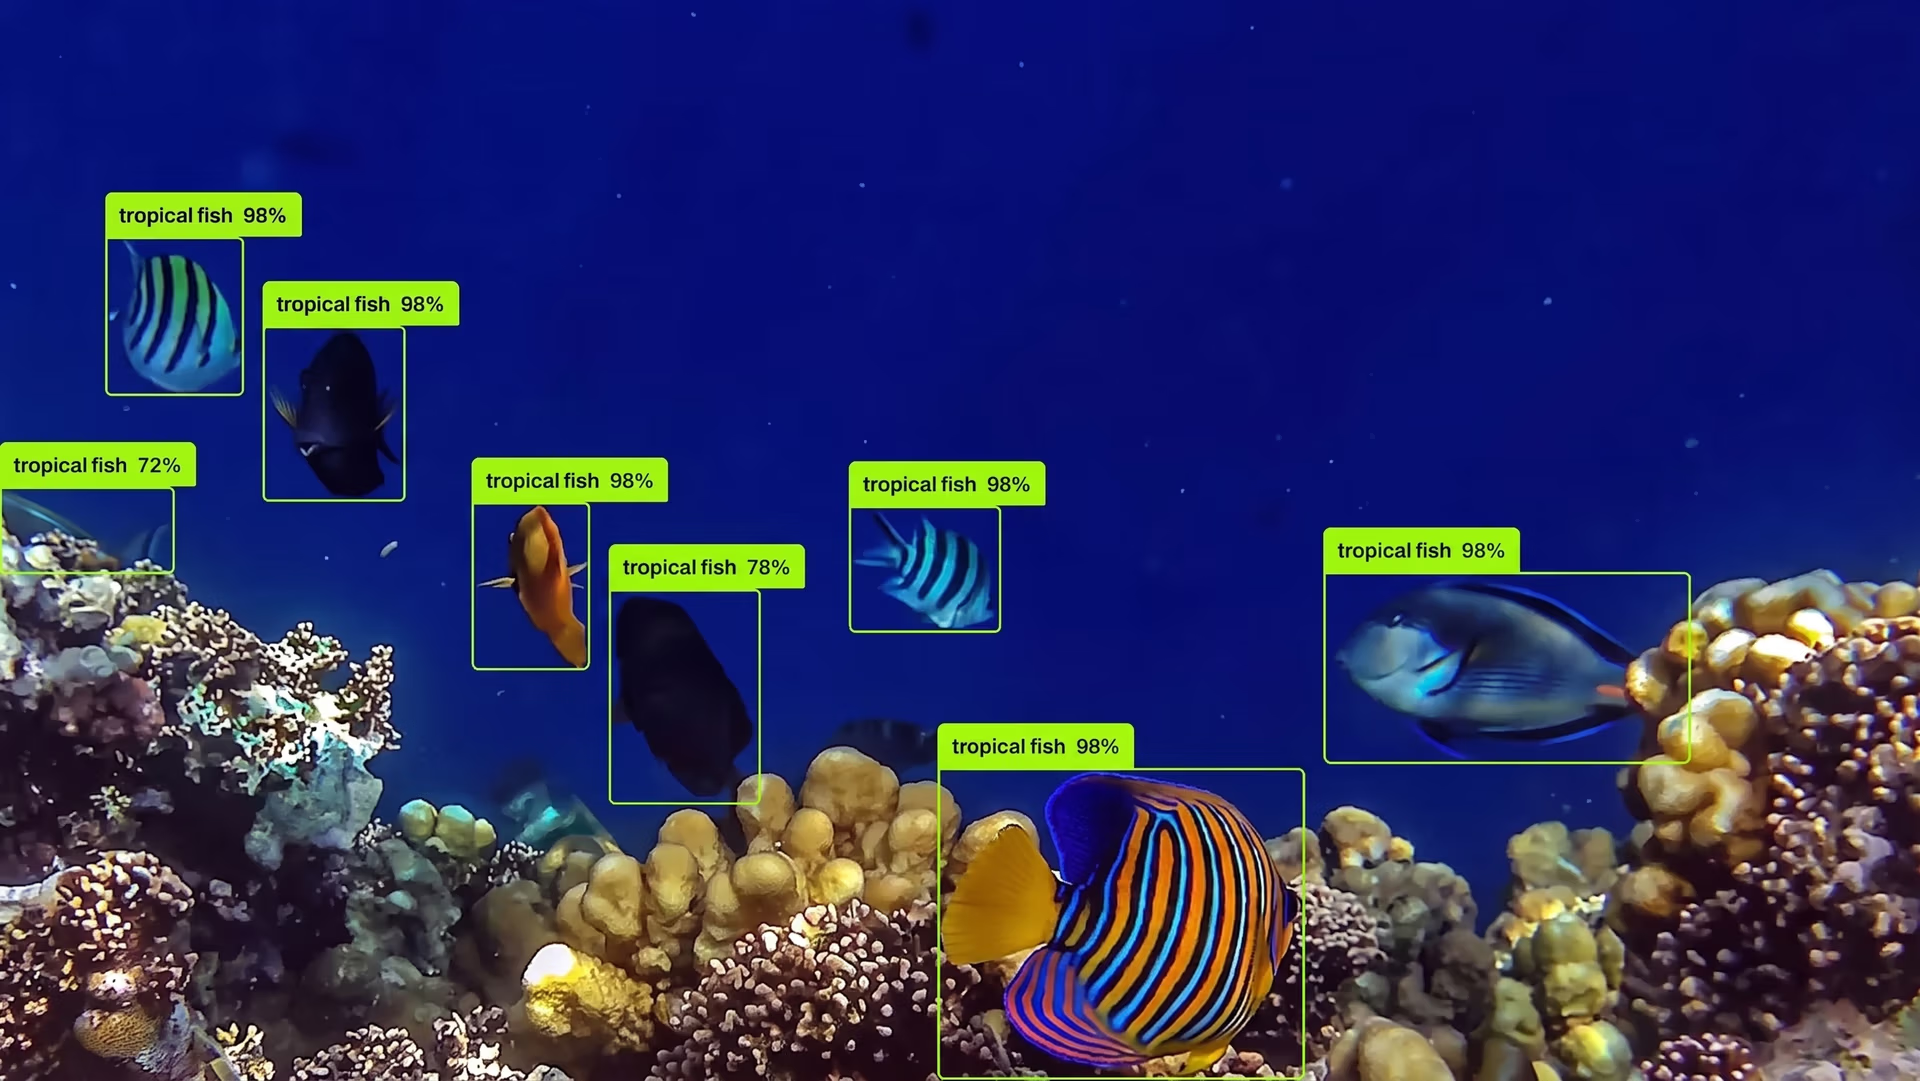
Hình 3. Ví dụ về phát hiện đối tượng bằng Ultralytics YOLO26.
Để cách này hoạt động, quá trình training cũng phải thay đổi. Thay vì để nhiều prediction cạnh tranh cho cùng một đối tượng, model học cách đưa ra một quyết định rõ ràng, tạo ra ít detection hơn và có độ tin cậy cao hơn.
Kết quả tổng thể là một inference pipeline đơn giản hơn. Vì các bản trùng lặp đã được giải quyết bên trong, không cần Non-Maximum Suppression trong thời gian inference. Output của model đã là tập detection cuối cùng.
Thiết kế end-to-end này cũng giúp triển khai dễ dàng hơn. Không có các bước post-processing hoặc implementation NMS dành riêng cho từng nền tảng, model đã export hoàn toàn self-contained và hoạt động nhất quán trên các framework inference cũng như target phần cứng khác nhau.
Với tư cách Lead Partnership Engineer của chúng tôi, Francesco Mattioli, giải thích: “Học end-to-end thực sự có nghĩa là model phải xử lý mọi thứ từ pixel đến prediction mà không cần các bước post-processing được thiết kế thủ công, vốn phá vỡ khả năng vi phân và làm phức tạp việc triển khai.”
Cách Ultralytics YOLO26 loại bỏ NMS#
Ultralytics YOLO26 loại bỏ Non-Maximum Suppression bằng cách thay đổi cách detection được học và tạo ra, thay vì dựa vào post-processing để dọn dẹp chúng. Thay vì cho phép nhiều prediction cạnh tranh cho cùng một đối tượng, YOLO26 được train để học mối quan hệ một-một rõ ràng giữa các đối tượng và output.
Điều này một phần được hỗ trợ bởi phương pháp phát hiện dựa trên query có thể học, giúp model tập trung tạo ra một prediction duy nhất, có độ tin cậy cao cho mỗi đối tượng thay vì nhiều ứng viên chồng lấn. Mỗi đối tượng được liên kết với một prediction, qua đó tự nhiên giảm các detection trùng lặp.
Hành vi này được củng cố thông qua các chiến lược matching nhất quán trong quá trình training, khuyến khích model đưa ra một quyết định có độ tin cậy cao cho mỗi đối tượng thay vì tạo ra các prediction chồng lấn. Cuối cùng, model tạo ra ít prediction hơn, nhưng mỗi prediction đều đại diện cho một detection cuối cùng.
Tại sao việc loại bỏ DFL giúp detection không cần NMS trở nên khả thi#
Một cải tiến quan trọng khác hỗ trợ inference không cần NMS trong Ultralytics YOLO26 là loại bỏ Distribution Focal Loss, hay DFL. Trong các model YOLO trước đây, DFL được sử dụng để cải thiện khả năng hồi quy bounding box bằng cách dự đoán một phân phối các vị trí box khả dĩ thay vì một giá trị duy nhất.
Mặc dù phương pháp này cải thiện độ chính xác định vị, nó cũng làm tăng độ phức tạp của detection pipeline. Độ phức tạp đó trở thành một hạn chế khi hướng tới inference end-to-end thực sự.
DFL tạo thêm phép tính và các miền hồi quy cố định, khiến model khó học các phép gán đối tượng một-một rõ ràng hơn và làm tăng sự phụ thuộc vào các bước post-processing như Non-Maximum Suppression. Với Ultralytics YOLO26, chúng tôi đã loại bỏ DFL và thiết kế lại việc hồi quy bounding box theo hướng đơn giản, trực tiếp hơn.
Thay vì phụ thuộc vào output dựa trên phân phối, model học cách dự đoán tọa độ box chính xác theo cách hỗ trợ ít detection hơn nhưng có độ tin cậy cao hơn. Thay đổi này giúp giảm các prediction chồng lấn ngay từ nguồn và đồng bộ hóa việc hồi quy bounding box với thiết kế end-to-end, không cần NMS của Ultralytics YOLO26.
Ultralytics YOLO26 không cần NMS và dễ triển khai#
Thiết kế không cần NMS biến Ultralytics YOLO26 thành một model end-to-end thực sự. Điều này có tác động quan trọng đến việc export model.
Export là quá trình chuyển một model đã train sang định dạng có thể chạy bên ngoài môi trường training, chẳng hạn như ONNX, TensorRT, CoreML hoặc OpenVINO. Trong các pipeline truyền thống, quy trình này thường gặp trục trặc vì Non-Maximum Suppression không phải là một phần của chính model.
Bằng cách loại bỏ NMS, Ultralytics YOLO26 hoàn toàn tránh được vấn đề này. Model đã export vốn đã bao gồm mọi thành phần cần thiết để tạo ra các detection cuối cùng.
Điều này giúp model đã export hoàn toàn self-contained và dễ chuyển đổi hơn giữa các framework inference cũng như target phần cứng. Cùng một model hoạt động nhất quán dù được triển khai trên server, hệ thống chỉ có CPU, thiết bị nhúng hay bộ tăng tốc edge. Việc triển khai trở nên đơn giản hơn vì thứ bạn export chính là thứ bạn chạy.
Sự đơn giản này đặc biệt quan trọng đối với các ứng dụng edge. Ví dụ, YOLO26 có thể dễ dàng được triển khai trên các thiết bị như drone cho các use case như giám sát cây trồng, kiểm tra đồng ruộng và phân tích sức khỏe thực vật, nơi ngân sách tính toán và năng lượng hạn chế khiến các pipeline post-processing phức tạp trở nên không thực tế. Vì model trực tiếp output các detection cuối cùng, model có thể chạy đáng tin cậy trên phần cứng nhẹ mà không cần thêm bước xử lý.
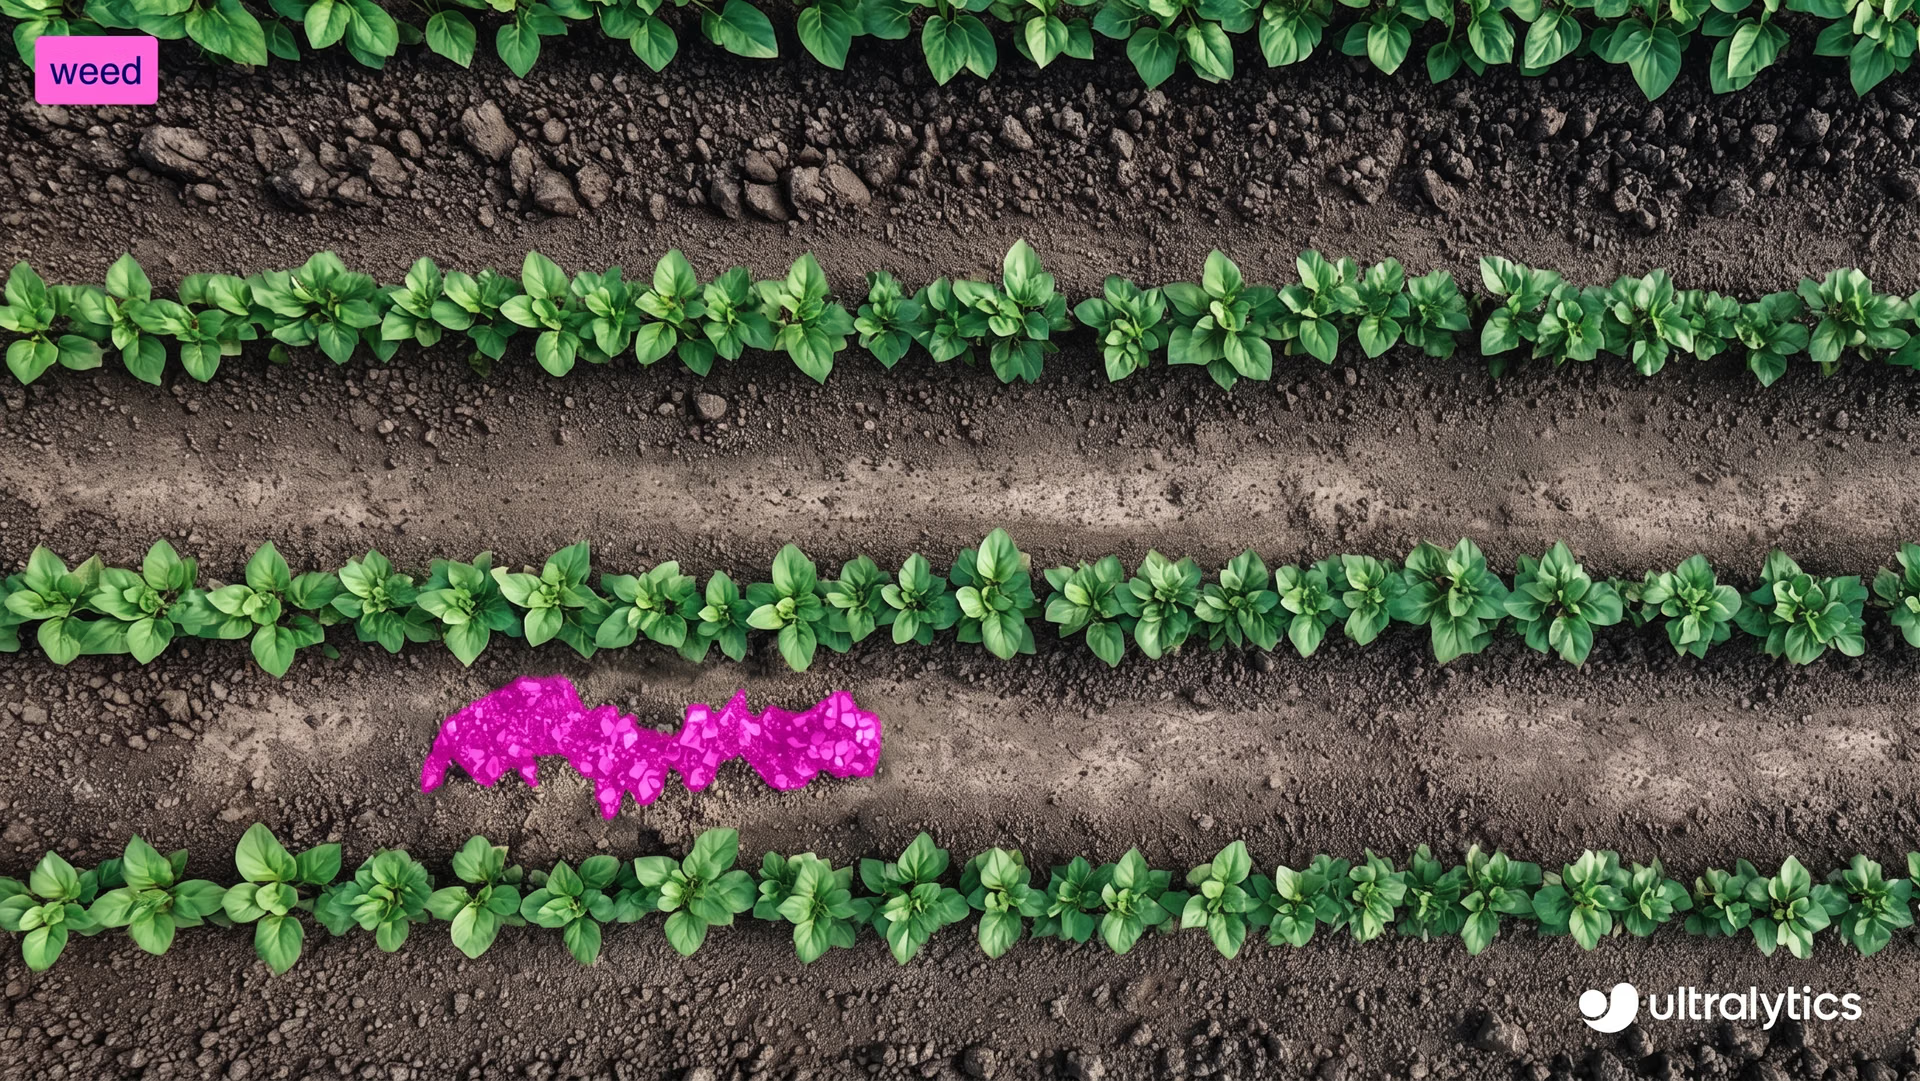
Hình 4. Ultralytics YOLO26 dễ triển khai trên các thiết bị edge như drone.
Tóm lại, inference không cần NMS loại bỏ trở ngại trong việc export và triển khai, đồng thời hỗ trợ xây dựng các hệ thống vision gọn gàng và đáng tin cậy hơn. NMS từng là một giải pháp tình thế. Ultralytics YOLO26 không còn cần các giải pháp tình thế nữa.
Những điểm chính#
Ultralytics YOLO26 loại bỏ Non-Maximum Suppression bằng cách giải quyết vấn đề cốt lõi là các detection trùng lặp, thay vì dọn dẹp chúng sau khi tạo ra. Thiết kế end-to-end cho phép model trực tiếp tạo ra các detection cuối cùng, giúp việc export và triển khai trở nên đơn giản, nhất quán hơn trên các phần cứng khác nhau. NMS là một giải pháp tình thế hữu ích cho các hệ thống trước đây, nhưng YOLO26 không còn cần đến nó.
Tham gia cộng đồng của chúng tôi và xem repository GitHub để tìm hiểu thêm về AI. Khám phá các trang giải pháp của chúng tôi về AI trong nông nghiệp và computer vision trong bán lẻ. Tìm hiểu các tùy chọn cấp phép của chúng tôi và bắt đầu sử dụng vision AI ngay hôm nay!








