计算机视觉模型在生产环境中失效的五大原因
了解计算机视觉模型在生产环境中失效的原因,包括数据不匹配和延迟问题,以及团队如何提升真实视觉 AI 系统中的模型性能。
 Abirami Vina6 分钟阅读
计算机视觉如今已成为一项关键的人工智能技术,正应用于大多数行业,使机器能够解读和分析视觉数据,以完成各种任务。从医学影像和机器人技术,到制造业和零售自动化,这些系统支持着许多真实场景中的应用。
然而,构建计算机视觉系统并不总是那么简单。通常需要开发一个经过训练的视觉 AI 模型,使其能够识别图像和视频中的模式,从而支持目标检测和跟踪等任务。
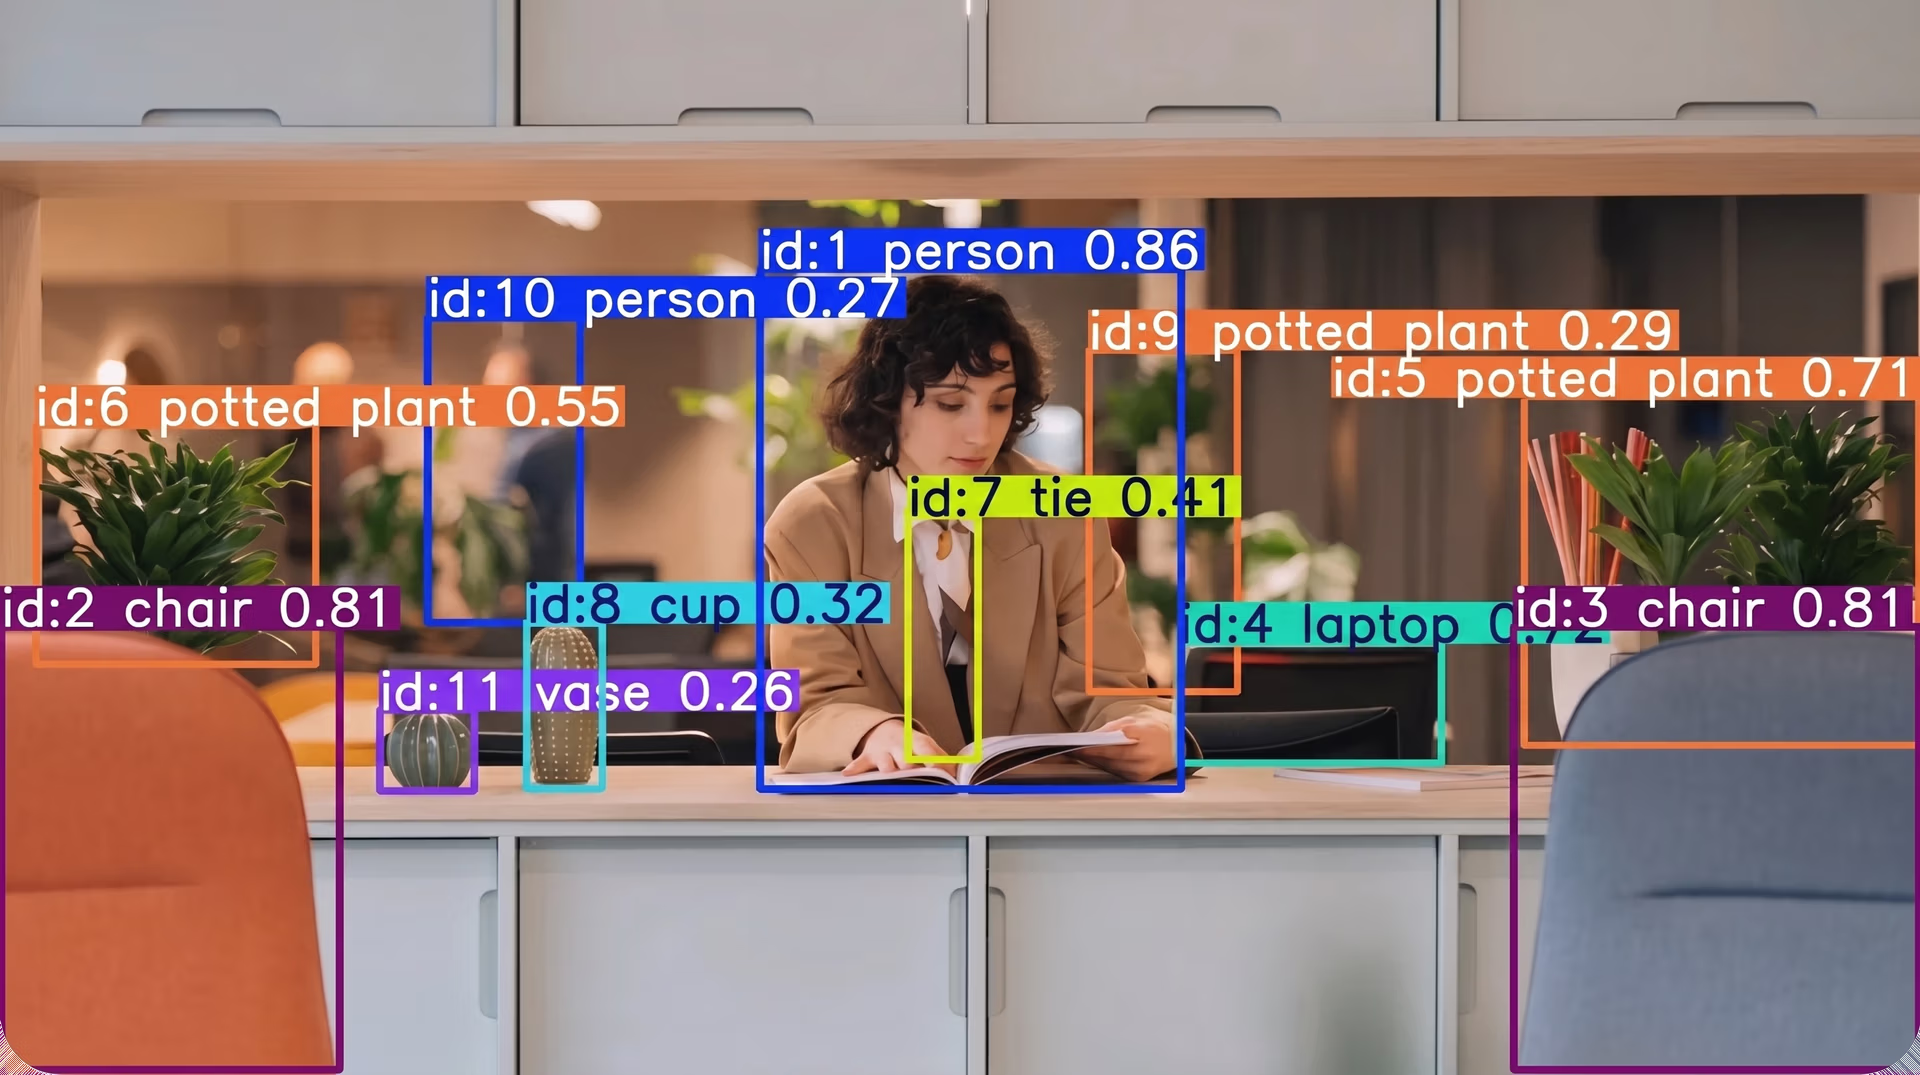
图 1. 目标检测和跟踪示例(来源)
尽管计算机视觉模型多年来不断进步,但它们在开发阶段与部署到真实环境后仍可能表现不同。这是因为在受控开发环境之外部署模型,会带来新的、往往难以预料的挑战。
数据集缺乏多样性、模型监控不佳以及基础设施限制等因素,都可能导致同一个模型在部署后于真实环境中表现不同。
本文将介绍计算机视觉模型在生产环境中可能表现不佳的五个常见原因。
模型训练与生产环境之间的差距#
模型训练通常在受控环境中进行。在这一阶段,AI 开发者使用精心准备的训练数据集。
这些庞大的视觉数据集合包含结构良好的标注,或用于描述每张图像内容的标签。训练也在一致的条件下进行,让视觉 AI 模型能够有效学习视觉模式。
为了确保模型正确学习这些模式,开发期间可以使用标准评估指标和基准数据集对模型进行系统评估。与训练数据集一样,这些基准数据集也经过了精心准备。
然而,真实世界中的计算机视觉系统遇到的数据,可能与训练和评估期间使用的数据大不相同。模型部署后,几乎不会一直在受控条件下运行。
它们可能会处理来自不可预测环境的图像和视频:光照不断变化、摄像机角度不断偏移,背景也会随时间改变。例如,如果一个用于交通检测的视觉 AI 模型主要使用白天图像进行训练和评估,那么它可能难以在夜间检测车辆。
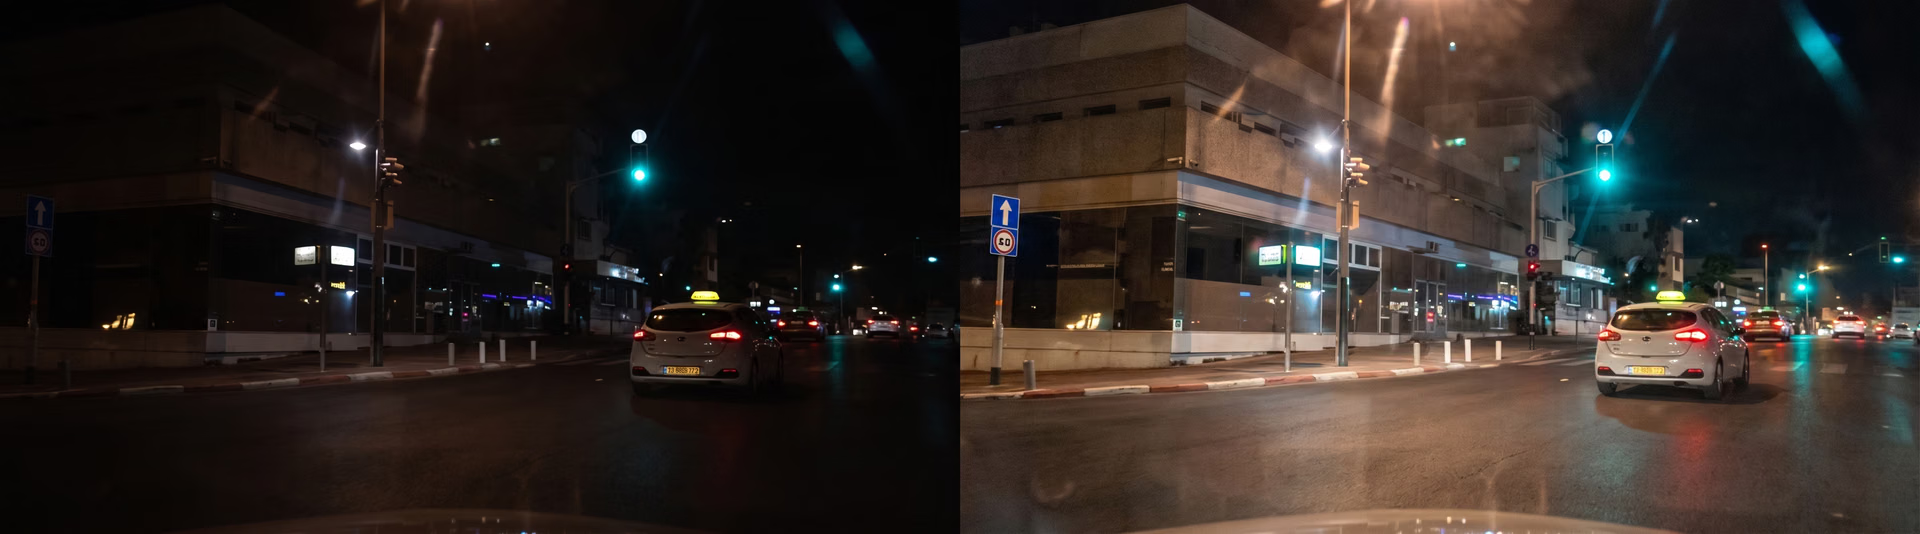
图 2. 即使经过增强,使用白天图像训练的模型仍难以解读夜间图像。(来源)
开发环境与真实部署环境之间的差异,就是训练与生产之间的差距。由于这一差距,许多模型故障只有在部署后才会显现,因此了解从实验室到生产环境的路径,对于构建更可靠、更稳健的计算机视觉系统至关重要。
计算机视觉模型在生产环境中失效的 5 个常见原因#
接下来,我们仔细看看计算机视觉模型在生产环境中失效的五个常见原因。
1. 低质量训练数据集#
数据集在计算机视觉模型训练中发挥着核心作用,因为数据集决定了模型在训练期间学习的内容,以及部署后如何响应真实世界的输入。在监督学习中,这一点尤其重要,因为模型会从带标签的示例中学习,了解每张图像所代表的内容。
许多深度学习模型(包括卷积神经网络(CNN))依靠这些带标签的示例来识别视觉数据中的模式。然而,如果训练数据集不能反映真实世界的情况,模型学到的模式可能无法充分代表物体在训练数据之外的外观。
例如,使用大型裂纹缺陷数据集训练的模型,可能无法在真实的制造业工作流程中检测到罕见的轻微裂纹。同样,标注质量也会影响模型行为。带标签数据中的标注不一致或细节缺失,可能导致模型在训练期间学到错误信息。
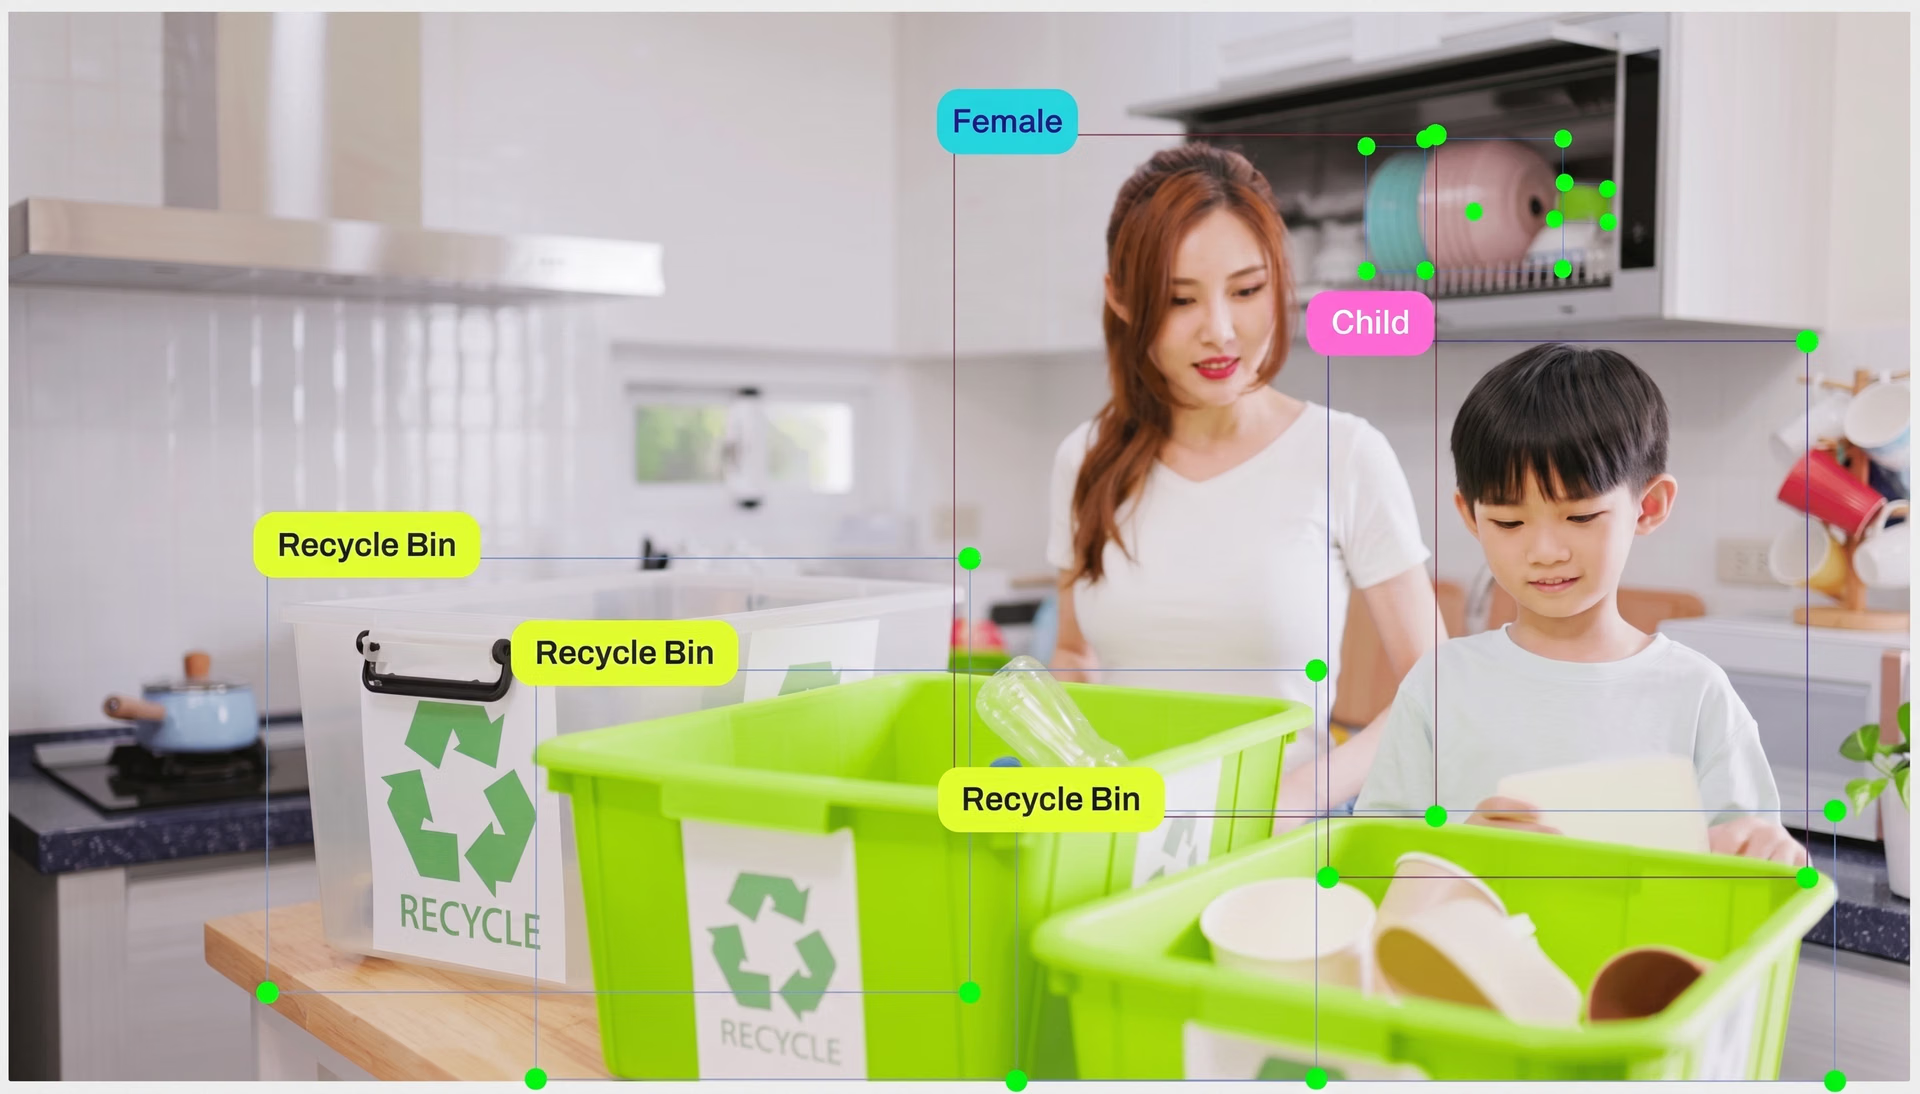
图 3. 图像标注一览(来源)
总体而言,训练数据的质量和多样性至关重要,能够决定模型在真实应用中的表现。数据集具有代表性且标注准确时,模型部署后的表现通常会更可靠。
2. 过拟合与泛化#
视觉模型等机器学习模型会从训练数据集中学习模式。但有时,模型可能会过度依赖少数几种模式。
模型最终可能记住训练数据中的有限模式,而不是学习更广泛的视觉关系。这种现象称为过拟合。
过拟合通常发生在训练数据集规模较小或数据多样性不足时。在这种情况下,模型很擅长识别已经见过的图像,却难以解读新数据或不熟悉的输入。
因此,模型可能在测试数据上表现良好(因为测试数据与训练数据相似),但部署后在新条件下的表现可能有所不同。这就是泛化能力至关重要的原因。简单来说,泛化能力指模型将训练中学到的知识应用于新场景的能力。
为了减少过拟合,实践者通常会使用更多样化的数据集训练模型,并应用数据增强——这种方法会对训练图像进行轻微修改,以增加数据多样性。如果不考虑这些因素,系统一旦开始在真实环境中运行,模型性能就可能迅速下降。
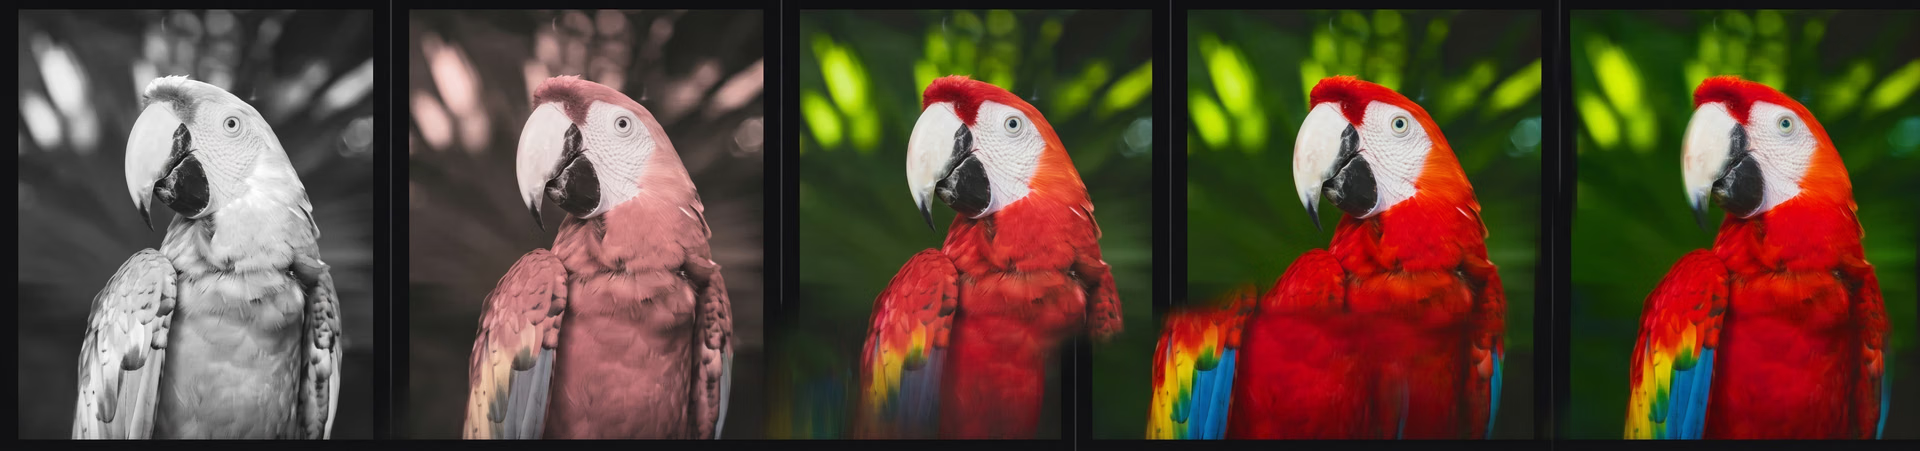
图 4. 数据增强有助于在数据集中生成同一图像的不同版本。(来源)
3. 真实环境中隐藏的边缘案例#
即使计算机视觉模型对新数据具有良好的泛化能力,真实环境中仍可能出现意料之外的边缘案例。这些不常见的情况与模型在训练期间学到的典型模式有所不同。
由于许多此类情况很少发生、难以重现,或收集为训练数据的成本高昂,因此在开发期间很难涵盖。例如,物体可能呈现不寻常的形状、移动方式难以预测,或被其他物体部分遮挡。
光照、摄像机角度或背景条件的变化,也可能造成识别难度增加的情况。这些边缘案例往往只有在系统部署到真实应用中后才会显现。
例如,在机器人技术和制造业自动化领域,物品的摆放或位置可能与预期不同,从而产生模型原本无法处理的情况。最终,测试期间看似可靠的预测,在系统于真实环境中运行后可能变得不那么稳定。
4. 缺乏部署后监控和调试#
除了开发视觉 AI 模型,监控并提升模型性能也至关重要。然而,系统投入运行后,关注重点往往转向维持系统运行,而不是密切跟踪系统随时间推移的表现。因此,模型行为的变化可能会被忽视。
与此同时,输入数据的变化、摄像头设置或运行环境等因素,也会逐渐影响模型检测或分类对象的准确度。这些变化并不总是显而易见,在日常运行中可能一直不被察觉。
监控模型输出和整体系统行为,有助于团队更早发现这些问题。定期检查、验证流程和调试工作流程可以让团队调查异常结果,并了解可能的成因。
在制造业等领域,摄像机配置变更后,模型可能会突然错误识别装配线上的物体。跟踪已部署视觉 AI 系统的行为变化,有助于更轻松地应对这些变化,并维持系统在真实环境中的稳定性能。
5. 基础设施限制与延迟#
许多计算机视觉系统需要实时运行,这可能给硬件、网络和处理流水线带来很大压力。资源有限时,可能出现计算延迟或网络延迟,导致预测结果到达过慢,影响系统整体性能。
在某些情况下,先进的深度学习模型也可能带来基础设施方面的挑战。例如,基于 Transformer 的架构旨在处理大量视觉数据并学习图像中的复杂关系,但通常需要大量计算资源。运行这些模型可能需要更强大或更昂贵的硬件。
如果没有适当优化,即使是在测试期间运行迅速的模型,部署后也可能变慢或表现不稳定。为了解决这个问题,团队通常会优化流水线、尽可能降低模型复杂度,并在准确度与速度之间取得平衡。
这可能包括将大型模型压缩成更轻量的版本、使用效率更高的架构,或以较低分辨率处理图像,让系统在现有硬件上流畅运行。在许多情况下,团队还会选择轻量且速度更快的模型,例如 Ultralytics YOLO26,以满足部署限制。
预防计算机视觉模型失效的最佳实践#
以下是一些最佳实践,可帮助减少计算机视觉模型在生产环境部署时发生故障:
- 采用分阶段部署策略:逐步将模型引入生产环境,让团队观察模型行为,并在需要时进行调整。
- 建立反馈闭环:收集新图像并检查错误预测,使用更新后的数据集重新训练模型,逐步改善模型性能。
- 记录模型的局限性: 清楚记录模型可能遇到困难的情况,让团队能够在部署期间预判潜在问题。
- 针对真实环境中的变化进行设计:提前考虑光照、摄像头角度、对象位置或背景条件的变化,有助于模型在不同运行场景下保持稳定。
要点#
计算机视觉模型很少是因为算法本身薄弱而失效。在大多数情况下,真正的挑战来自这些系统运行的环境。训练期间表现良好的模型,往往会遇到不可预测的真实环境情况,从而影响模型行为。
因此,构建可靠的视觉 AI 系统,不能只靠训练模型。还需要仔细准备数据集、在部署后监控模型性能,并持续让系统适应真实环境。
想进一步探索视觉 AI?加入我们的社区,阅读 AI 在汽车行业的应用和计算机视觉在物流领域的应用等内容。查看我们的许可选项,开始计算机视觉项目。访问我们的 GitHub 代码仓库了解更多。
作者
评论
提出问题、分享你的结果,或帮助其他人。









