最佳目标检测模型
探索 2026 年最佳目标检测模型,从 Ultralytics YOLO 到 RT-DETR,对比其架构、性能权衡和部署因素。
 Abirami Vina9 分钟阅读
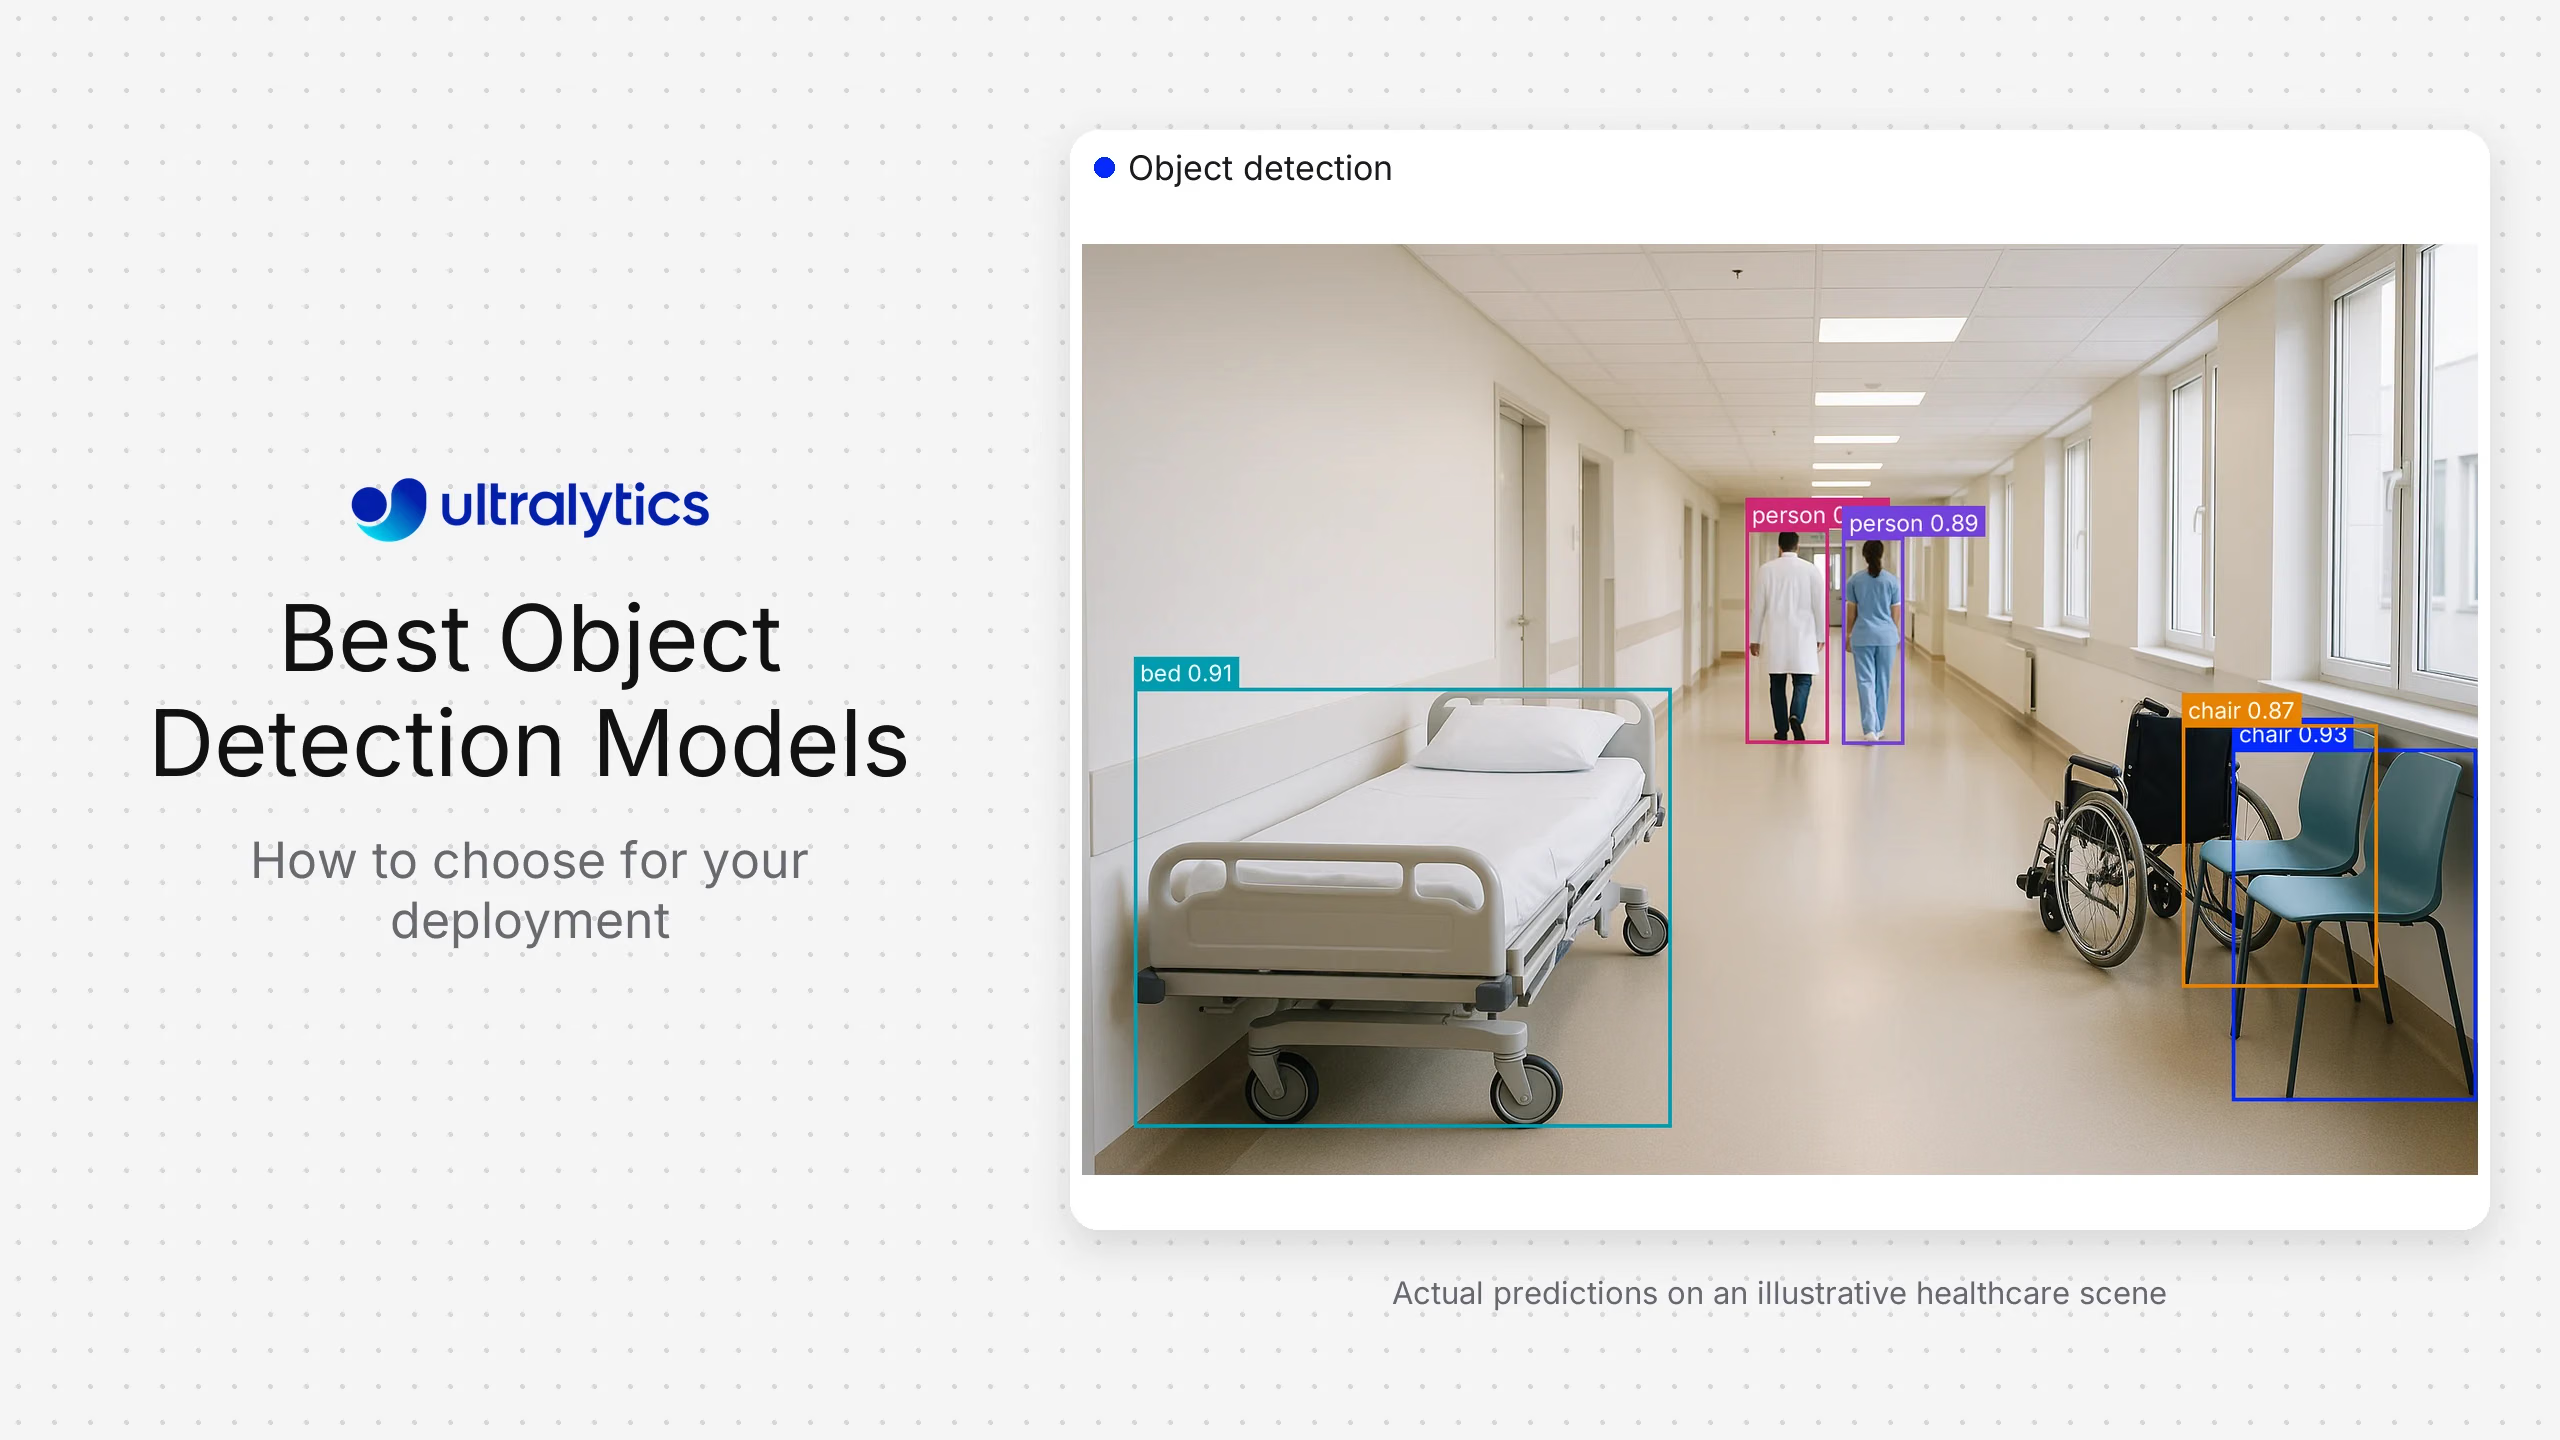
今年早些时候,AI 和机器学习领域的先驱 Andrew Ng 提出了智能体目标检测这一概念。这种方法利用推理智能体根据文本提示检测目标,而无需大量训练数据。
无需庞大的标注数据集,就能识别图像和视频中的目标,这是迈向更智能、更灵活的计算机视觉系统的一步。不过,智能体视觉 AI 仍处于早期阶段。
虽然它可以处理检测图像中的行人或路标等一般任务,但更精确的计算机视觉应用仍依赖传统目标检测模型。这些模型使用大量经过精心标注的数据集进行训练,从而准确学习需要寻找的目标及其位置。
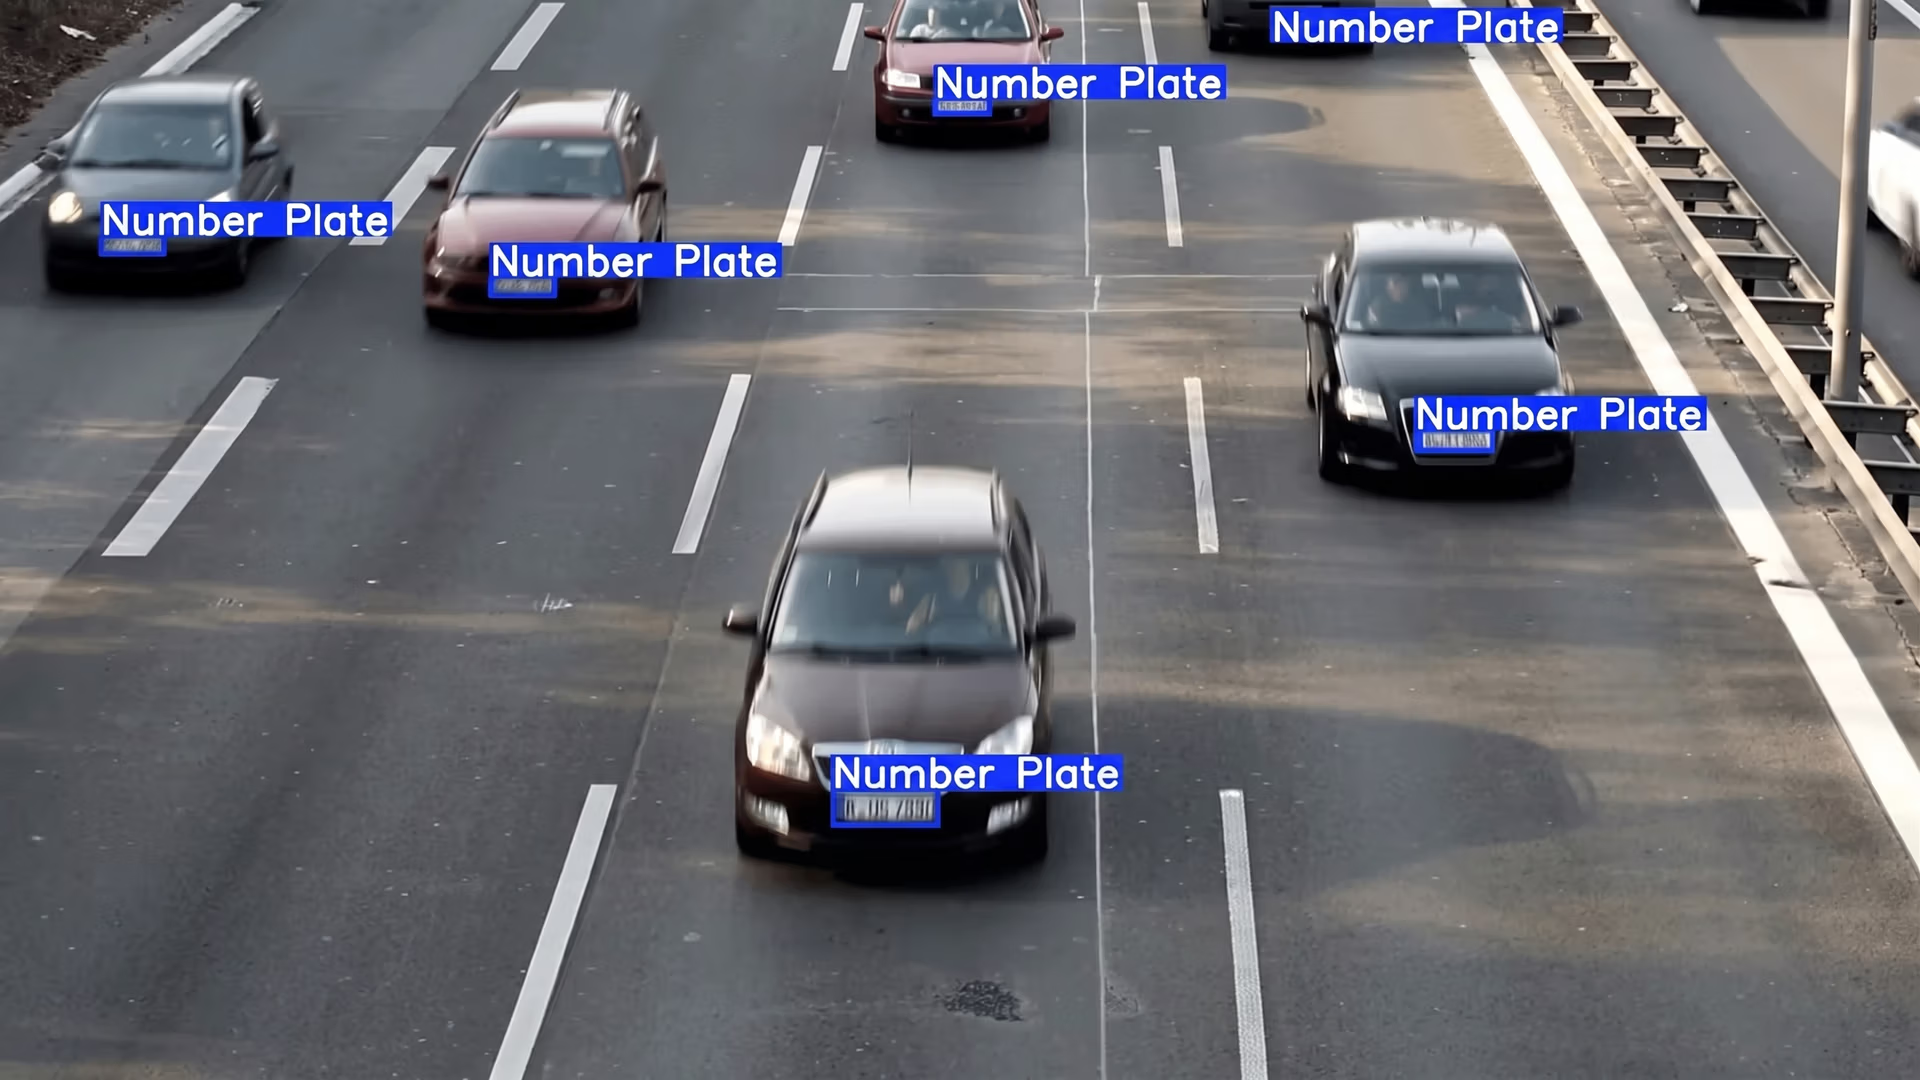
图 1. 目标检测示例。(来源)
传统目标检测至关重要,因为它既能识别目标是什么,也能定位目标在图像中的确切位置。这种结合使机器能够可靠地执行复杂的真实世界任务,从自动驾驶到工业自动化和医疗诊断。
目标检测模型不断改进,速度更快、精度更高,也更适合真实环境。本文将介绍目前一些最出色的目标检测模型。
目标检测的必要性#
图像分类等计算机视觉任务可以判断图像中是否包含汽车、行人或其他目标。但它们无法确定目标在图像中的位置。
这正是目标检测发挥作用的地方。目标检测模型既能识别画面中的物体,也能精确定位物体。这一过程称为定位,可让机器更准确地理解场景并做出适当响应,无论是让自动驾驶汽车停车、引导机械臂,还是在医学影像中标出某个区域。
深度学习的兴起改变了目标检测。现代模型不再依赖手工编写的规则,而是直接从标注和视觉数据中学习模式。这些数据集教会模型识别目标外观、目标通常出现的位置,以及如何应对小目标、杂乱场景或光照变化等挑战。
事实上,先进的目标检测系统能够同时准确检测多个目标。因此,目标检测已成为自动驾驶、机器人、医疗保健和工业自动化等应用中的关键技术。
目标检测任务的工作原理#
目标检测模型的输入是一张图像,它可以来自摄像头、视频帧,甚至医学扫描。输入图像会经过神经网络处理,通常是卷积神经网络 (CNN),这种网络经过训练,能够识别视觉数据中的模式。
在网络内部,图像会经过多个阶段的分析。模型根据检测到的特征,预测图像中有哪些目标以及它们出现的位置。
这些预测通过边界框表示,即围绕每个检测到的目标绘制的矩形。对于每个边界框,模型都会分配一个类别标签(例如汽车、行人或狗)和一个置信度分数,用来表示模型对预测结果的确信程度(也可以将其理解为概率)。
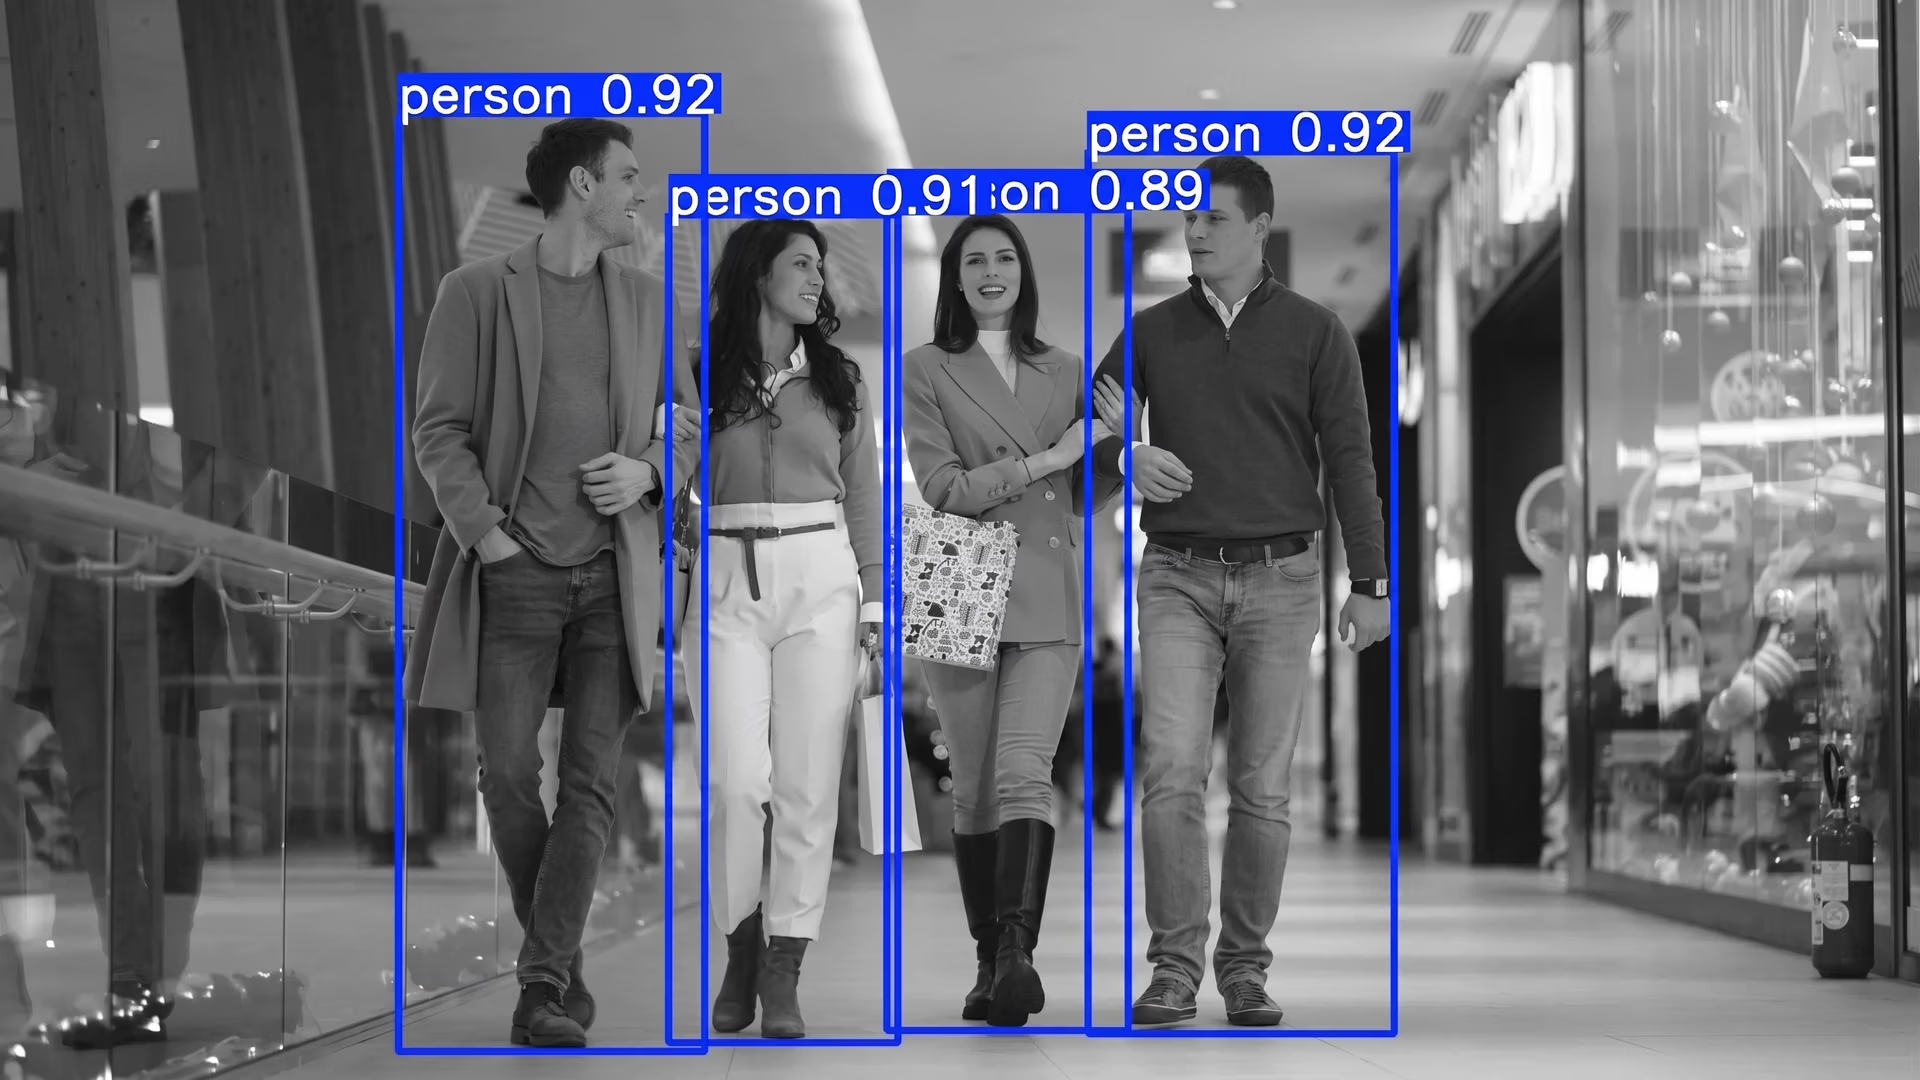
图 2. 目标检测预测结果可以通过边界框进行可视化。
整个过程高度依赖特征提取。模型会学习识别有用的视觉模式,例如边缘、形状、纹理和其他区别性特征。这些模式会编码在特征图中,帮助网络从不同细节层次理解图像。
目标检测:两阶段与单阶段#
根据模型架构的不同,目标检测器会采用不同策略来定位目标,并在速度、准确率和复杂度之间进行权衡。
许多目标检测模型,尤其是 Faster R-CNN 等两阶段检测器,会关注图像中称为感兴趣区域 (ROI) 的特定部分。通过重点分析这些区域,模型会优先处理更可能包含目标的区域,而不是同等分析每个像素。
另一方面,早期 YOLO 模型等单阶段模型不会像两阶段模型那样选择特定的 ROI。它们会将图像划分为网格,并使用称为锚框的预定义框以及特征图,在一次处理中预测整幅图像中的目标。
包括近期 Ultralytics YOLO 模型在内的许多现代目标检测模型都采用无锚框方法。与依赖预定义锚框的传统单阶段模型不同,无锚框模型直接根据特征图预测物体的位置和大小。这种方法可以简化架构、降低计算开销并提升性能,尤其适合检测形状和大小各异的物体。
盘点最佳目标检测模型#
如今有许多目标检测模型,每种模型都有特定的设计目标。有些模型针对实时性能进行了优化,另一些则专注于实现最高准确率。为计算机视觉解决方案选择合适的模型,通常取决于你的具体用例和性能要求。
接下来,我们来看看 2026 年的一些最佳目标检测模型。
1. Ultralytics YOLO 模型#
如今,应用最广泛的目标检测模型系列之一是 Ultralytics YOLO 模型系列。YOLO 是 You Only Look Once(只需看一次)的缩写,因检测性能出色、速度快、可靠且易于使用而广受各行业欢迎。
Ultralytics YOLO 系列包括 Ultralytics YOLOv5、Ultralytics YOLOv8、Ultralytics YOLO11 和最新的 Ultralytics YOLO26,可满足不同的性能需求和使用场景。得益于轻量化设计和速度优化,Ultralytics YOLO 模型非常适合实时检测,也能部署在计算能力和内存有限的边缘设备上。
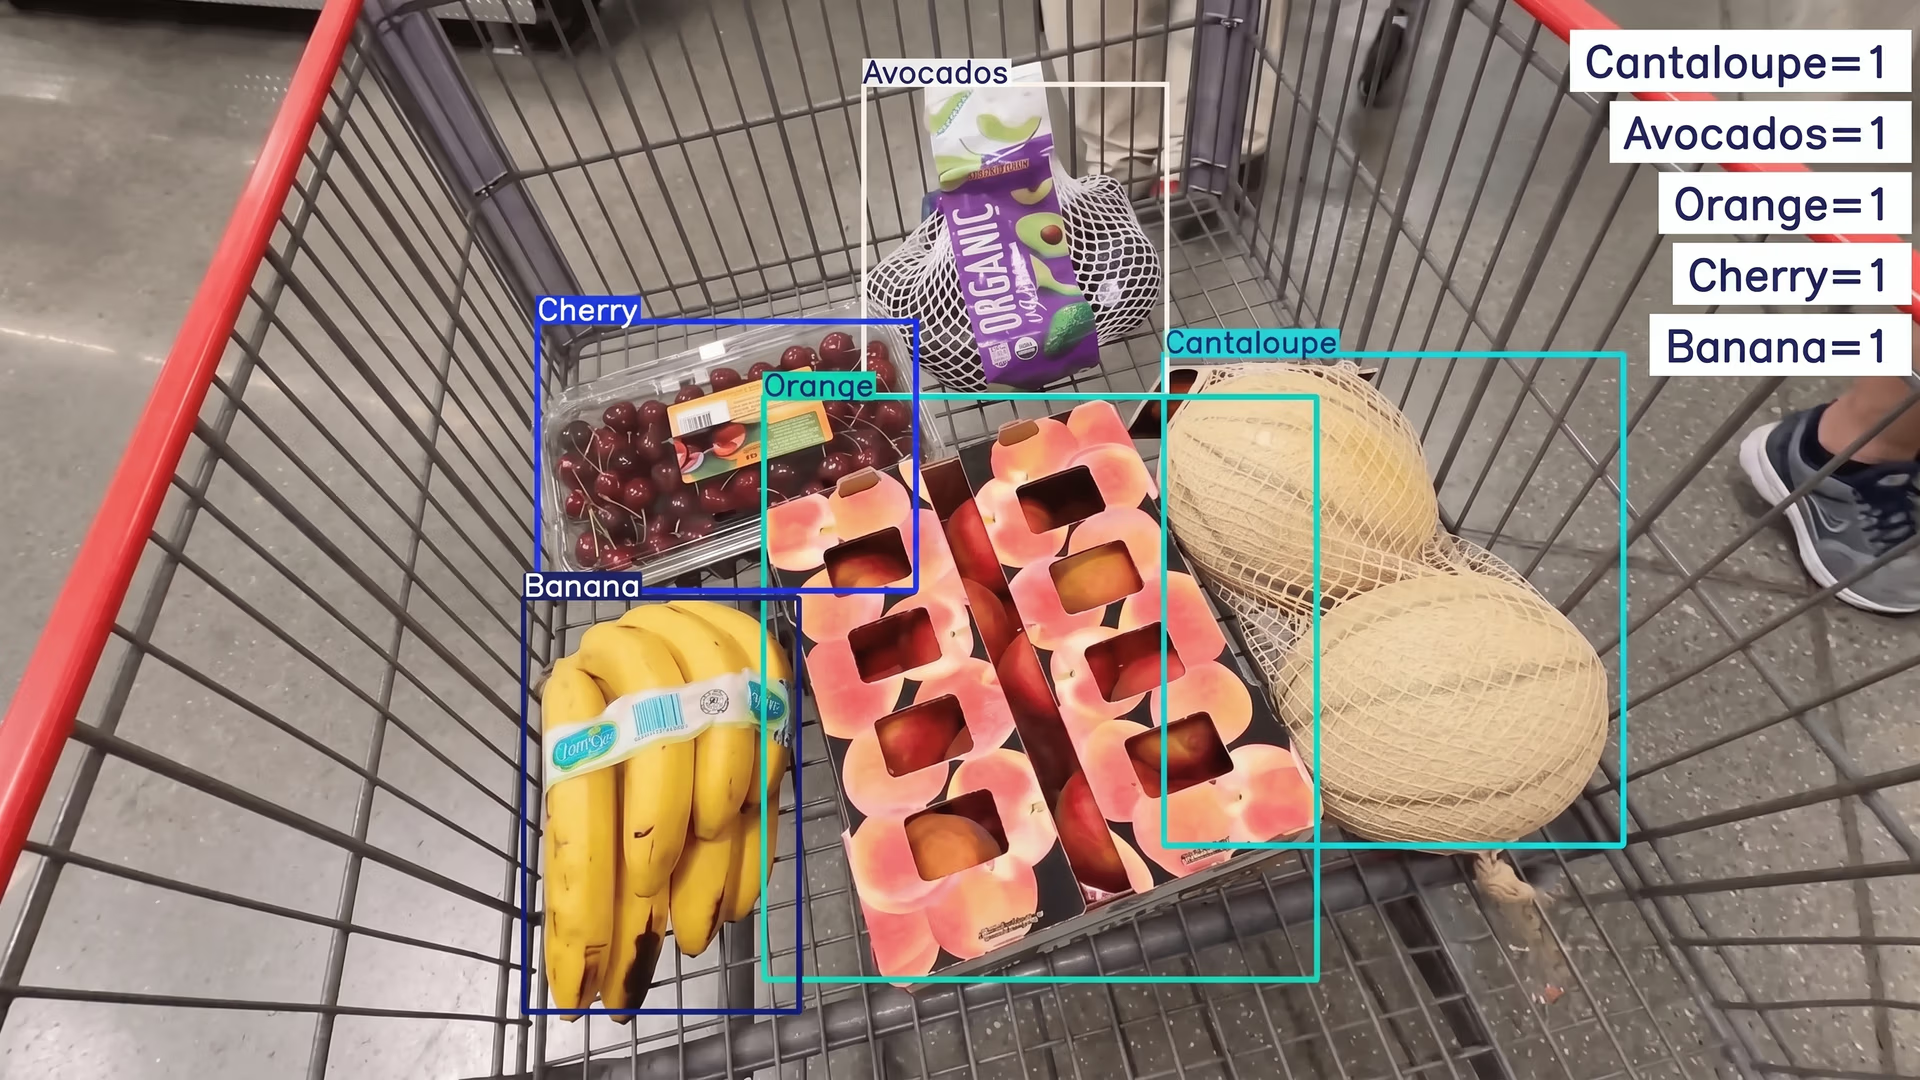
图 3. 使用 Ultralytics YOLO11 进行目标检测(来源)
除了基本的目标检测,这些模型还具有很强的多功能性。它们还支持实例分割(在像素级勾勒物体轮廓)和姿态估计(识别人物或物体上的关键点)等任务。这种灵活性让 Ultralytics YOLO 模型成为众多应用场景的首选,涵盖农业、物流、零售和制造业等领域。
Ultralytics YOLO 模型广受欢迎的另一个重要原因是 Ultralytics Python 软件包,它提供了简单易用的接口,用于训练、微调和部署模型。开发者可以从预训练权重开始,针对自己的数据集定制模型,并通过几行代码完成部署。
2. RT-DETR 和 RT-DETRv2#
RT‑DETR(实时检测 Transformer)和较新的 RT‑DETRv2 都是为实时应用打造的目标检测模型。与许多传统模型不同,它们可以直接接收图像并输出最终检测结果,无需使用非极大值抑制 (NMS)。
当模型多次预测同一个物体时,NMS 会移除多余的重叠框。省去 NMS 可以让检测流程更简单、更快。
这些模型将 CNN 与 Transformer 结合起来。CNN 用于查找边缘和形状等视觉细节,而 Transformer 是一种神经网络,可以一次查看整张图像,并理解不同部分之间的关系。这种全面的理解能力让模型能够检测彼此靠近或相互重叠的物体。
RT‑DETRv2 在原始模型的基础上增加了多尺度检测等功能,有助于发现大小不同的物体,并改进了对复杂场景的处理能力。这些改进在提升精度的同时保持了模型的速度。
3. RF-DETR#
RF‑DETR 是一款基于 Transformer 的实时模型,旨在兼顾 Transformer 架构的准确性与实际应用所需的速度。与 RT‑DETR 和 RT‑DETRv2 一样,它使用 Transformer 分析整张图像,并通过 CNN 提取边缘、形状和纹理等精细视觉特征。
该模型直接根据输入图像预测物体,跳过锚框和非极大值抑制,从而简化检测流程并保持较快的推理速度。RF‑DETR 还支持实例分割,除了预测边界框外,还能在像素级勾勒物体轮廓。
4. EfficientDet#
EfficientDet 于 2019 年底发布,是一款注重高效扩展和高性能的目标检测模型。EfficientDet 的独特之处在于复合缩放:这种方法会同时调整输入分辨率、网络深度和网络宽度,而不是只调整一个因素。因此,无论是为高性能任务扩大模型,还是缩小模型以便轻量化部署,它都能保持稳定的精度。
EfficientDet 的另一个关键组件是高效的特征金字塔网络(FPN),它让模型能够以多个尺度分析图像。这种多尺度分析对于检测不同大小的物体至关重要,使 EfficientDet 能够在同一张图像中可靠地识别大小物体。
5. PP-YOLOE+#
PP-YOLOE+ 于 2022 年发布,是一种 YOLO 风格的目标检测模型,也就是说,它会在一次图像处理过程中检测并分类物体。这种方法速度快,适合实时应用,同时仍能保持较高精度。
PP-YOLOE+ 的一项关键改进是任务对齐学习,它有助于让模型的置信度分数反映物体定位的准确程度。这对于检测较小或相互重叠的物体尤其有用。
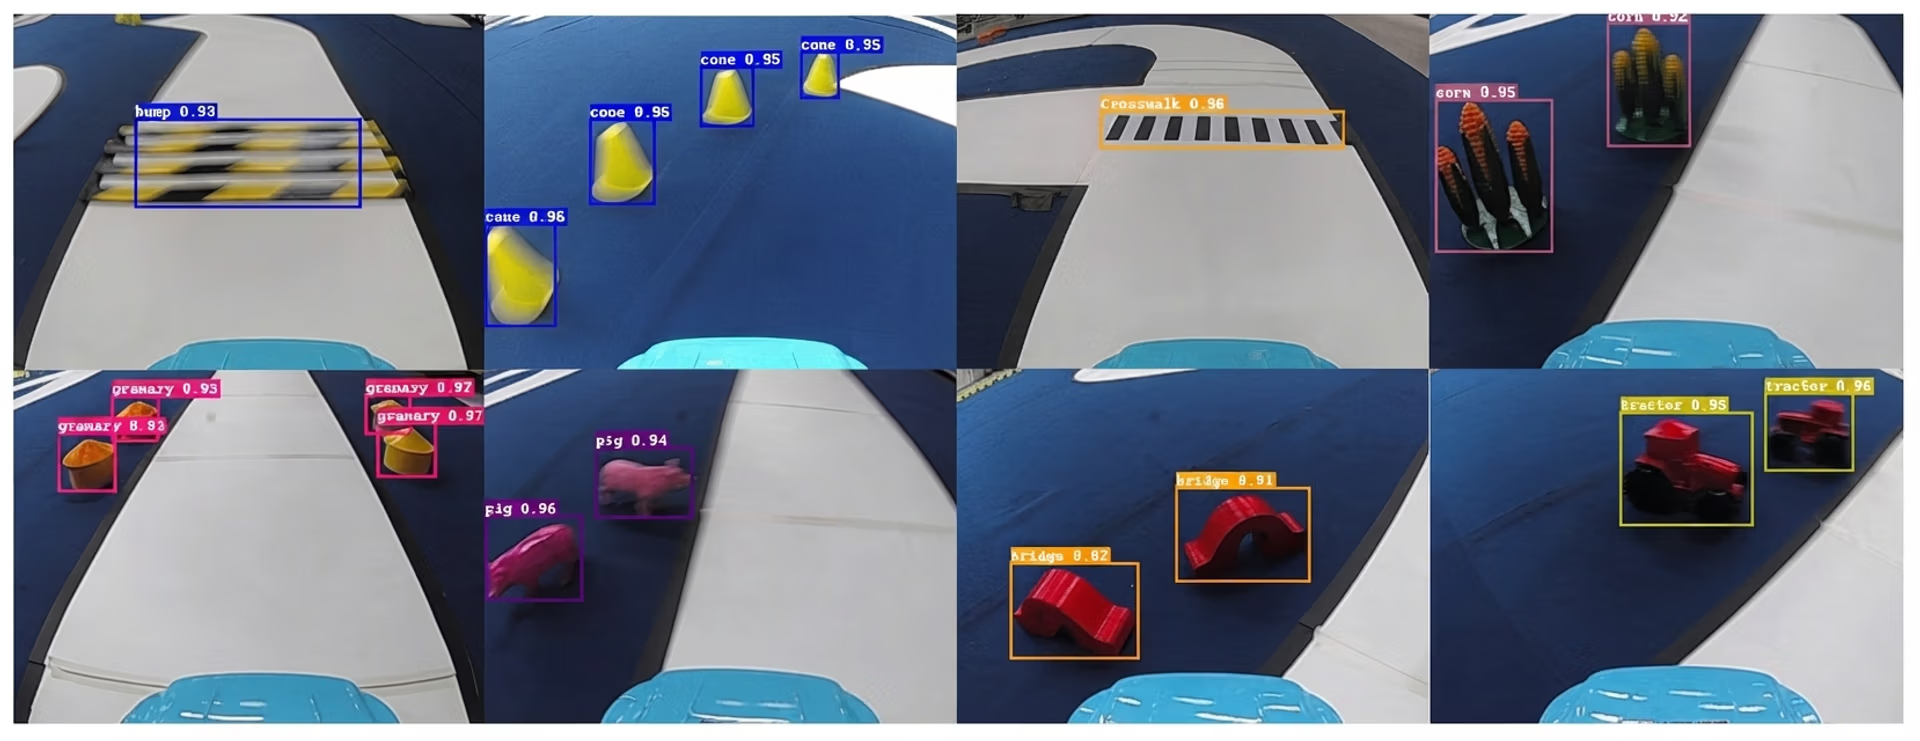
图 4. 使用 PP-YOLOE+ 检测物体(来源)
该模型还采用了解耦头架构,将物体位置预测与类别标签预测分开处理。这让模型能够更精确地绘制边界框,同时正确分类物体。
6. GroundingDINO#
GroundingDINO 是一种基于 Transformer 的目标检测模型,结合了视觉与语言能力。它不依赖固定类别集合,而是允许用户使用自然语言文本提示检测对象。
通过将图像中的视觉特征与文本描述对应起来,模型即使遇到训练数据中没有的标签,也能定位物体。这意味着你可以使用“戴着头盔的人”或“建筑物附近的红色汽车”等描述提示模型,模型会在匹配的物体周围绘制边界框。
此外,GroundingDINO 支持零样本检测,因此无需针对每种新使用场景重新训练或微调模型,能够灵活适用于广泛的应用。若想了解它在真实数据集上与其他开放词汇检测器和视觉语言模型的对比情况,请查看 VLM 排行榜。
目标检测器常用的评估指标#
在比较各种目标检测模型时,你可能会想知道如何判断哪一个的实际表现最好。这是个值得思考的问题,因为除了模型架构和数据质量之外,还有许多因素会影响性能。
研究人员通常依靠通用基准和标准性能指标来一致地评估模型、比较结果,并了解速度与准确率之间的权衡。标准基准尤为重要,因为许多目标检测模型都在相同的数据集上进行评估,例如 COCO 数据集。
衡量检测准确率和速度#
下面来看看评估目标检测模型时常用的一些指标:
- 交并比 (IoU):这项指标用于衡量预测边界框与图像中真实物体的重叠程度。它会比较模型绘制的框与真实标注框,后者表示数据集中标注的物体位置。IoU 的计算方法是两个框的重叠面积除以它们的并集面积。IoU 越高,表示模型定位越准确;IoU 越低,则说明预测不够精确。简单来说,IoU 表示模型的预测与物体真实位置有多接近。
- 平均精度均值(mAP):这是用于评估目标检测整体性能的主要指标。它综合考量模型正确检测到的物体数量,以及模型在不同置信度水平和物体类别下的检测准确性。
- 每秒帧数(FPS) 和延迟:FPS 表示模型每秒可以处理多少张图像或视频帧。例如,以 30 FPS 运行的模型每秒可以处理 30 帧。FPS 越高,系统响应越快,这对实时视频、交通监控或机器人等用例十分重要。另一方面,延迟衡量的是从模型接收单张图像或一帧到结果就绪所需的时间。
使用目标检测算法的优缺点#
以下是目标检测模型在实际应用中的一些主要优势:
- 适用于各行各业: 目标检测可用于各种场景,从交通监控和零售分析到医疗保健、农业和制造业。
- 减少人工工作: 自动化视觉检查和监控任务可以减少持续人工监督的需求,帮助团队专注于更有价值的工作。
- 受益于开源生态: 活跃的开源社区和 GitHub 上的资源让你更容易获取预训练模型、开展实验并定制解决方案。
尽管目标检测模型有这些优点,但实际应用中也存在一些会影响模型表现的限制。以下是需要考虑的一些重要因素:
- 对高质量数据的要求: 目标检测模型依赖大量经过良好标注的数据集进行训练。创建和维护这些数据集可能耗时、成本高昂,而且难以扩展。
- 计算需求: 检测准确率较高的模型通常需要大量算力,无论是在训练期间还是实时部署时都是如此。这通常意味着要使用高性能 GPU,从而增加基础设施成本。
- 对真实环境条件敏感: 光照、摄像头角度、天气和场景拥挤程度的变化都可能影响检测性能,因此需要持续测试和调优。
要点#
哪种目标检测模型最适合你的计算机视觉项目,取决于你的使用场景、数据配置、性能要求和硬件限制。有些模型针对速度进行了优化,有些则侧重准确率,而大多数实际应用都需要兼顾两者。得益于开源框架和 GitHub 上活跃的社区,这些模型的评估、调整和实际部署正变得越来越容易。
如需了解更多信息,请查看我们的 GitHub 代码仓库。加入我们的社区,并查看我们的解决方案页面,了解 AI 在医疗保健领域的应用和汽车行业中的计算机视觉等应用。了解我们的许可选项,立即开始使用视觉 AI。
作者
评论
提出问题、分享你的结果,或帮助其他人。









