打通自然语言处理与计算机视觉
了解自然语言处理 (NLP) 和计算机视觉 (CV) 如何协同工作,通过更智能的跨模态 AI 系统推动行业变革。
 Abirami Vina6 分钟阅读

自然语言处理 (NLP)和计算机视觉 (CV)是人工智能 (AI)中两个不同的分支,近年来都广受关注。得益于 AI 的进步,这两个分支如今的联系比以往任何时候都更加紧密。
自动图像字幕生成就是一个很好的例子。计算机视觉可以分析和理解图像内容,而自然语言处理则可以生成描述图像的字幕。自动图像字幕生成常用于社交媒体平台,以提升无障碍体验;也常用于内容管理系统,以便高效整理和标记图像。
NLP 和视觉 AI 的创新在各行各业催生了许多此类应用。本文将深入介绍 NLP 和计算机视觉,讨论它们各自的工作方式。我们还将探讨同时使用这两种技术的应用。
了解 NLP 和视觉 AI#
NLP 关注计算机与人类语言之间的交互。它让机器能够以有意义的方式理解、解释和生成文本或语音。NLP 可用于执行翻译、情感分析或摘要生成等任务。
与此同时,计算机视觉帮助机器分析和处理图像与视频。它可用于检测照片中的物体、面部识别、目标跟踪或图像分类等任务。视觉 AI 技术让机器能够更好地理解视觉世界并与之交互。
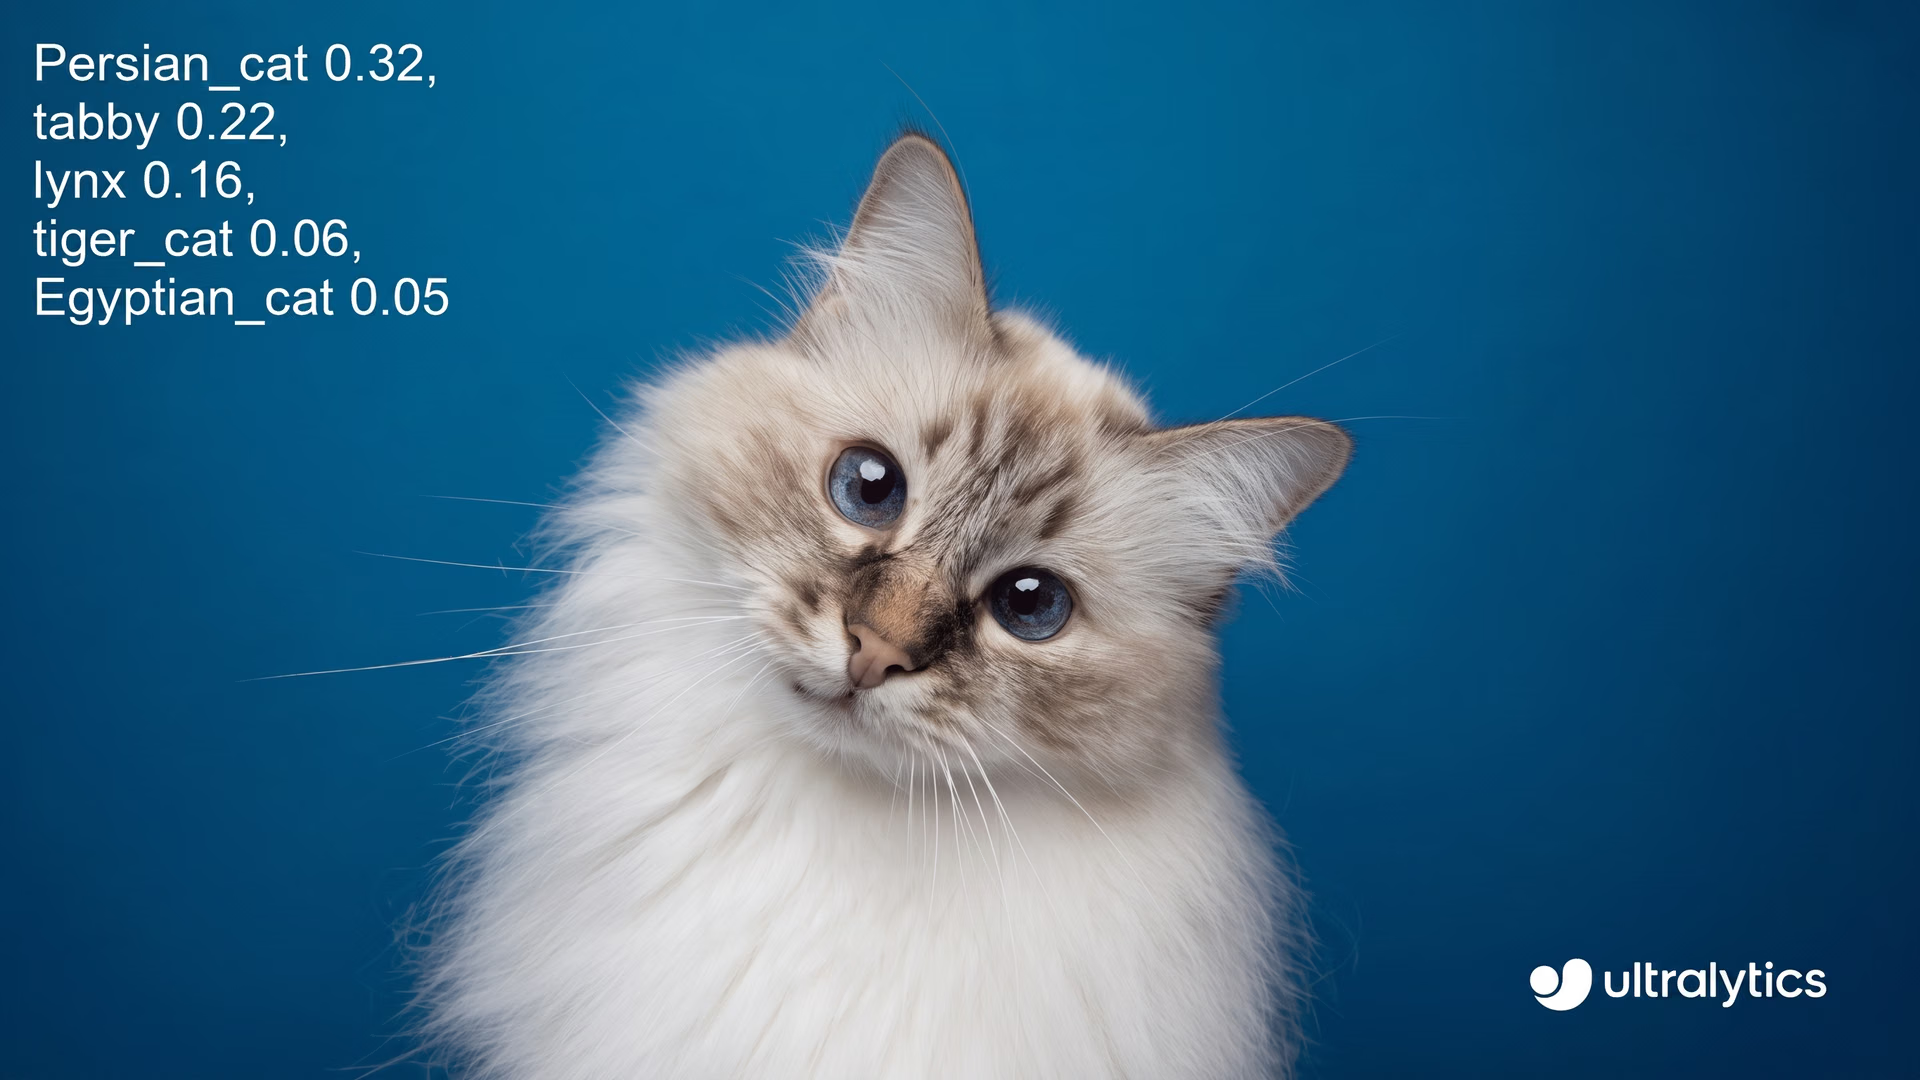
图 1. 图像分类示例。
与计算机视觉集成后,NLP 可以通过结合文本和图像为视觉数据赋予意义,从而实现更深入的理解。俗话说,“一图胜千言”;与文本结合后,图像的表达力会更强,带来更丰富的见解。
NLP 与计算机视觉协同工作的示例#
你可能在日常工具中见过 NLP 和计算机视觉协同工作,却没有注意到,例如手机可以翻译图片中的文字。
事实上,Google 翻译使用自然语言处理和计算机视觉来翻译图像中的文字。当你拍摄一张其他语言的路牌照片时,计算机视觉会识别并提取文字,而 NLP 则会将其翻译成你偏好的语言。
NLP 和 CV 协同工作,让整个过程顺畅高效,使用户能够实时理解并处理不同语言的信息。这种集成有助于打破沟通障碍。

图 2。Google 翻译功能。
以下是 NLP 和计算机视觉协同工作的其他应用:
- 自动驾驶汽车:CV 可用于检测道路标志、车道和障碍物,而 NLP 可以处理语音指令或道路标志上的文字。
- 文档阅读器:视觉 AI 可以识别扫描文档或手写内容中的文字,自然语言处理则可以解读和总结这些信息。
- 购物应用中的视觉搜索:计算机视觉可以识别照片中的商品,而 NLP 会处理搜索词以改进推荐结果。
- 教育工具:CV 可以识别手写笔记或视觉输入,NLP 则可以根据内容提供解释或反馈。
连接计算机视觉与 NLP 的关键概念#
了解计算机视觉和自然语言处理的应用后,接下来我们来探讨它们如何结合起来实现跨模态 AI。
跨模态 AI 将计算机视觉带来的视觉理解能力与 NLP 的语言理解能力结合起来,以处理并关联文本和图像中的信息。例如,在医疗保健领域,跨模态 AI 可以帮助分析X 光片,并生成清晰的书面摘要,说明潜在问题,从而帮助医生更快、更准确地做出决策。
自然语言理解 (NLU)#
自然语言理解是 NLP 的一个子领域,重点是通过分析文本的意图、上下文、语义、语气和结构来解读并提取含义。NLP 处理原始文本,而 NLU 让机器能够更有效地理解人类语言。例如,解析是一种 NLU 技术,可将书面文本转换为机器能够理解的结构化格式。

图 3。NLP 与 NLU 的关系。
当视觉数据中包含需要理解的文本时,NLU 会与计算机视觉协同工作。计算机视觉利用光学字符识别 (OCR)等技术,从图像、文档或视频中提取文本。这些任务可以包括扫描收据、读取路牌文字或将手写笔记数字化。
随后,NLU 会处理提取出的文本,以理解其含义、上下文和意图。这种组合让系统不只是识别文本,还能对收据中的费用进行分类,或分析语气和情感。计算机视觉与 NLU 协同工作,能将视觉文本转化为有意义、可执行的信息。
提示词工程#
提示词工程是设计清晰、准确且详尽的输入提示词,以引导生成式 AI 系统(如大型语言模型 (LLMs)和视觉语言模型 (VLMs))生成预期输出的过程。这些提示词充当指令,帮助 AI 模型理解用户的意图。
有效的提示词工程需要了解模型的能力,并设计输入内容,最大限度地发挥模型生成准确、有创意或有见地的回答的能力。这对于同时处理文本和图像的多模态模型尤为重要。
以 OpenAI 的 DALL·E 文生图模型为例。如果你要求它生成“一张宇航员骑马的照片级真实图像”,它就能根据你的描述生成对应图像。这在平面设计等领域很有用,专业人士可以快速将文字创意转化为视觉草图,节省时间并提高效率。

图 4。使用 OpenAI 的 DALL-E 创建的图像。
你可能会想知道这与计算机视觉有什么关系——这不只是生成式 AI吗?实际上,两者关系密切。生成式 AI 基于计算机视觉的基础,创造全新的视觉内容。
生成式 AI 模型通过大量图像及其配套文本描述进行训练,从文本提示词生成图像。这使模型能够学习语言与物体、纹理和空间关系等视觉概念之间的联系。
这些模型并不像传统计算机视觉系统那样解读视觉数据,例如识别真实图像中的物体。相反,它们会利用对这些概念的学习理解,根据提示词生成新的视觉内容。通过将这些知识与精心设计的提示词结合,生成式 AI 可以生成逼真、细致且符合用户输入的图像。
问答 (QA)#
问答系统旨在理解自然语言问题,并提供准确、相关的答案。它们使用信息检索、语义理解和深度学习等技术来解读并回答问题。
OpenAI 的 GPT-4o等先进模型可以处理视觉问答 (VQA),也就是说,它们能够分析图像并回答有关图像的问题。不过,GPT-4o 不会直接执行计算机视觉任务。相反,它会使用专用图像编码器处理图像、提取特征,并将这些特征与语言理解能力结合起来给出答案。

图 5. ChatGPT 的视觉问答能力。图片由作者提供。
其他系统更进一步,全面集成了计算机视觉能力。这些系统可以直接分析图像或视频,以识别物体、场景或文字。与自然语言处理结合后,它们能够回答有关视觉内容的更复杂问题。例如,它们可以通过检测和解读视觉元素来回答“这张图像中有哪些物体?”或“这段视频里是谁?”。要了解当前视觉语言模型在图像中定位物体的表现,请查看 VLM 排行榜。
零样本学习 (ZSL)#
零样本学习 (ZSL)是一种机器学习方法,可让 AI 模型处理未见过的新任务,而无需专门针对这些任务进行训练。它利用描述或语义关系等额外信息,将模型已有的知识(已见类别)与新的、未见过的类别联系起来。
在自然语言处理中,ZSL 依靠词语和概念之间的关系,帮助模型理解并处理未经训练的主题。同样,在计算机视觉中,ZSL 通过将翅膀或羽毛等视觉特征与鸟类等已知概念联系起来,让模型能够识别从未见过的物体或场景。
ZSL 将语言理解与视觉识别结合起来,连接 NLP 和 CV,因此特别适用于需要同时处理两者的任务。例如,在视觉问答中,模型可以分析图像,同时理解相关问题,从而给出准确的回答。ZSL 也适用于图像描述生成等任务。
要点#
自然语言处理与计算机视觉的结合,催生了能够理解文本和图像的 AI 系统。从帮助自动驾驶汽车读取道路标志,到改善医疗诊断和提升社交媒体安全性,这种组合已应用于许多行业。随着这些技术不断进步,它们将继续让生活更便利,并为各行各业开辟新的机遇。访问我们的 GitHub 仓库,并加入我们的社区交流。通过解决方案页面了解 自动驾驶汽车和农业中的 AI 应用。
作者
评论
提出问题、分享你的结果,或帮助其他人。









