OpenAI o1:专为 AI 推理打造的全新 OpenAI 模型系列
了解新发布的 OpenAI o1 模型及其独特之处。我们还将探讨其工作原理,以及它们对 AI 未来的影响。
AI 社区一直热议 OpenAI 的 GPT 模型下一步会如何发展,许多人称之为“Project Strawberry”。原因是,如果你通过询问单词“strawberry”里有几个 R 来提示 GPT-4o,它会告诉你单词“strawberry”里有两个 R。考虑到 GPT-4o 的强大能力,这似乎有些奇怪。不过,该模型的设计目标是处理潜台词,而非精确的字词。此前有传言称,下一个模型将致力于解决这个问题。Sam Altman 在自己的 X(原名 Twitter)账号上发布草莓图片,进一步助长了这些传言。
随着 OpenAI 于 9 月 12 日星期四发布最新公告,关于这场猜测,我们终于有了答案!OpenAI o1 已经发布,这是一个全新的 AI 模型系列,旨在放慢速度、先思考再回答。有趣的是,OpenAI o1 的推理能力更强,也能正确回答草莓相关的问题!本文将介绍 OpenAI o1 是什么、如何工作、可以应用于哪些场景,以及它对 AI 未来意味着什么。现在开始吧!
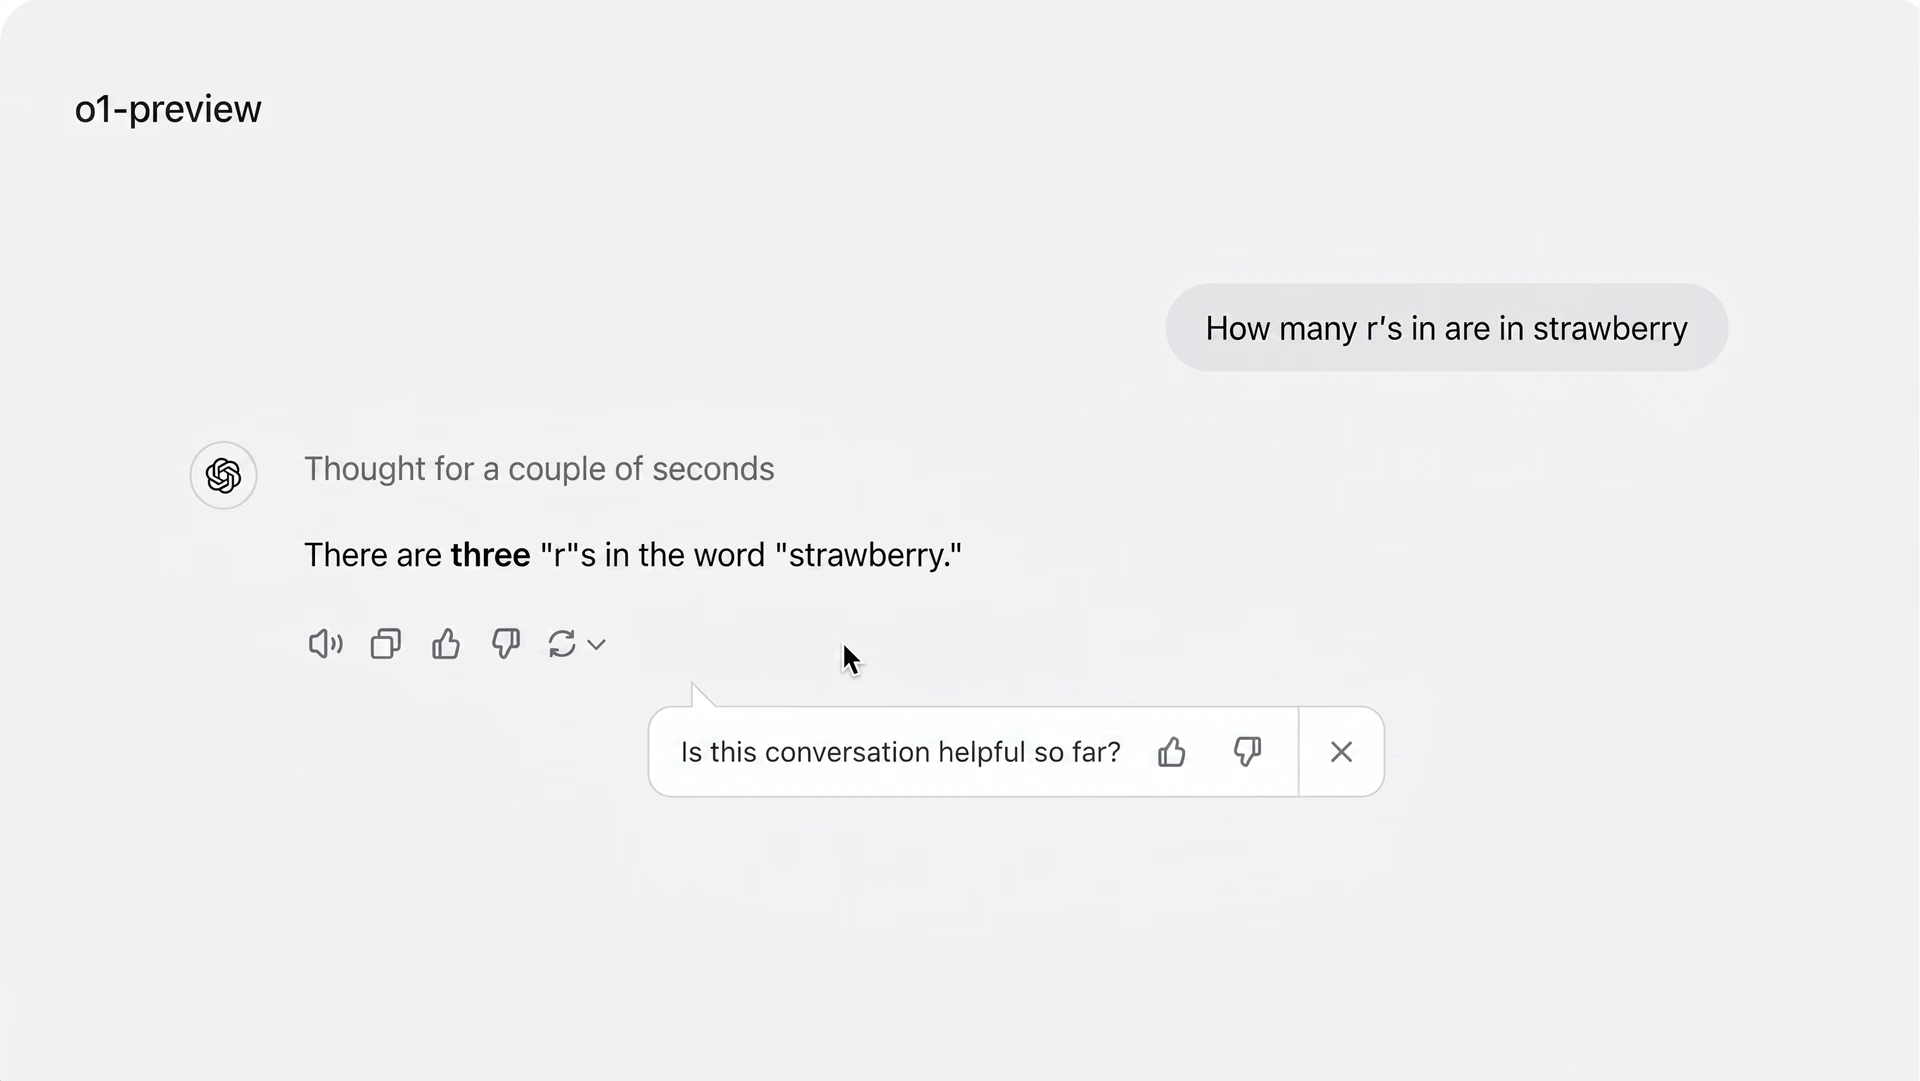
图 1。向 OpenAI o1 提问草莓相关问题的示例。
OpenAI 在 AI 领域的新进展#
2024 年 7 月,OpenAI 高管表示,OpenAI 的研究正接近人类水平的问题解决能力,他们将其称为 AI 的第 2 级。显然,这一等级侧重于推理能力,因为 OpenAI 将全新模型系列 OpenAI o1 描述为会先思考再回答。OpenAI o1 是一种全新的 LLM(大型语言模型),这类 AI 模型通过从海量语言数据中学习模式,理解并生成类似人类的文本。它专为处理需要深入推理的复杂问题而设计。
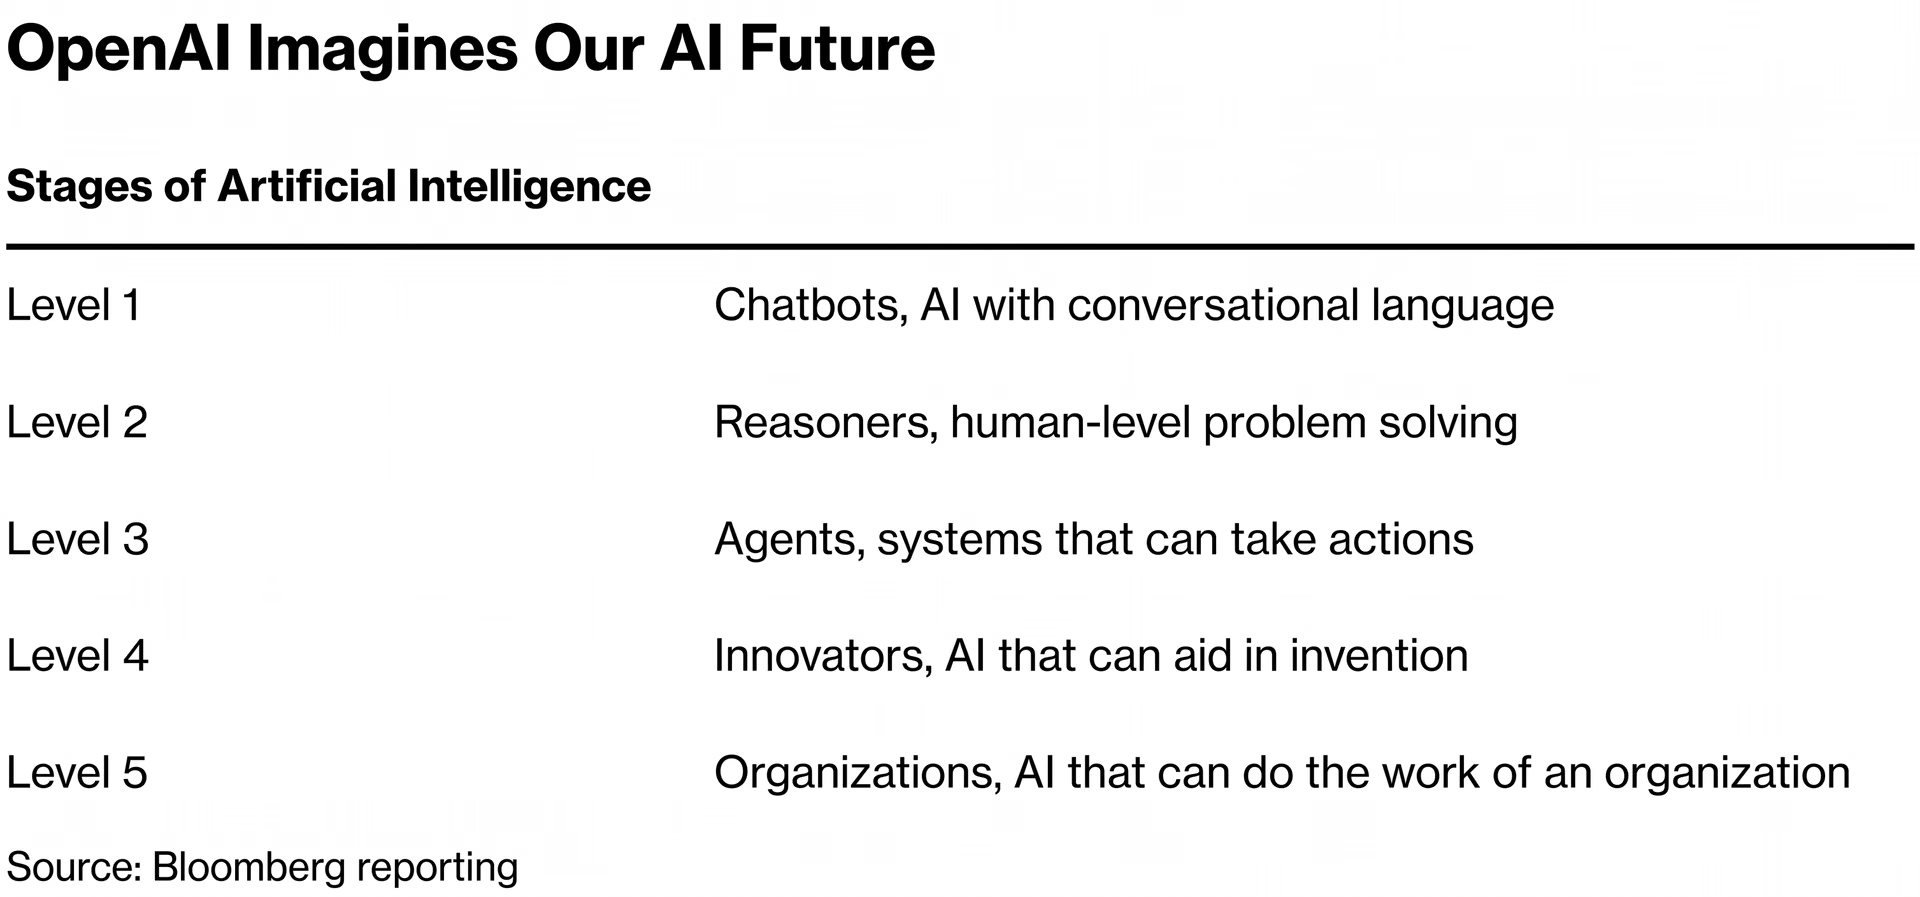
图 2。 OpenAI 对 AI 发展阶段的看法。
该模型通过强化学习进行训练,这种技术让模型通过试错来学习做出更好的决策,并根据自身行为获得奖励或惩罚。强化学习算法通过引导模型进行思维链推理,帮助模型更有效地思考。OpenAI 还表示,o1 的性能会随着训练期间强化学习次数的增加,以及解决问题时用于“思考”的时间延长而持续提升,这表明延长训练和审慎处理都有助于增强模型能力。
尽管 OpenAI o1 在复杂推理方面取得了重大进展,但它仍处于早期阶段,缺少一些让 ChatGPT 实用的功能,例如网页浏览以及上传文件和图片。对于许多常见任务,目前 GPT-4o 可能仍然更胜一筹。不过,OpenAI o1 大幅提升了 AI 处理复杂推理的能力,因此 OpenAI 正在开启一个新的模型系列,并将其命名为 OpenAI o1。
全新 OpenAI 模型如何增强 AI 推理能力#
OpenAI o1 可用于解密、解决编程挑战、回答数学问题、破解填字游戏,甚至处理科学、安全和医疗保健等领域的复杂主题。为了有趣地呼应项目代号,OpenAI 展示了模型的推理能力:它破解了一段密码,揭示出“THERE ARE THREE R’S IN STRAWBERRY”这句话。
除了破解密码,OpenAI o1 也擅长编程。它在 Codeforces 等平台举办的竞技编程挑战中表现出色。程序员会在限时条件下于该平台解决复杂的编程问题。在这些挑战中,该模型取得了较高的 Elo 评分(根据与其他参赛者对战的表现衡量技能水平的评分系统),并且表现优于此前的模型。它在数学方面也很出色,并在考试中表现良好,例如美国数学邀请赛(AIME)。
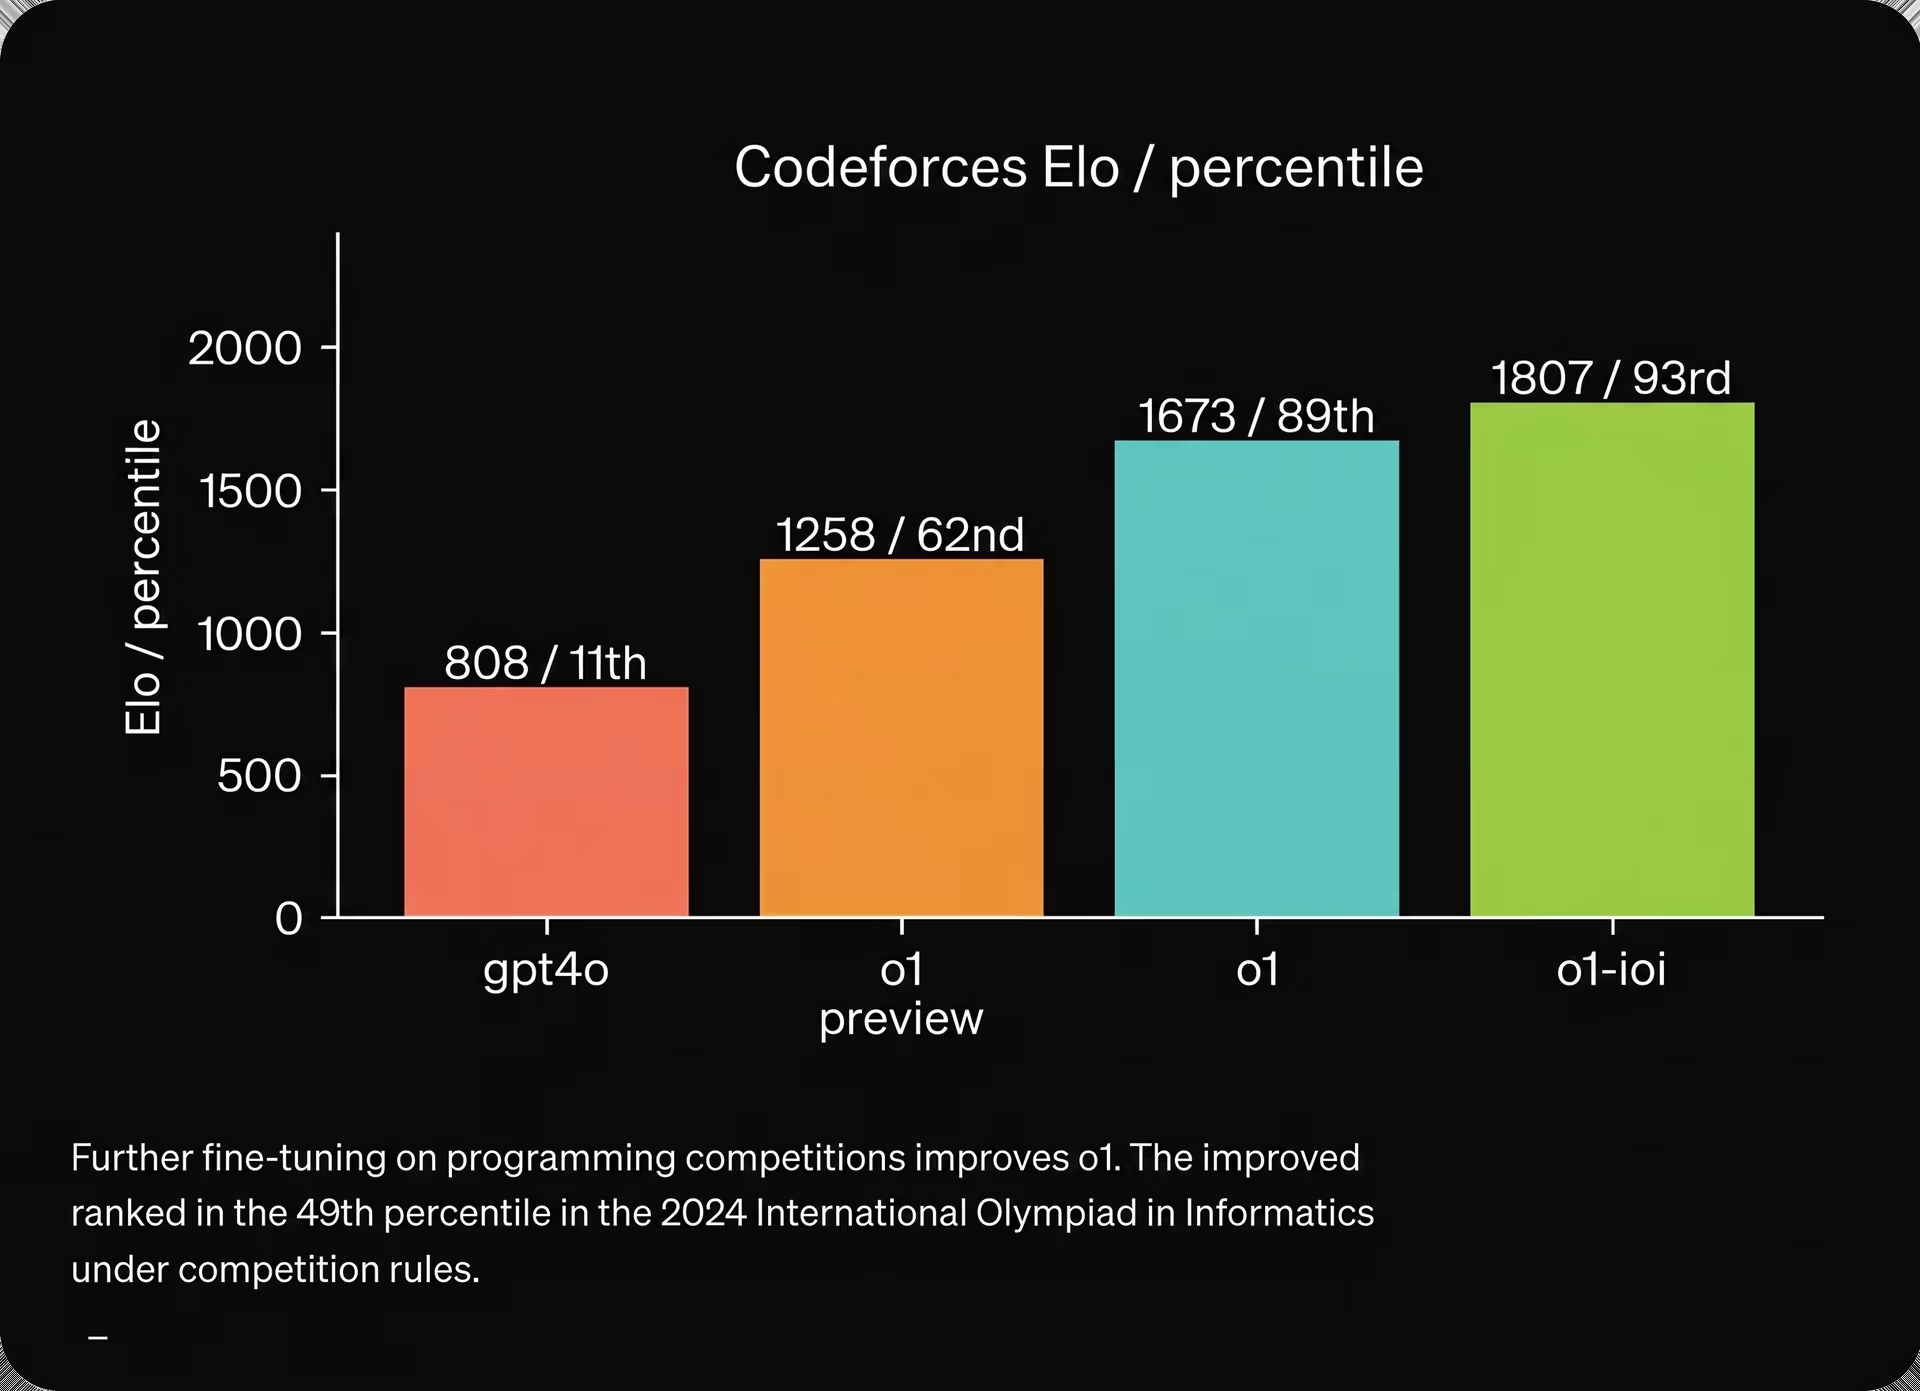
图 3。 o1 编程能力基准测试。
这些进展使 OpenAI o1 成为相较 GPT-4o 等早期模型的一次重大升级。它为 AI 在商业、开发、研究和医疗保健等领域开辟了新的可能性。例如,在遗传学研究中,OpenAI o1 可以快速查阅大量研究论文,提取关键发现以及遗传标记与疾病之间的联系。它能理解复杂的科学语言并总结要点,帮助研究人员聚焦于最相关的信息。
深入了解思维链#
前面提到,OpenAI o1 引入了“思维链”推理过程。这使模型能够以类似人类认知策略的方式处理复杂问题。模型可以把挑战拆解为更小、更易处理的步骤,并反复改进解决方法。与依赖即时模式识别的早期模型不同,o1 会探索多条推理路径来优化决策,并通过强化学习从成功和失误中汲取经验。
OpenAI 决定不向用户公开这些未经处理的思维链,而是提供摘要,让用户了解模型的推理过程,同时不暴露每个步骤。这个决定有助于防止模型的思维过程被滥用,同时仍让开发者能够监控和改进 AI 的安全性与对齐情况。通过在内部观察隐藏的思维链,开发者可以确保 o1 遵循道德准则,避免有害行为。
OpenAI o1 的基准测试#
在多项测试推理和问题解决能力的基准测试中,OpenAI o1 的表现都远胜 GPT-4o。在 2024 年美国数学邀请赛(AIME)中,这项考试面向顶尖高中生且难度很高,o1 每道题仅使用一个样本就取得了 74% 的准确率,而 GPT-4o 为 12%。综合 64 个样本的结果后,o1 的准确率提升至 83%;使用 1,000 个样本进行改进后的重新排序后,准确率达到 93%,跻身全国前 500 名学生之列。
除了数学,o1 在测试科学知识的基准测试中也表现卓越,例如 GPQA Diamond。这项测试涵盖化学、物理学和生物学领域的博士级问题。值得注意的是,o1 在这项测试中超越了拥有博士学位的人类专家,成为首个做到这一点的 AI 模型。在测试历史、法律和科学等多学科理解能力的 MMLU 基准测试中,o1 在 57 个类别中的 54 个类别里也胜过 GPT-4o。
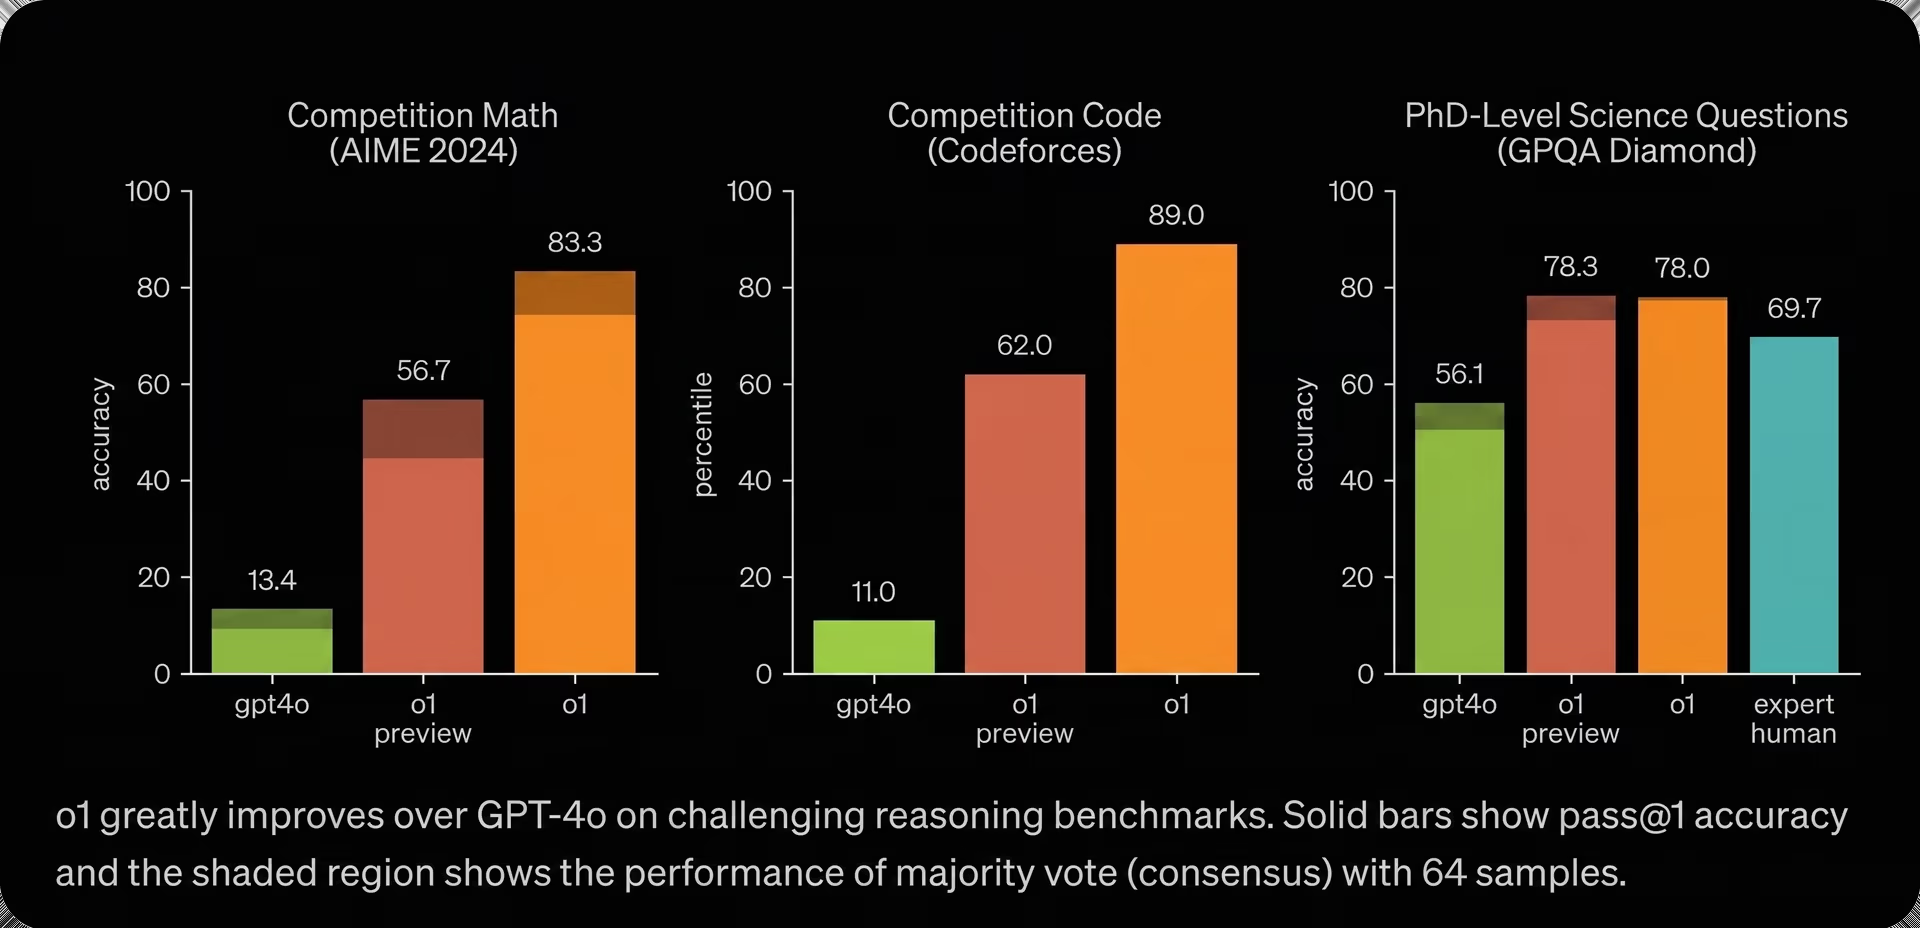
图 4。 OpenAI o1 基准测试。
亲自体验 OpenAI o1#
OpenAI 推出了 o1 系列中的两款全新 AI 模型:o1-preview 和 o1-mini。o1-preview 旨在回答前进行更深入的思考,擅长科学、编程和数学领域的复杂推理任务。它为处理高难度项目的用户提供先进的问题解决能力。相比之下,o1-mini 是一个更小、更快、更具成本效益的模型,专门针对 STEM 推理进行优化,尤其适用于数学和编程。虽然它的世界知识覆盖面可能较窄,但在 AIME 数学竞赛和 Codeforces 编程挑战等关键评估中,o1-mini 的表现几乎与 o1-preview 不相上下,成本却低 80%。
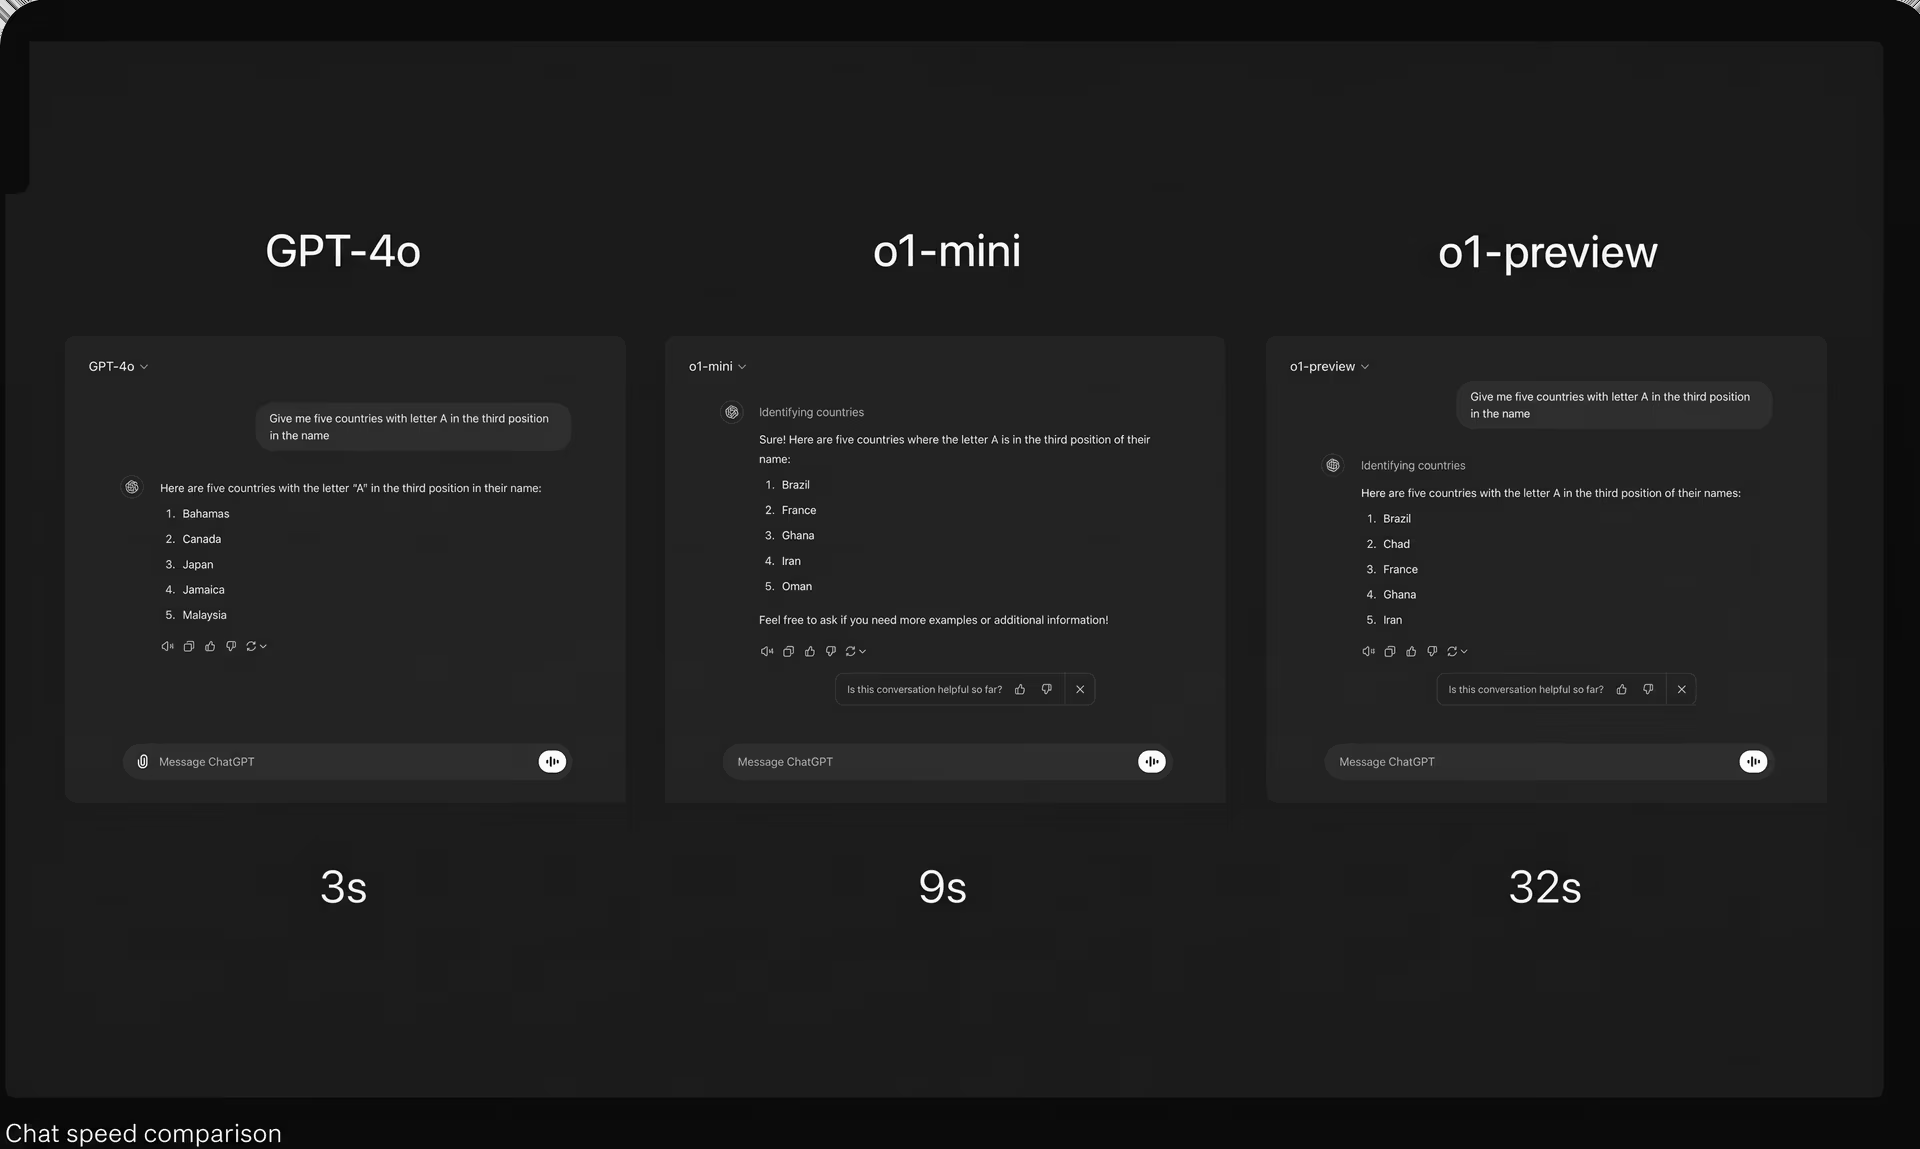
图 5。 OpenAI 模型对比。
你可以通过多个 OpenAI 平台试用这些模型。ChatGPT Plus 和 Team 用户可以通过模型选择器使用 o1-preview 和 o1-mini,直接在 ChatGPT 中体验增强的推理能力。API 使用等级为 5 的开发者可以开始使用这些模型进行原型开发,不过部分高级功能仍在开发中。OpenAI 还计划很快向所有 ChatGPT 免费用户开放 o1-mini。探索这些模型,你可以亲自体验 AI 推理方面的进展,并选择最适合自己需求的模型。
OpenAI 对 AI 道德问题的考量#
OpenAI 在开发 o1 模型系列时重点关注道德与安全。在发布 o1-preview 和 o1-mini 模型之前,OpenAI 进行了全面评估,包括外部测试和内部风险检查,涵盖违规内容、幻觉和偏见等风险。这些模型具备先进的推理能力,能够更好地理解并遵守安全规则。
OpenAI 还实施了屏蔽列表和安全分类器等防护措施来管理风险。o1 模型的总体风险评级为中等。在网络安全和模型自主性等方面,风险较低;而在 CBRN(化学、生物、放射性和核相关)内容及说服能力等方面,风险为中等。OpenAI 的安全顾问小组和董事会审查了这些安全措施,确保模型的使用安全且合乎道德。
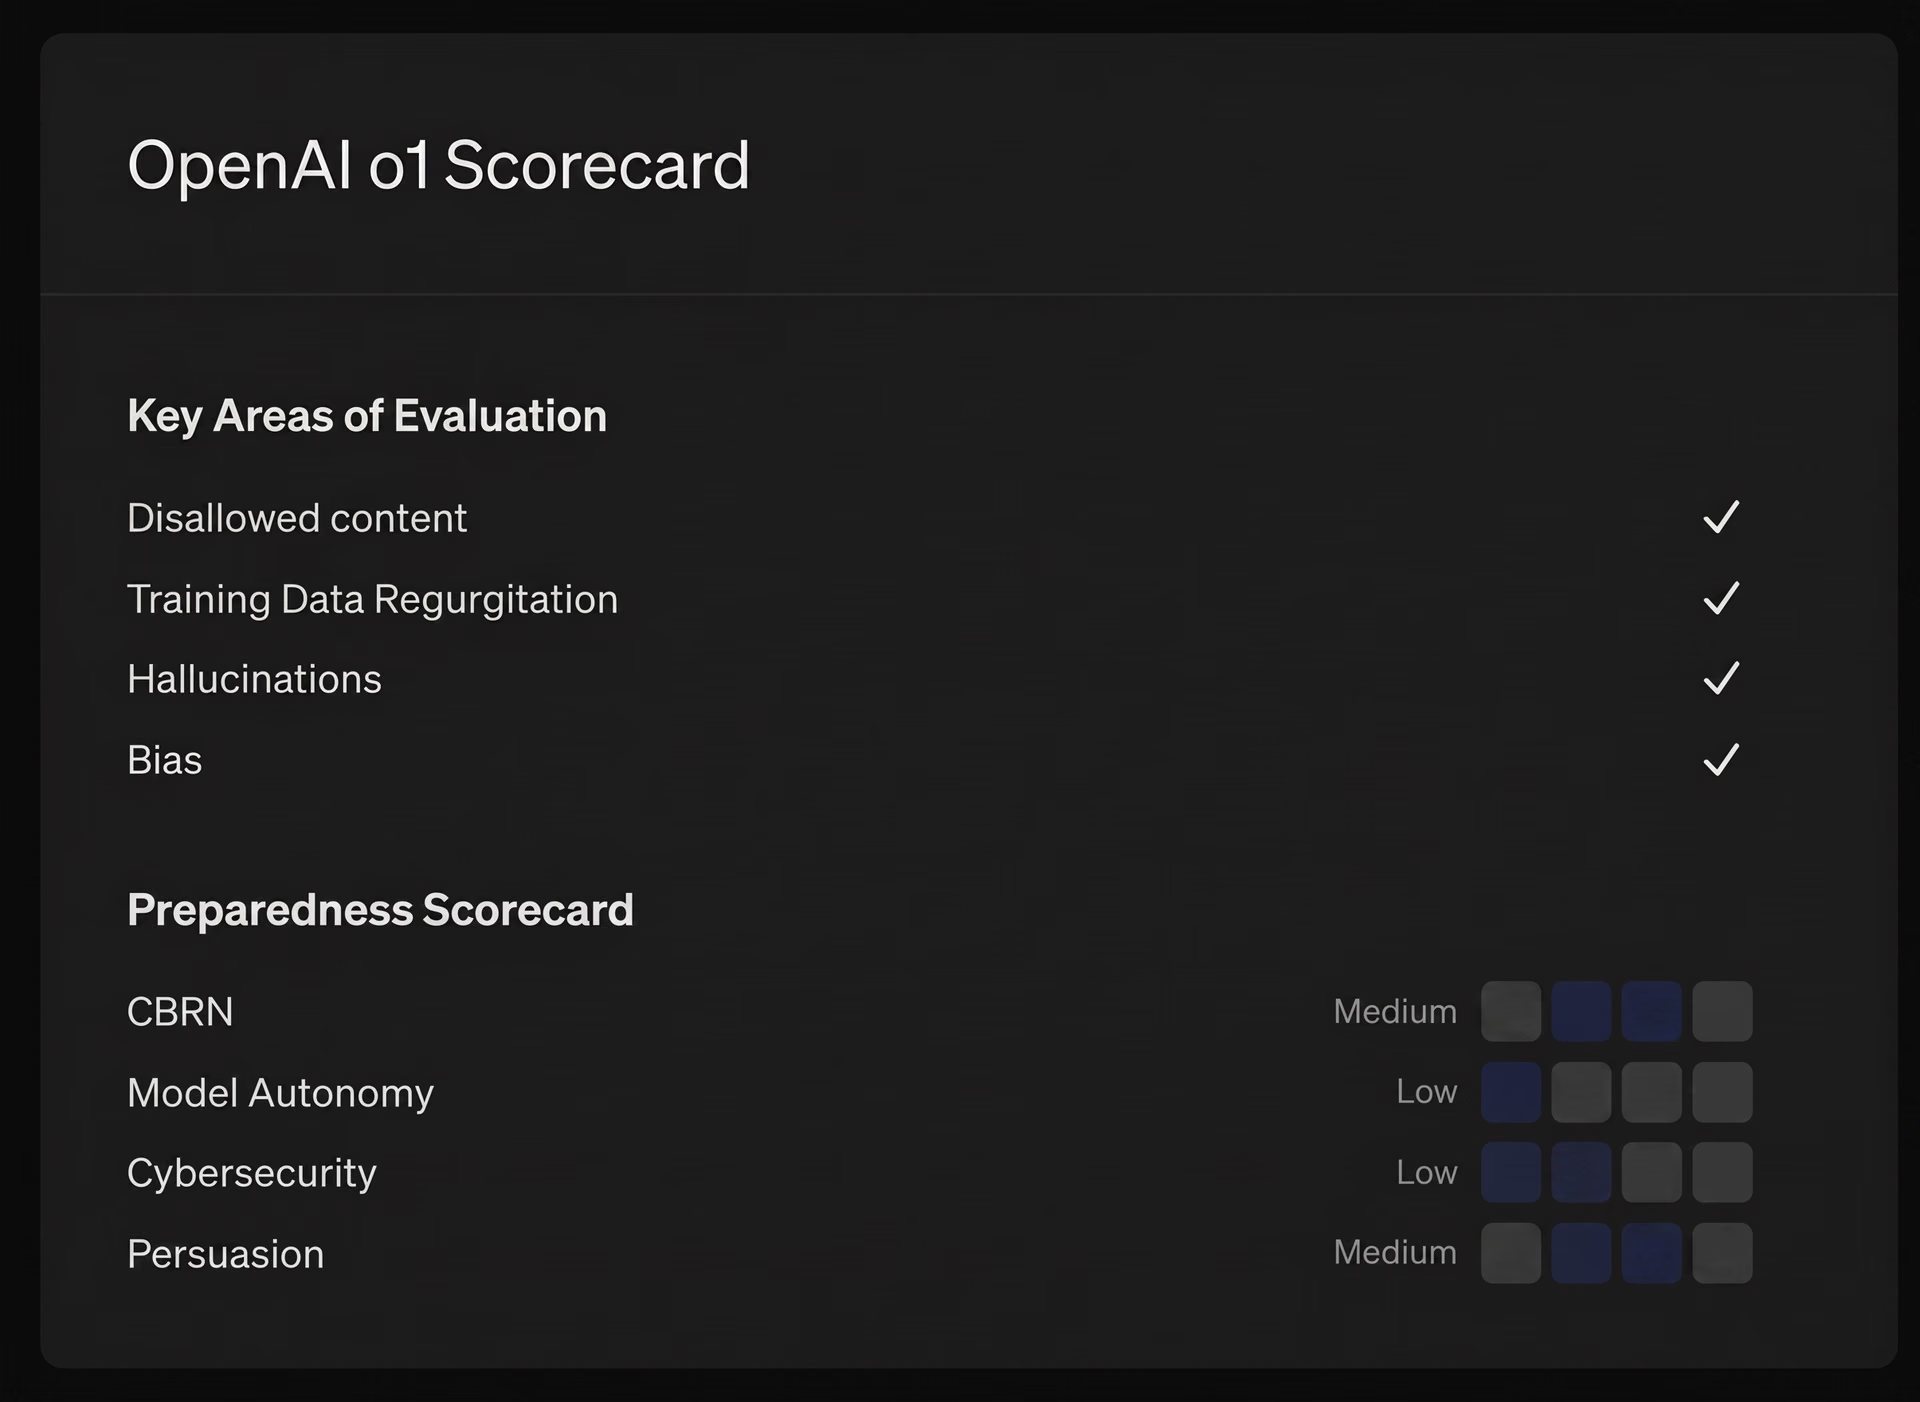
图 6。 OpenAI o1 评分卡。
从传闻到现实:OpenAI o1 登场#
OpenAI o1 大幅提升了 AI 的推理能力,让一些早期传闻成为现实。与 GPT-4o 不同,o1 系列采用“思维链”方法进行更深入的思考,将复杂问题拆解为更小的步骤,以便给出更好的回答。目前,OpenAI o1 已作为早期预览版在 ChatGPT 和 API 中推出,OpenAI 计划添加网页浏览以及文件和图片上传等功能。OpenAI 还表示,除了全新的 OpenAI o1 系列,还将继续开发并发布 GPT 系列模型。随着 AI 持续发展,这些进展正为更强大、更直观、更灵活的 AI 系统铺路,让系统能够更好地帮助人们并理解人类需求。
加入我们的社区,紧跟 AI 领域的最新动态!访问我们的 GitHub 代码仓库,了解我们如何在制造业和医疗保健等领域开创 AI 解决方案。🚀








