如何使用 Ultralytics Platform 导出 Ultralytics YOLO 模型
使用 Ultralytics Platform 轻松导出视觉 AI 模型。了解如何只需几次点击,就能为边缘端、移动端和云端部署做好模型准备。
上个月,我们推出了 Ultralytics Platform,这是一个统一的工作空间,旨在简化完整的计算机视觉工作流。它将数据集管理、标注、模型训练、测试、部署和监控等关键视觉 AI 功能整合到一个简洁流畅的界面中。
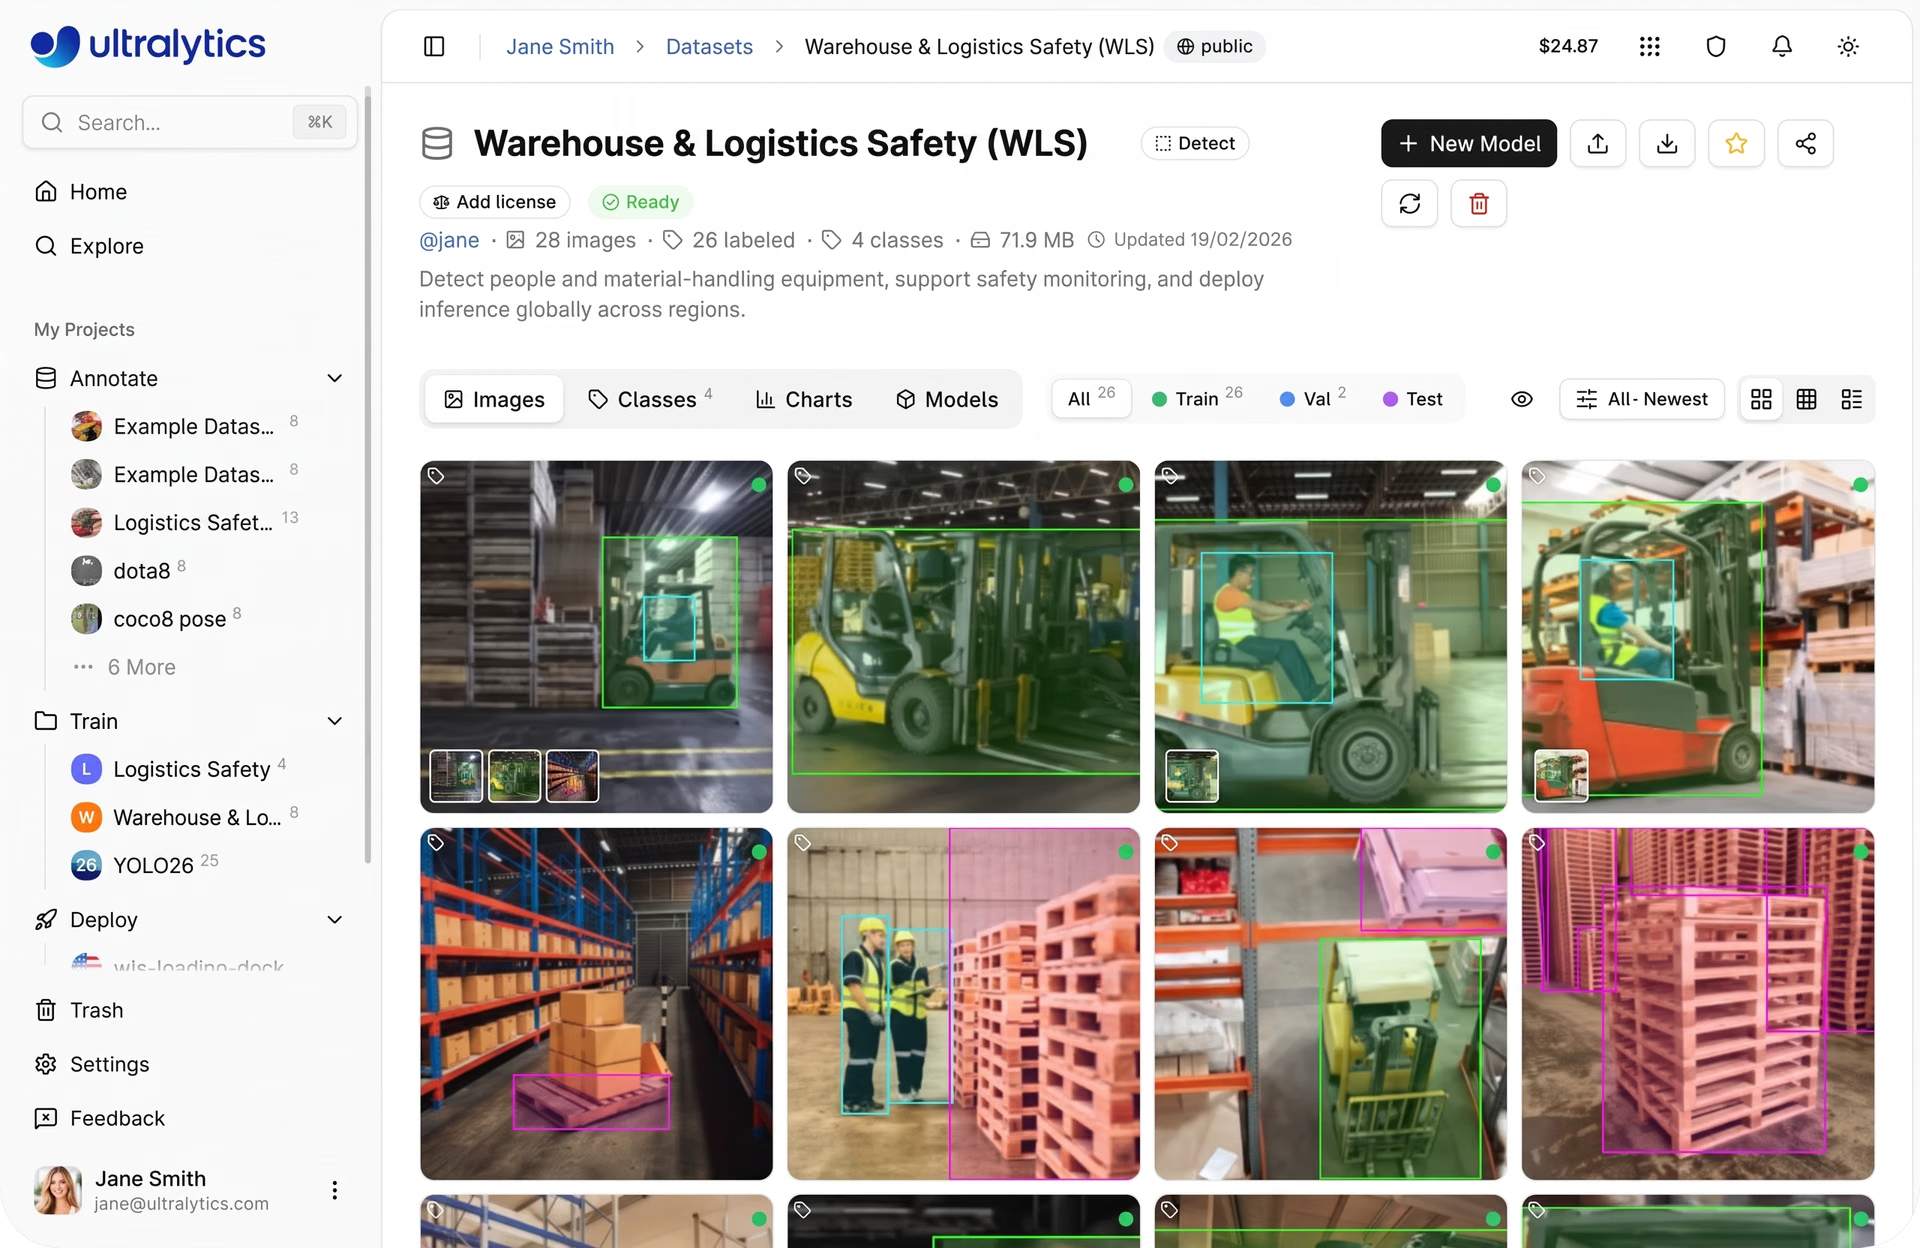
图 1. Ultralytics Platform 一览(来源)
在这个端到端工作流中,部署对于将模型从实验阶段带入实际应用至关重要。此前,我们介绍了平台提供的各种部署选项,包括通过 API 进行共享推理、用于可扩展生产部署的专用端点,以及导出模型以便在边缘设备或外部基础设施上运行。
现在,让我们深入了解模型导出,以及它如何支持模型在不同环境中部署。与在 Ultralytics Platform 托管基础设施中执行模型的共享推理和专用端点不同,模型导出能够让模型部署并运行在外部环境中,例如边缘设备、移动应用和自定义基础设施。
在这些环境中运行模型之前,需要先将模型转换为目标运行时支持的格式。每种部署配置都有自己的要求,从适用于移动设备和边缘设备的轻量级格式,到适用于云端和 GPU 系统的高性能格式。
传统上,这个过程可能耗时很久,需要编写脚本、处理依赖项并使用多种工具。使用 Ultralytics Platform,导出过程要简单得多。只需点击几下,就能转换和优化模型,无需额外配置。
本文将介绍模型导出的含义、Ultralytics Platform 支持的格式,以及如何根据你的使用场景选择合适的格式。我们开始吧!
模型导出概览#
模型导出是指将预训练模型或自定义训练的模型转换为可在其原始框架之外使用的格式。Ultralytics YOLO 模型使用 PyTorch 构建,并以原生格式存储。这种格式适用于 PyTorch 生态系统中的训练、评估和实验。
不过,部署环境通常采用不同的运行时,并有不同的硬件要求。因此,训练时使用的格式并不总是适合部署。
例如,移动应用可能需要针对低功耗进行优化的轻量级格式,而基于浏览器的应用则需要能够在 Web 环境中高效运行的格式。
摄像头和嵌入式系统等边缘设备适合使用紧凑、快速的模型,而云系统则专为高性能推理而设计。为支持这些不同场景,模型需要导出为兼容的格式。
为什么模型导出选项比以往任何时候都重要#
如今,计算机视觉模型正被部署到更接近数据生成位置的地方,尤其是边缘设备。智能手机运行实时视觉应用,CCTV 摄像头执行设备端监控,而自主系统则依赖即时决策。
不过,在这些环境中部署也会带来一系列挑战。边缘设备的计算能力有限,延迟要求严格,而且内存和能耗也受到限制。在资源充足的情况下训练时表现良好的模型,在这些受限条件下可能无法高效运行。
将模型导出为合适的格式有助于应对这些挑战。通过适当转换模型,可以优化运行速度、缩小模型体积,并使其兼容特定硬件。
与此同时,导出也提供了灵活性。根据具体需求将同一模型转换为多种格式,就能让它适配不同的部署环境。
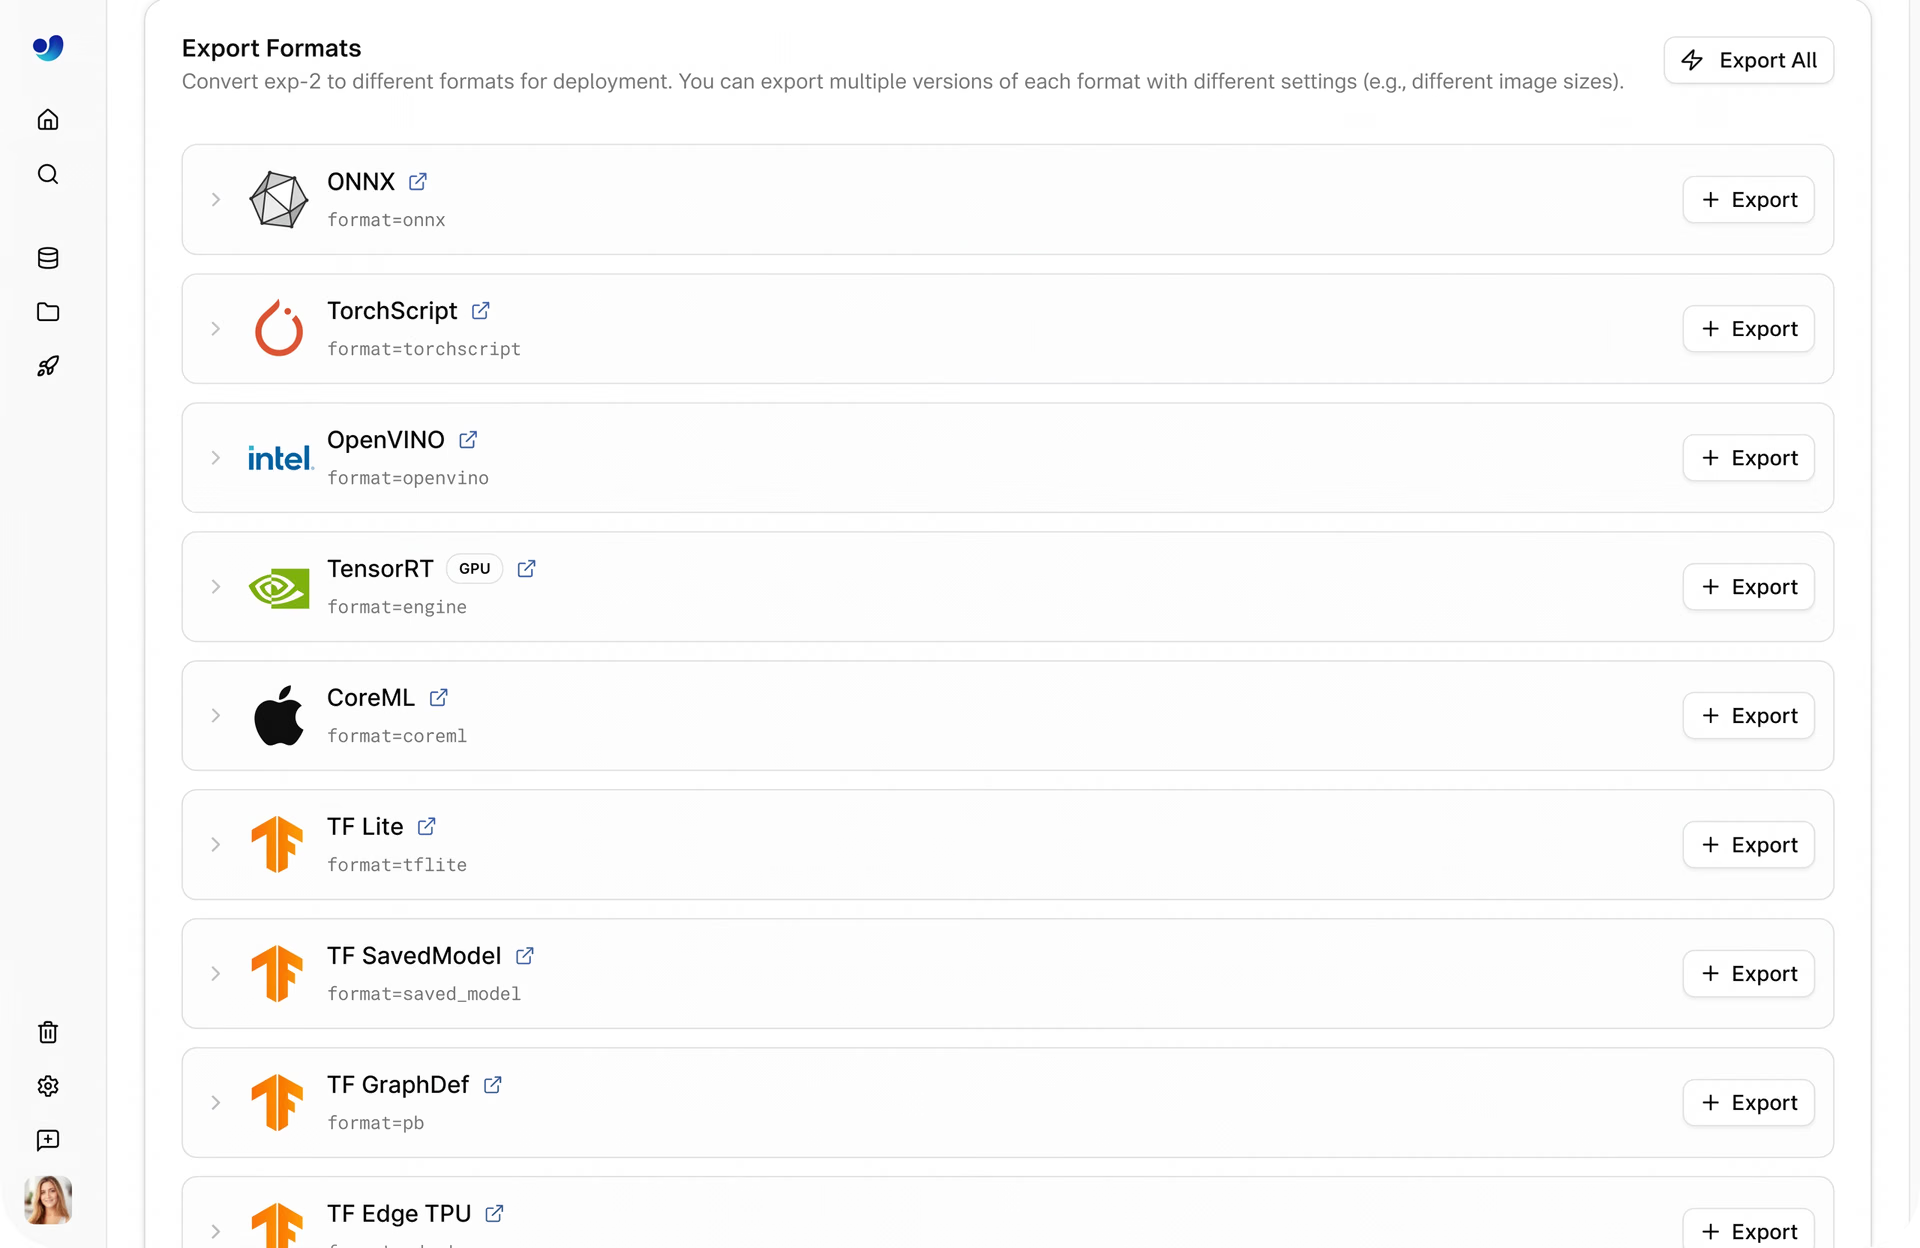
图 2. Ultralytics Platform 支持的部分导出格式(来源)
例如,NCNN 模型格式针对移动设备和边缘设备进行了优化,资源占用较低。而 OpenVINO 格式则针对 Intel 硬件进行了优化,可在中央处理器 (CPU)、图形处理器 (GPU) 和神经处理器 (NPU) 上提供更出色的性能。
在大多数情况下,要实现这种灵活性,就意味着需要手动转换、处理依赖项并使用多种工具,导致过程既耗时又复杂。Ultralytics Platform 通过让模型导出更易上手、更易管理,简化了这一工作流。
Ultralytics Platform 如何简化模型导出#
通常,模型导出在计算机视觉工作流中被视为一个独立而复杂的步骤。Ultralytics Platform 改变了这一点,它将模型导出功能直接整合到一个涵盖训练到部署全过程的统一工作空间中。
它的一大优势是无需编写代码即可导出。你不必编写脚本、管理环境或使用特定框架的命令。通过直观的界面,只需点击几下就能导出模型。
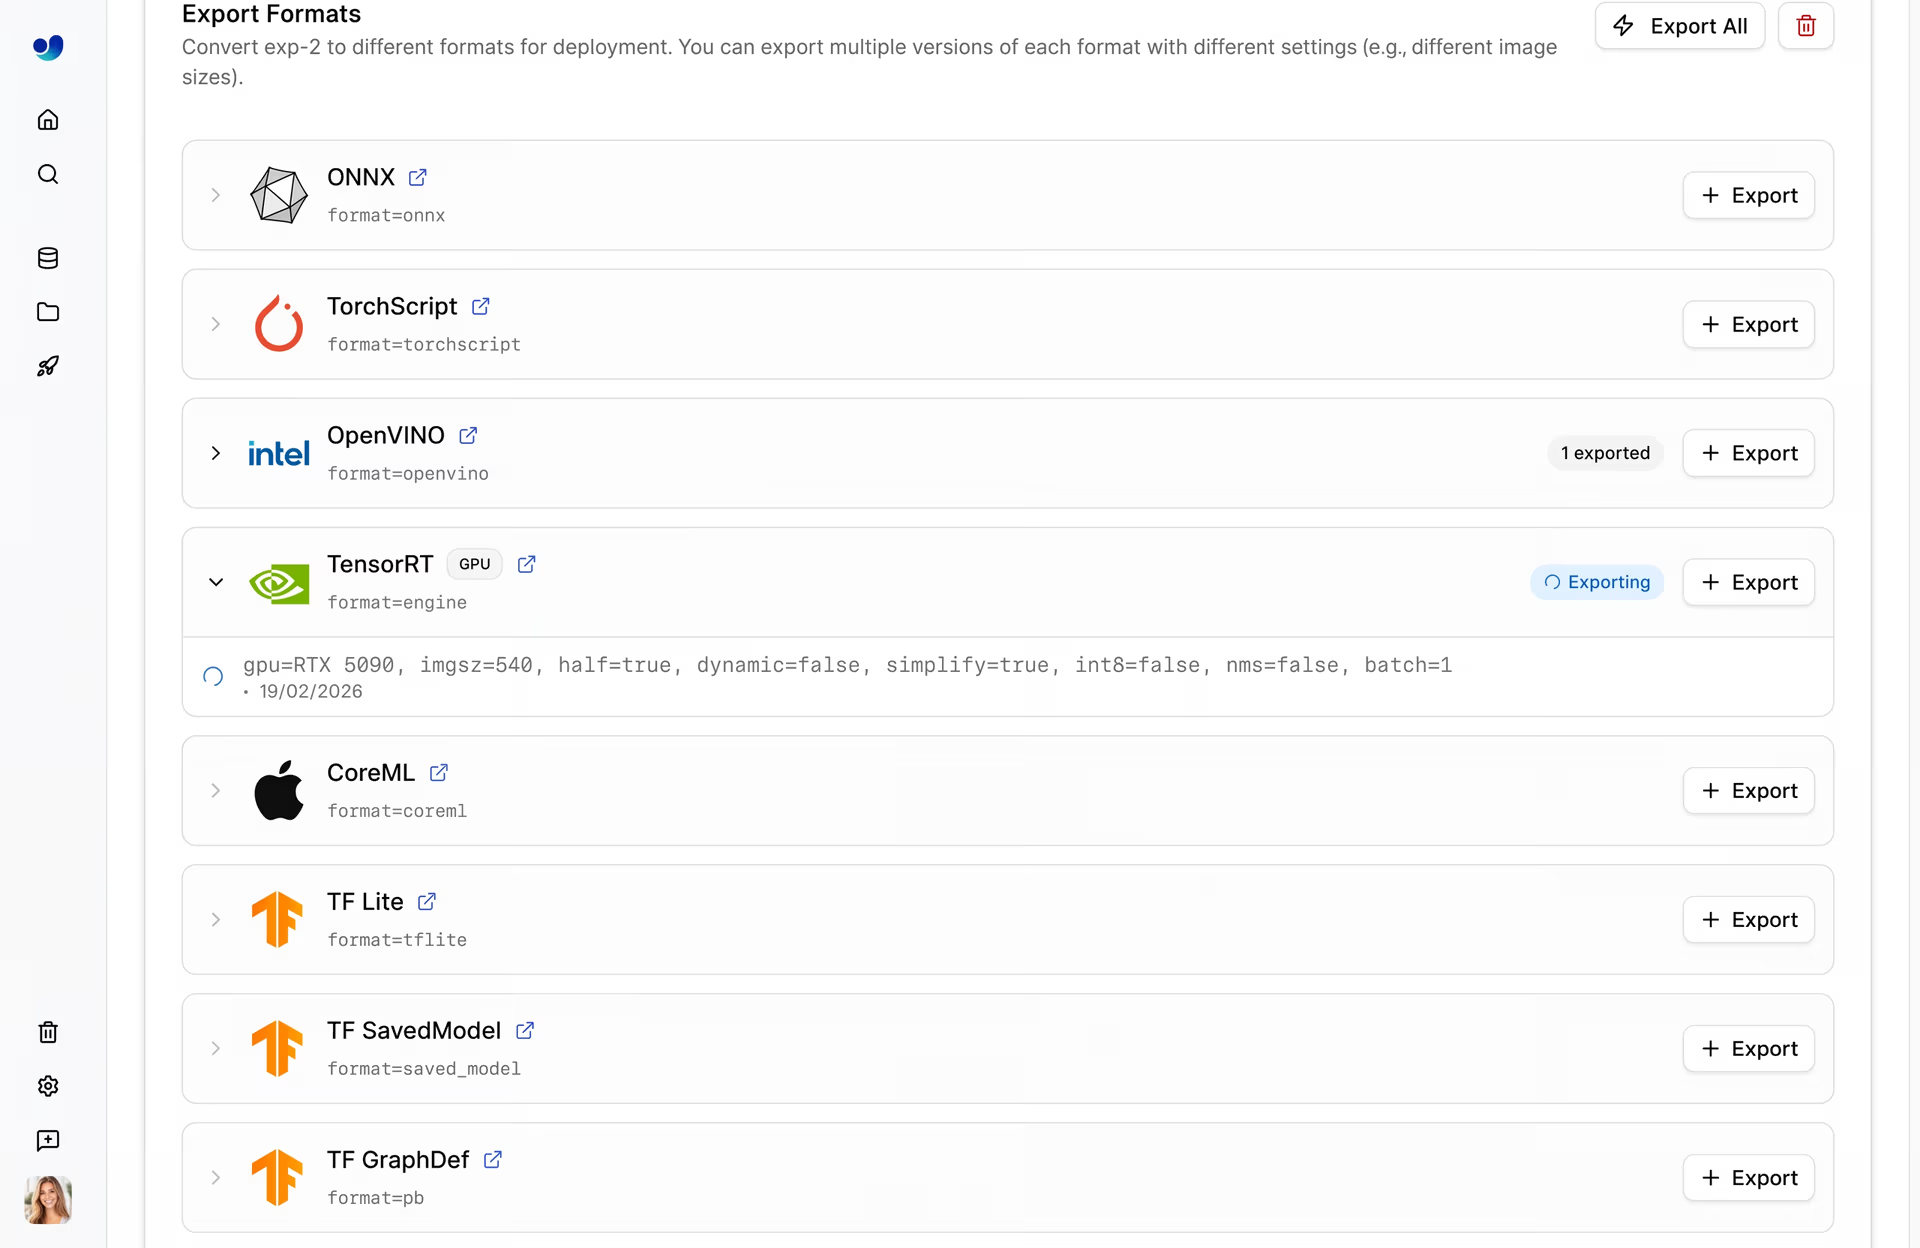
图 3. 在 Ultralytics Platform 中导出模型示例(来源)
平台会在后台处理繁重的工作。通常需要多种工具和手动配置的任务,现在都简化为一个流程。你无需安装额外的依赖项,也不必处理兼容性问题,因此可以更轻松地将训练好的模型转化为可用于生产的解决方案。
Ultralytics Platform 支持的模型导出格式#
Ultralytics Platform 支持 21 种导出格式,让你无需增加复杂性,就能轻松为各种部署环境准备模型。
以下是一些常用导出格式的概览:
- 跨平台与互操作性: ONNX 和 TorchScript 广泛用于在不同框架和环境中运行模型。ONNX 充当不同生态系统之间的桥梁,让模型更容易在各种工具之间迁移;TorchScript 则可以在生产环境中运行 PyTorch 模型,而无需 Python 运行时。
- GPU 高性能推理: TensorRT 专为 NVIDIA GPU 设计,重点在于优化模型,以实现低延迟和高吞吐量。它支持精度降低和层融合等技术来加速推理,因此非常适合实时应用和大规模生产应用。
- 移动端与边缘端部署: CoreML、LiteRT (TensorFlow Lite) 和 NCNN 针对计算能力和内存有限的设备进行了优化。这些格式可以缩小模型体积并提升效率,让模型在智能手机、嵌入式系统和边缘硬件上流畅运行。CoreML 通常用于 Apple 生态系统,而 LiteRT 则常用于 Android。
- 硬件优化执行: OpenVINO 针对 Intel 硬件进行了优化,包括 CPU、GPU 和 VPU,有助于提升这些设备上的推理速度和效率。当你需要充分发挥特定系统的性能时,这类针对硬件的格式很有用。
- 特定框架与专用运行时: PaddlePaddle 和 ExecuTorch 等格式支持特定生态系统和部署需求,包括在边缘设备上高效运行模型,或与特定深度学习技术栈集成。
如何使用 Ultralytics Platform 导出模型#
在 Ultralytics Platform 上导出模型是一个简单的基于 UI 的流程。整个工作流都通过界面完成,无需使用脚本或命令行工具。
以下是使用该平台导出模型的方法:
- 登录并选择模型: 前往你的项目,打开要导出的已训练模型。
- 前往 Export 选项卡:在模型仪表板中,点击 Export 选项卡查看可用的导出选项。
- 选择导出格式:根据部署需求,选择 ONNX、TensorRT 或 CoreML 等格式。
- 配置导出设置(可选):调整图像尺寸、精度或批次大小等参数,以优化性能。
- 开始导出流程:点击“Start Export”开始导出。平台会自动完成转换。
- 下载导出的模型:导出完成后,你就可以下载模型,并在部署流水线中使用。
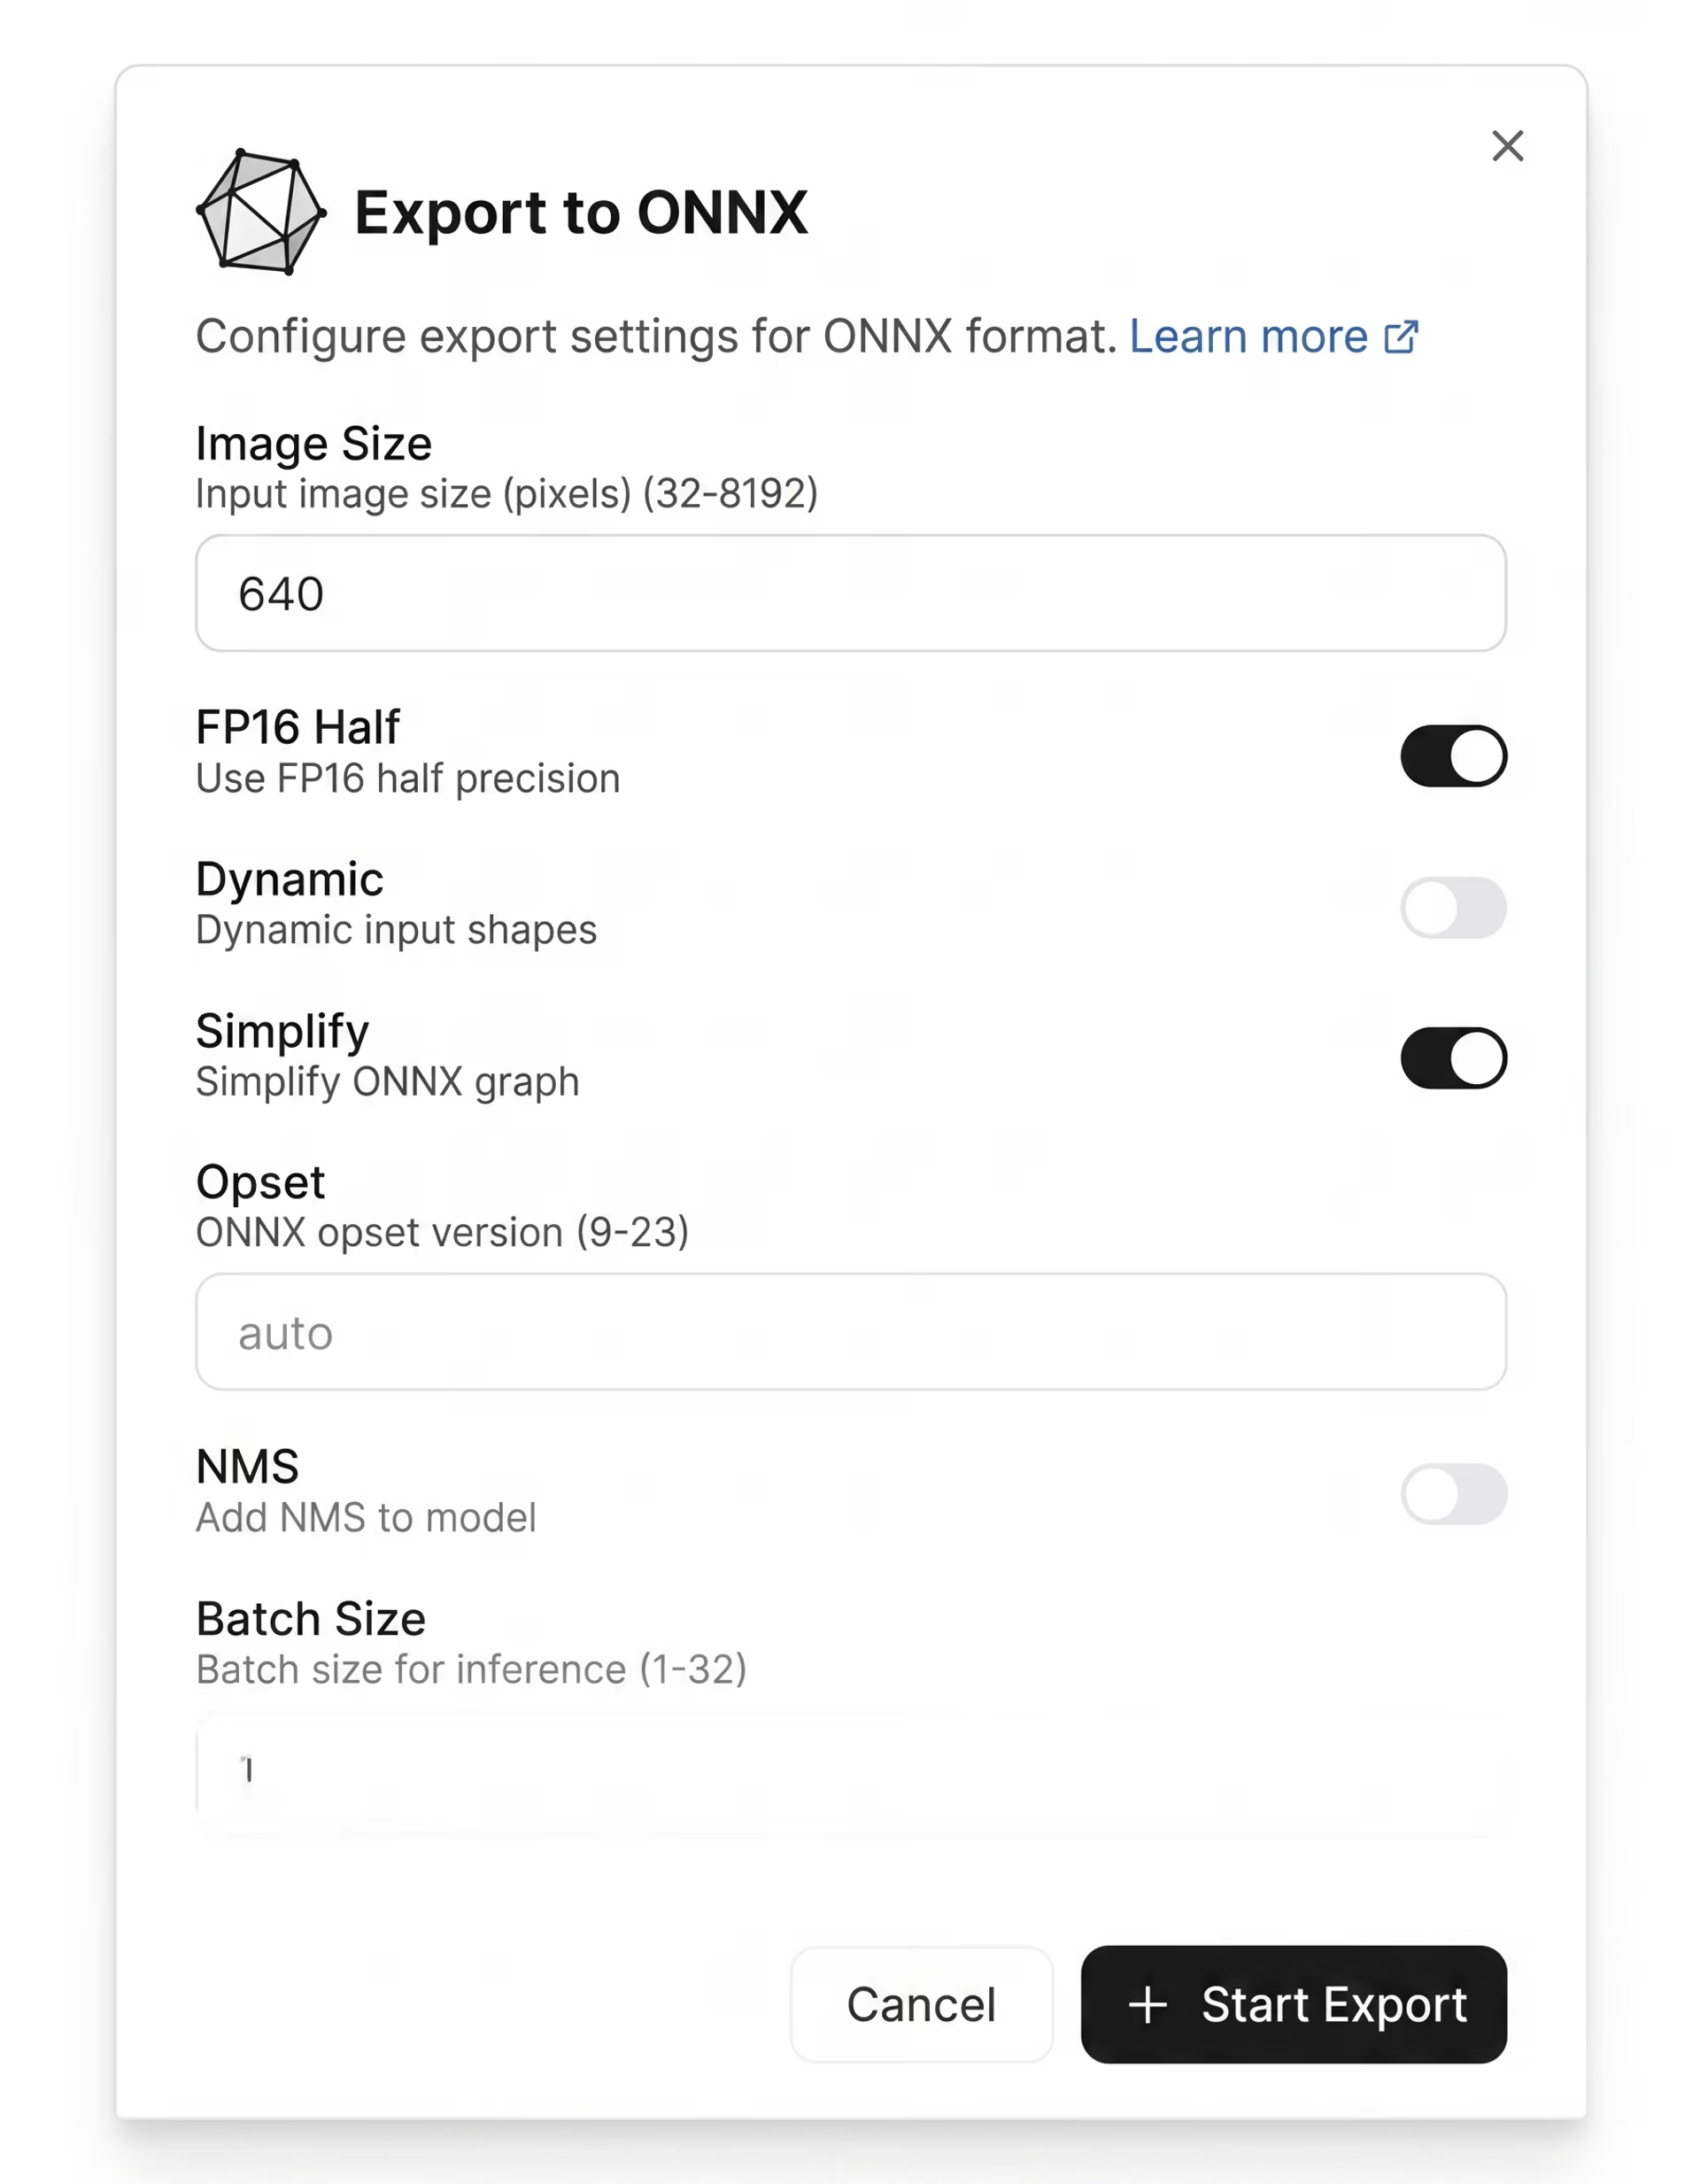
图 4. 在 Ultralytics Platform 中配置导出设置
选择合适的导出格式#
了解 Ultralytics Platform 支持的各种导出格式时,你可能会想知道该选哪一种。答案取决于你计划在哪里以及如何使用模型。
以下是一些需要考虑的因素:
- 延迟要求:对于视频分析或自主系统等实时应用,低延迟至关重要。针对高性能推理优化的格式,例如 TensorRT,通常更适合这类场景。
- 硬件限制:内存和处理能力有限的设备,例如手机或嵌入式系统,需要使用 LiteRT 或 NCNN 等轻量级格式。
- 模型大小与功耗:使用边缘设备时,模型大小和功耗会变得很重要。更小、经过优化的模型有助于确保性能稳定,同时避免耗尽资源。
- 部署环境: 如果模型需要在不同平台上运行,ONNX 等格式可以提供灵活性。对于特定平台的使用场景,例如 iOS 应用,CoreML 往往是更好的选择。
没有一种格式适合所有情况。关键在于平衡性能、兼容性和目标环境的限制。Ultralytics Platform 让你无需额外费力,就能尝试并比较不同格式,从而简化这一过程。
要点#
模型导出是让模型为在不同环境中实际应用做好准备的重要步骤。使用 Ultralytics Platform,这个过程会简单得多,你可以在无需额外配置或增加复杂性的情况下转换和优化模型。选择适合使用场景的格式,就能确保模型在任何部署环境中都能高效运行。
加入不断壮大的社区,并查看我们的 GitHub 代码库,进一步了解计算机视觉。浏览我们的解决方案页面,了解机器人领域的 AI和物流领域的计算机视觉等应用。了解我们的许可选项,开始构建视觉 AI 应用!









