部署时的专用推理端点与共享推理对比
了解何时应在 Ultralytics Platform 上选择专用推理端点,以实现可扩展、低延迟的视觉 AI 部署,而不是使用共享推理。
最近,我们推出了 Ultralytics Platform,这是一个端到端解决方案,将完整的计算机视觉工作流整合到一个平台中,涵盖从数据集准备、模型训练,到推理、部署和监控的各个环节。
该平台根据计算机视觉社区的反馈构建,旨在通过提供支持视觉 AI 应用完整生命周期的集成功能,简化开发的每个阶段。
例如,在模型训练完成后,下一步就是部署模型,以便在实际应用中运行推理并做出预测。平台提供多种部署选项,让这一流程变得简单直接。
你可以导出模型,在自己的环境中运行;也可以使用共享推理进行快速测试,或部署专用端点,以支持可扩展、适用于生产环境的应用。这些部署选项都能运行 AI 推理,但分别针对不同阶段和使用场景设计。
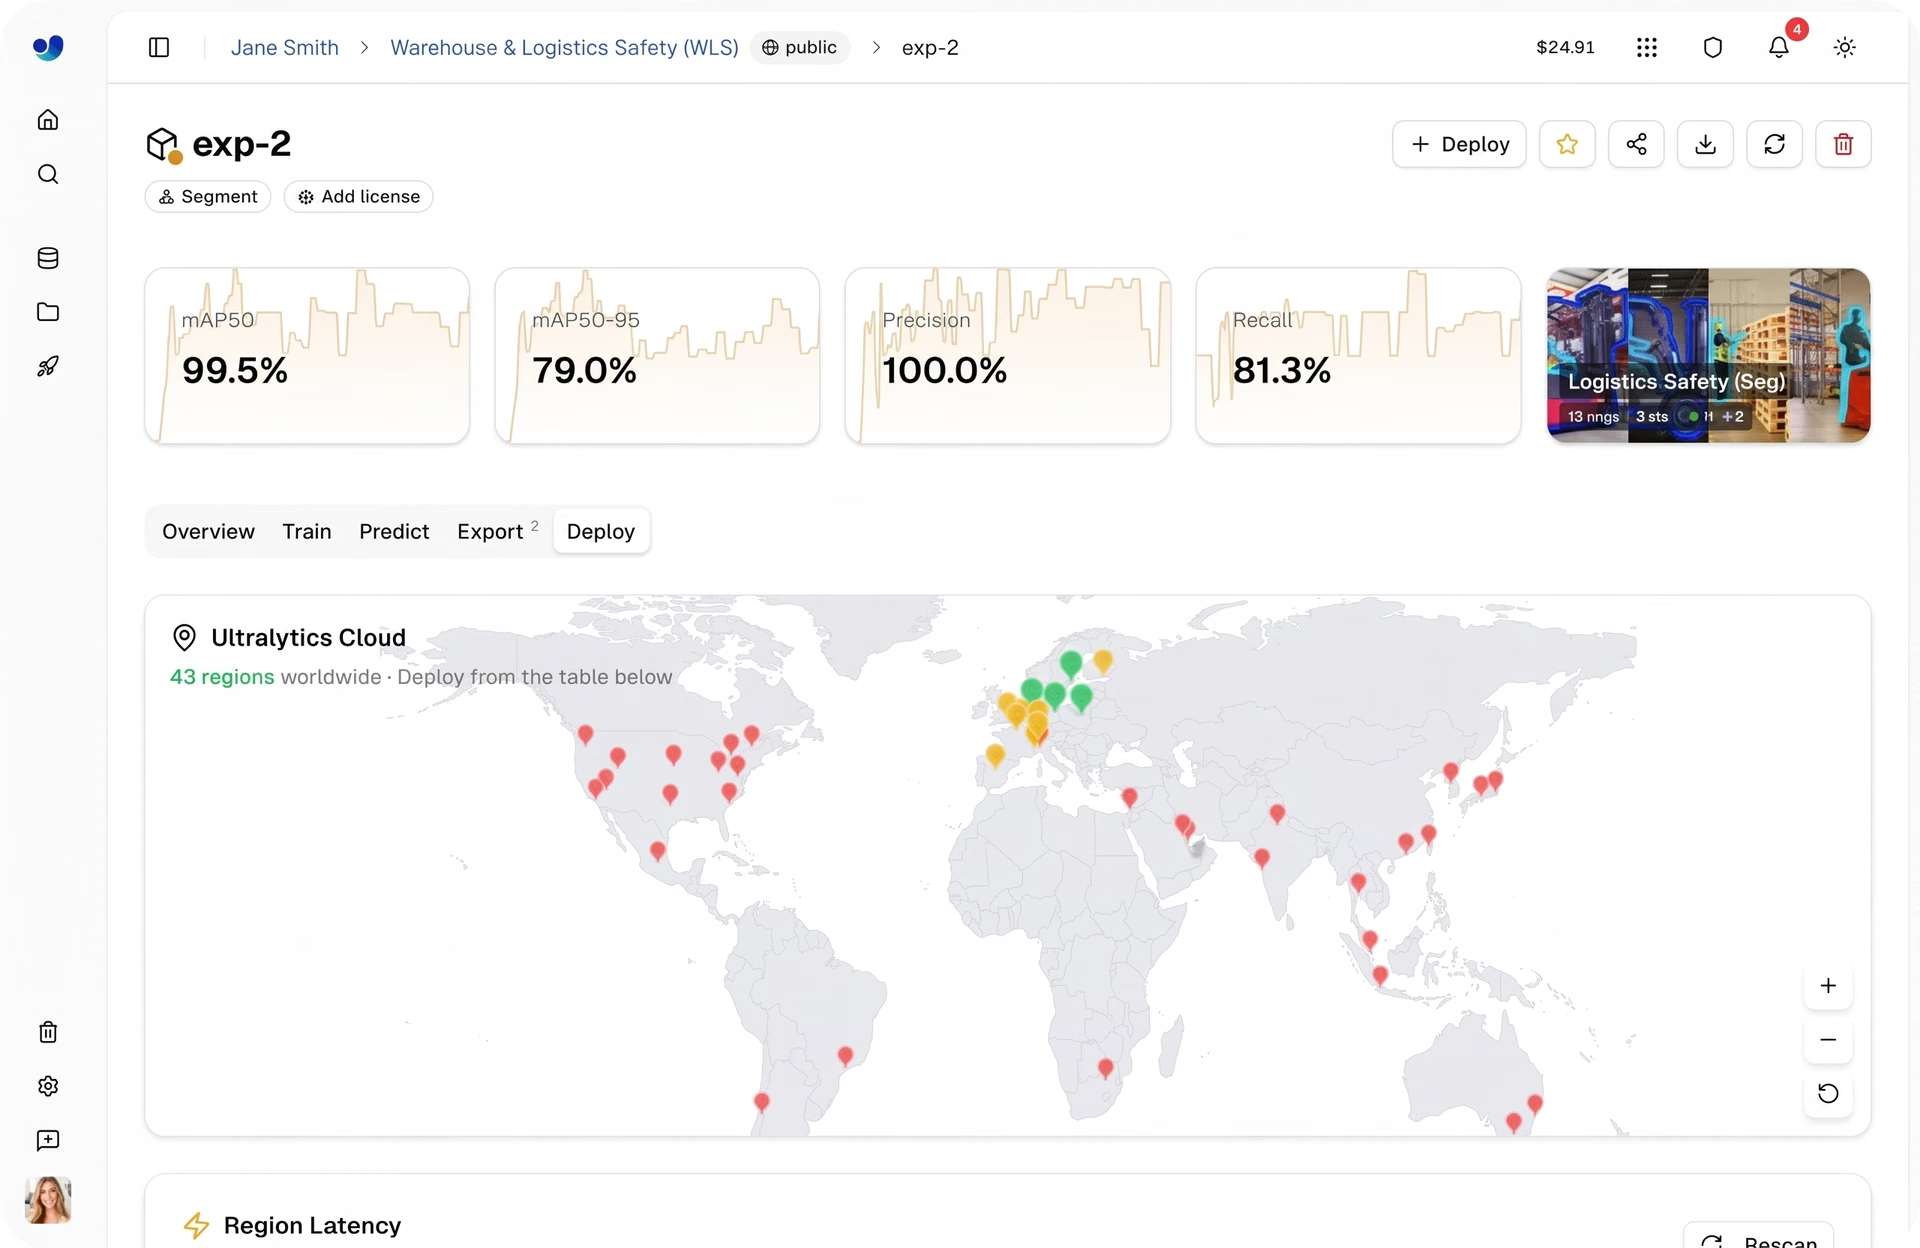
图 1. Ultralytics Platform 支持可扩展的全球视觉 AI 模型部署(来源)
模型导出让你完全掌控在自己的基础设施中运行模型;共享推理让你无需设置即可轻松测试和实验;专用端点则专为可靠的大规模生产工作负载而构建。
乍看之下,共享推理和专用端点似乎十分相似。两者都支持你向模型发送 API 请求并接收结构化预测结果,因此很容易将视觉 AI 集成到应用中。
不过,随着工作负载增长、计算机视觉应用开始处理实时推理请求,这些选项之间的差异会变得更加重要。本文将深入介绍共享推理和专用端点,对比两者、说明各自的适用场景,并解释为什么应用扩展时专用端点会成为更好的选择。
共享推理部署概览#
共享推理是一种简单的方式,无需设置任何基础设施,也不必操心 GPU 类型、框架集成或运行时配置,就能让模型运行 AI 推理。模型训练或微调完成后,你可以直接通过平台使用模型进行预测。
在这种设置下,模型运行在共享的多租户计算资源上,覆盖美国、欧洲和亚太地区等几个主要区域。请求会自动路由至可用服务,因此你无需配置 GPU 实例或运行时环境。平台会为你处理一切,让你轻松上手。
使用共享推理时,你可以通过 Python 或 CLI 等工具,经由 REST API 向模型发送请求,并接收结构化的 JSON 输出,例如检测到的对象、置信度分数及其他预测详情。这样便于测试模型并将其集成到应用中。
由于系统资源由多个用户共享,它主要面向开发、测试和轻量级使用,适合验证预测结果和构建早期集成。同时,性能可能随系统负载而变化,并且每个 API 密钥的使用量限制为每分钟 20 个请求,因此不太适合高吞吐量的生产工作负载。
总的来说,共享推理最适合开发早期阶段,让你在转向更大规模的应用前了解并改进模型。
使用专用端点在全球部署模型#
专用端点是单租户推理服务,你的视觉 AI 模型运行在隔离的计算资源上。每个端点都拥有自己的运行时环境,并可配置 CPU 和内存等资源;与共享基础设施不同,这让你能更好地控制性能。
将模型部署为专用端点后,系统会为其分配唯一的 API URL,并使用你的 API 密钥进行身份验证,因此很容易集成到应用中。这些端点可部署在全球 43 个区域,让你能够在更靠近用户的位置运行推理,从而降低延迟。
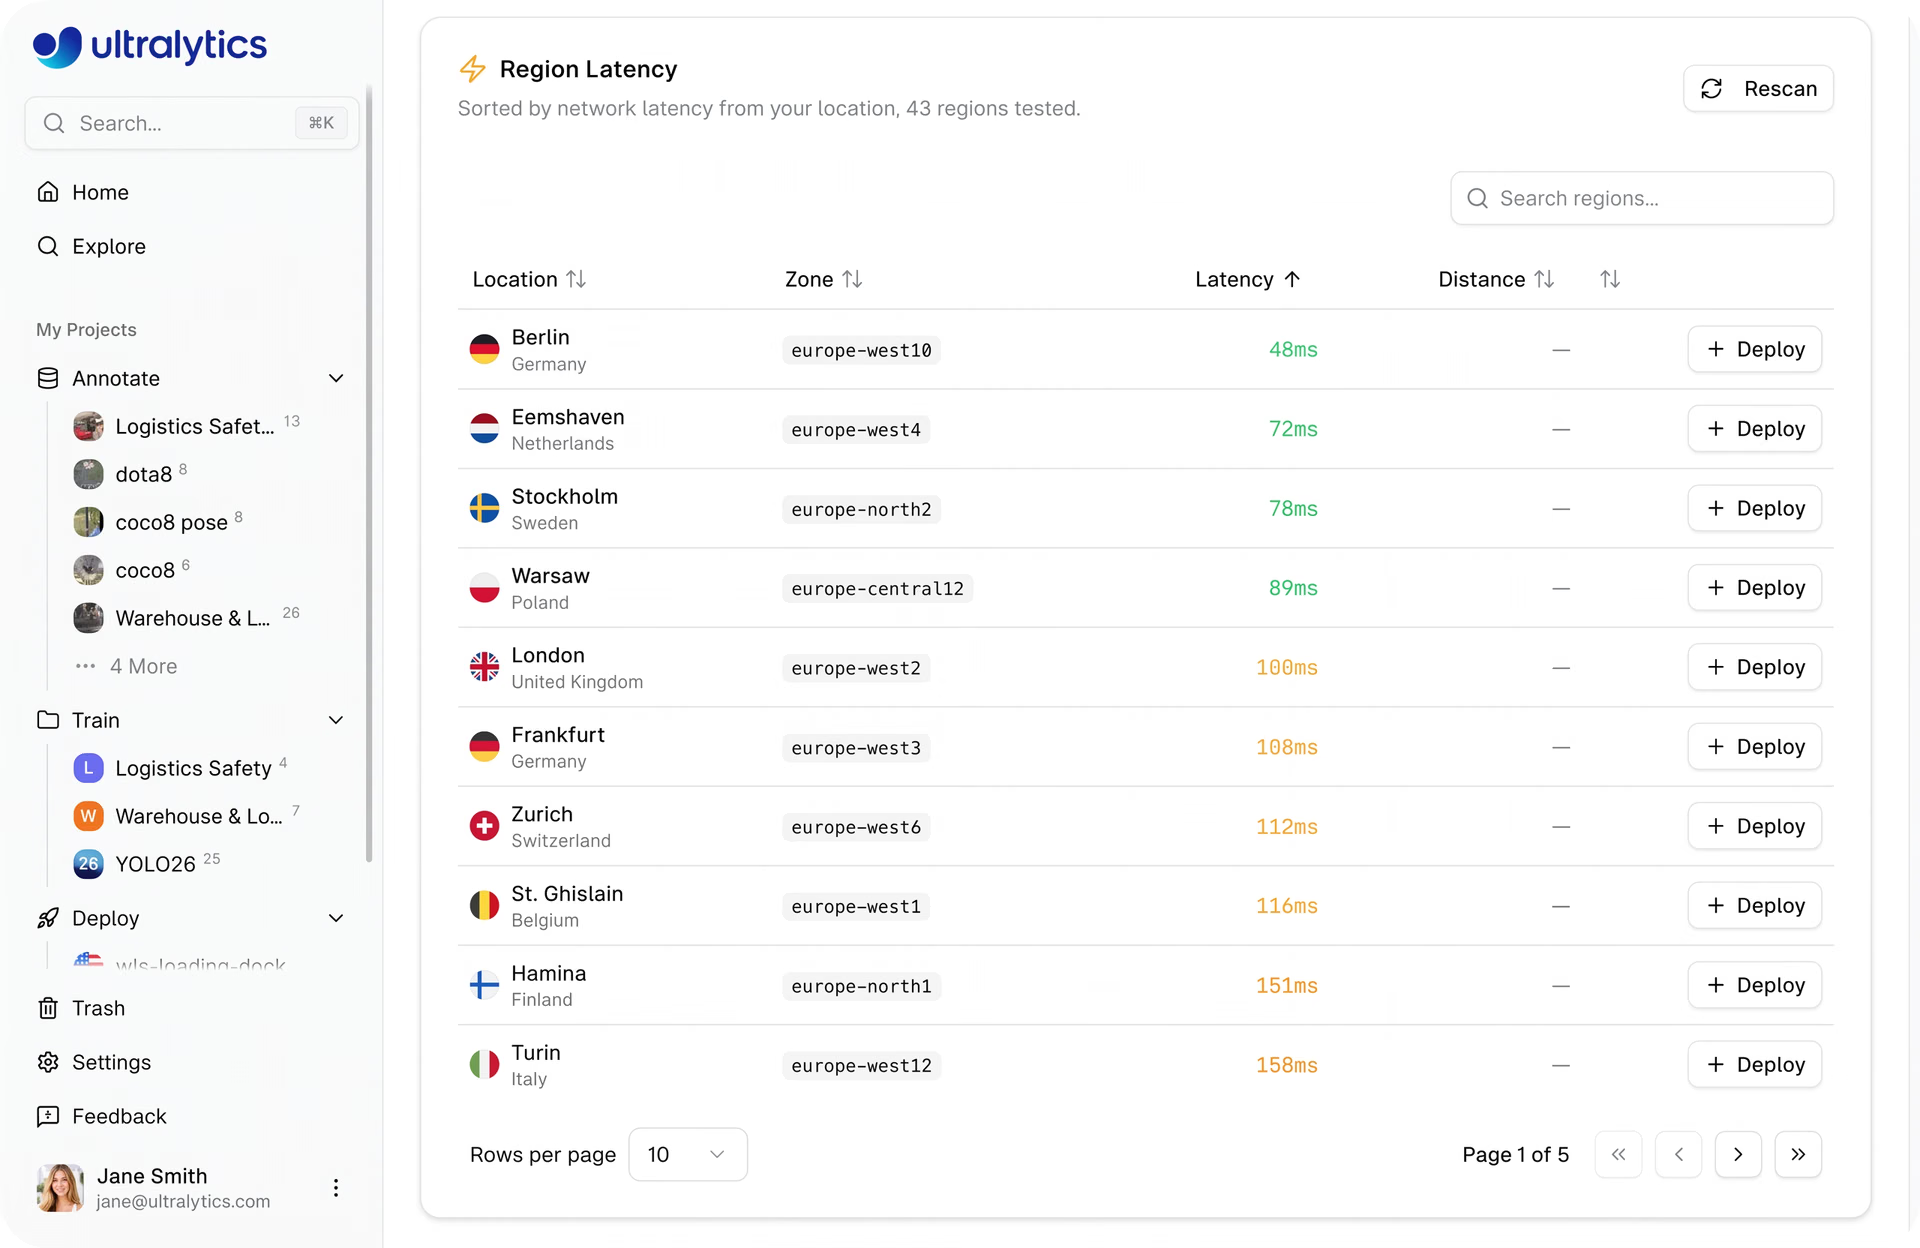
图 2. 你可以在全球 43 个区域部署专用端点(来源)
自动扩缩是专用端点的一大优势。端点会根据传入请求自动调整:流量增加时扩容,需求下降时缩容。默认启用缩容至零后,端点空闲时会关闭,并在需要时重新启动,从而帮助优化资源使用。
换句话说,专用端点专为生产工作负载设计。与共享推理相比,它们能提供稳定的低延迟、更高的吞吐量和更强的可靠性。
此外,专用端点没有速率限制。请求会直接发送到你的端点,因此可处理的流量取决于你的配置和扩缩能力,而非固定限额。
此外,内置监控、日志、运行状况检查,以及可预测的运行时和启动行为,让你能够轻松跟踪性能,并在所有套餐中维持稳定的部署。免费套餐的冷启动通常需要 5 到 45 秒,而 Pro 套餐的端点会保持热状态,因此推理性能更快、更可预测。
简而言之,专用端点非常适合需要可靠、可扩展且高性能推理的实时视觉 AI 应用。
共享推理与专用端点:主要区别#
下面详细对比共享推理和专用端点:
- 延迟:共享环境中的延迟可能因资源共享而波动,而专用端点能提供更稳定的低延迟响应。
- 区域:共享推理仅在少数区域(美国、欧盟、亚太地区)提供,而专用端点支持部署在全球 43 个区域。
- 可扩展性:共享推理的扩缩不可配置,而专用端点会根据传入流量自动扩缩。
- 速率限制:共享推理设有速率限制(每个 API 密钥每分钟 20 个请求或 API 调用),而专用端点没有平台级速率限制。
- 定价:共享推理可免费用于测试和开发,无需额外付费;专用端点则提供更强的控制能力和可扩展性,费用取决于资源配置和部署需求。
为什么专用端点更适合生产工作负载#
随着 AI 和机器学习应用从测试走向实际使用,性能、可扩展性和可靠性变得至关重要。这就是专用端点相较于共享推理具有明显优势的原因。
使用专用端点时,你的预训练模型或自定义模型运行在独立的计算资源上,因此性能不会受到其他用户影响。这有助于保持低延迟和稳定性能,这对视频分析和监控系统等实时应用非常重要。
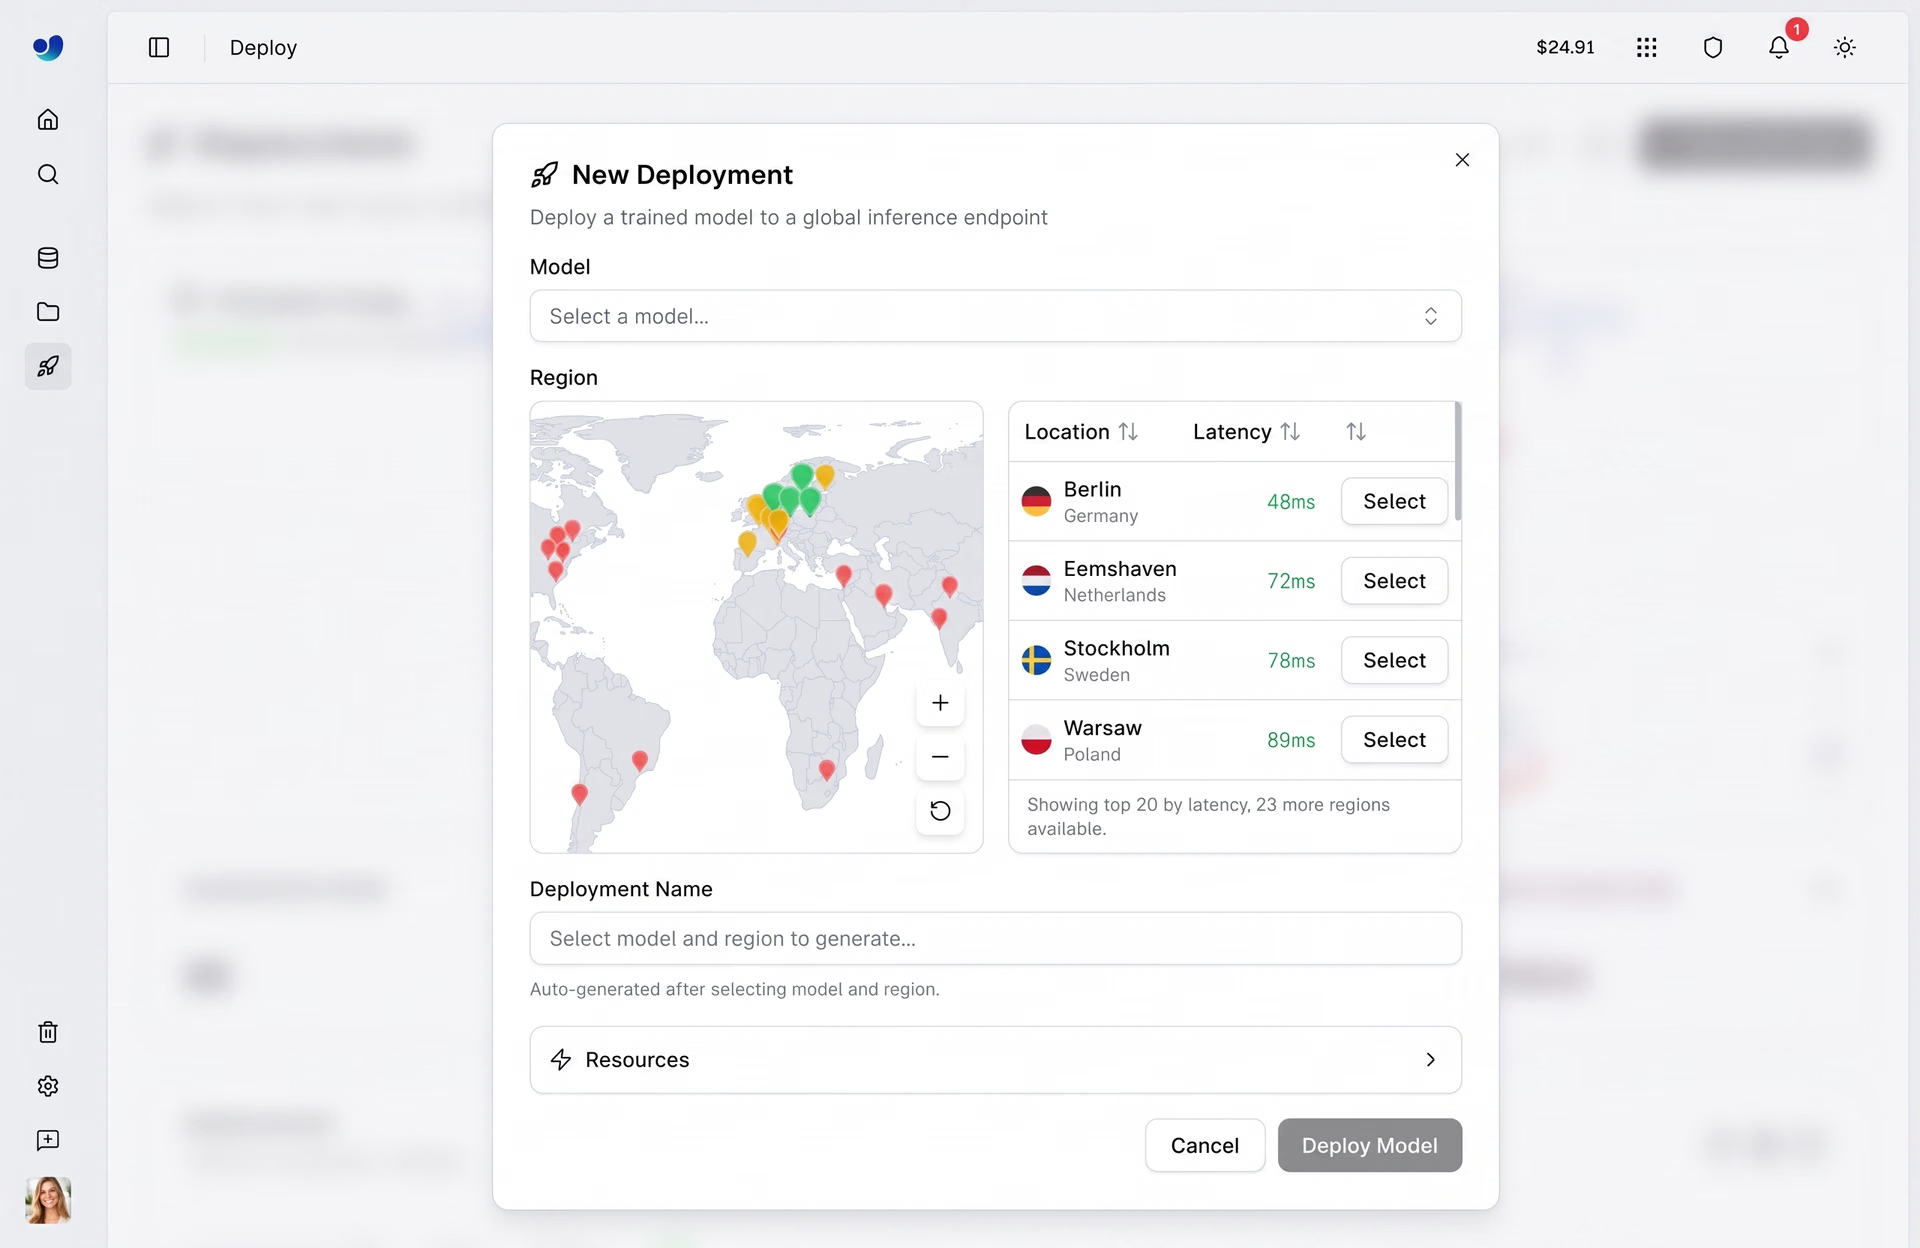
图 3. 使用专用推理端点进行部署(来源)
例如,设想一个零售分析系统,它要处理多家门店的实时摄像头画面。通过在全球 43 个区域部署端点,推理可以在更靠近各门店的位置运行,从而降低延迟并缩短响应时间。
而在资源共享且可用区域有限的共享推理环境中,繁忙时段的性能可能会出现波动。
专用端点还可以处理更多流量,并根据需求自动扩缩。借助内置监控、日志和运行状况检查,专用端点能够提供更可预测的性能,因此非常适合大规模、持续运行的 AI 工作负载。
共享推理在视觉 AI 工作流中的定位#
在了解共享推理和专用端点之间的差异时,你可能会想知道共享推理在完整的计算机视觉工作流中发挥什么作用。
再来看零售分析的例子。在将视觉解决方案部署到多家门店之前,团队通常需要先用真实数据测试其表现,并根据测试结果进行改进。
共享推理让这一流程变得简单:你可以发送来自门店摄像头的样本图像或视频帧,快速查看预测结果,而无需设置基础设施。这对于测试模型行为、调试错误预测,以及验证模型在不同条件下的结果尤其有用,例如光照变化或门店布局不同的情况。
通过这样反复迭代,团队可以在投入生产前提升模型的准确性和可靠性。模型在这些测试场景中表现良好后,就可以部署到专用端点,在多个地点实时使用。
共享推理也适用于使用量较低或不频繁的应用。例如,小型零售店可以偶尔用它分析客流,或在特定时段查看顾客活动,而无需进行完整的规模化部署。在这些情况下,共享推理提供了一种简单、经济高效的按需推理方式。
专用端点的真实应用场景#
随着 AI 应用从测试走向实际使用,部署选择会直接影响性能、可扩展性和用户体验。专用端点凭借稳定的性能、低延迟和处理大规模工作负载的能力,可广泛应用于各行各业。
以下是一些常见场景,展示专用端点如何用于实际应用:
- 零售与视频分析:零售连锁企业可以利用计算机视觉追踪顾客动向、识别热门商品,并实时监控门店活动。专用端点能确保多个门店位置的推理速度快且稳定,即使在高峰时段也不例外。
- 制造业与质量检测:在生产线上,模型可以在产品流经系统时检测缺陷或异常。专用端点支持持续的实时推理,帮助团队及早发现问题、维持产品质量,同时避免拖慢生产运营。
- 医疗保健与医学影像:医疗服务提供者和诊断实验室可以依靠视觉模型分析 X 光片或扫描图像等医学影像。专用端点能提供可靠且稳定的性能;处理敏感数据和时间紧迫的诊断时,这一点至关重要。
- 仓储与物流自动化:大型仓库通常会运行多套相同的系统,例如传送带和分拣线,它们实际上是同一套配置的多个副本。计算机视觉模型可以监控每个副本,检测堵塞或包裹分拣错误等问题。专用端点可确保所有副本都能实时获得稳定的推理服务。
从共享推理迁移到专用端点#
Ultralytics Platform 的一大优势是,随着应用增长,从共享推理切换到专用端点非常简单。你无需更换工具或重建设置,就能在同一环境中迁移到适用于生产环境的部署方案。
使用共享推理测试模型后,下一步就是轻松迁移到专用端点。你可以将同一个模型部署到端点,选择首选区域和计算资源,然后在应用中更新端点 URL。整体集成方式基本不变,因此发送请求或处理响应的方式几乎无需调整。
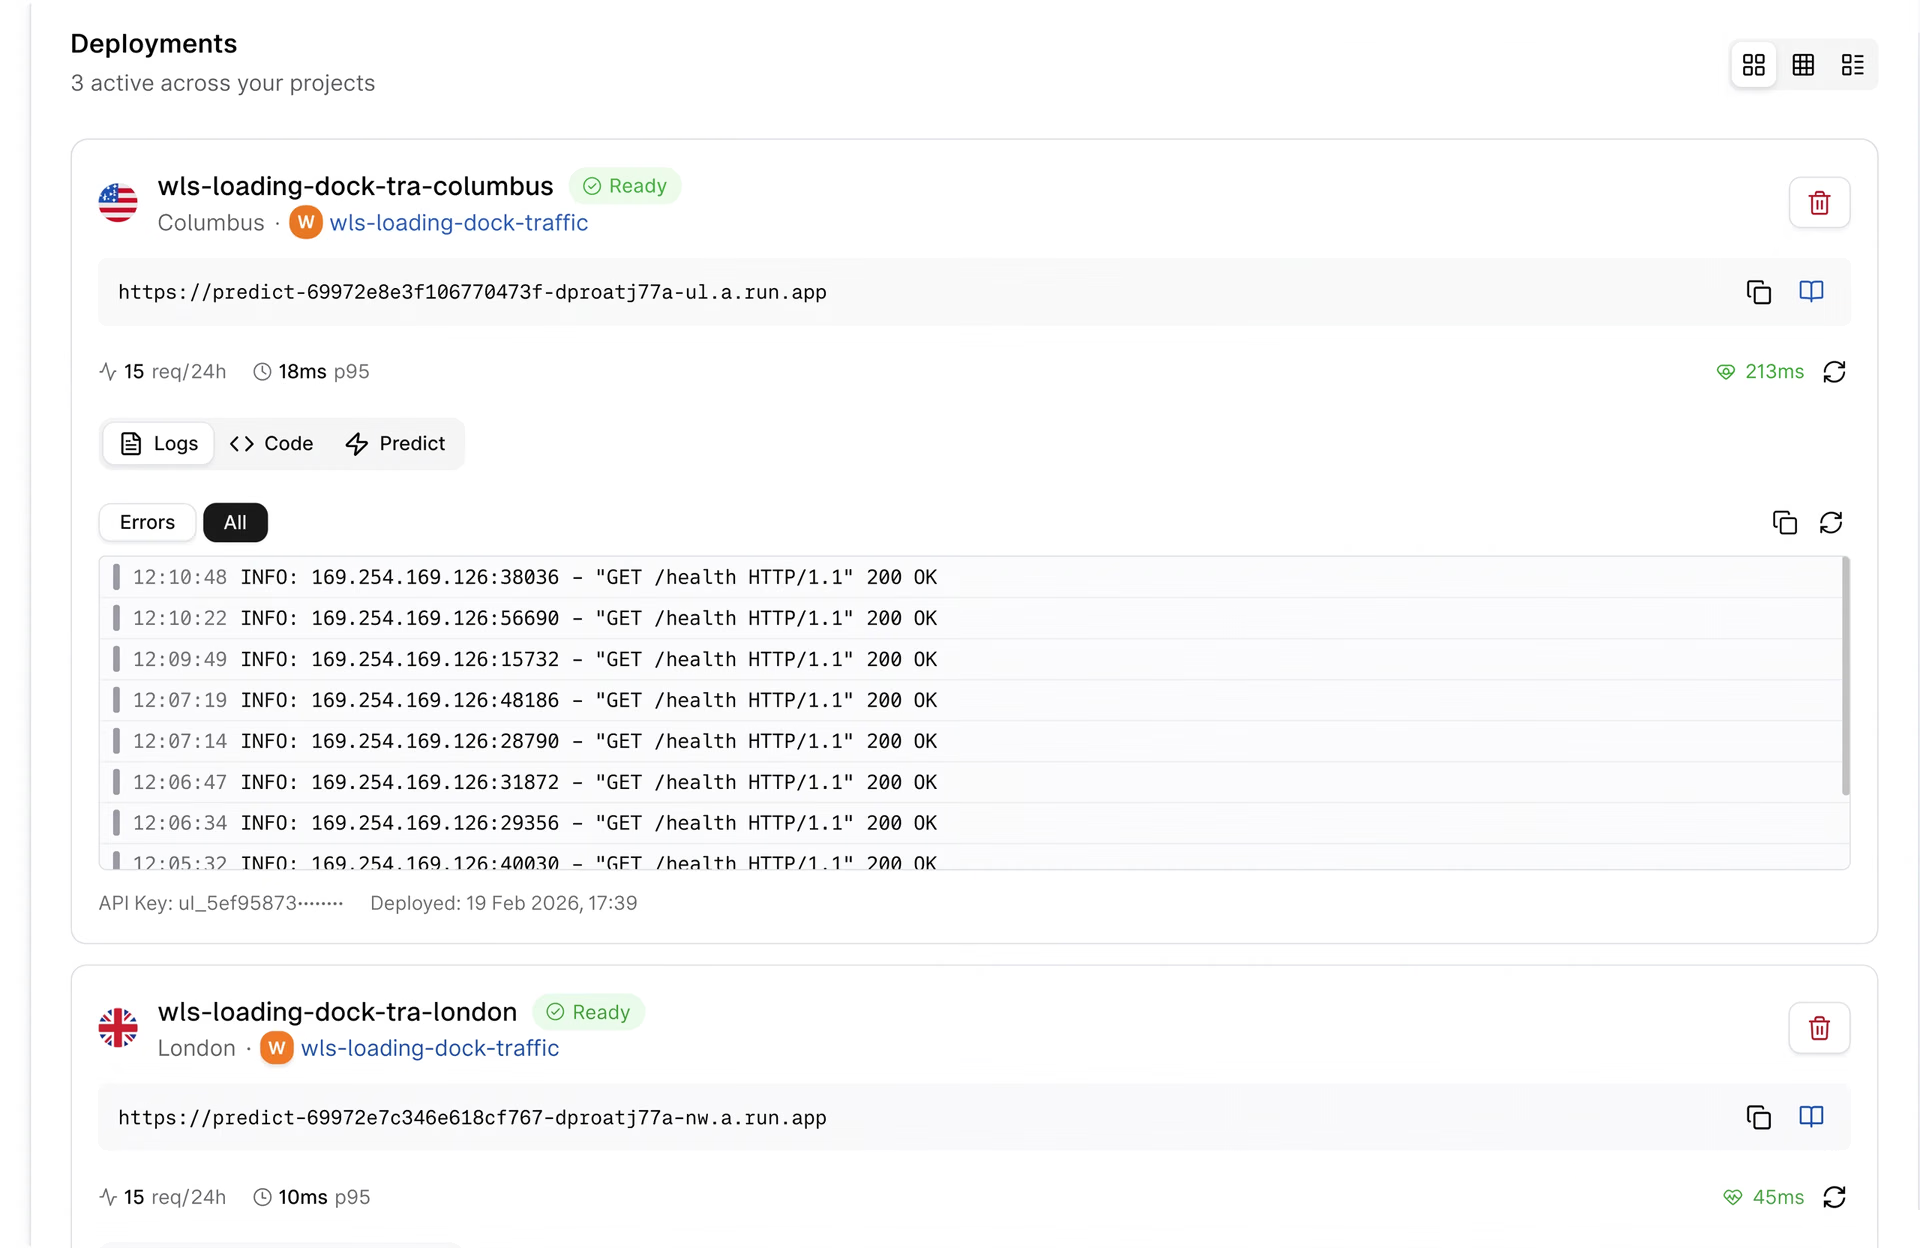
图 4. 在 Ultralytics Platform 上查看专用端点 URL(来源)
这意味着你只需点击几下,就能从测试扩展到生产环境。随着工作负载增加,或应用对性能一致性的要求提高,你可以迁移到专用端点,而不会中断现有工作流。
要进一步了解如何在 Ultralytics Platform 上使用专用端点部署模型,请查看官方 Ultralytics Platform 文档。
要点#
共享推理是测试和实验的绝佳起点,但生产工作负载需要更稳定的性能和更强的扩展能力。随着应用增长,专用端点能提供支持实际使用所需的性能与可靠性。因此,它们是大多数生产部署的最佳选择。
加入我们的社区,并浏览我们的 GitHub 代码库,进一步了解计算机视觉模型。在我们的解决方案页面上,阅读 AI 在农业中的应用和计算机视觉在机器人领域的应用等内容。查看我们的许可选项,开始使用视觉 AI。








