使用 Ultralytics Platform 智能管理计算机视觉数据集
了解如何在计算机视觉项目中使用 Ultralytics Platform 更好地管理数据集。轻松跟踪、比较和改进数据集。
 Abirami Vina11 分钟阅读
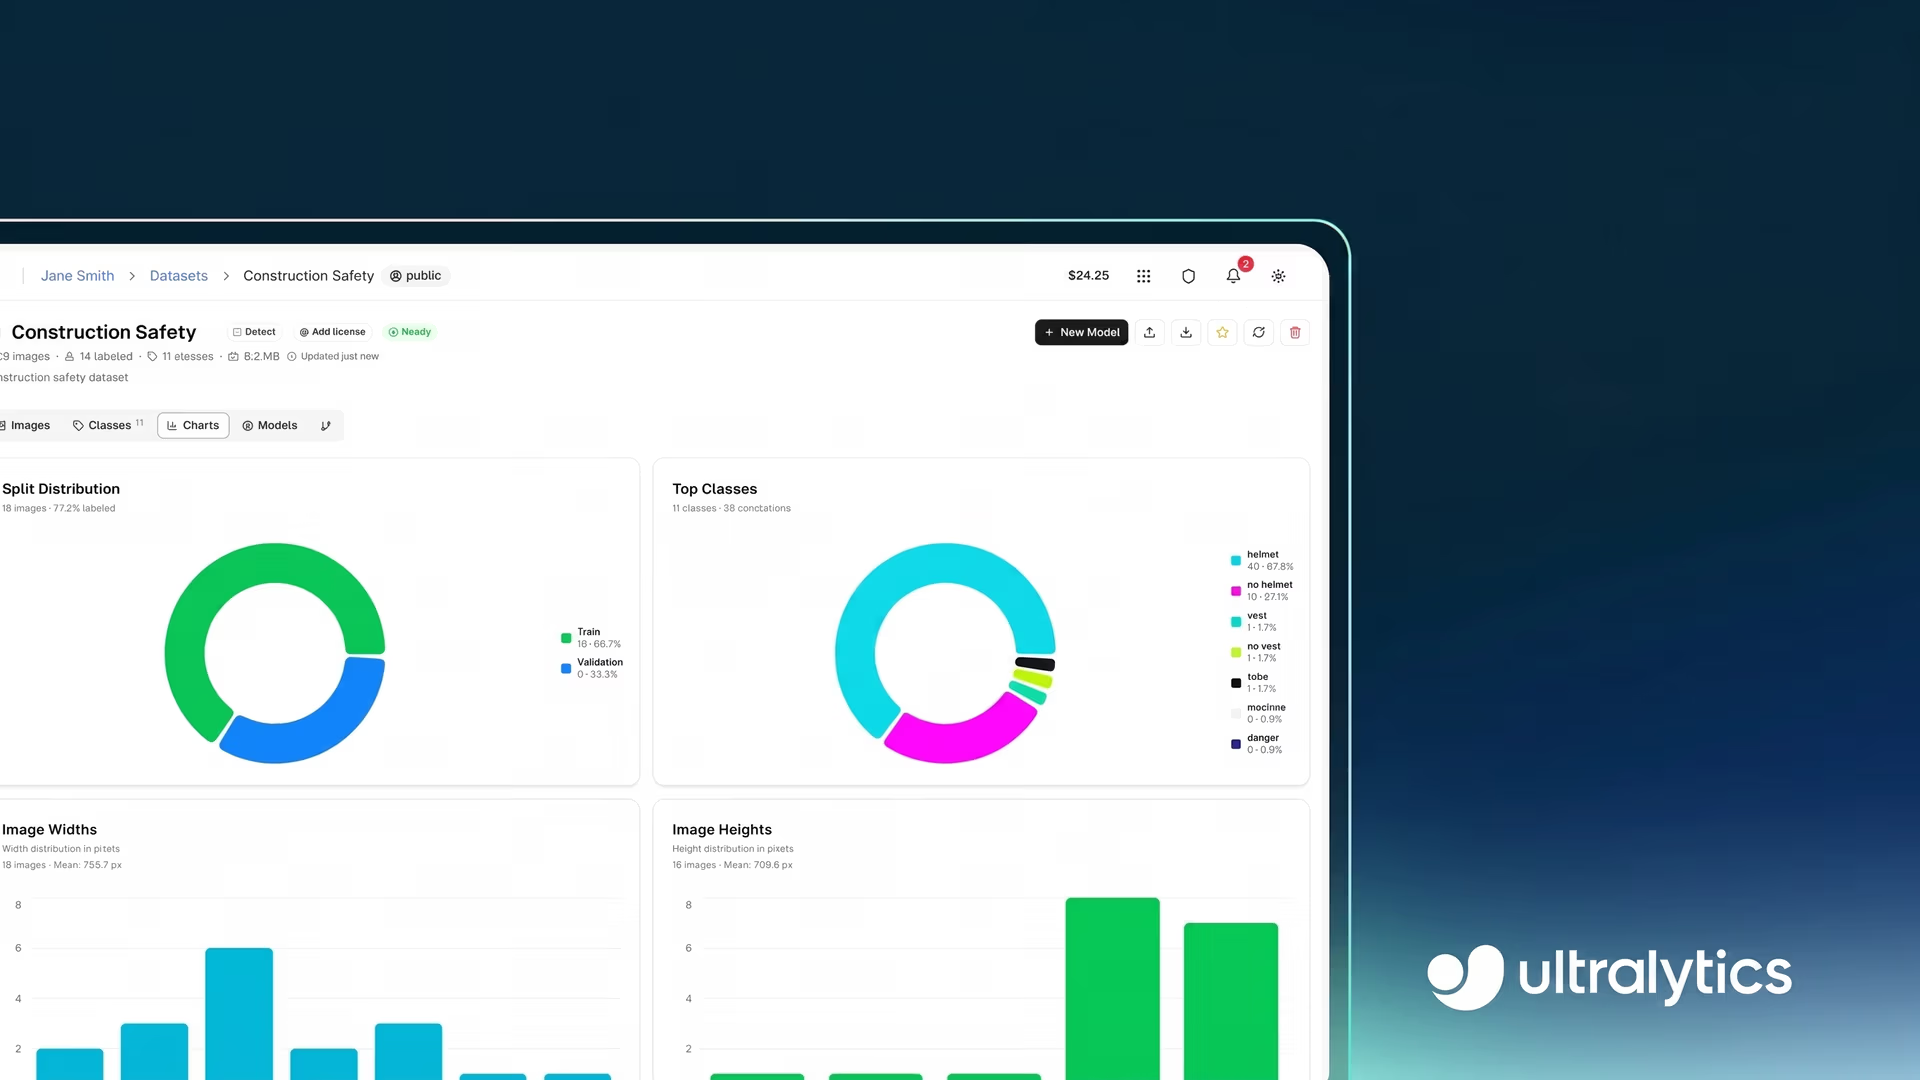
视觉 AI,也就是计算机视觉,自早期发展至今已取得长足进步,从实验性研究演变为驱动实际应用的关键技术。如今,AI 爱好者可以使用易于获取的工具和框架,构建用于目标检测和实例分割等任务的强大模型。
然而,当这些应用从实验走向生产时,数据集管理仍然是一项关键且常被忽视的挑战。随着计算机视觉数据集规模扩大、复杂度提高,团队往往难以保持标注一致、跟踪不同版本之间的变化,并确保整体数据质量。
即使是先进模型,如果训练数据不完整、不平衡或管理不善,在真实环境中也可能表现不佳。开发阶段的性能与真实环境中的可靠性之间差距日益扩大,因此需要采用更有条理的数据集管理方法。
另一个常见问题是,数据收集、标注和训练往往使用彼此独立的工具。工作流程碎片化会让数据集管理效率降低、增加不一致的风险,并拖慢迭代速度。
为了解决数据集管理和工作流程碎片化等视觉 AI 瓶颈,我们最近推出了 Ultralytics Platform。这是一个端到端工作空间,将数据集管理、标注、训练、部署和监控整合到一个统一的工作流程中。
通过连接计算机视觉生命周期的每个阶段,你可以更轻松地跟踪数据集变化、比较不同版本的性能,并持续优化数据以获得更好的结果。
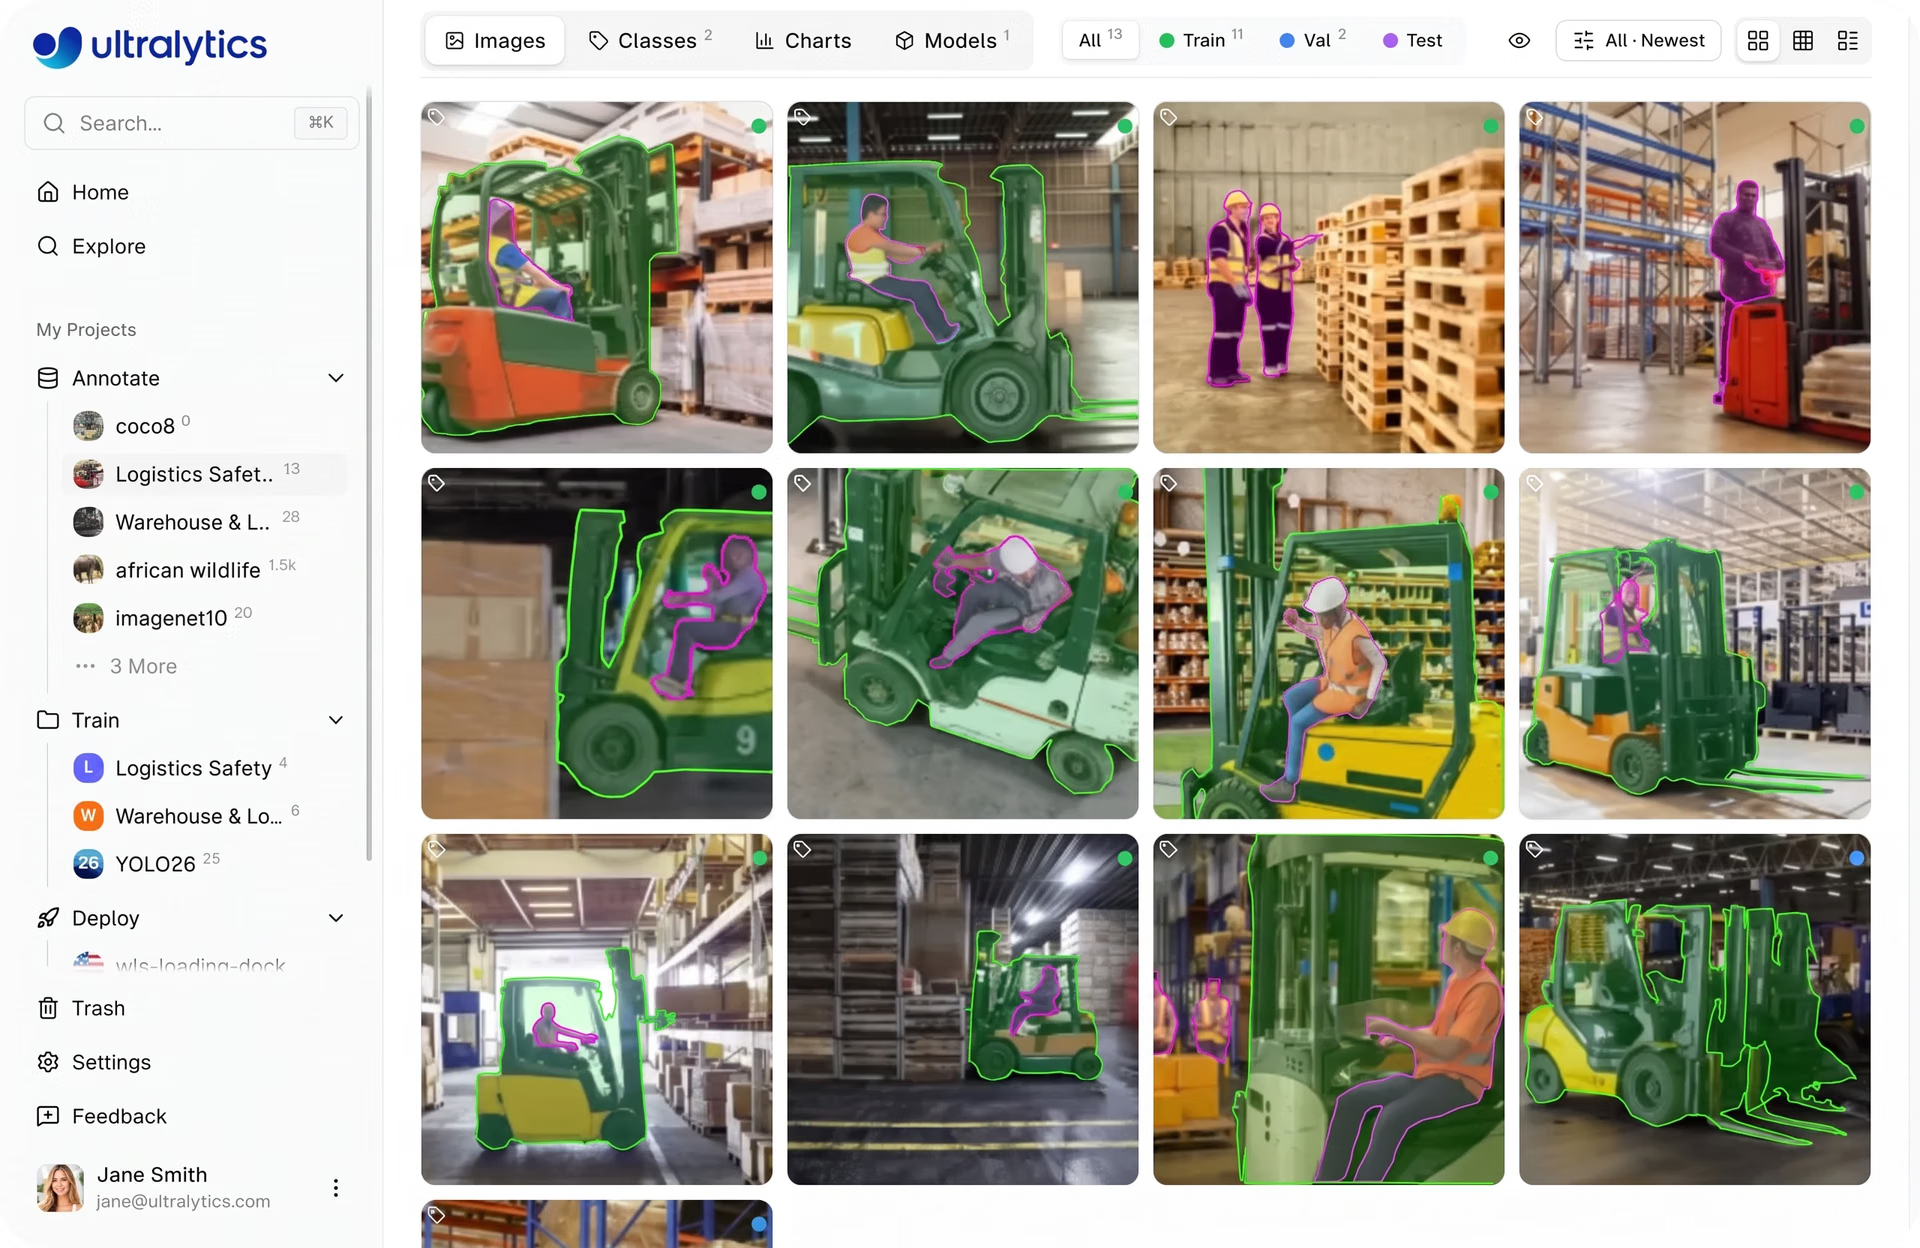
图 1. 在 Ultralytics Platform 中查看数据集图像的示例(来源)
本文将深入介绍 Ultralytics Platform 如何帮助你跟踪、比较和改进数据集,从而构建更可靠的计算机视觉模型。
数据集管理对计算机视觉的重要性#
计算机视觉模型的性能与其训练数据密切相关。模型准确率,也就是预测正确的频率,不仅取决于算法,还取决于数据集对真实环境的代表性。
简而言之,模型直接从数据中学习模式,因此数据集中的任何缺失、偏差或不一致都可能影响模型的预测方式。换句话说,即使模型架构本身很强大,低质量数据、错误标注,或对图像中真实变化的覆盖不足(例如不同的光照条件、物体角度、背景或遮挡程度),都可能显著降低准确率。
这同样适用于微调模型:在微调过程中,会使用新的或更新后的数据进一步训练预训练模型,使其更好地适应特定用例或环境。由于模型准确率在很大程度上取决于数据,妥善管理数据就变得至关重要。
数据集管理包括整理、标注和持续更新数据,使数据保持准确且相关。这样可以更轻松地随着时间推移提升性能,尤其是在使用新数据重新训练或微调模型时。
数据集质量如何影响实际应用的可靠性#
计算机视觉应用场景,例如安全监控系统,充分说明了妥善管理数据为何至关重要。这些系统需要在各种真实环境中可靠运行,包括不同的光照环境、摄像机角度、人群密度和局部遮挡情况。
如果训练数据没有覆盖这些变化,或者缺少物体在不同场景和条件下外观的多样性,模型可能难以准确检测物体。例如,主要使用光线充足、场景整洁的图像训练的模型,在低光照环境或拥挤场景中可能表现不佳。在安全系统中,这可能导致漏报事件或误报。
为避免这种情况,维护的数据集不仅要干净、标注准确,还要保持良好的平衡并持续更新。这意味着要找出数据缺口,在条件变化时添加新样本,并确保不同类别和环境都得到均衡呈现。
数据集越完整、结构越清晰,模型就越能应对现实世界中的变化并给出更可靠的预测。
数据集管理的关键方面#
那么,数据集管理具体包括什么?它涉及整理、标注和维护数据,确保数据能在模型开发过程的各个阶段得到有效利用。
例如,整理数据包括构建数据集,并将其划分为训练集、验证集和测试集。训练集用于教会模型,验证集用于监控性能并指导开发过程中的调整,而测试集用于评估最终模型在完全未见数据上的表现。
与此同时,标注是指为图像添加类别标签、边界框或分割掩码等信息。由于模型从这些标注中学习,准确性和一致性对于帮助模型学习有意义的模式并做出可靠预测至关重要。
此外,维护数据集还包括随时间推移检查和更新数据。这可能包括修正标注错误、删除低质量或重复数据,以及添加新样本以覆盖缺失情况或变化的条件。
更广泛地说,数据集管理是一项持续进行的工作。随着模型接受评估、新数据不断收集,数据集也需要更新,以反映真实环境和边缘案例。跟踪这些更新并比较不同版本,有助于团队了解哪些变化提升了性能,以及还需要在哪些方面继续调整。
使用 Ultralytics Platform 管理数据集#
Ultralytics Platform 提供了一个结构化工作流程,可在同一环境中管理数据集,涵盖从数据准备到导出的所有环节。它旨在同时支持个人开发者和团队,无论你独立工作还是跨项目协作,都能更轻松地一致地管理数据集。
每个阶段都旨在简化数据集在整个模型开发生命周期中的整理、处理和使用方式。平台将这些步骤集中到一处,减少工作流程碎片化,让你更轻松地在不同工作流程中保持一致性。
接下来,我们将逐一介绍其中的关键步骤,以及平台如何为每个步骤提供支持。
将数据集上传到 Ultralytics Platform#
你可以灵活地开始在平台上使用数据集,有多种方式导入或复用数据。你可以上传自己的数据,也可以使用平台上的公开数据集快速开始。你还可以克隆社区分享的现有数据集,并在其基础上继续构建。
平台的社区功能让你可以轻松探索并复用已有成果。你可以访问其他用户创建的数据集,其中包含数百万张图像及其标注,因此无需自行收集和标注所有数据,就能快速开始。克隆数据集会在你的工作空间中创建副本,让你能够修改和扩展数据集,同时保留原始版本。
上传方面,平台支持单张图像、视频以及 ZIP、TAR 或 GZ 等数据集压缩包。平台还支持 YOLO 和 COCO 等常用数据集格式,因此无需额外转换即可轻松导入现有数据集和标注。此外,你还可以上传从平台导出的 NDJSON 文件,以便在不同项目中轻松重建或重复使用数据集。
数据上传后,平台会通过结构化流水线处理数据,包括验证文件格式和大小、按需调整图像尺寸、解析标注以及生成数据集统计信息。
例如,视频会转换为帧以便用于训练,而图像则会经过优化和预处理,方便浏览与分析。处理完成后,你就可以在平台中使用数据集进行标注、分析和模型训练。
在 Ultralytics Platform 上进行数据标注#
上传后,你可以直接在平台内查看和标注数据集。平台提供内置的图像标注工具,支持多种计算机视觉任务,例如目标检测、实例分割、语义分割、图像分类、姿态估计和旋转框(OBB)检测。
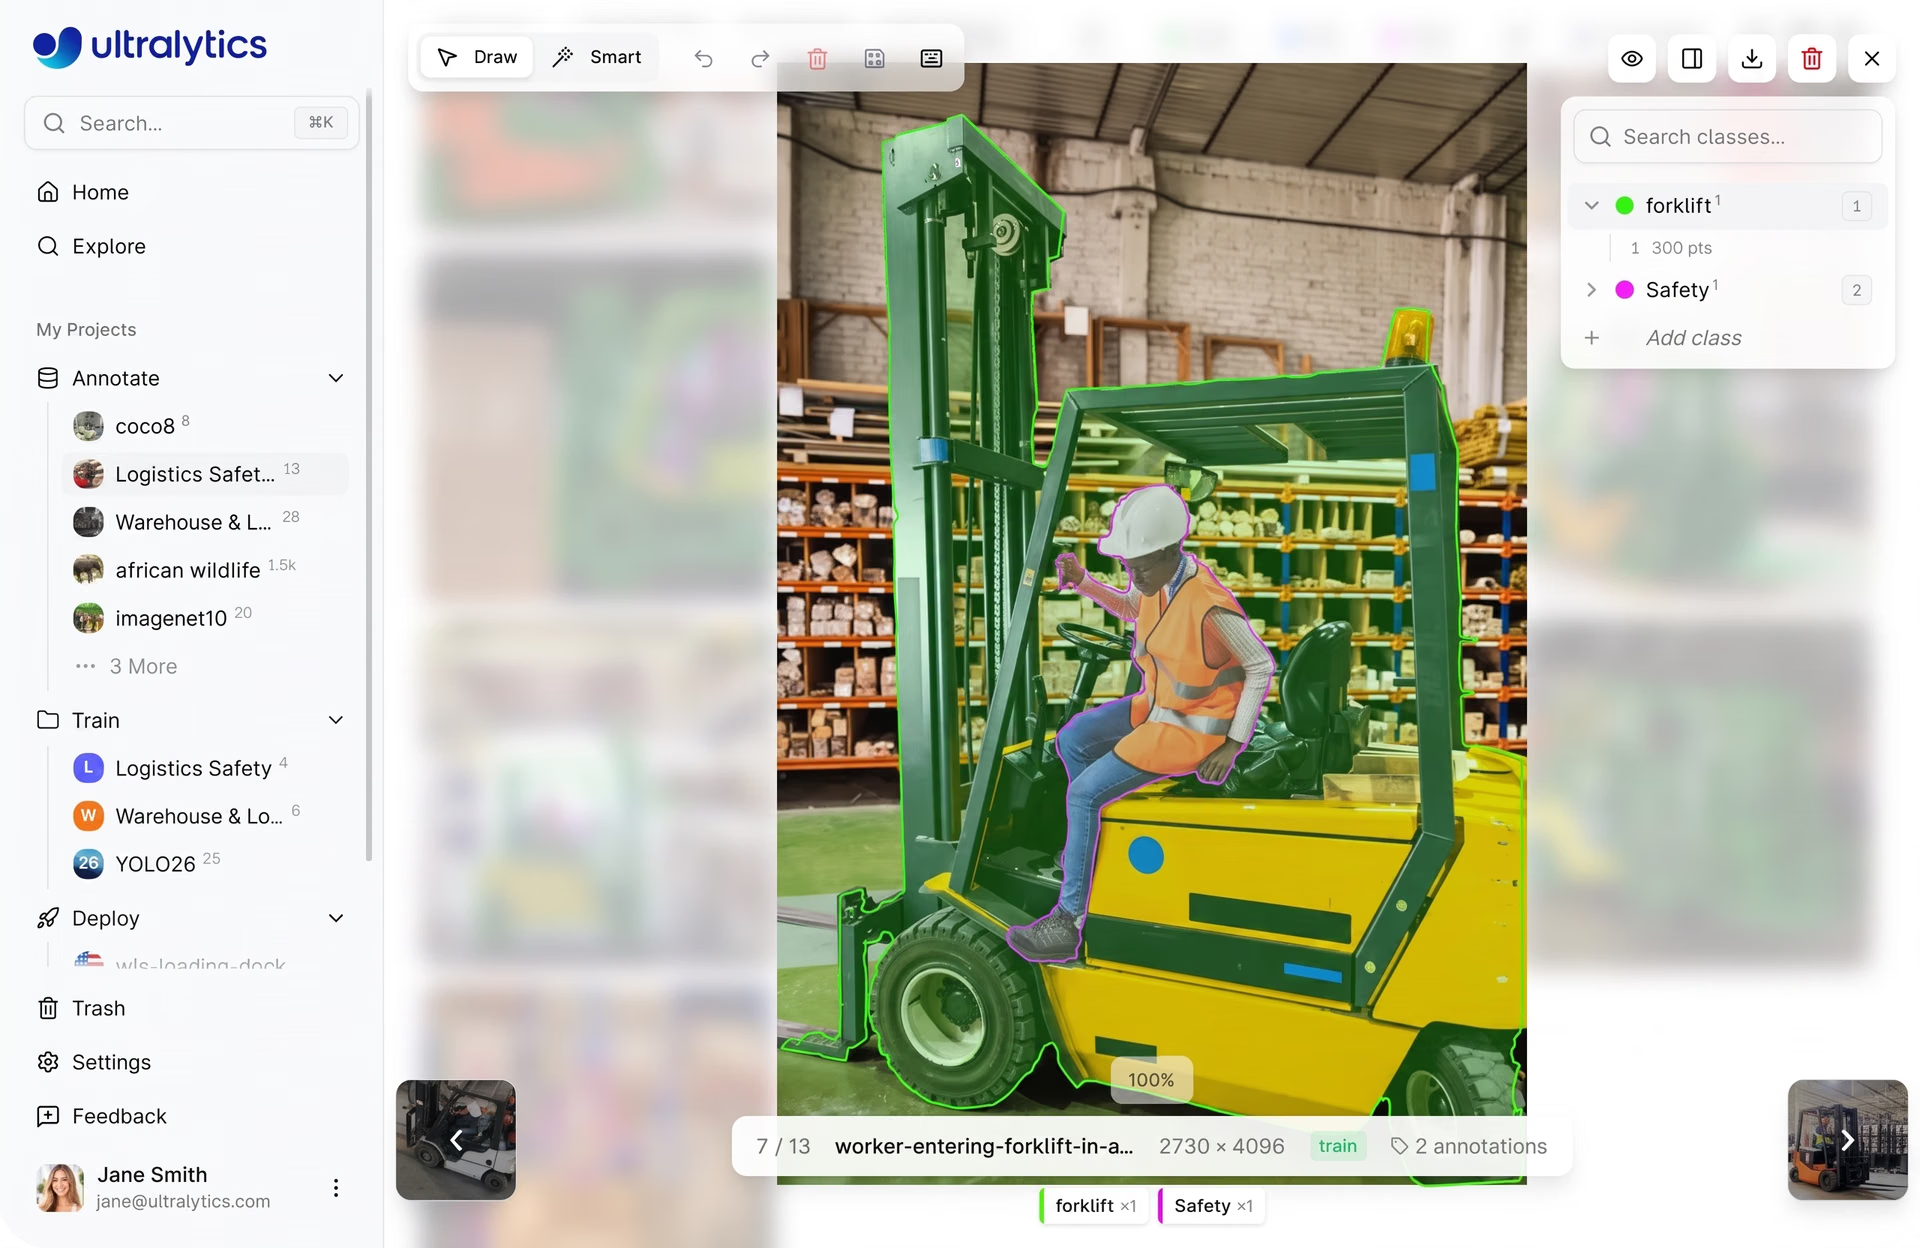
图 2. 使用 Ultralytics Platform 标注数据(来源)
你可以使用这些工具手动创建标注,也可以借助 SAM 驱动的智能标注等 AI 辅助功能加快处理速度。使用 SAM 时,你可以通过与图像交互来生成掩码、边界框或定向框,从而在保持准确性的同时加快标注流程。
通过 Ultralytics Platform 分析数据集质量#
除了准备和标注数据,了解数据集质量对于构建可靠的计算机视觉模型也至关重要。如果无法清楚了解类别分布、标注质量、数据集划分,以及数据在不同条件下的呈现情况,就很难发现影响模型性能的问题。
Ultralytics Platform 内置了多种功能,可帮助你更有效地分析数据集。你可以直接在数据集界面中查看这些分析结果,包括“图像”“类别”和“图表”等选项卡。
在“图表”选项卡中,你可以查看数据集级别的统计信息,例如数据划分分布(训练集、验证集和测试集)、类别频率,以及显示物体在图像中出现位置的标注热力图。
“类别”选项卡会按类别汇总标注数量,让你更容易发现类别不平衡问题。与此同时,“图像”选项卡会显示图像级别的详细信息,例如图像尺寸、标注数量,以及标签在各张图像中的分布情况。
这些分析结果有助于你更轻松地发现类别不平衡、场景缺失或数据分布不均等问题。例如,你可能会发现某些类别的样本极少,或者大多数标注都集中在图像的特定区域。
除了数据分析,平台还支持数据集整理和增强,也就是通过修正或删除有问题的数据来优化数据集,并创建现有数据的变体以提升模型性能。你可以直接在平台中更新标注、添加新数据,或根据分析结果重新整理数据集划分,完成这些改进。
从 Ultralytics Platform 导出数据集#
准备并验证数据集后,你可以将其导出,以便在不同环境中使用。这样,你可以灵活地在自己选择的任何环境中使用计算机视觉数据,无论是在本地、云端,还是通过其他工具和工作流程训练模型。
Ultralytics Platform 会将数据集导出为 Ultralytics NDJSON 文件,这种格式可以直接用于 Ultralytics Python 软件包进行训练,也可以重新导入平台,方便你将数据集集成到不同的训练工作流程和工具中。
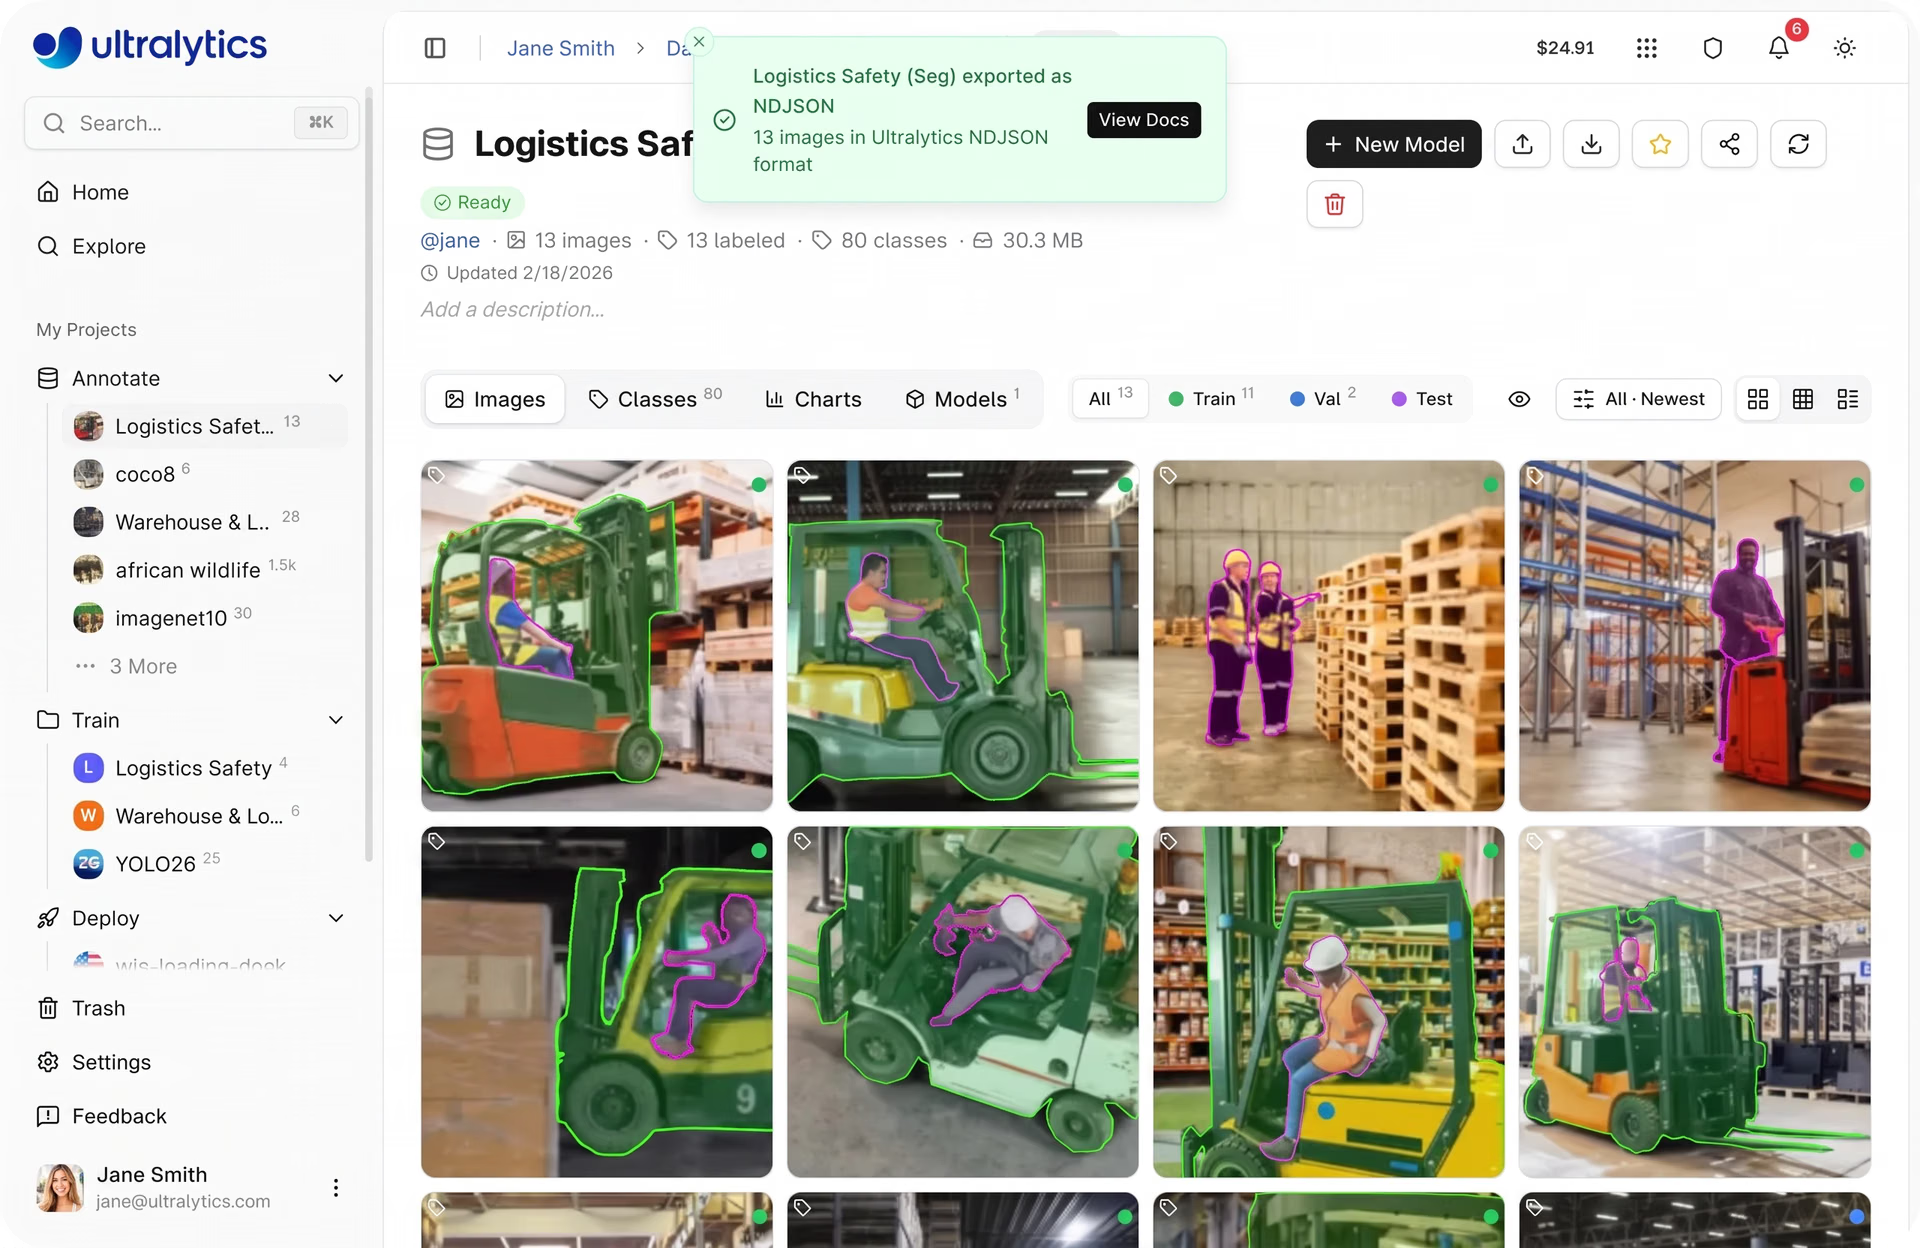
图 3. 从 Ultralytics Platform 导出数据集(来源)
导出数据集会创建一份特定时间点的数据固定快照,其中包括图像、标注和结构。这很有用,因为数据集经常会随着新数据的添加、标注的更新或数据划分的调整而发生变化。导出快照后,你就可以保留特定训练运行所用数据集的确切版本。
这样一来,之后复现结果会更加简单,因为你可以使用相同的数据设置再次训练模型,并比较不同数据集版本的性能。例如,你可以评估添加新图像或修正标注是否确实提升了模型准确率,而不必猜测发生了哪些变化。
导出的数据集可以下载,并用于本地、云端或离线训练环境。
通过在 Ultralytics Platform 上迭代改进数据集质量#
在机器学习和深度学习工作流程中,即使模型已经部署,数据集管理仍会持续进行,因为现实世界中的数据往往与训练数据不同。
随着模型接触新的输入,数据集中的缺口会逐渐显现,例如缺少低光照环境、不同摄像机角度、遮挡或拥挤场景等情况,以及标注错误,因此需要随着时间推移不断优化数据。
改进数据集有多种方法。你可以添加新的图像或视频,覆盖低光照环境、不同摄像机角度、遮挡或拥挤场景等缺失情况,从而减少数据中的盲点。
同时,确保标注准确一致,例如正确标记物体并精确绘制边界框或掩码,有助于模型学习更可靠的模式。
通常可以遵循一个简单的循环:训练模型、评估结果、识别错误、改进数据集,然后重新训练。每个步骤都有助于发现标注错误、数据缺失或代表性不足的情况。
假设你正在开发一个实时零售货架监控系统,用于检测商店中的商品。数据集的早期版本可能未包含某些商品类型、光照条件或货架拥挤摆放的情况。在评估过程中,你可能会发现模型难以检测这些情况下的商品。
为了提升性能,你可以收集覆盖这些缺失场景的新图像,并在需要时更新标注。随着时间推移,重复这一流程有助于模型在真实环境中变得更准确、更可靠。
Ultralytics Platform 通过将数据集更新与训练和评估流程相连接来支持这一工作流程。借助内置的实验跟踪和性能指标,你可以更轻松地监控进展,并持续改进数据集。
使用 Ultralytics Platform 跟踪数据集变化#
我们简要介绍了数据集如何随着模型开发过程不断演变。随着新数据的加入、标注的优化以及类别的更新,跟踪这些变化对于保持数据质量和确保模型性能稳定至关重要。
以下是 Ultralytics Platform 中支持数据集跟踪和版本控制的一些主要功能:
- 数据集版本控制:你可以将数据集创建为固定版本,并以 NDJSON 快照保存。每个版本都会记录特定时间点的关键信息,例如图像数量、类别数量、标注数量和数据集大小。这些版本会被保存下来,之后也可以下载,方便你复现实验并比较数据集不同状态下的结果。
- “版本”选项卡:所有数据集版本都集中显示在“版本”选项卡中,你可以在其中查看版本历史、为变更添加说明,并跟踪数据集随时间的演变。
- 关联模型:“模型”选项卡会显示在数据集上训练的所有模型,包括 mAP 等指标和训练详情。数据集版本会与训练运行关联,帮助你了解数据变化对模型性能的影响。
- “错误”选项卡:“错误”选项卡会突出显示处理失败的文件,并提供错误详情和建议。这样,你就可以在训练前找出并修复损坏文件或不支持的格式等问题。
- 数据集界面(“图像”和“类别”选项卡):这些视图让你能够浏览图像、检查标注、管理类别标签并分析类别分布。筛选、排序和识别未标注图像等功能,让你更轻松地持续监控数据集质量。
- 统计信息和图表:内置数据可视化功能(例如数据划分分布、类别频率和标注热力图)有助于跟踪数据分布变化,并在数据集演变过程中发现不平衡问题。
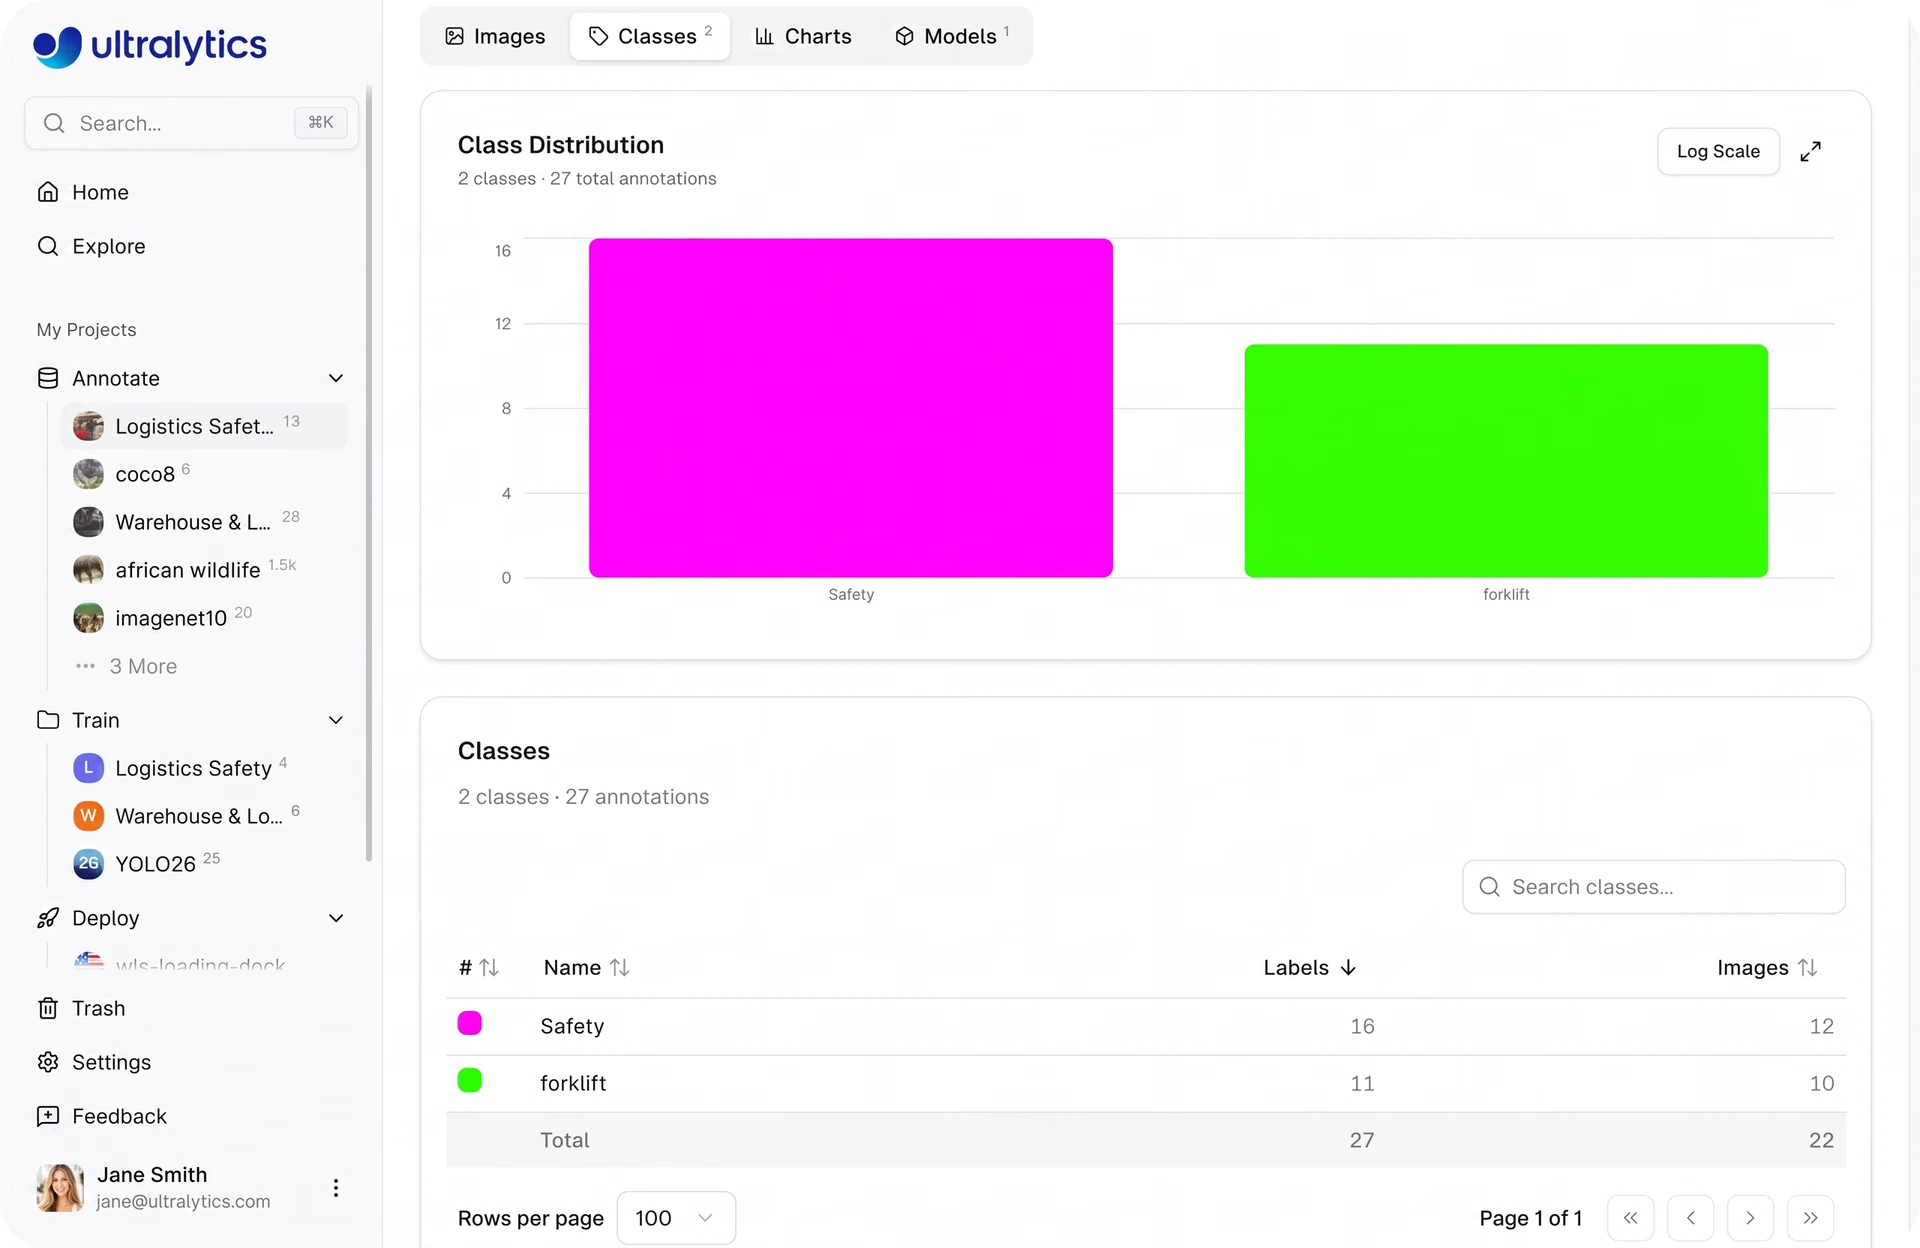
图 4. 在 Ultralytics Platform 上分析数据集类别分布的示例(来源)
在 Ultralytics Platform 中将数据集连接到训练和部署流程#
Ultralytics Platform 将 AI 模型开发的不同阶段连接到一个统一流水线中,从而简化从原始数据到可投入生产的视觉 AI 应用的整个流程。
数据集准备并完成标注后,你可以直接在平台中使用它们训练计算机视觉模型,例如 Ultralytics YOLO26。训练期间,你可以通过内置仪表板监控性能指标、跟踪实验,并评估模型的学习效果。
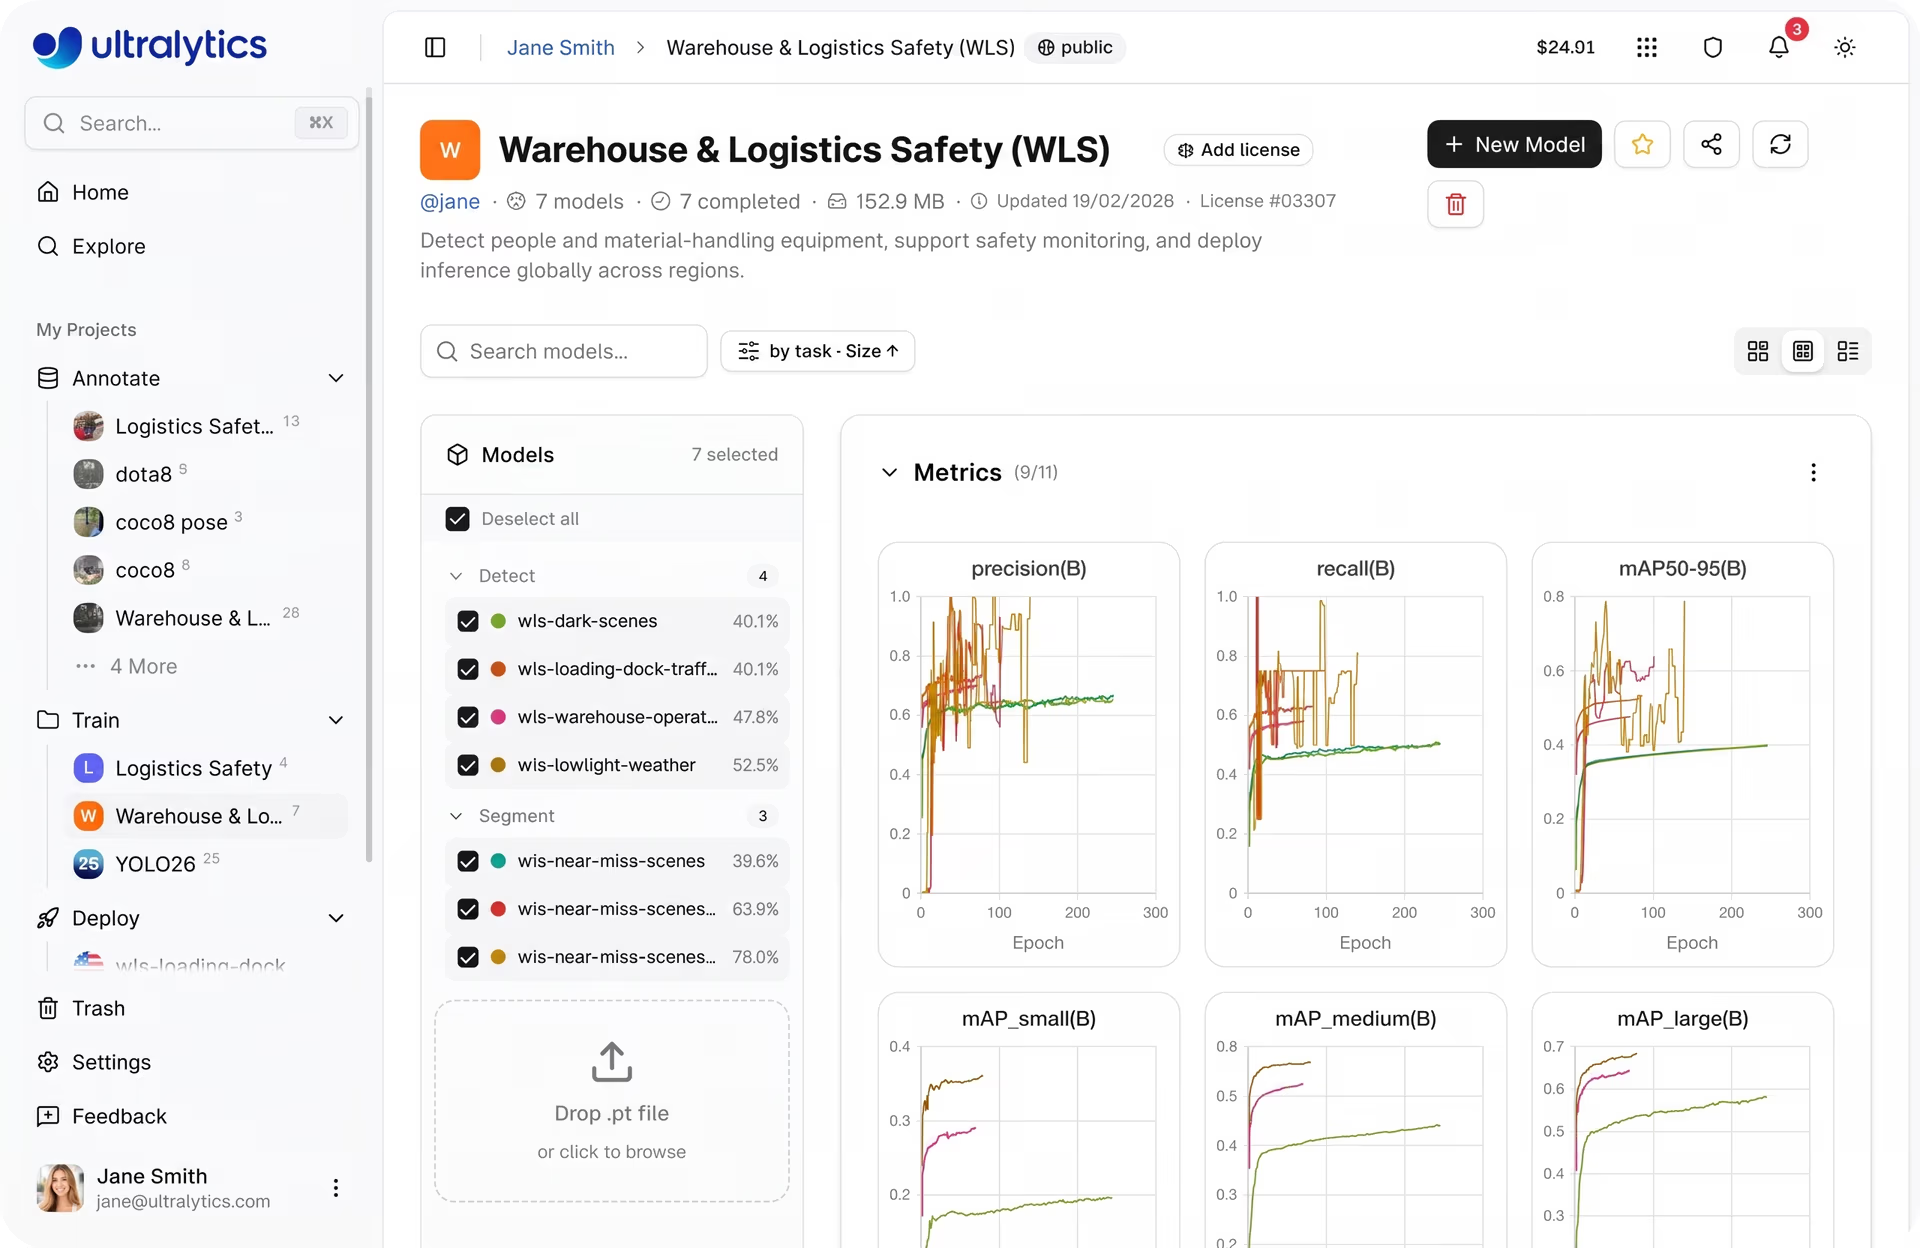
图 5. 在 Ultralytics Platform 上查看模型训练指标的示例(来源)
训练完成后,你可以直接在浏览器中使用新图像测试模型,评估预测结果并找出部署前需要改进的方面。模型表现良好后,就可以将其部署到生产环境中。
平台支持将模型导出为多种格式,也支持通过推理服务和专用端点进行部署,从而让模型能够在不同环境中运行。
部署后,内置监控工具有助于跟踪系统随时间推移的性能,包括与使用情况和模型行为相关的指标。这让你能够更轻松地在真实应用中维护和改进视觉 AI 系统。
使用 Ultralytics Platform 管理数据集的最佳实践#
使用 Ultralytics Platform 管理数据集时,以下是一些需要牢记的关键因素:
- 使用筛选器查找缺口:使用筛选工具识别未标注或代表性不足的数据,从而更轻松地补全标注并提升覆盖率。
- 尽早修复错误: 使用 Errors 选项卡进行质量控制,在训练前发现上传失败、文件损坏或格式不受支持等问题。
- 持续更新数据集: 添加新数据、修正标注,并在出现边缘案例时将其纳入数据集。这有助于提升覆盖率,并确保模型在真实场景中可靠运行。
- 谨慎管理数据集划分: 确保训练集、验证集和测试集之间保持良好平衡。你可以手动重新组织数据划分,也可以在需要时使用自动重新分配功能。
如需详细了解 Ultralytics Platform,请参阅官方的 Ultralytics Platform 文档。
要点#
随着计算机视觉项目规模不断扩大,有效管理数据集变得和模型开发同样重要。采用结构化的数据集管理方法,有助于提升数据质量、简化工作流程,并随着时间推移持续改善模型性能。
Ultralytics Platform 将数据集管理、训练和部署整合到一个工作流程中,简化了这一过程。采用结构化的数据集管理方法,团队可以降低复杂性、提高效率,并构建更具扩展性和可靠性的计算机视觉系统。
加入不断壮大的社区,并探索我们的 GitHub 代码仓库,获取 AI 资源。若要立即开始构建视觉 AI 应用,请查看我们的许可选项。访问我们的解决方案页面,了解 AI 如何应用于农业,以及医疗健康领域的视觉 AI如何塑造未来。
作者
评论
提出问题、分享你的结果,或帮助其他人。









