使用 Ultralytics Platform 更快地训练 YOLO 模型
了解如何使用 Ultralytics Platform 更快地训练 YOLO 模型。这是一套端到端环境,旨在加快从数据到部署的进程。
上周,Ultralytics 推出了 Ultralytics Platform,这是一个统一的工作空间,旨在简化团队构建、训练和部署计算机视觉模型的方式。你无需再周旋于多个工具之间,因为该平台将所有功能集中到一处。借助视觉 AI 模型,从创意到部署变得轻松无忧。
这至关重要,因为计算机视觉正迅速成为各行各业的核心组成部分。它为制造业检测、零售分析和自动导航等应用提供支持。
将这些具备视觉能力的应用转化为可靠系统,取决于模型训练的质量。模型训练是从标注数据中学习,使模型能够识别模式并做出准确预测的过程。通常,训练良好的模型能够带来更出色的模型性能,以及在真实应用中更可靠的结果。
然而,训练计算机视觉模型并不总是简单直接的过程。它涉及多个方面,例如设置环境、选择合适的计算资源、调整超参数,以及跟踪多个训练实验。当这些步骤分散在不同工具和系统中时,训练工作流很快就会变得复杂且难以管理。
Ultralytics Platform 通过将整个训练过程集中到一个统一的控制面板中,解决了这一问题。无论你是在云端、本地还是 Google Colab 中工作,都可以在同一处配置、运行和监控训练任务。
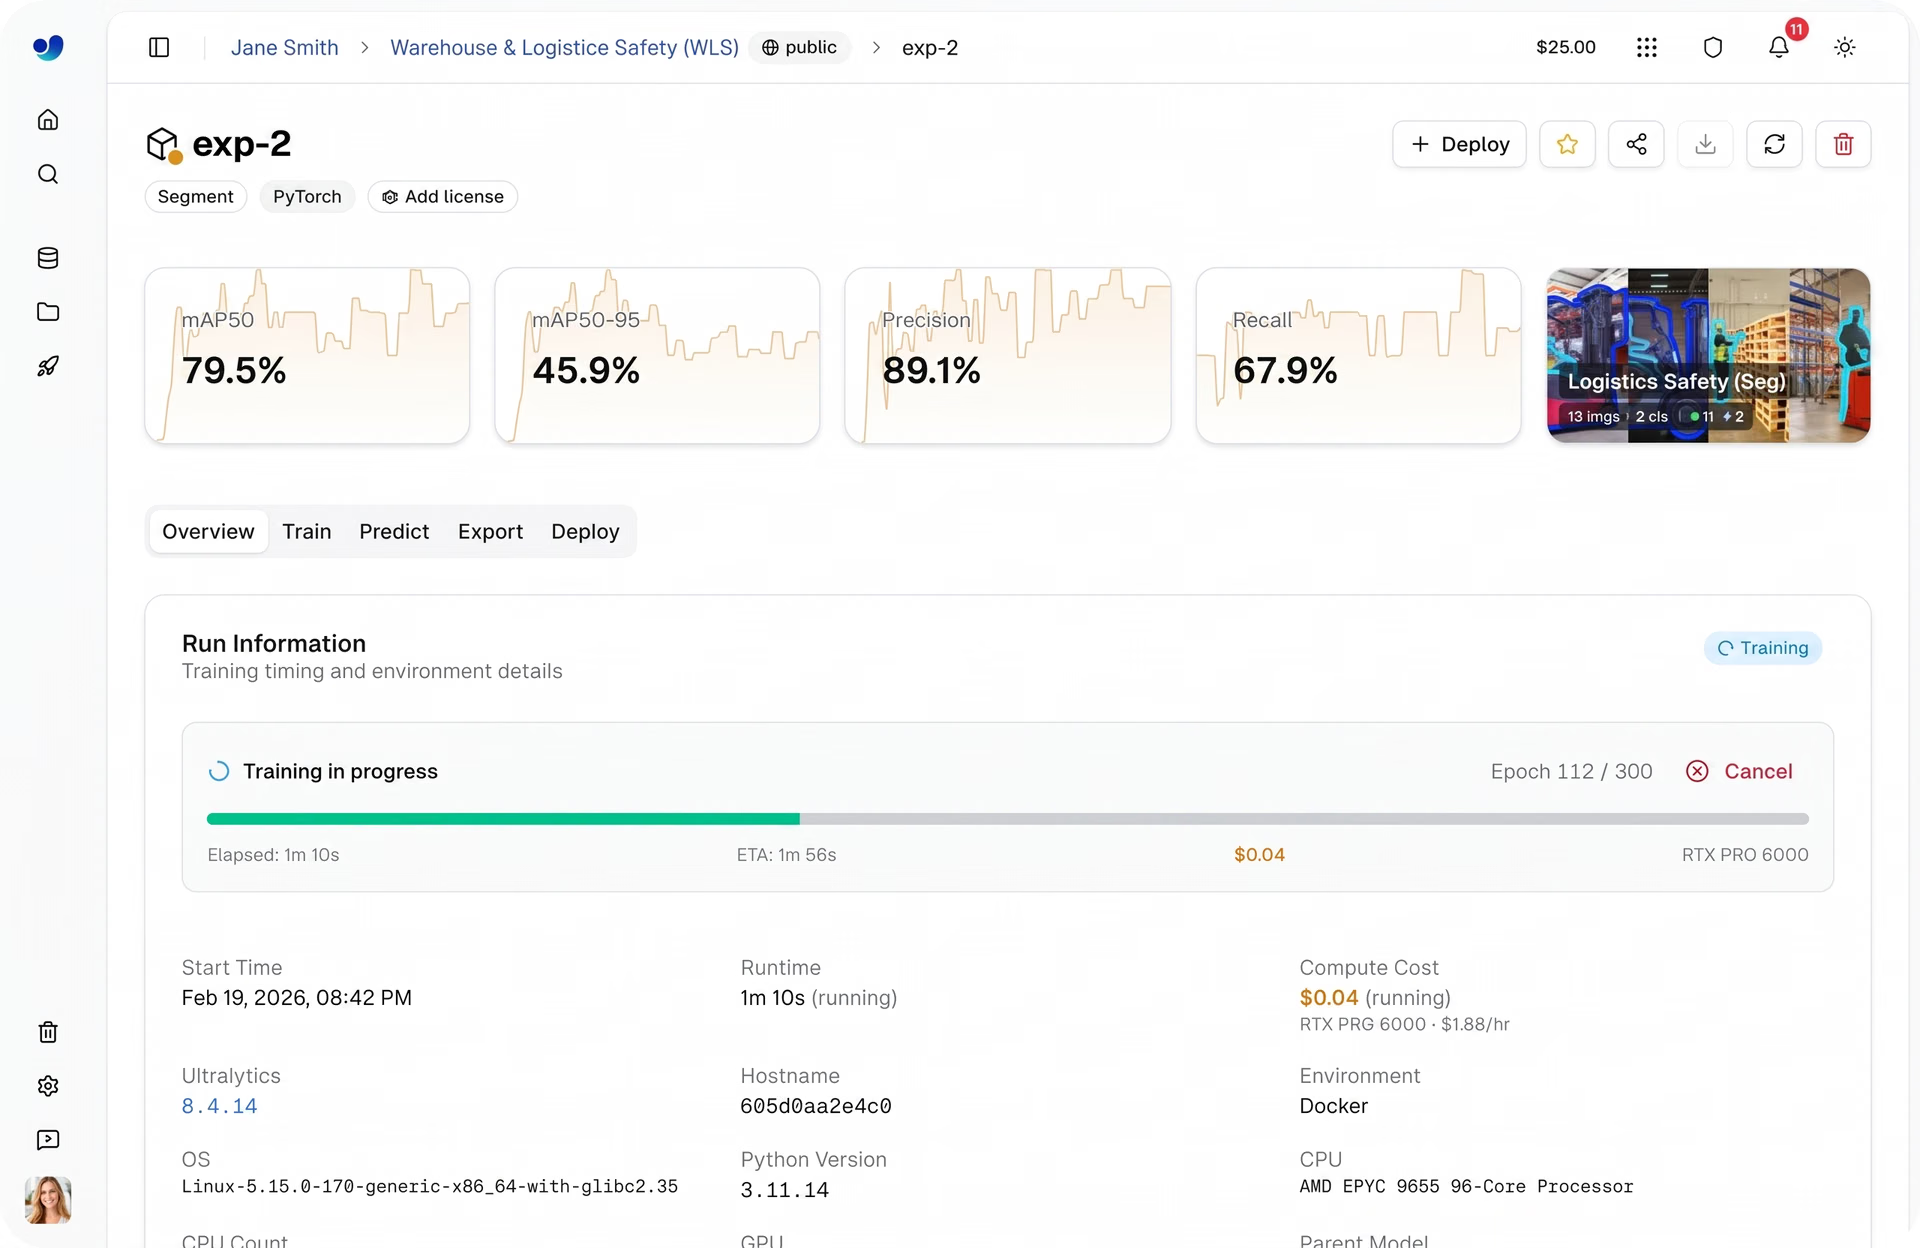
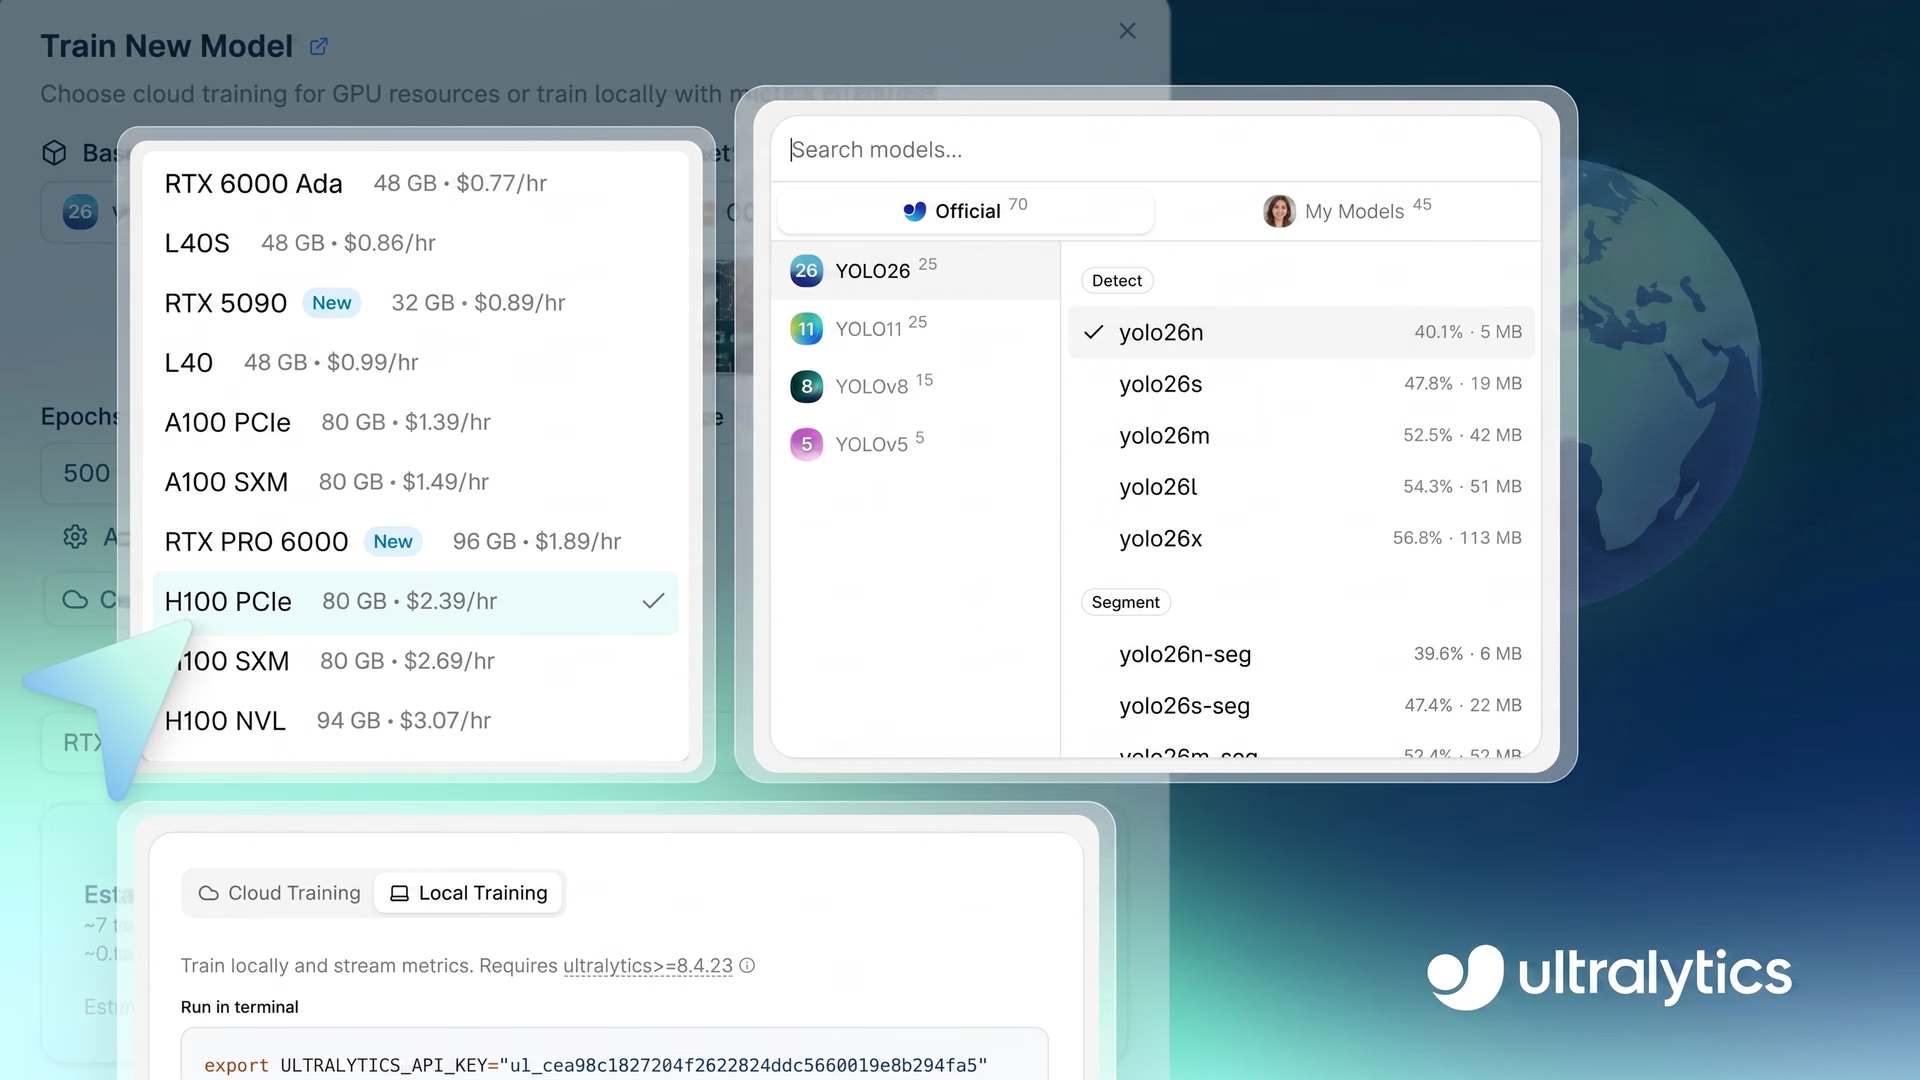
图 1. Ultralytics Platform 中模型训练的一览(来源)
本文将探讨 Ultralytics Platform 如何简化模型训练,以及它为何能让你的视觉 AI 项目更具优势。让我们开始吧!
计算机视觉模型通过模型训练从数据中学习#
在深入了解 Ultralytics Platform 上的模型训练工作原理之前,我们先退一步,了解模型训练是什么,以及其中包含哪些内容。
模型训练是计算机视觉模型学习解读视觉数据的过程。它会分析图像或视频,并逐步调整内部参数,以准确执行目标检测、图像分类和实例分割等视觉任务。随着时间推移,模型会直接从所看到的数据中学习模式,从而不断改进。
训练质量在很大程度上取决于数据集。你可以把数据集想象成教师用来训练学生的一套闪卡,其中每个示例都会帮助模型学会应该关注什么。
典型的计算机视觉数据集包含图像,通常采用 JPG 或 PNG 等格式,以及描述每张图像内容的标注。这些标注通常存储为 JSON 或 TXT 文件,为模型有效学习提供所需的标签和上下文。
但训练并不只是将数据输入模型。它包含多个关键步骤,从准备数据集,到选择合适的模型,再到配置训练过程。接下来,让我们仔细了解其中几个步骤。
了解数据集的准备方式#
你可能会觉得,只要有了数据集就可以立即开始训练模型,但在此之前还需要完成几个步骤,例如拆分数据集。
通常,数据集会拆分为三部分:训练集、验证集和测试集。训练图像用于教模型学习数据中的模式,而验证集则有助于在训练期间监控和微调性能。
测试集用于最后评估模型在全新、未见过的数据上的表现。这种设置有助于确保模型不会只是记住数据,而是能够泛化到真实场景。
为训练选择合适的模型#
训练前的另一个重要步骤是选择要使用的模型。在许多情况下,这意味着选择一个预训练模型。Ultralytics YOLO 模型已经在大型数据集上完成训练,并学习了通用视觉模式,因此是一个很好的起点。
使用这些模型就是迁移学习的一个例子:在现有知识的基础上,将模型调整到特定任务。这种方法有助于加快训练并改善结果,尤其是在数据有限的情况下。
这些模型也有不同的尺寸,每种尺寸都在速度和准确率之间提供了不同的权衡。较小的模型速度更快、效率更高,而较大的模型通常能提供更高的准确率,但需要更多计算资源。
为视觉模型配置训练参数#
准备好数据集并选定模型后,下一步就是配置模型的学习方式。
计算机视觉模型使用一组参数进行训练,这些参数决定模型如何处理数据、更新权重并随时间改进。这些设置会直接影响训练速度和最终准确率,因此对于取得良好结果至关重要。
以下是一些最常用的训练参数:
- Epochs:表示模型在训练期间遍历整个数据集的次数。增加 epoch 数量可以让模型获得更多机会从数据中学习模式。
- Batch size:表示单个训练步骤中同时处理的图像数量。较大的 batch size 可以加快训练,但需要更多内存。
- Image size:指定训练期间使用的输入图像分辨率。更高的分辨率可能提高检测准确率,但会增加计算成本。
- Learning rate:表示模型在训练期间更新内部参数的速率。过高或过低的值都可能导致训练不稳定。
- Optimizer:负责根据每次训练迭代中计算出的误差更新模型参数的算法。
在基于 Ultralytics YOLO 的工作流中,这些配置通常定义在 YAML 文件中。该文件指定数据集路径、类别名称以及数据的拆分方式。它充当中央配置,告诉模型如何解读数据集。
从碎片化工作流到借助 Ultralytics Platform 实现统一体验#
我们刚刚讨论了训练计算机视觉模型所涉及的一些关键步骤,从准备数据集到选择模型,再到配置训练参数。在实践中,这一过程通常还会继续,包括跟踪实验、比较多次训练运行,并随着时间推移持续改进模型。
这些步骤很少在同一处完成。数据集可能在一个工具中准备,训练运行在另一个环境中执行,而实验跟踪则由单独的系统管理。随着项目发展,这种碎片化会增加复杂性、减慢迭代速度,也让一切更难保持井然有序。
Ultralytics Platform 将整个训练工作流集中到一个环境中,从而消除了这些复杂性。你无需在工具之间来回切换,就可以在同一处管理数据集、配置训练、运行实验和监控结果。
接下来,让我们深入了解 Ultralytics Platform 如何让模型训练更智能。
Ultralytics Platform 支持的训练选项#
在真实应用中,训练计算机视觉模型通常需要灵活的环境。根据数据集大小、模型复杂度和可用硬件,你可以选择在云端、本地计算机或外部笔记本环境中运行训练。
Ultralytics Platform 支持以下训练选项,以满足这些需求:
- 云端训练:训练在由 Ultralytics 管理的云端图形处理单元 (GPUs) 上运行。此选项适合需要大量计算资源的大型数据集或复杂模型。
- 本地训练:此选项使用计算机上的可用硬件,适合快速实验、测试配置或处理较小的数据集。对于更具扩展性的工作负载,你也可以在自己的云环境中运行训练,例如 AWS 或 GCP。
- Google Colab:借助 Ultralytics Platform,你可以在 Google Colab 托管的笔记本环境中运行训练,实现灵活的基于浏览器的工作流,而无需配置本地计算机。
探索 Ultralytics Platform 上的云端训练#
对于计算机视觉项目而言,在本地或通过笔记本环境训练模型并不总是容易。
例如,在本地训练中,性能完全取决于你的硬件,这可能会限制计算能力并减慢实验速度。GPU 对高效训练至关重要,但并非所有环境都能可靠地访问 GPU。
Google Colab 等笔记本环境通过提供基于云端的 GPU 提供了另一种选择,但会话通常是临时的,可能中断较长时间的训练运行。随着数据集增大、工作流变得更加复杂,这些限制很快就会成为瓶颈,使训练速度变慢且可靠性降低。
Ultralytics Platform 通过云端训练选项解决了这一问题。它提供了一个开箱即用的环境,其中 Python 依赖项和 PyTorch 等框架已预先配置,让你无需额外设置即可开始训练。
你可以从一个控制面板启动训练任务并实时监控进度。这让你更容易专注于改进模型,而不是管理基础设施。
现在,让我们了解如何开始在 Ultralytics Platform 上进行云端训练。
步骤 1:选择基础模型#
第一步是为训练运行选择基础模型。你可以选择一个预训练的 Ultralytics YOLO 模型、克隆社区模型,或上传自己的预训练权重以满足自定义需求。
该平台支持所有 Ultralytics YOLO 模型,包括 Ultralytics YOLO26、Ultralytics YOLO11、Ultralytics YOLOv8 和 Ultralytics YOLOv5,每个模型都有 nano (n)、small (s)、medium (m)、large (l) 和 extra-large (x) 等不同尺寸变体。不同模型变体在速度和准确率之间提供了不同权衡,你可以选择符合性能和计算需求的模型。
这些模型支持一系列 Ultralytics YOLO 用户已经熟悉的计算机视觉任务,包括目标检测、实例分割、图像分类、定向边界框 (OBB) 检测和姿态估计。
如果你有自定义需求,也可以上传自己的预训练模型权重。这意味着你可以直接在平台中继续训练或微调现有模型,例如目标检测器,而无需从头开始。如果你已经在其他地方训练过模型,或希望将模型调整到更具体的使用场景,这一功能尤其有用。
步骤 2:选择数据集#
下一步是选择用于训练的数据集。在 Ultralytics Platform 上,你可以使用 COCO 数据集等现有数据集、克隆社区数据集,或上传针对具体应用定制的自定义数据集。
该平台支持 Ultralytics YOLO 和 COCO 等常见标注格式。如果你计划直接在平台上标注自定义数据,也可以处理原始图像上传。
上传后,数据集会自动进行处理,包括验证、规范化、标签解析和统计信息生成。这样你可以立即了解数据情况,包括类别分布和数据集结构,并有助于确保一切准备就绪,可以开始训练。
数据集还会自动关联到训练运行,让你能够跟踪每个模型使用的数据,并确保不同实验之间的一致性。
步骤 3:配置训练参数#
选择数据集后,你可以配置控制模型学习方式的训练参数。这些参数包括 epoch 数、batch size、图像尺寸和训练日志的运行名称。其中许多参数会同时影响训练时长和模型的最终性能。
为了实现更精细的训练控制,该平台还允许你调整学习率、优化器类型、颜色增强设置和其他训练选项等高级参数。这些设置可以微调训练过程,从而提高模型准确率和稳定性。
步骤 4:选择 GPU#
接下来,你可以为训练运行选择 GPU 配置。选择合适的 GPU 取决于数据集大小、batch size、图像分辨率和模型复杂度等因素。找到合适的平衡,有助于在不使用过多计算资源的情况下保持训练高效。
Ultralytics Platform 提供 22 种 GPU 选项,具有不同级别的 VRAM(GPU 上的内存)和计算能力,可支持从小型任务到大规模工作负载的各种需求。
借助这些选项,你可以根据具体需求匹配硬件,无论是训练轻量级模型,还是处理大型复杂数据集。要了解更多信息,请查看 Ultralytics Platform 训练文档页面上的可用 GPU 列表。
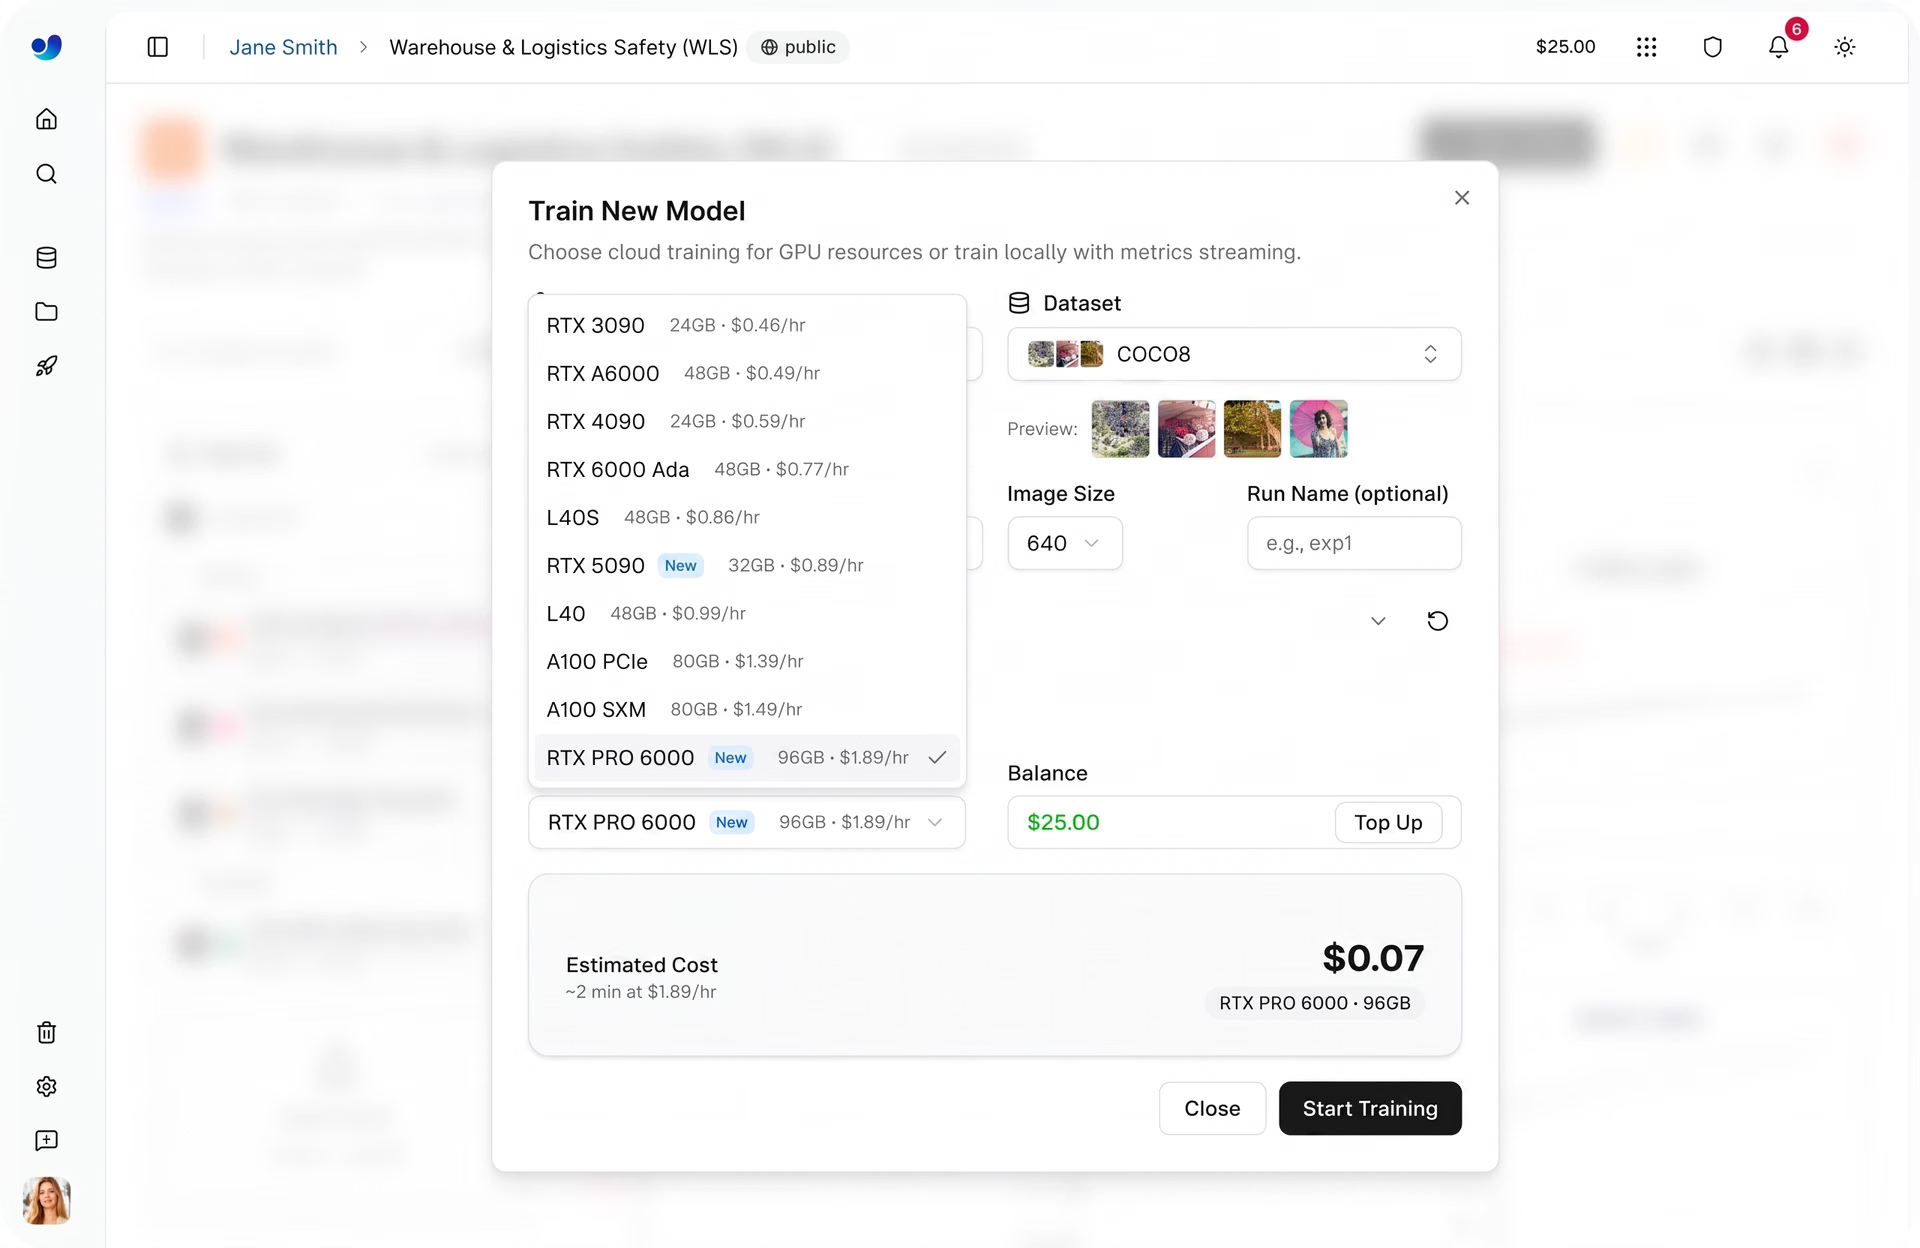
图 2. Ultralytics Platform 启用的部分 GPU 选项(来源)
步骤 5:开始云端训练#
选择模型、数据集、训练参数和计算选项后,启动训练运行非常迅速。你可以从控制面板单击一次启动训练,平台会完成其余工作:初始化环境,并在选定的 GPU 上运行任务。
训练开始后,你可以直接在平台中监控进度。Train 选项卡提供关键指标的实时可见性,包括性能指标、损失曲线、系统使用情况和实时训练日志。
如果想进一步了解如何在本地训练,或如何将 Google Colab 与 Ultralytics Platform 结合使用,可以在官方 Ultralytics Platform 文档中查看更多教程。
在 Ultralytics Platform 上评估和比较模型#
训练完成后,下一步是评估模型的表现。在 Ultralytics Platform 上,你可以在一个项目中比较多次训练运行,清晰了解不同实验的表现。
开发模型时,通常会使用不同设置重复训练多次,例如更改学习率、batch size 或模型尺寸,以改善结果。每次运行都会生成略有不同的模型,因此比较它们非常重要。
项目充当集中枢纽,将模型和实验统一组织起来。你可以跟踪进度、查看结果,并专注于工作,无需在不同工具或视图之间切换。
在这一统一视图中,你还可以分析 precision、recall 和 mAP(平均精度)等关键性能指标,了解模型在不同类别上的表现。你也可以并排比较训练运行,以确定哪些配置能带来最佳结果。
为了补充这些指标,你可以使用 Predict 选项卡在示例图像或数据上快速测试训练好的模型,帮助你通过视觉验证性能并发现潜在问题。
借助这些洞察,你可以选择表现最佳的模型,该模型通常保存为 “best.pt” 检查点,然后进入下一阶段,无论是进一步评估、使用模型运行推理,还是通过平台部署模型。
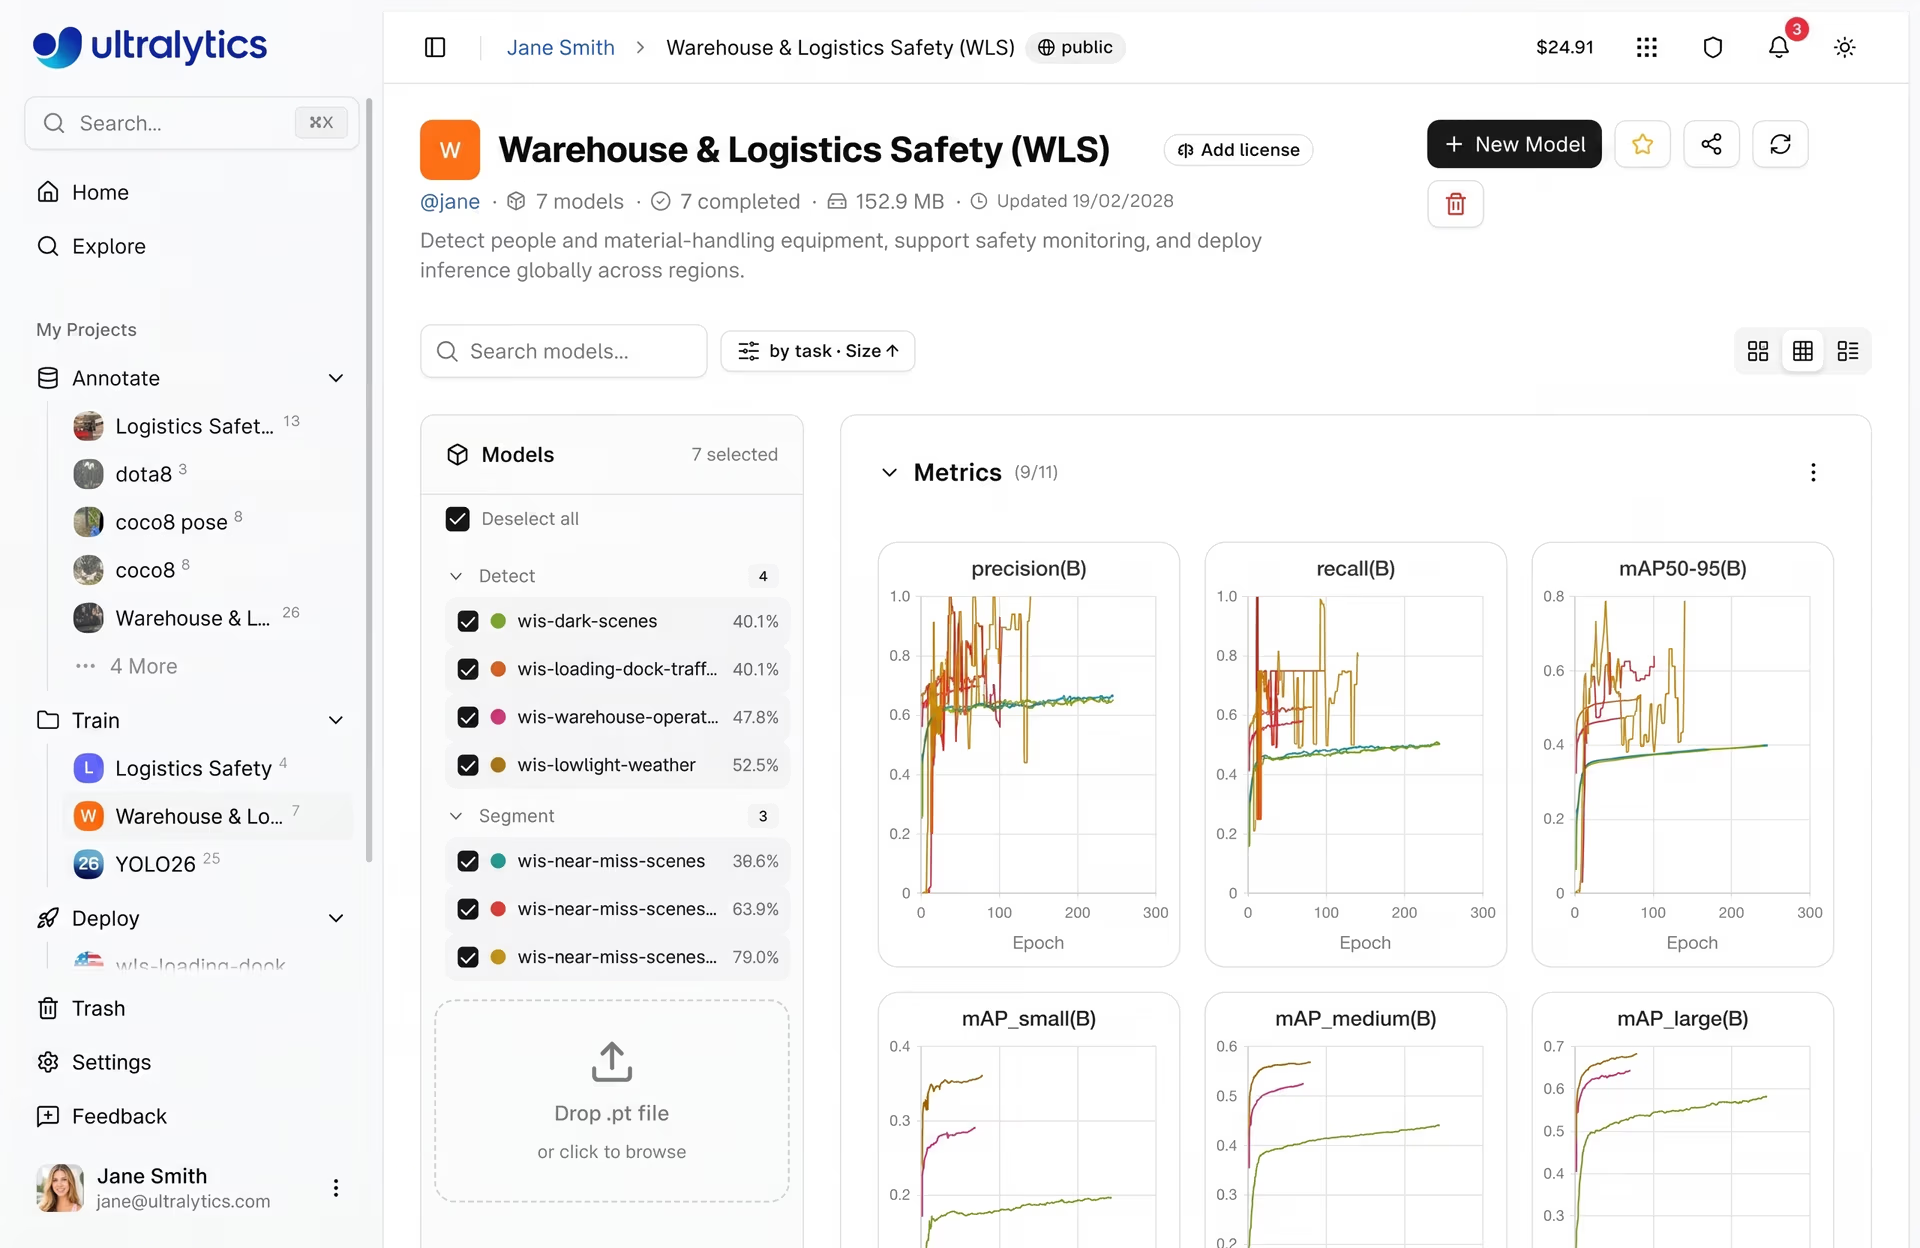
图 3. 在 Ultralytics Platform 上查看指标的示例(来源)
在 Ultralytics Platform 中估算训练成本#
在云端训练目标检测模型会产生计算成本,尤其是在使用高性能 GPU 时。为了让这一过程更加便捷,Ultralytics Platform 会在训练开始前提供成本估算。
它可以清晰展示预期用量,帮助你规划工作负载、管理预算,并在启动训练任务前避免意外支出。以下是如何在开始训练前查看预计成本。
训练时间如何估算#
为了准确估算成本,平台首先会计算单个训练 epoch 所需的时间。这取决于数据集大小、模型尺寸、图像分辨率、batch size 和所选 GPU 的速度等因素。
平台利用这些输入确定每个 epoch 的预计时间,并将其扩展到完整的训练运行。总时长通过汇总所有 epoch 的时间,再加上一小段启动开销来计算。
开销包括初始化环境、加载数据集和准备 GPU 等任务,从而确保估算反映完整的训练过程,而不仅仅是训练循环。
训练成本如何计算#
估算出总训练时间后,平台会根据所选 GPU 的小时费率将其转换为成本。
将训练时长与 GPU 定价结合起来,我们就能在运行开始前清楚估算其成本。
提前了解成本后,你可以轻松调整设置,例如微调训练参数或选择其他 GPU,从而更有效地平衡性能和成本。
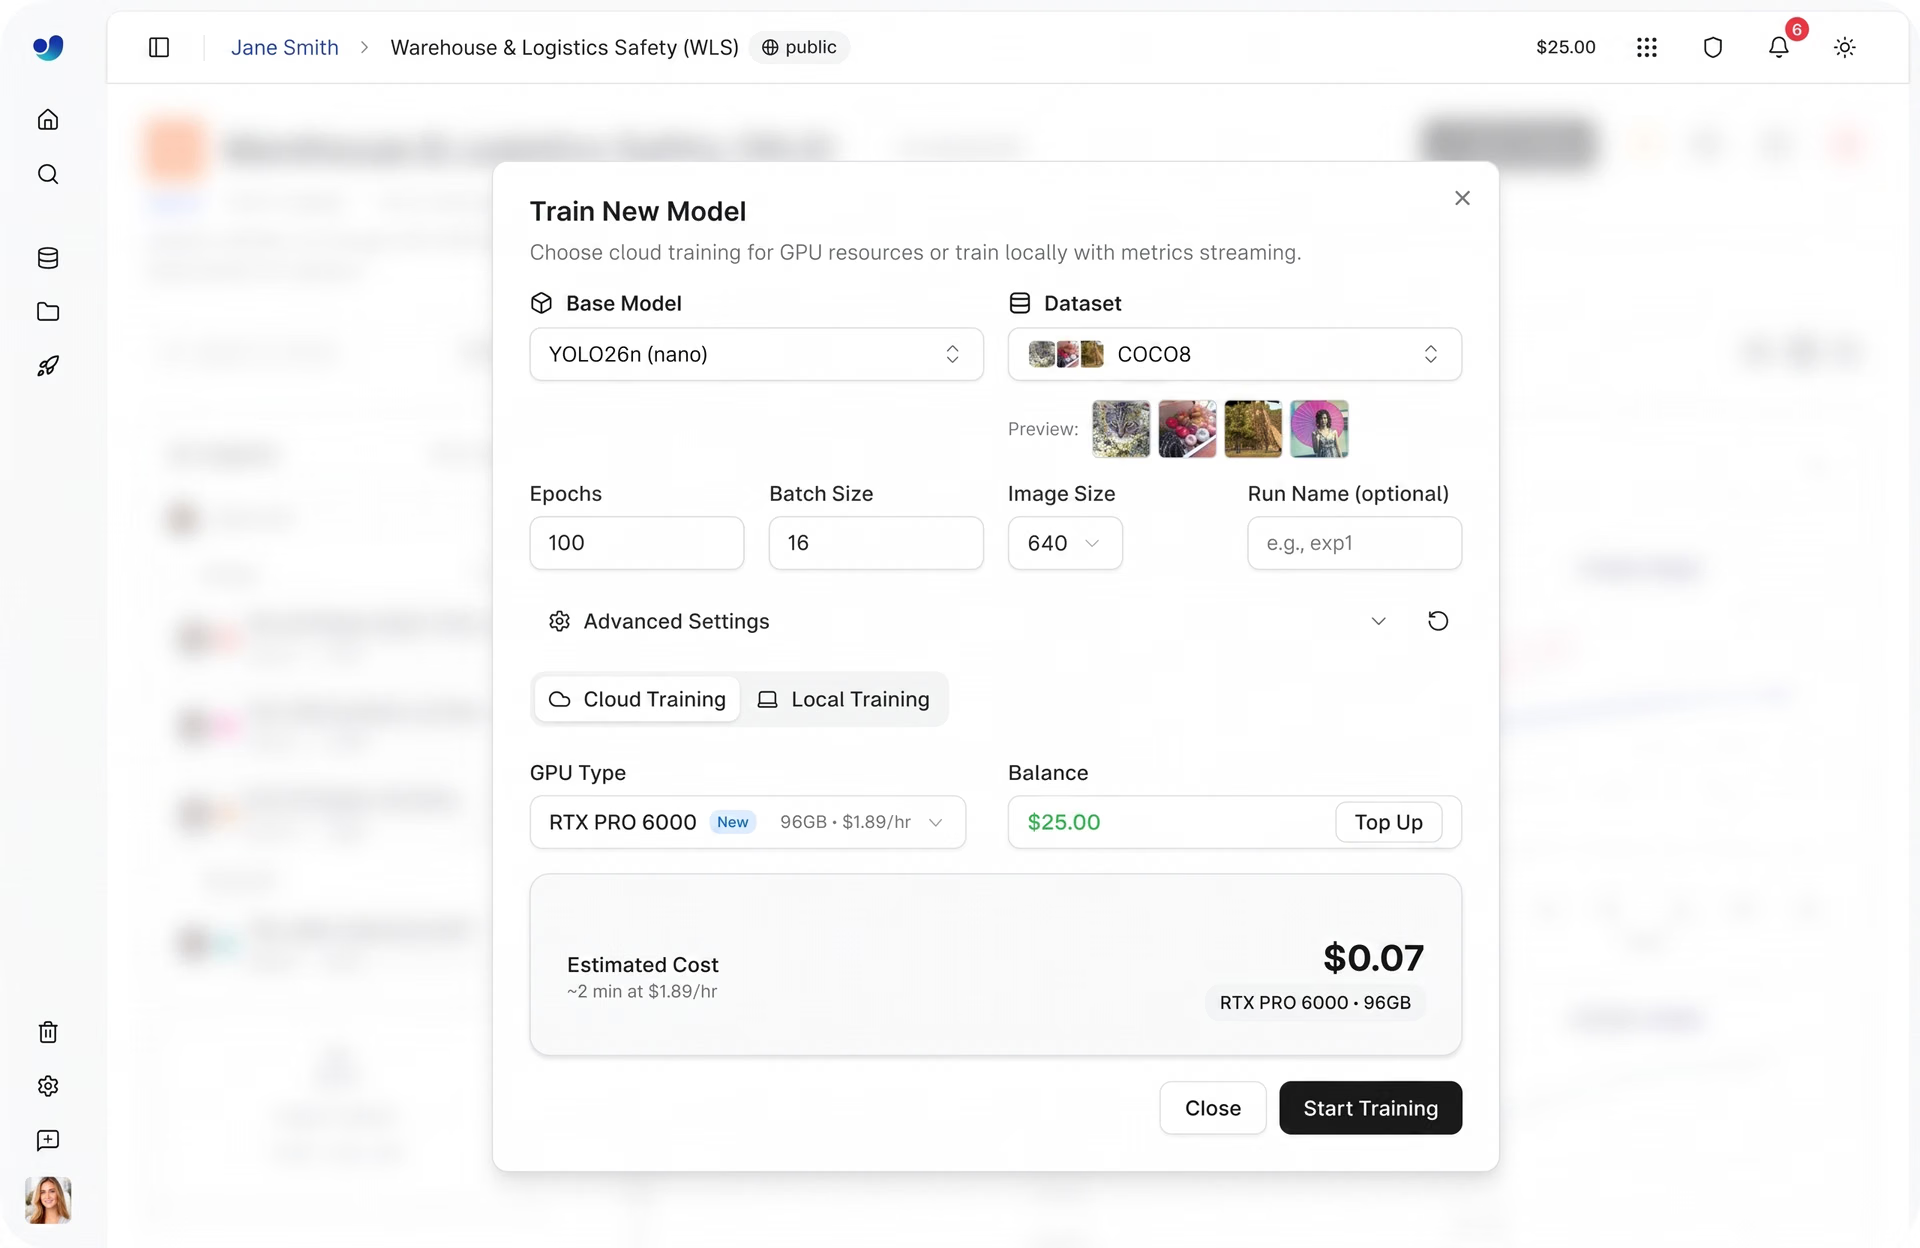
图 4. 在 Ultralytics Platform 中设置模型训练并估算成本(来源)
使用 Ultralytics Platform 进行模型训练的主要优势#
到目前为止,我们已经介绍了训练计算机视觉模型所涉及的关键步骤,以及这些步骤如何在 Ultralytics Platform 上协同完成。
除了这些核心功能之外,平台还提供了能够增强训练工作流的其他能力。以下是使用 Ultralytics Platform 进行模型训练的一些主要优势:
- 内置实验可复现性:每次训练运行都会自动记录完整配置,包括模型、数据集、参数和计算设置。这让你可以轻松重新查看实验,并可靠地复现结果。
- 随时间变化的训练洞察:你不仅可以查看最终结果,还可以跟踪模型性能在各个训练周期中的变化,从而更好地了解模型在训练期间的行为。
- 降低运维负担:平台在后台处理环境设置、依赖管理和基础设施,让你可以更专注于模型开发,减少在配置工作上的投入。
- 集中管理实验:项目提供统一的位置来管理模型、数据集和训练运行,帮助你在工作流程日益复杂时保持实验井然有序。
要点总结#
训练是机器学习模型生命周期中最重要的阶段之一。它决定了模型识别和解读视觉数据的准确程度。
通过在同一环境中整合训练数据配置、监控、实验比较和成本估算,Ultralytics Platform 简化了构建高性能计算机视觉模型并为其部署做好准备的流程。
访问不断发展的社区和我们的 GitHub 代码仓库,进一步了解计算机视觉。如果你希望构建视觉解决方案,可以查看我们的许可选项。探索我们的解决方案页面,进一步了解制造业中的计算机视觉和农业中的 AI所带来的优势。






