Ultralytics Platform 如何使用 AI 自动完成标注
了解 Ultralytics Platform 如何利用 AI 自动完成标注、管理大型数据集、提升一致性并加快计算机视觉开发。
用于分析图像和视频的计算机视觉解决方案,正逐渐成为众多行业工作流中的常规组成部分,应用领域从制造业到医学影像不等。例如,在制造业中,要检测传送带上产品的表面缺陷,就需要能够识别细微模式的计算机视觉模型。
要让这类模型有效运行,必须使用带标签的数据进行训练,并清楚标明每个缺陷。这能帮助模型学会关注哪些内容,并识别相似模式。
创建这些标签的过程称为数据标注。具体来说,图像标注和视频标注包括绘制边界框、勾勒形状,或为图像和视频帧中的特定区域添加标签。
对于小型数据集,这项工作尚可应付,但随着数据量增长,处理起来很快就会变得困难。标注数千张图像需要持续投入人工,使标注成为主要瓶颈。传统工具往往速度慢、彼此割裂,而且难以扩展。
Ultralytics Platform 是一个一体化视觉 AI 平台,它通过 AI 辅助标注帮助解决这些挑战。平台利用 AI 自动生成初始标签,供你快速审核和完善,从而减少人工工作并提高效率。
本文将介绍 Ultralytics Platform 中 AI 辅助标注的工作方式,以及它如何改进标注流程。现在开始吧!
数据标注流程概览#
在深入了解 Ultralytics Platform 上的 AI 驱动标注如何工作之前,我们先仔细看看数据标注。
数据标注也称为数据贴标签,是为原始数据分配结构化标签,使其能够用于训练机器学习模型的过程。在计算机视觉中,这些标签用于定义图像或视频中关注的对象、区域或特征。
在训练过程中,模型或算法会学习将输入数据映射到这些标签,因此标注质量是影响模型性能的关键因素。准确且一致的标注数据集有助于模型学到正确的模式,而质量差或不一致的标注则可能导致预测不可靠。
例如,在缺陷检测场景中,可以对传送带上的产品图像进行标注,标出缺陷出现的位置并标明缺陷类型。这有助于模型了解缺陷的样子,从而在新图像中识别缺陷。
常见标注任务一览#
接下来,我们来看看计算机视觉中图像标注的一些常见方式。这些方法用于为视觉数据添加标签,以执行目标检测、实例分割和图像分类等任务。每种标注方法都有不同用途,例如定位对象、描绘形状或识别关键结构。
边界框#
边界框是在图像中的对象周围绘制的简单矩形,用于标示对象的位置。它们是计算机视觉中最常见的数据标注方式之一。
通过在带有这些框的图像上训练,目标检测模型可以学会识别不同对象,并了解它们在图像中的位置。这样,模型就能一次检测多个对象,并确定每个对象出现的位置。
例如,可以用计算机视觉分析一场棒球比赛。在每一帧中,你都可以为球员、球棒和球画上框,让模型在整场比赛中检测并识别这些对象。
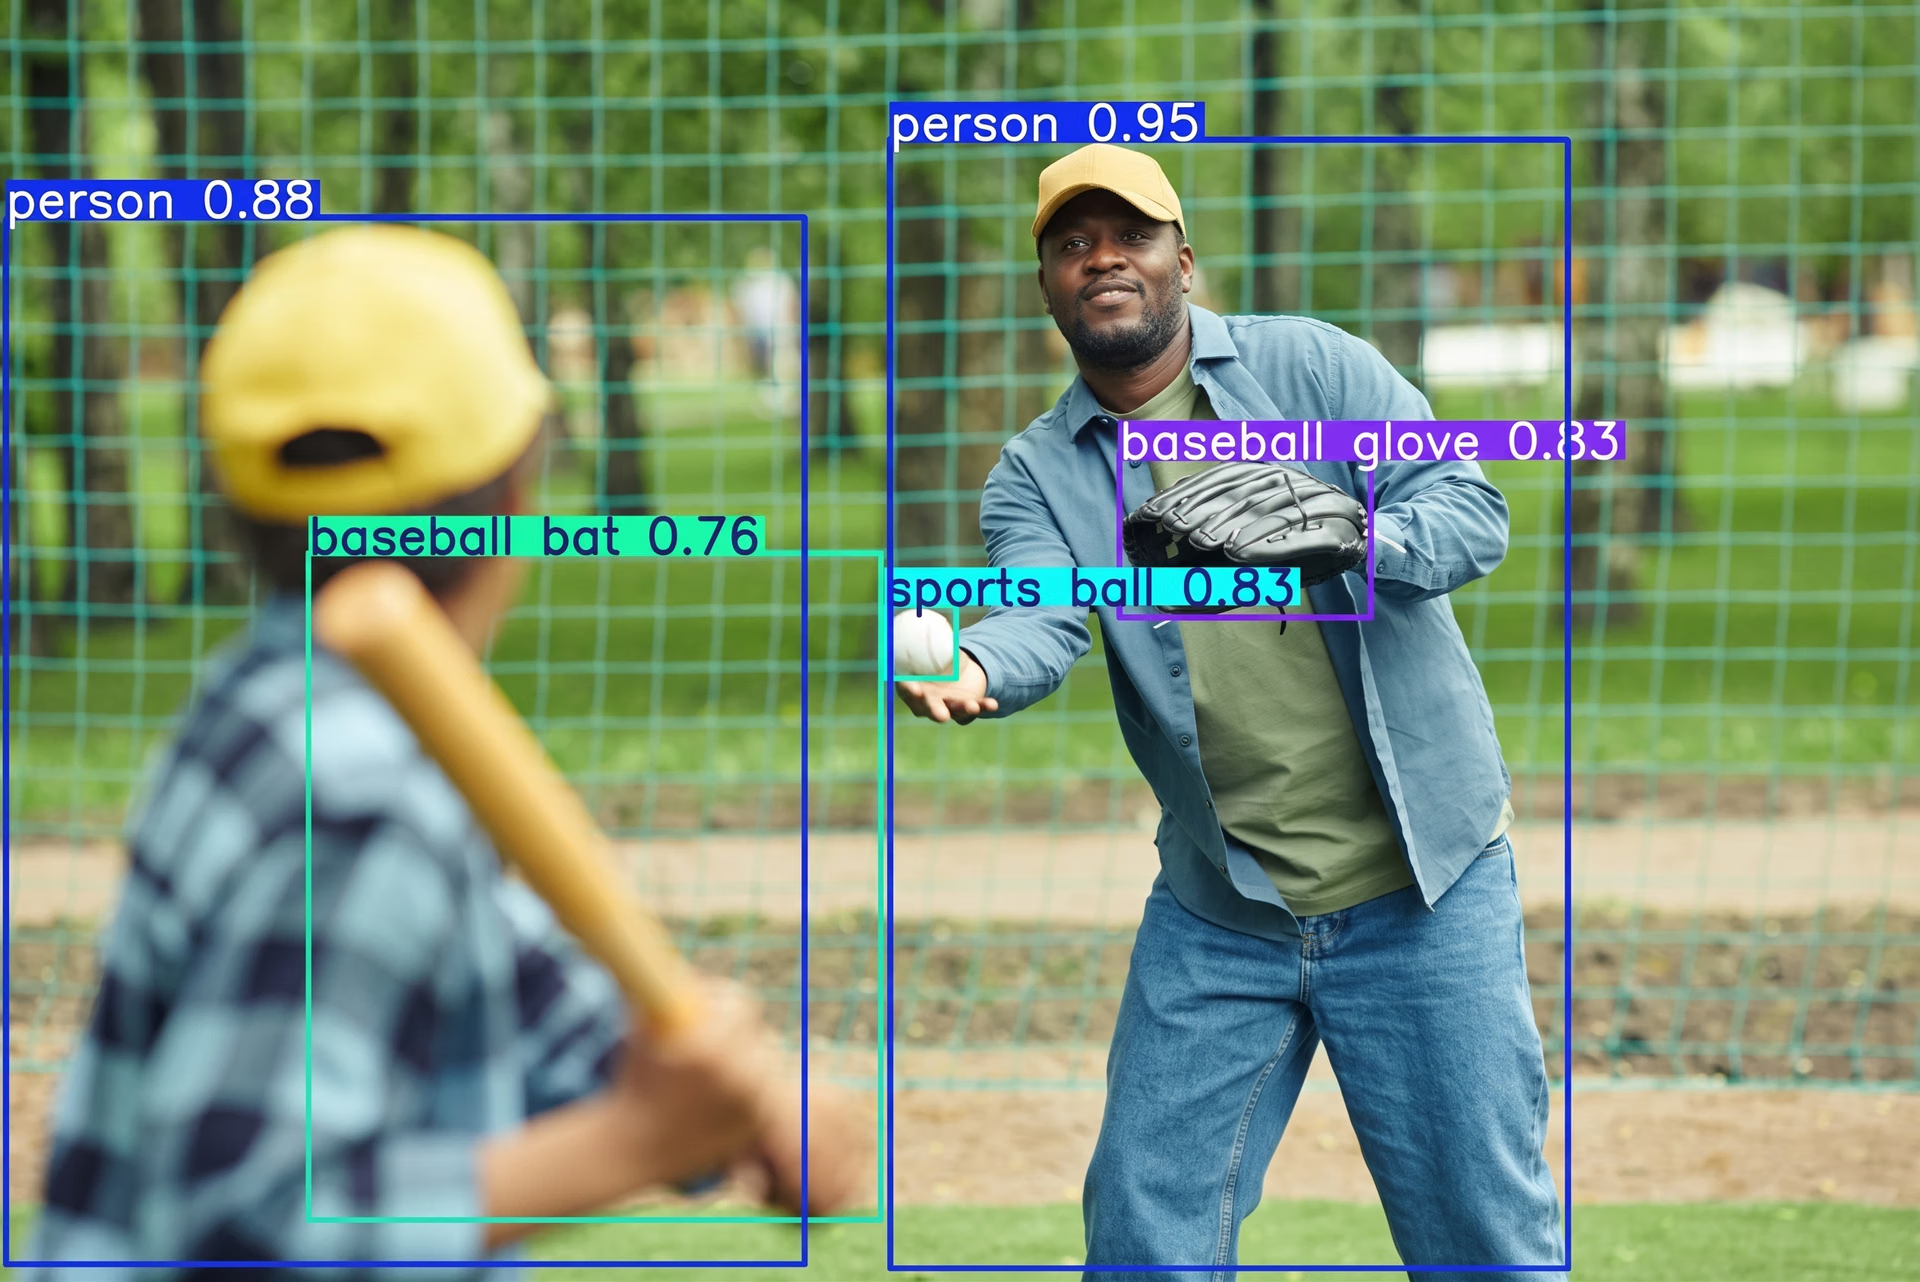
图 1. 边界框可用于标注和定位多个对象。(来源)
多边形或分割掩码#
多边形也称为分割掩码,相比边界框更进一步,能够在像素级别标注对象。它们不会绘制粗略的矩形,而是精确描绘图像中每个对象的形状和边缘,因此适用于需要更细致理解的任务。
例如,在自动驾驶中,分割掩码可用于语义分割等任务,为每个像素分配道路或天空等类别;也可用于实例分割,分别识别车辆或行人等单个对象。
它们还可用于背景移除等任务,例如需要将人物等物体从图像的其余部分中分离出来。
关键点#
关键点用于标记物体上的特定位置,例如人体关节或动物身体部位。识别这些点后,模型就能理解物体的结构,以及各部分之间的相对位置。
在计算机视觉中,这称为姿态估计,目标是识别这些关键点的位置并了解它们之间的关系。随着时间推移跟踪这些点,就能分析运动和姿势变化。
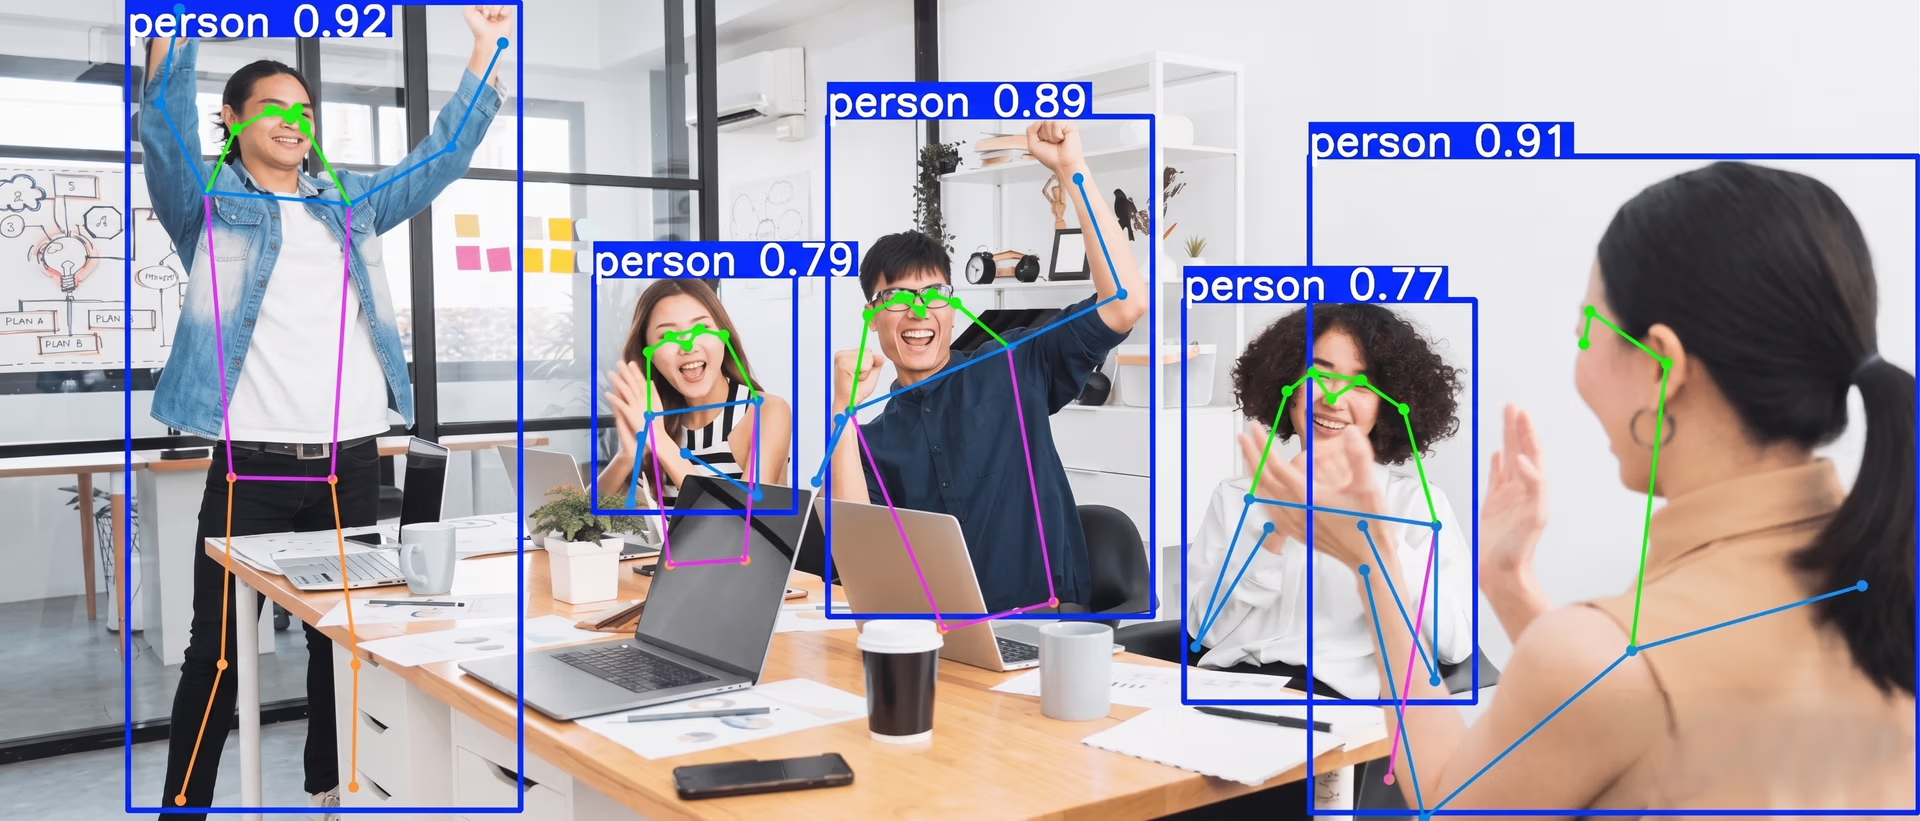
图 2. 关键点标注可用于标记人体姿态估计中的关节。(来源)
一个常见示例是在视频中标记身体关节,以分析人体运动。通过关注这些关键点,模型可以捕捉人体姿势及其随时间的变化。
定向边界框 (OBB)#
图像中的物体并非总是完美对齐。在许多现实场景中,物体可能是倾斜或旋转的,也可能从不同角度呈现。
在这些情况下,标准边界框往往效果不佳,因为它们可能包含不必要的背景,或无法紧密贴合物体。定向边界框通过使用与物体方向对齐的旋转矩形来解决这一问题,从而生成更紧凑、更准确的标注。
这种方法用于定向边界框 (OBB) 检测,模型会同时识别物体的位置和朝向。一个例子是航空影像,其中的建筑物、船只或车辆等物体通常以不同角度呈现。旋转框可以更轻松地捕捉它们在场景中的实际形状和方向。
分类标签#
分类标签采用了不同于其他标注方法的方式:为整张图像分配单个标签,而不是标记特定物体或区域。当目标是识别图像中有什么,而不关注其出现位置时,就会使用这种方法。
例如,可以根据图像的整体内容将其标记为“猫”或“狗”。因此,在只需对图像进行高层次理解的任务中,图像分类非常有用。
传统标注工具的局限#
许多传统标注工具依赖多个步骤和彼此割裂的工作流。AI 开发团队往往需要在用于标注、存储和验证的不同平台之间切换,这会拖慢 AI 项目的进度。
大多数工具仅支持有限的标注类型和数据类型,因此团队最终不得不分别使用不同工具处理边界框、分割和关键点。这样的碎片化配置很难管理,对刚接触计算机视觉的团队来说尤其如此。
人工工作量是另一项重大挑战。标注单张图像可能只需几分钟,但处理大型数据集很快就会变得耗时,尤其是相似图像涉及重复任务时。
随着数据集不断增长,团队还必须管理文件、跟踪数据集版本,并确保标注的一致性。这会增加工作量,让团队花更多时间管理数据,花更少时间提升模型性能。
更高效的方法是在 Ultralytics Platform 中使用 AI 辅助标注。该平台利用 AI 生成并完善标签,在减少人工工作量的同时提升速度和一致性,并在一个统一环境中整合数据集管理、标注、模型训练、部署和监控。
Ultralytics Platform 如何支持标注流程#
Ultralytics Platform 将标注与计算机视觉工作流的其他环节直接连接起来,从而简化标注流程。团队无需依赖彼此独立的工具,即可在同一环境中处理数据、标注和模型。
它支持多种计算机视觉任务,包括目标检测、图像分类、实例分割、姿态估计和定向边界框检测。
在这一配置中,团队可以通过多种方式进行标注。团队可以手动标注数据以获得全面控制,使用 SAM 驱动的智能标注进行交互式点选标注,或使用 YOLO 驱动的智能标注自动生成标注,再进行检查和完善。这种灵活性让团队更轻松地处理不同的数据集和标注需求。
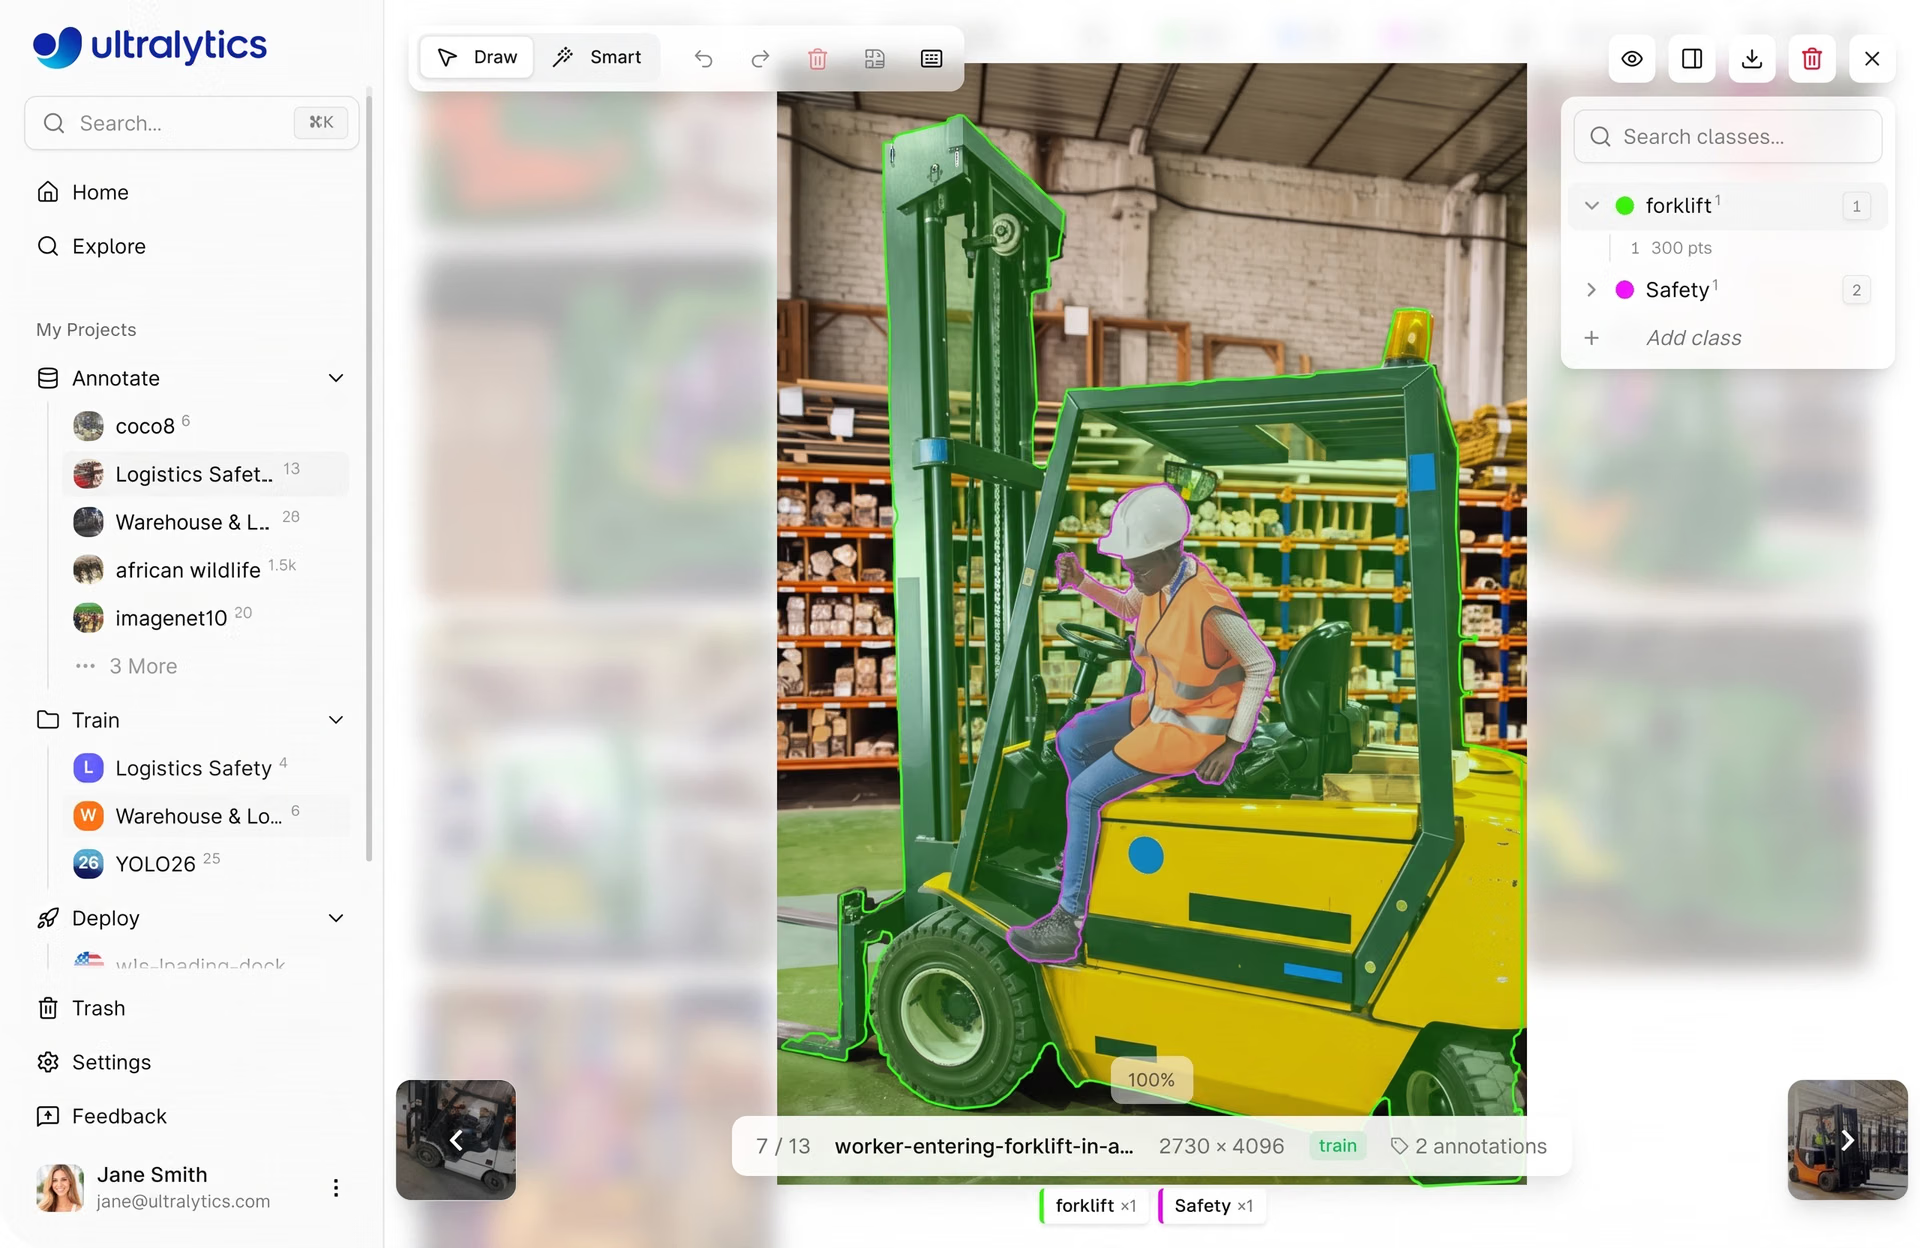
图 3. Ultralytics Platform 中的标注界面(来源)
由于 AI 辅助标注和手动标注与数据集管理及模型训练相集成,团队可以从标注数据无缝过渡到整理数据集和训练模型。这样可以让工作流保持有序,无需在工具之间切换或重新调整标注格式。
该平台还支持 Ultralytics YOLO 模型,例如 Ultralytics YOLO11 和 Ultralytics YOLO26,因此标注数据可直接用于训练和测试。这有助于更轻松地发现数据集中的不足、完善标注,并通过持续迭代重新训练模型。
Ultralytics Platform 上 SAM 智能标注的主要功能#
Ultralytics Platform 上由 SAM 驱动的智能标注旨在加快目标检测、实例分割和定向边界框 (OBB) 任务的标注速度。
该平台提供多个 SAM 模型版本,包括 SAM 2.1 Tiny、SAM 2.1 Small、SAM 2.1 Base、SAM 2.1 Large 和 SAM 3,让用户可以根据需要在速度和准确率之间进行选择。
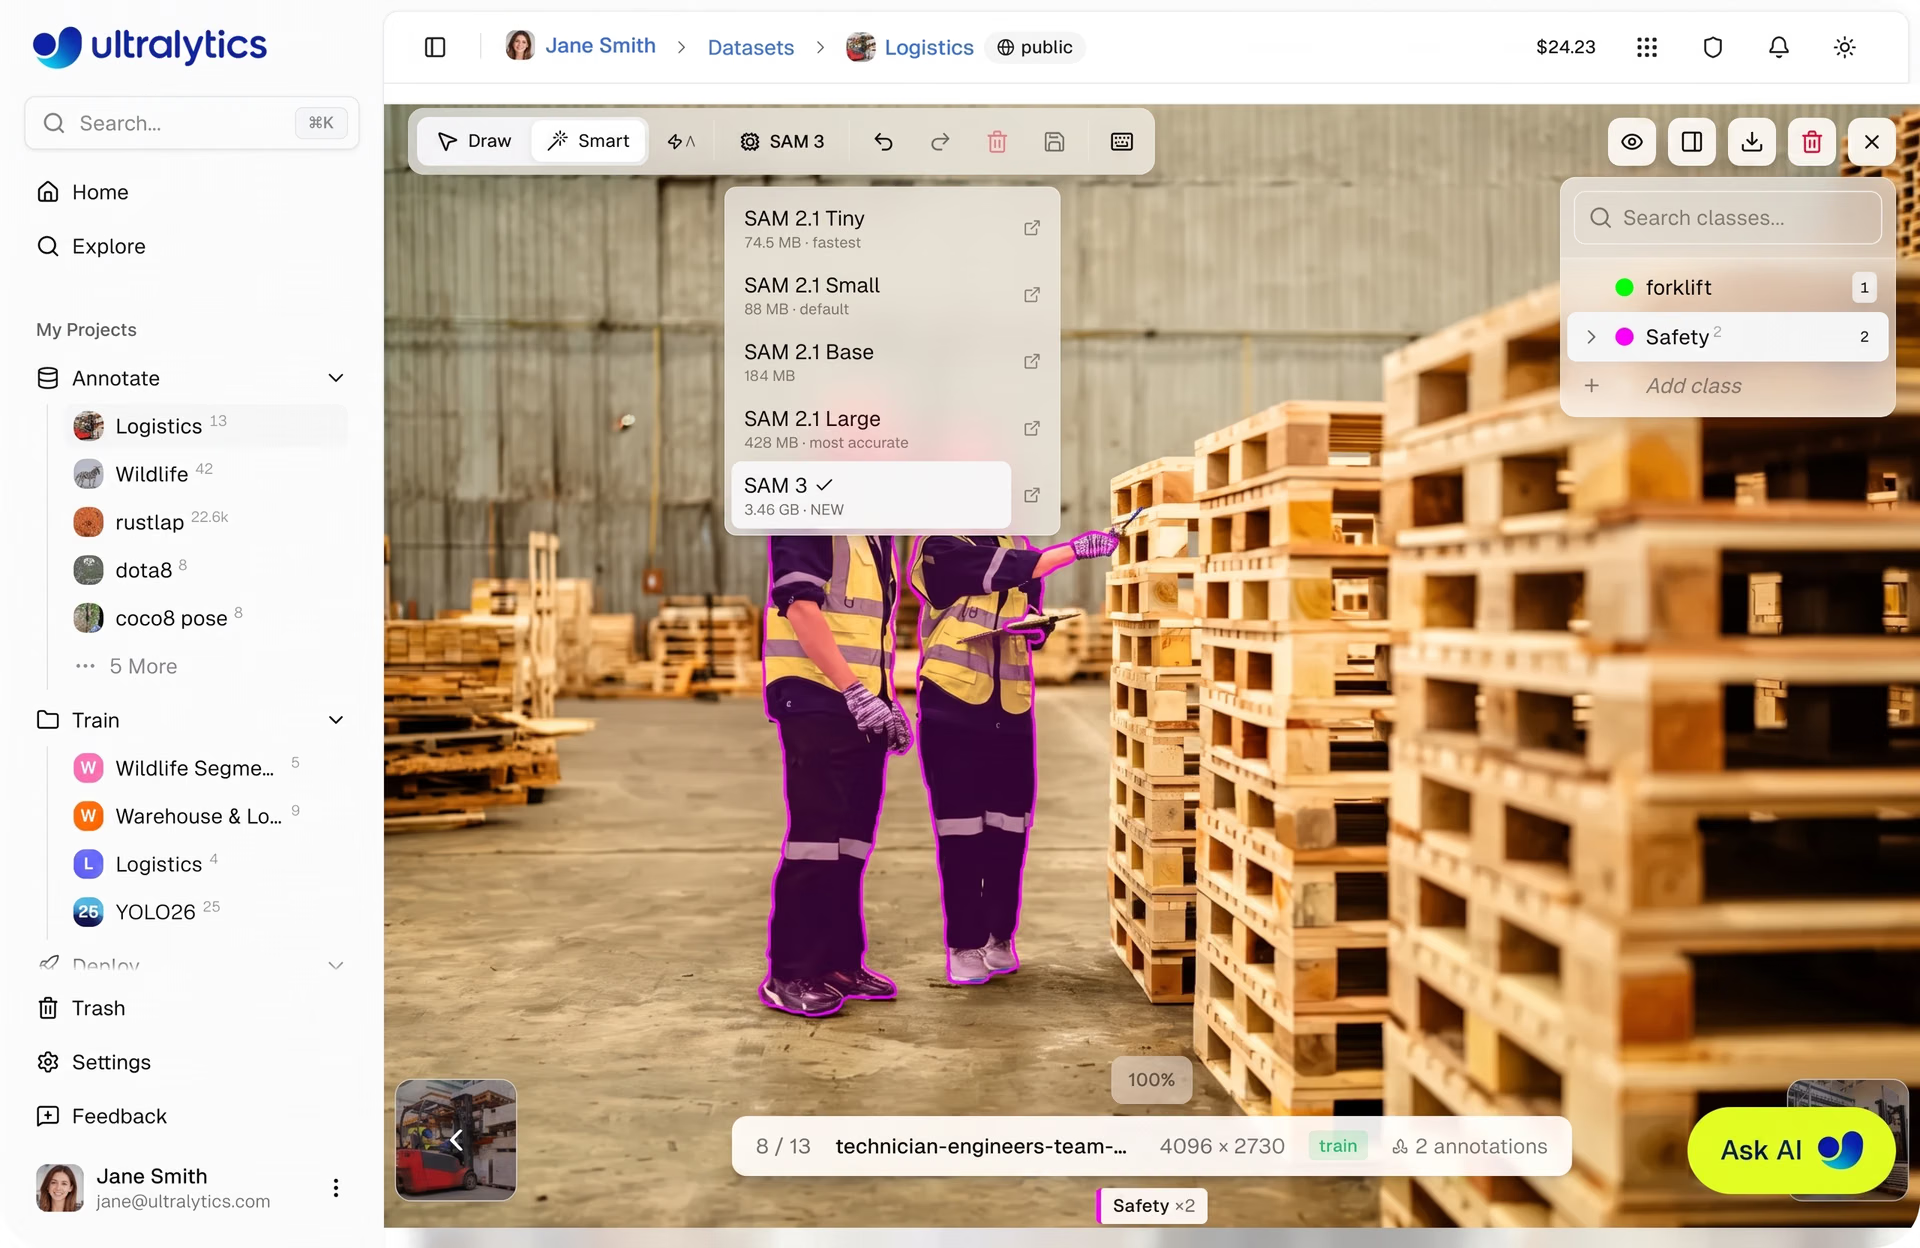
图 4. Ultralytics Platform 上由 SAM 驱动的智能标注(来源)
Tiny 和 Small 等较小的模型速度更快,非常适合快速标注工作流;Large 和 SAM 3 等较大的模型则能在更复杂的场景中提供更高的准确率。切换模型后,标注行为会立即更新。
在标注编辑器中选择 SAM 模型后,人工标注人员可以进入智能模式开始标注。无需手动绘制形状,只需通过简单的点选输入来引导模型。
单击鼠标左键可添加正向点以包含某个区域,单击鼠标右键则可添加负向点以排除不需要的区域。模型会根据这些输入实时生成精确的掩码。
要加快工作流,可以启用自动应用模式。启用后,每次单击都会自动生成并保存标注,无需手动确认。对于更复杂的物体,标注人员可以按住 "Shift" 在应用掩码前放置多个点,也可以关闭自动应用模式,自由添加点,然后按 "Enter" 应用掩码。
了解 Ultralytics Platform 上的 YOLO 智能标注#
与 SAM 驱动的智能标注类似,Ultralytics Platform 上的 YOLO 智能标注利用 AI 加快标注流程。它不通过单击来引导模型,而是使用模型预测自动生成标注。
这种方法支持目标检测、实例分割和定向边界框 (OBB) 标注等任务。它专门适用于 Ultralytics YOLO 模型,包括 Ultralytics 提供的预训练模型和自定义训练的 YOLO 模型。
在标注编辑器中,标注人员可以进入智能模式,从模型选择器中选择 YOLO 模型,然后单击“预测”。模型选择器只会显示与当前数据集任务匹配的 YOLO 模型,确保生成的标注兼容。
模型会分析图像并根据预测生成标注,然后将其直接添加到图像中。如果预测结果与同类别的现有标注重叠,且重叠程度超过设定阈值,系统会自动跳过重复检测,从而帮助保持标签整洁一致。
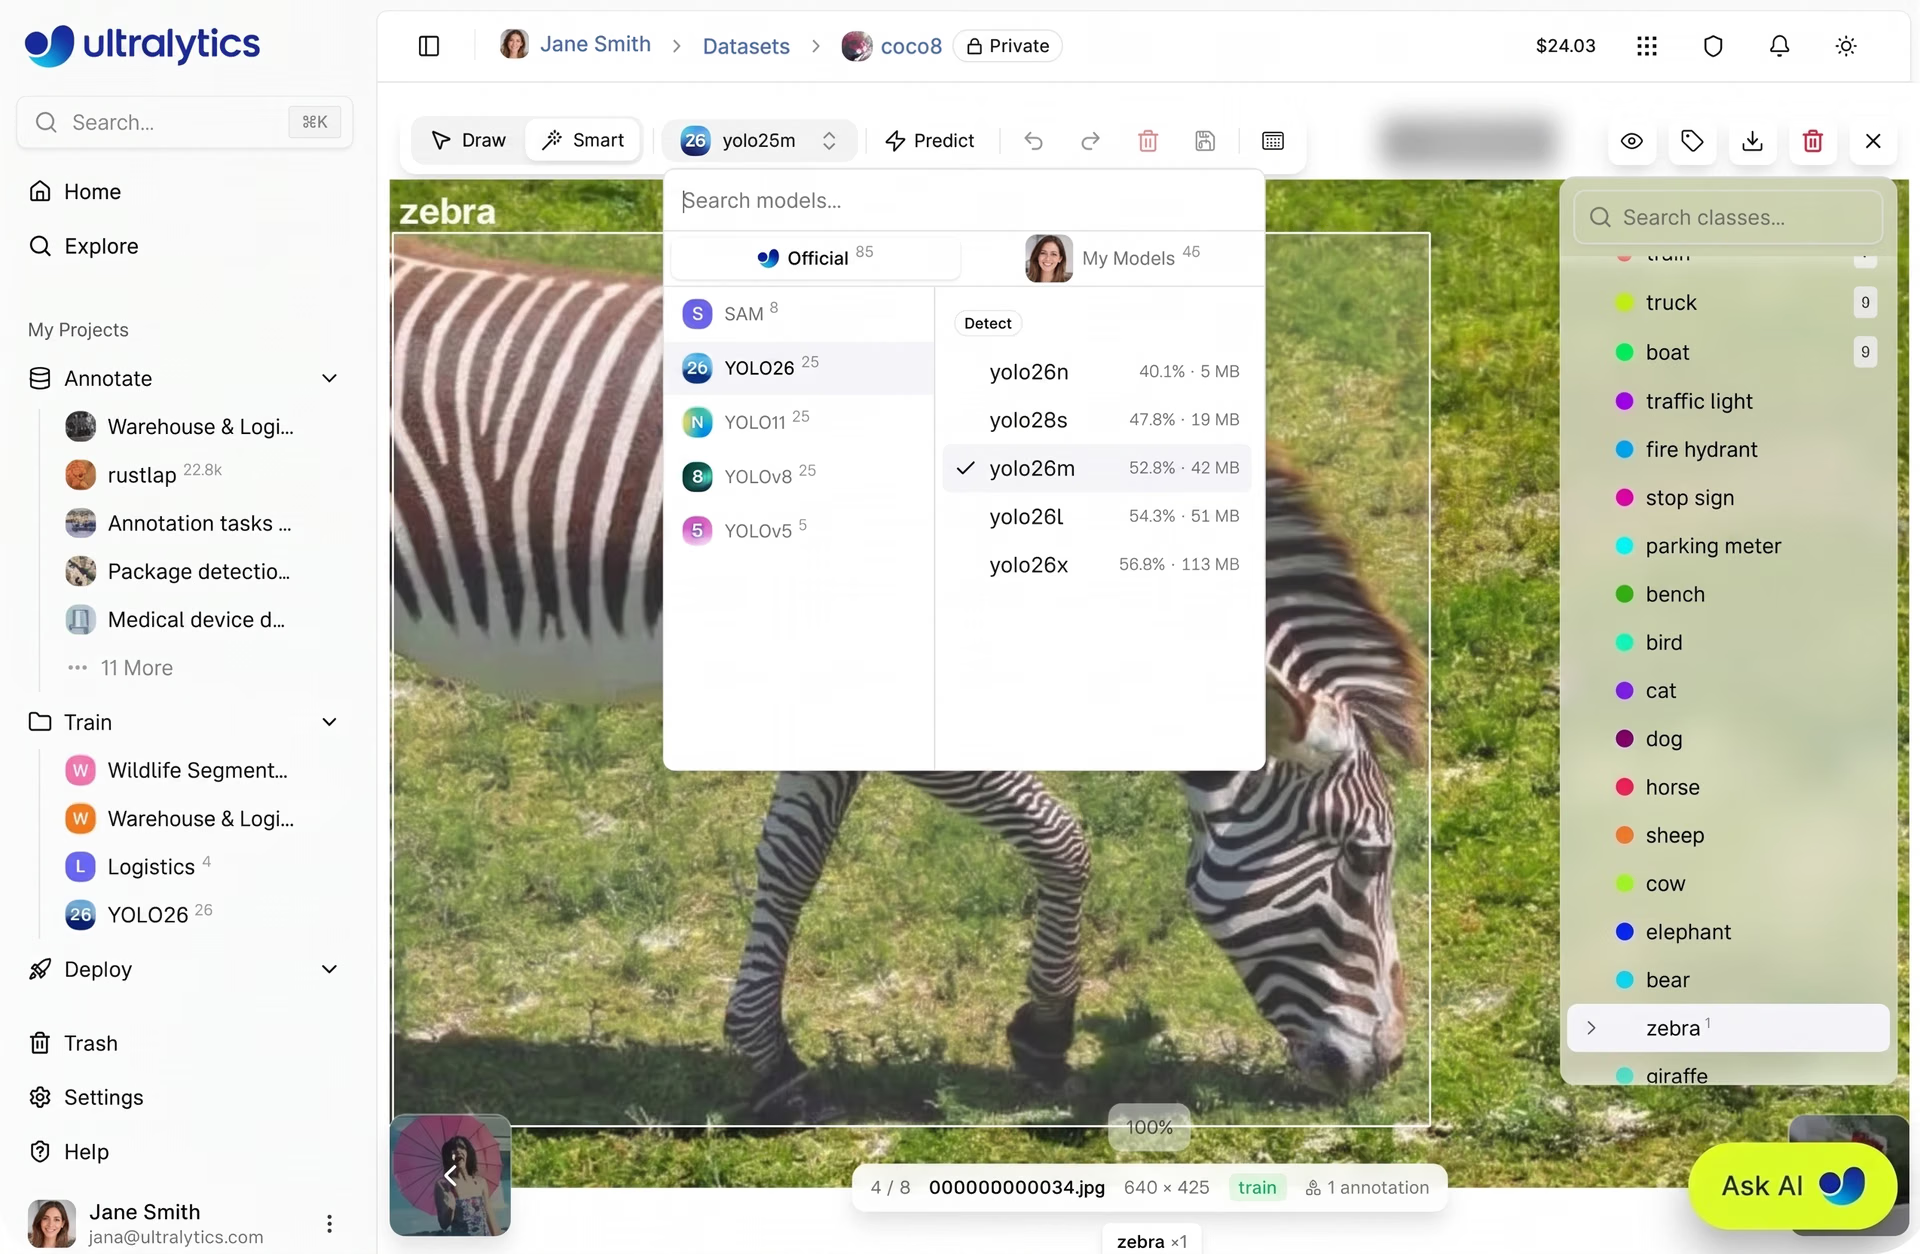
图 5. 由 Ultralytics YOLO 模型支持的 Ultralytics Platform 智能标注(来源)
生成预测后,人工参与式标注人员可以根据需要检查、调整或删除预测结果。团队可以先使用模型生成的标注,再对其进行完善,而不必全部手动标注,因此能够更轻松地快速标注大型数据集。
随着时间推移,团队可以重复使用改进后的 YOLO 模型来生成更好的预测结果,从而支持迭代式自动标注工作流。
在实际工作流中应用 AI 辅助标注#
接下来,我们将通过示例介绍 Ultralytics Platform 如何在实际应用场景中支持数据标注。
自动驾驶中的分割#
集成计算机视觉模型的自动驾驶车辆依赖经过良好标注的视觉数据来实时了解周围环境。使用这些数据训练的模型可以检测并分割车辆、行人、交通标志和道路边界。
分割任务需要精确到像素级的边界,因此标注至关重要,也很耗时。手动标注大量传感器数据很快就会成为瓶颈,尤其是在复杂的驾驶场景中。
Ultralytics Platform 通过结合 SAM 和 YOLO 模型进行 AI 辅助标注,简化了这一流程。SAM 驱动的智能标注可通过快速点选实现精准掩码分割,而 YOLO 模型则可用于自动生成图像标注。
这两种方法相结合,让处理包含重叠物体的复杂场景变得更加容易。
由于标注与模型训练直接关联,更新后的大规模数据集可以立即用于重新训练和评估模型。这样,团队就能持续提升性能,并更高效地适应新的驾驶条件。
提升制造业的质量保证系统#
在制造业中,保持质量控制的一致性取决于能否在生产过程中准确检测缺陷。计算机视觉模型通常用于实时识别问题,但模型性能取决于训练数据能否充分反映实际生产条件。
原材料、机器设置或照明等制造环境的变化,可能会带来原始训练数据中未包含的新型和罕见缺陷。这会导致模型已学习的内容与生产线上实际出现的情况之间产生差距。
为了保持一致,数据集需要定期使用高质量的内部标注进行更新。Ultralytics Platform 让团队能够轻松更新标注,并随着新缺陷模式出现而扩充数据集。随后,这些更新后的数据集可用于重新训练模型,帮助团队更快地适应不断变化的生产条件。
建筑工地监控与安全#
建筑工地是动态环境,有多个团队同时作业、设备不断移动,场地布局也持续变化。在这种条件下,保障安全有赖于清晰且经过良好标注的视觉数据。
准确的标注可以提升数据质量,帮助 AI 系统在各种工地条件下识别工人、设备、安全装备和潜在风险,包括人员密集的场景、不断变化的背景和光照条件。
Ultralytics Platform 通过简化标注的更新和完善来支持这一工作,让标注能够随着工地条件变化而调整。出现新图像时,团队可以将其采集并添加到数据集中,使数据集始终贴合真实场景。
要点#
高质量标注对于构建可靠的计算机视觉和 AI 模型至关重要,但传统工作流往往会拖慢团队进度。Ultralytics Platform 通过自动化标注工具和可扩展工作流简化了这一过程。因此,团队可以更快地从数据推进到模型,同时保持准确性和一致性。
欢迎访问不断壮大的社区和 GitHub 代码库,进一步了解计算机视觉。如果你想构建视觉解决方案,可以查看我们的许可选项。浏览我们的解决方案页面,进一步了解计算机视觉在制造业中的应用和 AI 在医疗健康领域的应用所带来的益处。








