比较 Ultralytics YOLO26 与其他 Ultralytics YOLO 模型的姿态估计性能
了解 Ultralytics YOLO26 如何改进姿态估计,包括更好地支持非人类关键点、更快的收敛速度、更出色的遮挡处理能力,以及高效的实时部署。
观察一个人的姿势时,你很容易注意到对方是否弯腰驼背、身体前倾或站得笔直。人类可以迅速理解身体各个部位之间的关系。
这是我们在日常生活中解读动作和肢体语言时与生俱来的能力。然而,机器并不会自动具备这种视觉理解能力。要教会系统识别动作和结构,需要先进的深度学习和计算机视觉技术,让系统能够有意义地解读图像。
具体来说,姿态估计是一种视觉 AI 技术,能让计算机视觉模型建立类似的理解能力。模型不只是检测图像中的物体,还会预测代表重要结构标志点的关键点。
这些关键点可以对应人体关节、动物肢体、机器部件,甚至球场角点等固定点。通过识别和跟踪这些点,系统可以用结构化、可测量的方式理解位置、对齐状态和运动。
随着姿态估计应用于更多真实场景,模型必须更有效地处理非人类关键点、复杂场景和定制数据集。例如,Ultralytics YOLO26等先进模型支持姿态估计等计算机视觉任务,并在早期 YOLO 姿态模型的基础上,加入旨在提升灵活性和整体性能的架构与训练改进。
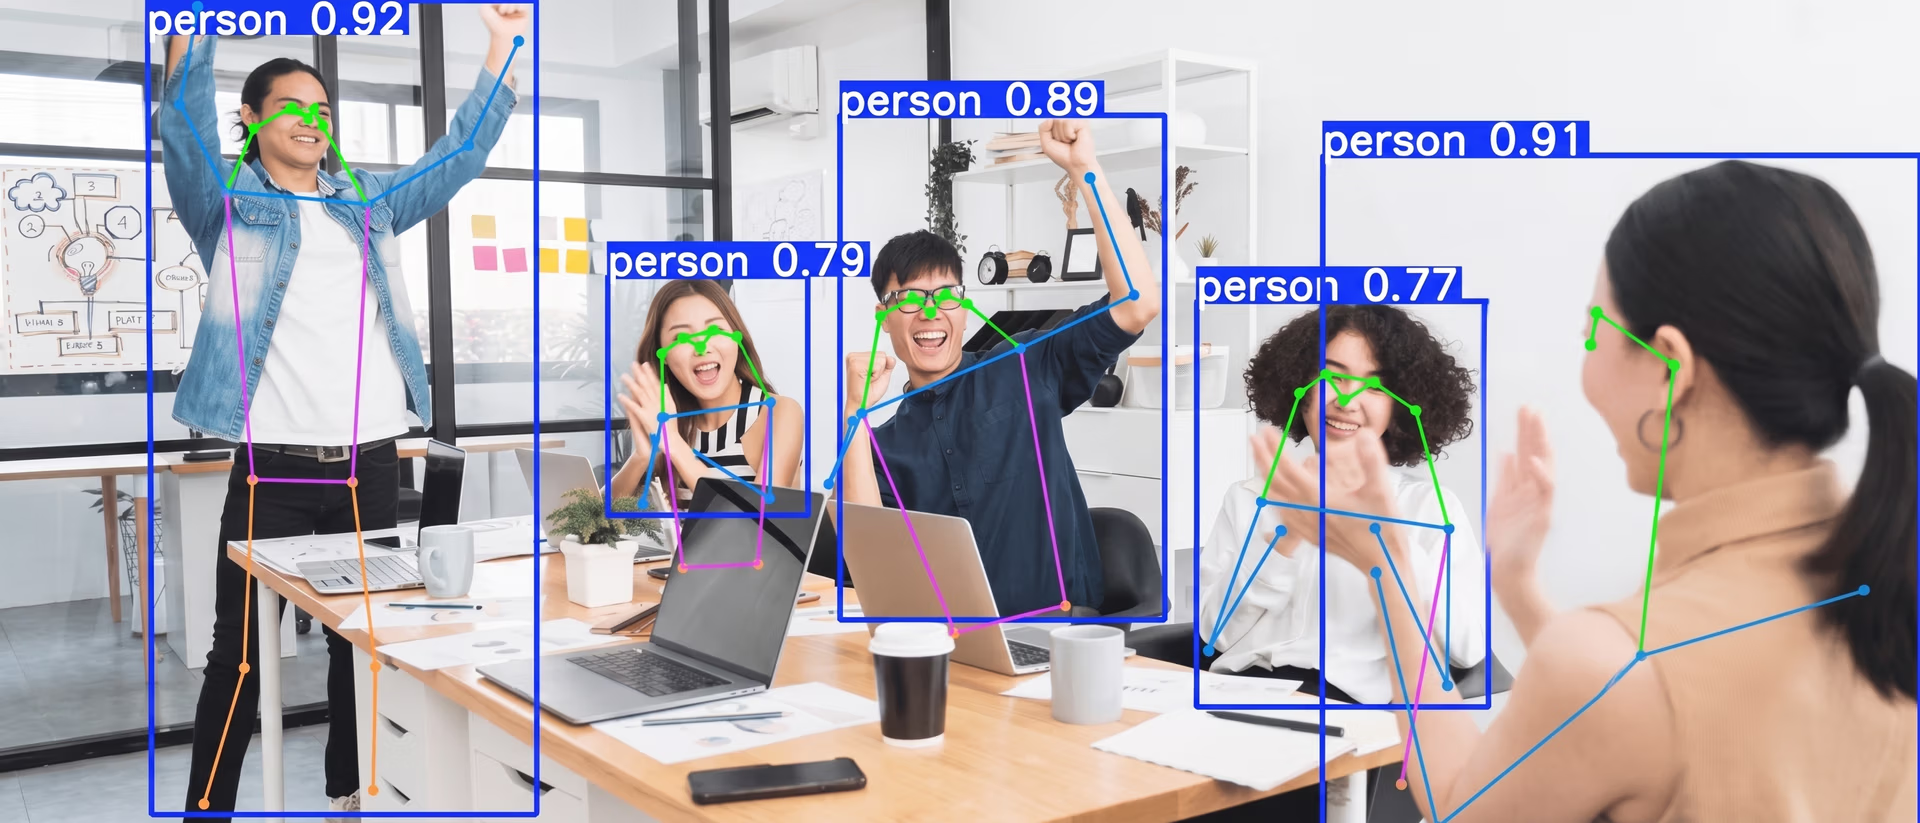
图 1. YOLO 支持的姿态估计示例(来源)
本文将把 YOLO26-pose 与早期 Ultralytics YOLO 姿态模型进行比较,并探讨它如何提升灵活性、收敛速度以及复杂场景下的性能。现在开始吧!
什么是姿态估计?#
在深入比较 Ultralytics YOLO 姿态模型之前,我们先来详细了解一下姿态估计在计算机视觉领域中的实际含义。
姿态估计是一种用于检测和跟踪图像或视频帧中特定关键点的技术。这些关键点可以代表重要的结构标志点,例如人体关节、动物肢体、机器部件或场景中的固定参考点。
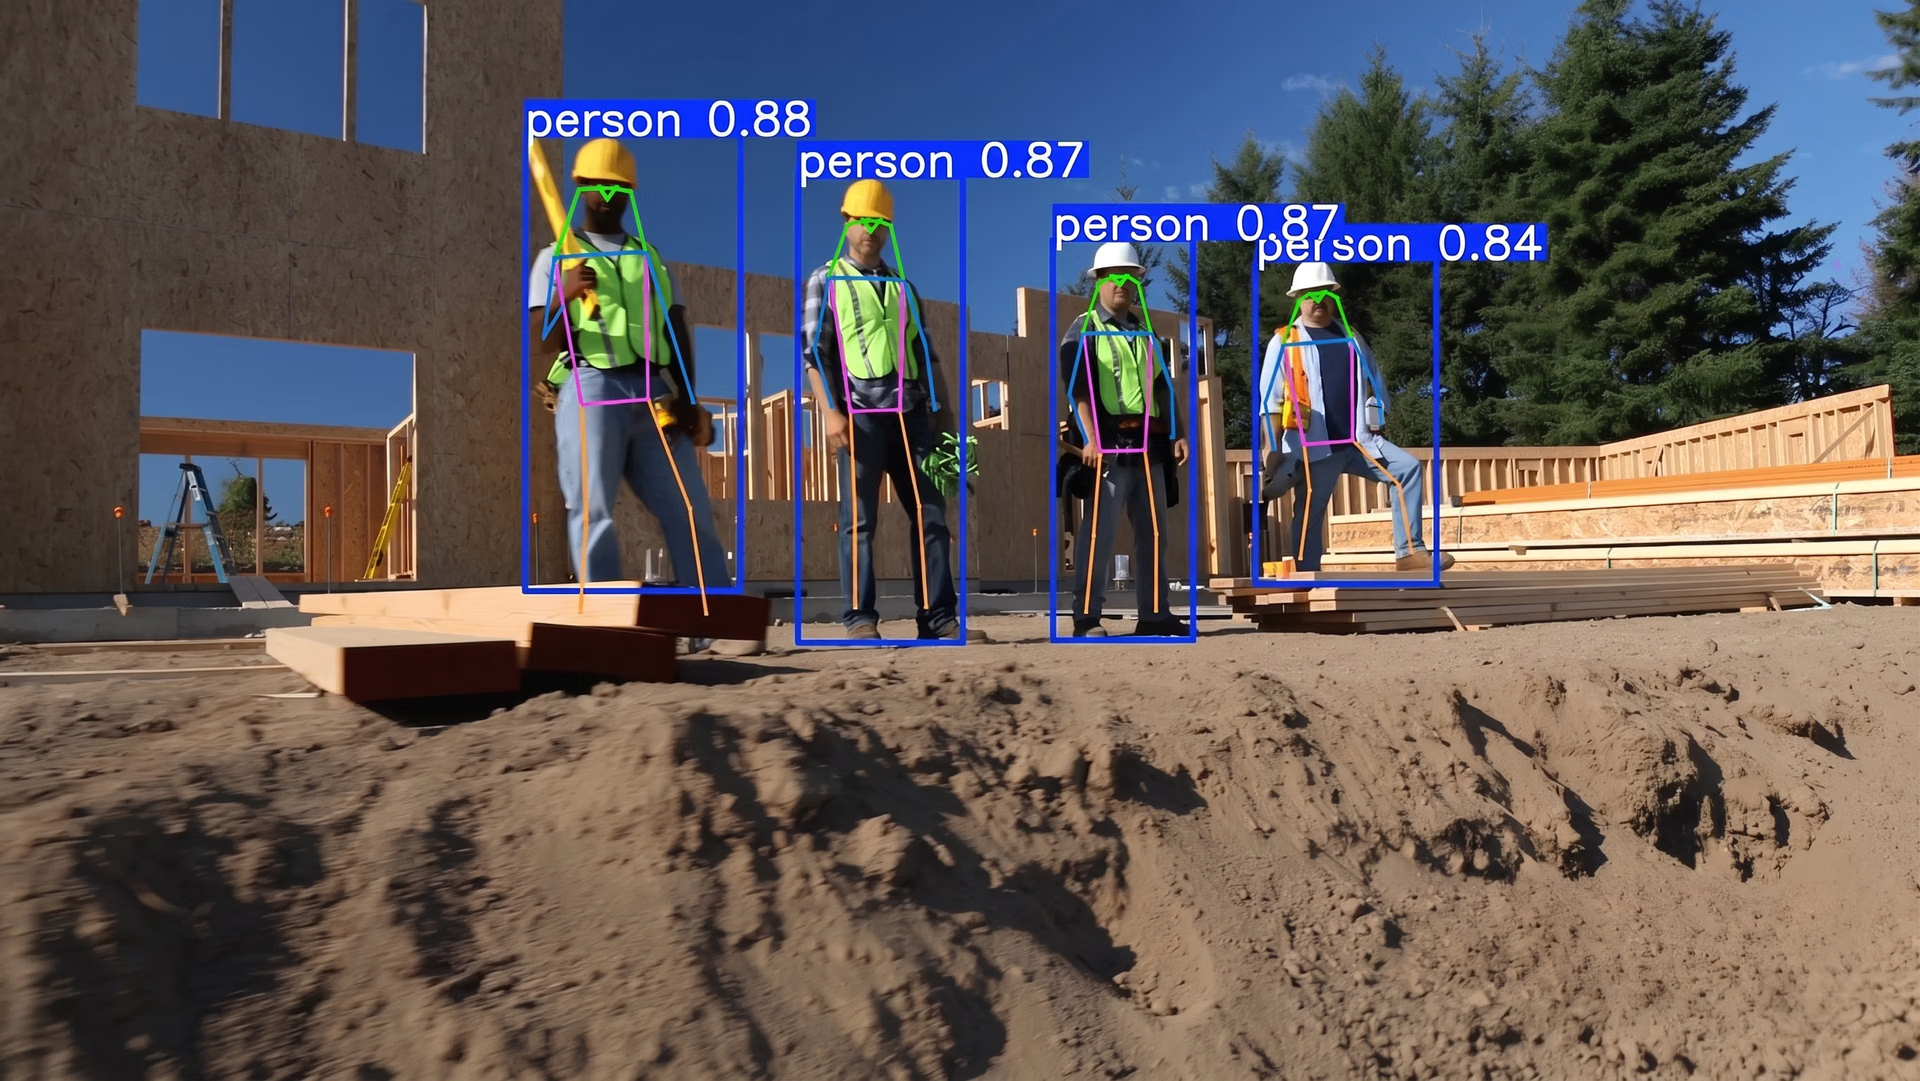
图 2. 使用人体姿态估计来估计工人的姿态(来源)
通过识别这些点的坐标,模型可以了解物体的位置以及物体随时间如何移动。图像分类会为整张图像分配单个标签,目标检测模型则着重为物体绘制边界框;与它们不同,姿态估计能提供有关结构和运动的更详细空间信息。
Ultralytics YOLO26-pose 概述#
YOLO26-pose 提供多种模型变体或尺寸,包括 YOLO26n-pose 等轻量级选项,以及 YOLO26m-pose、YOLO26l-pose 和 YOLO26x-pose 等更大型号。这样,团队就能根据硬件和性能需求,在速度与准确度之间选择合适的平衡。
Ultralytics 还提供使用 COCO 等大型通用数据集预训练的姿态模型,具体来说,就是使用 COCO-Pose(COCO 关键点)标注进行人体姿态估计,因此你不必从头开始训练。在大多数情况下,团队会使用自己的数据集微调这些模型,让模型适应特定的关键点、布局或环境。
这通常需要准备自定义标注文件,以结构化格式定义关键点坐标和类别标签。这些标注会将关键点映射到每张图像中的特定像素坐标,让模型在训练期间学会精确的空间关系。
使用预训练模型可以加快训练速度、减少数据需求,并帮助项目更高效地投入生产。
人体姿态估计的真实应用#
以下是姿态估计发挥重要作用的一些真实应用场景:
- 医疗保健与康复:临床医生可以使用姿态模型评估体态、监测康复进展,并分析物理治疗过程中的动作模式。
- 自主系统:无人机和智能摄像头可以利用姿态信息,更好地理解动态场景中物体的朝向和运动。
- 工作场所安全:组织可以监测身体姿势和重复动作,帮助识别潜在的安全风险。
- 健身与个人训练:健身应用利用姿态估计跟踪锻炼动作、计数重复次数,并在健身教程中实时反馈体态和动作情况。
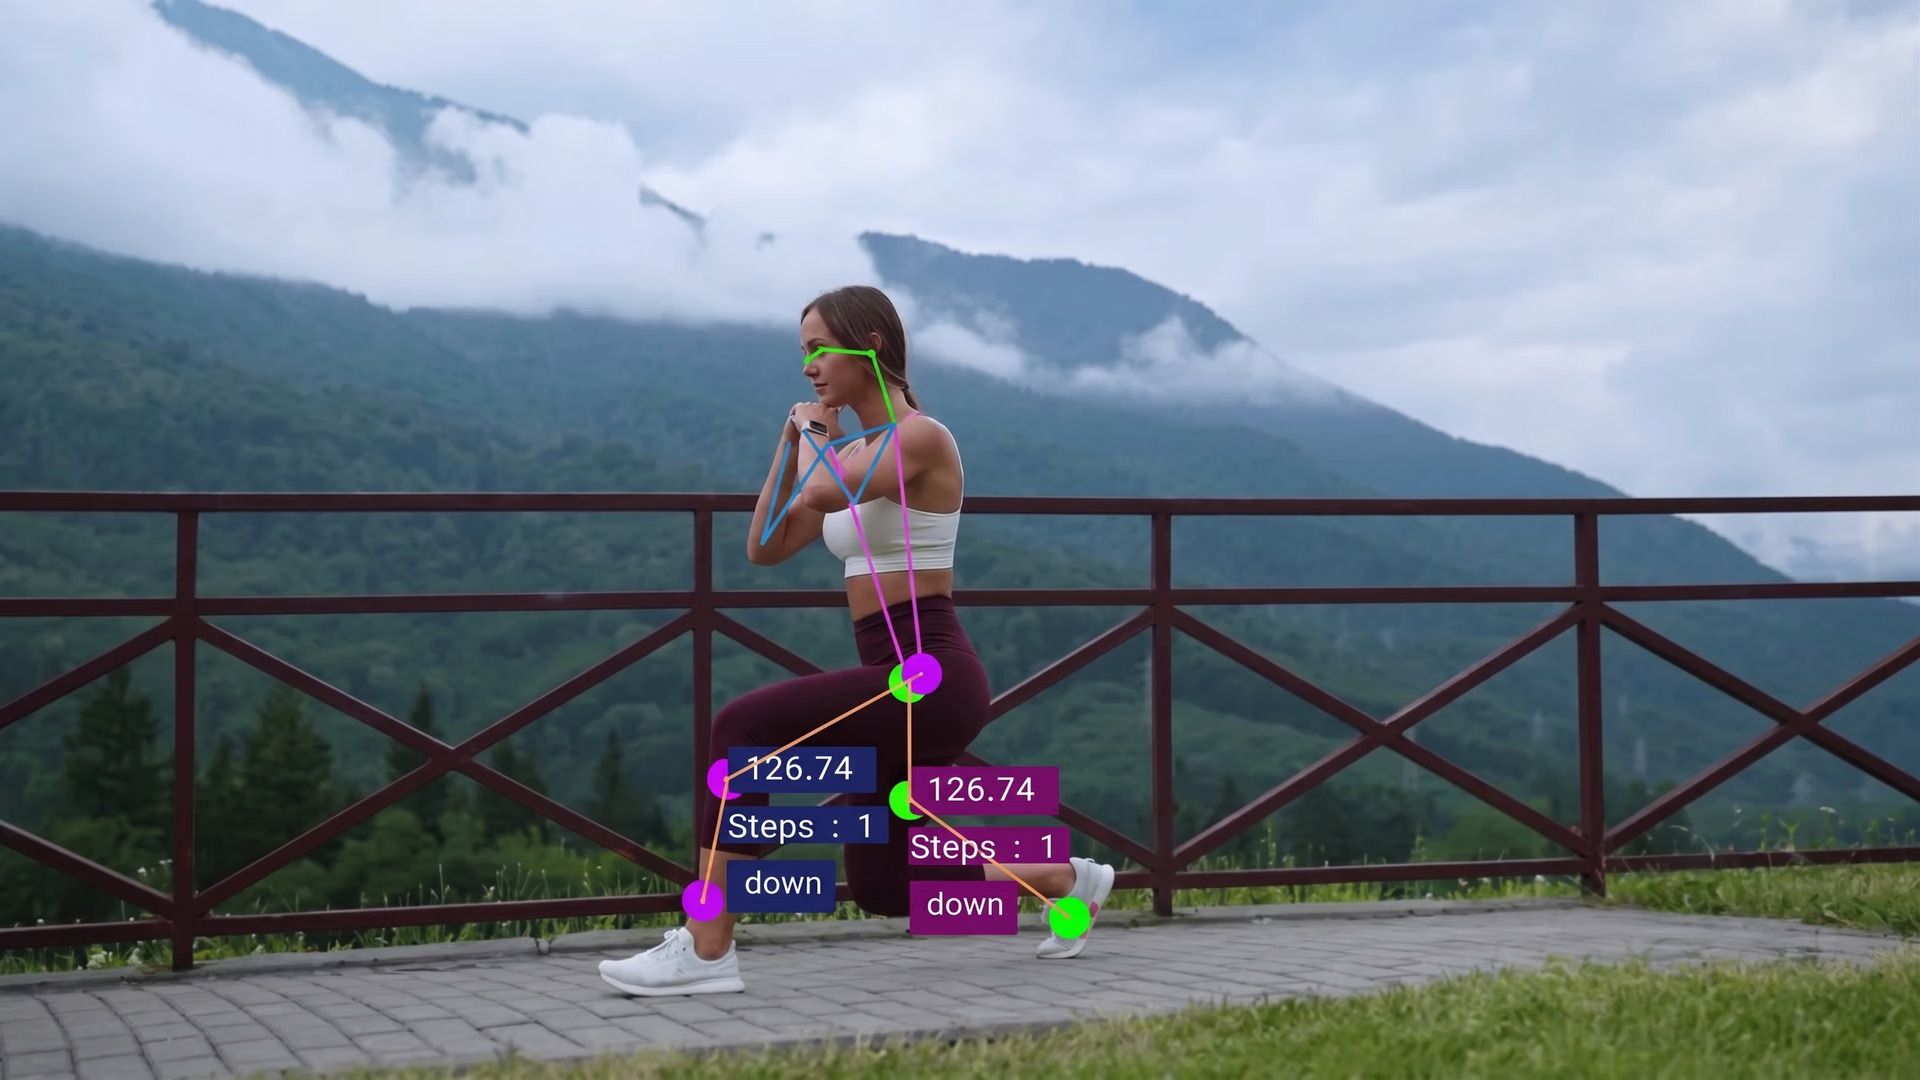
图 3. 姿态估计有助于在运动过程中跟踪关键身体点。(来源)
探索 Ultralytics YOLO26 对姿态估计的支持#
Ultralytics YOLO26 在早期 Ultralytics YOLO 模型的基础上进行了更新,旨在让训练和部署更加实用。
与之前的版本一样,它在统一框架中支持姿态估计。主要区别在于,Ultralytics YOLO26 的设计目标是在更广泛的真实应用场景中实现更高的灵活性和稳定性。
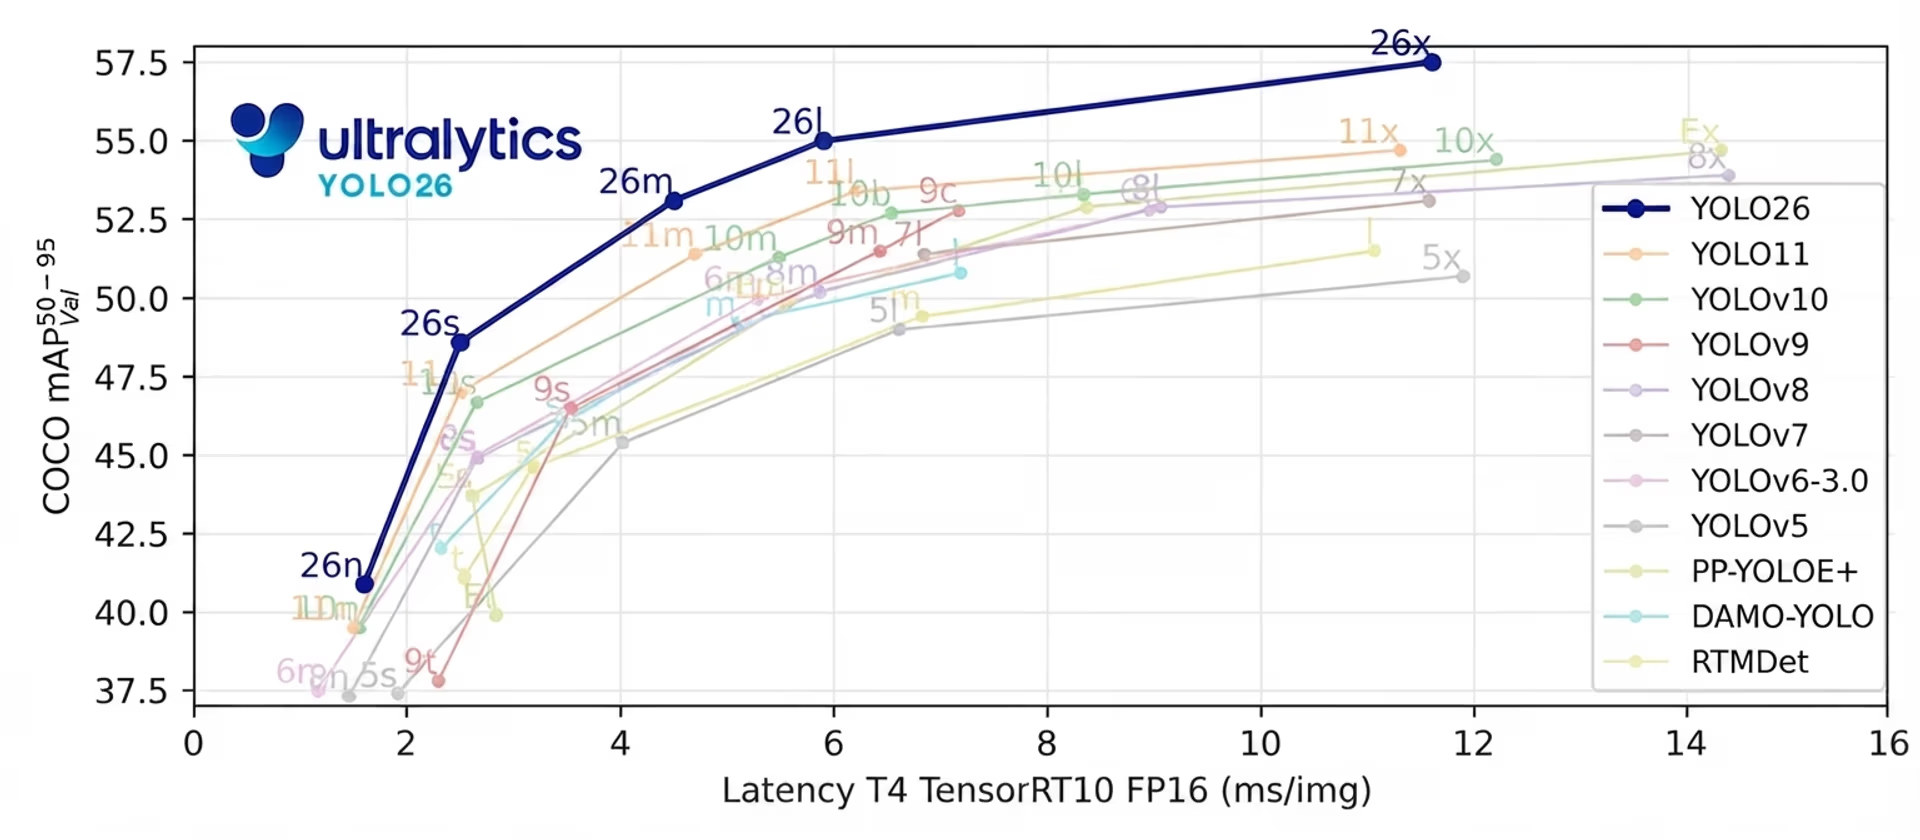
图 4. YOLO26 基准测试(来源)
早期的 Ultralytics YOLO 姿态模型很大程度上受到人体姿态数据集的影响,因此旧方法的部分设计针对人体关节结构进行了优化。YOLO26 则去除了这些针对人体的假设。
因此,它更适合处理非人类关键点,例如检测网球场角点或其他定制结构标志点。这一点很重要,因为开箱即用的预训练 Ultralytics YOLO26-pose 模型是在 COCO-pose 等数据集上训练的,并会预测数据集标注中定义的人体关键点。
不过,当团队希望检测不同类型的标志点,例如机器部件、运动场地标记或基础设施上的点位时,通常需要在标注了这些特定关键点的定制数据集上微调模型。
由于 Ultralytics YOLO26 不受人体关节结构假设的限制,它在微调过程中能够更有效地适应。这种灵活性让模型能够更可靠地学习定制关键点布局,从而在具有独特关键点配置的数据集上验证时提升评估指标。
Ultralytics YOLO26-pose 的设计也着眼于提升关键点定位能力,尤其是在物体局部被遮挡或尺寸很小时。在涉及远距离对象、无人机画面或小物体的真实场景中,与早期姿态模型相比,这有助于提高关键点预测的准确度。
另一项重要更新是训练过程中采用了改进的损失函数。损失函数决定了模型在学习过程中如何纠正错误。
说到 Ultralytics YOLO26-pose,这种方法更有效,能帮助模型更快学习,并在更少的轮次内达到较高精度;一个轮次指完整遍历一次训练数据集。
总体而言,YOLO26-pose 在早期 Ultralytics YOLO 姿态模型的基础上,进一步改进了对非人类关键点的支持和训练收敛,同时保留了熟悉的工作流。
YOLO26-pose 与 Ultralytics YOLOv5 对比#
Ultralytics YOLO 模型的最早版本 Ultralytics YOLOv5 主要用于目标检测。虽然 YOLOv5 后来扩展了实例分割支持,但在官方 Ultralytics 框架中并未内置专用的姿态估计头。
需要检测关键点的团队通常依赖单独的实现或自定义修改。Ultralytics YOLO26 将姿态估计作为内置任务,并配备专门用于预测关键点的架构头。
这意味着 Ultralytics YOLO26-pose 模型可以与检测和分割任务一样,在统一工作流中完成训练、验证和部署。对于专注于结构化关键点检测的项目,YOLO26 提供原生姿态支持和任务专用架构,而 YOLOv5 并未开箱即用地提供这些功能。
主要差异:YOLO26-pose 与 Ultralytics YOLOv8-pose#
Ultralytics YOLOv8 在统一的 Ultralytics 框架中引入了原生姿态估计,使你能够使用与检测和分割相同的工作流轻松训练和部署关键点模型。它依赖传统的后处理流程,使用非极大值抑制(NMS),并采用较早的边界框回归和训练损失函数。
Ultralytics YOLO26 在此基础上进行了架构和训练方面的更新,直接影响姿态估计。其中一项重大差异是端到端设计。YOLO26 在推理时无需外部 NMS,从而简化了部署并提高了延迟的一致性,尤其是在 CPU 和边缘设备上。
另一项重要改进体现在训练方法上。Ultralytics YOLO26 引入了 MuSGD 优化器以及更新后的损失策略。对于姿态任务,它集成了残差对数似然估计(Residual Log-Likelihood Estimation),改进了关键点不确定性的建模方式。这些变化结合起来,可以加快收敛并使关键点预测更加稳定,尤其是在复杂或部分遮挡的场景中。
简而言之,Ultralytics YOLOv8-pose 奠定了强大且灵活的基线。YOLO26-pose 在此基础上进一步改进了训练效率和遮挡处理能力,并增强了对真实场景中非人类姿态应用的支持。
YOLO26-pose 与 Ultralytics YOLO11-pose:有哪些改进?#
Ultralytics YOLO11 在 Ultralytics YOLOv8 的基础上改进了主干网络和特征提取层。它减少了 FLOPs,提高了参数效率,同时提升了 mAP 并保持出色的实时性能。对于姿态任务,这意味着更轻量的架构也能带来更高的关键点精度。
YOLO26-pose 沿着这一发展方向继续前进,并实现了更根本的架构转变。简而言之,YOLO11 提升了 YOLOv8 的效率和精度,而 YOLO26 则在此基础上更新架构和训练方法,旨在实现更快的收敛、更稳定的推理,以及在复杂场景中更高的姿态精度。
为什么要开始使用 Ultralytics YOLO26 模型进行姿态估计?#
在了解不同 Ultralytics YOLO 模型之间的差异时,你可能会想知道是否应该切换到 YOLO26-pose。
简短回答:升级很简单。如果你已经在使用 Ultralytics YOLOv8-pose 或 Ultralytics YOLO11-pose,切换到 YOLO26-pose 通常只需更换模型版本,无需重建整个流程。
你可以获得更好的非人类关键点支持、更快的训练收敛速度,以及更出色的遮挡点处理能力,同时继续使用同一个 Ultralytics 框架。对于大多数新的和现有的姿态项目,迁移到 YOLO26-pose 是以最小阻力获得这些改进的直接方式。
此外,YOLO26-pose 完全支持在基于 PyTorch 的 Ultralytics Python 软件包中使用,让训练、验证和部署变得简单。模型可以导出为 ONNX、TensorRT、OpenVINO、CoreML 和 TFLite 等格式,让你无需更改整体工作流,就能更轻松地将模型部署到 GPU、CPU 和边缘设备上。
要点#
Ultralytics YOLO26-pose 让姿态估计更加灵活可靠,尤其适用于非人类关键点或复杂场景。它训练速度更快,处理遮挡的能力更强,并能在不同数据集上提供更一致的结果。对于已经在使用 Ultralytics YOLO 姿态模型的团队,YOLO26 能带来明确的改进,同时无需更改现有工作流。
想进一步了解 AI?欢迎查看我们的社区和 GitHub 代码仓库。浏览我们的解决方案页面,了解机器人领域的 AI和农业中的计算机视觉。查看我们的许可选项,今天就开始使用计算机视觉构建应用吧!









