RTM 是一家总部位于首尔的工业人工智能公司。RTM 的视觉部门为制造现场构建了人工智能驱动的安全监控:工厂车间里现有的摄像头由 Ultralytics YOLO26 模型全天候监控,这些模型能够检测人员、跌倒、危险区域入侵以及火灾或烟雾,并且能够在客户现有的任何电脑上运行,从集成显卡到独立 GPU 均可支持。
监控无人看管的摄像头#
工业事故往往发生在无人关注的盲区。工厂每条产线上都已经安装了摄像头,但没有人能够随时随地盯着每一个视频流。RTM 构建了一个持续执行此任务的系统:每个摄像头通道运行两个 Ultralytics YOLO26 模型,一个专门用于人员检测,另一个用于火灾和烟雾检测,它们将数据输入确定性事件层,从而为工人跌倒和危险区域入侵发出警报。
在过去的六个月里,RTM 的工业安全人工智能解决方案已经在钢铁、电池、化工与塑料、食品以及机器人制造等 21 家制造企业中实现了 7x24 小时部署或正在进行现场评估。连接到现有闭路电视后,该系统可以检测工人何时进入危险区域或跌倒,并通过内部系统触发警报,或者通过 PLC 集成直接控制连接的工厂设备。
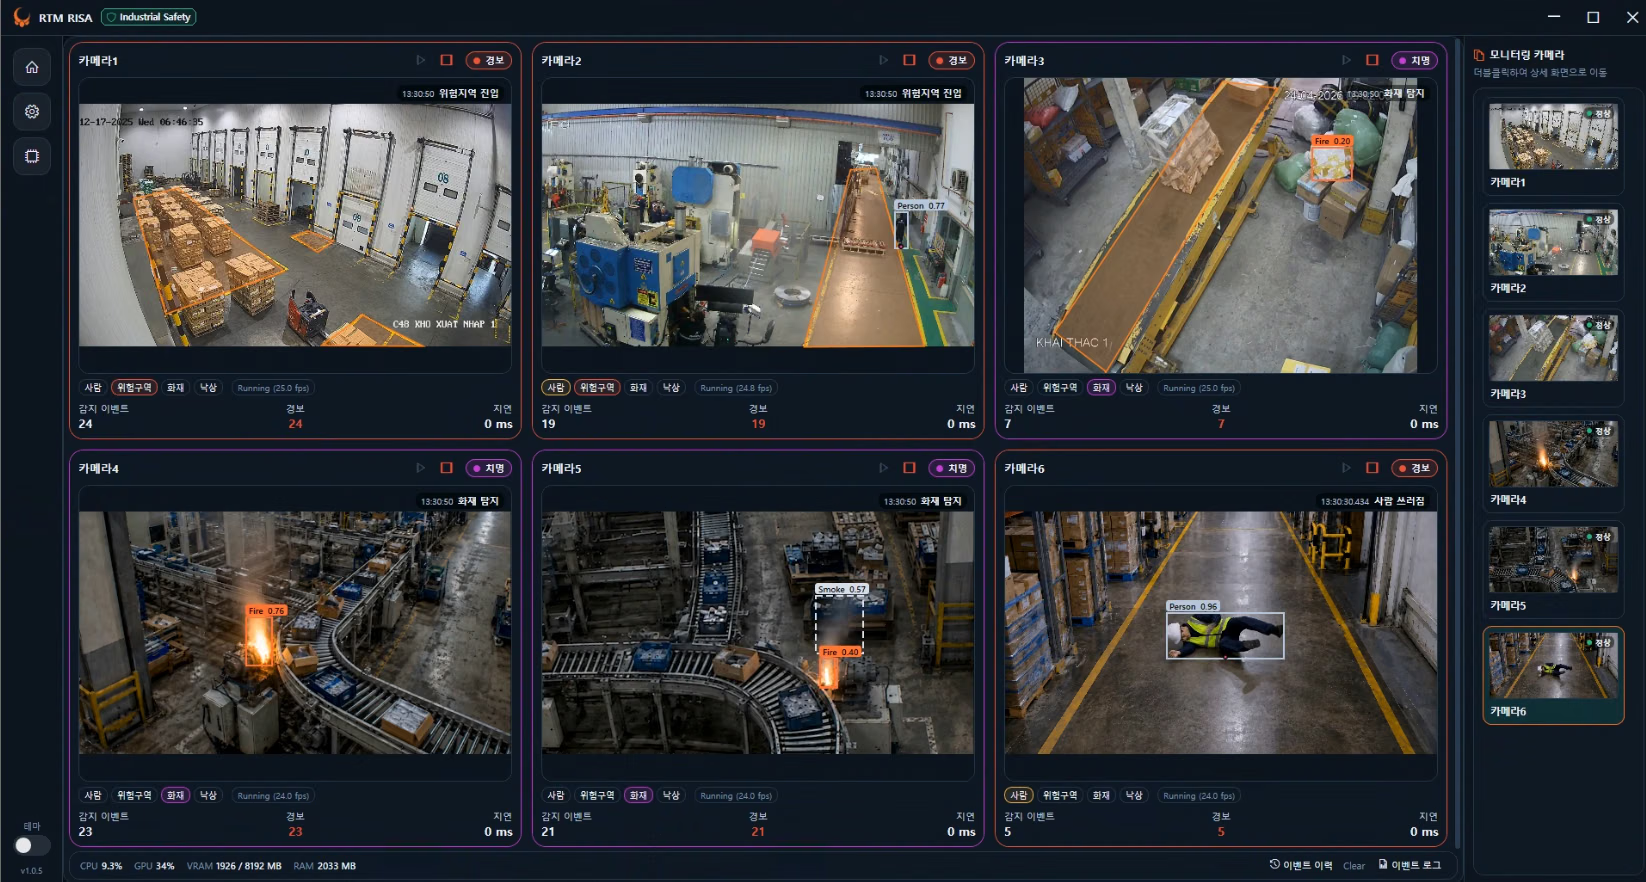 图 1。利用 Ultralytics YOLO 的 RTM 跌倒检测实时视频流。(图片来源:RTM)
解决无人愿意购买的硬件问题#
安全监控面临着不安装任何系统的选择。如果一个系统在监控单个摄像头之前需要购买新的服务器硬件,那么评估往往在开始之前就结束了。对于制造商而言,现状通常是在昂贵的专用硬件和完全没有自动监控之间做选择。
RTM 致力于消除这种权衡:只需一次部署,即可在控制室现有的任何电脑上运行,范围从英特尔集成显卡到 NVIDIA RTX 3090,且无需针对不同现场进行单独构建。
为了实现这一点,RTM 将两个 YOLO26 模型以静态形状导出为 ONNX 格式,并通过涵盖 TensorRT、CUDA、OpenVINO、DirectML 和 CPU 的五个执行提供程序运行它们。在启动时,推理库会检测已安装的 GPU 供应商并自动选择正确的提供程序链,因此无论目标机器完全没有独立 GPU 还是拥有高端显卡,每个模型相同的 36 MB 文件均可未经修改地运行。部署的应用程序中没有 Python 或 PyTorch 依赖项,也无需维护针对每个供应商的发布轨道。
YOLO26 的端到端检测头使得这种单一构件的方法切实可行:由于模型直接输出最终检测结果,RTM 的 C++ 推理层只需要置信度阈值和Letterbox反变换,无需重新实现 NMS,也无需在 Python 训练路径和 C++ 部署路径之间调试一致性差距——这种漏洞通常在检测器跨越语言边界时出现。
量化 GPU 带来的收益#
RTM 在 NVIDIA RTX 3090(ONNX Runtime 1.26.0、CUDA 执行提供程序、FP32、批大小 1、仅前向传播)上对两种输入分辨率下的两个 YOLO26 小型模型(人员检测以及火灾/烟雾检测)进行了基准测试。在 640×640 分辨率下,人员模型的运行速度为每帧 4.20 毫秒,火灾/烟雾模型为 4.34 毫秒;在 1280×1280 分辨率下,两者均攀升至约 12.5 毫秒,GPU 内存占用从 406 MB 升至 1,302 MB。这使得 640×640 的每帧成本降低了约 2.9 倍,内存占用减少了 3.2 倍,而较大的输入则改善了对小型、远处物体的检测。RTM 将 640×640 作为默认设置,并保留了 1280×1280 导出选项,供那些有闲置 GPU 性能可用于增加检测余量而非提升通道数量的现场使用。
从 FP32 的 CUDA 迁移到 FP16 的 TensorRT,将两个模型的组合每帧成本从 8.68 毫秒降至 6.26 毫秒,降幅达 28%,在单块 GPU 上四个通道的帧率从 28.8 FPS 提升至约 39.9 FPS。在发货之前,RTM 验证了 FP16 转换在准确率上没有任何损失:在所有对象大小区间以及火灾和烟雾的事件级别上,召回率均保持不变。在部署的应用程序中,推荐配置的机器(16 核英特尔酷睿 i7 或更高配置、32GB RAM、RTX 5060 8GB 或更高)可支持 6 个并发通道,而仅配备集成显卡的低端机器仍可支持 1 个通道,产品上限为每台设备 10 个通道。
为什么要利用 Ultralytics YOLO26?#
RTM 通过相同的 Ultralytics 训练代码库训练人员检测器和火灾/烟雾检测器,两者共用 352 行代码,完全没有针对特定领域的繁杂分支。监视人员的检测器与监视火灾的检测器之间唯一发生变化的是配置文件:输入大小、训练轮数、学习率和数据集组成。这是 Ultralytics YOLO 构建方式的直接产物。在检测任务中采用单一、一致的架构和训练 API,意味着建立一个新的检测领域只需修改配置,而无需构建新的流水线,这正是小型工程团队能够在不维护两个代码库的情况下建立两个生产级模型的原因。
同样的这种一致性使得转向 YOLO26 本身变得低风险。RTM 在项目开始四天后(即 2026 年 5 月)采用了 YOLO26,此次迁移不需要更改现有的任何一行训练代码,只需更换不同的检查点。由于 Ultralytics 在各个模型世代之间保持训练接口稳定,升级到最新的架构并不意味着重写 RTM 已经构建和测试过的流水线。
"即使在相同的数据集上,输入大小和数据增强也会改变模型的性能。使用 Ultralytics,所有这些都包含在一个配置文件中,因此我们只需更改几个值,并排运行几个变体,然后选择最好的一个。我们完全不需要碰任何代码,因此安排十次运行的工作量和运行一次差不多。" - RTM 人工智能工程师
这种稳定性也带来了准确率方面的回报。将五个阶段的连续训练课程整合为一次联合运行,在操作阈值不变的情况下,将验证集 mAP50 从 0.672 提高到了 0.689,这一收益 RTM 仅通过在相同的 YOLO26 架构上重新训练即可获得,而无需重新设计模型。并且由于 YOLO26 可以整洁地导出为固定形状的 ONNX 工件,且检测阈值作为附属文件随附而不是编译到应用程序中,现场只需替换一个 ONNX 文件即可吸收该准确率收益,而无需对主机应用程序进行任何更改。这正是小型工程团队能够在无需协调发布的情况下将模型更新推送至每个现场的原因,这也是基于 YOLO26 而非定制架构构建带来的直接结果。
检测之上的功能#
RTM 的警报并非原始检测结果:画面中的一个人并不算一个事件,但一个人跌倒并倒地不起则算作事件。确定性事件层位于两个 YOLO26 模型之上,在触发任何警报之前,它结合了跟踪、姿态状态、区域成员资格和滑动窗口投票。将该逻辑与模型保持分离,使得单个人员检测器能够服务于各个现场,尽管不同工厂之间的摄像头高度、角度和光照情况差异巨大。这也意味着新的安全行为可以复用现有的检测结果:RTM 目前正在基于相同的人员检测输出构建个人防护装备合规性监控,无需在配备 GPU 的现场引入新模型或新硬件。
整体影响#
这种影响在 RTM 的协作机器人集成商客户中表现得最为明显,这些客户在各个工厂供应和安装协作机器人,并且长期以来一直在处理尽管有物理或激光安全围栏但工人仍与机器人发生碰撞的问题。借助 RTM 的系统,危险区域入侵能够被检测到并立即触发连接 PLC 的机器人停止运行且毫无延迟,这些集成商此后已采用该系统作为默认安全设备,以取代物理围栏。
一家钢铁制造客户报告称,Ultralytics YOLO 针对不同现场定制检测场景的能力使他们能够裁减 100 多名此前在车间巡逻的安全监控人员。更广泛地说,制造商将 RTM 的解决方案描述为他们评估过的安全监控选项中最易于安装且最具成本效益的方案,危险区域、跌倒以及火灾/烟雾检测覆盖了他们最核心的需求。
基于相同模型的进一步扩展#
RTM 的下一步是个人防护装备合规性检测,该检测完全构建在其现有的个人检测输出之上。无需训练新模型,且在拥有 GPU 性能余量的现场,也无需安装新硬件。随着在更多制造现场和硬件层级上的持续推广,每个模型相同的单一 ONNX 导出持续承担着繁重的任务,从配置最低的集成显卡电脑到车间最高端的 GPU 服务器均能胜任。
有兴趣构建您自己的视觉人工智能解决方案吗?探索我们的 Ultralytics YOLO 模型,了解它们跨行业的应用情况(包括制造领域的计算机视觉),并查看许可选项以开始使用。








