توظيف التعلم المعزز في مشاريع الرؤية الحاسوبية
تعرّف على كيفية عمل التعلم المعزز وكيفية دمجه مع الرؤية الحاسوبية في روبوتات المستودعات والمركبات ذاتية القيادة والروبوتات الجراحية، إلى جانب المفاضلات المرتبطة به.
 Abirami Vina8 دقيقة قراءة
من الطرق المباشرة لشرح الذكاء الاصطناعي (AI) أنه مجال يركز على إعادة إنشاء كيفية تفكير البشر وتعلّمهم. ومن هنا جاءت فكرة تقنيات التعلّم في الذكاء الاصطناعي، وهي أساليب مختلفة تتيح للآلات تحسين أدائها بمرور الوقت، تمامًا كما يفعل البشر.
استكشفنا سابقًا أهم تقنيات التعلّم في الذكاء الاصطناعي، ومنها التعلّم الخاضع للإشراف والتعلّم غير الخاضع للإشراف والتعلّم المعزز والتعلّم بالنقل، وتناولنا الدور المهم الذي يؤديه كل منها في مساعدة نماذج الذكاء الاصطناعي على معالجة المعلومات واتخاذ القرارات.
سنلقي اليوم نظرة أقرب على التعلّم المعزز، وهو أسلوب يعلّم أنظمة الذكاء الاصطناعي التعلّم من خلال التجربة، وذلك بالتفاعل مع بيئة والتحسن استنادًا إلى التغذية الراجعة. وسنستكشف تحديدًا كيفية تطبيق التعلّم المعزز في تطبيقات الرؤية الحاسوبية، وهي أنظمة تمكّن الآلات من تفسير المعلومات المرئية من العالم وفهمها.
يفتح الجمع بين مفاهيم مثل التعلّم المعزز والرؤية الحاسوبية آفاقًا جديدة ومثيرة، وهو مجال بحث نشط. ويتيح ذلك لأنظمة الذكاء الاصطناعي التعرّف على ما تراه واتخاذ قرارات مدروسة استنادًا إلى المعلومات المرئية.
ما التعلّم المعزز؟#
التعلّم المعزز فرع من تعلّم الآلة، يتعلّم فيه وكيل الذكاء الاصطناعي من خلال اتخاذ الإجراءات وتلقي التغذية الراجعة في شكل مكافآت أو عقوبات. والهدف هو تحديد الإجراءات التي تؤدي إلى أفضل النتائج بمرور الوقت.
يمكنك تشبيه التعلّم المعزز بتدريب كلب. فعندما يجلس الكلب عند إصدار أمر له، تعطيه مكافأة. وبعد فترة، يتعلم الكلب أن الجلوس يؤدي إلى مكافأة. وفي التعلّم المعزز، يشبه وكيل الذكاء الاصطناعي أو النموذج الكلب؛ فالبيئة هي العالم المحيط به، وتساعده المكافأة على فهم ما إذا كان قد اتخذ الخطوة الصحيحة.
يختلف هذا عن التعلّم الخاضع للإشراف، حيث يُعرض على نموذج الذكاء الاصطناعي العديد من الأمثلة على الإجابات الصحيحة. فعلى سبيل المثال، قد يُعرض على النموذج صورة كلب ويُقال له: «هذا كلب».
أما التعلّم المعزز فلا يعتمد على البيانات المصنفة. بل يتضمن التعلّم عبر تجربة إجراءات مختلفة والاستفادة من نتائجها، تمامًا كما يحدث عند لعب لعبة ومحاولة معرفة الحركات التي تساعدك على الفوز.
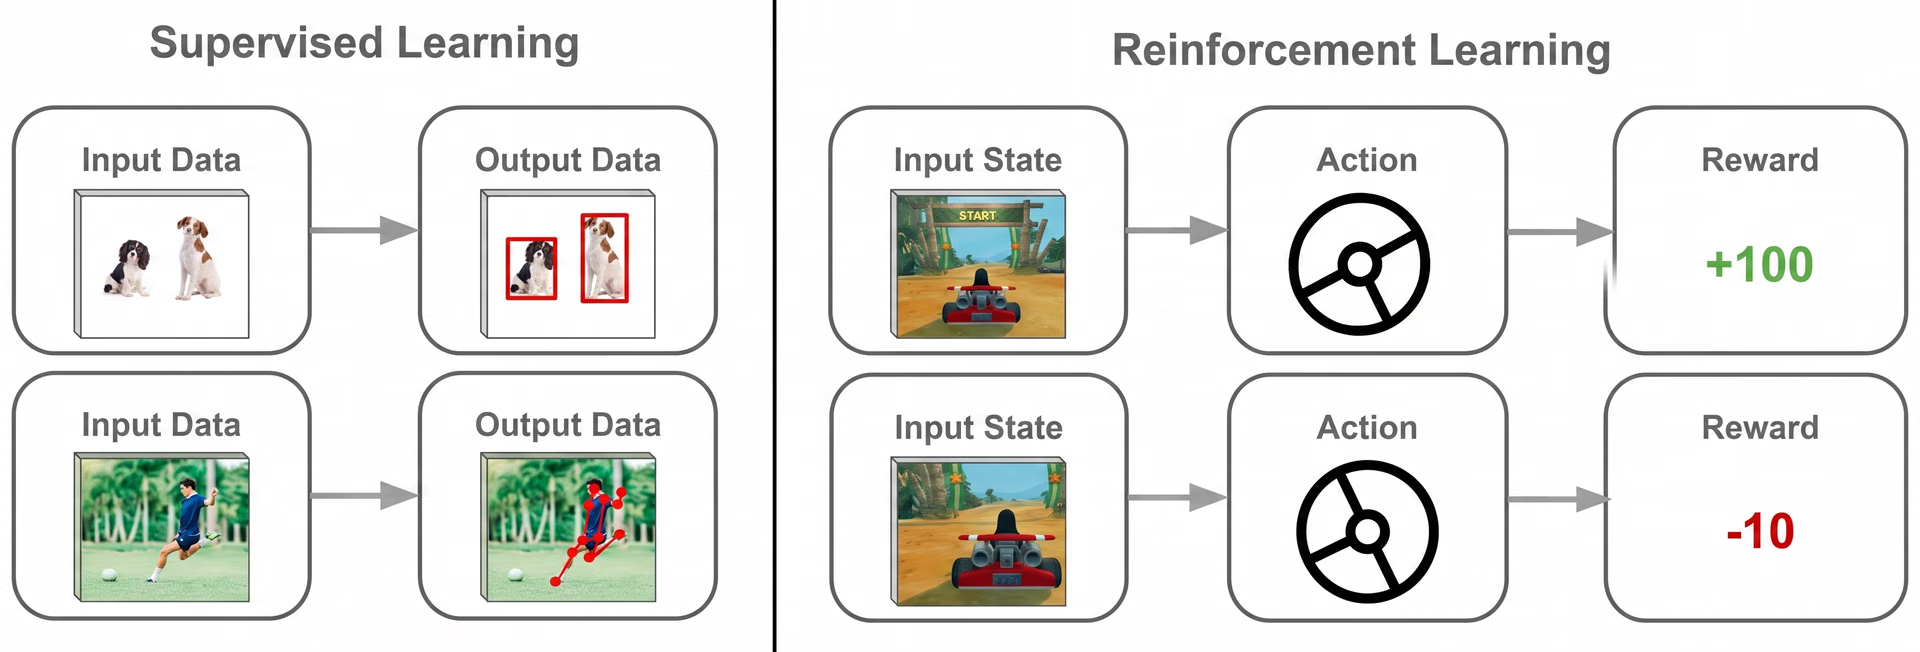
الشكل 1. التعلّم المعزز مقابل التعلّم الخاضع للإشراف.
يُعد التعلّم المعزز أساسيًا للمهام التي تُتخذ فيها القرارات خطوةً بخطوة، ويؤثر فيها كل اختيار في ما يحدث بعد ذلك. ويُستخدم هذا النوع من التعلّم في ألعاب الفيديو الاستراتيجية لجعل اللعب أكثر تحديًا وتشويقًا للاعبين.
كيفية عمل التعلّم المعزز في حلول الذكاء الاصطناعي#
فكّر في كيفية تعلّمك ركوب الدراجة. قد تسقط في البداية، لكنك تبدأ مع التمرين في اكتشاف ما يساعدك على الحفاظ على توازنك. وكلما زادت مرات ركوبك، تحسّن أداؤك. فأنت تتعلم بالممارسة، لا بمجرد تلقّي التعليمات.
يعمل التعلّم المعزز بطريقة مشابهة في الذكاء الاصطناعي. فهو يتعلم من خلال التجربة: يجرب إجراءات مختلفة، ويراقب ما يحدث، ويحسّن تدريجيًا قدرته على اتخاذ الخيارات الصحيحة بمرور الوقت.
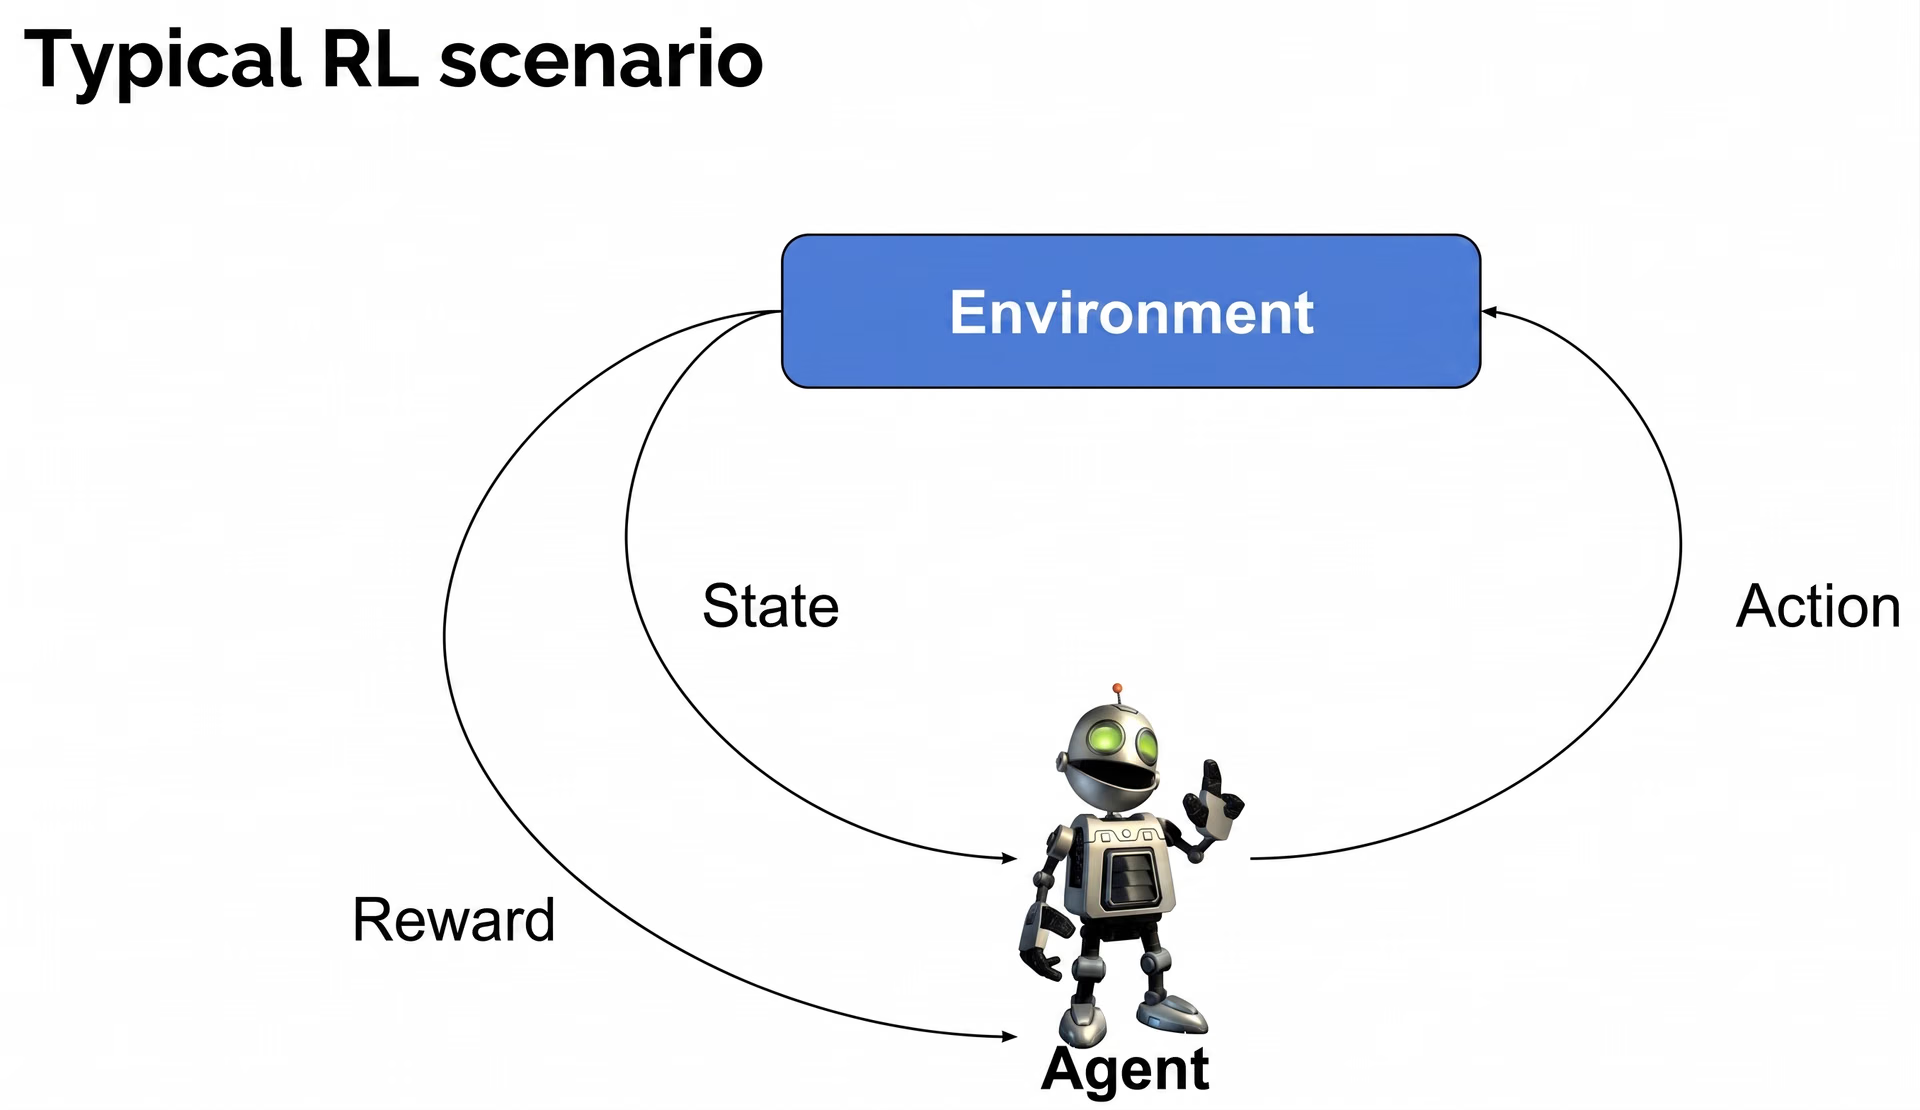
الشكل 2. فهم آلية عمل التعلّم المعزز.
إليك لمحة عن بعض المكوّنات الأساسية للتعلّم المعزّز:
- الوكيل: الوكيل هو المتعلّم أو متّخذ القرار. يتفاعل مع البيئة عبر تنفيذ الإجراءات، ويسعى إلى تحقيق هدف محدد.
- البيئة: تشمل البيئة كل ما يتفاعل معه الوكيل. وتتغير استجابةً لإجراءات الوكيل، وتقدم تغذية راجعة بناءً على النتائج.
- الحالة: تمثل الحالة لقطةً للوضع الراهن في البيئة. يراقب الوكيل الحالة لفهم ما يحيط به وتحديد الإجراء الذي ينبغي اتخاذه بعد ذلك.
- الإجراء: الإجراء هو حركة أو قرار يتخذه الوكيل ويؤثر في البيئة. يؤدي كل إجراء إلى حالة جديدة، ويمكن أن يؤثر في المكافآت المستقبلية.
- المكافأة: المكافأة هي ببساطة تغذية راجعة من البيئة تخبر الوكيل ما إذا كان الإجراء مفيدًا أم لا. تشجع المكافآت الإيجابية الوكيل على تكرار الإجراءات الجيدة، بينما تثنيه المكافآت السلبية عن الإجراءات غير الملائمة.
- السياسة: السياسة هي استراتيجية الوكيل لاختيار الإجراءات بناءً على الحالة الراهنة. وبمرور الوقت، ينقّح الوكيل سياسته لتعظيم إجمالي المكافآت التي يمكنه الحصول عليها.
من خلال استخدام هذه المكونات معًا، يتيح التعلّم المعزز لأنظمة الذكاء الاصطناعي اكتساب سلوكيات فعالة عبر التجربة والخطأ المستمرين. ومع كل محاولة، يتحسن أداء الوكيل في اختيار الإجراءات التي تؤدي إلى مكافآت أعلى ونتائج أفضل.
ابتكارات التعلّم المعزّز في الرؤية الحاسوبية#
تُستخدم الرؤية الحاسوبية في مهام مثل اكتشاف الأجسام في الصور، وتصنيف محتويات الصور، وتقسيم الصورة إلى أجزاء مختلفة. وتدعم نماذج الرؤية الحاسوبية مثل Ultralytics YOLO11 هذه المهام، ويمكن استخدامها لإنشاء تطبيقات مؤثرة قادرة على استخلاص الرؤى البصرية.
لكن عند الجمع بين مهام الذكاء الاصطناعي للرؤية والتعلّم المعزز، تكون النتيجة حلًا للذكاء الاصطناعي لا يكتفي بالرؤية، بل يتعلم أيضًا كيفية التصرف بناءً على الرؤى المرئية ويتحسن بمرور الوقت.
من الأمثلة المثيرة للاهتمام على التعلّم المعزز في تطبيقات الرؤية الحاسوبية استخدام الروبوتات في المستودعات. تستطيع الروبوتات المزوّدة بالكاميرات وأنظمة الرؤية الحاسوبية تحليل محيطها، واكتشاف موقع كل عنصر، وتحديد شكله وحجمه، وفهم موضعه على الرف.
في كل مرة يحاول فيها الروبوت التقاط عنصر، يتلقى تغذية راجعة: نجاحًا إذا التُقط العنصر على نحو صحيح، أو إخفاقًا إذا سقط. وبمرور الوقت، يتعلم الروبوت الإجراءات الأفضل لمختلف العناصر. وبدلًا من اتباع مجموعة ثابتة من التعليمات، يتحسن باستمرار من خلال التجربة.
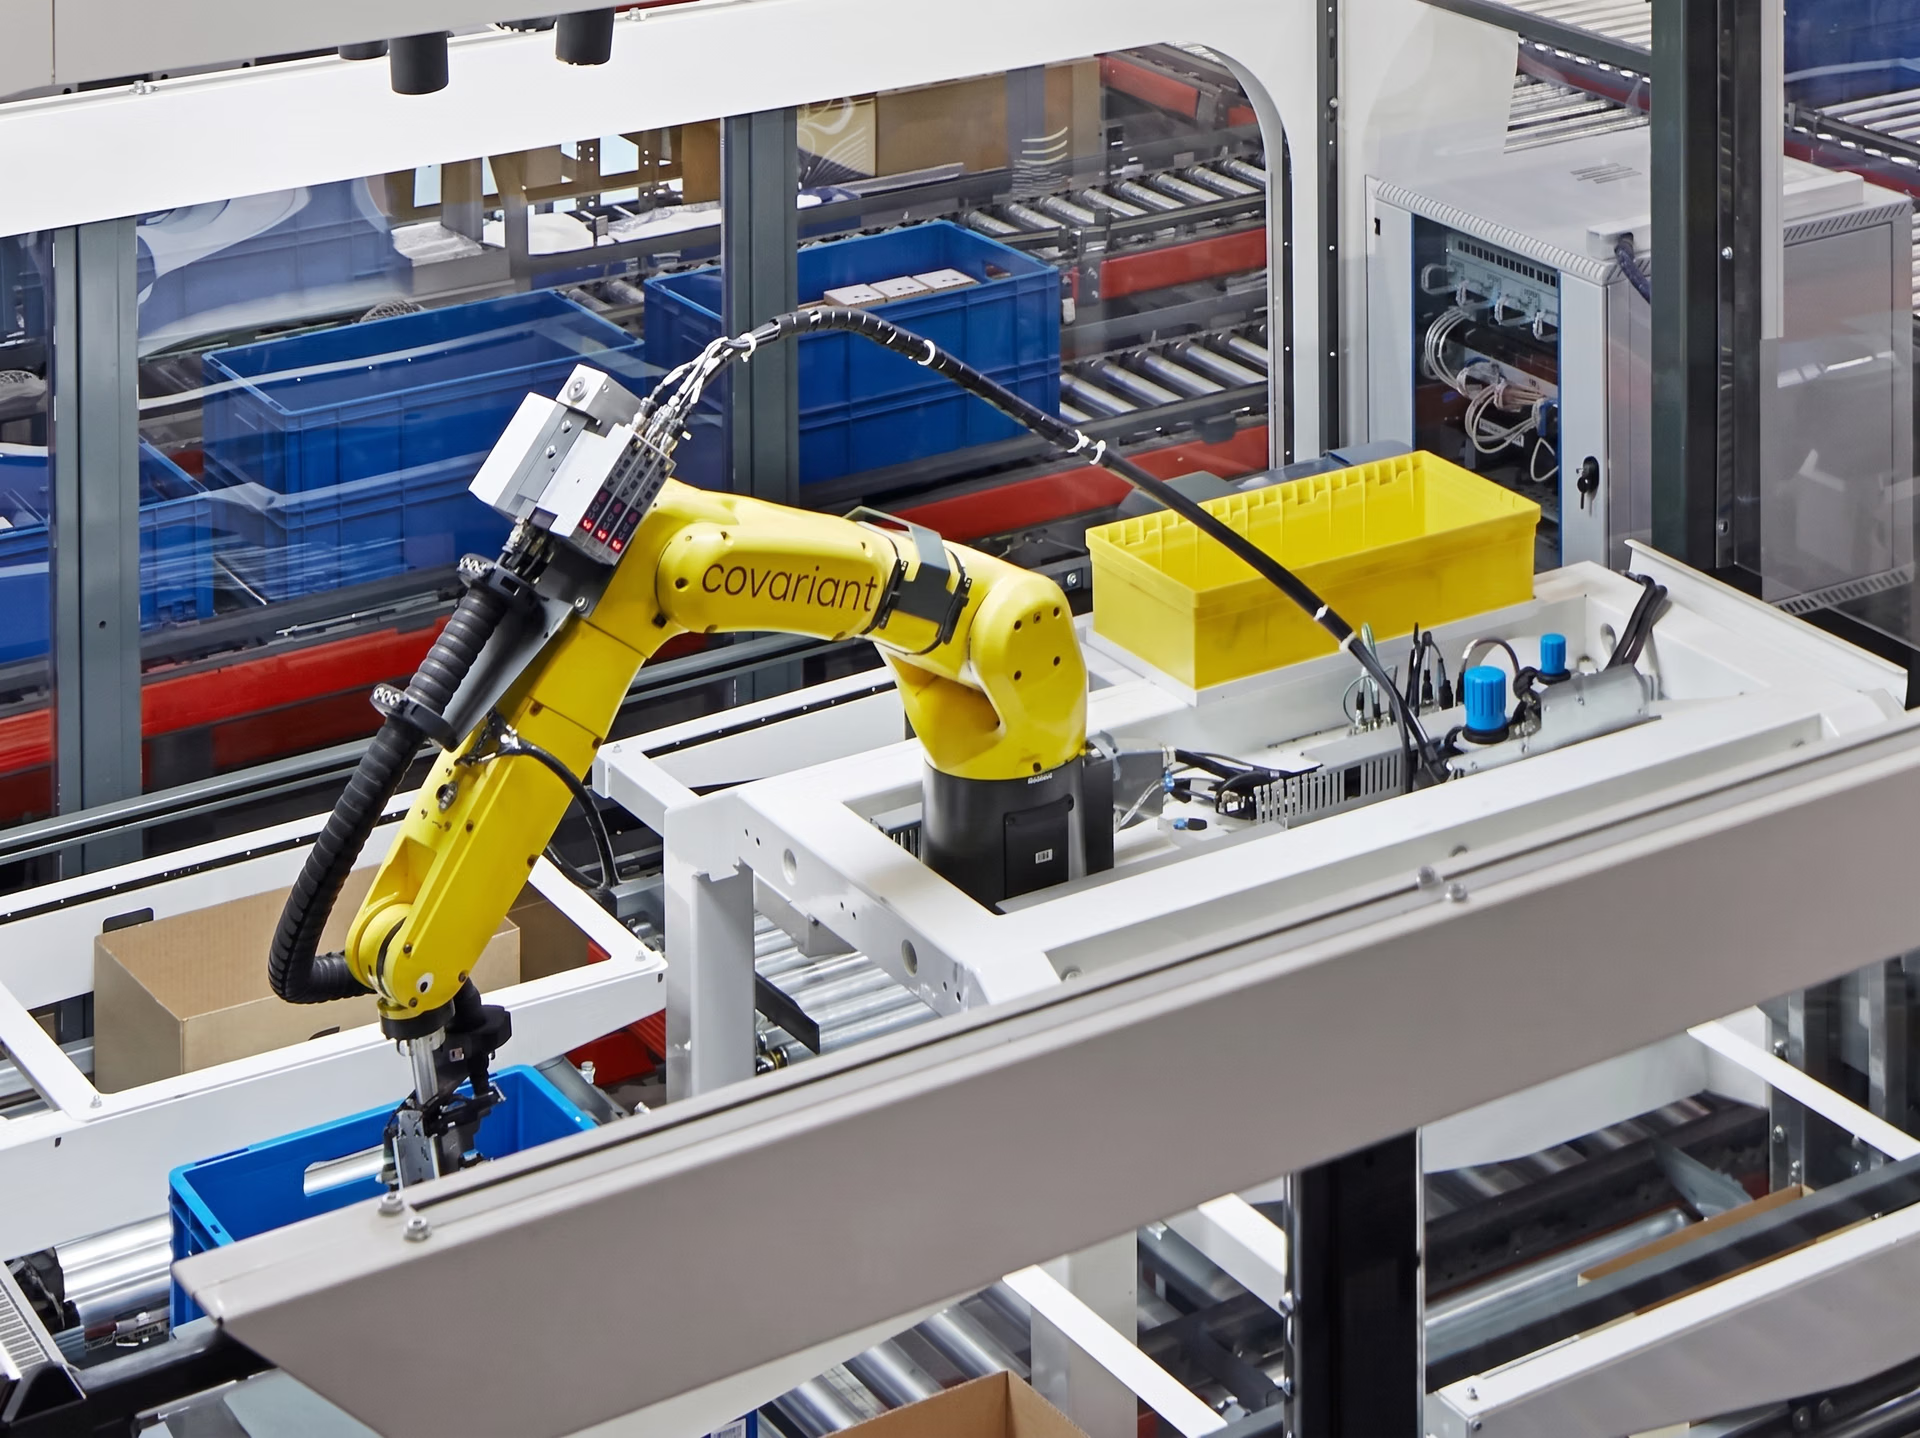
الشكل 3. ذراع روبوتية تستخدم الذكاء الاصطناعي البصري والتعلّم المعزّز لالتقاط الأجسام.
تطبيقات التعلّم المعزّز في الرؤية الحاسوبية#
بعد أن كوّنا فهمًا أفضل لمعنى التعلّم المعزّز ودوره في الرؤية الحاسوبية، لنتناول عن كثب بعض الأمثلة التي يُستخدم فيها التعلّم المعزّز والرؤية الحاسوبية معًا.
دمج الذكاء الاصطناعي البصري والتعلّم المعزّز لتطوير مركبات أكثر ذكاءً#
يمكن أن تعتمد المركبات ذاتية القيادة على الذكاء الاصطناعي للرؤية لفهم محيطها، وعلى التعلّم المعزز لاتخاذ القرارات بناءً على ما تراه. ويُعد AWS DeepRacer مثالًا رائعًا على ذلك.
إن AWS DeepRacer سيارة سباق مستقلة تمامًا بمقياس 1/18، تتعلم القيادة باستخدام كاميرا والتعلّم المعزّز. وبدلًا من تلقي تعليمات بشأن ما ينبغي فعله، تستنتج كيفية التصرف بنفسها من خلال المحاولة وارتكاب الأخطاء والتعلم منها.
تعمل كاميرا هذه السيارة الصغيرة كزوج من العيون، إذ تلتقط صورًا للمسار أمامها. وبناءً على ما تراه، تتعلم السيارة كيفية التوجيه والسرعة المناسبة. وتتحسن مع كل دورة. فعلى سبيل المثال، قد تتعلم اتخاذ منعطفات أوسع أو الإبطاء قبل المنعطفات الحادة بالاستفادة من المحاولات السابقة.
يبدأ تدريب DeepRacer في بيئة افتراضية، حيث يتدرب النموذج ويصقل مهارات القيادة. وعندما يبلغ مستوى معينًا من الأداء، تُنقل هذه المهارات إلى مسارات واقعية باستخدام سيارات فعلية.
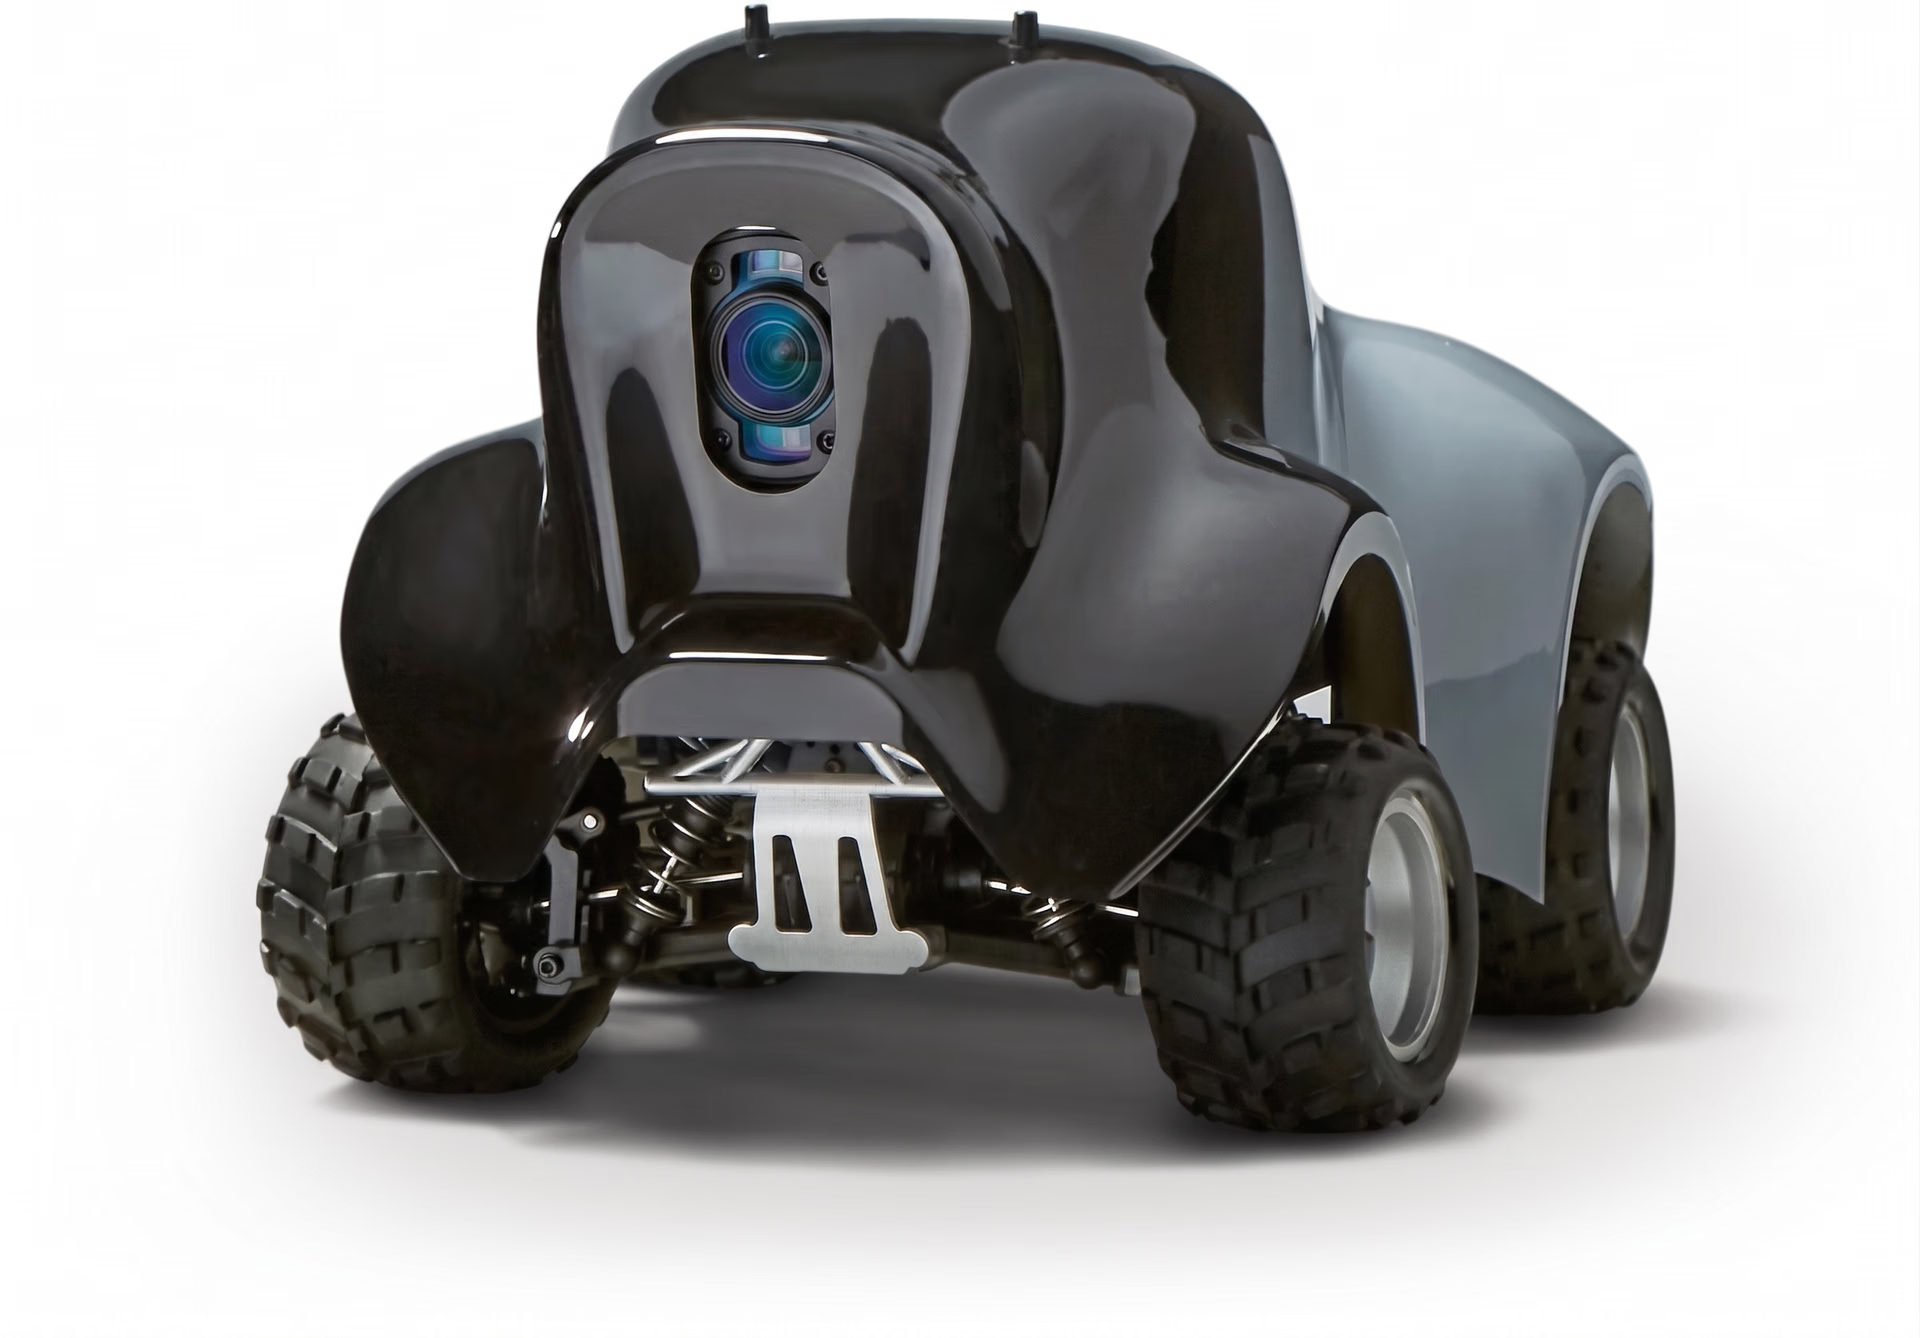
الشكل 4. تستخدم AWS DeepRacer الرؤية والتعلّم المعزّز للقيادة الذاتية. مصدر الصورة: Amazon.
التوجه نحو الروبوتات الجراحية ذاتية التشغيل#
من مجالات البحث الواعدة التي تحظى باهتمام متزايد دمج الذكاء الاصطناعي للرؤية والتعلّم المعزز في الجراحة الروبوتية. ولا يزال هذا التطبيق نظريًا إلى حد كبير في الوقت الراهن، إذ يجري الباحثون محاكاة في بيئات افتراضية.
لكن التجارب الأولية تحقق نتائج واعدة، وتشير إلى أن الروبوتات الجراحية قد تتمكن مستقبلًا من إجراء عمليات معقدة ودقيقة بمزيد من الدقة والقدرة على التكيّف، وبأقل قدر من التدخل البشري.
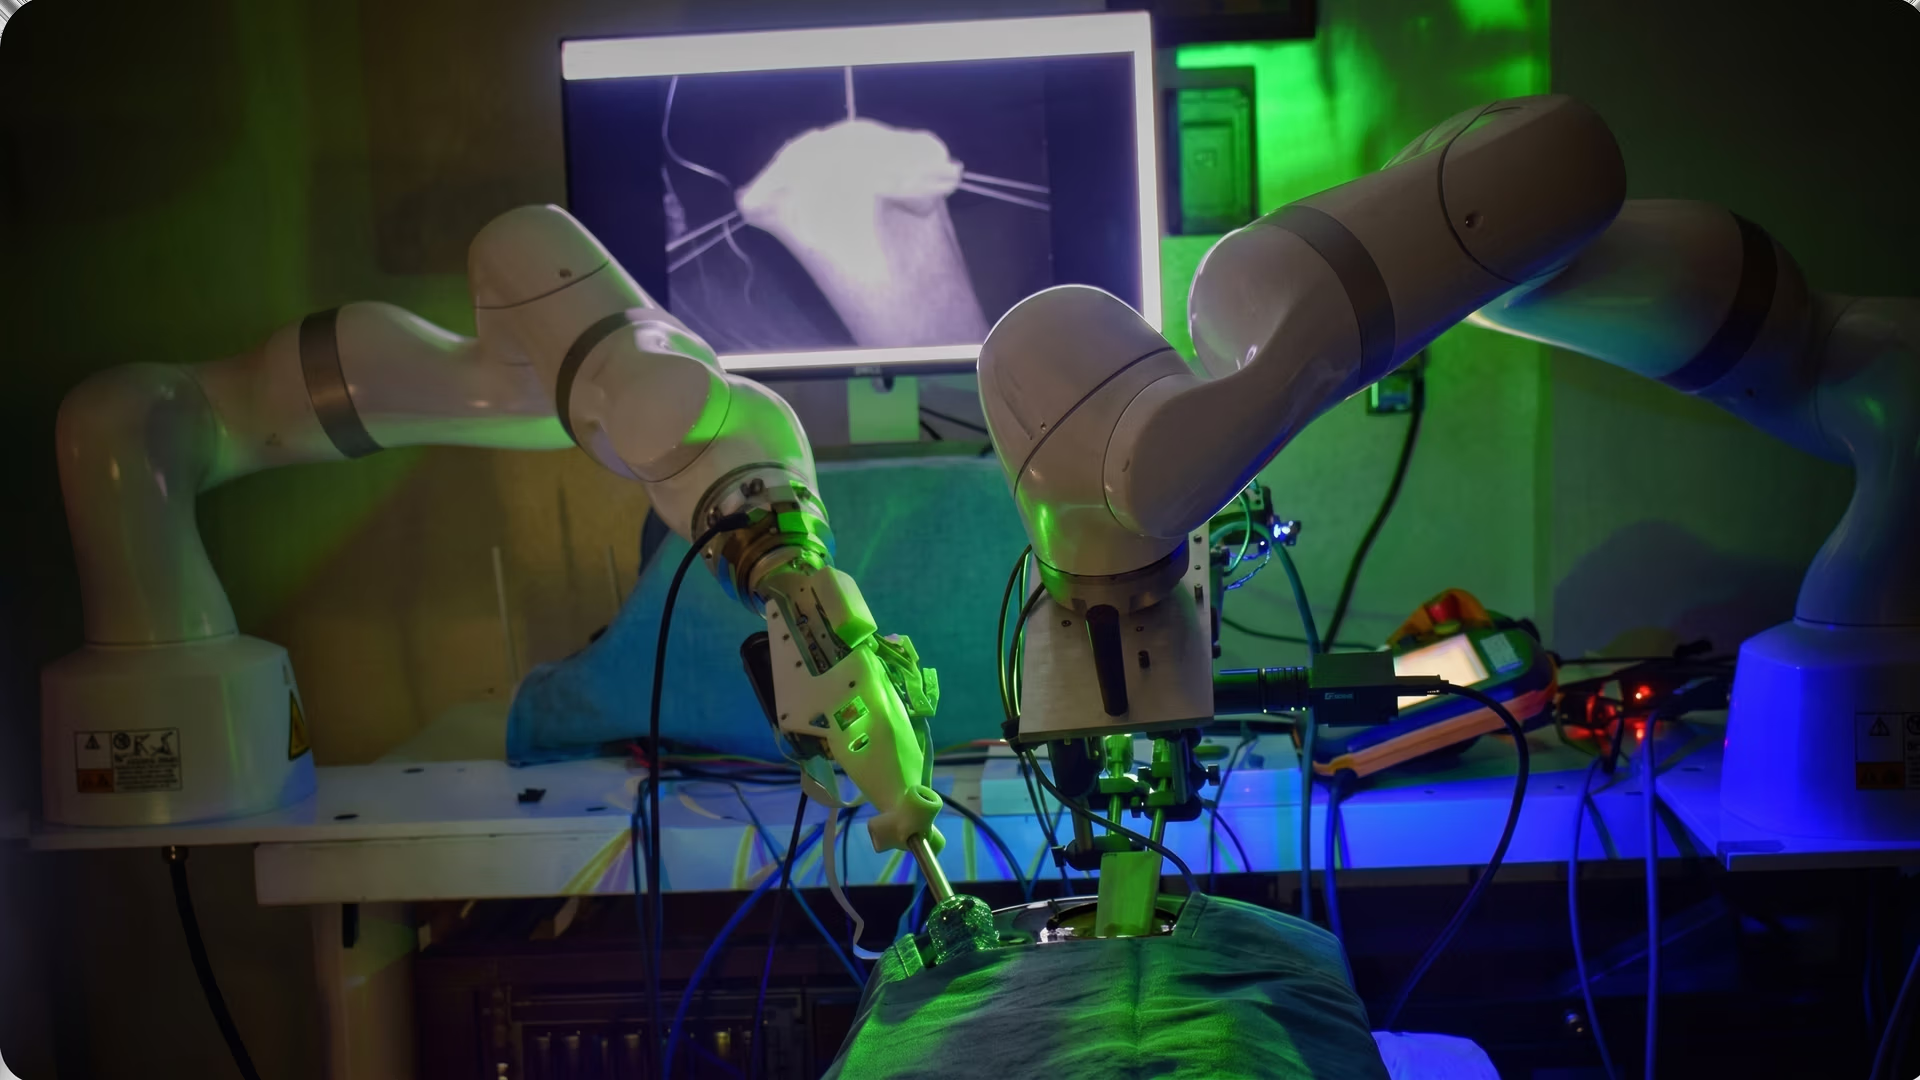
الشكل 5. تزداد الروبوتات الجراحية تطورًا باستمرار.
على سبيل المثال، تخيل موقفًا يلزم فيه رفع قطعة من الشاش بعناية من موضع جراحي. سيحلل الروبوت المزوّد بالذكاء الاصطناعي للرؤية المشهد أولًا، مستخدمًا التقسيم لتحديد الشاش والأنسجة المحيطة به.
بعد ذلك، يساعد التعلّم المعزّز الروبوت الجراحي على تحديد كيفية التعامل مع المهمة، واختيار أفضل زاوية للإمساك بالشاش، ومقدار الضغط اللازم، وطريقة رفعه دون إزعاج المناطق الحساسة المجاورة. وبمرور الوقت، ومن خلال التدريب المتكرر في بيئات محاكاة، قد يتعلم الروبوت تنفيذ هذه الحركات الدقيقة والحاسمة بمهارة وثقة متزايدتين.
مزايا التعلّم المعزّز في الذكاء الاصطناعي البصري وعيوبه#
يتيح التعلّم المعزز لأنظمة الذكاء الاصطناعي للرؤية تجاوز مجرد التعرّف البسيط والبدء في اتخاذ قرارات استنادًا إلى ما تراه. وهذا يفتح آفاقًا جديدة في مجالات مثل الروبوتات والأتمتة والتفاعل الآني.
فيما يلي بعض المزايا الرئيسية لدمج التعلّم المعزز في مسارات عمل الذكاء الاصطناعي للرؤية:
- اعتماد أقل على البيانات الموسومة: تستطيع هذه الأنظمة التعلم من التفاعل، لذا لا تحتاج إلى مجموعات بيانات ضخمة وموسومة للبدء.
- تعامل أفضل مع عدم اليقين: يستطيع التعلّم المعزّز التعامل مع المعلومات البصرية غير المكتملة أو المشوشة من خلال تعديل الإجراءات استنادًا إلى التغذية الراجعة، بدلًا من الاعتماد على بيانات مثالية فحسب.
- يدعم التعلّم طويل الأمد: يساعد النماذج على التحسن بمرور الوقت عبر التعلم من تسلسلات الإجراءات، لا من القرارات المنفردة فحسب.
من ناحية أخرى، إليك بعض قيود التعلّم المعزّز التي ينبغي مراعاتها:
- مشكلة إسناد الفضل: قد يصعب على الوكيل تحديد الإجراءات بعينها التي أسهمت في الوصول إلى نتيجة نهائية، لا سيما في تسلسلات القرارات الطويلة.
- خطر الاستكشاف غير الآمن: قد يجرب الوكيل أثناء التدريب إجراءات غير آمنة أو غير مرغوب فيها، لا يمكن قبولها في تطبيقات واقعية مثل الرعاية الصحية أو القيادة الذاتية.
- بطء التقارب: قد يستغرق النموذج وقتًا طويلًا ليصل فعليًا إلى أداء جيد، لا سيما في المهام المعقدة.
أبرز النقاط#
تتيح مشاريع الرؤية الحاسوبية التي تستخدم التعلّم المعزّز لأنظمة الذكاء الاصطناعي فهم ما يحيط بها وتعلّم كيفية التصرف من خلال الخبرة. ومع نماذج مثل Ultralytics YOLO11 التي توفر اكتشاف الأجسام في الوقت الفعلي، يستطيع النظام اتخاذ قرارات مستنيرة استنادًا إلى ما يراه.
يتجاوز هذا النهج الأساليب التقليدية، إذ يسمح للذكاء الاصطناعي بالتحسن من خلال التجربة والتغذية الراجعة بدلًا من الاعتماد حصريًا على البيانات المصنفة. وهو يدعم التعلّم المستمر ويساعد على بناء أنظمة ذكاء اصطناعي للرؤية أكثر مرونة وقدرة على التكيف وذكاءً، تتحسن بمرور الوقت.
انضم إلى مجتمعنا المتنامي. تفضّل بزيارة مستودع GitHub للتعمق أكثر في الذكاء الاصطناعي. هل ترغب في بدء مشاريعك الخاصة في الرؤية الحاسوبية؟ استكشف خيارات الترخيص لدينا. تعرّف أكثر على الذكاء الاصطناعي في التصنيع والذكاء الاصطناعي للرؤية في قطاع السيارات في صفحات الحلول لدينا.
بقلم
منشئ محتوى · Ultralytics
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









