So verbesserst du den mAP deines Modells bei kleinen Objekten: Eine kurze Anleitung
Erfahre, wie du den mAP deines Modells bei kleinen Objekten verbesserst – mit praktischen Tipps zu Datenqualität, Augmentierung, Trainingsstrategien, Evaluierung und Bereitstellung.
Mit der zunehmenden Verbreitung von künstlicher Intelligenz (AI), maschinellem Lernen und Bildverarbeitung kommen Objekterkennungssysteme überall zum Einsatz – von intelligenten Verkehrskameras bis hin zu Drohnen und Analysewerkzeugen für den Einzelhandel. Häufig sollen diese Systeme Objekte jeder Größe erkennen, egal ob es sich um einen großen Lkw in Kameranähe oder einen winzigen Fußgänger weit entfernt handelt.
Große und gut sichtbare Objekte lassen sich in der Regel leichter erkennen. Kleine Objekte zu erkennen ist dagegen schwieriger.
Wenn ein Objekt nur einen winzigen Teil des Bildes einnimmt, stehen nur sehr wenige visuelle Informationen zur Verfügung. Ein weit entfernter Fußgänger in einem Verkehrsbild oder ein kleines Fahrzeug in einer Luftaufnahme ist vielleicht nur wenige Pixel groß, doch diese Pixel können entscheidende Informationen enthalten.
Computer-Vision-Modelle wie die YOLO-Modelle von Ultralytics nutzen visuelle Muster, um Objekte zu erkennen. Sind diese Muster begrenzt oder unklar, leidet die Leistung. Bei der Verarbeitung können wichtige Details verloren gehen, wodurch Vorhersagen empfindlicher auf Lokalisierungsfehler reagieren. Schon eine geringfügige Verschiebung einer Bounding Box kann aus einer korrekten Erkennung eine übersehene machen.
Diese Lücke wird deutlich, wenn wir die Modellleistung betrachten. Die meisten Erkennungs- und Segmentierungsmodelle kommen mit mittelgroßen und großen Objekten gut zurecht, doch kleine Objekte verringern häufig die Gesamtgenauigkeit.
Die Leistung von Deep-Learning-Modellen wird üblicherweise anhand der mittleren durchschnittlichen Präzision, also mAP, gemessen. Diese Metrik zeigt sowohl, wie genau die Erkennungen sind, als auch, wie gut die vorhergesagten Boxen mit den tatsächlichen Objekten übereinstimmen.
Sie kombiniert Präzision, die angibt, wie viele der vorhergesagten Objekte korrekt sind, und den Recall, der angibt, wie viele der tatsächlich vorhandenen Objekte erfolgreich erkannt werden, und zwar über verschiedene Konfidenzwerte und Schwellenwerte für Intersection over Union (IoU; eine Metrik, die misst, wie stark sich die vorhergesagte Bounding Box mit der Ground-Truth-Box überschneidet) hinweg.
Zuvor haben wir uns mit der Erkennung kleiner Objekte und den Gründen beschäftigt, warum sie für Computer-Vision-Modelle so schwierig ist. In diesem Artikel bauen wir auf diesen Grundlagen auf und konzentrieren uns darauf, wie sich die mAP bei kleinen Objekten verbessern lässt. Legen wir los!
Warum sind kleine Objekte schwieriger zu erkennen?#
Bei Anwendungen mit Objektdetektoren hängt die Definition eines kleinen Objekts davon ab, wie viel Platz es im Bild einnimmt, und nicht unbedingt davon, wie klein es dem menschlichen Auge erscheint. Nimmt es nur einen winzigen Teil des Bildes ein, enthält es nur sehr wenige visuelle Informationen. Dadurch kann ein Computer-Vision-Algorithmus es schwerer genau erkennen.
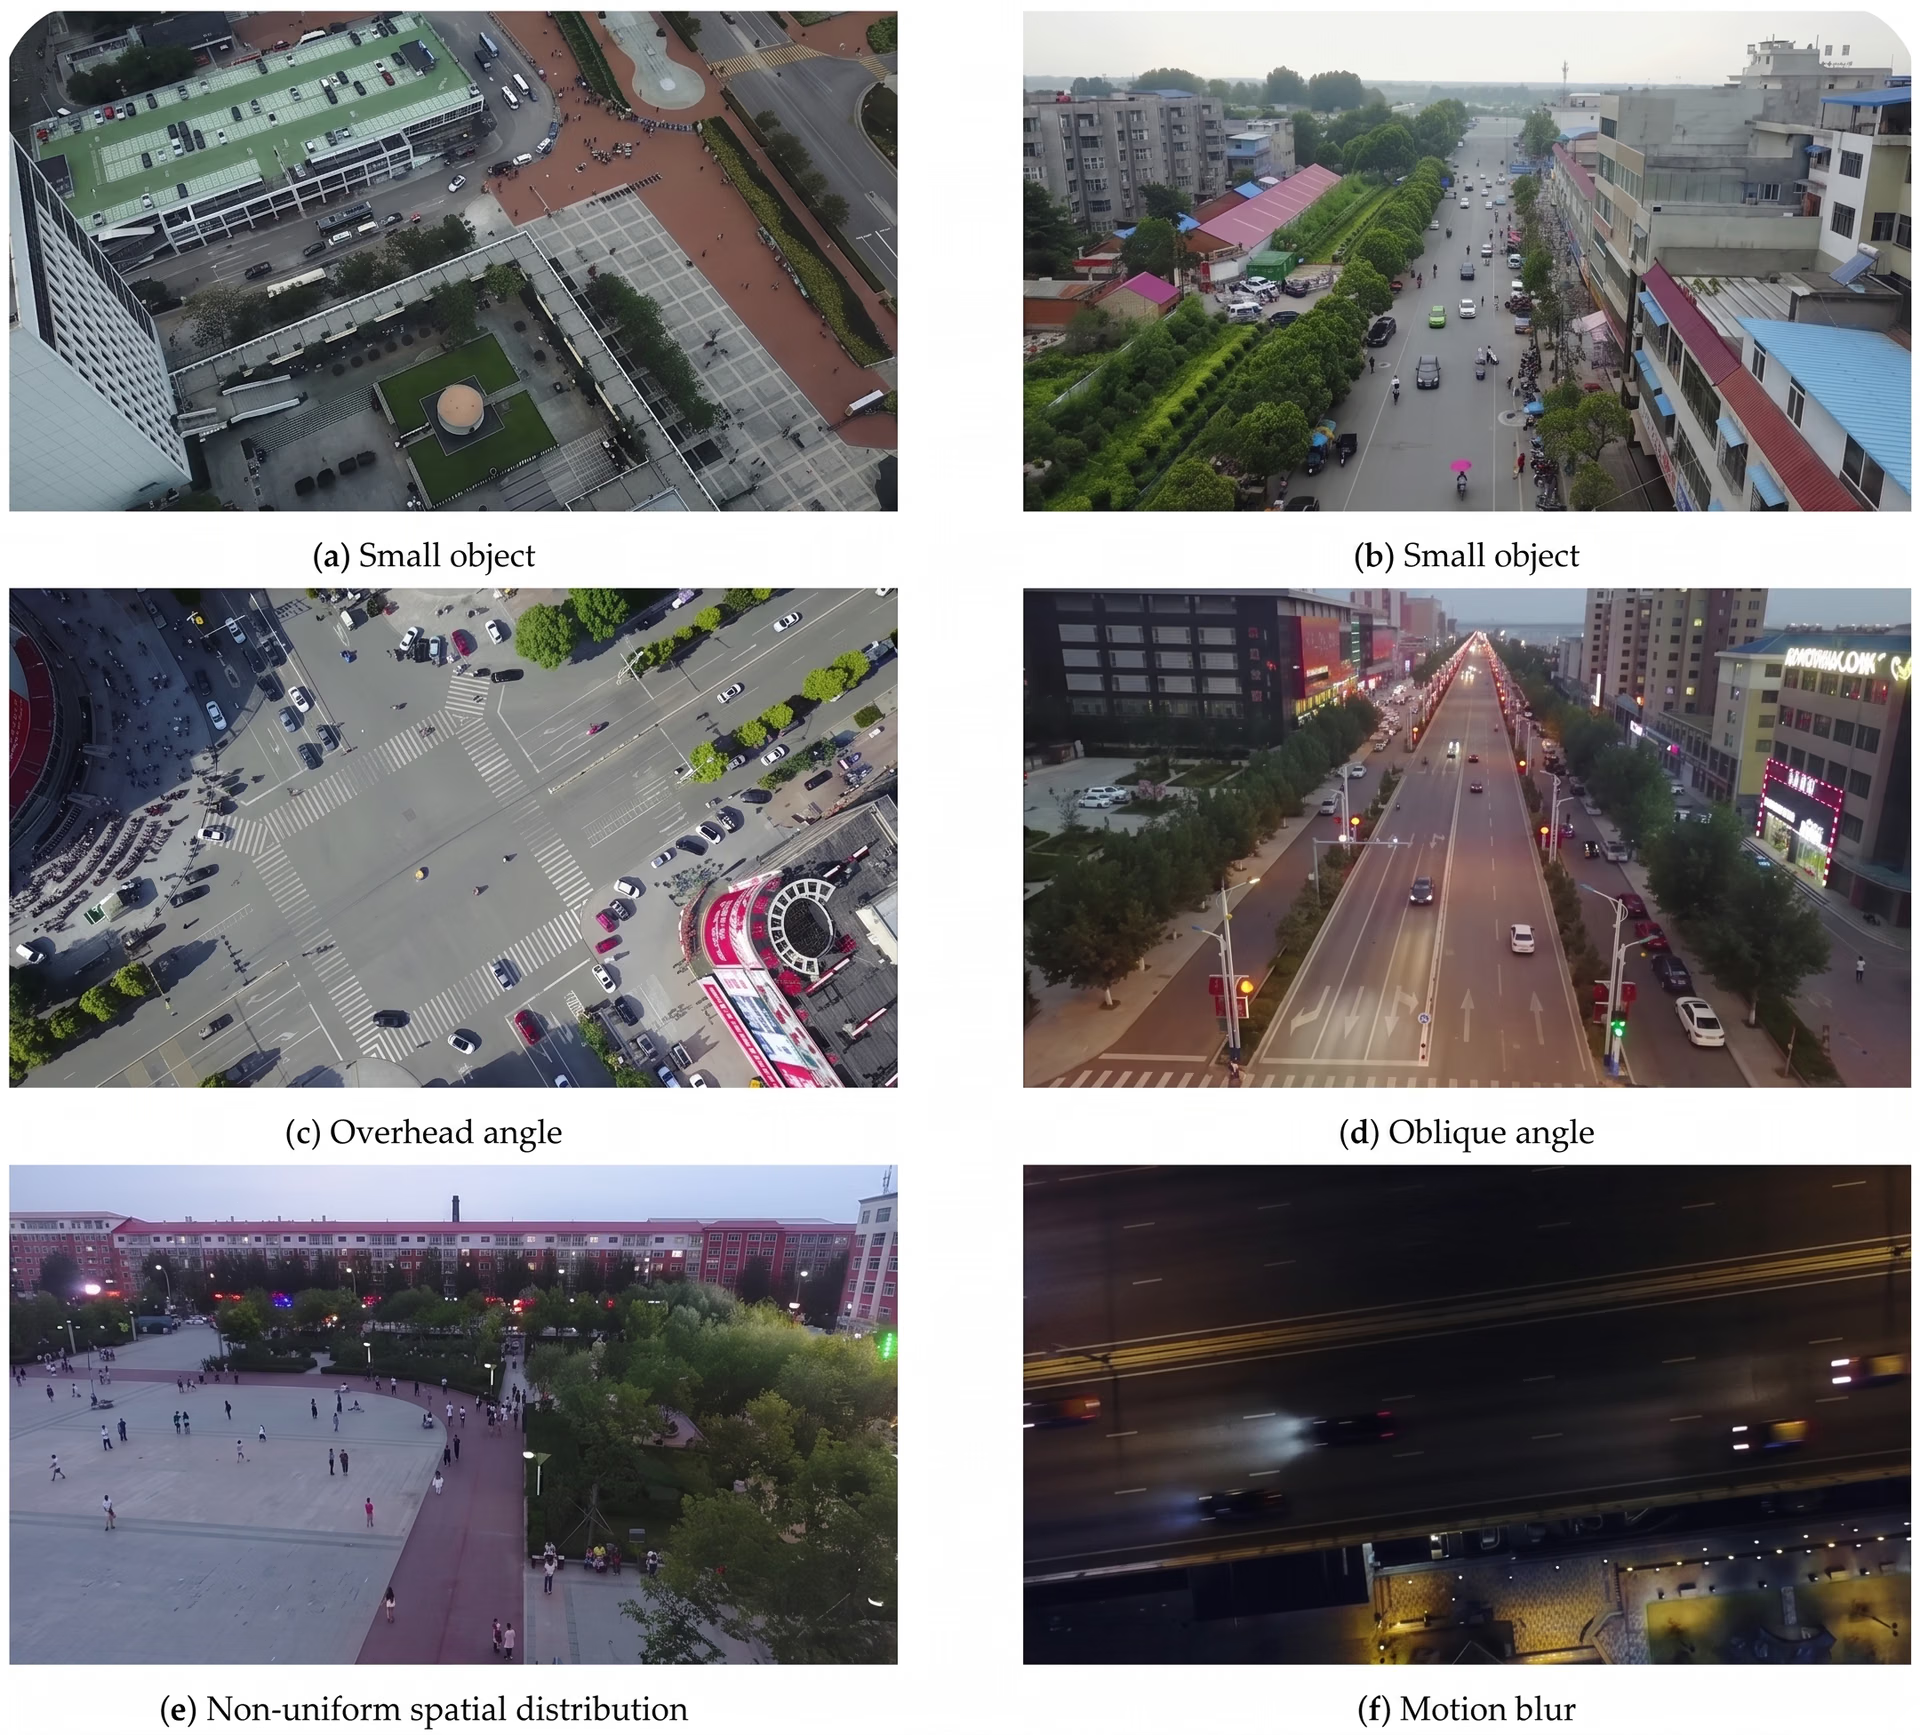
Abb. 1. Beispielbilder, auf denen kleine Objekte nur wenige Pixel einnehmen (Quelle)
Bei einer so geringen Pixelzahl können wichtige Details wie Kanten, Formen und Texturen unklar sein oder leicht verloren gehen. Während das Modell das Bild verarbeitet, wird es verkleinert und vereinfacht, um nützliche Muster hervorzuheben.
Das hilft dem Modell zwar, die Szene als Ganzes zu verstehen, kann feine Details aber noch weiter reduzieren. Bei kleinen Objekten sind diese Details oft entscheidend für eine korrekte Erkennung.
Diese Herausforderungen treten bei der Betrachtung von Evaluierungsmetriken noch deutlicher zutage. Kleine Objekte reagieren besonders empfindlich auf Lokalisierungsfehler. Schon eine leicht falsch ausgerichtete Bounding Box kann den erforderlichen Schwellenwert für Intersection over Union (IoU) unterschreiten.
In diesem Fall kann eine plausibel wirkende Vorhersage als falsch gewertet werden. Dadurch sinken sowohl die Präzision als auch der Recall, was letztlich die mittlere durchschnittliche Präzision (mAP) verringert.
Da diese Faktoren eng miteinander zusammenhängen, muss man zur Leistungsverbesserung oft das gesamte System berücksichtigen. Das bedeutet, Bildauflösung, Merkmalsextraktion, Modelldesign und Evaluierungseinstellungen sorgfältig auszubalancieren, damit feine visuelle Details besser erhalten bleiben und interpretiert werden können.
Die Bedeutung von Datenqualität und Annotationen#
Bei der Erkennung kleiner Objekte hat die Qualität eines Datensatzes oft den größten Einfluss auf die Leistung. Kleine Objekte nehmen nur einen winzigen Teil eines Bildes ein, sodass dem Modell nur sehr wenige visuelle Informationen zum Lernen zur Verfügung stehen. Deshalb sind die Trainingsdaten besonders wichtig. Enthält der Datensatz nicht genügend klare und repräsentative Beispiele, fällt es dem Objekterkennungsmodell schwer, beständige Muster zu erkennen.
Datensätze, die sich gut für die Erkennung kleiner Objekte eignen, enthalten in der Regel hochauflösende Bilder, häufige Aufnahmen kleiner Zielobjekte und einheitliche visuelle Bedingungen. Allgemeine Datensätze wie der COCO-Datensatz sind zwar ein nützlicher Ausgangspunkt, entsprechen aber oft nicht dem Maßstab, der Dichte oder dem Kontext bestimmter Anwendungsfälle in der Praxis. In solchen Fällen ist das Sammeln domänenspezifischer Trainingsdaten erforderlich, um die Modellleistung zu verbessern.
Auch die Annotationsqualität spielt eine entscheidende Rolle. Annotationen legen die Ground Truth fest, indem sie die korrekten Objektbezeichnungen und Positionen der Bounding Boxen angeben, die das Modell vorherzusagen lernt.
Bei kleinen Objekten müssen Bounding Boxen sorgfältig und einheitlich eingezeichnet werden. Schon geringfügige Unterschiede bei der Positionierung der Box können die Lokalisierungsgenauigkeit merklich beeinträchtigen, da kleine Objekte sehr empfindlich auf Verschiebungen um einzelne Pixel reagieren.
Schlechte oder uneinheitliche Annotationen können die mAP erheblich senken. Werden Objekte falsch beschriftet, lernt das Modell falsche Muster, was die Zahl falsch positiver Ergebnisse erhöhen kann.
Sind Objekte im Bild vorhanden, fehlen aber in der Ground Truth, können korrekte Erkennungen bei der Evaluierung als falsch positive Ergebnisse gewertet werden. Beide Situationen senken die Gesamtleistung.
Interessanterweise zeigen aktuelle Forschungsergebnisse, dass die durchschnittliche Präzision bei kleinen Objekten in standardisierten Benchmarks oft zwischen 20 % und 40 % liegt und damit deutlich niedriger ist als bei größeren Objekten. Diese Lücke unterstreicht, wie wichtig die Gestaltung des Datensatzes und einheitliche Annotationen für die Gesamtgenauigkeit der Erkennung sind.
Datenaugmentation kann entscheidend zur Genauigkeitsverbesserung beitragen#
Da wir nun die Bedeutung der Datenqualität und einheitlicher Annotationen besser verstehen, sehen wir uns an, wie ein Objekterkennungsmodell effektiver aus vorhandenen Daten lernen kann. Selbst wenn es schwierig oder teuer ist, zusätzliche Bilder zu sammeln, gibt es Möglichkeiten, die Leistung zu verbessern, indem die bereits verfügbaren Daten besser genutzt werden.
Eine der praktischsten Methoden ist die Datenaugmentation. Sie spielt bei der Erkennung kleiner Objekte eine besonders wichtige Rolle, weil kleine Objekte dem Modell weniger visuelle Anhaltspunkte zum Lernen bieten. Durch kontrollierte Variationen während des Trainings hilft die Augmentation dem Modell, besser zu generalisieren, ohne dass neue Daten gesammelt werden müssen.
Bei einer wirksamen Datenaugmentation bleiben kleine Objekte klar sichtbar. Verfahren wie kontrolliertes Skalieren, moderates Zuschneiden und das Kacheln von Bildern können kleine Objekte stärker hervorheben und zugleich ihre Form und ihr Erscheinungsbild bewahren. Ziel ist, dem Modell kleine Objekte häufiger und unter leicht unterschiedlichen Bedingungen zu zeigen, ohne ihr Aussehen in realen Situationen zu verändern.
Augmentation muss jedoch sorgfältig angewendet werden. Manche Transformationen können kleine Objekte weniger sichtbar machen oder ihr Erscheinungsbild auf eine Weise verändern, die in realen Daten unwahrscheinlich ist. In solchen Fällen kann es dem Modell schwerfallen, genaue Objektgrenzen zu lernen.
Intelligentere Datenaugmentation mit generativer KI#
Eine weitere interessante Form der Datenaugmentation, die immer beliebter wird, ist der Einsatz generativer KI zur Erstellung synthetischer Trainingsdaten. Statt sich auf manuell gesammelte und beschriftete Bilder zu verlassen, können Teams inzwischen realistische Szenen erzeugen, die bestimmte Umgebungen, Objektgrößen, Lichtverhältnisse und Hintergrundvariationen nachbilden.
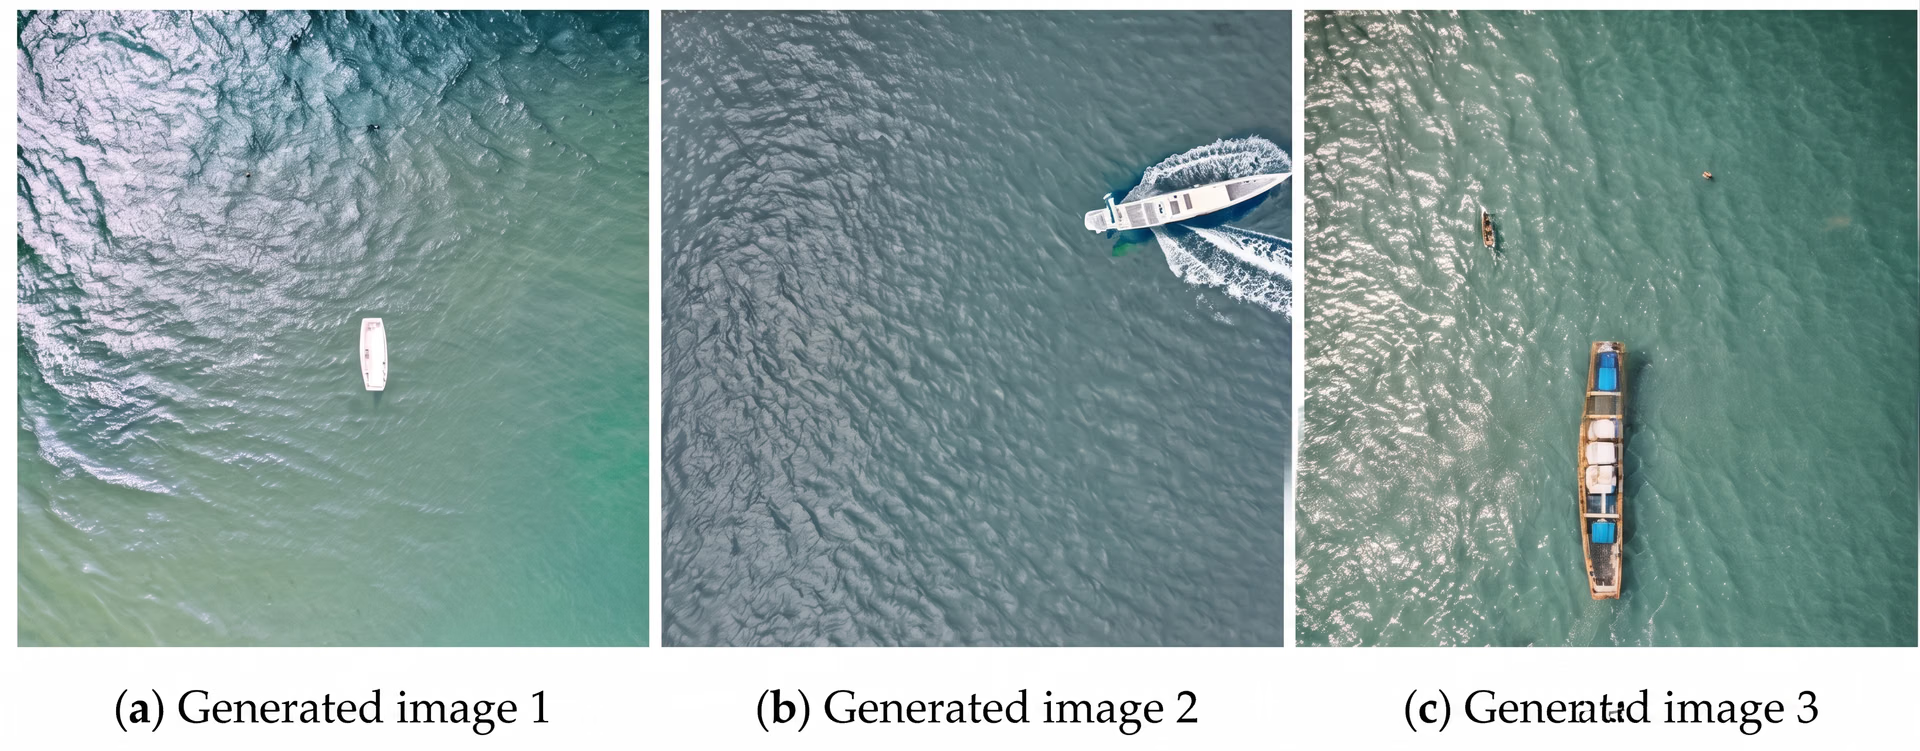
Abb. 2. Ein Blick auf synthetische Luftaufnahmen zur Datenaugmentation (Quelle)
Dieser Ansatz ist besonders nützlich für die Erkennung kleiner Objekte, für die sich reale Beispiele unter Umständen nur schwer regelmäßig aufnehmen lassen. Indem sich das Erscheinungsbild kleiner Objekte in synthetischen Bildern gezielt steuern lässt, etwa durch Anpassung von Größe, Dichte und Position, können Modelle mit einem breiteren Spektrum an Trainingsszenarien konfrontiert werden.
Sorgfältig mit realen Daten kombiniert, kann synthetische Augmentation die Robustheit des Modells verbessern, die Kosten für die Datenerfassung senken und gezieltere Leistungsverbesserungen unterstützen.
Trainingsentscheidungen, die die mAP bei kleinen Objekten beeinflussen können#
Neben der Qualität des Datensatzes und der Einheitlichkeit der Annotationen haben auch Trainingsentscheidungen einen großen Einfluss auf die Leistung bei der Erkennung kleiner Objekte.
Hier sind einige wichtige Trainingsstrategien, die du berücksichtigen solltest:
- Beginne mit vortrainierten Modellen: Ein vortrainiertes Modell wie Ultralytics YOLO26 hat bereits allgemeine visuelle Muster anhand großer Bilddatensätze gelernt. Das bietet eine solide Ausgangsbasis, statt das Modell von Grund auf neu zu trainieren. Das ist besonders hilfreich, wenn kleine Objekte mit wenigen Daten erkannt werden sollen.
- Setze Transfer Learning gezielt ein: Transfer Learning bedeutet, ein vortrainiertes Modell an deinen spezifischen Datensatz anzupassen. Dadurch kann sich das Modell auf deine kleinen Objekte konzentrieren und zugleich Overfitting reduzieren (das Auswendiglernen der Trainingsdaten, statt allgemeine Muster zu lernen).
- Berücksichtige eine unausgewogene Klassenverteilung: Wenn kleine Objekte seltener auftreten als größere, konzentriert sich das Modell möglicherweise stärker darauf, größere Objekte zu lernen. Verfahren wie Klassengewichtung oder Sampling-Strategien helfen dabei, sicherzustellen, dass kleine Objekte nicht ignoriert werden.
- Stimme Konfidenz- und IoU-Schwellenwerte ab: Kleine Objekte reagieren empfindlich auf geringfügige Lokalisierungsfehler. Durch die Feinabstimmung dieser Schwellenwerte lassen sich die Leistung bei kleinen Objekten während der Validierung und Inferenz besser bewerten und interpretieren.
Überlegungen zur Modellarchitektur bei der Erkennung kleiner Objekte#
Für Aufgaben zur Erkennung kleiner Objekte kannst du zwar ein allgemeines Objekterkennungsmodell verwenden, es gibt aber auch Modellarchitekturen, die gezielt auf eine bessere Erkennung kleiner Objekte ausgelegt sind. So gibt es beispielsweise P2-Modellvarianten des Modells Ultralytics YOLOv8, die feine räumliche Details besser bewahren.
Ultralytics YOLOv8 verarbeitet Bilder auf mehreren Maßstabsebenen und verkleinert sie schrittweise, während sie sich tiefer durch das Netzwerk bewegen. So kann das Modell die Szene als Ganzes erfassen, gleichzeitig gehen dabei jedoch feine Details verloren.
Ist ein Objekt bereits sehr klein, können bei diesem Vorgang wichtige visuelle Informationen verschwinden. Die P2-Variante von Ultralytics YOLOv8 wirkt dem entgegen, indem sie in ihrer Feature-Pyramide eine Schrittweite von 2 verwendet.
Eine Feature-Pyramide ist der Teil des Modells, der das Bild auf mehreren internen Auflösungsstufen analysiert, damit Objekte unterschiedlicher Größe erkannt werden können. Bei einer Schrittweite von 2 wird das Bild auf dieser Stufe schrittweise verkleinert, wodurch mehr Details auf Pixelebene erhalten bleiben.
Da mehr räumliche Details erhalten bleiben, behalten kleine Objekte im Netzwerk mehr von ihrer sichtbaren Struktur. Dadurch kann das Modell Objekte, die nur wenige Pixel einnehmen, leichter lokalisieren und erkennen, was die mAP bei kleinen Objekten verbessern kann.
Größenabhängige Evaluierung bei der Erkennung kleiner Objekte#
Die mittlere durchschnittliche Präzision fasst zwar die Gesamtleistung eines Modells zusammen, zeigt aber nicht immer, wie gut das Modell mit Objekten unterschiedlicher Größe zurechtkommt. Bei kleinen Objekten wird die Leistung oft eher durch die Lokalisierungsgenauigkeit als allein durch die Klassifizierung begrenzt. Das bedeutet, dass schon geringfügige Verschiebungen der Bounding Box die Ergebnisse erheblich beeinflussen können.
Mit anderen Worten: Das Modell kann die Klasse eines Objekts korrekt erkennen, doch wenn die vorhergesagte Bounding Box leicht falsch ausgerichtet ist, kann die Erkennung trotzdem als falsch gelten. Da kleine Objekte nur wenige Pixel einnehmen, kann bereits eine geringfügige Verschiebung der Boxposition die Überschneidung zwischen der vorhergesagten Box und der Ground Truth deutlich verringern. Dadurch können die Evaluierungswerte sinken, obwohl das Objekt korrekt erkannt wurde.
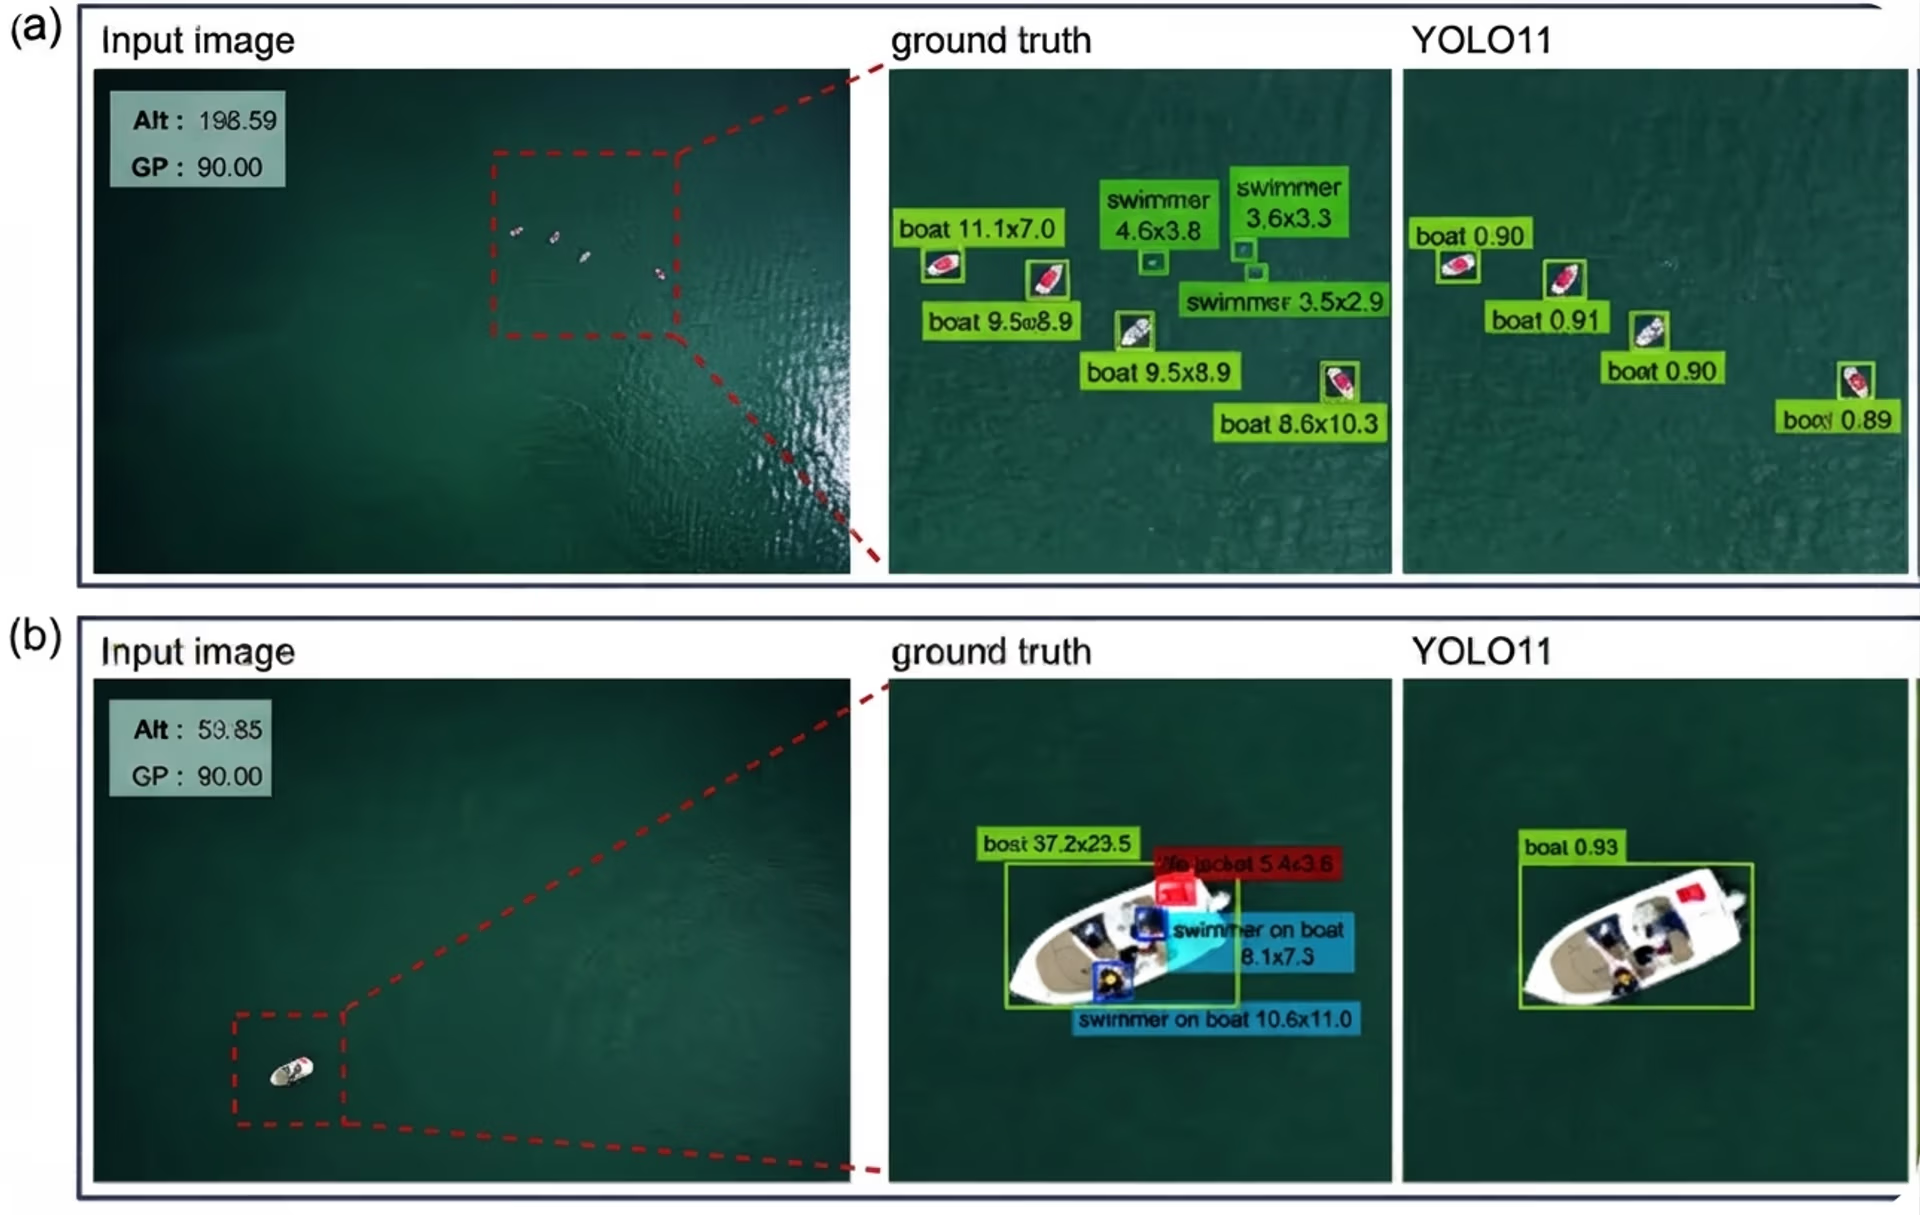
Abb. 3. Die Evaluierung der Erkennung kleiner Objekte kann knifflig sein (Quelle)
Ein aussagekräftigerer Ansatz ist, die Leistung nach Objektgröße auszuwerten. Die meisten weit verbreiteten Benchmarks weisen die durchschnittliche Präzision getrennt für kleine, mittelgroße und große Objekte aus.
Diese nach Größe aufgeschlüsselte Auswertung zeigt deutlicher, wo das Modell gut abschneidet und wo es Schwierigkeiten hat. In der Praxis bleibt die AP kleiner Objekte oft hinter der Gesamt-mAP zurück. Das macht Lokalisierungsprobleme sichtbar, die in zusammengefassten Metriken möglicherweise nicht auffallen.
Berücksichtige die Einschränkungen der Bereitstellung und Zielkonflikte in der Praxis#
Die Modellleistung verändert sich häufig, wenn ein Modell von einer kontrollierten Testumgebung in den praktischen Einsatz überführt wird. Faktoren wie Bildauflösung, Verarbeitungsgeschwindigkeit und verfügbare Hardware bringen Zielkonflikte mit sich, die sich unmittelbar auf die Erkennung kleiner Objekte auswirken.
Eine höhere Eingabeauflösung kann beispielsweise die mAP bei kleinen Objekten verbessern, weil kleine Zielobjekte mehr Pixel einnehmen und mehr Details behalten. Eine höhere Auflösung steigert jedoch auch den Speicherbedarf und die Verarbeitungszeit. Das kann die Inferenz verlangsamen und die Betriebskosten erhöhen.
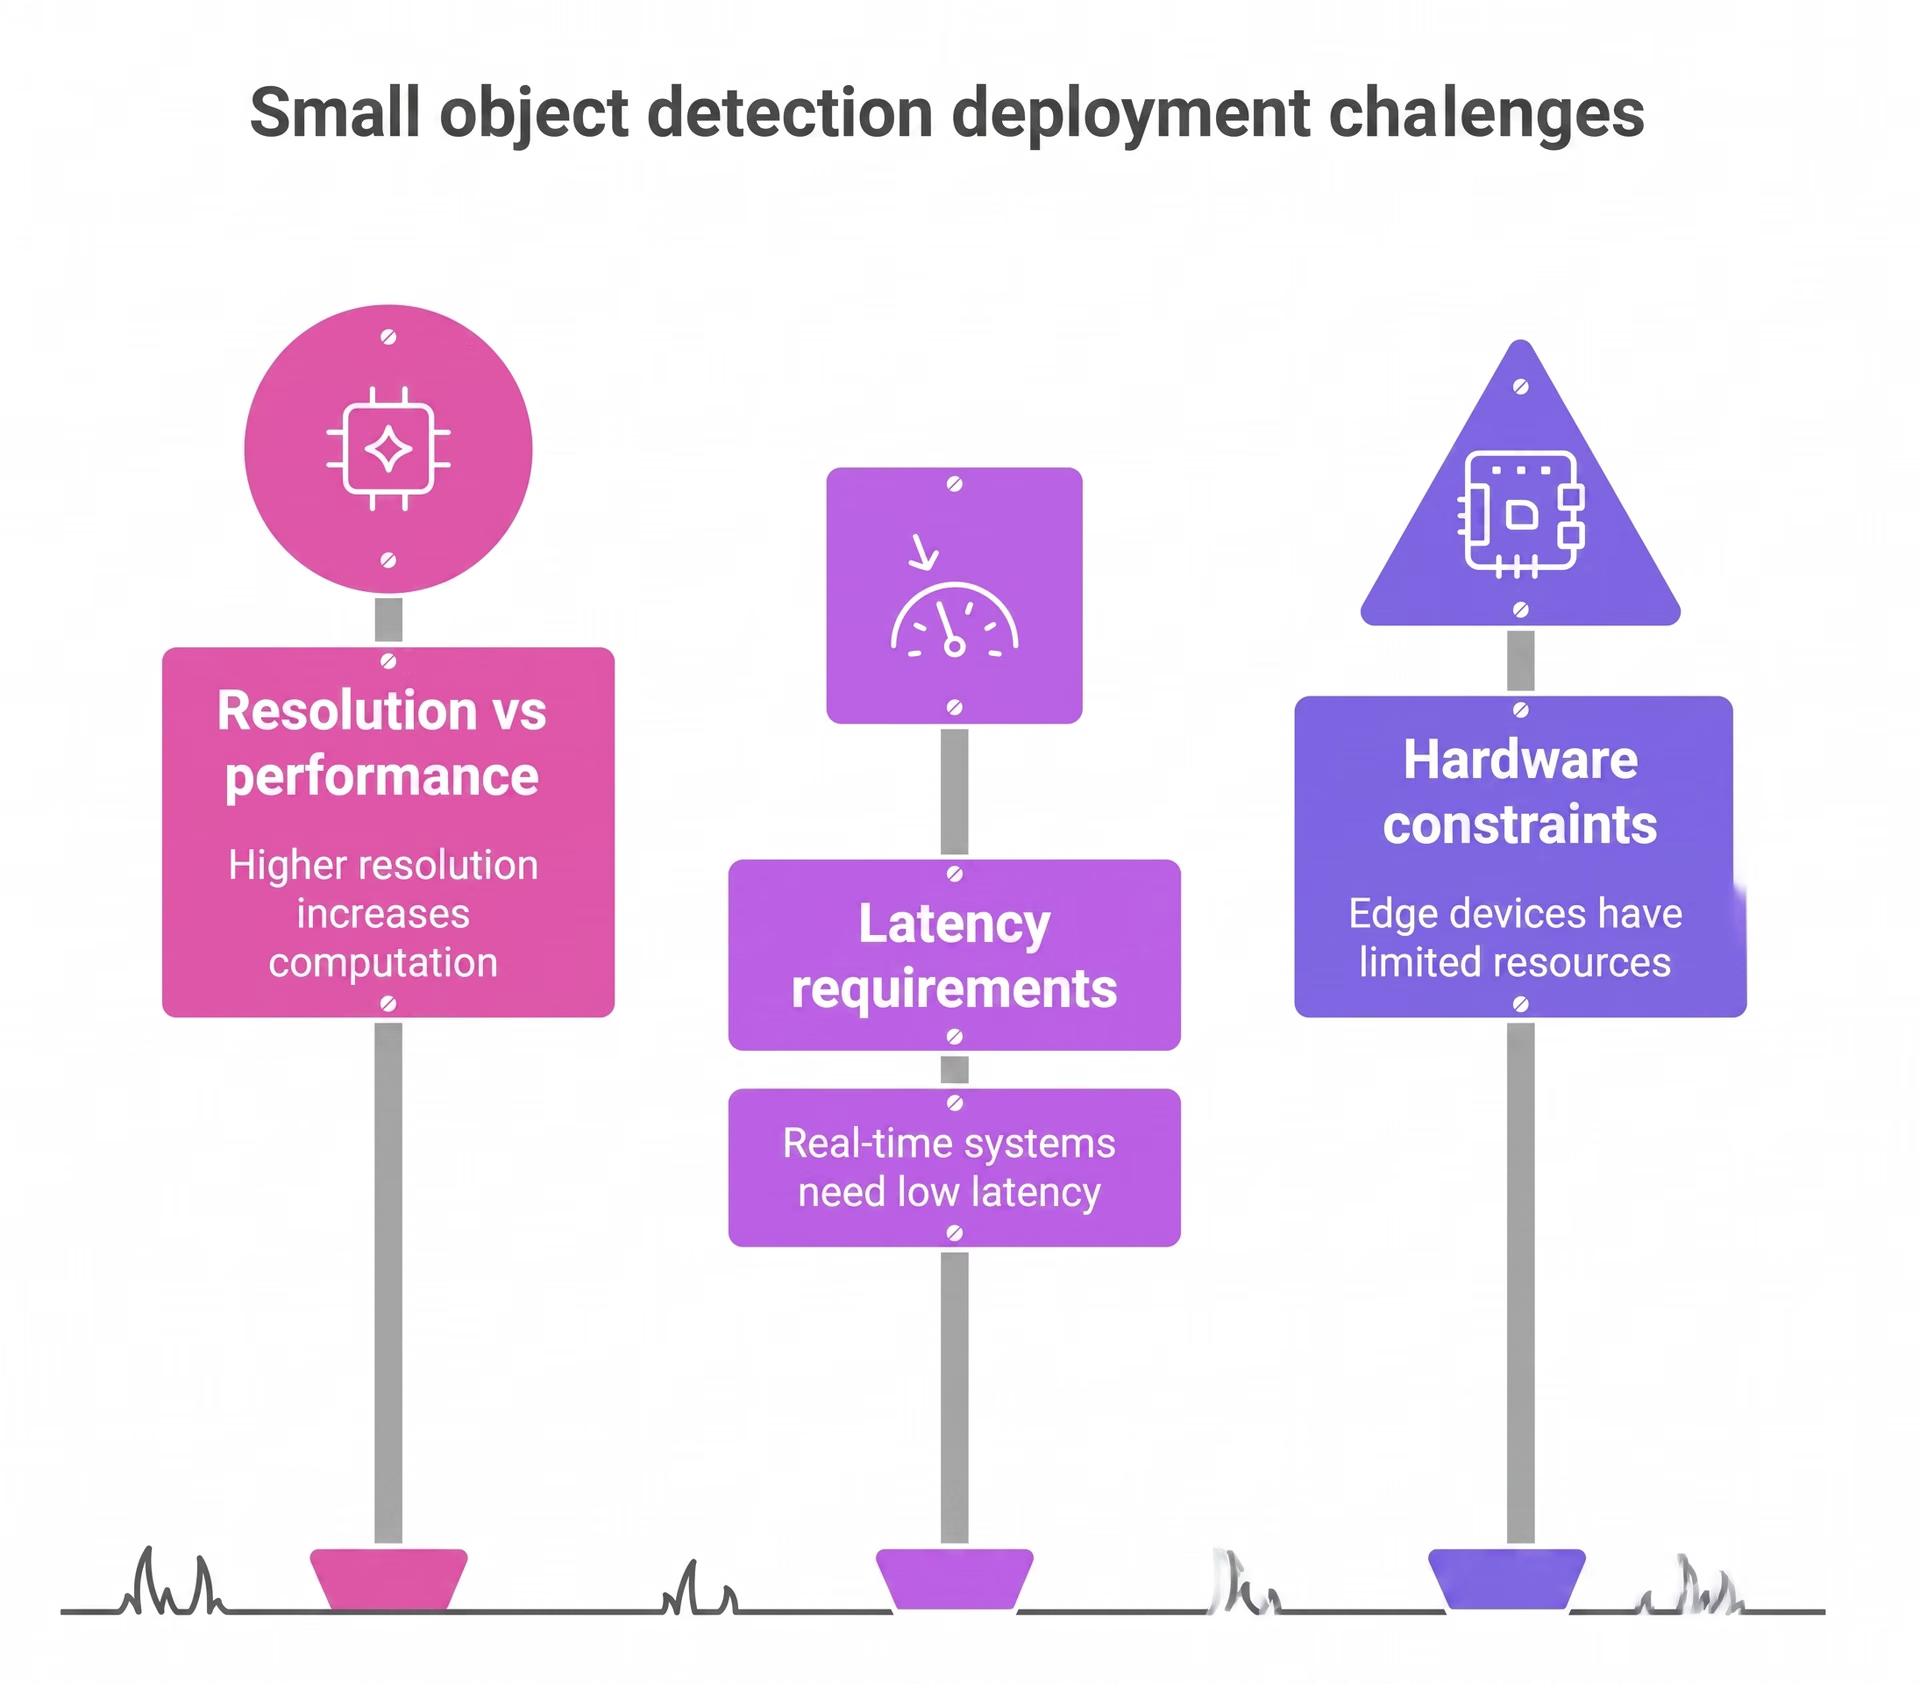
Abb. 4. Herausforderungen beim Einsatz zur Erkennung kleiner Objekte. Bild vom Autor.
Die Wahl der Hardware spielt eine wichtige Rolle, wenn es darum geht, diese Zielkonflikte zu bewältigen. Leistungsstärkere GPUs ermöglichen größere Modelle und eine schnellere Verarbeitung, doch in Einsatzumgebungen, insbesondere auf Edge-Geräten, sind die verfügbaren Rechen- und Speicherressourcen oft begrenzt.
Echtzeitanwendungen bringen eine weitere Einschränkung mit sich: Um eine geringe Latenz zu gewährleisten, muss möglicherweise die Modellgröße oder die Eingabeauflösung reduziert werden, was den Recall bei kleinen Objekten beeinträchtigen kann. Letztlich müssen bei der Bereitstellung die Erkennungsleistung, die Hardwarebeschränkungen, die Geschwindigkeitsanforderungen und die Gesamtkosten gegeneinander abgewogen werden.
Alles zusammenführen: Die mAP des Modells bei kleinen Objekten verbessern#
Die Erkennung kleiner Objekte lässt sich am besten mit einem praxisnahen, strukturierten Ansatz verbessern, besonders in realen Umgebungen. Hier findest du einen Überblick über die wichtigsten Schritte:
- Prüfe die Qualität deines Datensatzes: Stelle sicher, dass dein Datensatz genügend Beispiele kleiner Objekte enthält, nach Möglichkeit hochauflösende Bilder verwendet und die Bedingungen widerspiegelt, unter denen das Modell eingesetzt wird.
- Überprüfe die Einheitlichkeit der Annotationen: Stelle sicher, dass die Bounding Boxen genau, vollständig und einheitlich beschriftet sind. Uneinheitliche Annotationen können die Lokalisierungsleistung unmittelbar begrenzen.
- Stimme die Trainingseinstellungen gezielt ab: Passe Batch-Größe, Anzahl der Epochen und Optimierungseinstellungen sorgfältig an, damit kleine Objekte während des Trainings angemessen berücksichtigt werden.
- Gehe schrittweise vor: Nimm kontrollierte Anpassungen vor, miss ihre Auswirkungen und verfeinere deinen Ansatz. Kontinuierliche, datengestützte Iterationen führen mit der Zeit zu beständigen Verbesserungen.
Die wichtigsten Erkenntnisse#
Die mAP bei kleinen Objekten lässt sich besser mit einem strukturierten, datengestützten Ansatz verbessern als mit zufälligen Anpassungen. Wirkliche Fortschritte entstehen durch die Kombination guter Daten, einheitlicher Annotationen, sorgfältigen Trainings und geeigneter Evaluierungsmethoden. In realen Projekten führen kontinuierliche Tests und kleine, messbare Änderungen mit der Zeit zu einer besseren und zuverlässigeren Erkennung kleiner Objekte.
Werde Teil unserer wachsenden Community und entdecke unser GitHub-Repository mit praxisnahen KI-Ressourcen. Wenn du heute mit Vision AI entwickeln möchtest, informiere dich über unsere Lizenzoptionen. Erfahre auf unseren Lösungsseiten, wie KI in der Landwirtschaft den Ackerbau verändert und wie Vision AI in der Robotik die Zukunft mitgestaltet.








