Was ist Mask R-CNN und wie funktioniert es?
Erfahre, wie Mask R-CNN funktioniert – vom Backbone und Region Proposal Network über ROI Align bis zur Maskenvorhersage – und lerne seine Einsatzgebiete, Grenzen und YOLO-Nachfolger kennen.
 Abirami Vina8 Min. Lesezeit
Roboter in Lagerhallen, selbstfahrende Autos, die sich sicher durch belebte Straßen bewegen, Drohnen, die Felder überwachen, und KI-Systeme, die Produkte in Fabriken kontrollieren, werden mit der zunehmenden Verbreitung von KI immer alltäglicher. Eine Schlüsseltechnologie hinter diesen Innovationen ist das maschinelle Sehen, ein Teilgebiet der KI, das Maschinen ermöglicht, visuelle Daten zu verstehen und zu interpretieren.
Die Objekterkennung ist beispielsweise eine Aufgabe des maschinellen Sehens, mit der sich Objekte in Bildern anhand von Begrenzungsrahmen erkennen und lokalisieren lassen. Begrenzungsrahmen liefern zwar nützliche Informationen, geben aber nur eine ungefähre Position des Objekts an und können dessen genaue Form oder Grenzen nicht erfassen. Dadurch sind sie für Anwendungen, die eine präzise Erkennung erfordern, weniger geeignet.
Um dieses Problem zu lösen, entwickelten Forscher Segmentierungsmodelle, die die exakten Konturen von Objekten erfassen und Details auf Pixelebene für eine genauere Erkennung und Analyse liefern.
Mask R-CNN ist eines dieser Modelle. Es wurde 2017 von Facebook AI Research (FAIR) vorgestellt und baut auf früheren Modellen wie R-CNN, Fast R-CNN und Faster R-CNN auf. Als wichtiger Meilenstein in der Geschichte des maschinellen Sehens ebnete Mask R-CNN den Weg für fortschrittlichere Modelle wie Ultralytics YOLO11.
In diesem Artikel erklären wir, was Mask R-CNN ist, wie es funktioniert, wofür es eingesetzt wird und welche Verbesserungen danach folgten und schließlich zu Ultralytics YOLO11 führten.
Überblick über Mask R-CNN#
Mask R-CNN, kurz für Mask Region-based Convolutional Neural Network, ist ein Deep-Learning-Modell für Aufgaben des maschinellen Sehens wie Objekterkennung und Instanzsegmentierung.
Die Instanzsegmentierung geht über die herkömmliche Objekterkennung hinaus: Sie erkennt nicht nur Objekte in einem Bild, sondern grenzt jedes einzelne auch präzise ab. Jedem erkannten Objekt wird eine eindeutige Bezeichnung zugewiesen, und seine genaue Form wird auf Pixelebene erfasst. Dieser detaillierte Ansatz ermöglicht es, überlappende Objekte klar voneinander zu unterscheiden und komplexe Formen präzise zu erfassen.
Mask R-CNN baut auf Faster R-CNN auf, das Objekte erkennt und kennzeichnet, ihre genauen Formen jedoch nicht bestimmt. Mask R-CNN verbessert dieses Verfahren, indem es die exakten Pixel identifiziert, aus denen jedes Objekt besteht. So ist eine wesentlich detailliertere und genauere Bildanalyse möglich.
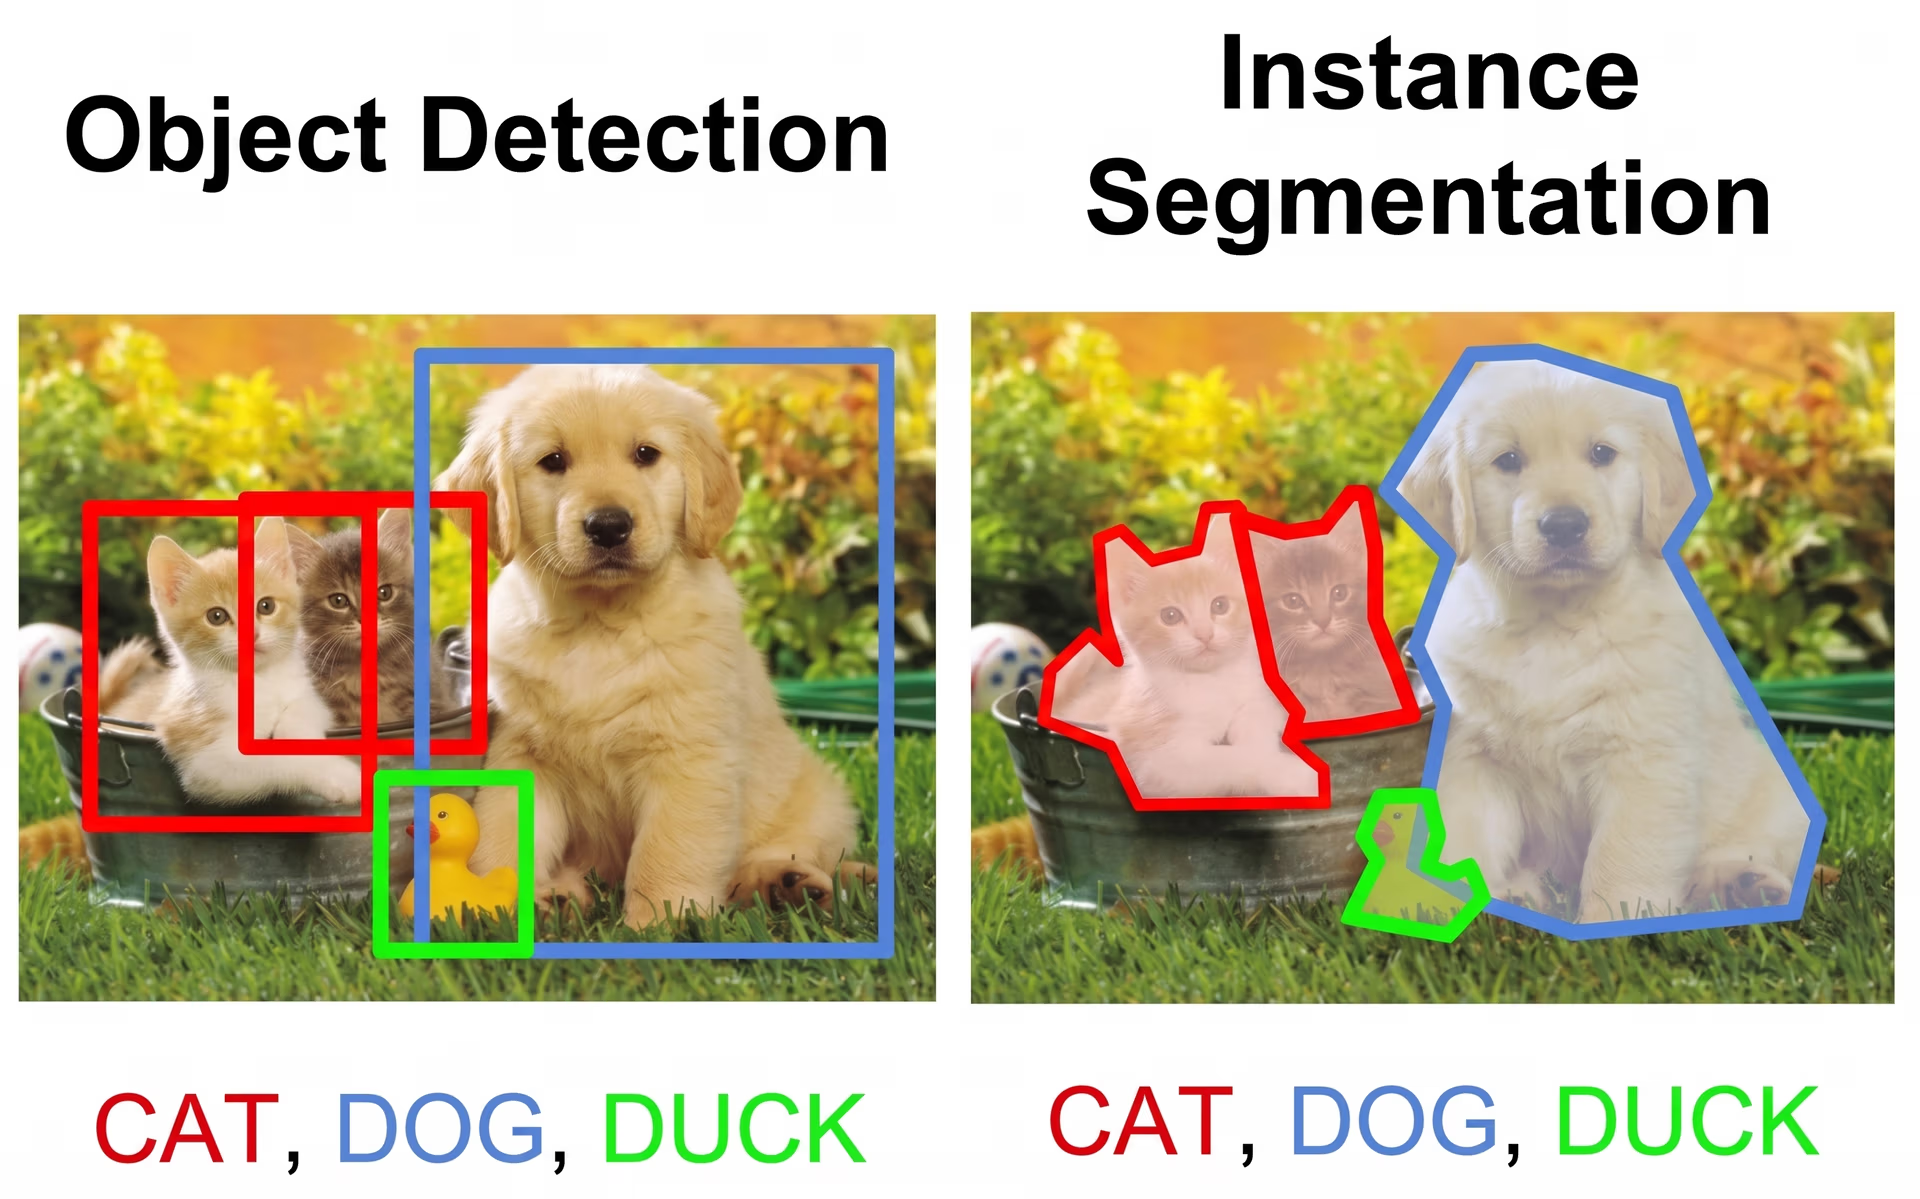
Abb. 1 Vergleich von Objekterkennung und Instanzsegmentierung.
Die Architektur von Mask R-CNN und ihre Funktionsweise#
Mask R-CNN erkennt und segmentiert Objekte präzise in mehreren Schritten. Zunächst extrahiert es mithilfe eines tiefen neuronalen Netzes – eines mehrschichtigen Modells, das aus Daten lernt – wichtige Merkmale. Anschließend identifiziert es mögliche Objektbereiche mithilfe eines Region Proposal Network, einer Komponente, die wahrscheinliche Objektbereiche vorschlägt. Schließlich verfeinert es diese Bereiche, indem es detaillierte Segmentierungsmasken erstellt, also präzise Umrisse der Objekte, die die genaue Form jedes Objekts erfassen.
Im Folgenden gehen wir die einzelnen Schritte durch, um die Funktionsweise von Mask R-CNN besser zu verstehen.
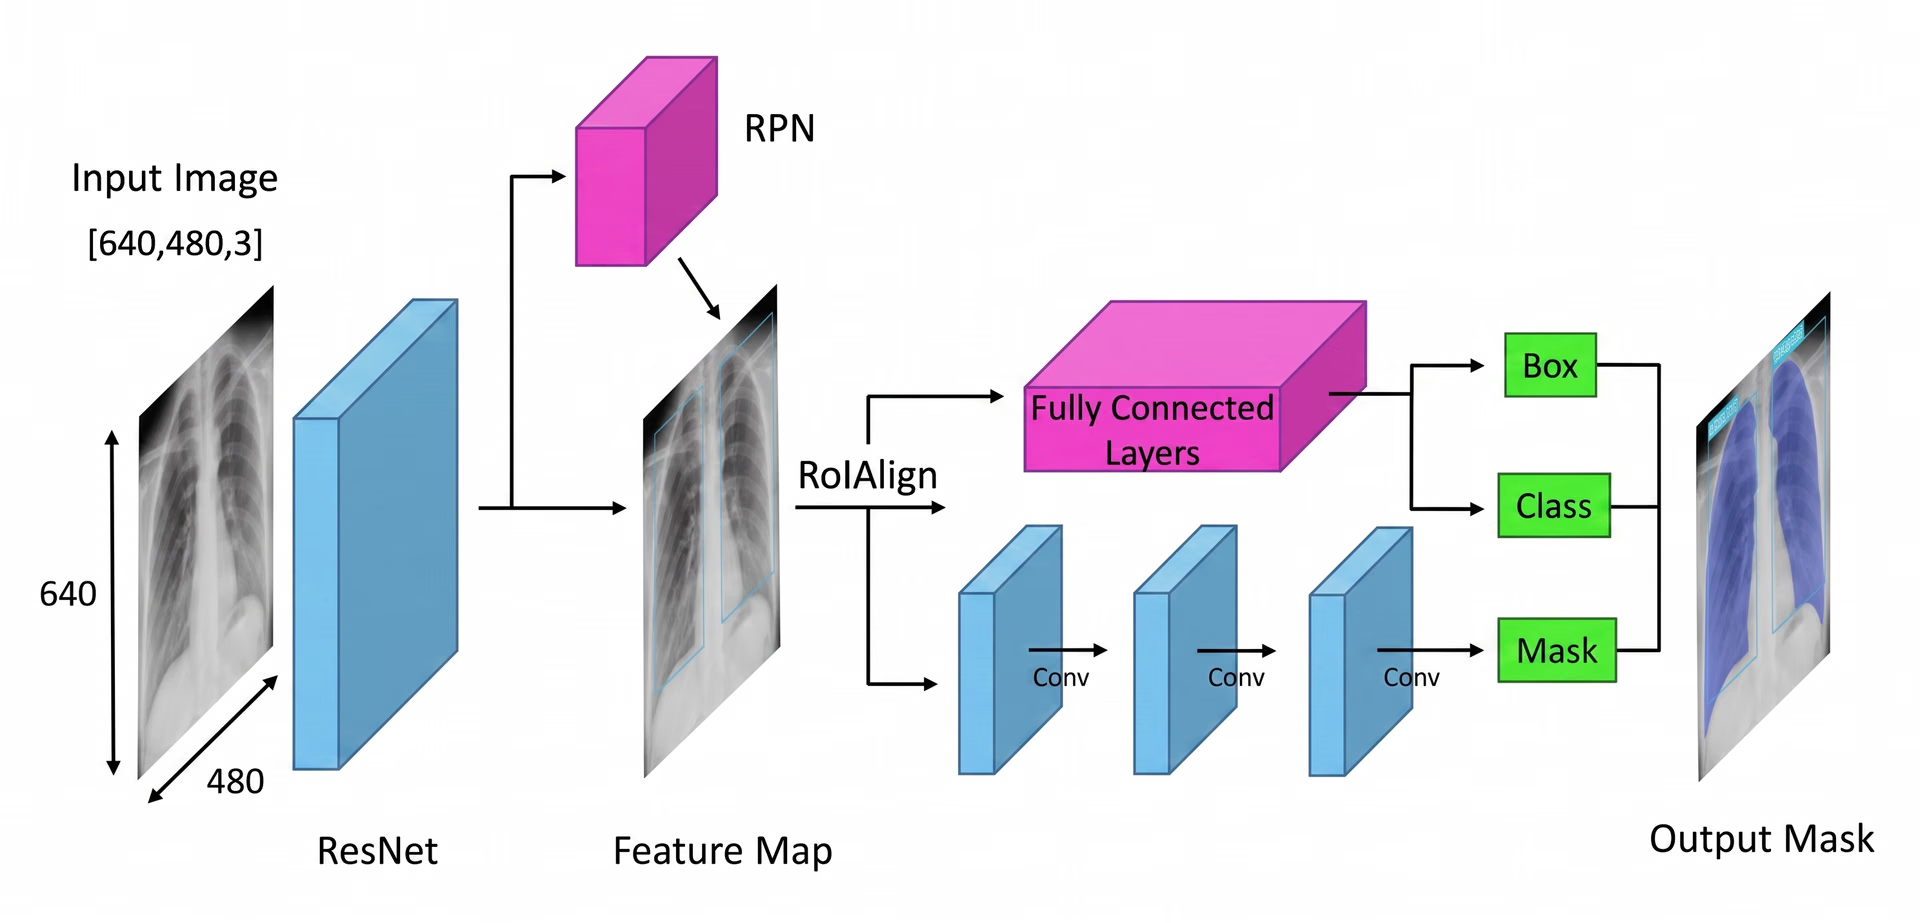
Abb. 2. Überblick über die Architektur von Mask R-CNN (Quelle: researchgate.net).
Beginn mit der Merkmalsextraktion#
Im ersten Schritt der Mask-R-CNN-Architektur wird das Bild in seine wichtigsten Bestandteile zerlegt, damit das Modell versteht, was darauf zu sehen ist. Stell dir vor, du betrachtest ein Foto und bemerkst ganz automatisch Details wie Formen, Farben und Kanten. Ähnlich geht das Modell mit einem tiefen neuronalen Netz vor, dem sogenannten „Backbone“ (oft ResNet-50 oder ResNet-101). Dieses dient als Auge des Modells, scannt das Bild und erfasst wichtige Details.
Da Objekte in Bildern sehr klein oder sehr groß sein können, verwendet Mask R-CNN ein Feature-Pyramidennetzwerk. Das ist, als hätte man verschiedene Vergrößerungsgläser, mit denen das Modell sowohl feine Details als auch das Gesamtbild erkennen kann. So werden Objekte aller Größen erfasst.
Nachdem diese wichtigen Merkmale extrahiert wurden, macht sich das Modell daran, mögliche Objekte im Bild zu lokalisieren. Damit ist die Grundlage für die weitere Analyse geschaffen.
Mögliche Bereiche mit Objekten im Bild vorschlagen#
Nachdem das Bild auf wichtige Merkmale hin verarbeitet wurde, übernimmt das Region Proposal Network. Dieser Teil des Modells untersucht das Bild und schlägt Bereiche vor, die wahrscheinlich Objekte enthalten.
Dazu erzeugt das Netzwerk mehrere mögliche Objektpositionen, sogenannte Anker. Anschließend bewertet es diese Anker und wählt die aussichtsreichsten für die weitere Analyse aus. So konzentriert sich das Modell auf die Bereiche, die am ehesten interessant sind, anstatt jede einzelne Stelle im Bild zu überprüfen.
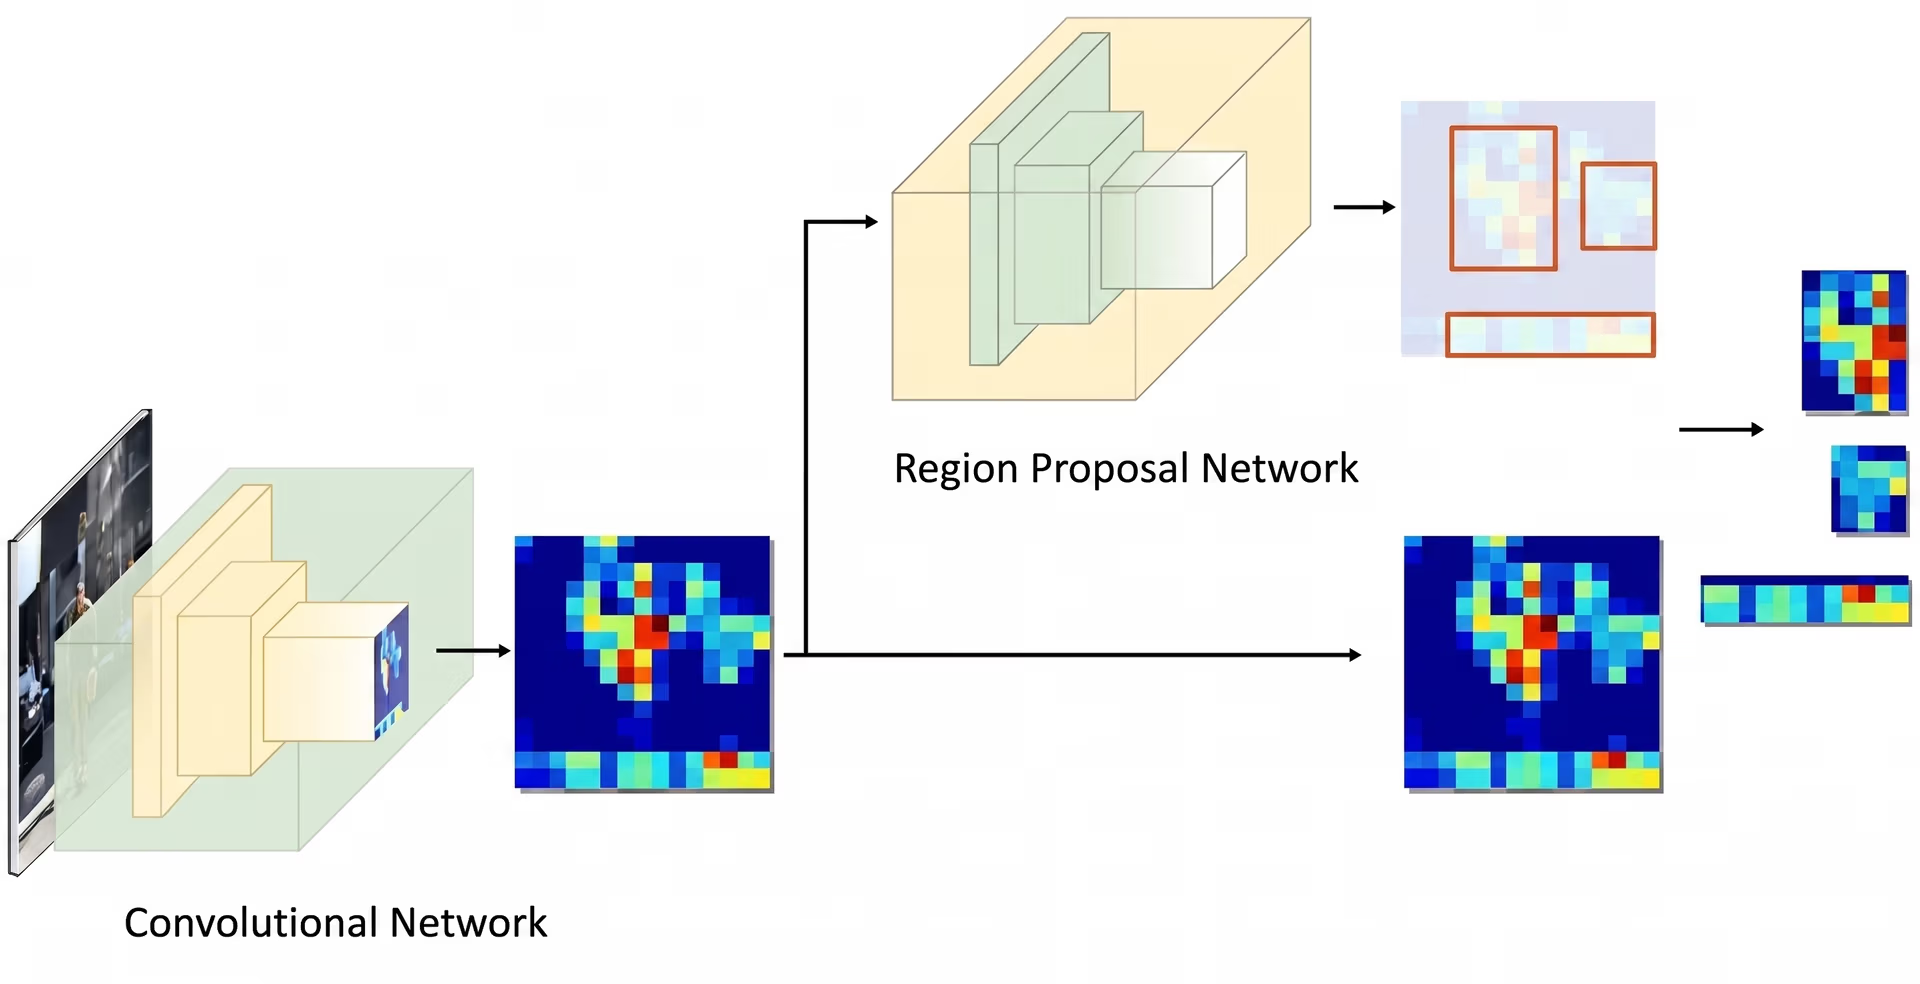
Abb. 3 Beispiel für ein Region Proposal Network.
Extrahierte Merkmale verbessern#
Nachdem die wichtigen Bereiche identifiziert wurden, besteht der nächste Schritt darin, die aus diesen Bereichen extrahierten Details zu verfeinern. Frühere Modelle verwendeten dafür ein Verfahren namens ROI Pooling (Pooling der interessierenden Region), um Merkmale aus jedem Bereich zu erfassen. Beim Skalieren von Bereichen führte diese Technik jedoch manchmal zu leichten Verschiebungen und war dadurch weniger effektiv – insbesondere bei kleineren oder überlappenden Objekten.
Mask R-CNN verbessert dieses Verfahren mit einer Technik namens ROI Align (Region of Interest Align). Anders als ROI Pooling, das Koordinaten rundet, nutzt ROI Align bilineare Interpolation, um Pixelwerte präziser zu schätzen. Bei der bilinearen Interpolation wird ein neuer Pixelwert als gewichteter Mittelwert der Werte seiner vier nächstgelegenen Nachbarpixel berechnet, wodurch weichere Übergänge entstehen. So bleiben die Merkmale korrekt am Originalbild ausgerichtet, was zu einer genaueren Objekterkennung und Segmentierung führt.
Bei einem Fußballspiel könnten beispielsweise zwei dicht beieinanderstehende Spieler miteinander verwechselt werden, weil sich ihre Begrenzungsrahmen überlappen. ROI Align hilft dabei, sie voneinander zu unterscheiden, indem ihre Formen klar getrennt bleiben.
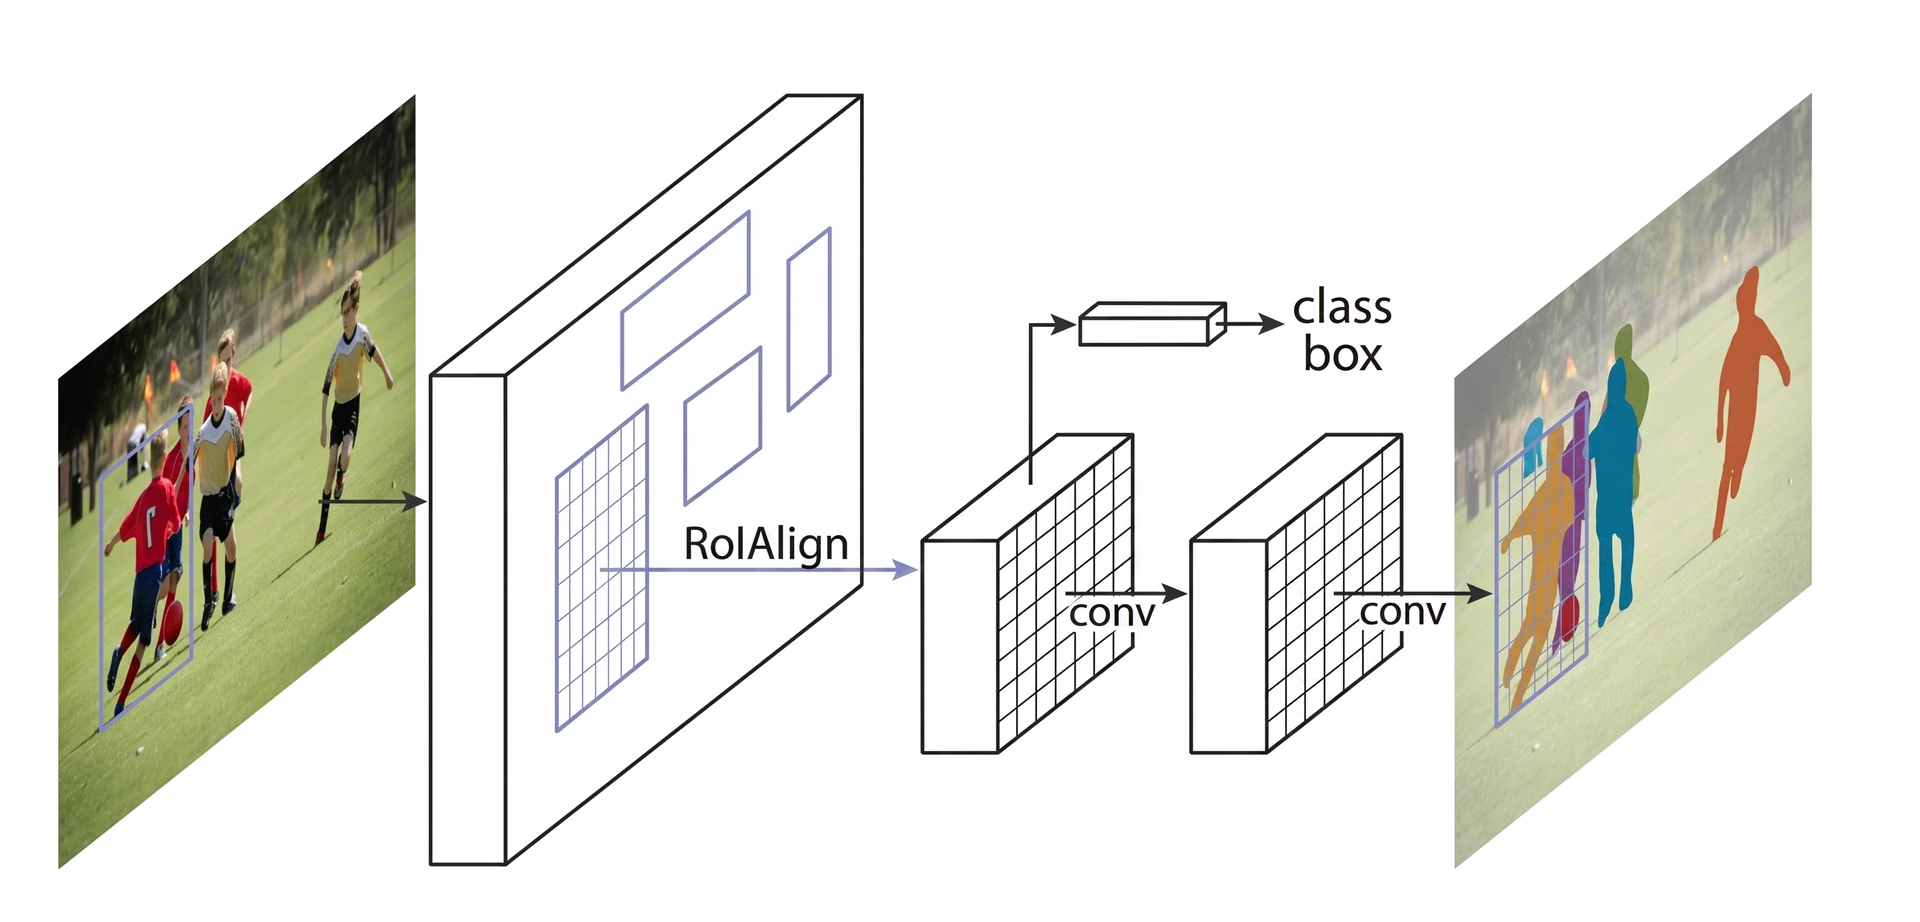
Abb. 4. Mask R-CNN verwendet ROI Align.
Objekte klassifizieren und ihre Masken vorhersagen#
Nachdem ROI Align das Bild verarbeitet hat, besteht der nächste Schritt darin, Objekte zu klassifizieren und ihre Positionen zu verfeinern. Das Modell untersucht jede extrahierte Region und bestimmt, welches Objekt sie enthält. Es weist verschiedenen Kategorien Wahrscheinlichkeitswerte zu und wählt die beste Übereinstimmung aus.
Gleichzeitig passt es die Begrenzungsrahmen so an, dass sie besser zu den Objekten passen. Die ursprünglichen Rahmen sitzen möglicherweise nicht optimal. Durch die Anpassung wird die Genauigkeit verbessert, da jeder Rahmen das erkannte Objekt eng umschließt.
Schließlich geht Mask R-CNN noch einen Schritt weiter: Für jedes Objekt wird parallel eine detaillierte Segmentierungsmaske erzeugt.
Mask R-CNN und seine Anwendungen in der Praxis#
Als dieses Modell veröffentlicht wurde, stieß es in der KI-Community auf große Begeisterung und kam bald in verschiedenen Anwendungen zum Einsatz. Durch seine Fähigkeit, Objekte mit Präzision auf Pixelebene zu erkennen und zu segmentieren, wurde es in zahlreichen Branchen beliebt.
Zum Beispiel ist es eine anspruchsvolle Aufgabe, bedrohte Tiere in freier Wildbahn zu verfolgen. Viele Arten bewegen sich durch dichte Wälder, was es Naturschützern erschwert, sie im Blick zu behalten. Herkömmliche Methoden nutzen Kamerafallen, Drohnen und Satellitenbilder, doch die manuelle Auswertung all dieser Daten ist zeitaufwendig. Fehlidentifizierungen und übersehene Sichtungen können die Naturschutzarbeit verlangsamen.
Anhand einzigartiger Merkmale wie Tigerstreifen, Giraffenflecken oder der Form von Elefantenohren kann Mask R-CNN Tiere in Bildern und Videos genauer erkennen und segmentieren. Selbst wenn Tiere teilweise von Bäumen verdeckt werden oder dicht beieinanderstehen, kann das Modell sie voneinander trennen und einzeln identifizieren. Dadurch wird die Überwachung von Wildtieren schneller und zuverlässiger.
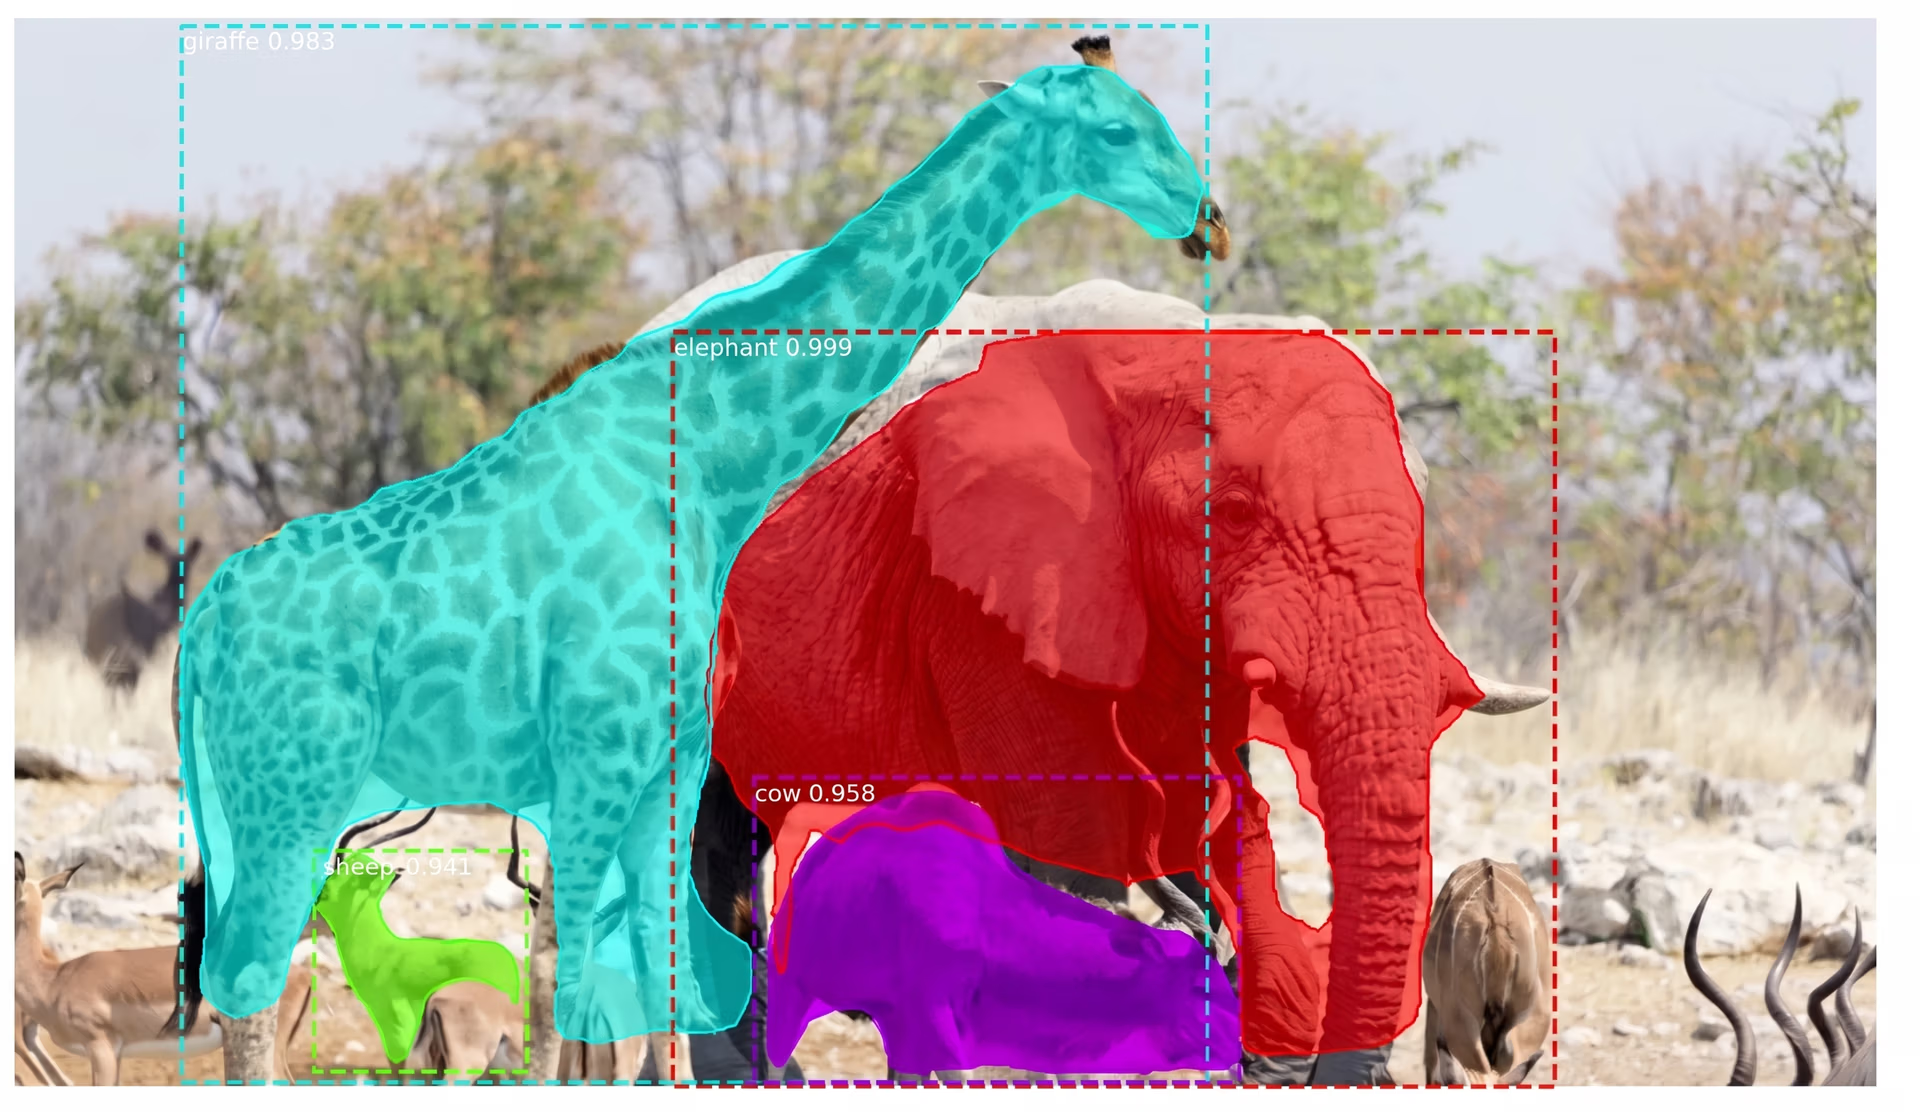
Abb. 5. Tiere mit Mask R-CNN erkennen und segmentieren.
Einschränkungen von Mask R-CNN#
Trotz seiner historischen Bedeutung für die Objekterkennung und -segmentierung bringt Mask R-CNN auch einige wesentliche Nachteile mit sich. Zu den Herausforderungen bei Mask R-CNN gehören:
- Hoher Rechenaufwand: Das Modell benötigt leistungsstarke GPUs, was den Betrieb teuer und die Verarbeitung großer Datenmengen langsam machen kann.
- Langsamere Verarbeitung: Durch den mehrstufigen Ablauf ist das Modell langsamer als schnellere Echtzeitmodelle wie YOLO und eignet sich daher möglicherweise nicht für zeitkritische Aufgaben.
- Abhängigkeit von hochwertigen Daten: Mit klaren, gut annotierten Bildern erzielt das Modell die besten Ergebnisse. Unscharfe oder schlecht beleuchtete Bilder können seine Genauigkeit erheblich verringern.
- Komplexe Implementierung: Die mehrstufige Architektur kann schwierig einzurichten und zu optimieren sein, insbesondere bei großen Datensätzen oder begrenzten Ressourcen.
Von Mask R-CNN zu Ultralytics YOLO11#
Mask R-CNN eignete sich hervorragend für Segmentierungsaufgaben, doch viele Branchen wollten Computer Vision einsetzen und dabei Geschwindigkeit und Echtzeitleistung priorisieren. Dieser Bedarf veranlasste Forschende, einstufige Modelle zu entwickeln, die Objekte in einem einzigen Durchlauf erkennen und so die Effizienz deutlich steigern.
Anders als der mehrstufige Prozess von Mask R-CNN konzentrieren sich einstufige Computer-Vision-Modelle wie YOLO (Du siehst nur einmal) auf Computer-Vision-Aufgaben in Echtzeit. Anstatt Erkennung und Segmentierung getrennt durchzuführen, können YOLO-Modelle Objekte in einem einzigen Durchlauf erkennen und segmentieren. Dadurch eignen sie sich ideal für Anwendungen wie autonomes Fahren, Gesundheitswesen, Fertigung und Robotik, bei denen schnelle Entscheidungen entscheidend sind.
Insbesondere Ultralytics YOLO11 (inzwischen abgelöst durch Ultralytics YOLO26) geht noch einen Schritt weiter und vereint Geschwindigkeit mit Genauigkeit. Es benötigt 22 % weniger Parameter als YOLOv8m und erzielt trotzdem eine höhere mittlere durchschnittliche Präzision (mAP) auf dem COCO-Datensatz, das heißt, es erkennt Objekte genauer. Dank der verbesserten Verarbeitungsgeschwindigkeit eignet es sich gut für Echtzeitanwendungen, bei denen jede Millisekunde zählt.
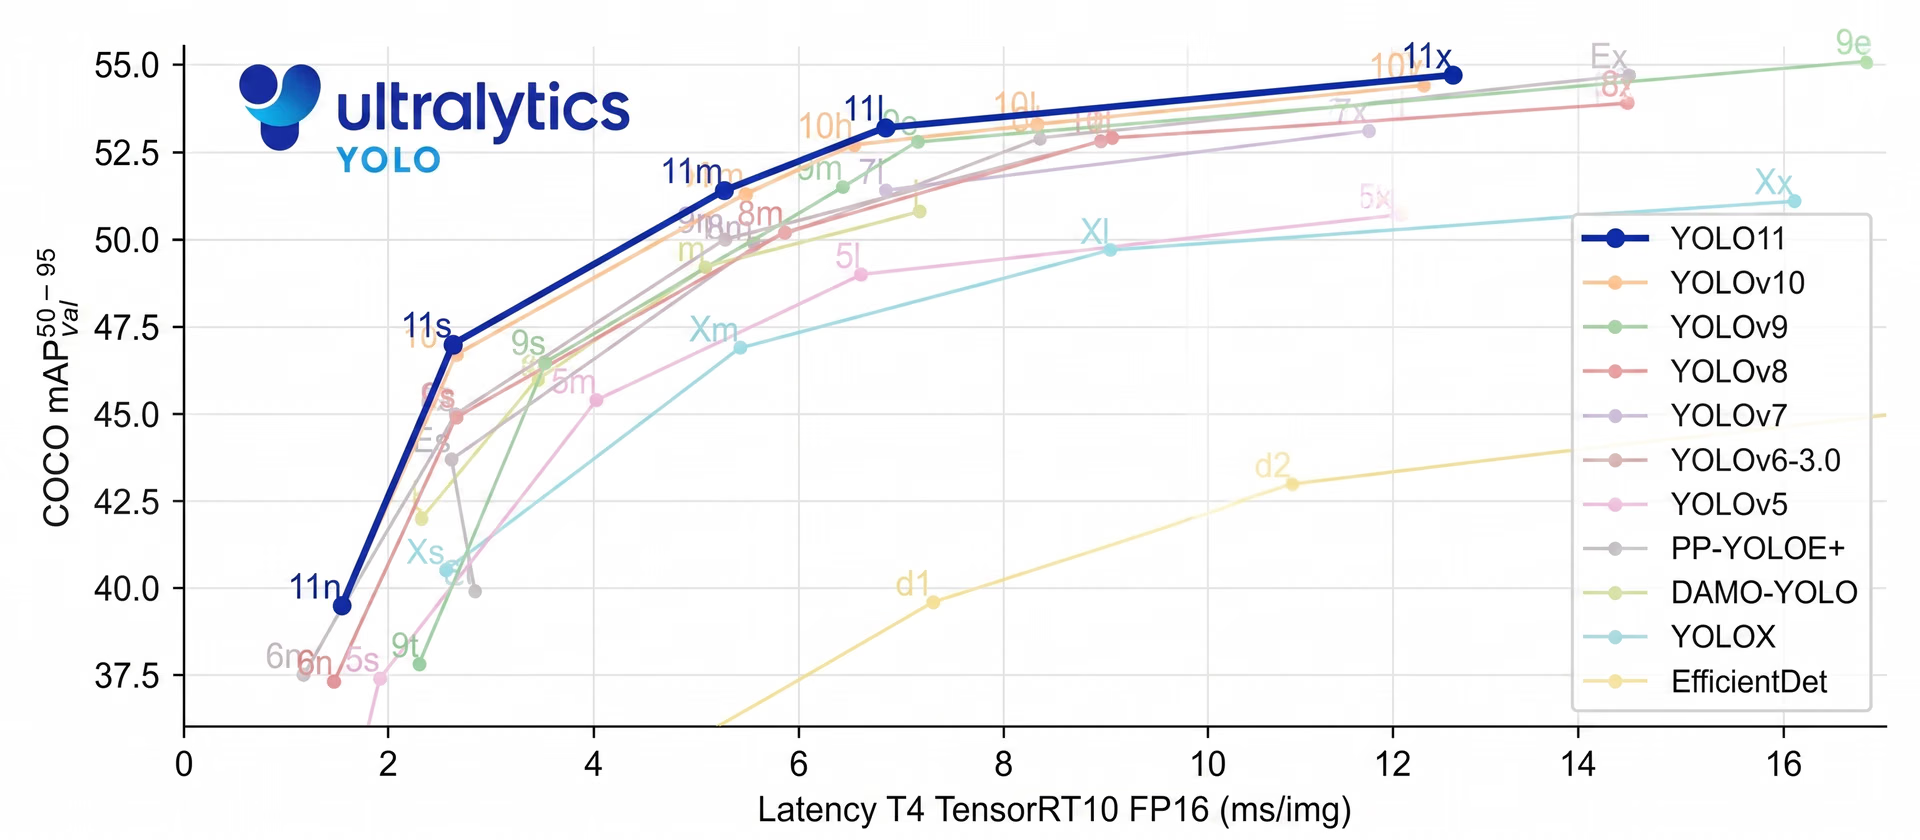
Abb. 6. Leistung von YOLO11 im Vergleich zu anderen Modellen.
Die wichtigsten Erkenntnisse#
Rückblickend auf die Geschichte von Computer Vision gilt Mask R-CNN als bedeutender Durchbruch bei der Objekterkennung und -segmentierung. Dank seines detaillierten mehrstufigen Ablaufs liefert es selbst in komplexen Situationen sehr präzise Ergebnisse.
Dieser Prozess macht das Modell jedoch langsamer als Echtzeitmodelle wie YOLO. Da Geschwindigkeit und Effizienz immer wichtiger werden, setzen viele Anwendungen inzwischen auf einstufige Modelle wie Ultralytics YOLO11, die eine schnelle und genaue Objekterkennung ermöglichen. Mask R-CNN bleibt zwar für das Verständnis der Entwicklung von Computer Vision wichtig, doch der Wechsel zu Echtzeitmodellen spiegelt den wachsenden Bedarf an schnelleren und effizienteren Lösungen wider.
Werde Teil unserer wachsenden Community! In unserem GitHub-Repository erfährst du mehr über KI. Möchtest du eigene Computer-Vision-Projekte starten? Sieh dir unsere Lizenzoptionen an. Entdecke KI in der Landwirtschaft und Vision-KI im Gesundheitswesen auf unseren Lösungsseiten!
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









